
Last chance! 50% off DataCamp Premium
Sale ends in
Keşifsel Veri Analizi (EDA) ve başlangıç düzeyi model hazır olduğuna göre, ilk gerçek Makine Öğrenimi modeliniz üzerinde çalışmaya başlayabilirsiniz.
Not: Bu eğitim bir Facebook Live kodlama oturumuna dayanmaktadır; Buradan tekrar izleyebilirsiniz:
Başlamadan önce, gerekli tüm kütüphaneleri içe aktarın:
# Import modules
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import re
import numpy as np
from sklearn import tree
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import GridSearchCV

# Figures inline and set visualization style
%matplotlib inline
sns.set()

# Import data
df_train = pd.read_csv('data/train.csv')
df_test = pd.read_csv('data/test.csv')
data DataFrame'i oluşturacaksınız. Bunu, veriyi biraz ön işlemek ve eğitim setinde yaptığınız işlemlerin test setinde de yapıldığından emin olmak için yapıyorsunuz.# Store target variable of training data in a safe place
survived_train = df_train.Survived
# Concatenate training and test sets
data = pd.concat([df_train.drop(['Survived'], axis=1), df_test])
info() metodunu kullanarak yeni data DataFrame'inize göz atın.data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1046 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1308 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KB
Eksik değerlere sahip 2 sayısal değişken var.
Hangileri?
Doğru, 'Age' ve 'Fare' sütunlarında eksik değerleriniz var! Yukarıdaki .info() çıktısında, toplam 1309 kayıttan yalnızca 1046'sı null olmayan değer içerdiği için ilk sütunda 263 değerin eksik olduğunu görüyorsunuz. İdeal olarak bu 1309 kaydın hepsinin null olmayan değerlere sahip olmasını istersiniz, ama burada durum böyle değil!
Neyse ki, Fare sütununda yalnızca bir değer eksik. Ayrıca 'Cabin' ve 'Embarked' sütunlarında da eksikler olduğunu ve bununla da bir noktada ilgilenmeniz gerekeceğini unutmayın.
Ancak şimdi, sayısal değişkenleri düzeltmeye odaklanacaksınız: 'Age' ve 'Fare' sütunlarındaki eksik değerleri, bu değişkenlerin bilinen değerlerinin medyanını kullanarak atayacak ya da dolduracaksınız.
Not: Bu durumda medyan kullanıyorsunuz çünkü aykırı değerlere karşı idealdir. Başka bir deyişle, veri dağılımı çarpık olduğunda medyan kullanışlıdır. Eksikleri doldurmanın diğer yolları ortalama (tüm veri noktalarını toplayıp veri noktası sayısına bölerek bulunur) veya en çok tekrar eden değer olan mod olabilir.
# Impute missing numerical variables
data['Age'] = data.Age.fillna(data.Age.median())
data['Fare'] = data.Fare.fillna(data.Fare.median())

# Check out info of data
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1309 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1309 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KB
Bu çok daha iyi görünüyor, değil mi!
Ayrıca, önceki eğitimde ve notebook'ta, EDA’dan hareketle 'Survived' için önemli olacağını gördüğünüz ve tahminlerde kullanmak istediğiniz bir dizi özellik vardı. Bunlardan biri 'Fare' idi; ama 'Age' ve 'Sex' de diğerleriydi!
Ancak verinizi sayılarla kodlamak istiyorsunuz, bu yüzden 'male' ve 'female'i sayılara çevireceksiniz. Bunu, çoğu makine öğrenimi modelinin sayısal giriş özellikleriyle çalışması nedeniyle yaparsınız. Bunun için pandas'ın .get_dummies() fonksiyonunu kullanabilirsiniz:
data = pd.get_dummies(data, columns=['Sex'], drop_first=True)
data.head()
| PassengerId | Pclass | Name | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Sex_male | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 3 | Braund, Mr. Owen Harris | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S | 1 |
| 1 | 2 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C | 0 |
| 2 | 3 | 3 | Heikkinen, Miss. Laina | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S | 0 |
| 3 | 4 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S | 0 |
| 4 | 5 | 3 | Allen, Mr. William Henry | 35.0 | 0 | 0 | 373450 | 8.0500 | NaN | S | 1 |
.get_dummies(), 'Sex' içindeki her seçenek için yeni bir sütun oluşturmanıza olanak tanır. Böylece female için 'Sex_female' adlı yeni bir sütun ve ardından o satırın erkek mi kadın mı olduğunu kodlayan 'Sex_male' adlı bir sütun oluşturur.
Şimdi, yukarıdaki kod satırında drop_first argümanını eklediğiniz için, aslında bu yeni sütunlar 'Sex_female' ve 'Sex_male' aynı bilgiyi kodladığından 'Sex_female' sütununu düşürdünüz.
Yani yaptığınız şey, o satır erkekse 1, kadınsa 0 olan yeni bir 'Sex_male' sütunu oluşturmak oldu.
.get_dummies(), makine öğrenimi için veri işleme yaparken en iyi dostlarınızdan biri olacak!
['Sex_male', 'Fare', 'Age','Pclass', 'SibSp'] sütunlarını seçeceksiniz:# Select columns and view head
data = data[['Sex_male', 'Fare', 'Age','Pclass', 'SibSp']]
data.head()
| Sex_male | Fare | Age | Pclass | SibSp | |
|---|---|---|---|---|---|
| 0 | 1 | 7.2500 | 22.0 | 3 | 1 |
| 1 | 0 | 71.2833 | 38.0 | 1 | 1 |
| 2 | 0 | 7.9250 | 26.0 | 3 | 0 |
| 3 | 0 | 53.1000 | 35.0 | 1 | 1 |
| 4 | 1 | 8.0500 | 35.0 | 3 | 0 |
.info() ile data'yı kontrol edin:data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 5 columns):
Sex_male    1309 non-null uint8
Fare        1309 non-null float64
Age         1309 non-null float64
Pclass      1309 non-null int64
SibSp       1309 non-null int64
dtypes: float64(2), int64(2), uint8(1)
memory usage: 52.4 KB
Tüm kayıtlar artık null değil. Harika iş!
Şu ana kadar, verinizi ilk makine öğrenimi modelini kuracak forma getirdiniz. Bu da nihayet ilk makine öğrenimi modelinizi oluşturabileceğiniz anlamına geliyor!
pandas hakkında daha fazlası için Python ile Veri Manipülasyonu öğrenim yolumuza göz atın.
Karar ağacı sınıflandırıcısı nedir? Özellik değişkenlerine dayanarak veri noktalarını (hedef değişkenler olarak da bilinir) sınıflandırmanıza olanak tanıyan bir ağaçtır.
Örneğin, aşağıdaki ağaç, kök düğümde şu soruya göre ilk kararı vermenizi sağlar: "'Sex_male' 0,5'ten küçük müydü?" Başka bir deyişle, veri noktası kadın mıydı? Bu sorunun cevabı True ise sola inersiniz ve sonuç 'Survived' olur. False ise sağa inersiniz ve sonuç 'Dead' olur.
Şimdilik, düğümlerde gördüğünüz gini, samples veya value gibi ek bilgiler için endişelenmenize gerek yok. Bunların hepsine daha sonra bakabilirsiniz!
'Male' sonucunun 'Dead' tahminiyle sonuçlanması gibi.Not: Bu kararları vermek için aslında gini katsayısı kullanılır. Bu noktada bu konulara daha derinlemesine girmeyeceksiniz.
data'nıza uydurmadan önce, veriyi tekrar eğitim ve test setlerine ayırın:data_train = data.iloc[:891]
data_test = data.iloc[891:]
scikit-learn kullanacaksınız; bu paket verinizi DataFrame değil, dizi (array) olarak ister; bu yüzden dönüştürün:X = data_train.values
test = data_test.values
y = survived_train.values
max_depth=3 ile bir model oluşturun ve ardından verinize uydurun. Not: Modele clf adını veriyorsunuz; bu, "Classifier"ın kısaltmasıdır.# Instantiate model and fit to data
clf = tree.DecisionTreeClassifier(max_depth=3)
clf.fit(X, y)
DecisionTreeClassifier(class_weight=None, criterion='gini', max_depth=3,
            max_features=None, max_leaf_nodes=None,
            min_impurity_decrease=0.0, min_impurity_split=None,
            min_samples_leaf=1, min_samples_split=2,
            min_weight_fraction_leaf=0.0, presort=False, random_state=None,
            splitter='best')
Özellik değişkenleri X, .fit() metoduna verdiğiniz ilk argümandır; hedef değişken y ise ikinci argümandır.
Çıktı, az önce oluşturduğunuz Karar Ağacı Sınıflandırıcısı hakkında bilmeniz gereken her şeyi söyler: Örneğin, azami derinliğin 3 olarak ayarlandığını görürsünüz.
'Survived' sütunu oluşturacak ve tahminlerinizi burada saklayacaksınız. df_test'in 'PassengerId' ve 'Survived' sütunlarını bir .csv dosyasına kaydedip Kaggle'a gönderin.# Make predictions and store in 'Survived' column of df_test
Y_pred = clf.predict(test)
df_test['Survived'] = Y_pred
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/1st_dec_tree.csv', index=False)
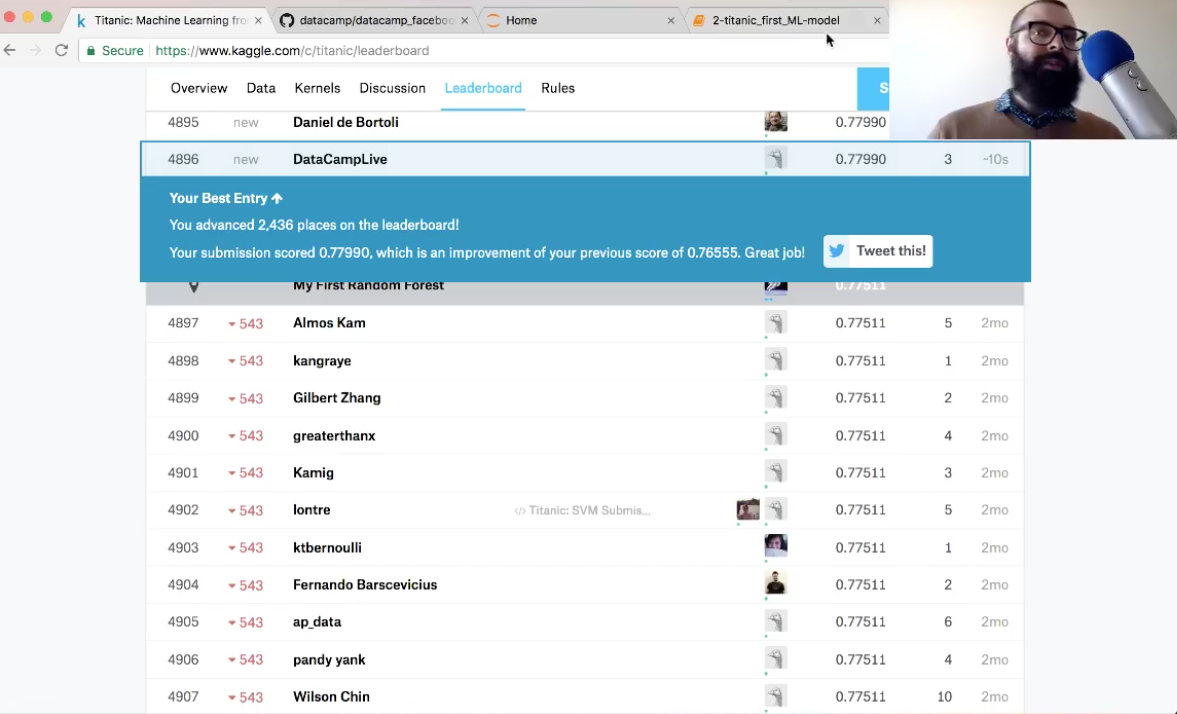
Doğruluk %78. 2000'den fazla sıra yükseldiniz!
Tebrikler, verinizi ilk makine öğrenimi modelini kuracak forma getirdiniz. Üstelik ilk makine öğrenimi modelinizi de oluşturdunuz: bir karar ağacı sınıflandırıcısı.
Şimdi, bu max_depth argümanının ne olduğunu, neden bunu seçtiğinizi ve train_test_split'i keşfedeceksiniz.
scikit-learn hakkında daha fazlası için scikit-learn ile Denetimli Öğrenme kursumuza göz atın.
Az önce kurduğunuz Karar Ağacı Sınıflandırıcısı max_depth=3 idi ve şöyle görünüyor:
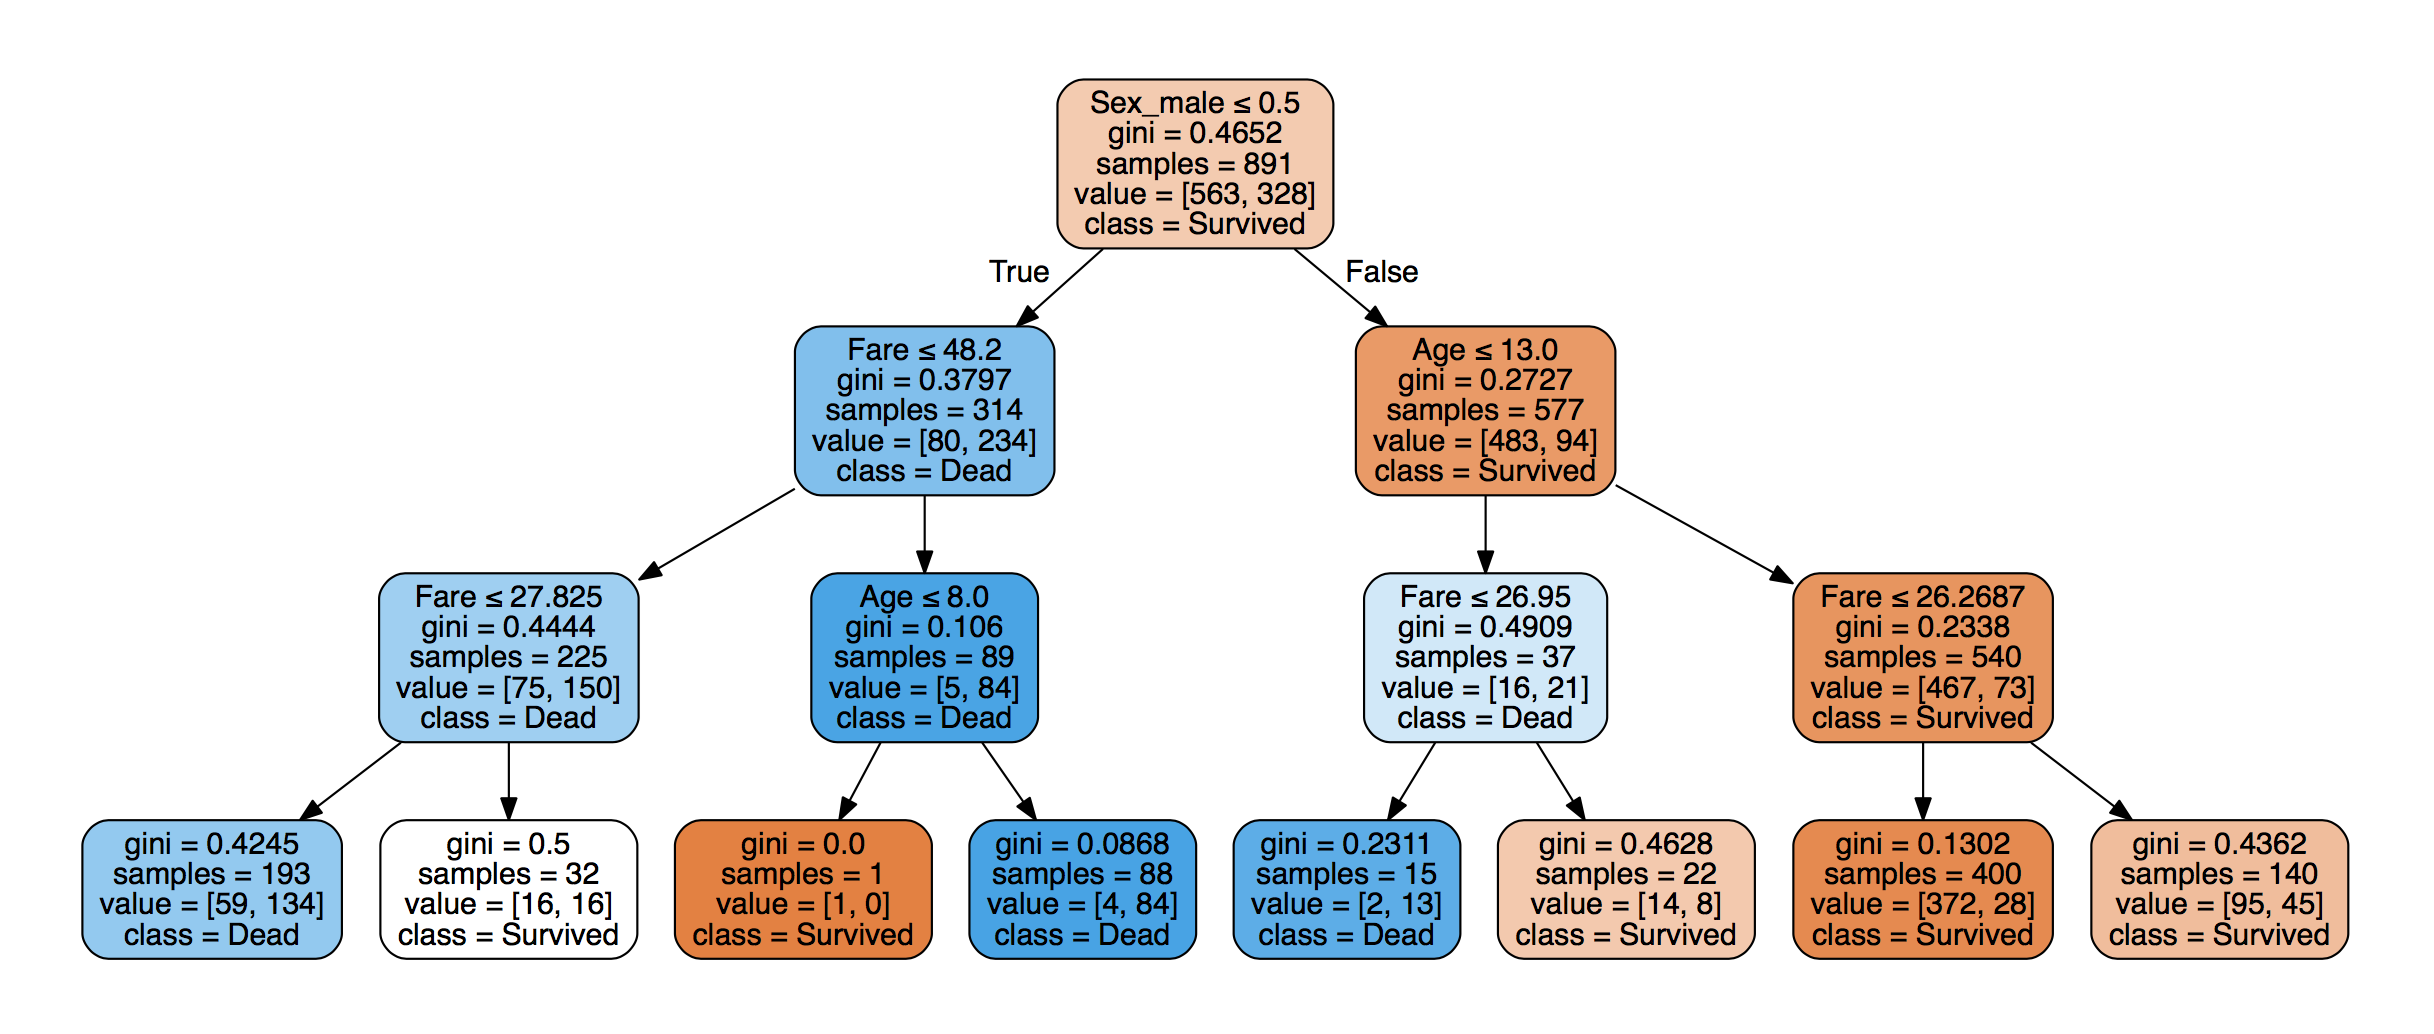
İlk karar ile son karar arasındaki en büyük mesafe 3’tür; yani max_depth=3.
Not: Bu tür şekilleri üretmek için graphviz kullanabilirsiniz. Daha fazla ayrıntı için scikit-learn dokümantasyonuna buradan bakın.
Bu modeli kurarken özünde yaptığınız şey, özellik değişkenleri uzayında bir karar sınırı oluşturmaktır; örneğin (görsel buradan):
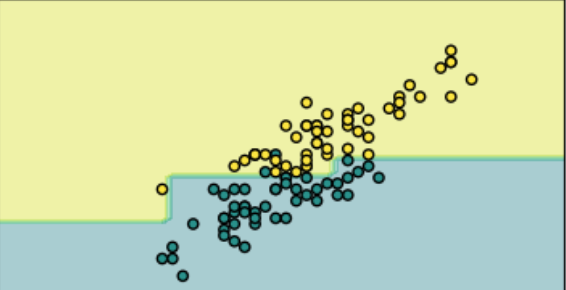
max_depth=3 Seçilir?Ağaç derinliği bir hiperparametredir; yani modeli veriye uydurmadan önce karar vermeniz gereken bir parametre. Daha büyük bir max_depth seçerseniz, daha karmaşık bir karar sınırı elde edersiniz.
Karar sınırınız çok karmaşıksa, veriye aşırı uyum sağlayabilirsiniz; bu da modelinizin sinyalle birlikte gürültüyü de açıklaması anlamına gelir.
max_depth çok küçükse, veriyi eksik öğrenebilirsiniz; yani modeliniz sinyali yeterince yakalamaz.
Peki aşırı uyum mu, eksik öğrenme mi olduğunu nasıl anlarsınız?
Not: Buna önyargı-varyans dengesi de denir; burada ayrıntıya girmeyeceğiz, sadece tamlık adına anıyoruz!
Yollardan biri, eğitim verinizden bir test setini ayırmaktır. Ardından modeli eğitim verinize uydurur, test setinde tahminler yapar ve tahmininizin test setinde ne kadar iyi iş çıkardığını görürsünüz.
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.33, random_state=42, stratify=y)
1’den 9’a kadar değişen max_depth değerleri üzerinde yineleme yapın ve modellerin eğitim ve test setlerindeki doğruluğunu görselleştirin:# Setup arrays to store train and test accuracies
dep = np.arange(1, 9)
train_accuracy = np.empty(len(dep))
test_accuracy = np.empty(len(dep))
# Loop over different values of k
for i, k in enumerate(dep):
# Setup a Decision Tree Classifier
clf = tree.DecisionTreeClassifier(max_depth=k)
# Fit the classifier to the training data
clf.fit(X_train, y_train)
#Compute accuracy on the training set
train_accuracy[i] = clf.score(X_train, y_train)
#Compute accuracy on the testing set
test_accuracy[i] = clf.score(X_test, y_test)
# Generate plot
plt.title('clf: Varying depth of tree')
plt.plot(dep, test_accuracy, label = 'Testing Accuracy')
plt.plot(dep, train_accuracy, label = 'Training Accuracy')
plt.legend()
plt.xlabel('Depth of tree')
plt.ylabel('Accuracy')
plt.show()
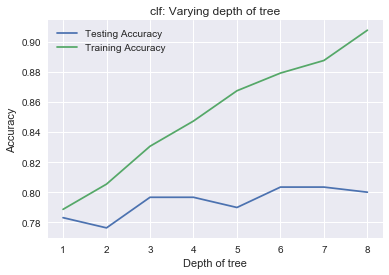
max_depth'i artırdıkça, eğitim verisine daha iyi uyum sağlayacaksınız çünkü eğitim verisini açıklayan kararlar alacaksınız. Eğitim verisi için doğruluk sürekli artacaktır; ancak bunun test verisi için olmadığını görüyorsunuz: aşırı uyum söz konusu.
İşte bu yüzden max_depth=3'ü seçtiniz.
Bu eğitimde, verinizi ilk makine öğrenimi modelinizi kuracak forma getirdiniz. Ardından, ilk makine öğrenimi modelinizi de oluşturdunuz: bir karar ağacı sınıflandırıcısı. Son olarak, train_test_split'i ve ML model hiperparametrelerini seçmemize nasıl yardımcı olduğunu öğrendiniz.
Bir sonraki eğitim, 10 Ocak 2018'de DataCamp Community’de yayınlanacak; orada yeni özellikler nasıl türetileceğini ve yeni modellerin nasıl kurulacağını öğreneceksiniz!
Bu arada, scikit-learn hakkında daha fazlasını keşfetmek isterseniz, DataCamp’in scikit-learn ile Denetimli Öğrenme kursuna göz atın.
Makine Öğrenimi Kursları
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.





