
Last chance! 50% off DataCamp Premium
Sale ends in
Exploratory Data Analysis (EDA) और बेसलाइन मॉडल हाथ में होने के साथ, आप अपना पहला वास्तविक मशीन लर्निंग मॉडल बनाना शुरू कर सकते हैं।
नोट कि यह ट्यूटोरियल एक Facebook Live कोड-अलॉन्ग सत्र पर आधारित है; आप इसे यहां फिर से देख सकते हैं:
शुरू करने से पहले, सभी आवश्यक लाइब्रेरी इम्पोर्ट करें:
# Import modules
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import re
import numpy as np
from sklearn import tree
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import GridSearchCV

# Figures inline and set visualization style
%matplotlib inline
sns.set()

# Import data
df_train = pd.read_csv('data/train.csv')
df_test = pd.read_csv('data/test.csv')
data बनाएंगे, जिसमें प्रशिक्षण और टेस्ट सेट दोनों साथ जोड़े होंगे। आप ऐसा इसलिए करते हैं क्योंकि आप डेटा को थोड़ा-बहुत प्रीप्रोसेस करना चाहते हैं और यह सुनिश्चित करना चाहते हैं कि जो भी ऑपरेशन आप प्रशिक्षण सेट पर करें, वही टेस्ट डेटा सेट पर भी हों।# Store target variable of training data in a safe place
survived_train = df_train.Survived
# Concatenate training and test sets
data = pd.concat([df_train.drop(['Survived'], axis=1), df_test])
info() मेथड का उपयोग करके अपने नए DataFrame data को देखें।data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1046 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1308 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KB
दो संख्यात्मक वेरिएबल ऐसे हैं जिनमें मिसिंग वैल्यू हैं।
वे कौन से हैं?
बिल्कुल सही, आपके पास 'Age' और 'Fare' कॉलम के लिए वैल्यू गायब हैं! आप ऊपर .info() मेथड के परिणाम में देखते हैं कि पहले कॉलम के लिए 263 वैल्यू गायब हैं, क्योंकि आपके DataFrame की कुल 1309 एंट्रीज़ में से केवल 1046 non-null वैल्यू हैं। आदर्श रूप से, आप चाहते हैं कि सभी 1309 में non-null वैल्यू हों, पर यहां ऐसा नहीं है!
खुशकिस्मती से, Fare कॉलम के लिए केवल एक वैल्यू गायब है। यह भी नोट करें कि 'Cabin' और 'Embarked' में भी वैल्यू गायब हैं और आपको किसी बिंदु पर उनसे भी निपटना होगा।
हालांकि, अभी आप संख्यात्मक वेरिएबल्स को ठीक करने पर ध्यान देंगे: आप 'Age' और 'Fare' कॉलम की मिसिंग वैल्यू को, जहां वे ज्ञात हैं, उन वेरिएबल्स के median का उपयोग करके भरेंगे (इम्प्यूट करेंगे)।
नोट कि इस मामले में आप median का उपयोग करते हैं क्योंकि यह आउटलायर्स से निपटने के लिए उपयुक्त है। दूसरे शब्दों में, जब डेटा का वितरण skewed हो, तो median उपयोगी होता है। मिसिंग वैल्यू इम्प्यूट करने के अन्य तरीके mean का उपयोग करना है, जिसे सभी डेटा पॉइंट जोड़कर और डेटा पॉइंट्स की संख्या से भाग देकर पाया जाता है, या mode, जो वह संख्या है जो सबसे अधिक बार आती है।
# Impute missing numerical variables
data['Age'] = data.Age.fillna(data.Age.median())
data['Fare'] = data.Fare.fillna(data.Fare.median())

# Check out info of data
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1309 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1309 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KB
यह अब पहले से काफी बेहतर दिख रहा है, है ना!
यह भी नोट करें कि पिछले ट्यूटोरियल और नोटबुक में, आपके पास ऐसे कई फीचर्स थे जिन्हें आप प्रेडिक्शन के लिए इस्तेमाल करना चाहते थे, क्योंकि आपने अपनी exploratory data analysis से देखा था कि वे 'Survived' के लिए महत्वपूर्ण होंगे या नहीं। उन फीचर्स में से एक 'Fare' था, लेकिन 'Age' और 'Sex' भी थे!
लेकिन आप अपने डेटा को संख्याओं से एन्कोड करना चाहते हैं, इसलिए आप 'male' और 'female' को संख्याओं में बदलना चाहेंगे। आप ऐसा इसलिए करते हैं क्योंकि अधिकांश मशीन लर्निंग मॉडल्स संख्यात्मक इनपुट फीचर्स पर काम करते हैं। आप ऐसा करने के लिए pandas का .get_dummies() फंक्शन इस्तेमाल कर सकते हैं:
data = pd.get_dummies(data, columns=['Sex'], drop_first=True)
data.head()
| PassengerId | Pclass | Name | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Sex_male | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 3 | Braund, Mr. Owen Harris | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S | 1 |
| 1 | 2 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C | 0 |
| 2 | 3 | 3 | Heikkinen, Miss. Laina | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S | 0 |
| 3 | 4 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S | 0 |
| 4 | 5 | 3 | Allen, Mr. William Henry | 35.0 | 0 | 0 | 373450 | 8.0500 | NaN | S | 1 |
.get_dummies() आपको 'Sex' में मौजूद प्रत्येक विकल्प के लिए एक नया कॉलम बनाने देता है। तो यह female के लिए 'Sex_female' नाम से नया कॉलम बनाता है, और फिर 'Sex_male' का एक नया कॉलम बनाता है, जो एन्कोड करता है कि वह पंक्ति पुरुष थी या महिला।
अब, क्योंकि आपने ऊपर वाली कोड लाइन में drop_first आर्गुमेंट जोड़ा है, आपने 'Sex_female' को ड्रॉप कर दिया, क्योंकि मूलतः ये नए कॉलम, 'Sex_female' और 'Sex_male', एक ही जानकारी एन्कोड करते हैं।
तो आपने जो किया है वह यह है कि आपने 'Sex_male' नाम का एक नया कॉलम बनाया है, जिसमें यदि वह पंक्ति पुरुष है तो 1 होगा - और यदि वह पंक्ति महिला है तो 0 होगा।
डेटा मैनिपुलेशन करते समय .get_dummies() मशीन लर्निंग के लिए आपके सबसे अच्छे मित्रों में से एक होगा!
['Sex_male', 'Fare', 'Age','Pclass', 'SibSp'] चुनेंगे ताकि अपना पहला मशीन लर्निंग मॉडल बना सकें:# Select columns and view head
data = data[['Sex_male', 'Fare', 'Age','Pclass', 'SibSp']]
data.head()
| Sex_male | Fare | Age | Pclass | SibSp | |
|---|---|---|---|---|---|
| 0 | 1 | 7.2500 | 22.0 | 3 | 1 |
| 1 | 0 | 71.2833 | 38.0 | 1 | 1 |
| 2 | 0 | 7.9250 | 26.0 | 3 | 0 |
| 3 | 0 | 53.1000 | 35.0 | 1 | 1 |
| 4 | 1 | 8.0500 | 35.0 | 3 | 0 |
.info() का उपयोग करके data देखें:data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 5 columns):
Sex_male    1309 non-null uint8
Fare        1309 non-null float64
Age         1309 non-null float64
Pclass      1309 non-null int64
SibSp       1309 non-null int64
dtypes: float64(2), int64(2), uint8(1)
memory usage: 52.4 KB
अब सभी एंट्रीज़ non-null हैं। बहुत बढ़िया!
अब तक, आपने अपना डेटा ऐसे रूप में ला दिया है जिससे पहला मशीन लर्निंग मॉडल बनाया जा सके। इसका मतलब है कि आप अंततः अपना पहला मशीन लर्निंग मॉडल बना सकते हैं!
pandas पर और अधिक के लिए, हमारा Data Manipulation with Python ट्रैक देखें।
डिसीजन ट्री क्लासिफायर क्या है? यह एक ट्री होता है जो फीचर वेरिएबल्स के आधार पर डेटा पॉइंट्स (जिन्हें टार्गेट वेरिएबल भी कहते हैं) को वर्गीकृत करने देता है।
उदाहरण के लिए, नीचे दिए गए इस ट्री का एक रूट नोड है जो आपको पहला निर्णय लेने के लिए बाध्य करता है, यह प्रश्न पूछकर: "क्या 'Sex_male' 0.5 से कम था?" दूसरे शब्दों में, क्या डेटा पॉइंट महिला था। यदि इस प्रश्न का उत्तर True है, तो आप बाएं जाते हैं और आपको 'Survived' मिलता है। यदि False है, तो आप दाएं जाते हैं और आपको 'Dead' मिलता है।
फिलहाल, आपको नोड्स में दिख रही अतिरिक्त जानकारी, जैसे gini, samples, या value के बारे में चिंता करने की ज़रूरत नहीं है। आप यह सब बाद में देख सकते हैं!
'Male' का परिणाम 'Dead' की भविष्यवाणी देता है।नोट कि वास्तव में ये निर्णय लेने के लिए gini coefficient का उपयोग होता है। इस बिंदु पर, आप इन बातों में और गहराई में नहीं जाएंगे।
data पर मॉडल फिट करने से पहले, इसे वापस प्रशिक्षण और टेस्ट सेट में विभाजित करें:data_train = data.iloc[:891]
data_test = data.iloc[891:]
scikit-learn का उपयोग करेंगे, जो आपके डेटा को DataFrames नहीं बल्कि arrays के रूप में चाहता है, इसलिए उन्हें ट्रांसफॉर्म करें:X = data_train.values
test = data_test.values
y = survived_train.values
max_depth=3 के साथ ऐसा मॉडल बनाएं और फिर उसे अपने डेटा पर फिट करें। नोट कि आप अपने मॉडल का नाम clf रखते हैं, जो "Classifier" का संक्षिप्त रूप है।# Instantiate model and fit to data
clf = tree.DecisionTreeClassifier(max_depth=3)
clf.fit(X, y)
DecisionTreeClassifier(class_weight=None, criterion='gini', max_depth=3,
            max_features=None, max_leaf_nodes=None,
            min_impurity_decrease=0.0, min_impurity_split=None,
            min_samples_leaf=1, min_samples_split=2,
            min_weight_fraction_leaf=0.0, presort=False, random_state=None,
            splitter='best')
फीचर वेरिएबल्स X वह पहला आर्गुमेंट है जिसे आप .fit() मेथड को पास करते हैं, जबकि टार्गेट वेरिएबल y दूसरा आर्गुमेंट है।
आउटपुट आपको आपके द्वारा बनाए गए Decision Tree Classifier के बारे में वह सब बताता है जो जानना आवश्यक है: जैसे कि आप देखते हैं, उदाहरण के लिए, कि max depth 3 पर सेट है।
'Survived' बनाएंगे और अपनी भविष्यवाणियों को उसमें स्टोर करेंगे। df_test के 'PassengerId' और 'Survived' कॉलम्स को एक .csv में सेव करें और Kaggle पर सबमिट करें।# Make predictions and store in 'Survived' column of df_test
Y_pred = clf.predict(test)
df_test['Survived'] = Y_pred
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/1st_dec_tree.csv', index=False)
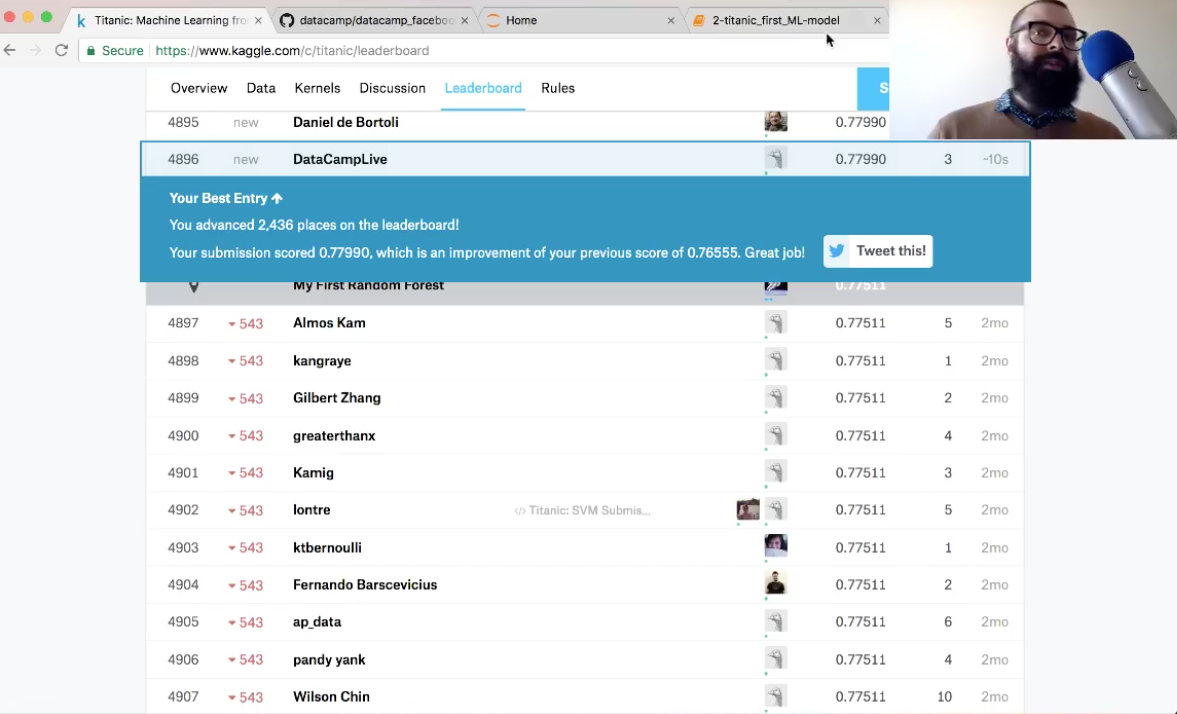
सटीकता 78% है। आप 2,000 से अधिक स्थान ऊपर बढ़ गए हैं!
बधाई हो, आपने अपना डेटा ऐसे रूप में ला दिया है जिससे पहला मशीन लर्निंग मॉडल बनाया जा सके। इसके ऊपर, आपने अपना पहला मशीन लर्निंग मॉडल भी बनाया: एक डिसीजन ट्री क्लासिफायर।
अब, आप समझेंगे कि यह max_depth आर्गुमेंट क्या था, आपने इसे क्यों चुना और train_test_split को एक्सप्लोर करेंगे।
scikit-learn पर और अधिक के लिए, हमारा Supervised Learning with scikit-learn कोर्स देखें।
जो Decision Tree Classifier आपने अभी बनाया, उसमें max_depth=3 था और वह इस तरह दिखता है:
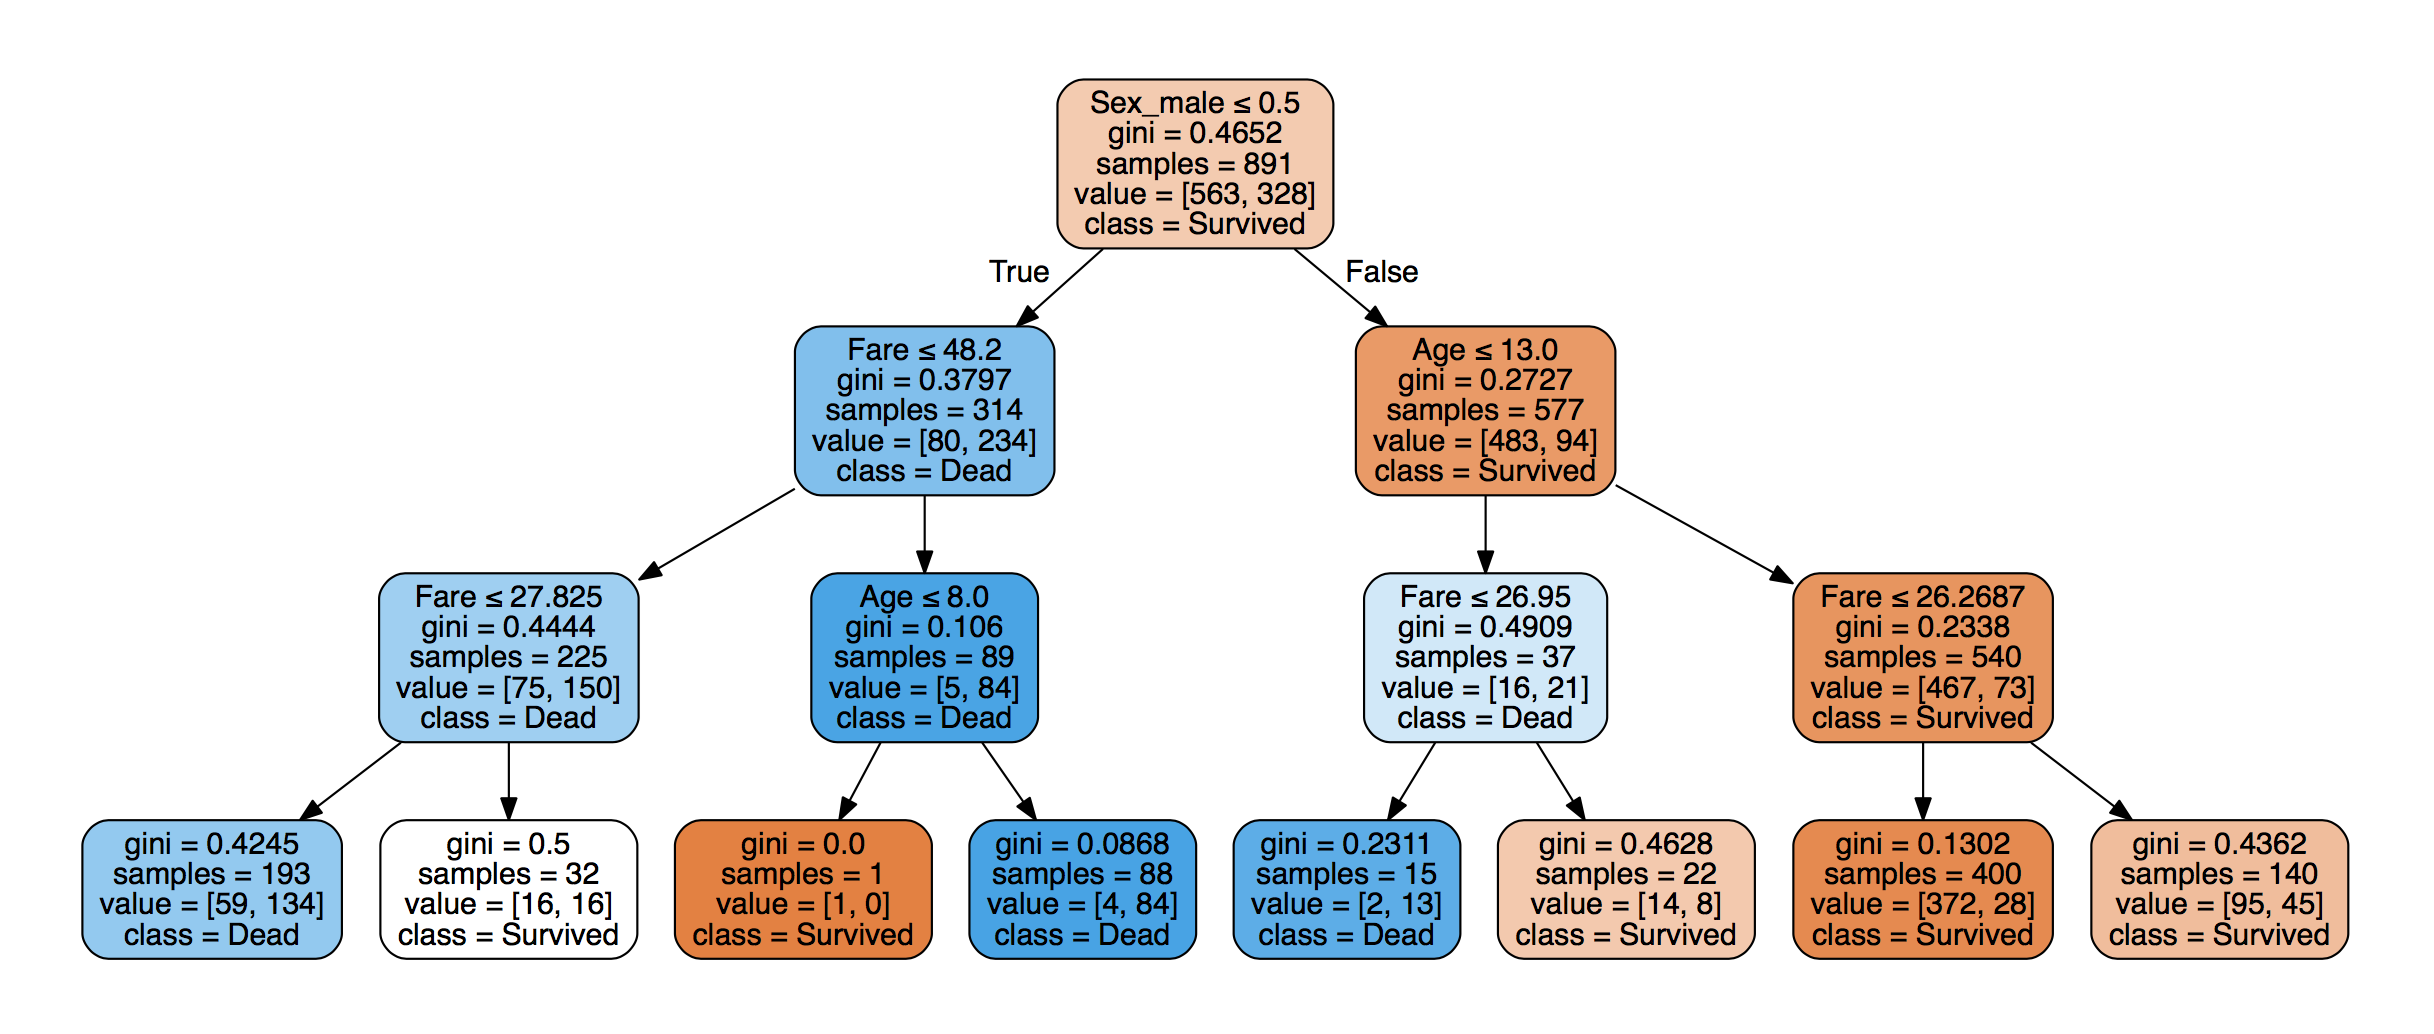
पहले निर्णय और आखिरी के बीच अधिकतम दूरी 3 है, इसलिए यह max_depth=3 है।
नोट: आप graphviz का उपयोग करके इस तरह के फिगर बना सकते हैं। विस्तृत जानकारी के लिए scikit-learn दस्तावेज यहां देखें।
यह मॉडल बनाते समय, आप मूलतः फीचर वेरिएबल्स के स्पेस में एक decision boundary बना रहे होते हैं, उदाहरण के लिए (चित्र यहां से):
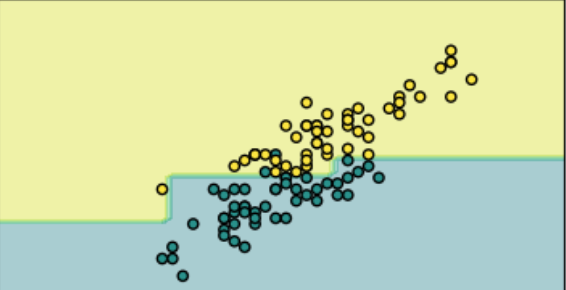
max_depth=3?ट्री की depth एक हाइपरपैरामीटर कहलाती है, जिसका मतलब है ऐसा पैरामीटर जिसे आपको मॉडल को डेटा पर फिट करने से पहले तय करना होता है। यदि आप बड़ा max_depth चुनते हैं, तो आपको अधिक जटिल decision boundary मिलेगा।
यदि आपकी decision boundary बहुत जटिल है, तो आप डेटा पर overfit कर सकते हैं, जिसका मतलब है कि आपका मॉडल सिग्नल के साथ-साथ noise का भी वर्णन करने लगेगा।
यदि आपका max_depth बहुत छोटा है, तो आप डेटा को underfit कर सकते हैं, यानी आपका मॉडल पर्याप्त सिग्नल को कैप्चर नहीं कर पाएगा।
लेकिन आप कैसे बताएंगे कि आप overfitting कर रहे हैं या underfitting?
नोट: इसे bias-variance trade-off भी कहा जाता है; हम यहां इसके विवरण में नहीं जाएंगे, इसे संपूर्णता के लिए बस उल्लेख कर रहे हैं!
एक तरीका यह है कि आप अपने प्रशिक्षण डेटा में से कुछ हिस्सा टेस्ट सेट के रूप में अलग रख लें। फिर आप मॉडल को अपने प्रशिक्षण डेटा पर फिट कर सकते हैं, अपने टेस्ट सेट पर प्रेडिक्शन कर सकते हैं और देख सकते हैं कि टेस्ट सेट पर आपका प्रेडिक्शन कितना अच्छा करता है।
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.33, random_state=42, stratify=y)
max_depth के मानों पर, जो 1 से 9 तक हैं, इटररेट करेंगे और प्रशिक्षण व टेस्ट सेट पर मॉडलों की accuracy को प्लॉट करेंगे:# Setup arrays to store train and test accuracies
dep = np.arange(1, 9)
train_accuracy = np.empty(len(dep))
test_accuracy = np.empty(len(dep))
# Loop over different values of k
for i, k in enumerate(dep):
# Setup a Decision Tree Classifier
clf = tree.DecisionTreeClassifier(max_depth=k)
# Fit the classifier to the training data
clf.fit(X_train, y_train)
#Compute accuracy on the training set
train_accuracy[i] = clf.score(X_train, y_train)
#Compute accuracy on the testing set
test_accuracy[i] = clf.score(X_test, y_test)
# Generate plot
plt.title('clf: Varying depth of tree')
plt.plot(dep, test_accuracy, label = 'Testing Accuracy')
plt.plot(dep, train_accuracy, label = 'Training Accuracy')
plt.legend()
plt.xlabel('Depth of tree')
plt.ylabel('Accuracy')
plt.show()
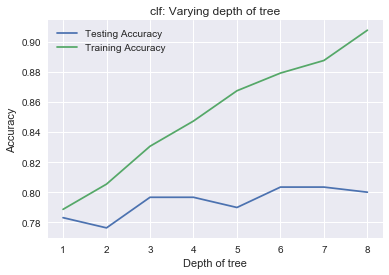
जैसे-जैसे आप max_depth बढ़ाते जाते हैं, आप प्रशिक्षण डेटा पर बेहतर और बेहतर फिट करेंगे क्योंकि आप ऐसे निर्णय लेंगे जो प्रशिक्षण डेटा का वर्णन करते हैं। प्रशिक्षण डेटा के लिए accuracy ऊपर और ऊपर जाती जाएगी, लेकिन आप देखते हैं कि टेस्ट डेटा के लिए ऐसा नहीं होता: आप overfitting कर रहे हैं।
यही कारण है कि आपने max_depth=3 चुना।
इस ट्यूटोरियल में, आपने अपना डेटा ऐसे रूप में ला दिया जिससे पहला मशीन लर्निंग मॉडल बनाया जा सके। इसके बाद, आपने अपना पहला मशीन लर्निंग मॉडल भी बनाया: एक डिसीजन ट्री क्लासिफायर। अंत में, आपने train_test_split के बारे में सीखा और कैसे यह हमें ML मॉडल के हाइपरपैरामीटर चुनने में मदद करता है।
अगले ट्यूटोरियल में, जो 10 जनवरी 2018 को DataCamp Community पर आएगा, आप सीखेंगे कि कुछ नए फीचर कैसे इंजीनियर करें और कुछ नए मॉडल कैसे बनाएं!
इस बीच, यदि आप scikit-learn के बारे में और जानना चाहते हैं, तो DataCamp का Supervised Learning with scikit-learn कोर्स देखें।
मशीन लर्निंग कोर्सेज
कोर्स
कोर्स
