Program
AI İşletme Temelleri
12 sa
Alexa veya Google Asistan gibi dijital asistanların sorularınıza nasıl bu kadar isabetli yanıtlar verdiğini hiç merak ettiniz mi?
Bunun arkasındaki sihir, bilgi getirme ile dil üretim tekniklerini birleştiren Retrieval-Augmented Generation (RAG) modelidir. Bu süreçte önemli bir rol oynayan unsur ise, yanıtların iyileştirilmesi için bu asistanların büyük bir yapılandırılmış bilgi havuzuna erişmesine yardımcı olan bir bilgi grafiğidir.
Bu öğreticide, bilgi grafiklerini ve daha doğru ve ilgili yanıtlar üreten RAG uygulamaları oluşturmak için nasıl kullanılabileceklerini inceleyeceğiz.
Bilgi grafiklerinin temelleri ve RAG içindeki rolleriyle başlayacağız. Bunları vektör veritabanlarıyla karşılaştıracak ve hangisini ne zaman kullanmanın daha iyi olduğuna bakacağız. Ardından, metin verilerinden bir bilgi grafiği oluşturup bunu bir veritabanında saklayacak ve kullanıcı sorguları için ilgili bilgiyi bulmak üzere kullanacağız. Ayrıca, bu yaklaşımı düz metnin ötesinde farklı veri türleri ve dosya biçimlerini ele alacak şekilde nasıl genişletebileceğimize de değineceğiz.
RAG hakkında daha fazla bilgi edinmek isterseniz, retrieval augmented generation üzerine bu makaleye göz atın.
Bilgi grafikleri, bilgiyi yapılandırılmış ve birbirine bağlı bir biçimde temsil eder. Varlıklardan (düğümler) ve bu varlıklar arasındaki ilişkilerden (kenarlar) oluşurlar. Varlıklar gerçek dünya nesnelerini, kavramları veya fikirleri temsil edebilirken, ilişkiler bu varlıkların nasıl bağlandığını açıklar.
Bilgi grafiklerinin ardındaki sezgi, insanların dünyayı anlama ve akıl yürütme biçimini taklit etmektir. Bilgiyi izole edilmiş silolarda saklamayız; bunun yerine, farklı bilgi parçaları arasında bağlantılar kurar, zengin ve birbirine bağlı bir bilgi ağı oluştururuz.
Bilgi grafikleri, farklı varlıklar arasındaki ilişkileri açıkça göstererek varlıkların nasıl bağlantılı olduğunu görmemize yardımcı olur. Bu bağlantıları keşfetmek, ayrı bilgi parçalarından çıkarması zor olabilecek yeni bilgiler bulmamıza ve sonuçlara varmamıza olanak tanır.
Bir örneğe bakalım.
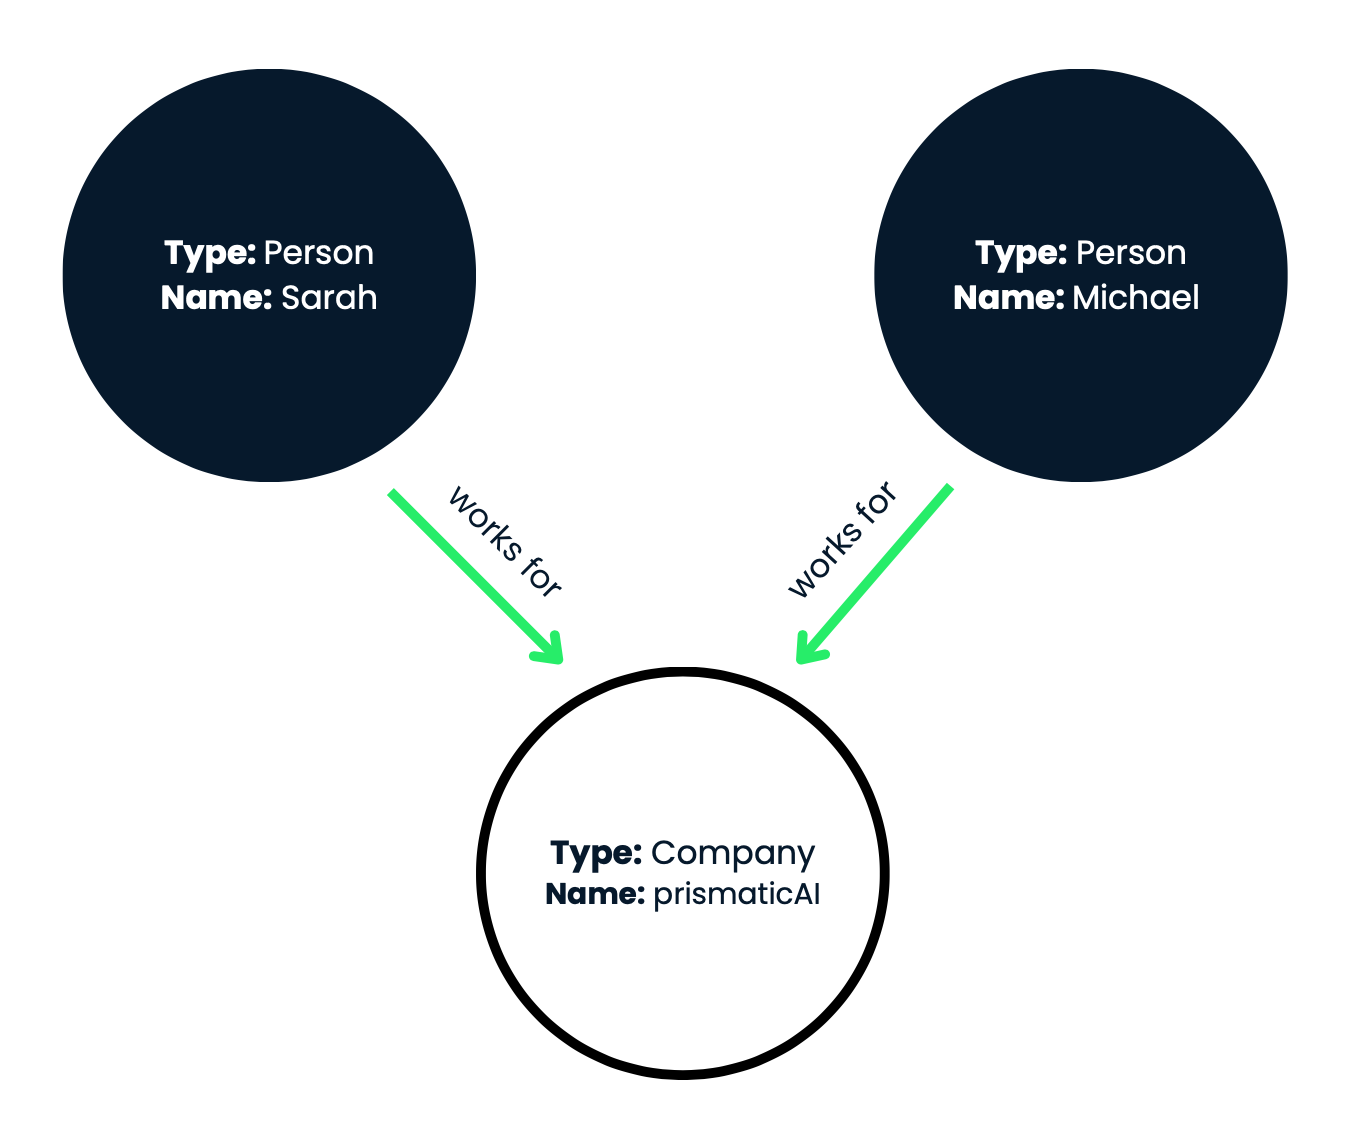
Şekil 1: Bu görsel temsilde, düğümler dairelerle, ilişkiler ise düğümleri birbirine bağlayan etiketli oklarla gösterilmiştir.
Bu bilgi grafiği, Sarah ve Michael adlı kişilerin prismaticAI şirketiyle olan istihdam ilişkilerini etkili bir şekilde yakalar. Örneğimizde üç düğümümüz var:
Özetle, iki kişi düğümümüz (Sarah ve Michael) ve bir şirket düğümümüz (prismaticAI) var. Şimdi bu düğümler arasındaki ilişkilere (kenarlara) bakalım:
Bilgi grafiklerinin güçlü yönlerinden biri, ilgili bilgiyi çıkarmak veya yeni bilgiyi türetmek için varlıklar arasındaki ilişkileri sorgulayabilme ve üzerinde geçiş yapabilme yeteneğidir. Bunu örnek bilgi grafiğimizle nasıl yapabileceğimize bakalım.
Önce, bilgi grafiğinden hangi bilgiyi almak istediğimizi belirlememiz gerekir. Örneğin:
Sorgu 1: Sarah nerede çalışıyor?
Bu sorguyu yanıtlamak için, bilgi grafiğinde uygun başlangıç noktasını bulmamız gerekir. Bu durumda, Sarah’yı temsil eden düğümden başlamak istiyoruz.
Başlangıç noktasından (Sarah’nın düğümü) çıkan "works for" ilişki kenarını takip ederiz. Bu kenar, Sarah’nın düğümünü prismaticAI’yi temsil eden düğüme bağlar. "Works for" ilişkisi üzerinde geçiş yaparak, Sarah’nın prismaticAI için çalıştığı sonucuna varabiliriz.
Cevap 1: Sarah prismaticAI için çalışıyor.
Başka bir sorgu deneyelim:
Sorgu 2: prismaticAI için kimler çalışıyor?
Bu kez, prismaticAI’yi temsil eden düğümden başlamak istiyoruz.
prismaticAI düğümünden, "works for" ilişki kenarlarını geriye doğru takip ederiz. Bu, prismaticAI için çalışan kişileri temsil eden düğümlere götürür. "Works for" ilişkilerini ters yönde izleyerek hem Sarah’nın hem de Michael’ın prismaticAI için çalıştığını belirleyebiliriz.
Cevap 2: Sarah ve Michael prismaticAI için çalışıyor.
Bir örnek daha!
Sorgu 3: Michael, Sarah ile aynı şirkette mi çalışıyor?
Sarah’nın düğümünden veya Michael’ın düğümünden başlayabiliriz. Sarah’nın düğümünden başlayalım.
prismaticAI düğümüne ulaşmak için "works for" ilişkisini takip ederiz.
Ardından, Michael’ın da aynı prismaticAI düğümüne giden bir "works for" ilişkisi olup olmadığını kontrol ederiz. Hem Sarah hem de Michael’ın prismaticAI düğümüyle "works for" ilişkisi olduğundan, aynı şirkette çalıştıkları sonucuna varabiliriz.
Cevap 3: Evet, Michael Sarah ile aynı şirkette (prismaticAI) çalışıyor.
Bilgi grafiğindeki ilişkiler üzerinde geçiş yapmak, belirli bilgi parçalarını çıkarmamıza ve varlıklar arasındaki bağlantıları anlamamıza olanak tanır. Bilgi grafikleri çok daha karmaşık hale gelebilir; çok sayıda düğüm ve ilişki içerebilir ve karmaşık gerçek dünya bilgisini yapılandırılmış ve birbirine bağlı bir şekilde temsil etmeyi mümkün kılar.
RAG uygulamaları, kullanıcı sorgularına veya istemlere ilgili ve tutarlı yanıtlar sağlamak için bilgi getirme ve doğal dil üretimini birleştirir. Bilgi grafikleri, bu uygulamalar için özellikle uygun olmalarını sağlayan çeşitli avantajlar sunar. Başlıca faydalara bakalım:
Önceki bölümde öğrendiğimiz gibi, bilgi grafikleri bilgiyi varlıklar (düğümler) ve bunların ilişkileri (kenarlar) ile yapılandırılmış bir şekilde temsil eder. Bu yapılandırılmış temsil, yapılandırılmamış metin verilerine kıyasla belirli bir sorgu veya görev için ilgili bilgilerin alınmasını kolaylaştırır.
Örnek bilgi grafiğimizde, "works for" ilişkilerini izleyerek prismaticAI için kimin çalıştığını kolayca alabiliriz.
Bilgi grafikleri varlıklar arasındaki ilişkileri yakalayarak bilginin sunulduğu bağlamın daha derinlemesine anlaşılmasını sağlar. Bu bağlamsal anlayış, RAG uygulamalarında tutarlı ve ilgili yanıtlar üretmek için kritik öneme sahiptir.
Örneğimize dönersek, Sarah, Michael ve prismaticAI arasındaki "works for" ilişkisinin anlaşılması, bir RAG uygulamasının onların istihdamına dair daha bağlama uygun yanıtlar vermesini sağlar.
Bir bilgi grafiğindeki ilişkiler üzerinde geçiş yapmak, RAG uygulamalarının açıkça belirtilmemiş olabilecek bilgilerden çıkarımlar yapmasına ve yeni bilgiler türetmesine olanak tanır. Bu çıkarımsal muhakeme yeteneği, üretilen yanıtların kalitesini ve bütünlüğünü artırır.
İlişkiler üzerinde geçiş yaparak, bir RAG uygulaması Sarah ve Michael’ın aynı şirkette çalıştığını, bu bilgi doğrudan belirtilmemiş olsa bile, çıkarabilir.
Bilgi grafikleri, birden fazla kaynaktan bilgiyi entegre edebilir ve RAG uygulamalarının çeşitli ve birbirini tamamlayan bilgi tabanlarını kullanmasına olanak tanır. Bu entegrasyon, daha kapsamlı ve dengeli yanıtlar ortaya çıkarabilir.
Örnek bilgi grafiğimize, farklı kaynaklardan şirketler, çalışanlar ve rolleri hakkında bilgiler ekleyebilir, böylece yanıt üretimi için daha bütünlüklü bir tablo sunabiliriz.
Bilgi grafikleri, yanıtların üretilmesinde kullanılan bilginin şeffaf bir temsilini sağlar. Bu şeffaflık, üretilen çıktının arkasındaki akıl yürütmenin açıklanması için anahtardır; bu da soru-cevap sistemleri gibi birçok uygulamada önemlidir.
Örneğimizdeki 3. cevabın açıklaması şöyle olabilir: Evet, Michael Sarah ile aynı şirket için çalışıyor. Bu sonuca, Sarah’nın prismaticAI için çalıştığını belirleyip ardından Michael’ın da prismaticAI ile bir 'works for' ilişkisine sahip olduğunu doğrulayarak ulaştım. Her ikisinin de aynı şirket varlığıyla bu ilişkiye sahip olması nedeniyle, aynı şirkette çalıştıklarını çıkarabilirim.
Akıl yürütme sürecindeki bu şeffaflık, kullanıcıların ve geliştiricilerin RAG uygulamasının yanıtına nasıl ulaştığını anlamasına olanak tanır; sistemi bir kara kutu gibi görmek yerine. Ayrıca, karar verme süreci açıkça ortaya konduğundan ve bilgi grafiğine göre doğrulanabildiğinden, sisteme duyulan güveni artırır.
Ayrıca, bilgi grafiğinde herhangi bir tutarsızlık veya eksik bilgi varsa, açıklama bu sorunları tespit etmeye ve ele almaya yardımcı olabilir; bu da yanıtların doğruluğunu ve bütünlüğünü artırır.
Bilgi grafikleri sayesinde, RAG uygulamaları daha doğru, açık ve anlaşılır yanıtlar oluşturabilir. Bu da onları doğal dil işleme alanındaki farklı görevler için faydalı kılar.
RAG uygulamaları oluştururken iki farklı yaklaşımla karşılaşabilirsiniz: bilgi grafikleri ve vektör veritabanları. Her ikisi de bilgiyi temsil etmek ve geri getirmek için kullanılsa da, temel veri yapıları ve bilgiyi ele alış biçimleri açısından farklılık gösterir.
Bu iki yaklaşım arasındaki temel farkları inceleyelim:
|
Özellik |
Bilgi Grafikleri |
Vektör Veritabanları |
|
Veri Temsili |
Bir grafik yapısı oluşturan varlıklar (düğümler) ve varlıklar arasındaki ilişkiler (kenarlar). |
Her biri bir bilgi parçasını (ör. belge, cümle) temsil eden yüksek boyutlu vektörler. |
|
Getirme Mekanizmaları |
Grafik yapısı üzerinde geçiş yapmak ve varlıklar arasındaki ilişkileri takip etmek. Çıkarım yapmaya ve yeni bilgi türetmeye imkân tanır. |
Benzerlik metriğine (ör. kosinüs benzerliği) dayalı vektör benzerliği. En benzer vektörleri ve ilişkili bilgileri döndürür. |
|
Yorumlanabilirlik |
İnsana anlaşılır bilgi temsili. Grafik yapısı ve etiketli ilişkiler, varlık bağlantılarını netleştirir. |
Yüksek boyutlu sayısal temsiller nedeniyle insanlar için daha az yorumlanabilir. İlişkileri veya geri getirilen bilginin arkasındaki akıl yürütmeyi doğrudan anlamak zordur. |
|
Bilgi Entegrasyonu |
Varlıkları ve ilişkileri tek bir grafik yapısında temsil ederek entegrasyonu kolaylaştırır. Varlıklar ve ilişkiler doğru eşlenirse sorunsuz entegrasyon sağlanır. |
Daha zorlu. Bilgiyi birleştirmek için vektör uzayı hizalaması veya ansambl yöntemleri gibi teknikler gerektirir. Vektör uyumluluğunu sağlamak önemsiz değildir. |
|
Çıkarımsal Muhakeme |
Grafik yapısı üzerinde geçiş yaparak ve varlıklar arasındaki ilişkilerden yararlanarak çıkarımsal muhakemeyi mümkün kılar. Örtük bağlantıları ortaya çıkarır ve yeni içgörüler türetir. |
Daha sınırlı. Vektör benzerliğine dayanır ve örtük ilişkileri veya çıkarımları kaçırabilir. Benzer bilgileri belirleyebilir, ancak bilgi grafiklerindeki karmaşık ilişkileri yakalayamayabilir. |
Hem bilgi grafikleri hem de vektör veritabanlarının güçlü yanları ve kullanım alanları vardır; aralarındaki seçim, uygulamanızın özel gereksinimlerine bağlıdır. Bilgi grafikleri, yapılandırılmış bilgiyi temsil etme ve üzerinde muhakeme etmede mükemmeldir; vektör veritabanları ise semantik benzerliğe ve vektör temsillerine dayalı bilgi getirme görevleri için uygundur.
Vektör veritabanları hakkında daha fazla bilgiyi makine öğrenimi için vektör veritabanlarına giriş yazısında bulabilirsiniz. Ayrıca, en popüler beş vektör veritabanına da bakın.
Bu bölümde, bir RAG uygulaması için dil üretim sürecini güçlendirmek üzere bir bilgi grafiğini nasıl uygulayacağımızı inceleyeceğiz.
Aşağıdaki temel adımları ele alacağız:
Bu bölümün sonunda, RAG uygulamalarında bilgi grafikleri uygulamaya dair sağlam bir anlayışa sahip olacak ve daha akıllı, bağlamın farkında dil üretim sistemleri kurabileceksiniz.
Başlamadan önce, aşağıdakilerin yüklü olduğundan emin olun:
pip install langchain)pip install llama-index)İlk adım, bilgi grafiğini çıkaracağımız metin verilerini yüklemek ve ön işlemektir. Bu örnekte, prismaticAI adlı bir teknoloji şirketini, çalışanlarını ve rollerini anlatan bir metin parçası kullanacağız.
from langchain.document_loaders import TextLoader
from langchain.text_splitter import CharacterTextSplitter

# Load text data
text = """Sarah is an employee at prismaticAI, a leading technology company based in Westside Valley. She has been working there for the past three years as a software engineer.
Michael is also an employee at prismaticAI, where he works as a data scientist. He joined the company two years ago after completing his graduate studies.
prismaticAI is a well-known technology company that specializes in developing cutting-edge software solutions and artificial intelligence applications. The company has a diverse workforce of talented individuals from various backgrounds.
Both Sarah and Michael are highly skilled professionals who contribute significantly to prismaticAI's success. They work closely with their respective teams to develop innovative products and services that meet the evolving needs of the company's clients."""

loader = TextLoader(text)
documents = loader.load()
text_splitter = CharacterTextSplitter(chunk_size=200, chunk_overlap=20)
texts = text_splitter.split_documents(documents)
LangChain’den gerekli sınıfları içe aktararak başlıyoruz: TextLoader ve CharacterTextSplitter. TextLoader, metin verilerini yükler; CharacterTextSplitter ise daha verimli işleme için metni daha küçük parçalara böler.
Ardından, metin verilerini çok satırlı bir dize değişkeni olan text olarak tanımlarız.
Sonra, TextLoader kullanarak metin verilerini doğrudan bu değişkenden yükleriz. loader.load() yöntemi, her biri metnin bir parçasını içeren Document nesnelerinden oluşan bir liste döndürür.
Metni daha küçük ve yönetilebilir parçalara bölmek için, chunk_size değeri 200 karakter ve chunk_overlap değeri 20 karakter olan bir CharacterTextSplitter örneği oluştururuz. chunk_overlap parametresi, komşu parçalar arasında bir miktar örtüşme olmasını sağlar; bu da bilgi çıkarımı sırasında bağlamın korunmasına yardımcı olabilir.
Son olarak, CharacterTextSplitter’ın split_documents yöntemini kullanarak Document nesnelerini daha küçük parçalara böleriz; bu parçalar texts değişkeninde bir Document listesi olarak saklanır.
Metin verilerini bu şekilde ön işlemek, bir sonraki adımda bir dil modeli başlatıp metin parçalarından bir bilgi grafiği çıkarabilmemiz için veriyi hazırlar.
Metin verilerini yükleyip ön işledikten sonra, bir dil modeli başlatıp metin parçalarından bir bilgi grafiği çıkarmak bir sonraki adımdır. Bu örnekte, LangChain’in sağladığı OpenAI dil modelini kullanacağız.
from langchain.llms import OpenAI
from langchain.transformers import LLMGraphTransformer
import getpass
import os

# Load environment variable for OpenAI API key
os.environ["OPENAI_API_KEY"] = getpass.getpass()

# Initialize LLM
llm = OpenAI(temperature=0)

# Extract Knowledge Graph
llm_transformer = LLMGraphTransformer(llm=llm)
graph_documents = llm_transformer.convert_to_graph_documents(texts)
Önce, LangChain’den gerekli sınıfları içe aktarırız: OpenAI ve LLMGraphTransformer. OpenAI, bilgi grafiğini çıkarmak için kullanacağımız OpenAI dil modeli için bir sarmalayıcıdır. LLMGraphTransformer ise metin verilerini bilgi grafiği temsiline dönüştürmeye yardımcı olan bir yardımcı sınıftır.
Ardından, OpenAI API anahtarını bir ortam değişkeninden yükleriz. Bu, hassas kimlik bilgilerini kodunuza gömmekten kaçınmak için bir güvenlik en iyi uygulamasıdır.
Daha sonra, OpenAI dil modelinin bir örneğini 0 sıcaklıkla başlatırız. Sıcaklık parametresi, model çıktısının rastgeleliğini kontrol eder; daha düşük değerler daha belirleyici yanıtlar üretir.
Dil modelini başlattıktan sonra, LLMGraphTransformer sınıfının bir örneğini oluşturur ve başlattığımız llm nesnesini ona iletiriz. LLMGraphTransformer sınıfı, metin parçalarını (texts) bir bilgi grafiği temsiline dönüştürür.
Son olarak, LLMGraphTransformer’ın convert_to_graph_documents yöntemini çağırarak metinler listesini iletiriz. Bu yöntem, metin parçalarını analiz etmek ve ilgili varlıkları, ilişkileri ve diğer yapılandırılmış bilgileri çıkarmak için dil modelini kullanır; ardından bunları bir bilgi grafiği olarak temsil eder. Ortaya çıkan bilgi grafiği graph_documents değişkeninde saklanır.
Bir dil modelini başarıyla başlattık ve onu metin verilerinden bir bilgi grafiği çıkarmak için kullandık. Bir sonraki adımda, bilgi grafiğini kalıcılık ve sorgulama için bir veritabanında saklayacağız.
Metin verilerinden bilgi grafiğini çıkardıktan sonra, bunu kalıcı ve sorgulanabilir bir formatta saklamak önemlidir. Bu öğreticide, bilgi grafiğini saklamak için Neo4j kullanacağız.
from langchain.graph_stores import Neo4jGraphStore

# Store Knowledge Graph in Neo4j
graph_store = Neo4jGraphStore(url="neo4j://your_neo4j_url", username="your_username", password="your_password")
graph_store.write_graph(graph_documents)
Önce, LangChain’den Neo4jGraphStore sınıfını içe aktarırız. Bu sınıf, bir Neo4j veritabanıyla etkileşim kurmak ve bilgi grafikleri saklamak için kullanışlı bir arayüz sunar.
Ardından, gerekli bağlantı ayrıntılarını (Neo4j veritabanı URL’si, kullanıcı adı ve parola) sağlayarak bir Neo4jGraphStore örneği oluştururuz. "your_neo4j_url", "your_username" ve "your_password" değerlerini kendi Neo4j örneğinize uygun değerlerle değiştirdiğinizden emin olun.
Son olarak, graph_store örneğinin write_graph yöntemini çağırır ve önceki adımda elde edilen graph_documents listesini iletiriz. Bu yöntem, bilgi grafiğini serileştirir ve Neo4j veritabanına yazar.
Bilgi grafiğini bir Neo4j veritabanında saklamak, onun kalıcı olmasını ve gerektiğinde kolayca sorgulanıp geri getirilebilmesini sağlar. Neo4j’in grafik yapısı, bilgi grafiğinde yer alan karmaşık ilişkilerin ve varlıkların verimli şekilde temsil edilmesine ve üzerinde geçiş yapılmasına olanak tanır.
Bir sonraki adımda, grafikten bilgi getirmek ve getirilen bağlamı kullanarak yanıt üretmek için bileşenleri kuracağız.
Bu öğreticide grafik veritabanı olarak Neo4j kullansak da, LangChain Amazon Neptune ve Gremlin Server gibi TinkerPop uyumlu veritabanları dahil olmak üzere diğer grafik veritabanlarını da destekler. Seçtiğiniz veritabanına uygun grafik depo uygulamasını kullanmak üzere Neo4jGraphStore’u değiştirebilirsiniz.
Artık bilgi grafiğini bir veritabanında sakladığımıza göre, kullanıcı sorgularına göre grafikten ilgili bilgiyi getirmek ve getirilen bağlamı kullanarak yanıtlar üretmek için bileşenleri ayarlayabiliriz. Bu, bir RAG uygulamasının çekirdek işlevselliğidir.
from llama_index.core.query_engine import RetrieverQueryEngine
from llama_index.core.retrievers import KnowledgeGraphRAGRetriever
from llama_index.core.response_synthesis import ResponseSynthesizer

# Retrieve Knowledge for RAG
graph_rag_retriever = KnowledgeGraphRAGRetriever(storage_context=graph_store.storage_context, verbose=True)
query_engine = RetrieverQueryEngine.from_args(graph_rag_retriever)
Önce, LlamaIndex’ten gerekli sınıfları içe aktarırız: RetrieverQueryEngine, KnowledgeGraphRAGRetriever ve ResponseSynthesizer.
RetrieverQueryEngine, bir veri kaynağından (bizim durumumuzda bilgi grafiği) ilgili bağlamı getirmek için bir getirici kullanan ve ardından bu bağlamı kullanarak bir yanıt sentezleyen bir sorgu motorudur.
KnowledgeGraphRAGRetriever, bir veritabanında saklanan bir bilgi grafiğinden ilgili bilgileri getirebilen uzmanlaşmış bir getiricidir.
ResponseSynthesizer, getirilen bağlamı bir dil modeliyle birleştirerek nihai bir yanıt üretmekten sorumludur.
Sonra, graph_store örneğimizin storage_context değerini ileterek bir KnowledgeGraphRAGRetriever örneği oluştururuz. Bu storage_context, bilgi grafiğini sakladığımız Neo4j veritabanına bağlanmak ve onu sorgulamak için gerekli bilgileri içerir. Getirme sürecinde ayrıntılı günlük kaydı için verbose=True olarak ayarlarız.
Ardından, from_args yöntemini kullanarak ve graph_rag_retriever örneğimizi ileterek bir RetrieverQueryEngine başlatırız. Bu sorgu motoru, bilgi grafiğinden ilgili bağlamı getirme ve bu bağlama dayalı bir yanıt üretme sürecinin tamamını yönetecektir.
Bu bileşenleri kurduğumuza göre, artık bilgi grafiğini sorgulamaya ve getirilen bağlamı kullanarak yanıtlar üretmeye hazırız. Bir sonraki adımda bunun pratikte nasıl yapılacağını göreceğiz.
Son olarak, bilgi grafiğini sorgulayabilir ve getirilen bağlamı kullanarak yanıtlar üretebiliriz.
def query_and_synthesize(query):
    retrieved_context = query_engine.query(query)
    response = response_synthesizer.synthesize(query, retrieved_context)
    print(f"Query: {query}")
    print(f"Answer: {response}\n")

# Initialize the ResponseSynthesizer instance
response_synthesizer = ResponseSynthesizer(llm)

# Query 1
query_and_synthesize("Where does Sarah work?")

# Query 2
query_and_synthesize("Who works for prismaticAI?")

# Query 3
query_and_synthesize("Does Michael work for the same company as Sarah?")
Bu örnekte, metin verilerinde anlatılan çalışanlar ve şirketle ilgili üç farklı sorgu tanımlarız. Her sorgu için, query_engine’i kullanarak bilgi grafiğinden ilgili bağlamı getirir, bir ResponseSynthesizer örneği oluşturur ve synthesize yöntemini sorgu ve getirilen bağlamla çağırırız.
ResponseSynthesizer, dil modelini ve getirilen bağlamı kullanarak sorguya nihai bir yanıt üretir; bu yanıt, bu makalenin ilk bölümündeki cevaplarla eşleşecek şekilde konsola yazdırılır.
Öğretici, nispeten basit metinlerle RAG uygulamaları için bir bilgi grafiği kullanımını gösterse de, gerçek dünya senaryoları genellikle daha karmaşık ve çeşitli veri setlerini içerir. Ayrıca, girdi verileri düz metnin ötesinde çeşitli dosya biçimlerinde gelebilir. Bu bölümde, bilgi grafiği tabanlı RAG uygulamasının bu tür senaryoları ele alacak şekilde nasıl genişletilebileceğini inceleyeceğiz.
Girdi verilerinin boyutu ve karmaşıklığı arttıkça, bilgi grafiği çıkarım süreci daha zor hale gelebilir. Büyük ve çeşitli veri setlerini ele almak için bazı stratejiler şunlardır:
Gerçek dünyada, veriler PDF’ler, Word belgeleri, elektronik tablolar veya JSON ya da XML gibi yapılandırılmış veri biçimleri olarak gelebilir. Bu farklı dosya türlerini ele almak için aşağıdaki stratejileri kullanabilirsiniz:
load yöntemini geçersiz kılarak kendi yükleyicinizi uygulayabilirsiniz.Bu stratejiler, bilgi grafiği tabanlı RAG uygulamasını daha karmaşık ve çeşitli veri setlerini ve daha geniş bir dosya türü yelpazesini ele alacak şekilde genişletmenize yardımcı olacaktır.
Girdi verilerinin karmaşıklığı arttıkça, doğru ve güvenilir sonuçlar sağlamak için bilgi grafiği çıkarım sürecinin daha fazla alana özgü özelleştirme ve ayar gerektirebileceğini unutmamak önemlidir.
Gerçek dünyada RAG uygulamaları için bilgi grafikleri kurmak, çeşitli zorlukları olan karmaşık bir görev olabilir. Bunlardan bazılarını inceleyelim:
Yüksek kaliteli bir bilgi grafiği oluşturmak, önemli ölçüde alan uzmanlığı ve çaba gerektiren karmaşık ve zaman alıcı bir süreçtir. Çeşitli veri kaynaklarından varlıkları, ilişkileri ve olguları çıkarmak ve bunları tutarlı bir bilgi grafiğinde entegre etmek, özellikle büyük ve çeşitli veri setleri için zorlayıcı olabilir. Bu, alanı anlamayı, ilgili bilgiyi tanımlamayı ve ilişkileri ve anlamsal yapıyı doğru şekilde yakalayacak bir biçimde yapılandırmayı içerir.
RAG uygulamaları genellikle her biri kendi yapısı, biçimi ve anlamsal özellikleri olan birden çok heterojen kaynaktan veri entegre etmeyi gerektirir. Veri tutarlılığını sağlamak, çakışmaları çözmek ve farklı veri kaynaklarındaki varlıkları ve ilişkileri eşlemek önemsiz değildir. Bilgi grafiğinin çeşitli kaynaklardaki bilgiyi doğru temsil etmesini sağlamak için dikkatli veri temizleme, dönüştürme ve eşleme gerekir.
Bilgi grafikleri statik değildir. Yeni bilgiler ortaya çıktıkça veya mevcut bilgiler değiştikçe sürekli güncellenmeleri ve bakımlarının yapılması gerekir. Bilgi grafiğini güncel tutmak ve gelişen veri kaynaklarıyla tutarlı olmasını sağlamak kaynak yoğun bir süreç olabilir. Bu, veri kaynaklarındaki değişiklikleri izlemeyi, ilgili güncellemeleri belirlemeyi ve bu güncellemeleri, bütünlüğü ve tutarlılığı koruyarak bilgi grafiğine aktarmayı içerir.
Bilgi grafiği boyut ve karmaşıklık bakımından büyüdükçe, grafik verilerinin verimli şekilde saklanması, geri getirilmesi ve sorgulanması giderek daha zor hale gelir. Özellikle yüksek sorgu hacmine sahip büyük ölçekli RAG uygulamalarında ölçeklenebilirlik ve performans sorunları ortaya çıkabilir. Kabul edilebilir performans seviyelerini korumak için bilgi grafiğinin depolanması, indekslenmesi ve sorgu işleme tekniklerinin optimize edilmesi kritik hale gelir.
Bilgi grafikleri, karmaşık ilişkileri temsil etme ve çok adımlı muhakemeyi mümkün kılmada başarılı olsa da, bu yeteneklerden yararlanan karmaşık sorguları formüle etmek ve yürütmek zor olabilir. Verimli sorgu işleme ve muhakeme algoritmaları geliştirmek, aktif bir araştırma alanıdır. Bilgi grafiği sisteminin sorgu dili ve muhakeme yeteneklerini anlamak, onun tam potansiyelinden etkin şekilde yararlanmak için önemlidir.
Bilgi grafikleri için temsil ve sorgulama konusunda yaygın olarak benimsenmiş standartların eksikliği, birlikte çalışabilirlik sorunlarına ve satıcıya bağımlılığa yol açabilir. Farklı bilgi grafiği sistemleri farklı veri modelleri, sorgu dilleri ve API’ler kullanabilir; bu da aralarında geçiş yapmayı veya diğer sistemlerle entegrasyonu zorlaştırabilir. Standartları benimsemek veya geliştirmek, birlikte çalışabilirliği kolaylaştırabilir ve satıcıya bağımlılığı azaltabilir.
Bilgi grafikleri açıklanabilir ve şeffaf muhakeme sağlayabilse de, özellikle karmaşık sorgular veya muhakeme yolları için akıl yürütme sürecinin son kullanıcılarca kolayca yorumlanabilir ve anlaşılır olmasını sağlamak zor olabilir. Akıl yürütme sürecini ve onun altında yatan varsayımları açıkça ileten kullanıcı dostu arayüzler ve açıklamalar geliştirmek, kullanıcı güveni ve benimsenmesi için önemlidir.
Alana ve uygulamaya bağlı olarak, alanla ilgili terminoloji, ontolojiler veya veri biçimleriyle başa çıkmak gibi ek zorluklar olabilir. Örneğin tıp alanında, karmaşık tıbbi terminolojiler, kodlama sistemleri ve mahremiyet kaygılarıyla uğraşmak, bilgi grafiği kurulumuna ve kullanımına ilave karmaşıklık katmanları ekleyebilir.
Bu zorluklara rağmen, bilgi grafikleri RAG uygulamaları için özellikle yapılandırılmış bilgiyi temsil etme, karmaşık muhakemeyi mümkün kılma ve açıklanabilir, şeffaf sonuçlar üretme açısından önemli avantajlar sunar. Bu zorlukların, dikkatli bilgi grafiği tasarımı, veri entegrasyon stratejileri ve verimli sorgu işleme teknikleriyle ele alınması, bilgi grafiği tabanlı RAG uygulamalarını başarıyla hayata geçirmek için kritik öneme sahiptir.
Bu öğreticide, daha doğru, bilgilendirici ve bağlamsal olarak ilgili yanıtlar üretmek için bilgi grafiklerinin gücünü inceledik. Bilgi grafiklerinin temel kavramlarını ve RAG uygulamalarındaki rollerini anlayarak başladık. Ardından, metin verilerinden bir bilgi grafiği çıkarıp bunu bir Neo4j veritabanında sakladığımız ve kullanıcı sorguları için ilgili bağlamı almak üzere kullandığımız uygulamalı bir örneği adım adım ele aldık. Son olarak, getirilen bağlamı kullanarak grafikteki yapılandırılmış bilgiyle nasıl yanıtlar üretebileceğimizi gösterdik.
AI ve LLM’ler hakkında daha fazla bilgi edinmek isterseniz, AI Fundamentals adlı altı derslik beceri yoluna göz atın.
Umarım bu öğreticiyi faydalı ve keyifli bulmuşsunuzdur; bir sonrakinde görüşmek üzere.
İyi kodlamalar!
AI ve LLM’ler hakkında daha fazlasını öğrenin!
Program
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




