Lộ trình
Cơ bản về Kinh doanh Trí tuệ Nhân tạo
12 giờ
Bạn có bao giờ thắc mắc vì sao các trợ lý số như Alexa hay Google Assistant có thể đưa ra câu trả lời chính xác đến vậy không?
Bí quyết đằng sau là Retrieval-Augmented Generation (RAG), kết hợp truy xuất thông tin với kỹ thuật sinh ngôn ngữ. Nhân tố chủ chốt trong quy trình này là knowledge graph, giúp các trợ lý truy cập vào một kho tri thức có cấu trúc khổng lồ để cải thiện chất lượng phản hồi.
Trong hướng dẫn này, chúng ta sẽ khám phá knowledge graph và cách sử dụng chúng để xây dựng các ứng dụng RAG cho câu trả lời chính xác và phù hợp hơn.
Chúng ta sẽ bắt đầu bằng việc phân tích các khái niệm cơ bản của knowledge graph và vai trò của chúng trong RAG. Sau đó so sánh với cơ sở dữ liệu vector và tìm hiểu khi nào nên dùng loại nào. Tiếp theo, chúng ta sẽ thực hành tạo một knowledge graph từ dữ liệu văn bản, lưu trữ nó trong cơ sở dữ liệu và dùng nó để tìm thông tin liên quan cho truy vấn của người dùng. Chúng ta cũng sẽ xem cách mở rộng phương pháp này để xử lý nhiều loại dữ liệu và định dạng tệp vượt ra ngoài văn bản thuần.
Nếu bạn muốn tìm hiểu thêm về RAG, hãy xem bài viết về retrieval augmented generation.
Knowledge graph biểu diễn thông tin theo định dạng có cấu trúc và liên kết. Chúng gồm các thực thể (nút) và các mối quan hệ (cạnh) giữa các thực thể đó. Thực thể có thể đại diện cho các đối tượng, khái niệm hay ý tưởng trong thế giới thực, trong khi mối quan hệ mô tả cách các thực thể được kết nối.
Trực giác đằng sau knowledge graph là mô phỏng cách con người hiểu và suy luận về thế giới. Chúng ta không lưu trữ thông tin trong các ngăn tách biệt; thay vào đó, ta kết nối các mảnh thông tin, tạo thành một mạng lưới tri thức phong phú và đan xen.
Knowledge graph giúp ta thấy các thực thể liên kết với nhau như thế nào bằng cách thể hiện rõ các mối quan hệ giữa chúng. Khám phá các kết nối này cho phép ta tìm ra thông tin mới và rút ra kết luận mà nếu chỉ nhìn rời rạc từng mảnh thì khó có thể có được.
Hãy xem một ví dụ.
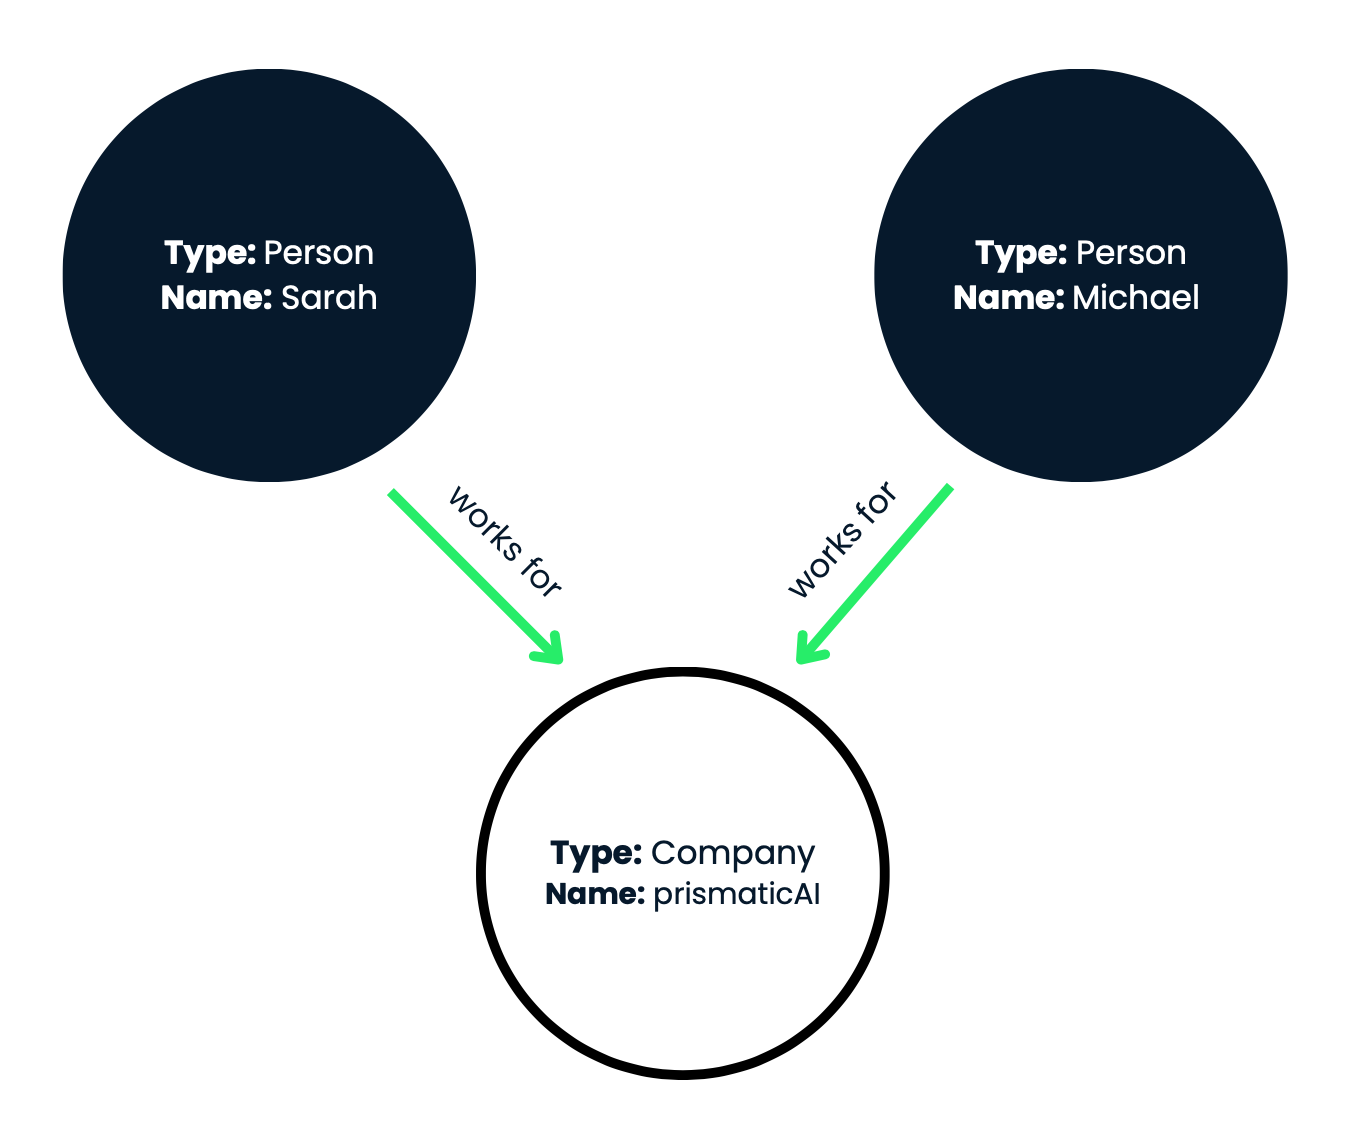
Hình 1: Trong biểu diễn trực quan này, các nút là các vòng tròn, còn các mối quan hệ là các mũi tên có nhãn nối giữa các nút.
Knowledge graph này nắm bắt hiệu quả mối quan hệ việc làm giữa hai cá nhân Sarah và Michael với công ty prismaticAI. Trong ví dụ, chúng ta có ba nút:
Tóm lại, ta có hai nút người (Sarah và Michael) và một nút công ty (prismaticAI). Giờ, hãy xem các mối quan hệ (cạnh) giữa các nút này:
Một khía cạnh mạnh mẽ của knowledge graph là khả năng truy vấn và duyệt qua các mối quan hệ giữa các thực thể để trích xuất thông tin liên quan hoặc suy ra tri thức mới. Hãy xem cách thực hiện với knowledge graph ví dụ của chúng ta.
Trước hết, ta cần xác định thông tin muốn truy xuất từ knowledge graph. Ví dụ:
Truy vấn 1: Sarah làm việc ở đâu?
Để trả lời, ta cần tìm điểm bắt đầu phù hợp trong knowledge graph. Ở đây, ta muốn bắt đầu từ nút đại diện cho Sarah.
Từ điểm bắt đầu (nút của Sarah), ta lần theo cạnh quan hệ "làm việc cho" hướng ra ngoài. Cạnh này nối nút của Sarah với nút đại diện cho prismaticAI. Bằng cách duyệt mối quan hệ "làm việc cho", ta kết luận Sarah làm việc cho prismaticAI.
Trả lời 1: Sarah làm việc cho prismaticAI.
Thử một truy vấn khác:
Truy vấn 2: Ai làm việc cho prismaticAI?
Lần này, ta muốn bắt đầu từ nút đại diện cho prismaticAI.
Từ nút prismaticAI, ta lần theo các cạnh quan hệ "làm việc cho" theo hướng ngược lại. Điều này sẽ dẫn đến các nút đại diện cho những người làm việc cho prismaticAI. Khi duyệt ngược các quan hệ "làm việc cho", ta xác định được cả Sarah và Michael đều làm việc cho prismaticAI.
Trả lời 2: Sarah và Michael làm việc cho prismaticAI.
Thêm một ví dụ nữa!
Truy vấn 3: Michael có làm việc cho cùng công ty với Sarah không?
Ta có thể bắt đầu từ nút của Sarah hoặc của Michael. Hãy bắt đầu từ nút của Sarah.
Ta lần theo quan hệ "làm việc cho" để đến nút prismaticAI.
Sau đó, ta kiểm tra xem Michael cũng có quan hệ "làm việc cho" dẫn đến cùng nút prismaticAI hay không. Vì cả Sarah và Michael đều có quan hệ "làm việc cho" với nút prismaticAI, ta có thể kết luận họ làm việc cho cùng một công ty.
Trả lời 3: Có, Michael làm việc cho cùng công ty với Sarah (prismaticAI).
Duyệt các mối quan hệ trong knowledge graph cho phép chúng ta trích xuất thông tin cụ thể và hiểu các kết nối giữa các thực thể. Knowledge graph có thể phức tạp hơn nhiều, với vô số nút và mối quan hệ, cho phép biểu diễn tri thức thế giới thực phong phú theo cách có cấu trúc và liên kết.
Ứng dụng RAG kết hợp truy xuất thông tin và sinh ngôn ngữ tự nhiên để cung cấp phản hồi phù hợp và mạch lạc cho truy vấn hay gợi ý của người dùng. Knowledge graph có nhiều ưu điểm khiến chúng đặc biệt phù hợp cho các ứng dụng này. Hãy cùng điểm qua các lợi ích chính:
Như đã thấy ở phần trước, knowledge graph biểu diễn thông tin theo cách có cấu trúc, với các thực thể (nút) và mối quan hệ (cạnh). Cách biểu diễn này giúp dễ dàng truy xuất thông tin liên quan cho một truy vấn hoặc tác vụ nhất định, so với dữ liệu văn bản phi cấu trúc.
Trong knowledge graph ví dụ, ta có thể dễ dàng lấy thông tin về những ai làm việc cho prismaticAI bằng cách lần theo các quan hệ "làm việc cho".
Knowledge graph nắm bắt các mối quan hệ giữa thực thể, cho phép hiểu sâu hơn về ngữ cảnh mà thông tin được trình bày. Sự hiểu biết theo ngữ cảnh này rất quan trọng để tạo ra phản hồi mạch lạc và phù hợp trong các ứng dụng RAG.
Quay lại ví dụ, hiểu quan hệ "làm việc cho" giữa Sarah, Michael và prismaticAI sẽ giúp ứng dụng RAG đưa ra các phản hồi liên quan hơn về tình trạng việc làm của họ.
Duyệt các mối quan hệ trong knowledge graph cho phép ứng dụng RAG suy luận và rút ra tri thức mới có thể không được nêu rõ ràng. Khả năng suy luận này cải thiện chất lượng và độ đầy đủ của phản hồi được tạo.
Bằng cách duyệt các mối quan hệ, ứng dụng RAG có thể suy ra rằng Sarah và Michael làm việc cho cùng một công ty, ngay cả khi thông tin này không được nêu trực tiếp.
Knowledge graph có thể tích hợp thông tin từ nhiều nguồn, cho phép ứng dụng RAG sử dụng các kho tri thức đa dạng và bổ trợ lẫn nhau. Sự tích hợp này có thể dẫn đến phản hồi toàn diện và cân bằng hơn.
Ta có thể thêm thông tin về công ty, nhân viên và vai trò của họ từ nhiều nguồn vào knowledge graph ví dụ, cung cấp bức tranh đầy đủ hơn để tạo phản hồi.
Knowledge graph cung cấp cách biểu diễn minh bạch về tri thức được dùng để tạo phản hồi. Tính minh bạch này là chìa khóa để giải thích lập luận đằng sau đầu ra, điều quan trọng trong nhiều ứng dụng như hệ thống hỏi đáp.
Lời giải thích cho câu trả lời 3 trong ví dụ của chúng ta có thể là: Có, Michael làm việc cho cùng công ty với Sarah. Tôi đi đến kết luận này bằng cách xác định Sarah làm việc cho prismaticAI rồi xác minh rằng Michael cũng có quan hệ 'làm việc cho' với prismaticAI. Vì cả hai đều có quan hệ này với cùng một thực thể công ty, tôi suy ra họ làm việc cho cùng công ty.
Sự minh bạch trong quá trình suy luận giúp người dùng và nhà phát triển hiểu ứng dụng RAG đưa ra phản hồi như thế nào thay vì coi nó như một hộp đen. Nó cũng tăng niềm tin vào hệ thống, vì quy trình ra quyết định được trình bày rõ ràng và có thể kiểm chứng với knowledge graph.
Ngoài ra, nếu có bất kỳ điểm không nhất quán hoặc thiếu thông tin trong knowledge graph, phần giải thích có thể giúp xác định và khắc phục, từ đó cải thiện độ chính xác và đầy đủ của phản hồi.
Nhờ knowledge graph, các ứng dụng RAG có thể tạo ra phản hồi chính xác, rõ ràng và dễ hiểu hơn. Điều này khiến chúng hữu dụng cho nhiều tác vụ trong xử lý ngôn ngữ tự nhiên.
Khi xây dựng ứng dụng RAG, bạn có thể gặp hai cách tiếp cận: knowledge graph và cơ sở dữ liệu vector. Dù cả hai đều được dùng để biểu diễn và truy xuất thông tin, chúng khác nhau ở cấu trúc dữ liệu nền tảng và cách xử lý thông tin.
Hãy xem những khác biệt chính giữa hai cách tiếp cận này:
|
Tính năng |
Knowledge Graph |
Cơ sở dữ liệu Vector |
|
Biểu diễn dữ liệu |
Thực thể (nút) và mối quan hệ (cạnh) giữa các thực thể, tạo thành cấu trúc đồ thị. |
Vector không gian chiều cao, mỗi vector đại diện cho một mẩu thông tin (ví dụ: tài liệu, câu). |
|
Cơ chế truy xuất |
Duyệt cấu trúc đồ thị và lần theo các mối quan hệ giữa thực thể. Cho phép suy luận và rút ra tri thức mới. |
Tương đồng vector dựa trên một thước đo tương đồng (ví dụ: cosine). Trả về các vector tương tự nhất và thông tin liên quan. |
|
Khả năng diễn giải |
Biểu diễn tri thức có thể diễn giải bởi con người. Cấu trúc đồ thị và mối quan hệ có nhãn làm rõ các kết nối giữa thực thể. |
Ít dễ diễn giải hơn do biểu diễn số chiều cao. Khó hiểu trực tiếp các mối quan hệ hoặc lập luận đằng sau thông tin được truy xuất. |
|
Tích hợp tri thức |
Tạo điều kiện tích hợp bằng cách biểu diễn thực thể và mối quan hệ trong một đồ thị thống nhất. Tích hợp trơn tru nếu ánh xạ thực thể và mối quan hệ chính xác. |
Khó hơn. Cần các kỹ thuật như căn chỉnh không gian vector hoặc phương pháp tổ hợp để kết hợp thông tin. Đảm bảo tính tương thích của vector không đơn giản. |
|
Suy luận |
Cho phép suy luận bằng cách duyệt cấu trúc đồ thị và tận dụng các mối quan hệ giữa thực thể. Khai mở các kết nối ngầm và rút ra hiểu biết mới. |
Hạn chế hơn. Dựa trên tương đồng vector và có thể bỏ sót các mối quan hệ ngầm hoặc suy luận. Có thể nhận diện thông tin tương tự nhưng không phải các mối quan hệ phức tạp như trong knowledge graph. |
Cả knowledge graph và cơ sở dữ liệu vector đều có điểm mạnh và tình huống sử dụng riêng, và lựa chọn giữa chúng phụ thuộc vào yêu cầu cụ thể của ứng dụng. Knowledge graph vượt trội trong việc biểu diễn và suy luận trên tri thức có cấu trúc, trong khi cơ sở dữ liệu vector phù hợp cho các tác vụ dựa nhiều vào ngữ nghĩa và truy xuất thông tin dựa trên biểu diễn vector.
Bạn có thể tìm hiểu thêm về cơ sở dữ liệu vector trong giới thiệu về cơ sở dữ liệu vector cho machine learning. Ngoài ra, xem thêm năm cơ sở dữ liệu vector phổ biến nhất.
Trong phần này, chúng ta sẽ tìm hiểu cách triển khai knowledge graph để bổ trợ quy trình sinh ngôn ngữ cho ứng dụng RAG.
Chúng ta sẽ thực hiện các bước sau:
Kết thúc phần này, bạn sẽ nắm vững cách triển khai knowledge graph trong ứng dụng RAG, cho phép xây dựng hệ thống sinh ngôn ngữ thông minh và nhận biết ngữ cảnh hơn.
Trước khi bắt đầu, hãy đảm bảo bạn đã cài đặt:
pip install langchain)pip install llama-index)Bước đầu tiên là nạp và tiền xử lý dữ liệu văn bản từ đó chúng ta sẽ trích xuất knowledge graph. Trong ví dụ này, ta dùng một đoạn văn bản mô tả một công ty công nghệ tên prismaticAI, các nhân viên và vai trò của họ.
from langchain.document_loaders import TextLoader
from langchain.text_splitter import CharacterTextSplitter

# Load text data
text = """Sarah is an employee at prismaticAI, a leading technology company based in Westside Valley. She has been working there for the past three years as a software engineer.
Michael is also an employee at prismaticAI, where he works as a data scientist. He joined the company two years ago after completing his graduate studies.
prismaticAI is a well-known technology company that specializes in developing cutting-edge software solutions and artificial intelligence applications. The company has a diverse workforce of talented individuals from various backgrounds.
Both Sarah and Michael are highly skilled professionals who contribute significantly to prismaticAI's success. They work closely with their respective teams to develop innovative products and services that meet the evolving needs of the company's clients."""

loader = TextLoader(text)
documents = loader.load()
text_splitter = CharacterTextSplitter(chunk_size=200, chunk_overlap=20)
texts = text_splitter.split_documents(documents)
Chúng ta bắt đầu bằng cách nhập các lớp cần thiết từ LangChain: TextLoader và CharacterTextSplitter. TextLoader nạp dữ liệu văn bản, trong khi CharacterTextSplitter chia văn bản thành các đoạn nhỏ hơn để xử lý hiệu quả hơn.
Tiếp theo, ta định nghĩa dữ liệu văn bản dưới dạng biến chuỗi nhiều dòng text.
Sau đó, ta dùng TextLoader để nạp dữ liệu văn bản trực tiếp từ biến text. Phương thức loader.load() trả về danh sách các đối tượng Document, mỗi đối tượng chứa một đoạn văn bản.
Để chia văn bản thành các đoạn nhỏ, dễ xử lý hơn, ta tạo một thể hiện của CharacterTextSplitter với chunk_size là 200 ký tự và chunk_overlap là 20 ký tự. Tham số chunk_overlap đảm bảo có một phần chồng lấn giữa các đoạn kề nhau, giúp duy trì ngữ cảnh trong quá trình trích xuất tri thức.
Cuối cùng, ta dùng phương thức split_documents của CharacterTextSplitter để chia các đối tượng Document thành các đoạn nhỏ hơn và lưu vào biến texts dưới dạng danh sách các Document.
Tiền xử lý dữ liệu văn bản theo cách này giúp chuẩn bị cho bước tiếp theo, nơi chúng ta sẽ khởi tạo mô hình ngôn ngữ và dùng nó để trích xuất knowledge graph từ các đoạn văn bản.
Sau khi nạp và tiền xử lý dữ liệu văn bản, bước tiếp theo là khởi tạo một mô hình ngôn ngữ và dùng nó để trích xuất knowledge graph từ các đoạn văn bản. Trong ví dụ này, ta sẽ sử dụng mô hình ngôn ngữ OpenAI do LangChain cung cấp.
from langchain.llms import OpenAI
from langchain.transformers import LLMGraphTransformer
import getpass
import os

# Load environment variable for OpenAI API key
os.environ["OPENAI_API_KEY"] = getpass.getpass()

# Initialize LLM
llm = OpenAI(temperature=0)

# Extract Knowledge Graph
llm_transformer = LLMGraphTransformer(llm=llm)
graph_documents = llm_transformer.convert_to_graph_documents(texts)
Đầu tiên, ta nhập các lớp cần thiết từ LangChain: OpenAI và LLMGraphTransformer. OpenAI là lớp bao cho mô hình ngôn ngữ OpenAI, được dùng để trích xuất knowledge graph. LLMGraphTransformer là lớp tiện ích giúp chuyển đổi dữ liệu văn bản sang biểu diễn knowledge graph.
Tiếp theo, ta nạp khóa API OpenAI từ biến môi trường. Đây là thực hành bảo mật tốt để tránh ghi cứng thông tin nhạy cảm trong mã nguồn.
Sau đó, ta khởi tạo một thể hiện của mô hình ngôn ngữ OpenAI với nhiệt độ 0. Tham số nhiệt độ kiểm soát độ ngẫu nhiên của đầu ra, giá trị thấp cho phản hồi mang tính quyết định hơn.
Sau khi khởi tạo mô hình ngôn ngữ, ta tạo một thể hiện LLMGraphTransformer và truyền đối tượng llm đã khởi tạo vào. Lớp LLMGraphTransformer sẽ chuyển đổi các đoạn văn bản (texts) thành biểu diễn knowledge graph.
Cuối cùng, ta gọi phương thức convert_to_graph_documents của LLMGraphTransformer, truyền vào danh sách texts. Phương thức này dùng mô hình ngôn ngữ để phân tích các đoạn văn và trích xuất các thực thể, mối quan hệ và thông tin có cấu trúc liên quan, rồi biểu diễn thành một knowledge graph. Knowledge graph thu được được lưu trong biến graph_documents.
Chúng ta đã khởi tạo mô hình ngôn ngữ và dùng nó để trích xuất knowledge graph từ dữ liệu văn bản. Ở bước tiếp theo, ta sẽ lưu knowledge graph vào cơ sở dữ liệu để bền vững và truy vấn.
Sau khi trích xuất knowledge graph từ dữ liệu văn bản, điều quan trọng là lưu nó theo định dạng bền vững và có thể truy vấn. Trong hướng dẫn này, ta sẽ dùng Neo4j để lưu trữ knowledge graph.
from langchain.graph_stores import Neo4jGraphStore

# Store Knowledge Graph in Neo4j
graph_store = Neo4jGraphStore(url="neo4j://your_neo4j_url", username="your_username", password="your_password")
graph_store.write_graph(graph_documents)
Trước tiên, ta nhập lớp Neo4jGraphStore từ LangChain. Lớp này cung cấp giao diện thuận tiện để tương tác với cơ sở dữ liệu Neo4j và lưu trữ knowledge graph.
Tiếp theo, ta tạo một thể hiện Neo4jGraphStore bằng cách cung cấp thông tin kết nối cần thiết: URL cơ sở dữ liệu Neo4j, tên người dùng và mật khẩu. Hãy thay "your_neo4j_url", "your_username" và "your_password" bằng thông tin phù hợp cho phiên bản Neo4j của bạn.
Cuối cùng, ta gọi phương thức write_graph của thể hiện graph_store, truyền vào danh sách graph_documents thu được từ bước trước. Phương thức này tuần tự hóa knowledge graph và ghi nó vào cơ sở dữ liệu Neo4j.
Lưu knowledge graph trong cơ sở dữ liệu Neo4j giúp đảm bảo tính bền vững và dễ dàng truy vấn, truy xuất khi cần. Cấu trúc đồ thị của Neo4j cho phép biểu diễn và duyệt hiệu quả các mối quan hệ và thực thể phức tạp trong knowledge graph.
Ở bước tiếp theo, ta sẽ thiết lập các thành phần để truy xuất tri thức từ đồ thị và tạo phản hồi dựa trên ngữ cảnh truy xuất được.
Lưu ý rằng dù hướng dẫn này dùng Neo4j làm cơ sở dữ liệu đồ thị, LangChain cũng hỗ trợ các cơ sở dữ liệu khác, như Amazon Neptune và các cơ sở tương thích TinkerPop như Gremlin Server. Bạn có thể thay Neo4jGraphStore bằng triển khai phù hợp với cơ sở dữ liệu đã chọn.
Giờ đây khi đã lưu knowledge graph vào cơ sở dữ liệu, ta có thể thiết lập các thành phần để truy xuất tri thức liên quan từ đồ thị dựa trên truy vấn của người dùng và tạo phản hồi bằng ngữ cảnh đó. Đây là chức năng cốt lõi của một ứng dụng RAG.
from llama_index.core.query_engine import RetrieverQueryEngine
from llama_index.core.retrievers import KnowledgeGraphRAGRetriever
from llama_index.core.response_synthesis import ResponseSynthesizer

# Retrieve Knowledge for RAG
graph_rag_retriever = KnowledgeGraphRAGRetriever(storage_context=graph_store.storage_context, verbose=True)
query_engine = RetrieverQueryEngine.from_args(graph_rag_retriever)
Đầu tiên, ta nhập các lớp cần thiết từ LlamaIndex: RetrieverQueryEngine, KnowledgeGraphRAGRetriever và ResponseSynthesizer.
RetrieverQueryEngine là một công cụ truy vấn sử dụng retriever để lấy ngữ cảnh liên quan từ nguồn dữ liệu (trong trường hợp này là knowledge graph) rồi tổng hợp phản hồi dựa trên ngữ cảnh đó.
KnowledgeGraphRAGRetriever là retriever chuyên biệt có thể truy xuất thông tin liên quan từ knowledge graph lưu trong cơ sở dữ liệu.
ResponseSynthesizer chịu trách nhiệm tạo phản hồi cuối cùng bằng cách kết hợp ngữ cảnh truy xuất với mô hình ngôn ngữ.
Tiếp theo, ta tạo một thể hiện KnowledgeGraphRAGRetriever bằng cách truyền vào storage_context từ thể hiện graph_store. storage_context chứa thông tin cần thiết để kết nối và truy vấn cơ sở dữ liệu Neo4j nơi ta đã lưu knowledge graph. Ta cũng đặt verbose=True để bật ghi log chi tiết trong quá trình truy xuất.
Sau đó, ta khởi tạo RetrieverQueryEngine bằng phương thức from_args và truyền vào thể hiện graph_rag_retriever. Công cụ truy vấn này sẽ xử lý toàn bộ quy trình truy xuất ngữ cảnh liên quan từ knowledge graph và tạo phản hồi dựa trên ngữ cảnh đó.
Với các thành phần này, ta đã sẵn sàng truy vấn knowledge graph và tạo phản hồi dựa trên ngữ cảnh truy xuất. Ở bước tiếp theo, chúng ta sẽ thực hành điều này.
Cuối cùng, ta có thể truy vấn knowledge graph và tạo phản hồi dựa trên ngữ cảnh truy xuất được.
def query_and_synthesize(query):
    retrieved_context = query_engine.query(query)
    response = response_synthesizer.synthesize(query, retrieved_context)
    print(f"Query: {query}")
    print(f"Answer: {response}\n")

# Initialize the ResponseSynthesizer instance
response_synthesizer = ResponseSynthesizer(llm)

# Query 1
query_and_synthesize("Where does Sarah work?")

# Query 2
query_and_synthesize("Who works for prismaticAI?")

# Query 3
query_and_synthesize("Does Michael work for the same company as Sarah?")
Trong ví dụ này, ta định nghĩa ba truy vấn khác nhau liên quan đến các nhân viên và công ty được mô tả trong dữ liệu văn bản. Với mỗi truy vấn, ta dùng query_engine để truy xuất ngữ cảnh liên quan từ knowledge graph, tạo một thể hiện ResponseSynthesizer và gọi phương thức synthesize của nó với truy vấn và ngữ cảnh truy xuất.
ResponseSynthesizer sử dụng mô hình ngôn ngữ và ngữ cảnh truy xuất để tạo phản hồi cuối cùng cho truy vấn, rồi in ra console, khớp với các câu trả lời ở phần đầu bài viết.
Mặc dù hướng dẫn minh họa việc dùng knowledge graph cho ứng dụng RAG với văn bản tương đối đơn giản, các kịch bản thực tế thường liên quan đến tập dữ liệu phức tạp và đa dạng hơn. Ngoài ra, dữ liệu đầu vào có thể ở nhiều định dạng tệp khác ngoài văn bản thuần. Trong phần này, ta sẽ tìm hiểu cách mở rộng ứng dụng RAG dựa trên knowledge graph để xử lý các kịch bản như vậy.
Khi kích thước và độ phức tạp của dữ liệu đầu vào tăng lên, quy trình trích xuất knowledge graph có thể trở nên thách thức hơn. Dưới đây là một số chiến lược để xử lý tập dữ liệu lớn và đa dạng:
Trong thực tế, dữ liệu có thể đến từ nhiều định dạng tệp như PDF, tài liệu Word, bảng tính, hoặc thậm chí các định dạng dữ liệu có cấu trúc như JSON hay XML. Để xử lý các loại tệp này, bạn có thể dùng các chiến lược sau:
Những chiến lược này sẽ giúp bạn mở rộng ứng dụng RAG dựa trên knowledge graph để xử lý các tập dữ liệu phức tạp và đa dạng hơn, cũng như nhiều loại tệp hơn.
Lưu ý rằng khi độ phức tạp của dữ liệu đầu vào tăng lên, quy trình trích xuất knowledge graph có thể cần nhiều tùy biến và tinh chỉnh theo miền để đảm bảo kết quả chính xác và tin cậy.
Thiết lập knowledge graph cho các ứng dụng RAG trong thực tế có thể là một nhiệm vụ phức tạp với nhiều thách thức. Hãy cùng xem một vài điều trong số đó:
Xây dựng một knowledge graph chất lượng cao là quá trình phức tạp và tốn thời gian, đòi hỏi nhiều chuyên môn miền và nỗ lực. Việc trích xuất thực thể, mối quan hệ và sự kiện từ nhiều nguồn dữ liệu và tích hợp chúng vào một knowledge graph mạch lạc có thể rất thách thức, đặc biệt với các tập dữ liệu lớn và đa dạng. Nó bao gồm việc hiểu miền, xác định thông tin liên quan và cấu trúc hóa sao cho phản ánh chính xác các mối quan hệ và ngữ nghĩa.
Các ứng dụng RAG thường cần tích hợp dữ liệu từ nhiều nguồn dị biệt, mỗi nguồn có cấu trúc, định dạng và ngữ nghĩa riêng. Đảm bảo tính nhất quán dữ liệu, giải quyết xung đột và ánh xạ thực thể, mối quan hệ giữa các nguồn là điều không hề đơn giản. Cần làm sạch, chuyển đổi và ánh xạ dữ liệu cẩn trọng để knowledge graph phản ánh chính xác thông tin từ nhiều nguồn.
Knowledge graph không tĩnh. Chúng cần được liên tục cập nhật và bảo trì khi có thông tin mới hoặc thông tin hiện có thay đổi. Giữ cho knowledge graph luôn cập nhật và nhất quán với các nguồn dữ liệu đang tiến hóa có thể tốn nhiều nguồn lực. Công việc này bao gồm giám sát các thay đổi ở nguồn, xác định cập nhật liên quan và truyền các cập nhật đó vào knowledge graph trong khi vẫn duy trì tính toàn vẹn và nhất quán.
Khi knowledge graph phát triển về kích thước và độ phức tạp, đảm bảo lưu trữ, truy xuất và truy vấn hiệu quả trở nên ngày càng thách thức. Các vấn đề về khả năng mở rộng và hiệu năng có thể phát sinh, đặc biệt với các ứng dụng RAG quy mô lớn có lưu lượng truy vấn cao. Tối ưu hóa lưu trữ, lập chỉ mục và kỹ thuật xử lý truy vấn cho knowledge graph trở nên tối quan trọng để duy trì mức hiệu năng chấp nhận được.
Dù knowledge graph xuất sắc trong việc biểu diễn các mối quan hệ phức tạp và cho phép suy luận nhiều bước, việc xây dựng và thực thi các truy vấn phức tạp tận dụng được những khả năng này có thể khó khăn. Phát triển các thuật toán xử lý truy vấn và suy luận hiệu quả vẫn là lĩnh vực nghiên cứu sôi động. Hiểu ngôn ngữ truy vấn và khả năng suy luận của hệ thống knowledge graph là quan trọng để khai thác hết tiềm năng của nó.
Hiện thiếu các tiêu chuẩn được chấp nhận rộng rãi cho việc biểu diễn và truy vấn knowledge graph, có thể dẫn đến vấn đề liên vận và bị khóa chặt nhà cung cấp. Các hệ thống knowledge graph khác nhau có thể dùng mô hình dữ liệu, ngôn ngữ truy vấn và API khác nhau, khiến việc chuyển đổi hoặc tích hợp với hệ thống khác trở nên khó khăn. Việc áp dụng hoặc phát triển tiêu chuẩn có thể thúc đẩy liên vận và giảm rủi ro khóa chặt nhà cung cấp.
Dù knowledge graph có thể mang lại suy luận có thể giải thích và minh bạch, việc đảm bảo quy trình suy luận dễ diễn giải và dễ hiểu với người dùng cuối có thể là thách thức, đặc biệt với các truy vấn hoặc đường suy luận phức tạp. Phát triển giao diện và lời giải thích thân thiện, truyền đạt rõ ràng quy trình suy luận và các giả định nền tảng là quan trọng để xây dựng niềm tin và thúc đẩy chấp nhận.
Tùy theo lĩnh vực và ứng dụng, có thể phát sinh các thách thức riêng, như xử lý thuật ngữ chuyên ngành, ontology hoặc định dạng dữ liệu đặc thù. Ví dụ, trong lĩnh vực y tế, xử lý thuật ngữ y khoa phức tạp, hệ thống mã hóa và vấn đề riêng tư có thể làm tăng độ phức tạp cho việc thiết lập và sử dụng knowledge graph.
Bất chấp các thách thức, knowledge graph mang lại lợi thế lớn cho ứng dụng RAG, đặc biệt trong việc biểu diễn tri thức có cấu trúc, cho phép suy luận phức tạp và cung cấp kết quả có thể giải thích, minh bạch. Giải quyết các thách thức thông qua thiết kế knowledge graph cẩn trọng, chiến lược tích hợp dữ liệu và kỹ thuật xử lý truy vấn hiệu quả là yếu tố then chốt để triển khai thành công ứng dụng RAG dựa trên knowledge graph.
Trong hướng dẫn này, chúng ta đã khám phá sức mạnh của knowledge graph để tạo ra các phản hồi chính xác, nhiều thông tin và phù hợp với ngữ cảnh hơn. Chúng ta bắt đầu bằng việc hiểu các khái niệm nền tảng của knowledge graph và vai trò của chúng trong ứng dụng RAG. Sau đó, ta đi qua ví dụ thực hành: trích xuất knowledge graph từ dữ liệu văn bản, lưu vào cơ sở dữ liệu Neo4j và dùng nó để truy xuất ngữ cảnh liên quan cho truy vấn của người dùng. Cuối cùng, chúng ta minh họa cách sử dụng ngữ cảnh truy xuất để tạo phản hồi dựa trên tri thức có cấu trúc trong đồ thị.
Nếu bạn muốn tìm hiểu thêm về AI và LLM, hãy xem lộ trình kỹ năng gồm sáu khóa học về AI Fundamentals.
Hy vọng bạn thấy hướng dẫn này hữu ích và thú vị, hẹn gặp lại bạn trong bài tiếp theo.
Chúc bạn mã hóa vui vẻ!
Tìm hiểu thêm về AI và LLM!
Lộ trình
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
