Programma
Nozioni di base sull'intelligenza artificiale nel mondo degli affari
12 ore
Ti sei mai chiesto come assistenti digitali come Alexa o Google Assistant riescono a darti risposte così accurate?
La magia dietro a tutto questo si chiama Retrieval-Augmented Generation (RAG), che combina il recupero delle informazioni con tecniche di generazione del linguaggio. Un elemento chiave in questo processo è il knowledge graph, che aiuta questi assistenti ad accedere a un enorme bacino di informazioni strutturate per migliorare le loro risposte.
In questo tutorial esploreremo i knowledge graph e come possono essere utilizzati per costruire applicazioni RAG in grado di fornire risposte più accurate e pertinenti.
Partiremo dalle basi dei knowledge graph e del loro ruolo nel RAG. Li confronteremo con i database vettoriali e vedremo quando conviene usare l’uno o l’altro. Poi passeremo alla pratica: creeremo un knowledge graph a partire da dati testuali, lo salveremo in un database e lo useremo per trovare informazioni rilevanti in risposta alle domande degli utenti. Vedremo anche come estendere questo approccio per gestire diversi tipi di dati e formati di file, non solo testo semplice.
Se vuoi saperne di più sul RAG, dai un’occhiata a questo articolo sulla retrieval augmented generation.
I knowledge graph rappresentano le informazioni in un formato strutturato e interconnesso. Sono composti da entità (nodi) e relazioni (archi) tra tali entità. Le entità possono rappresentare oggetti, concetti o idee del mondo reale, mentre le relazioni descrivono come queste entità sono collegate.
L’intuizione alla base dei knowledge graph è imitare il modo in cui gli esseri umani comprendono e ragionano sul mondo. Non memorizziamo informazioni in silos isolati; invece, creiamo collegamenti tra pezzi di informazione diversi, formando una ricca rete di conoscenza interconnessa.
I knowledge graph ci aiutano a vedere come le entità sono connesse, mostrando chiaramente le relazioni tra di esse. Esplorando questi collegamenti possiamo trovare nuove informazioni e trarre conclusioni che sarebbe difficile ricavare da informazioni separate.
Vediamo un esempio.
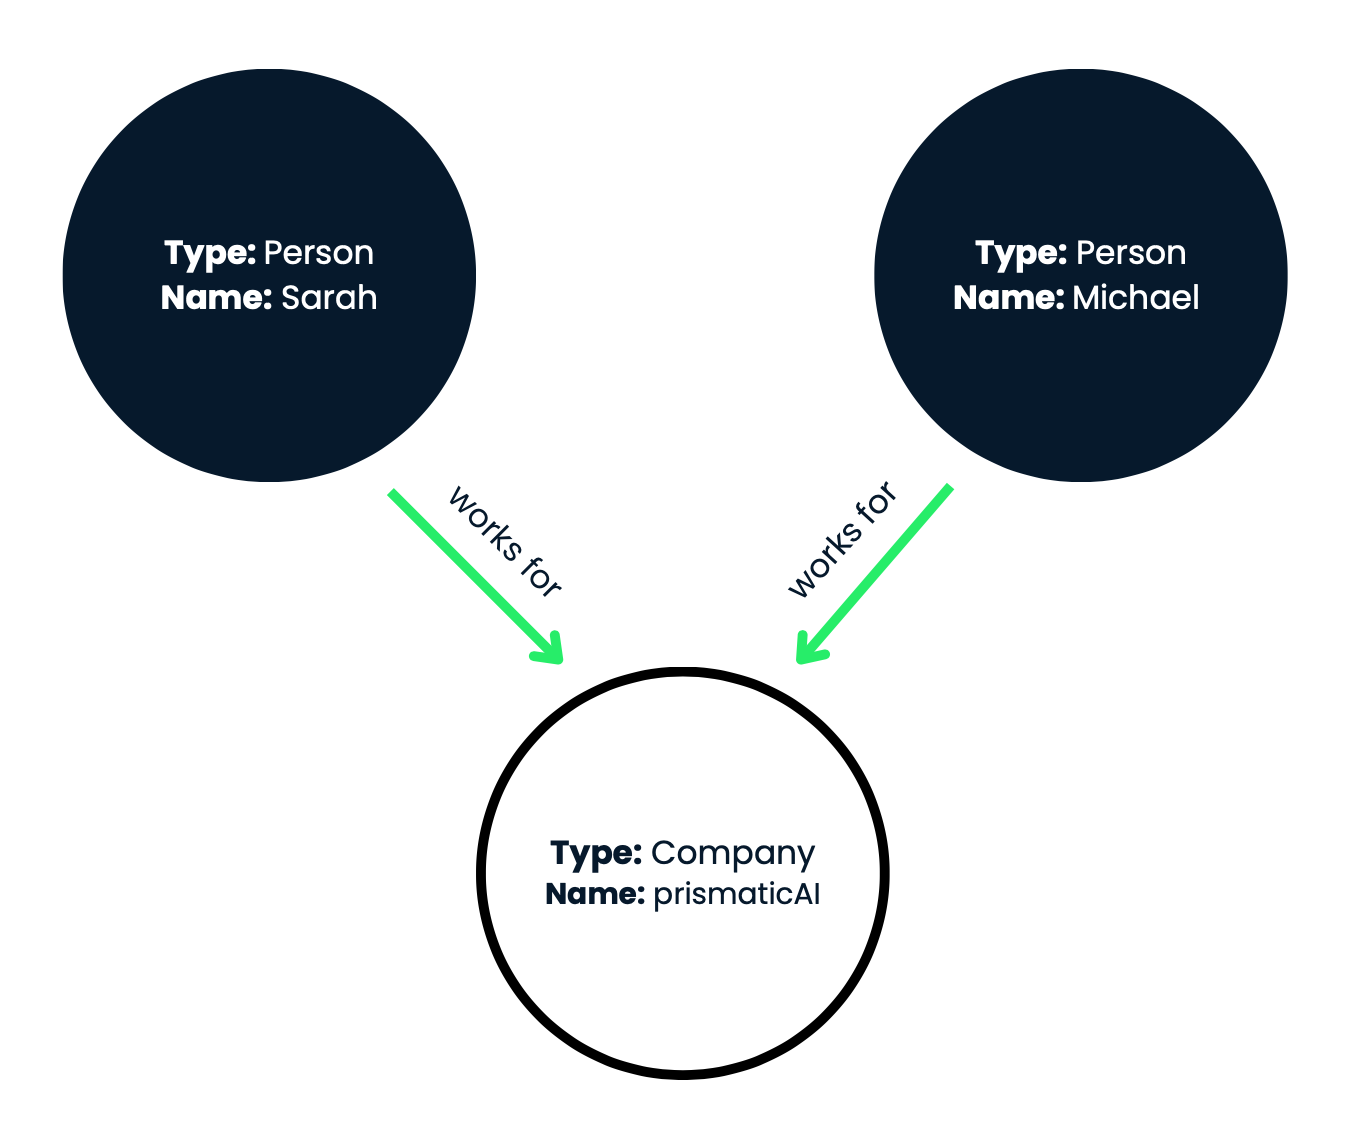
Figura 1: In questa rappresentazione visiva, i nodi sono cerchi e le relazioni sono frecce etichettate che collegano i nodi.
Questo knowledge graph cattura in modo efficace le relazioni di impiego tra le persone Sarah e Michael e l’azienda prismaticAI. Nel nostro esempio abbiamo tre nodi:
In sintesi, abbiamo due nodi persona (Sarah e Michael) e un nodo azienda (prismaticAI). Ora vediamo le relazioni (archi) tra questi nodi:
Uno degli aspetti più potenti dei knowledge graph è la possibilità di interrogarli e attraversare le relazioni tra le entità per estrarre informazioni rilevanti o inferire nuova conoscenza. Vediamo come farlo con il nostro esempio.
Per prima cosa, dobbiamo stabilire quali informazioni vogliamo recuperare dal knowledge graph. Per esempio:
Query 1: Dove lavora Sarah?
Per rispondere alla query, dobbiamo trovare il punto di partenza nel knowledge graph. In questo caso partiamo dal nodo che rappresenta Sarah.
Dal punto di partenza (il nodo di Sarah), seguiamo l’arco uscente della relazione "lavora per". Questo arco collega il nodo di Sarah al nodo che rappresenta prismaticAI. Attraversando la relazione "lavora per", possiamo concludere che Sarah lavora per prismaticAI.
Risposta 1: Sarah lavora per prismaticAI.
Proviamo un’altra query:
Query 2: Chi lavora per prismaticAI?
Questa volta vogliamo partire dal nodo che rappresenta prismaticAI.
Dal nodo prismaticAI, seguiamo all’indietro gli archi della relazione "lavora per". Questo ci porterà ai nodi che rappresentano le persone che lavorano per prismaticAI. Attraversando al contrario le relazioni "lavora per", possiamo identificare che sia Sarah sia Michael lavorano per prismaticAI.
Risposta 2: Sarah e Michael lavorano per prismaticAI.
Un altro esempio!
Query 3: Michael lavora per la stessa azienda di Sarah?
Possiamo partire dal nodo di Sarah o da quello di Michael. Partiamo dal nodo di Sarah.
Seguiamo la relazione "lavora per" per arrivare al nodo prismaticAI.
Poi verifichiamo se anche Michael ha una relazione "lavora per" che porta allo stesso nodo prismaticAI. Poiché sia Sarah sia Michael hanno una relazione "lavora per" con il nodo prismaticAI, possiamo concludere che lavorano per la stessa azienda.
Risposta 3: Sì, Michael lavora per la stessa azienda di Sarah (prismaticAI).
Attraversare le relazioni nel knowledge graph ci permette di estrarre informazioni specifiche e comprendere le connessioni tra le entità. I knowledge graph possono diventare molto più complessi, con numerosi nodi e relazioni, consentendo di rappresentare conoscenze reali articolate in modo strutturato e interconnesso.
Le applicazioni RAG combinano recupero delle informazioni e generazione del linguaggio naturale per fornire risposte pertinenti e coerenti a domande o prompt degli utenti. I knowledge graph offrono diversi vantaggi che li rendono particolarmente adatti a queste applicazioni. Ecco i benefici principali:
Come visto nella sezione precedente, i knowledge graph rappresentano le informazioni in modo strutturato, con entità (nodi) e loro relazioni (archi). Questa rappresentazione facilita il recupero di informazioni rilevanti per una determinata query o attività, rispetto ai dati testuali non strutturati.
Nel nostro esempio, possiamo recuperare facilmente chi lavora per prismaticAI seguendo le relazioni "lavora per".
I knowledge graph catturano le relazioni tra le entità, consentendo una comprensione più profonda del contesto in cui l’informazione è presentata. Questa comprensione contestuale è cruciale per generare risposte coerenti e pertinenti nelle applicazioni RAG.
Tornando all’esempio, comprendere la relazione "lavora per" tra Sarah, Michael e prismaticAI permetterebbe a un’applicazione RAG di fornire risposte più rilevanti sul loro impiego.
Attraversare le relazioni in un knowledge graph consente alle applicazioni RAG di fare inferenze e ricavare nuova conoscenza non esplicitata. Questa capacità di ragionamento inferenziale migliora qualità e completezza delle risposte generate.
Attraversando le relazioni, un’applicazione RAG può inferire che Sarah e Michael lavorano per la stessa azienda, anche se ciò non è affermato direttamente.
I knowledge graph possono integrare informazioni da più fonti, consentendo alle applicazioni RAG di usare basi di conoscenza diverse e complementari. Questa integrazione può portare a risposte più complete ed equilibrate.
Nel nostro esempio, potremmo aggiungere al knowledge graph informazioni su aziende, dipendenti e ruoli provenienti da varie fonti, offrendo un quadro più completo per generare risposte.
I knowledge graph forniscono una rappresentazione trasparente della conoscenza usata per generare risposte. Questa trasparenza è fondamentale per spiegare il ragionamento alla base dell’output, importante in molte applicazioni, come i sistemi di question answering.
La spiegazione della risposta 3 nel nostro esempio potrebbe essere: Sì, Michael lavora per la stessa azienda di Sarah. Sono arrivato a questa conclusione identificando che Sarah lavora per prismaticAI e verificando poi che anche Michael ha una relazione "lavora per" con prismaticAI. Poiché entrambi hanno questa relazione con la stessa entità aziendale, posso inferire che lavorano per la stessa azienda.
Questa trasparenza nel processo di ragionamento consente a utenti e sviluppatori di capire come l’applicazione RAG è arrivata alla risposta, invece di considerarla una scatola nera. Aumenta anche la fiducia nel sistema, perché il processo decisionale è esposto chiaramente e può essere verificato sul knowledge graph.
Inoltre, se nel knowledge graph ci sono incoerenze o informazioni mancanti, la spiegazione può aiutare a identificarle e risolverle, migliorando l’accuratezza e la completezza delle risposte.
Usando i knowledge graph, le applicazioni RAG possono creare risposte più accurate, chiare e comprensibili. Questo le rende utili per diversi compiti di elaborazione del linguaggio naturale.
Quando crei applicazioni RAG, potresti imbatterti in due approcci diversi: knowledge graph e database vettoriali. Sebbene entrambi vengano usati per rappresentare e recuperare informazioni, differiscono nelle strutture dati sottostanti e nel modo in cui gestiscono le informazioni.
Ecco le differenze principali tra i due approcci:
|
Caratteristica |
Knowledge graph |
Database vettoriali |
|
Rappresentazione dei dati |
Entità (nodi) e relazioni (archi) tra entità, formando una struttura a grafo. |
Vettori ad alta dimensionalità, ciascuno rappresenta un’informazione (ad es., documento, frase). |
|
Meccanismi di recupero |
Attraversamento della struttura a grafo seguendo le relazioni tra le entità. Consente inferenze e derivazione di nuova conoscenza. |
Similarità tra vettori basata su una metrica (ad es., similarità coseno). Restituisce i vettori più simili e le informazioni associate. |
|
Interpretabilità |
Rappresentazione della conoscenza interpretabile per gli esseri umani. Struttura a grafo e relazioni etichettate chiariscono le connessioni tra entità. |
Meno interpretabili per gli esseri umani a causa di rappresentazioni numeriche ad alta dimensionalità. Difficile comprendere direttamente relazioni o ragionamento dietro le informazioni recuperate. |
|
Integrazione della conoscenza |
Facilita l’integrazione rappresentando entità e relazioni in un grafo unificato. Integrazione fluida se entità e relazioni sono mappate correttamente. |
Più complessa. Richiede tecniche come allineamento degli spazi vettoriali o metodi ensemble per combinare le informazioni. Garantire la compatibilità tra vettori può non essere banale. |
|
Ragionamento inferenziale |
Abilita il ragionamento inferenziale attraversando il grafo e sfruttando le relazioni tra le entità. Scopre connessioni implicite e ricava nuove insight. |
Più limitato. Si basa sulla similarità tra vettori e può non cogliere relazioni o inferenze implicite. Sa identificare informazioni simili ma non relazioni complesse come nei knowledge graph. |
Sia i knowledge graph sia i database vettoriali hanno punti di forza e casi d’uso, e la scelta dipende dai requisiti specifici della tua applicazione. I knowledge graph eccellono nella rappresentazione e nel ragionamento su conoscenza strutturata, mentre i database vettoriali sono adatti a compiti che dipendono fortemente dalla similarità semantica e dal recupero basato su rappresentazioni vettoriali.
Puoi saperne di più sui database vettoriali con questa introduzione ai database vettoriali per il machine learning. Inoltre, consulta le cinque soluzioni di database vettoriali più popolari.
In questa sezione vedremo come implementare un knowledge graph per potenziare il processo di generazione del linguaggio in un’applicazione RAG.
Copriràmo i seguenti passaggi chiave:
Alla fine di questa sezione avrai una solida comprensione dell’implementazione dei knowledge graph nelle applicazioni RAG, per costruire sistemi di generazione del linguaggio più intelligenti e consapevoli del contesto.
Prima di iniziare, assicurati di avere installato:
pip install langchain)pip install llama-index)Il primo passo è caricare e preprocessare i dati testuali da cui estrarremo il knowledge graph. In questo esempio useremo un brano che descrive un’azienda tecnologica chiamata prismaticAI, i suoi dipendenti e i loro ruoli.
from langchain.document_loaders import TextLoader
from langchain.text_splitter import CharacterTextSplitter

# Load text data
text = """Sarah is an employee at prismaticAI, a leading technology company based in Westside Valley. She has been working there for the past three years as a software engineer.
Michael is also an employee at prismaticAI, where he works as a data scientist. He joined the company two years ago after completing his graduate studies.
prismaticAI is a well-known technology company that specializes in developing cutting-edge software solutions and artificial intelligence applications. The company has a diverse workforce of talented individuals from various backgrounds.
Both Sarah and Michael are highly skilled professionals who contribute significantly to prismaticAI's success. They work closely with their respective teams to develop innovative products and services that meet the evolving needs of the company's clients."""

loader = TextLoader(text)
documents = loader.load()
text_splitter = CharacterTextSplitter(chunk_size=200, chunk_overlap=20)
texts = text_splitter.split_documents(documents)
Iniziamo importando le classi necessarie da LangChain: TextLoader e CharacterTextSplitter. TextLoader carica i dati testuali, mentre CharacterTextSplitter suddivide il testo in porzioni più piccole per un’elaborazione più efficiente.
Poi definiamo i dati testuali come stringa multilinea nella variabile text.
Usiamo quindi TextLoader per caricare i dati direttamente dalla variabile di testo. Il metodo loader.load() restituisce un elenco di oggetti Document, ognuno contenente un frammento di testo.
Per dividere il testo in porzioni più gestibili, creiamo un’istanza di CharacterTextSplitter con chunk_size pari a 200 caratteri e chunk_overlap pari a 20 caratteri. Il parametro chunk_overlap assicura una sovrapposizione tra porzioni adiacenti, utile per mantenere il contesto durante l’estrazione della conoscenza.
Infine usiamo il metodo split_documents di CharacterTextSplitter per suddividere gli oggetti Document in pezzi più piccoli, memorizzati nella variabile texts come elenco di Document.
Questo preprocessing ci permette di preparare i dati per il passo successivo, in cui inizializzeremo un modello linguistico e lo useremo per estrarre un knowledge graph dai frammenti di testo.
Dopo aver caricato e preprocessato i dati, il passo successivo è inizializzare un modello linguistico e usarlo per estrarre un knowledge graph dai frammenti. In questo esempio useremo il modello OpenAI fornito da LangChain.
from langchain.llms import OpenAI
from langchain.transformers import LLMGraphTransformer
import getpass
import os

# Load environment variable for OpenAI API key
os.environ["OPENAI_API_KEY"] = getpass.getpass()

# Initialize LLM
llm = OpenAI(temperature=0)

# Extract Knowledge Graph
llm_transformer = LLMGraphTransformer(llm=llm)
graph_documents = llm_transformer.convert_to_graph_documents(texts)
Per prima cosa importiamo le classi necessarie da LangChain: OpenAI e LLMGraphTransformer. OpenAI è un wrapper del modello linguistico OpenAI, che useremo per estrarre il knowledge graph. LLMGraphTransformer è una classe di utilità che aiuta a convertire dati testuali in una rappresentazione a knowledge graph.
Poi carichiamo la chiave API di OpenAI da una variabile d’ambiente. È una buona pratica di sicurezza per evitare di inserire credenziali sensibili direttamente nel codice.
Inizializziamo quindi un’istanza del modello linguistico OpenAI con temperatura 0. Il parametro di temperatura controlla la casualità dell’output del modello: valori più bassi producono risposte più deterministiche.
Dopo aver inizializzato il modello, creiamo un’istanza di LLMGraphTransformer passando l’oggetto llm inizializzato. La classe LLMGraphTransformer converte i frammenti di testo (texts) in una rappresentazione a knowledge graph.
Infine chiamiamo il metodo convert_to_graph_documents di LLMGraphTransformer passando la lista texts. Questo metodo usa il modello linguistico per analizzare i frammenti e estrarre entità, relazioni e altre informazioni strutturate, rappresentandole come knowledge graph. Il grafo risultante è memorizzato nella variabile graph_documents.
Abbiamo inizializzato con successo un modello linguistico e lo abbiamo usato per estrarre un knowledge graph dai dati testuali. Nel prossimo passo lo salveremo in un database per persistenza e interrogazione.
Dopo aver estratto il knowledge graph, è importante archiviarlo in un formato persistente e interrogabile. In questo tutorial useremo Neo4j per archiviare il knowledge graph.
from langchain.graph_stores import Neo4jGraphStore

# Store Knowledge Graph in Neo4j
graph_store = Neo4jGraphStore(url="neo4j://your_neo4j_url", username="your_username", password="your_password")
graph_store.write_graph(graph_documents)
Per prima cosa importiamo la classe Neo4jGraphStore da LangChain. Questa classe fornisce un’interfaccia comoda per interagire con un database Neo4j e archiviare knowledge graph.
Poi creiamo un’istanza di Neo4jGraphStore fornendo i dettagli di connessione necessari: URL del database Neo4j, nome utente e password. Assicurati di sostituire "your_neo4j_url", "your_username" e "your_password" con i valori corretti per la tua istanza Neo4j.
Infine chiamiamo il metodo write_graph dell’istanza graph_store, passando la lista graph_documents ottenuta nel passo precedente. Questo metodo serializza il knowledge graph e lo scrive nel database Neo4j.
Archiviare il knowledge graph in Neo4j ci consente di garantirne la persistenza e di interrogarlo e recuperarlo facilmente quando serve. La struttura a grafo di Neo4j permette una rappresentazione e un attraversamento efficienti delle relazioni ed entità complesse presenti nel knowledge graph.
Nel passo successivo configureremo i componenti per recuperare conoscenza dal grafo e generare risposte usando il contesto recuperato.
È importante notare che, sebbene questo tutorial usi Neo4j, LangChain supporta anche altri database a grafo, come Amazon Neptune e database compatibili con TinkerPop come Gremlin Server. Puoi sostituire Neo4jGraphStore con l’implementazione adatta al database che scegli.
Ora che abbiamo archiviato il knowledge graph in un database, possiamo configurare i componenti per recuperare conoscenza rilevante dal grafo in base alle query degli utenti e generare risposte usando il contesto recuperato. Questa è la funzionalità centrale di un’applicazione RAG.
from llama_index.core.query_engine import RetrieverQueryEngine
from llama_index.core.retrievers import KnowledgeGraphRAGRetriever
from llama_index.core.response_synthesis import ResponseSynthesizer

# Retrieve Knowledge for RAG
graph_rag_retriever = KnowledgeGraphRAGRetriever(storage_context=graph_store.storage_context, verbose=True)
query_engine = RetrieverQueryEngine.from_args(graph_rag_retriever)
Per prima cosa importiamo le classi necessarie da LlamaIndex: RetrieverQueryEngine, KnowledgeGraphRAGRetriever e ResponseSynthesizer.
RetrieverQueryEngine è un motore di query che usa un retriever per ottenere il contesto rilevante da una sorgente dati (nel nostro caso, il knowledge graph) e poi sintetizza una risposta usando quel contesto.
KnowledgeGraphRAGRetriever è un retriever specializzato che può recuperare informazioni pertinenti da un knowledge graph archiviato in un database.
ResponseSynthesizer è responsabile della generazione della risposta finale combinando il contesto recuperato con un modello linguistico.
Quindi creiamo un’istanza di KnowledgeGraphRAGRetriever passando lo storage_context dalla nostra istanza graph_store. Questo storage_context contiene le informazioni necessarie per connettersi e interrogare il database Neo4j in cui abbiamo salvato il knowledge graph. Impostiamo anche verbose=True per abilitare log dettagliati durante il recupero.
Poi inizializziamo un RetrieverQueryEngine usando il metodo from_args e passando la nostra istanza graph_rag_retriever. Questo motore gestirà l’intero processo: recuperare il contesto rilevante dal knowledge graph e generare una risposta basata su quel contesto.
Con questi componenti pronti, siamo ora in grado di interrogare il knowledge graph e generare risposte usando il contesto recuperato. Nel prossimo passo vedremo come farlo in pratica.
Infine, possiamo interrogare il knowledge graph e generare risposte usando il contesto recuperato.
def query_and_synthesize(query):
    retrieved_context = query_engine.query(query)
    response = response_synthesizer.synthesize(query, retrieved_context)
    print(f"Query: {query}")
    print(f"Answer: {response}\n")

# Initialize the ResponseSynthesizer instance
response_synthesizer = ResponseSynthesizer(llm)

# Query 1
query_and_synthesize("Where does Sarah work?")

# Query 2
query_and_synthesize("Who works for prismaticAI?")

# Query 3
query_and_synthesize("Does Michael work for the same company as Sarah?")
In questo esempio definiamo tre query relative ai dipendenti e all’azienda descritti nei dati testuali. Per ciascuna query usiamo il query_engine per recuperare il contesto pertinente dal knowledge graph, creiamo un’istanza di ResponseSynthesizer e chiamiamo il suo metodo synthesize con la query e il contesto recuperato.
ResponseSynthesizer usa il modello linguistico e il contesto recuperato per generare la risposta finale, che viene poi stampata in console, in linea con le risposte mostrate nella prima sezione di questo articolo.
Anche se il tutorial mostra l’uso di un knowledge graph per applicazioni RAG con testo relativamente semplice, gli scenari reali spesso coinvolgono insiemi di dati più complessi e vari. Inoltre, i dati in ingresso possono arrivare in diversi formati oltre al testo semplice. In questa sezione vedremo come estendere l’applicazione RAG basata su knowledge graph per gestire tali scenari.
Con l’aumentare di dimensione e complessità dei dati in ingresso, il processo di estrazione del knowledge graph può diventare più impegnativo. Ecco alcune strategie per gestire insiemi di dati ampi e diversificati:
Nel mondo reale i dati possono arrivare in vari formati: PDF, documenti Word, fogli di calcolo, o persino formati strutturati come JSON o XML. Per gestire questi formati, puoi adottare le seguenti strategie:
Queste strategie ti aiuteranno a estendere l’applicazione RAG basata su knowledge graph per gestire insiemi di dati più complessi e vari, oltre a una gamma più ampia di tipi di file.
È importante notare che, con l’aumentare della complessità dei dati in ingresso, il processo di estrazione del knowledge graph può richiedere una personalizzazione e una calibrazione più specifiche di dominio per garantire risultati accurati e affidabili.
Impostare knowledge graph per applicazioni RAG nel mondo reale può essere un’attività complessa con diverse sfide. Eccone alcune:
Costruire un knowledge graph di alta qualità è un processo complesso e dispendioso in termini di tempo, che richiede notevole competenza di dominio e impegno. Estrarre entità, relazioni e fatti da varie fonti e integrarli in un grafo coerente può essere difficile, specialmente per dataset grandi e diversificati. Comporta comprendere il dominio, identificare le informazioni rilevanti e strutturarle in modo da catturare accuratamente relazioni e semantica.
Le applicazioni RAG spesso devono integrare dati da più fonti eterogenee, ciascuna con la propria struttura, formato e semantica. Garantire coerenza dei dati, risolvere conflitti e mappare entità e relazioni tra diverse fonti non è banale. Richiede un’attenta pulizia, trasformazione e mappatura per assicurare che il knowledge graph rappresenti accuratamente le informazioni provenienti da più fonti.
I knowledge graph non sono statici. Vanno aggiornati e mantenuti continuamente quando emergono nuove informazioni o cambiano quelle esistenti. Mantenere il grafo aggiornato e allineato con fonti in evoluzione può essere impegnativo in termini di risorse. Implica monitorare i cambiamenti nelle fonti, identificare gli aggiornamenti rilevanti e propagarli nel grafo mantenendone integrità e coerenza.
Con la crescita in dimensioni e complessità del grafo, garantire archiviazione, recupero e interrogazione efficienti diventa sempre più difficile. Possono sorgere problemi di scalabilità e prestazioni, soprattutto per applicazioni RAG su larga scala con alti volumi di query. Ottimizzare archiviazione, indicizzazione e tecniche di elaborazione delle query diventa cruciale per mantenere livelli di performance accettabili.
Sebbene i knowledge graph eccellano nel rappresentare relazioni complesse e consentire ragionamento multi-hop, formulare ed eseguire query complesse che sfruttino queste capacità può essere difficile. Sviluppare algoritmi efficienti per l’elaborazione delle query e il ragionamento è un’area di ricerca attiva. Comprendere il linguaggio di query e le capacità di ragionamento del sistema di knowledge graph è importante per sfruttarne appieno il potenziale.
La mancanza di standard ampiamente adottati per rappresentare e interrogare i knowledge graph può causare problemi di interoperabilità e lock-in con i fornitori. Sistemi diversi possono usare modelli dati, linguaggi di query e API differenti, rendendo difficile passare da uno all’altro o integrarsi con altri sistemi. Adottare o sviluppare standard può facilitare l’interoperabilità e ridurre il lock-in.
Pur offrendo ragionamenti spiegabili e trasparenti, garantire che il processo sia facilmente interpretabile e comprensibile per gli utenti finali può essere una sfida, specialmente per query o percorsi di ragionamento complessi. Sviluppare interfacce ed esposizioni user-friendly che comunichino chiaramente il processo di ragionamento e le sue assunzioni è importante per la fiducia e l’adozione da parte degli utenti.
A seconda del dominio e dell’applicazione, possono emergere ulteriori sfide specifiche, come la gestione di terminologia, ontologie o formati dati di dominio. Per esempio, in ambito medico, trattare terminologie cliniche complesse, sistemi di codifica e questioni di privacy aggiunge ulteriori livelli di complessità nella configurazione e nell’uso del knowledge graph.
Nonostante queste sfide, i knowledge graph offrono vantaggi significativi per le applicazioni RAG, in particolare nella rappresentazione della conoscenza strutturata, nell’abilitare ragionamenti complessi e nel fornire risultati spiegabili e trasparenti. Affrontare queste sfide attraverso un’attenta progettazione del grafo, strategie di integrazione dei dati ed efficienti tecniche di elaborazione delle query è cruciale per implementare con successo applicazioni RAG basate su knowledge graph.
In questo tutorial abbiamo esplorato la potenza dei knowledge graph per creare risposte più accurate, informative e contestualmente rilevanti. Siamo partiti dai concetti fondamentali dei knowledge graph e del loro ruolo nelle applicazioni RAG. Poi abbiamo seguito un esempio pratico: estrazione di un knowledge graph da dati testuali, archiviazione in un database Neo4j e utilizzo per recuperare contesto rilevante per le query degli utenti. Infine, abbiamo mostrato come usare il contesto recuperato per generare risposte basate sulla conoscenza strutturata del grafo.
Se vuoi approfondire l’IA e gli LLM, dai un’occhiata a questo percorso di sei corsi su AI Fundamentals.
Spero che questo tutorial ti sia utile e divertente, ci vediamo al prossimo.
Buon coding!
Scopri di più su IA e LLM!
Programma
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



