
Last chance! 50% off DataCamp Premium
Sale ends in
Inferensi model bahasa besar dapat menjadi semakin mahal seiring bertambahnya panjang prompt.
Sistem RAG, agen pengodean, alur kerja multi-agen, dan percakapan panjang sering kali mengirim dokumen yang sama, prompt sistem, definisi alat, atau riwayat percakapan ke model berulang kali.
Setiap kali konteks bersama ini diproses selama prefill, model menghasilkan status key-value (KV) yang digunakan selama generasi token.
Menghitung ulang status tersebut untuk konteks yang sama membuang komputasi GPU dan meningkatkan latensi.
LMCache mengatasinya dengan menambahkan lapisan KV cache khusus ke tumpukan inferensi.
Ia dapat menyimpan status KV yang telah dihitung sebelumnya dan membuatnya dapat digunakan ulang di berbagai permintaan dan pekerja inferensi, sekaligus mendukung CPU, penyimpanan lokal, backend jarak jauh, dan arsitektur penyajian yang terdisagregasi.
Dalam tutorial ini, saya akan menunjukkan cara kerja LMCache, bagaimana perbedaannya dari KV caching bawaan vLLM, dan di mana fitur seperti penyimpanan multi-tier, cache bersama, CacheBlend, serta disaggregasi prefill/decode cocok dalam penyajian LLM modern.
Anda kemudian akan menghubungkan LMCache ke vLLM, menyajikan IBM Granite 4.2 3B, dan menjalankan eksperimen terkontrol untuk mengukur bagaimana penggunaan ulang prefix bersama yang besar memengaruhi latensi inferensi.
LMCache adalah lapisan manajemen KV cache untuk inferensi LLM sumber terbuka.
Ini memungkinkan status key-value yang dibuat selama prefill disimpan dan digunakan ulang ketika permintaan di masa mendatang memiliki prefix prompt yang sama.
Sumber: LMCache – Membangun fondasi tensor memori AI dengan Infrastruktur KV Cache
Ini berbeda dari caching respons tradisional.
Cache respons menyimpan jawaban akhir yang dihasilkan dan mengembalikannya ketika permintaan yang sama muncul lagi:
cache = {
    "What is Python?":
        "Python is a general-purpose programming language..."
}
LMCache bekerja lebih awal dalam proses inferensi. Alih-alih menyimpan respons akhir, ia menyimpan status KV attention yang dihasilkan saat model memproses prompt.
Sebagai contoh, tanpa KV cache yang dapat digunakan ulang, prompt panjang yang dibagi harus melalui prefill lagi setiap kali pertanyaan baru ditambahkan.
Dengan LMCache, permintaan pertama melakukan prefill penuh dan menyimpan status KV yang dihasilkan. Permintaan berikutnya dengan prefix yang sama dapat memuat status tersebut dan hanya memproses token baru.
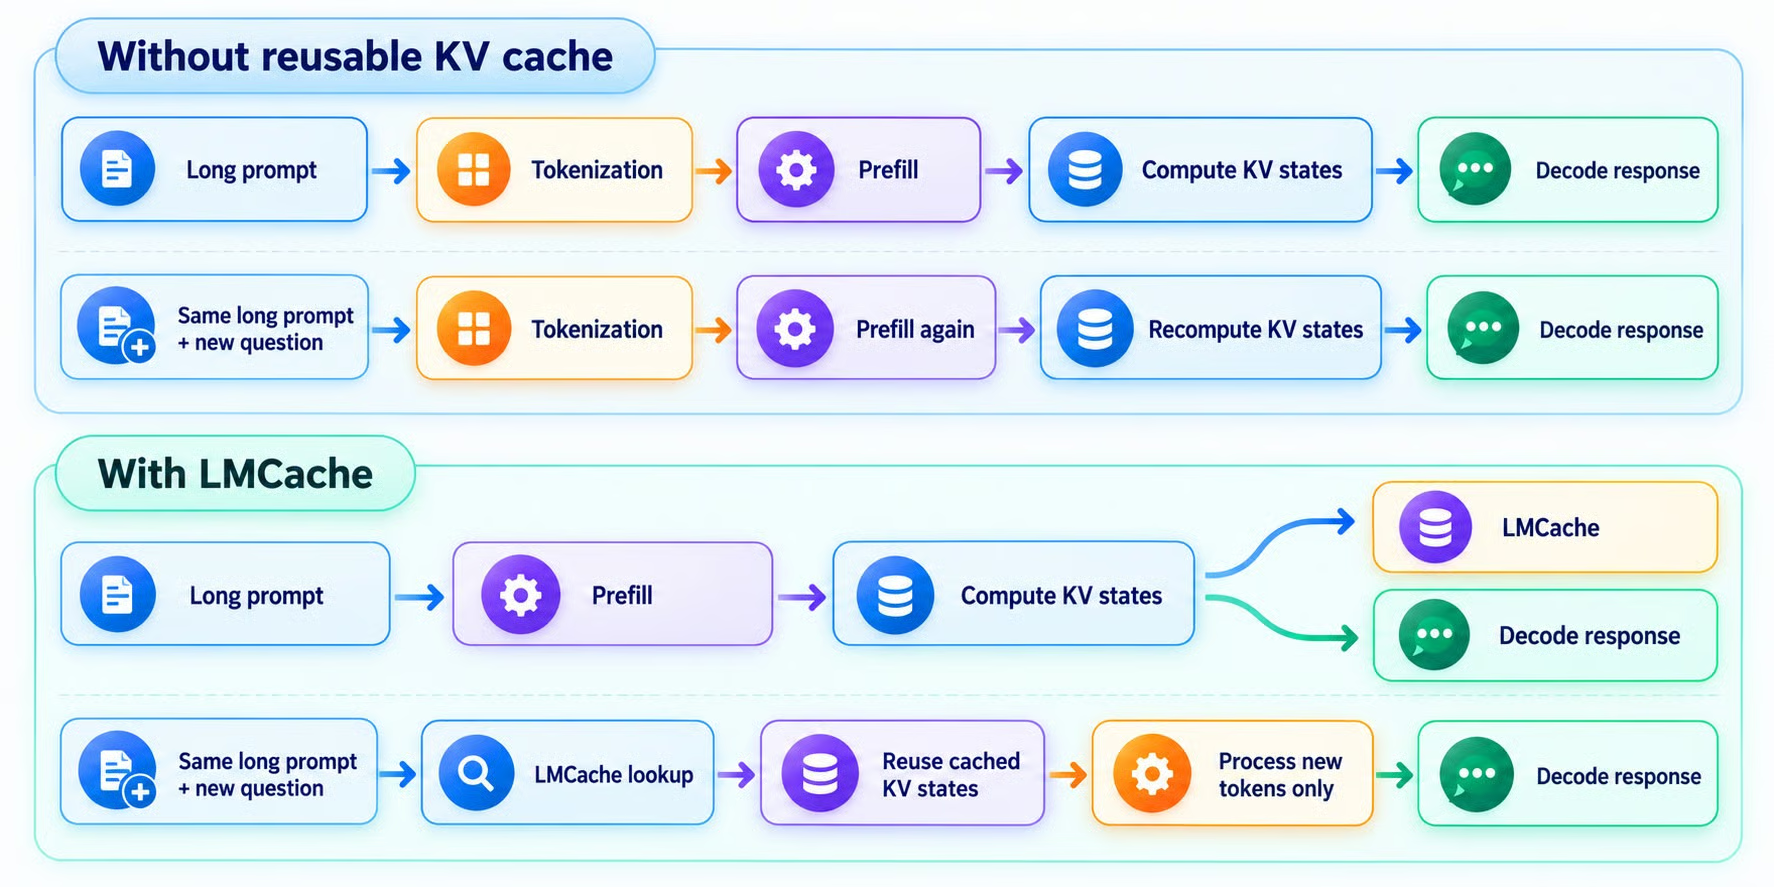
Gbr 1: Tanpa KV cache yang dapat digunakan ulang, seluruh prompt dihitung ulang untuk setiap permintaan; dengan LMCache, status KV dalam cache digunakan ulang dan hanya token baru yang diproses.
Ini menjadi semakin berharga seiring bertambahnya jendela konteks.
Memproses ulang beberapa ratus token mungkin murah, tetapi berulang kali memproses puluhan ribu token bersama dapat meningkatkan latensi dan penggunaan GPU secara signifikan.
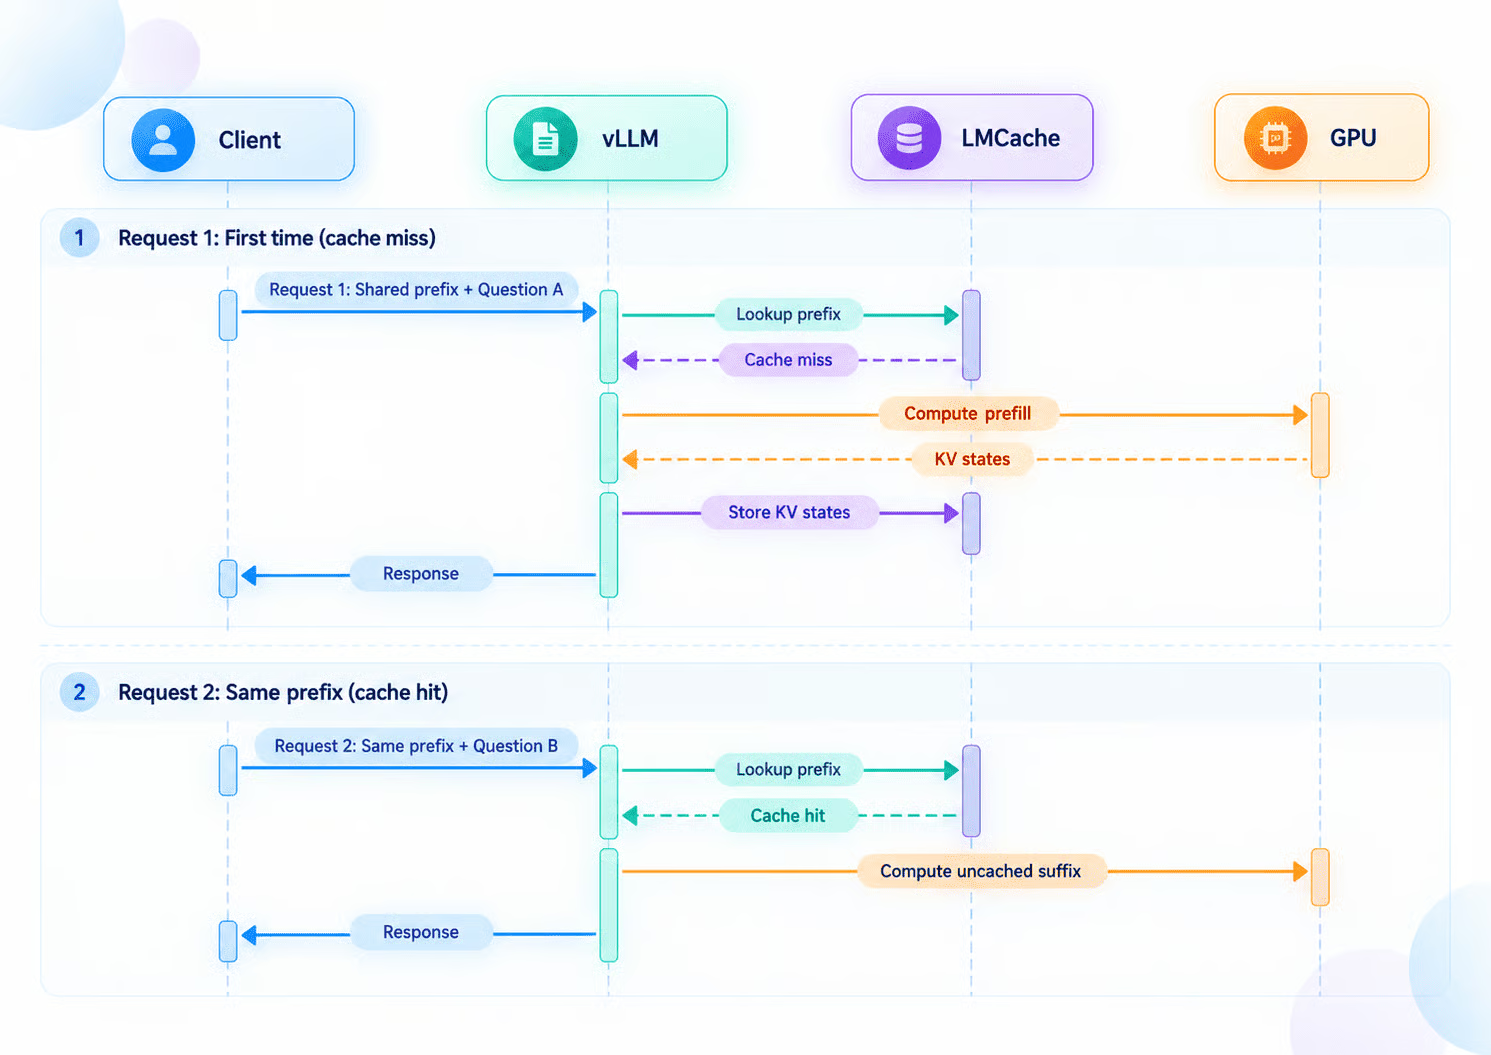
Cara termudah untuk memahami LMCache adalah mengikuti dua permintaan yang memiliki prefix yang sama.
Untuk permintaan pertama, LMCache memeriksa apakah status KV yang dapat digunakan ulang sudah ada. Karena ini pertama kalinya prompt terlihat, pencarian menghasilkan cache miss.
vLLM kemudian melakukan prefill di GPU, membuat status KV, dan menyerahkannya ke LMCache untuk disimpan.
Untuk permintaan kedua, prefix yang dibagi tetap sama, tetapi pertanyaannya berubah.
LMCache melakukan pencarian lagi. Kali ini, prefix sudah tersedia, menghasilkan cache hit. Status dalam cache digunakan ulang, dan GPU hanya perlu memproses sufiks yang belum dicache.
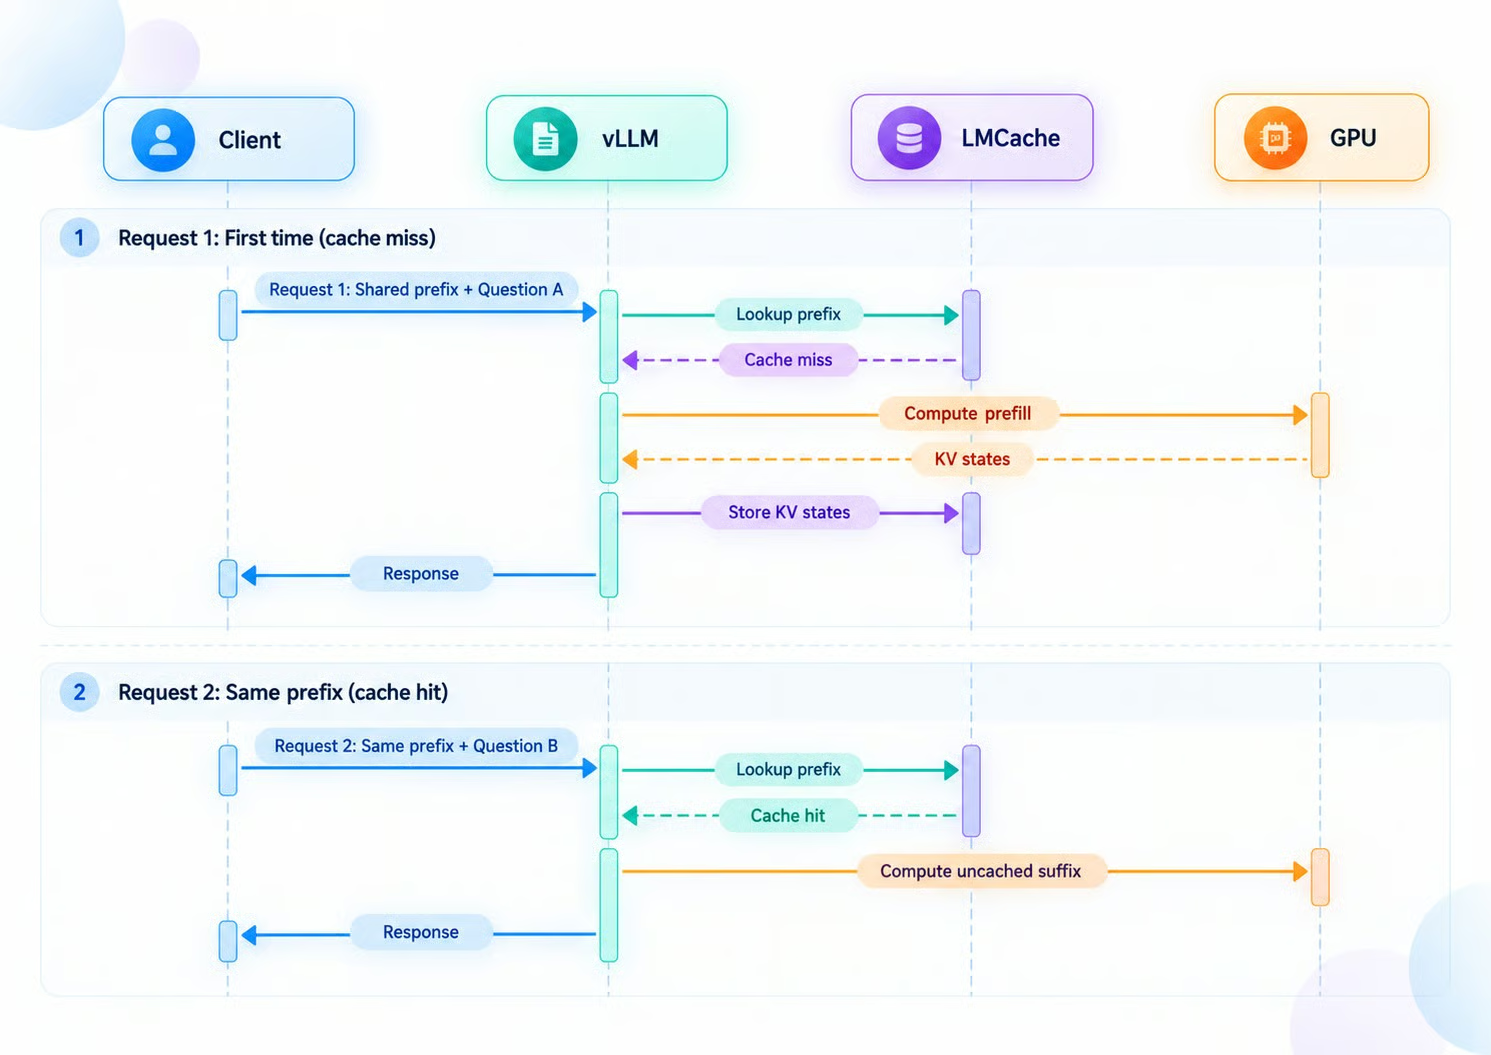
Gbr 2: Permintaan pertama dengan prefix baru meleset dari cache, jadi vLLM menghitung prefill dan menyimpan status KV di LMCache; permintaan ulang dengan prefix yang sama mengenai cache dan hanya menghitung sufiks baru.
Poin pentingnya adalah LMCache tidak mengharuskan seluruh permintaan identik. Yang penting adalah prefix yang dapat digunakan ulang.
Hal ini membuatnya cocok untuk aplikasi di mana konteks latar belakang tetap sama sementara kueri pengguna berubah.
vLLM sudah mendukung prefix caching otomatis, jadi wajar untuk bertanya mengapa LMCache masih diperlukan.
Kedua pendekatan berupaya menghindari penghitungan ulang status KV untuk prefix prompt yang sudah diproses model.
Perbedaan utama adalah di mana cache itu berada dan seberapa luas ia dapat digunakan ulang.
|
Fitur |
KV Caching Bawaan vLLM |
LMCache |
|
Penggunaan ulang KV prefix |
Ya, melalui Automatic Prefix Caching |
Ya |
|
Penggunaan ulang KV non-prefix |
Tidak |
Ya, melalui CacheBlend |
|
KV cache di GPU |
Ya |
Bekerja berdampingan dengan GPU KV cache milik vLLM |
|
Offloading KV ke CPU |
Ya |
Ya |
|
Penyimpanan SSD / NVMe |
Didukung melalui tier penyimpanan sekunder |
Ya, termasuk disk lokal, NVMe, dan GDS |
|
Penyimpanan jarak jauh |
Mendukung opsi seperti penyimpanan objek kompatibel S3 |
Mendukung banyak backend termasuk Redis/Valkey, S3, Mooncake, InfiniStore, NIXL, dan lainnya |
|
Berbagi cache lintas proses |
Didukung dalam beberapa konfigurasi, termasuk P2P dan penyimpanan bersama |
Fitur inti, dengan banyak pekerja inferensi dapat menggunakan status KV dalam cache bersama |
|
Layanan cache mandiri |
Tidak, caching dikelola sebagai bagian dari tumpukan penyajian vLLM |
Ya, mode MP LMCache dapat berjalan terpisah dari vLLM |
|
Skalabilitas cache independen |
Sumber daya cache umumnya dikonfigurasi bersama dengan deployment inferensi |
Kapasitas cache dapat diskalakan terpisah dari pekerja vLLM |
|
Disaggregasi prefill/decode |
Didukung melalui konektor KV |
Dibangun khusus untuk mendukung transfer KV antara pekerja prefill dan decode |
|
Paling cocok untuk |
Penggunaan ulang prefix yang efisien dan offloading KV dalam deployment vLLM |
Beban kerja KV-cache berskala besar, bersama, multi-tier, atau terdistribusi |
Prefix caching bawaan vLLM adalah opsi yang lebih sederhana ketika permintaan berulang ditangani oleh server inferensi yang sama.
Jika beberapa permintaan dimulai dengan token yang sama, vLLM dapat menggunakan ulang blok KV yang ada alih-alih melakukan seluruh prefill lagi.
LMCache memperluas gagasan ini melampaui mesin inferensi.
Alih-alih menyimpan status KV yang dapat digunakan ulang hanya dalam cache milik vLLM, LMCache memperkenalkan lapisan cache terpisah yang dapat menyimpan dan memindahkan status KV melintasi tier penyimpanan tambahan dan membuatnya tersedia bagi arsitektur penyajian yang lebih luas.
Cara sederhana untuk memikirkan perbedaannya adalah:
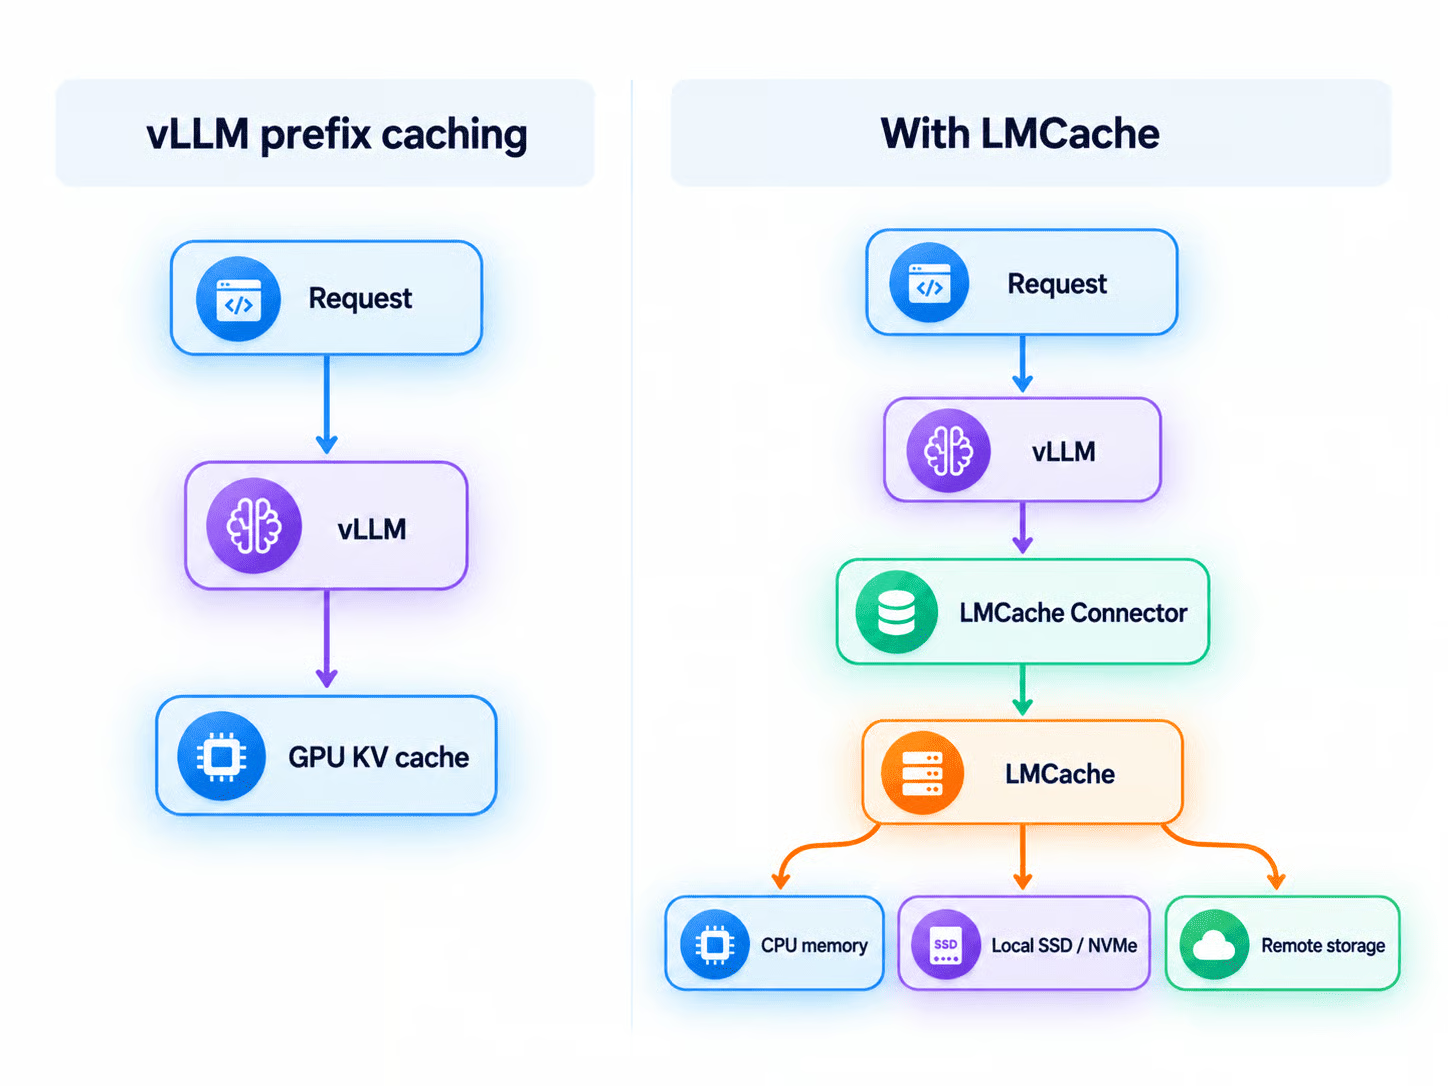
Gbr 3: vLLM prefix caching vs LMCache. LMCache menambahkan lapisan caching yang mentier status KV di memori CPU, SSD/NVMe lokal, dan penyimpanan jarak jauh alih-alih hanya memori GPU.
Jadi LMCache tidak menggantikan gagasan KV caching di vLLM. Ia memperluas manajemen KV-cache melampaui batas normal mesin inferensi.
LMCache menyediakan lebih dari sekadar cache dalam memori. Ia dirancang untuk menyimpan, memindahkan, dan menggunakan ulang status KV di berbagai tier penyimpanan dan pekerja inferensi.
Fitur utama LMCache adalah kemampuan menggunakan ulang status KV yang telah dihitung sebelumnya alih-alih memproses token yang sama melalui model lagi.
Ini sangat berguna ketika permintaan berulang kali menyertakan konteks yang sama atau serupa, seperti:
Dengan menggunakan ulang status KV dalam cache, LMCache dapat mengurangi komputasi prefill berulang dan meningkatkan waktu ke token pertama.
Memori GPU terbatas dan mahal, terutama saat bekerja dengan konteks panjang.
LMCache dapat memindahkan status KV melampaui memori GPU dan menyimpannya di beberapa tier, termasuk memori CPU, penyimpanan SSD atau NVMe lokal, serta penyimpanan jarak jauh atau terdistribusi.
Ini memungkinkan lebih banyak konteks yang dapat digunakan ulang tetap tersedia daripada yang dapat sepenuhnya ditampung di memori GPU, sambil tetap memindahkan status KV yang sering digunakan kembali ke GPU saat dibutuhkan.
LMCache dapat membuat status KV dalam cache tersedia di banyak pekerja inferensi alih-alih mengikatnya ke satu proses model.
Misalnya, jika satu pekerja vLLM memproses dokumen panjang, pekerja lain berpotensi menggunakan ulang status KV dalam cache alih-alih menghitung ulang konteks yang sama.
Ini sangat berguna untuk penyajian terdistribusi, deployment multi-GPU, dan aplikasi di mana permintaan dirutekan ke beberapa replika inferensi.
LMCache berintegrasi dengan vLLM melalui antarmuka konektor KV.
Aplikasi dapat terus berkomunikasi dengan endpoint vLLM yang kompatibel dengan OpenAI sementara LMCache beroperasi di bawah lapisan inferensi.
Ini berarti aplikasi yang ada tidak perlu mengubah cara mereka mengirim prompt atau menerima respons. LMCache menangani penyimpanan dan pengambilan KV antara vLLM dan backend cache yang dikonfigurasi.
LMCache dapat berjalan sebagai proses terpisah dari vLLM.
Alih-alih menjaga manajemen cache di dalam setiap pekerja inferensi, server LMCache khusus dapat mengelola status KV secara independen dan melayani banyak proses vLLM.
Ini memisahkan manajemen cache dari penyajian model, memungkinkan banyak pekerja berbagi cache yang sama, dan memudahkan penskalaan kapasitas cache secara independen dari sumber daya inferensi GPU.
Prefix caching tradisional bekerja paling baik ketika permintaan berbagi awal prompt yang sama.
LMCache juga menyediakan CacheBlend untuk beban kerja di mana konten yang dapat digunakan ulang dapat muncul di posisi berbeda.
Misalnya, aplikasi RAG mungkin mengambil dokumen yang sama dalam urutan berbeda untuk pertanyaan yang berbeda.
CacheBlend dapat menggunakan ulang bagian dari status KV yang telah dihitung sebelumnya sambil secara selektif menghitung ulang token yang bergantung pada konteks baru.
Ini membuat penggunaan ulang KV lebih bermanfaat untuk RAG, aplikasi multi-dokumen, dan alur kerja agen di mana prompt sering diatur ulang.
LMCache juga dapat membantu mentransfer status KV antara pekerja prefill dan decode yang terpisah.
Dalam arsitektur ini, satu kelompok GPU menangani tahap pemrosesan prompt yang intensif komputasi, sementara kelompok lain menangani generasi token.
LMCache menyediakan lapisan yang digunakan untuk memindahkan status KV yang dihasilkan di antara keduanya.
Ini memungkinkan sumber daya prefill dan decoding diskalakan secara independen dan dapat meningkatkan pemanfaatan GPU dalam deployment inferensi yang lebih besar.
Sekarang setelah kita memahami cara kerja LMCache, mari hubungkan ke vLLM, mesin inferensi LLM berperforma tinggi yang dirancang untuk penyajian dan manajemen memori yang efisien.
Untuk panduan ini, saya akan menggunakan IBM Granite 4.2 3B, model ringkas yang memberikan performa kuat untuk ukurannya sekaligus tetap ringan untuk pengujian praktis.
Kita akan menjalankan LMCache dalam mode multiproses bersama vLLM dan memverifikasi bahwa status KV dapat digunakan ulang di berbagai permintaan.
Untuk tutorial ini, kita akan menggunakan Python 3.12, uv, vLLM, LMCache, klien Python OpenAI, pandas, dan matplotlib.
Sebelum memulai, pastikan Anda memiliki:
Anda dapat memasang uv dengan:
curl -LsSf https://astral.sh/uv/install.sh | shLalu buat proyeknya:
mkdir lmcache-tutorial
cd lmcache-tutorial
Buat dan aktifkan virtual environment Python 3.12:
uv venv --python 3.12
source .venv/bin/activate
Pasang dependensi yang diperlukan:
uv pip install -U \
    "lmcache==0.5.4" \
    "vllm==0.28.0" \
    openai \
    pandas \
    matplotlib \
    --torch-backend=cu130
Di sini, kita menggunakan cu130 karena lingkungan kita disiapkan dengan CUDA 13.
Jika Anda menggunakan versi CUDA lain, ubah nilai --torch-backend ke backend PyTorch yang kompatibel untuk lingkungan Anda.
Granite 4.2 menggunakan reasoning parser kustom, jadi unduh dari Hugging Face:
hf download ibm-granite/granite-4.2-3b \
    granite_thinking_parser.py \
    --local-dir .
Terakhir, verifikasi bahwa instalasi GPU dan CUDA Anda terdeteksi:
nvidia-smi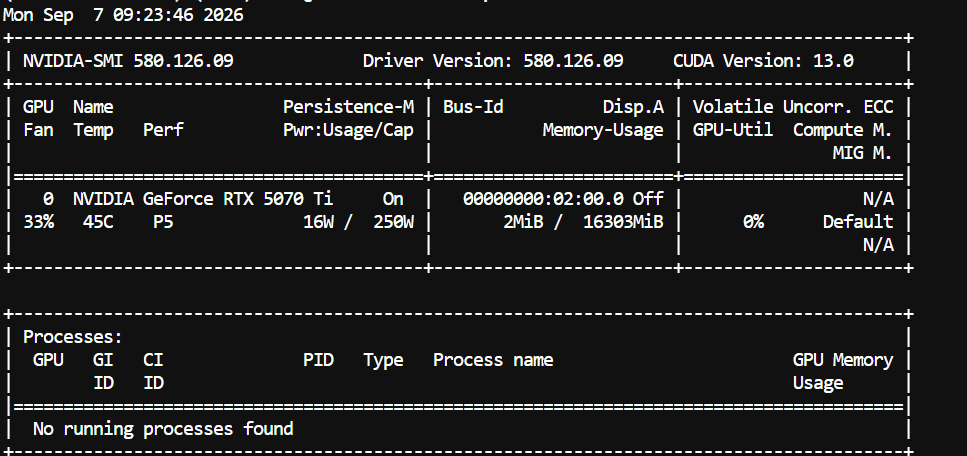
Untuk tutorial ini, kami menggunakan NVIDIA GeForce RTX 5070 Ti dengan VRAM 16 GB.
Sistem menjalankan driver NVIDIA 580.126.09, dengan dukungan CUDA 13.0.
Kita memerlukan dua proses yang berjalan: satu untuk server LMCache dan satu lagi untuk vLLM.
Jalankan LMCache di terminal pertama:
lmcache server \
    --host localhost \
    --port 6555 \
    --http-port 8081 \
    --l1-size-gb 20 \
    --eviction-policy LRU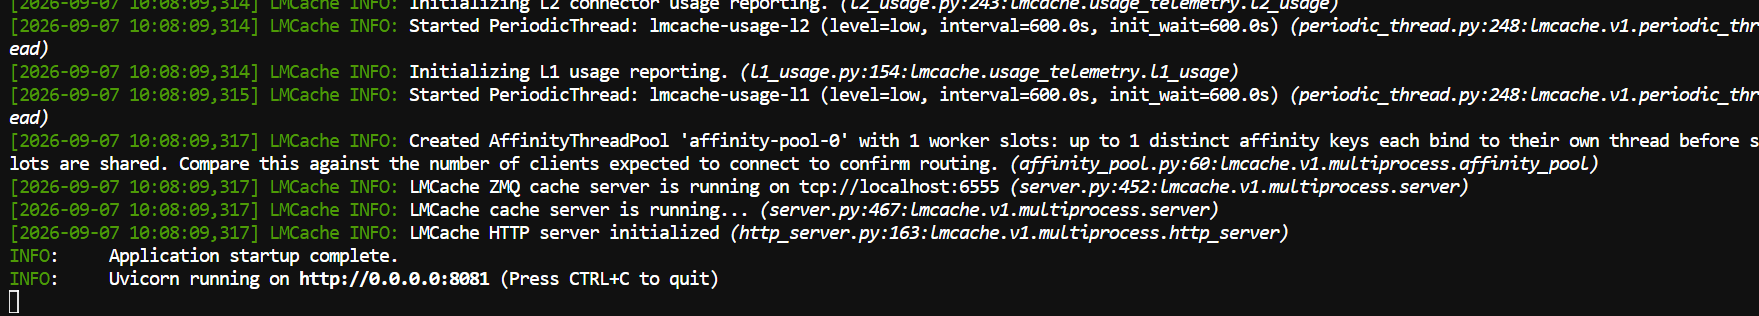
Di sini, kita menggunakan:
6555 untuk komunikasi antara vLLM dan LMCache8081 untuk antarmuka HTTP LMCache20 GB untuk L1 cacheLRU sebagai kebijakan evictionBiarkan terminal ini tetap berjalan.
Buka terminal kedua, aktifkan virtual environment yang sama, dan hapus konfigurasi allocator CUDA yang dapat diperluas jika diaktifkan:
cd lmcache-tutorial
source .venv/bin/activate
unset PYTORCH_CUDA_ALLOC_CONF
Sekarang jalankan vLLM dengan konektor LMCache:
vllm serve ibm-granite/granite-4.2-3b \
  --served-model-name granite-4.2-3b \
  --dtype bfloat16 \
  --max-model-len 65536 \
  --kv-cache-dtype fp8 \
  --gpu-memory-utilization 0.90 \
  --enforce-eager \
  --max-num-seqs 1 \
  --max-num-batched-tokens 2048 \
  --no-enable-prefix-caching \
  --reasoning-parser granite_thinking_parser \
  --reasoning-parser-plugin "$(pwd)/granite_thinking_parser.py" \
  --tool-call-parser qwen3_coder \
  --enable-auto-tool-choice \
  --port 8000 \
  --kv-transfer-config \
  '{
    "kv_connector":"LMCacheMPConnector",
    "kv_connector_module_path":"lmcache.integration.vllm.lmcache_mp_connector",
    "kv_role":"kv_both",
    "kv_connector_extra_config":{
      "lmcache.mp.host":"tcp://localhost",
      "lmcache.mp.port":6555,
      "lmcache.mp.mp_transfer_mode":"lmcache_driven"
    }
  }'
Kita menonaktifkan prefix caching bawaan vLLM dengan:
--no-enable-prefix-cachingIni memungkinkan eksperimen berikutnya berfokus secara spesifik pada penggunaan ulang KV melalui LMCache.
Setelah vLLM selesai memuat, model tersedia melalui endpoint yang kompatibel dengan OpenAI:
http://localhost:8000/v1Kita sekarang akan melakukan eksperimen terkontrol sederhana untuk memastikan LMCache berfungsi.
Kita akan membuat prefix bersama yang besar, mengosongkan cache, mengirim prefix sekali untuk mengisi LMCache, lalu mengirim permintaan lain dengan prefix yang sama tetapi pertanyaan berbeda.
Pertama, buat klien OpenAI:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local",
)
Selanjutnya, buat dokumen bersama yang panjang:
base_text = """
Large language model inference consists of two main stages:
prefill and decoding.

During prefill, the model processes the input sequence and calculates
the key and value tensors used by the attention mechanism.

During autoregressive decoding, these tensors are reused so the model
does not need to recompute attention states for every previous token.

KV cache management is therefore an important part of modern LLM
serving infrastructure, particularly for long-context applications.
"""

document = base_text * 500

SYSTEM_PROMPT = f"""
You are a technical assistant.

Use only the following document to answer the user's question.

DOCUMENT:

{document}
"""
Mengulang dokumen 500 kali memberi kita prefix bersama yang besar sehingga cukup mahal untuk membuat efek penggunaan ulang KV terlihat.
Sebelum mengirim permintaan pertama, kosongkan LMCache agar kita mulai dengan cache kosong:
import subprocess
import time

subprocess.run(
    [
        "lmcache",
        "kvcache",
        "clear",
        "--url",
        "http://localhost:8081",
    ],
    check=True,
)

time.sleep(0.5)
Ini memastikan bahwa permintaan pertama adalah permintaan cold-cache dan tidak dapat menggunakan ulang status KV yang tersisa dari pengujian sebelumnya.
Sekarang kirim permintaan pertama:
prompt_1 = SYSTEM_PROMPT + """

Question:
Explain the purpose of the KV cache.
"""

start = time.perf_counter()

client.completions.create(
    model="granite-4.2-3b",
    prompt=prompt_1,
    max_tokens=100,
    temperature=0,
)

latency_1 = time.perf_counter() - start
Ini adalah permintaan pemanasan cache. vLLM harus memproses prefix bersama yang panjang selama prefill, sementara LMCache menyimpan status KV yang dihasilkan.
Berikutnya, pertahankan prefix bersama persis sama dan ubah hanya pertanyaannya:
prompt_2 = SYSTEM_PROMPT + """

Question:
Explain what happens during prefill.
"""

start = time.perf_counter()

client.completions.create(
    model="granite-4.2-3b",
    prompt=prompt_2,
    max_tokens=100,
    temperature=0,
)

latency_2 = time.perf_counter() - start
Karena prefix yang besar tidak berubah, LMCache dapat menggunakan ulang status KV yang dihasilkan oleh permintaan pertama alih-alih menghitung ulang seluruh prefix.
Terakhir, bandingkan waktu kedua permintaan:
print(f"Cold request:   {latency_1:.3f}s")
print(f"Warm request:   {latency_2:.3f}s")
print(f"Speedup:        {latency_1 / latency_2:.2f}x")

print(
    f"Latency saved:  "
    f"{((latency_1 - latency_2) / latency_1) * 100:.1f}%"
)
Hasil saya menghasilkan:
Cold request:   26.276s
Warm request:   4.402s
Speedup:        5.97x
Latency saved:  83.2%
Permintaan hangat selesai hampir 6× lebih cepat, mengurangi latensi end-to-end sebesar 83,2%.
Pertanyaannya berbeda, jadi LMCache tidak menyimpan respons akhir. Sebaliknya, ia menggunakan ulang status KV yang dihasilkan untuk prefix bersama.
Permintaan pertama harus memproses seluruh prefix panjang selama prefill dan membuat status KV tersebut dari awal.
Pada permintaan kedua, LMCache mengambil status dalam cache yang cocok, memungkinkan vLLM melewati sebagian besar pekerjaan prefill berulang itu dan fokus hanya pada sufiks baru.
Ini mengonfirmasi bahwa LMCache berhasil menggunakan ulang prefix bersama.
LMCache sangat berguna ketika sebuah aplikasi berulang kali mengirim sejumlah besar konteks yang identik.
Beberapa contoh umum adalah:
Seorang pengguna dapat mengajukan beberapa pertanyaan tentang dokumen yang sama yang diambil.
Alih-alih memproses seluruh dokumen dari awal untuk setiap pertanyaan, status KV-nya dapat digunakan ulang.
Asisten pengodean sering kali mengirim berkas repositori, instruksi proyek, dan potongan konteks besar lainnya pada setiap pemanggilan model.
Sebagian besar konteks itu tetap identik sementara tugasnya berubah.
Agen sering menggunakan ulang prompt sistem besar, definisi alat, memori, instruksi, dan status lingkungan di banyak langkah.
Percakapan yang berjalan lama mungkin berulang kali mengirim porsi besar dari riwayatnya pada setiap pesan baru.
Beberapa agen dapat berbagi dokumen latar belakang atau konteks sistem yang sama sambil mengerjakan tugas yang berbeda.
Dalam semua kasus ini, model berulang kali diperlihatkan informasi yang sudah diprosesnya pada permintaan sebelumnya.
LMCache menyediakan cara untuk menggunakan ulang pekerjaan tersebut pada level KV-cache.
LMCache mengatasi sumber pemborosan utama dalam inferensi konteks panjang dengan membuat status KV yang dibuat selama prefill dapat digunakan ulang.
Alih-alih memproses konteks bersama yang sama berulang kali, model dapat menggunakan ulang pekerjaan yang sudah diselesaikan.
Kami tidak menyertakan kode benchmark atau hasil terperinci dalam tutorial ini, tetapi kami menjalankan serangkaian pengujian terpisah dengan setelan yang sama.
Hasilnya signifikan. Penggunaan ulang prefix bersama yang besar menurunkan total latensi permintaan dari 26,276 detik menjadi 4,386 detik.
Rata-rata waktu ke token pertama turun dari 22,149 detik menjadi 0,726 detik, sebuah peningkatan 30,54×. Keuntungan juga meningkat seiring ukuran konteks, dari 3,55× dengan sekitar 12.000 karakter bersama menjadi 30,22× dengan kira-kira 245.000 karakter.
Sederhananya, semakin banyak konteks yang dapat digunakan ulang, semakin banyak pekerjaan yang dapat dihindari LMCache.
DeepSeek adalah contoh dunia nyata yang baik tentang mengapa hal ini penting.
Sistem caching-nya dapat menggunakan ulang prefix prompt yang cocok, yang sangat berharga untuk agen pengodean yang berulang kali mengirim prompt sistem, alat, riwayat percakapan, dan konteks kode yang sama.
Tingkat hit cache yang lebih tinggi berarti komputasi berulang lebih sedikit dan biaya lebih rendah bagi penyedia maupun pengguna.
Inti dari panduan ini adalah bahwa inferensi LLM yang lebih cepat tidak hanya tentang GPU yang lebih baik atau generasi token yang lebih cepat. Ini juga tentang tidak mengulang pekerjaan secara tidak perlu.
Untuk sistem RAG, asisten pengodean, agen, dan aplikasi konteks panjang lainnya, KV caching yang dapat digunakan ulang dapat menjadi bagian penting untuk meningkatkan latensi, mengurangi penggunaan GPU, dan menurunkan biaya inferensi.
Kursus Teratas di DataCamp
{count, plural, one {Program} other {Program}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt




