
लर्निंग पाथ
Deploy Production-Ready Agents
2 घंटा
जैसे-जैसे प्रॉम्प्ट बड़े होते जाते हैं, बड़े भाषा मॉडल इन्फरेंस की लागत तेज़ी से बढ़ सकती है.
RAG सिस्टम, कोडिंग एजेंट, मल्टी-एजेंट वर्कफ़्लो, और लंबी बातचीतें अक्सर वही डॉक्यूमेंट, सिस्टम प्रॉम्प्ट, टूल डेफ़िनिशन, या बातचीत का इतिहास बार-बार मॉडल को भेजती हैं।
हर बार जब इस साझा संदर्भ को प्रीफिल के दौरान प्रोसेस किया जाता है, तो मॉडल की-वैल्यू (KV) स्टेट्स जनरेट करता है जिनका उपयोग टोकन जनरेशन के दौरान होता है.
एक ही संदर्भ के लिए उन स्टेट्स को फिर से कंप्यूट करना GPU कंप्यूट बर्बाद करता है और लेटेंसी बढ़ाता है।
LMCache इसका समाधान इन्फरेंस स्टैक में एक समर्पित KV कैश लेयर जोड़कर करता है.
यह पहले से कंप्यूट किए गए KV स्टेट्स को स्टोर कर सकता है और उन्हें रिक्वेस्ट्स और इन्फरेंस वर्कर्स के बीच री-यूज़ करने योग्य बनाता है, साथ ही CPU, लोकल स्टोरेज, रिमोट बैकएंड्स और डिसएग्रीगेटेड सर्विंग आर्किटेक्चर का समर्थन भी करता है।
इस ट्यूटोरियल में, मैं दिखाऊंगा कि LMCache कैसे काम करता है, यह vLLM के नैटिव KV कैशिंग से कैसे अलग है, और मल्टी-टियर स्टोरेज, साझा कैशिंग, CacheBlend, और प्रीफिल/डिकोड डिसएग्रीगेशन जैसी विशेषताएं आधुनिक LLM सर्विंग में कहाँ फिट होती हैं।
इसके बाद आप LMCache को vLLM से कनेक्ट करेंगे, IBM Granite 4.2 3B सर्व करेंगे, और एक नियंत्रित प्रयोग चलाएंगे ताकि मापा जा सके कि बड़े साझा प्रीफिक्स को री-यूज़ करने से इन्फरेंस लेटेंसी पर क्या असर पड़ता है।
LMCache एक ओपन-सोर्स KV कैश मैनेजमेंट लेयर है जो LLM इन्फरेंस के लिए बनाई गई है.
यह प्रीफिल के दौरान बनाए गए की-वैल्यू स्टेट्स को स्टोर करने और तब री-यूज़ करने की अनुमति देता है जब भविष्य की रिक्वेस्ट्स वही प्रॉम्प्ट प्रीफिक्स साझा करती हैं।
स्रोत: LMCache – KV Cache Infrastructure के साथ AI मेमोरी टेन्सर की नींव बनाना
यह पारंपरिक रिस्पॉन्स कैशिंग से अलग है।
रिस्पॉन्स कैश अंतिम जेनरेटेड उत्तर को स्टोर करता है और वही रिक्वेस्ट दोबारा आने पर उसे लौटा देता है:
cache = {
    "What is Python?":
        "Python is a general-purpose programming language..."
}
LMCache इन्फरेंस प्रक्रिया में इससे पहले काम करता है। अंतिम उत्तर को कैश करने की बजाय, यह उन अटेंशन KV स्टेट्स को स्टोर करता है जो मॉडल के प्रॉम्प्ट प्रोसेस करते समय बनते हैं।
उदाहरण के लिए, री-यूज़ेबल KV कैशिंग के बिना, एक लंबा साझा प्रॉम्प्ट हर बार जब कोई नया प्रश्न जोड़ा जाता है, तो फिर से प्रीफिल से गुजरना पड़ता है.
LMCache के साथ, पहली रिक्वेस्ट पूरा प्रीफिल करती है और परिणामी KV स्टेट्स को स्टोर करती है। बाद की रिक्वेस्ट्स जिनका प्रीफिक्स वही है, वे उन स्टेट्स को लोड कर सकती हैं और सिर्फ नए टोकन्स को प्रोसेस करती हैं।
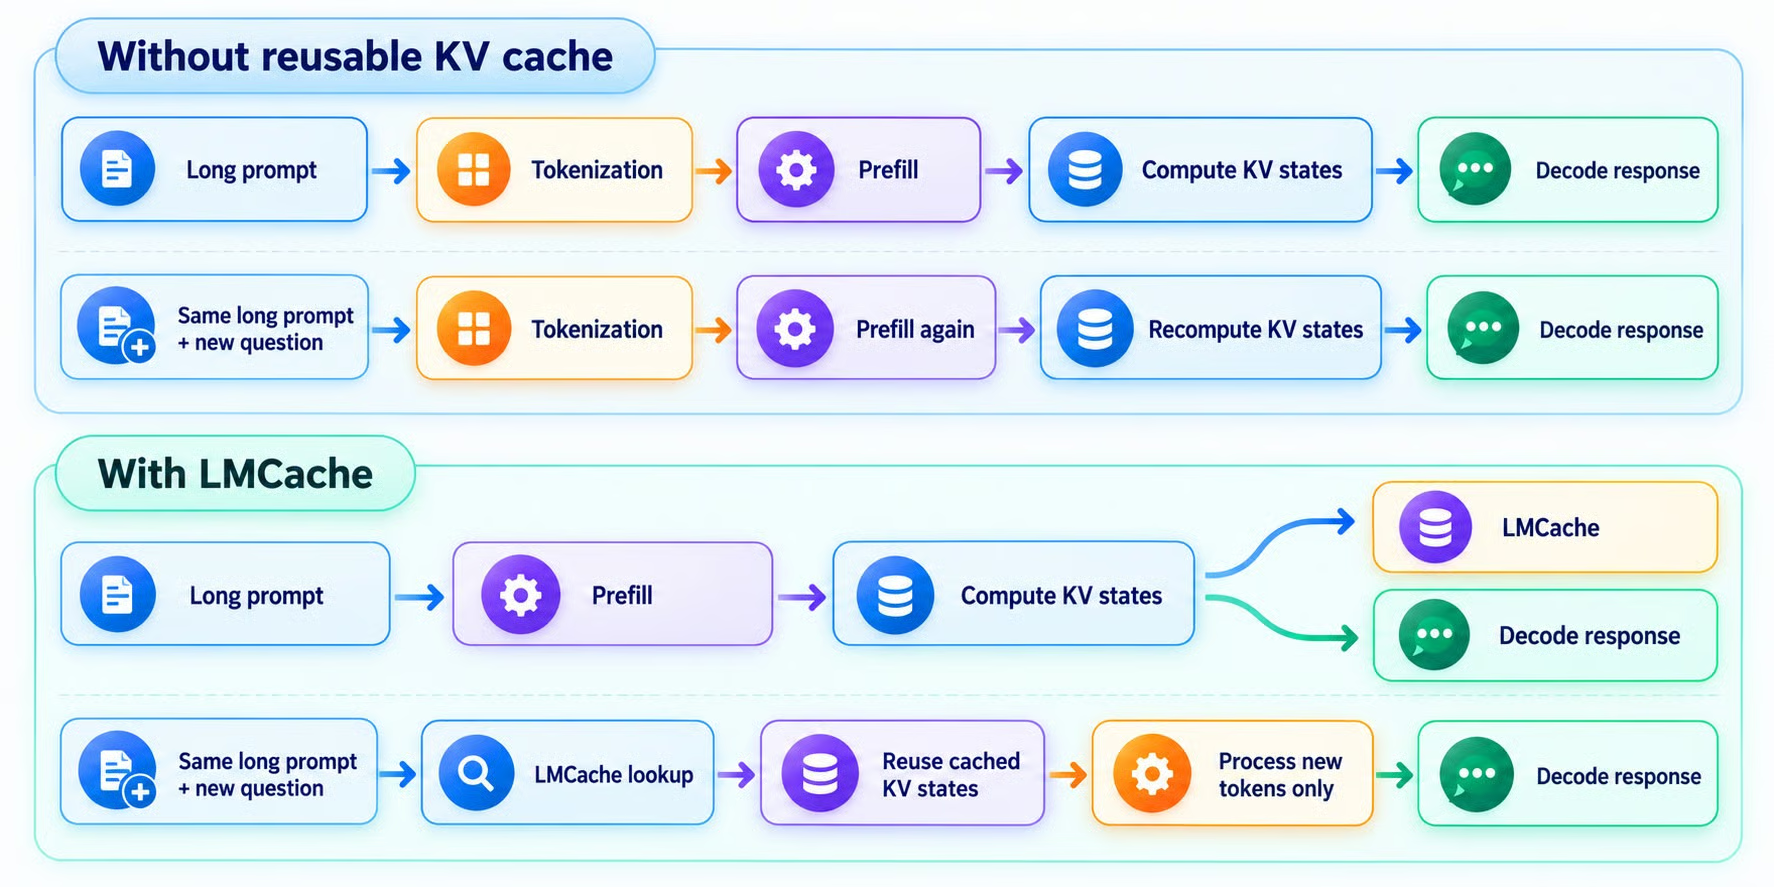
चित्र 1: री-यूज़ेबल KV कैश के बिना, हर रिक्वेस्ट के लिए पूरा प्रॉम्प्ट फिर से कंप्यूट होता है; LMCache के साथ, कैश किए गए KV स्टेट्स री-यूज़ होते हैं और केवल नए टोकन्स प्रोसेस होते हैं।
जैसे-जैसे कॉन्टेक्स्ट विंडो बढ़ती है, यह और अधिक मूल्यवान हो जाता है.
कुछ सौ टोकन्स को फिर से प्रोसेस करना सस्ता हो सकता है, लेकिन बार-बार दसियों हज़ार साझा टोकन्स प्रोसेस करना लेटेंसी और GPU उपयोग को काफ़ी बढ़ा सकता है।
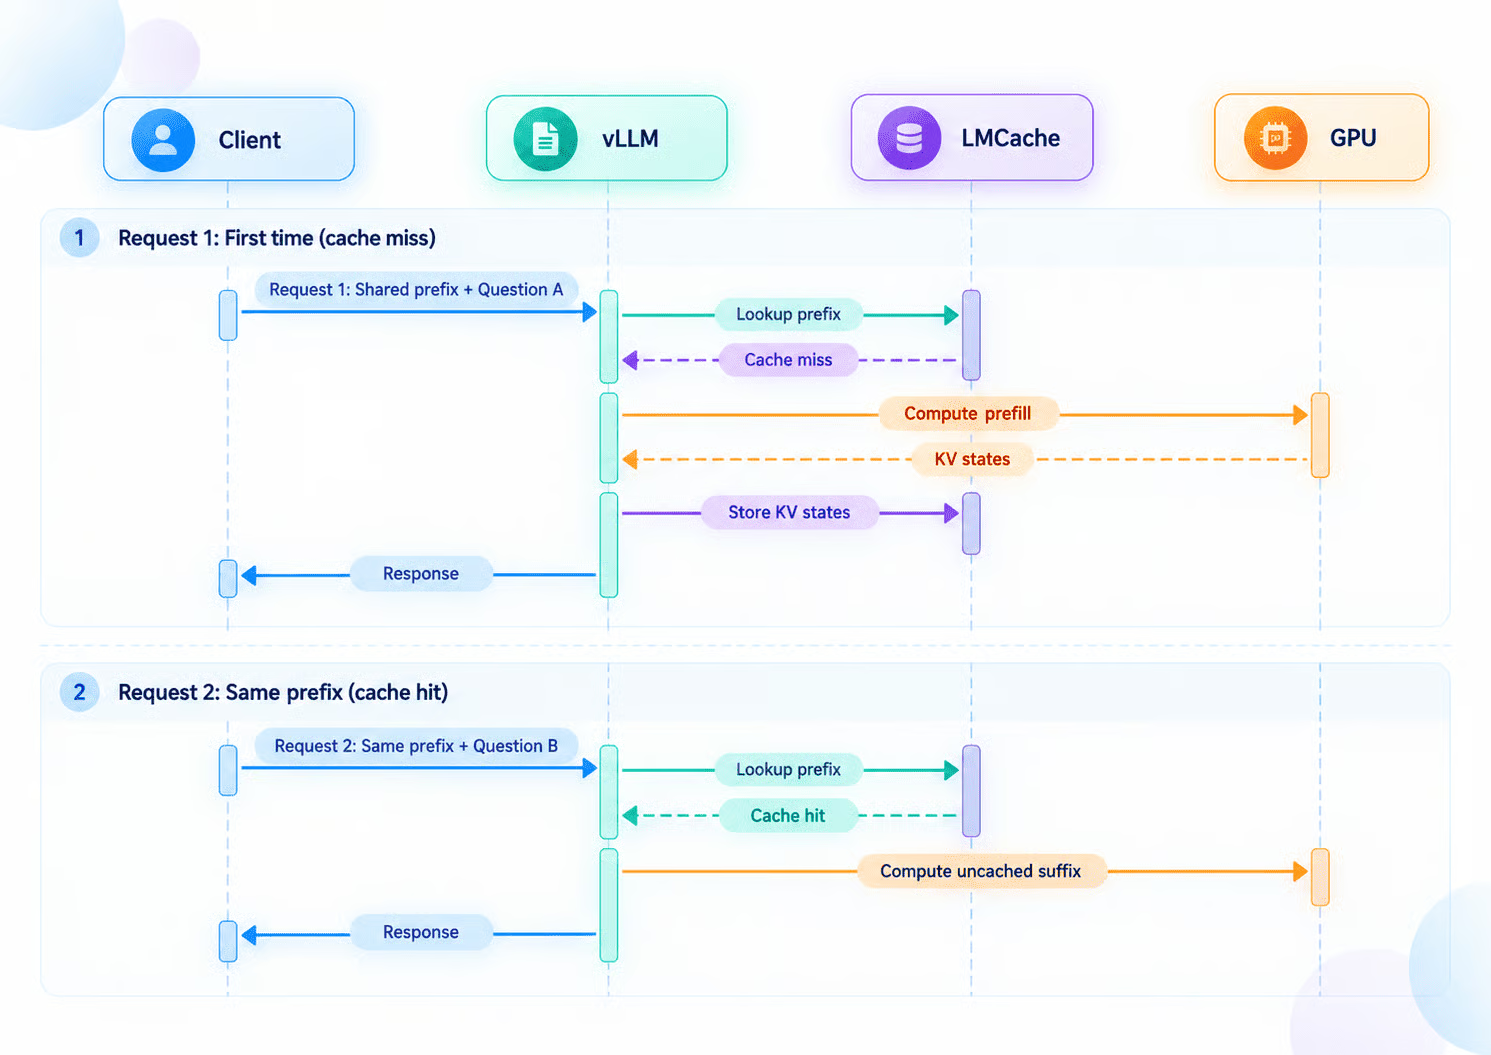
LMCache को समझने का सबसे आसान तरीका है दो ऐसी रिक्वेस्ट्स को फॉलो करना जिनका प्रीफिक्स समान हो।
पहली रिक्वेस्ट के लिए, LMCache यह जांचता है कि क्या री-यूज़ेबल KV स्टेट्स पहले से मौजूद हैं। क्योंकि यह प्रॉम्प्ट पहली बार देखा गया है, लुकअप में कैश मिस मिलता है।
इसके बाद vLLM GPU पर प्रीफिल करता है, KV स्टेट्स बनाता है, और उन्हें स्टोरेज के लिए LMCache को सौंप देता है।
दूसरी रिक्वेस्ट के लिए, साझा प्रीफिक्स वही रहता है, लेकिन प्रश्न बदल जाता है।
LMCache एक और लुकअप करता है। इस बार, प्रीफिक्स पहले से उपलब्ध है, इसलिए कैश हिट मिलती है। कैश किए गए स्टेट्स री-यूज़ होते हैं, और GPU को केवल अनकैश्ड सफिक्स प्रोसेस करना होता है।
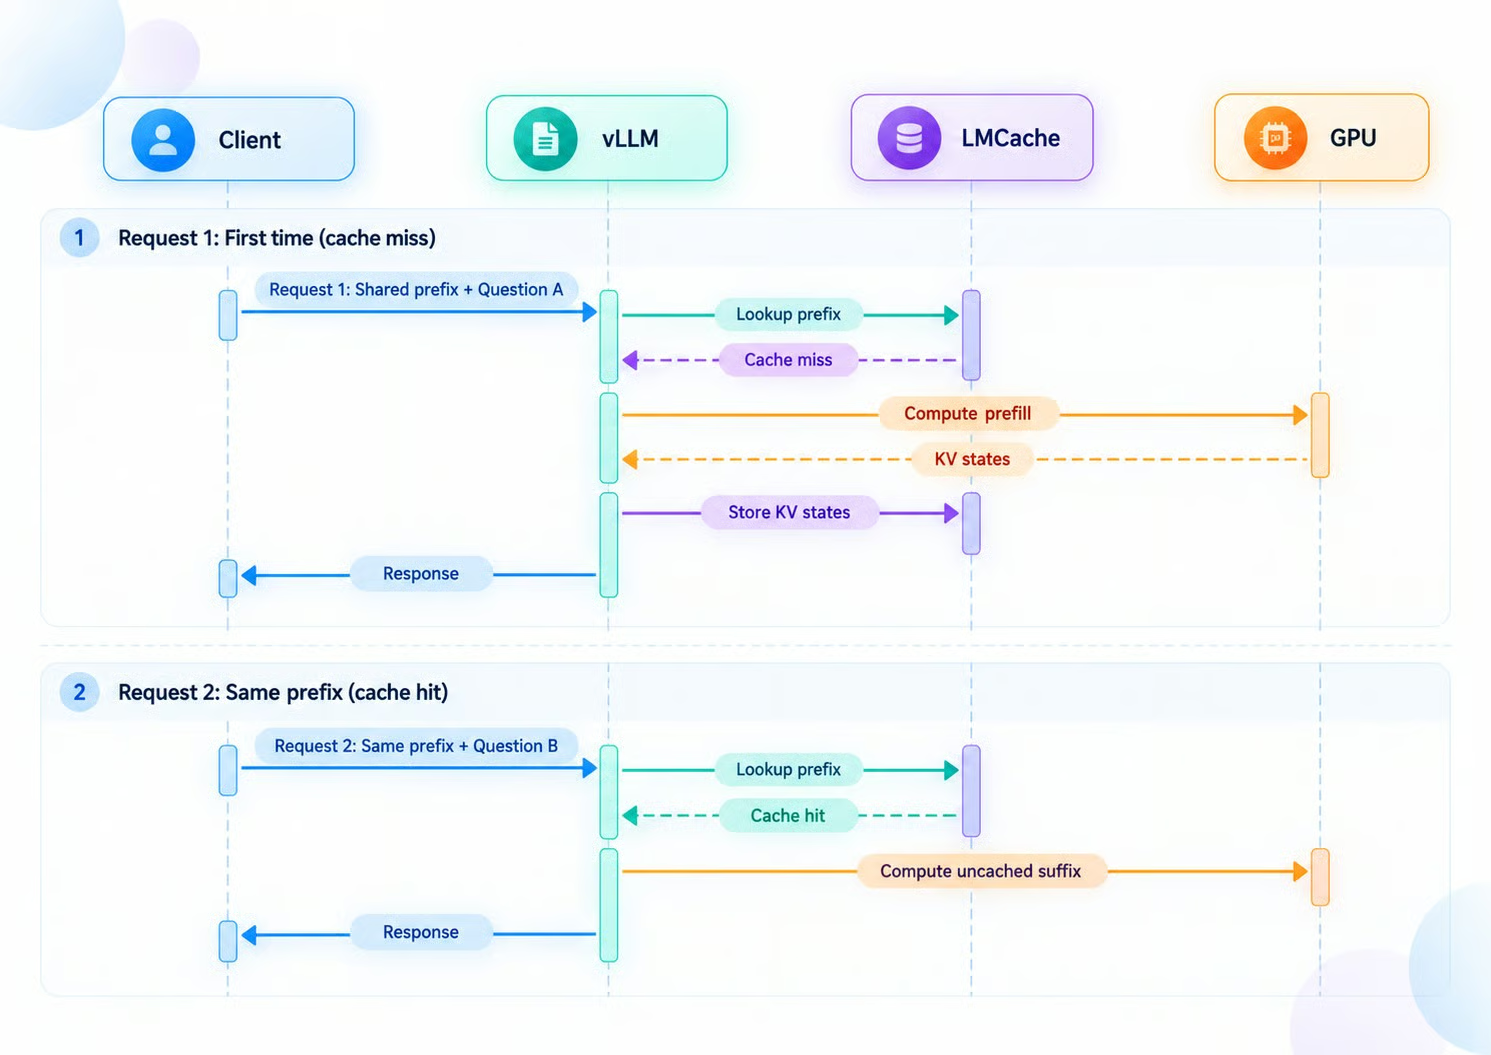
चित्र 2: नए प्रीफिक्स के साथ पहली रिक्वेस्ट कैश मिस करती है, इसलिए vLLM प्रीफिल कंप्यूट करता है और KV स्टेट्स को LMCache में स्टोर करता है; वही प्रीफिक्स होने पर दोहराई गई रिक्वेस्ट कैश हिट करती है और केवल नया सफिक्स कंप्यूट करती है।
महत्वपूर्ण बात यह है कि LMCache को पूरी रिक्वेस्ट का एक जैसा होना ज़रूरी नहीं है। मायने रखता है री-यूज़ेबल प्रीफिक्स।
यह उसे उन एप्लिकेशनों के लिए उपयुक्त बनाता है जहाँ बैकग्राउंड संदर्भ समान रहता है जबकि उपयोगकर्ता क्वेरी बदलती है।
vLLM पहले से ऑटोमैटिक प्रीफिक्स कैशिंग को सपोर्ट करता है, तो यह पूछना वाजिब है कि फिर LMCache की ज़रूरत क्यों है।
दोनों तरीकों का लक्ष्य उन प्रॉम्प्ट प्रीफिक्स के लिए KV स्टेट्स को फिर से कंप्यूट करने से बचना है जिन्हें मॉडल पहले ही प्रोसेस कर चुका है.
मुख्य अंतर यह है कि वह कैश कहाँ रहता है और उसे कितनी व्यापकता से री-यूज़ किया जा सकता है।
|
फ़ीचर |
vLLM का नैटिव KV कैशिंग |
LMCache |
|
प्रीफिक्स KV री-यूज़ |
हाँ, ऑटोमैटिक प्रीफिक्स कैशिंग के माध्यम से |
हाँ |
|
नॉन-प्रीफिक्स KV री-यूज़ |
नहीं |
हाँ, CacheBlend के माध्यम से |
|
GPU KV कैश |
हाँ |
vLLM के GPU KV कैश के साथ मिलकर काम करता है |
|
CPU KV ऑफलोडिंग |
हाँ |
हाँ |
|
SSD / NVMe स्टोरेज |
सेकेंडरी स्टोरेज टियर के माध्यम से सपोर्टेड |
हाँ, लोकल डिस्क, NVMe, और GDS सहित |
|
रिमोट स्टोरेज |
S3-कम्पैटिबल ऑब्जेक्ट स्टोरेज जैसे विकल्प सपोर्टेड |
Redis/Valkey, S3, Mooncake, InfiniStore, NIXL, और अन्य सहित अनेक बैकएंड्स सपोर्ट करता है |
|
क्रॉस-प्रोसेस कैश शेयरिंग |
कुछ कॉन्फ़िगरेशन में सपोर्टेड, P2P और साझा स्टोरेज सहित |
एक कोर फ़ीचर, जिसमें कई इन्फरेंस वर्कर्स साझा कैश्ड KV स्टेट्स का उपयोग कर सकते हैं |
|
स्टैंडअलोन कैश सर्विस |
नहीं, कैशिंग vLLM सर्विंग स्टैक का हिस्सा बनकर मैनेज होती है |
हाँ, LMCache MP मोड vLLM से स्वतंत्र रूप से चल सकता है |
|
स्वतंत्र कैश स्केलिंग |
कैश संसाधन आम तौर पर इन्फरेंस डिप्लॉयमेंट के साथ कॉन्फ़िगर होते हैं |
कैश क्षमता vLLM वर्कर्स से अलग से स्केल की जा सकती है |
|
प्रीफिल/डिकोड डिसएग्रीगेशन |
KV कनेक्टर्स के माध्यम से सपोर्टेड |
प्रीफिल और डिकोड वर्कर्स के बीच KV ट्रांसफ़र सपोर्ट के लिए खास तौर पर बनाया गया |
|
इनके लिए सर्वोत्तम |
vLLM डिप्लॉयमेंट्स के भीतर कुशल प्रीफिक्स री-यूज़ और KV ऑफलोडिंग |
बड़े पैमाने, साझा, मल्टी-टियर, या डिस्ट्रिब्यूटेड KV-कैश वर्कलोड्स |
जब दोहराई जाने वाली रिक्वेस्ट्स एक ही इन्फरेंस सर्वर द्वारा हैंडल होती हैं, तो vLLM की बिल्ट-इन प्रीफिक्स कैशिंग सरल विकल्प है.
यदि कई रिक्वेस्ट्स उन्हीं टोकन्स से शुरू होती हैं, तो vLLM पूरा प्रीफिल फिर से करने के बजाय मौजूदा KV ब्लॉक्स को री-यूज़ कर सकता है।
LMCache इस विचार को इन्फरेंस इंजन से आगे बढ़ाता है।
vLLM के अपने कैश के भीतर ही री-यूज़ेबल KV स्टेट्स रखने के बजाय, LMCache एक अलग कैश लेयर पेश करता है जो KV स्टेट्स को अतिरिक्त स्टोरेज टियर्स में स्टोर और मूव कर सकता है और उन्हें एक व्यापक सर्विंग आर्किटेक्चर में उपलब्ध करा सकता है।
अंतर को समझने का एक सरल तरीका यह है:
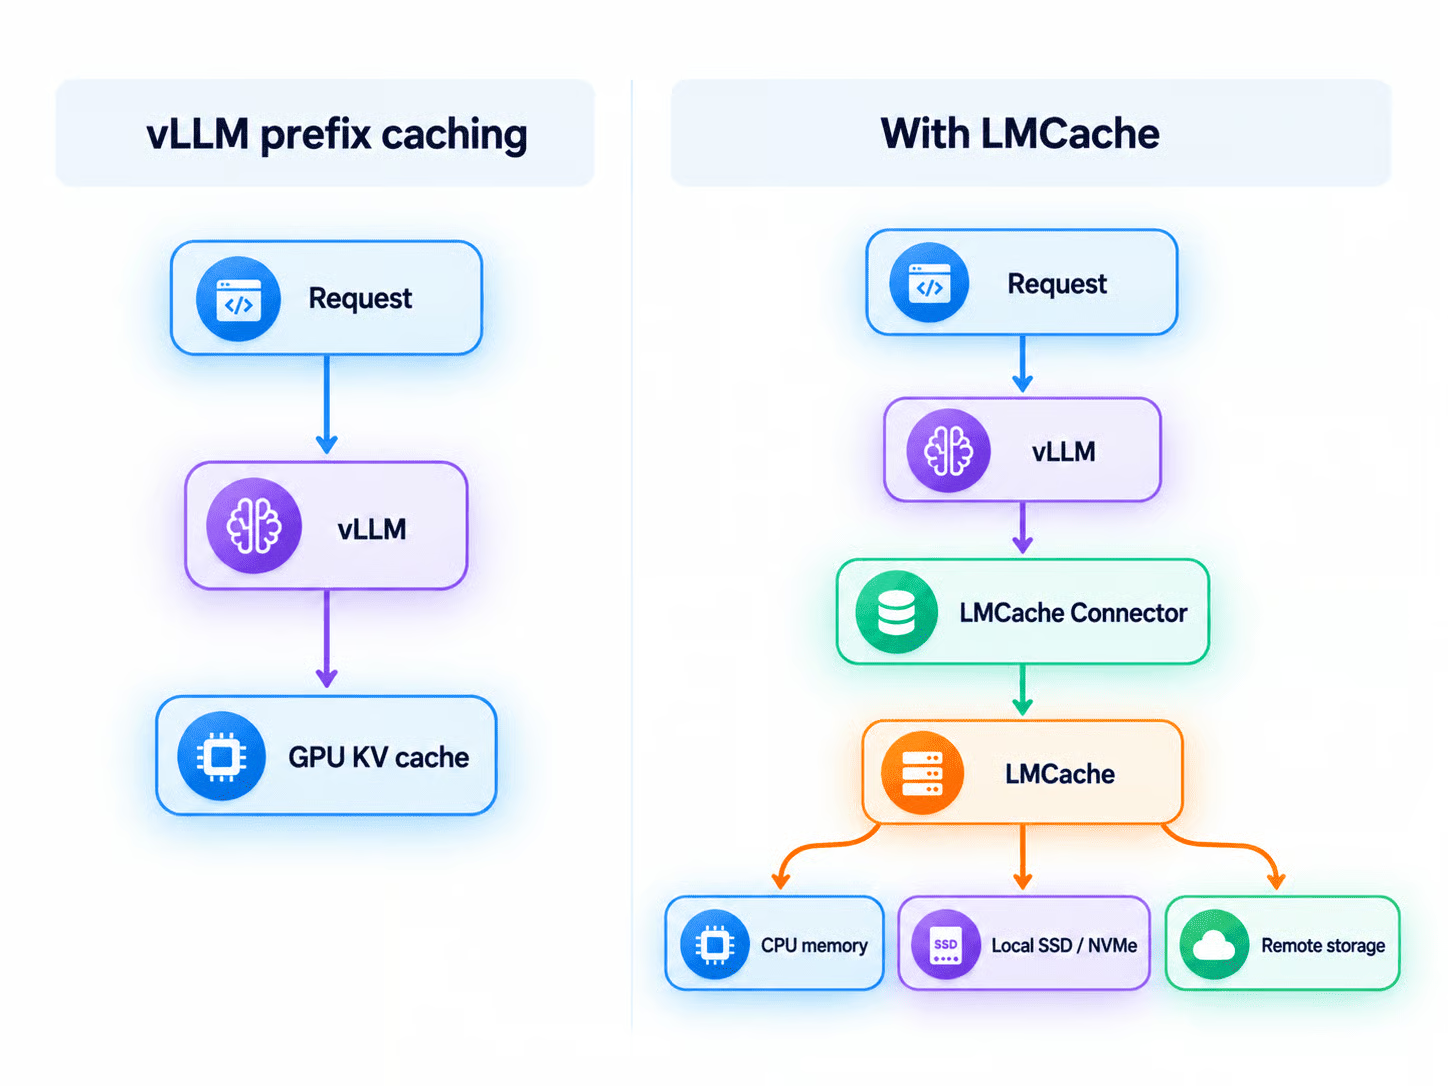
चित्र 3: vLLM प्रीफिक्स कैशिंग बनाम LMCache। LMCache एक कैशिंग लेयर जोड़ता है जो GPU मेमोरी तक सीमित रहने के बजाय KV स्टेट्स को CPU मेमोरी, लोकल SSD/NVMe, और रिमोट स्टोरेज में टियर करता है।
तो LMCache vLLM में KV कैशिंग की अवधारणा को बदल नहीं रहा है। यह इन्फरेंस इंजन की सामान्य सीमा से परे KV-कैश मैनेजमेंट का विस्तार करता है।
LMCache सिर्फ एक सिंपल इन-मेemory कैश से अधिक प्रदान करता है। इसे विभिन्न स्टोरेज टियर्स और इन्फरेंस वर्कर्स में KV स्टेट्स को स्टोर, मूव और री-यूज़ करने के लिए डिज़ाइन किया गया है।
LMCache की मुख्य विशेषता है पहले से कंप्यूट किए गए KV स्टेट्स को फिर से मॉडल से गुज़ारने के बजाय री-यूज़ करना।
यह विशेष रूप से तब उपयोगी है जब रिक्वेस्ट्स बार-बार वही या मिलता-जुलता संदर्भ शामिल करती हैं, जैसे:
कैश्ड KV स्टेट्स को री-यूज़ करके, LMCache दोहराए जाने वाले प्रीफिल कम्प्यूटेशन को कम कर सकता है और पहले टोकन तक का समय सुधार सकता है।
GPU मेमोरी सीमित और महंगी होती है, खासकर लंबी संदर्भ-लंबाई के साथ काम करते समय।
LMCache KV स्टेट्स को GPU मेमोरी से आगे बढ़ाकर कई टियर्स—जैसे CPU मेमोरी, लोकल SSD या NVMe स्टोरेज, और रिमोट/डिस्ट्रिब्यूटेड स्टोरेज—में स्टोर कर सकता है।
इससे GPU मेमोरी में पूरी तरह फिट होने की तुलना में कहीं अधिक री-यूज़ेबल संदर्भ उपलब्ध रखना संभव हो जाता है, जबकि ज़रूरत पड़ने पर अक्सर उपयोग होने वाले KV स्टेट्स को वापस GPU पर लाया जा सकता है।
LMCache कैश्ड KV स्टेट्स को कई इन्फरेंस वर्कर्स में उपलब्ध करा सकता है, बजाय इसके कि उन्हें एक ही मॉडल प्रोसेस से बंधा रखा जाए।
उदाहरण के लिए, यदि एक vLLM वर्कर एक लंबा डॉक्यूमेंट प्रोसेस करता है, तो दूसरा वर्कर वही संदर्भ दोबारा कंप्यूट करने की बजाय कैश्ड KV स्टेट्स को री-यूज़ कर सकता है।
यह डिस्ट्रिब्यूटेड सर्विंग, मल्टी-GPU डिप्लॉयमेंट्स, और ऐसी ऐप्लिकेशनों के लिए खास तौर पर उपयोगी है जहाँ रिक्वेस्ट्स कई इन्फरेंस रेप्लिकाज़ में रूट होती हैं।
LMCache vLLM के साथ उसके KV कनेक्टर इंटरफ़ेस के माध्यम से इंटीग्रेट होता है।
एप्लिकेशन सामान्य OpenAI-कम्पैटिबल vLLM एंडपॉइंट के साथ संवाद जारी रख सकता है, जबकि LMCache इन्फरेंस लेयर के नीचे काम करता है।
इसका अर्थ है कि मौजूदा ऐप्लिकेशनों को प्रॉम्प्ट भेजने या रिस्पॉन्स पाने के तरीके बदलने की ज़रूरत नहीं है। LMCache vLLM और कॉन्फ़िगर किए गए कैश बैकएंड के बीच KV स्टोरेज और रिट्रीवल संभालता है।
LMCache vLLM से अलग एक प्रोसेस के रूप में चल सकता है।
हर इन्फरेंस वर्कर के अंदर कैश मैनेजमेंट रखने के बजाय, एक समर्पित LMCache सर्वर KV स्टेट्स को स्वतंत्र रूप से मैनेज कर सकता है और कई vLLM प्रोसेसेज़ को सर्व कर सकता है।
यह मॉडल सर्विंग से कैश मैनेजमेंट को अलग करता है, कई वर्कर्स को वही कैश शेयर करने देता है, और कैश क्षमता को GPU इन्फरेंस संसाधनों से स्वतंत्र रूप से स्केल करना आसान बनाता है।
पारंपरिक प्रीफिक्स कैशिंग तब सबसे बेहतर काम करती है जब रिक्वेस्ट्स एक ही प्रॉम्प्ट शुरुआत साझा करती हैं.
LMCache CacheBlend भी प्रदान करता है उन वर्कलोड्स के लिए जहाँ री-यूज़ेबल सामग्री अलग-अलग पोज़िशन पर आ सकती है।
उदाहरण के लिए, एक RAG एप्लिकेशन अलग-अलग प्रश्नों के लिए वही डॉक्यूमेंट्स अलग क्रम में रिट्रीव कर सकता है.
CacheBlend पहले से कंप्यूट किए गए KV स्टेट्स के हिस्सों को री-यूज़ कर सकता है, जबकि नए संदर्भ पर निर्भर टोकन्स को चयनात्मक रूप से फिर से कंप्यूट करता है।
यह KV री-यूज़ को RAG, मल्टी-डॉक्यूमेंट ऐप्लिकेशनों, और एजेंटिक वर्कफ़्लोज़ के लिए अधिक उपयोगी बनाता है, जहाँ प्रॉम्प्ट्स अक्सर फिर से व्यवस्थित किए जाते हैं।
LMCache अलग प्रीफिल और डिकोड वर्कर्स के बीच KV स्टेट्स ट्रांसफ़र करने में भी मदद कर सकता है।
इस आर्किटेक्चर में, GPU का एक समूह कंप्यूट-इंटेंसिव प्रॉम्प्ट प्रोसेसिंग स्टेज संभालता है, जबकि दूसरा समूह टोकन जनरेशन संभालता है.
LMCache वह लेयर प्रदान करता है जिसका उपयोग उनके बीच परिणामी KV स्टेट्स को मूव करने के लिए किया जाता है।
यह प्रीफिल और डिकोडिंग संसाधनों को स्वतंत्र रूप से स्केल करने की अनुमति देता है और बड़े इन्फरेंस डिप्लॉयमेंट्स में GPU उपयोग में सुधार कर सकता है।
अब जब हम समझ गए हैं कि LMCache कैसे काम करता है, तो आइए इसे vLLM से कनेक्ट करें—एक हाई-परफ़ॉर्मेंस LLM इन्फरेंस इंजन जिसे कुशल सर्विंग और मेमोरी मैनेजमेंट के लिए डिज़ाइन किया गया है।
इस गाइड के लिए, मैं IBM Granite 4.2 3B का उपयोग करूंगा—एक कॉम्पैक्ट मॉडल जो अपने आकार के लिए मज़बूत परफ़ॉर्मेंस देता है और प्रैक्टिकल टेस्टिंग के लिए पर्याप्त हल्का रहता है।
हम LMCache को vLLM के साथ मल्टीप्रोसेस मोड में चलाएंगे और सत्यापित करेंगे कि KV स्टेट्स रिक्वेस्ट्स के बीच री-यूज़ हो सकते हैं।
इस ट्यूटोरियल के लिए, हम Python 3.12, uv, vLLM, LMCache, OpenAI Python क्लाइंट, pandas, और matplotlib का उपयोग करेंगे।
शुरू करने से पहले, सुनिश्चित करें कि आपके पास ये हैं:
आप uv को इस तरह इंस्टॉल कर सकते हैं:
curl -LsSf https://astral.sh/uv/install.sh | shफिर प्रोजेक्ट बनाएं:
mkdir lmcache-tutorial
cd lmcache-tutorial
Python 3.12 वर्चुअल एनवायरनमेंट बनाएं और सक्रिय करें:
uv venv --python 3.12
source .venv/bin/activate
आवश्यक डिपेंडेंसी इंस्टॉल करें:
uv pip install -U \
    "lmcache==0.5.4" \
    "vllm==0.28.0" \
    openai \
    pandas \
    matplotlib \
    --torch-backend=cu130
यहाँ, हम cu130 का उपयोग कर रहे हैं क्योंकि हमारा वातावरण CUDA 13 के साथ सेटअप है.
यदि आप अलग CUDA वर्ज़न इस्तेमाल कर रहे हैं, तो --torch-backend का मान अपने वातावरण के कम्पैटिबल PyTorch बैकएंड में बदलें।
Granite 4.2 एक कस्टम रीजनिंग पार्सर उपयोग करता है, इसलिए उसे Hugging Face से डाउनलोड करें:
hf download ibm-granite/granite-4.2-3b \
    granite_thinking_parser.py \
    --local-dir .
अंत में, सत्यापित करें कि आपका GPU और CUDA इंस्टॉलेशन डिटेक्ट हो रहा है:
nvidia-smi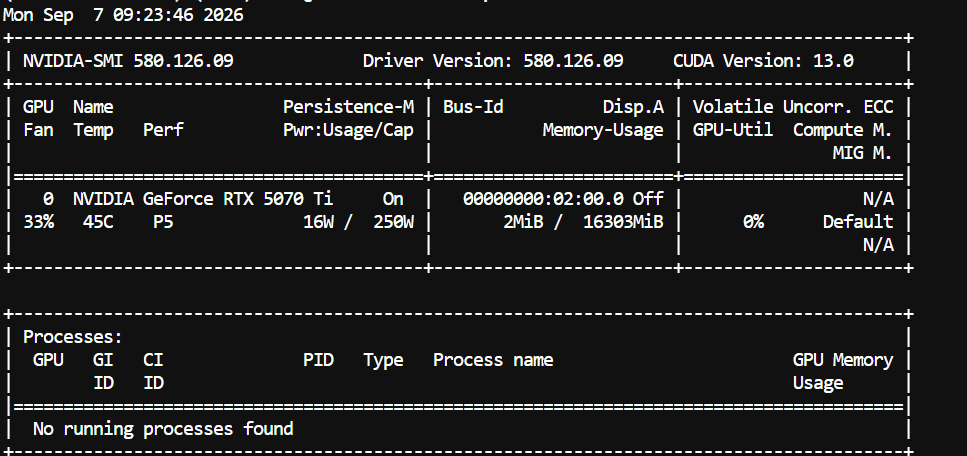
इस ट्यूटोरियल के लिए, हम 16 GB VRAM वाले NVIDIA GeForce RTX 5070 Ti का उपयोग कर रहे हैं.
सिस्टम NVIDIA ड्राइवर 580.126.09 पर चल रहा है, जिसमें CUDA 13.0 का समर्थन है.
हमें दो रनिंग प्रोसेस चाहिए: एक LMCache सर्वर के लिए और दूसरा vLLM के लिए।
पहले टर्मिनल में LMCache शुरू करें:
lmcache server \
    --host localhost \
    --port 6555 \
    --http-port 8081 \
    --l1-size-gb 20 \
    --eviction-policy LRU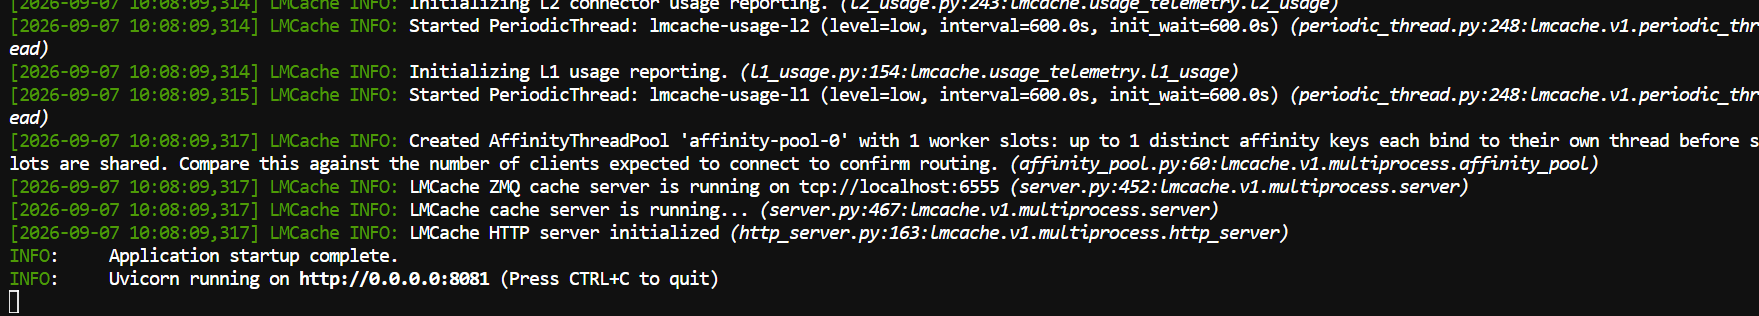
यहाँ, हम उपयोग करते हैं:
6555 808120 GBLRUइस टर्मिनल को चालू रखें।
दूसरा टर्मिनल खोलें, वही वर्चुअल एनवायरनमेंट सक्रिय करें, और यदि एक्सपैंडेबल CUDA अलोकेटर कॉन्फ़िगरेशन सक्षम है तो उसे अनसेट कर दें:
cd lmcache-tutorial
source .venv/bin/activate
unset PYTORCH_CUDA_ALLOC_CONF
अब LMCache कनेक्टर के साथ vLLM शुरू करें:
vllm serve ibm-granite/granite-4.2-3b \
  --served-model-name granite-4.2-3b \
  --dtype bfloat16 \
  --max-model-len 65536 \
  --kv-cache-dtype fp8 \
  --gpu-memory-utilization 0.90 \
  --enforce-eager \
  --max-num-seqs 1 \
  --max-num-batched-tokens 2048 \
  --no-enable-prefix-caching \
  --reasoning-parser granite_thinking_parser \
  --reasoning-parser-plugin "$(pwd)/granite_thinking_parser.py" \
  --tool-call-parser qwen3_coder \
  --enable-auto-tool-choice \
  --port 8000 \
  --kv-transfer-config \
  '{
    "kv_connector":"LMCacheMPConnector",
    "kv_connector_module_path":"lmcache.integration.vllm.lmcache_mp_connector",
    "kv_role":"kv_both",
    "kv_connector_extra_config":{
      "lmcache.mp.host":"tcp://localhost",
      "lmcache.mp.port":6555,
      "lmcache.mp.mp_transfer_mode":"lmcache_driven"
    }
  }'
हम vLLM की बिल्ट-इन प्रीफिक्स कैशिंग को इस तरह डिसेबल करते हैं:
--no-enable-prefix-cachingइससे निम्नलिखित प्रयोग विशेष रूप से LMCache के माध्यम से KV री-यूज़ पर फोकस कर सकते हैं।
vLLM लोडिंग पूरी होने पर, मॉडल अपने OpenAI-कम्पैटिबल एंडपॉइंट के माध्यम से उपलब्ध होता है:
http://localhost:8000/v1अब हम एक सरल नियंत्रित प्रयोग करेंगे ताकि पुष्टि हो सके कि LMCache काम कर रहा है।
हम एक बड़ा साझा प्रीफिक्स बनाएंगे, कैश को क्लियर करेंगे, प्रीफिक्स को एक बार भेजकर LMCache पॉप्युलेट करेंगे, और फिर उसी प्रीफिक्स के साथ लेकिन अलग प्रश्न वाली दूसरी रिक्वेस्ट भेजेंगे।
पहले OpenAI क्लाइंट बनाएँ:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local",
)
इसके बाद, एक लंबा साझा डॉक्यूमेंट बनाएँ:
base_text = """
Large language model inference consists of two main stages:
prefill and decoding.

During prefill, the model processes the input sequence and calculates
the key and value tensors used by the attention mechanism.

During autoregressive decoding, these tensors are reused so the model
does not need to recompute attention states for every previous token.

KV cache management is therefore an important part of modern LLM
serving infrastructure, particularly for long-context applications.
"""

document = base_text * 500

SYSTEM_PROMPT = f"""
You are a technical assistant.

Use only the following document to answer the user's question.

DOCUMENT:

{document}
"""
डॉक्यूमेंट को 500 बार दोहराने से हमारे पास इतना बड़ा साझा प्रीफिक्स बन जाता है कि KV री-यूज़ का प्रभाव स्पष्ट दिख सके।
पहली रिक्वेस्ट भेजने से पहले, LMCache को क्लियर करें ताकि हम खाली कैश से शुरू करें:
import subprocess
import time

subprocess.run(
    [
        "lmcache",
        "kvcache",
        "clear",
        "--url",
        "http://localhost:8081",
    ],
    check=True,
)

time.sleep(0.5)
यह सुनिश्चित करता है कि पहली रिक्वेस्ट एक कोल्ड-कैश रिक्वेस्ट हो और किसी पुराने टेस्ट से बचे हुए KV स्टेट्स री-यूज़ न कर सके।
अब पहली रिक्वेस्ट भेजें:
prompt_1 = SYSTEM_PROMPT + """

Question:
Explain the purpose of the KV cache.
"""

start = time.perf_counter()

client.completions.create(
    model="granite-4.2-3b",
    prompt=prompt_1,
    max_tokens=100,
    temperature=0,
)

latency_1 = time.perf_counter() - start
यह कैश-वार्मिंग रिक्वेस्ट है। vLLM को प्रीफिल के दौरान लंबे साझा प्रीफिक्स को प्रोसेस करना पड़ता है, जबकि LMCache परिणामी KV स्टेट्स को स्टोर करता है।
इसके बाद, साझा प्रीफिक्स को बिल्कुल वैसा ही रखें और केवल प्रश्न बदलें:
prompt_2 = SYSTEM_PROMPT + """

Question:
Explain what happens during prefill.
"""

start = time.perf_counter()

client.completions.create(
    model="granite-4.2-3b",
    prompt=prompt_2,
    max_tokens=100,
    temperature=0,
)

latency_2 = time.perf_counter() - start
क्योंकि बड़ा प्रीफिक्स अपरिवर्तित है, LMCache पहली रिक्वेस्ट द्वारा जेनरेट किए गए KV स्टेट्स को फिर से पूरे प्रीफिक्स को कंप्यूट करने के बजाय री-यूज़ कर सकता है।
अंत में, दोनों रिक्वेस्ट टाइम की तुलना करें:
print(f"Cold request:   {latency_1:.3f}s")
print(f"Warm request:   {latency_2:.3f}s")
print(f"Speedup:        {latency_1 / latency_2:.2f}x")

print(
    f"Latency saved:  "
    f"{((latency_1 - latency_2) / latency_1) * 100:.1f}%"
)
मेरे रन ने यह आउटपुट दिया:
Cold request:   26.276s
Warm request:   4.402s
Speedup:        5.97x
Latency saved:  83.2%
वार्म रिक्वेस्ट लगभग 6× तेज़ पूरी हुई, जिससे एंड-टू-एंड लेटेंसी में 83.2% की कमी आई।
प्रश्न अलग हैं, इसलिए LMCache अंतिम रिस्पॉन्स को कैश नहीं कर रहा है। बल्कि, यह साझा प्रीफिक्स के लिए जनरेट किए गए KV स्टेट्स को री-यूज़ कर रहा है।
पहली रिक्वेस्ट को प्रीफिल के दौरान पूरे लंबे प्रीफिक्स को प्रोसेस करना पड़ता है और वे KV स्टेट्स शुरू से बनाने पड़ते हैं.
दूसरी रिक्वेस्ट पर, LMCache मिलते-जुलते कैश्ड स्टेट्स रिट्रीव करता है, जिससे vLLM उस दोहराए जाने वाले प्रीफिल काम का अधिकांश भाग स्किप कर सके और केवल नए सफिक्स पर ध्यान दे।
यह पुष्टि करता है कि LMCache सफलतापूर्वक साझा प्रीफिक्स को री-यूज़ कर रहा है.
LMCache विशेष रूप से तब उपयोगी है जब कोई एप्लिकेशन बार-बार बड़ी मात्रा में एक जैसी संदर्भ-सामग्री भेजता है।
कुछ सामान्य उदाहरण हैं:
एक उपयोगकर्ता उसी रिट्रीव किए गए डॉक्यूमेंट के बारे में कई प्रश्न पूछ सकता है।
हर प्रश्न के लिए पूरे डॉक्यूमेंट को शुरू से प्रोसेस करने के बजाय, उसके KV स्टेट्स को री-यूज़ किया जा सकता है।
कोडिंग असिस्टेंट अक्सर हर मॉडल कॉल के साथ रिपॉज़िटरी फ़ाइलें, प्रोजेक्ट निर्देश और अन्य बड़े संदर्भ भेजते हैं।
उस संदर्भ का बड़ा हिस्सा कार्य बदलने पर भी समान रहता है।
एजेंट अक्सर बड़े सिस्टम प्रॉम्प्ट, टूल डेफ़िनिशन, मेमोरी, निर्देश, और एनवायरनमेंट स्टेट को कई चरणों में री-यूज़ करते हैं।
लंबे समय तक चलने वाली बातचीत हर नए संदेश के साथ अपने इतिहास के एक बड़े हिस्से को बार-बार भेज सकती है।
कई एजेंट समान बैकग्राउंड डॉक्यूमेंट्स या सिस्टम संदर्भ साझा कर सकते हैं जबकि अलग-अलग कार्यों पर काम कर रहे हों।
इन सभी मामलों में, मॉडल बार-बार उसे जानकारी दिखा रहा है जिसे वह पहले की रिक्वेस्ट्स के दौरान प्रोसेस कर चुका है।
LMCache उस काम को KV-कैश स्तर पर री-यूज़ करने का तरीका प्रदान करता है।
LMCache प्रीफिल के दौरान बनाए गए KV स्टेट्स को री-यूज़ेबल बनाकर लंबी संदर्भ-लंबाई वाली इन्फरेंस में होने वाली बड़ी बर्बादी को संबोधित करता है.
एक ही साझा संदर्भ को बार-बार प्रोसेस करने के बजाय, मॉडल उस काम को री-यूज़ कर सकता है जो वह पहले ही कर चुका है।
हमने इस ट्यूटोरियल में बेंचमार्क कोड या विस्तृत परिणाम शामिल नहीं किए हैं, लेकिन हमने उसी सेटअप का उपयोग करके अलग से कुछ टेस्ट चलाए थे.
परिणाम उल्लेखनीय थे। बड़े साझा प्रीफिक्स को री-यूज़ करने से कुल रिक्वेस्ट लेटेंसी 26.276 सेकंड से 4.386 सेकंड तक कम हो गई.
पहले टोकन तक का औसत समय 22.149 सेकंड से 0.726 सेकंड तक गिरा—यानी 30.54× सुधार। लाभ संदर्भ आकार के साथ बढ़े—लगभग 12,000 साझा कैरेक्टर्स पर 3.55× से लेकर लगभग 245,000 कैरेक्टर्स पर 30.22× तक.
सरल शब्दों में, जितना अधिक संदर्भ री-यूज़ किया जा सकता है, LMCache उतना ही अधिक काम बचा सकता है।
DeepSeek इस बात का एक अच्छा वास्तविक उदाहरण है कि यह क्यों महत्वपूर्ण है।
इसकी कैशिंग प्रणाली मेल खाते प्रॉम्प्ट प्रीफिक्स को री-यूज़ कर सकती है, जो विशेष रूप से उन कोडिंग एजेंट्स के लिए मूल्यवान है जो बार-बार वही सिस्टम प्रॉम्प्ट, टूल्स, बातचीत का इतिहास और कोड संदर्भ भेजते हैं.
उच्च कैश-हिट रेट का मतलब है कम दोहराया हुआ कम्प्यूटेशन और प्रदाता व उपयोगकर्ता दोनों के लिए कम लागत।
इस गाइड से मुख्य सीख यह है कि तेज़ LLM इन्फरेंस केवल बेहतर GPUs या तेज़ टोकन जनरेशन के बारे में नहीं है। यह बेमतलब का दोहराव टालने के बारे में भी है.
RAG सिस्टम, कोडिंग असिस्टेंट्स, एजेंट्स, और अन्य लंबी संदर्भ-लंबाई वाली एप्लिकेशनों के लिए, री-यूज़ेबल KV कैशिंग लेटेंसी सुधारने, GPU उपयोग घटाने, और इन्फरेंस लागत कम करने का एक महत्वपूर्ण हिस्सा हो सकती है।
टॉप DataCamp कोर्स
लर्निंग पाथ
कोर्स
कोर्स