
Kursus
Model Transformer dengan PyTorch
2 jam
9.2K
Inferensi Large Language Models (LLM) kini telah menjadi keahlian tersendiri.
Perusahaan semakin mencari engineer inferensi LLM dan MLOps yang dapat melayani model lebih cepat, menggunakan lebih sedikit perangkat keras, dan menurunkan biaya inferensi.
Baik Anda menjalankan model secara lokal, menerapkan server inferensi, atau bereksperimen dengan LLM open-source, memahami cara kerja inferensi dapat membuat perbedaan besar.
Di balik inferensi LLM yang efisien terdapat tumpukan teknik lengkap, termasuk kuantisasi, optimasi KV-cache, continuous batching, kernel atensi yang dioptimalkan, speculative decoding, dan penyesuaian yang sadar perangkat keras.
Banyak kerangka inferensi modern mengaktifkan sebagian dari ini secara otomatis, yang berarti Anda mungkin sudah merasakan manfaatnya tanpa sepenuhnya memahami apa yang terjadi di balik layar.
Dalam panduan ini, saya akan mengulas dasar-dasar inferensi LLM, metrik kinerja terpenting, kerangka serving populer, dan teknik praktis untuk membuat model lebih cepat, lebih hemat memori, dan lebih murah dijalankan.
Kita mulai dari dasar: apa itu inferensi, bagaimana inferensi bekerja, bagaimana kinerja diukur, dan mengapa arsitektur model penting.
Inferensi LLM terjadi setiap kali Anda mengirim sebuah prompt ke model bahasa dan menunggu respons. Model memproses masukan melalui lapisannya lalu menghasilkan keluaran token demi token.
Ini berbeda dari pelatihan. Selama pelatihan, model belajar dari data dan memperbarui bobotnya. Saat inferensi, bobot tersebut tetap, dan model terlatih hanya digunakan untuk menghasilkan prediksi.
Inferensi adalah tempat sebagian besar biaya komputasi LLM terjadi di produksi.
Sebuah model mungkin hanya dilatih sekali, tetapi menangani jutaan permintaan. Itu menjadikan efisiensi inferensi salah satu masalah rekayasa paling krusial dalam AI terapan saat ini.
Memahami cara kerja inferensi pada tingkat teknis penting karena bottleneck-nya tidak selalu jelas.
Perangkat keras yang lebih cepat tidak selalu berarti respons lebih cepat. Model yang lebih besar tidak selalu lebih lambat. Arsitektur model, panjang masukan, ukuran batch, dan infrastruktur serving semuanya saling memengaruhi dengan cara yang patut dipahami sebelum Anda mulai mengoptimalkan.
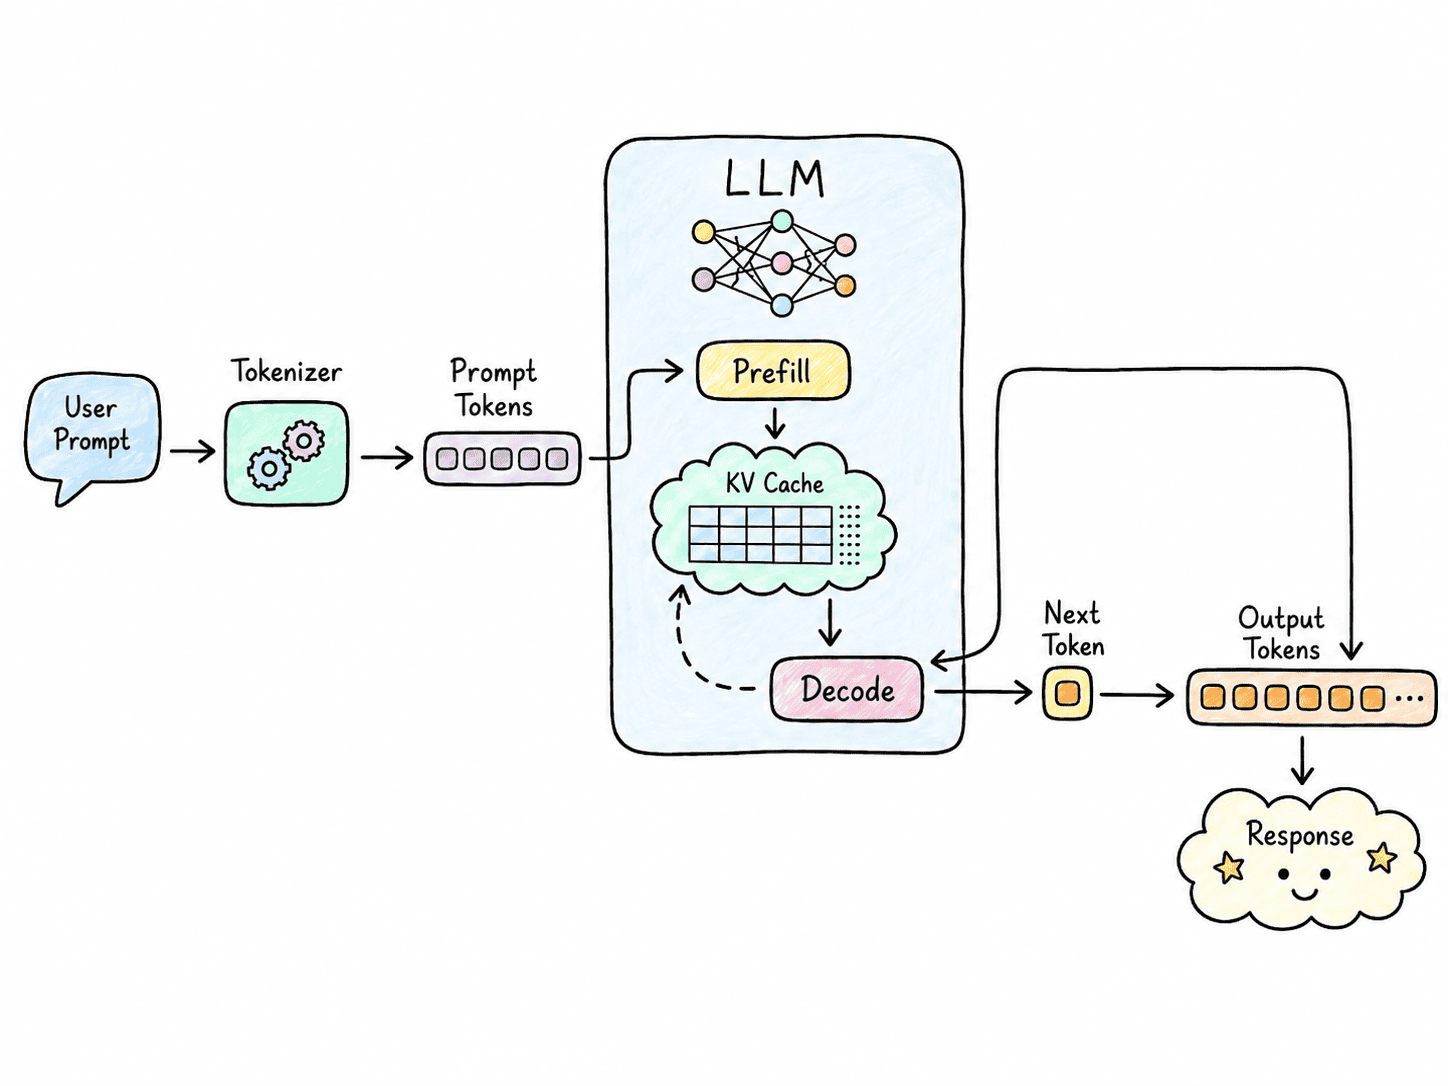
Untuk sebagian besar LLM berbasis decoder, inferensi terdiri dari dua fase utama: prefill dan decode.
Pada ukuran batch yang lebih kecil, decoding seringkali lebih dibatasi oleh bandwidth memori daripada kemampuan komputasi GPU mentah karena bobot model dan status atensi yang di-cache harus terus-menerus dibaca dari memori.
Pembedaan ini penting karena optimasi yang meningkatkan kinerja prefill belum tentu meningkatkan kinerja decoding.
Tidak ada satu metrik pun yang memberi tahu kita apakah server inferensi cepat, efisien, atau hemat biaya. Metrik-metrik ini membantu mengidentifikasi bottleneck, membandingkan konfigurasi serving, dan menentukan apakah suatu optimasi benar-benar meningkatkan kinerja.
Beberapa metrik terpenting meliputi:
Tingkat hit cache bisa sangat penting di produksi. Sistem agentik sering menggunakan ulang sistem prompt yang besar, definisi alat, prefiks percakapan, atau dokumen.
Jika 95% atau lebih dari masukan tersebut dapat dilayani dari cache, perhitungan prefill berulang dapat dikurangi secara signifikan, memperbaiki latensi dan menurunkan biaya efektif untuk melayani permintaan tersebut.
Metrik-metrik ini saling berkaitan erat.
Batch yang lebih besar dan konkruensi yang lebih tinggi dapat meningkatkan throughput dan utilisasi GPU, tetapi dapat meningkatkan latensi bagi pengguna individu.
Demikian pula, menurunkan presisi dapat menurunkan penggunaan memori dan kebutuhan perangkat keras, tetapi mungkin tidak meningkatkan kecepatan generasi jika perangkat keras tidak memiliki kernel yang dioptimalkan untuk format tersebut.
Tujuannya bukan memaksimalkan satu metrik, melainkan menemukan keseimbangan yang tepat antara latensi, throughput, utilisasi, dan biaya untuk beban kerja Anda.
Kinerja inferensi sangat dipengaruhi oleh arsitektur model itu sendiri.
Sebuah transformer dens pada dasarnya menggunakan semua parameternya untuk setiap token. Sebuah model Mixture-of-Experts (MoE), sebaliknya, berisi banyak expert tetapi hanya mengaktifkan sebagian kecil untuk setiap token.
Ini dapat mengurangi jumlah komputasi per token, tetapi juga menghadirkan tantangan seperti perutean expert, penyeimbangan beban, komunikasi GPU, dan penempatan expert.
Arsitektur atensi juga sangat memengaruhi penggunaan memori dan kecepatan inferensi.
Multi-Head Attention (MHA) tradisional menyimpan representasi key dan value terpisah untuk setiap head atensi, yang dapat membuat KV-cache besar.
Multi-Query Attention (MQA) mengurangi kebutuhan memori ini dengan memungkinkan beberapa head query berbagi key dan value yang sama.
Grouped-Query Attention (GQA) berada di antara keduanya, dengan kelompok head query berbagi representasi key-value. Arsitektur yang lebih baru dapat menggunakan teknik seperti Multi-head Latent Attention (MLA), yang memampatkan representasi ini lebih jauh lagi.
Inilah mengapa dua model dengan jumlah parameter serupa dapat berperilaku sangat berbeda saat inferensi.
Arsitekturnya dapat secara signifikan memengaruhi kebutuhan komputasi, ukuran KV-cache, penggunaan memori, dan kecepatan generasi.
Selanjutnya, kita akan melihat kerangka yang paling banyak digunakan untuk menjalankan LLM, dari penyiapan lokal hingga sistem produksi skala besar.
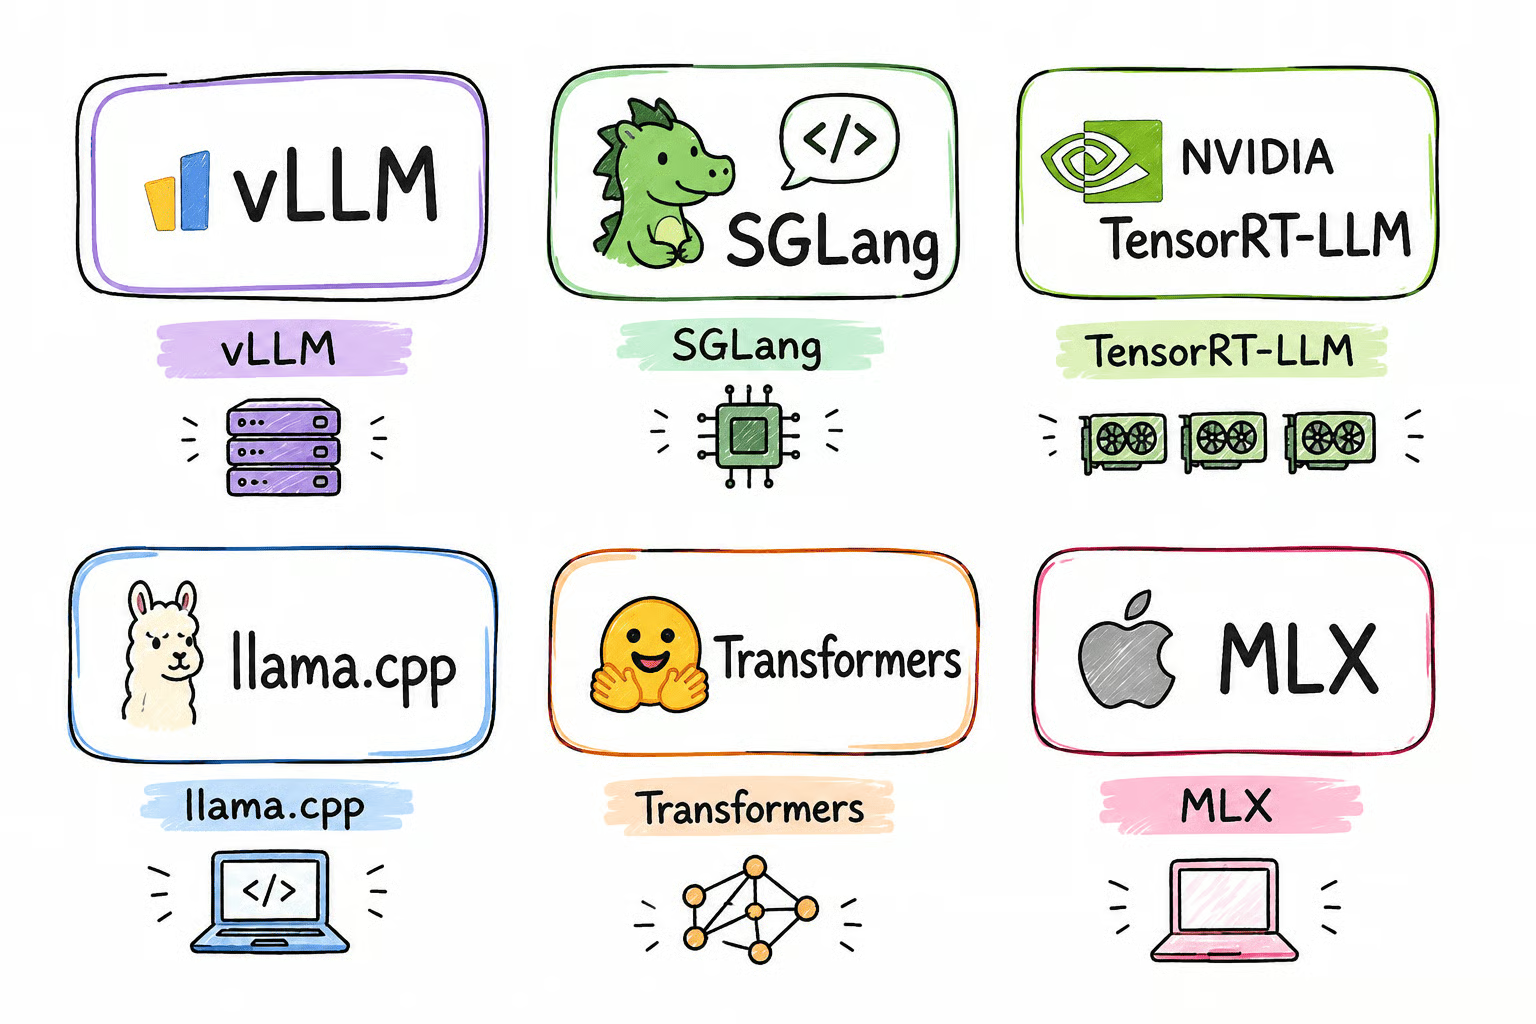
vLLM adalah salah satu mesin inferensi serbaguna yang paling banyak digunakan. Ini mendukung continuous batching, PagedAttention, prefill bertahap (chunked), prefix caching, kuantisasi, speculative decoding, kernel atensi yang dioptimalkan, dan inferensi terdistribusi.
SGLang berfokus pada generasi berkinerja tinggi dan penjadwalan permintaan yang efisien. Ini sangat berguna untuk agen, model penalaran, konteks berulang, keluaran terstruktur, dan beban kerja generasi kompleks lainnya.
TensorRT-LLM adalah tumpukan inferensi yang dioptimalkan oleh NVIDIA. Ia memanfaatkan fitur GPU NVIDIA, kernel CUDA khusus, format presisi rendah, eksekusi terdistribusi, KV caching, dan batching tingkat lanjut.
llama.cpp sangat berguna untuk inferensi lokal dan terbatas sumber daya. Ia mendukung kuantisasi GGUF, inferensi hibrida CPU-GPU, dan berkas model memory-mapped, memungkinkan bobot didistribusikan antara memori GPU, RAM sistem, dan, bila perlu, memori berbasis disk.
Hal ini memungkinkan menjalankan model yang jauh lebih besar daripada VRAM yang tersedia, meskipun sangat bergantung pada disk dapat menurunkan kinerja secara signifikan.
MLX adalah kerangka inferensi dan pembelajaran mesin yang dirancang untuk Apple Silicon. Ia memanfaatkan arsitektur memori terpadu pada Mac, menjadikannya opsi yang berguna untuk menjalankan dan bereksperimen dengan LLM secara lokal di perangkat seri M.
Mulai dari kuantisasi hingga speculative decoding, bagian ini membahas teknik yang membuat inferensi lebih cepat, lebih murah, dan lebih hemat memori.
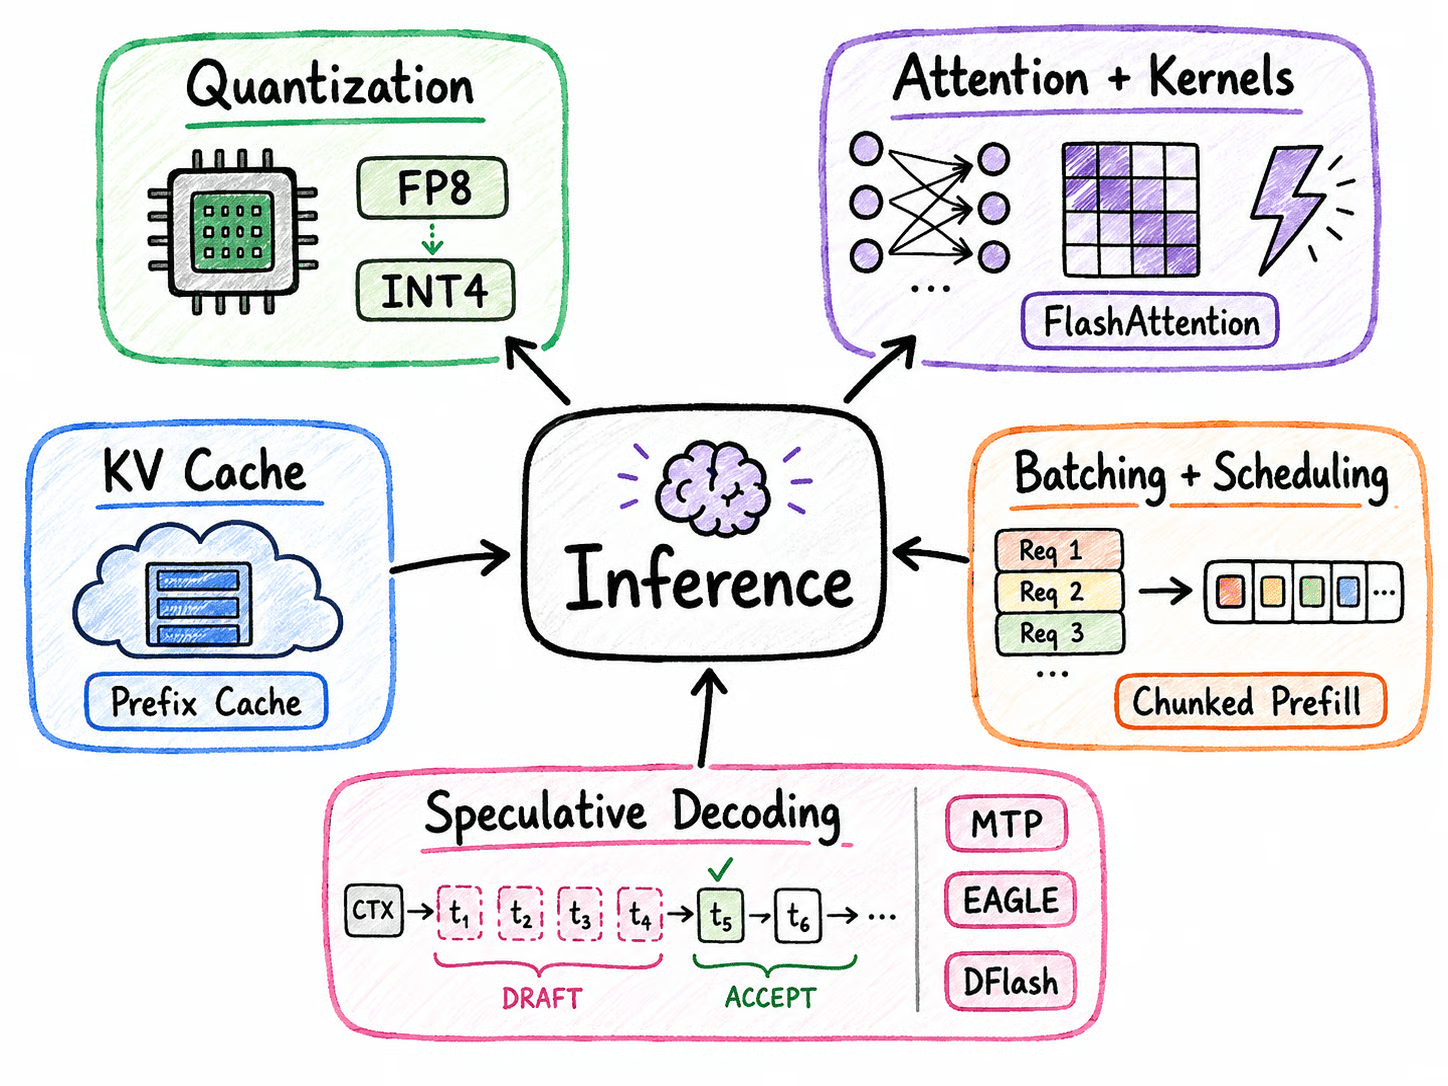
Salah satu optimasi inferensi yang paling umum adalah kuantisasi.
Model sering dilatih menggunakan presisi BF16 atau FP16.
Kuantisasi merepresentasikan bobot, aktivasi, atau cache menggunakan format numerik yang lebih kecil.
Format dan pendekatan umum meliputi:
Menurunkan presisi menurunkan konsumsi memori dan dapat mengurangi kebutuhan bandwidth memori.
Namun, lebih kecil tidak otomatis berarti lebih cepat. Kinerja sangat bergantung pada apakah perangkat keras target menyediakan kernel yang efisien untuk presisi tersebut.
KV cache juga dapat dikuantisasi, yang menjadi semakin bernilai untuk serving konteks panjang dan konkruensi tinggi.
Atensi adalah salah satu operasi terpenting di dalam transformer. Ini memungkinkan model menentukan token mana dalam konteks yang paling relevan saat menghasilkan token berikutnya.
Namun, atensi dapat menjadi mahal secara komputasi, terutama saat jendela konteks membesar.
Di sinilah kernel yang dioptimalkan menjadi penting. Kernel adalah potongan kode yang sangat dioptimalkan untuk melakukan operasi matematis tertentu pada perangkat keras seperti GPU. Alih-alih mengubah cara kerja model, kernel yang dioptimalkan membuat perhitungan yang sama berjalan lebih cepat dan menggunakan memori lebih efisien.
Contoh yang baik adalah FlashAttention. Atensi tradisional dapat menghabiskan banyak waktu untuk memindahkan hasil antara memori GPU dan unit komputasi.
FlashAttention mengurangi overhead ini dengan memproses atensi dalam blok yang lebih kecil dan menjaga lebih banyak komputasi tetap dekat dengan GPU.
Mesin inferensi modern menggunakan beberapa optimasi serupa, termasuk:
Gagasan pentingnya adalah bahwa teknik-teknik ini umumnya tidak mengubah model atau kualitas keluarannya. Mereka mengoptimalkan cara perhitungan dieksekusi, membantu mesin inferensi menghasilkan token lebih cepat dan menggunakan perangkat keras yang tersedia lebih efisien.
Selama generasi, transformer menyimpan key dan value dari token sebelumnya di KV cache.
Tanpa cache ini, model harus menghitung ulang token sebelumnya setiap kali menghasilkan token lain.
Kekurangannya adalah konsumsi memori. Konteks yang panjang dan banyak pengguna simultan dapat membuat KV cache menempati porsi besar memori GPU.
Beberapa teknik mengatasi masalah ini.
PagedAttention membagi memori KV-cache menjadi blok-blok yang dapat dikelola alih-alih membutuhkan alokasi kontigu besar.
Prefix caching memungkinkan permintaan dengan prefiks identik menggunakan ulang status KV yang dihitung sebelumnya. Ini sangat berguna untuk sistem prompt bersama, agen, dan konteks dokumen yang berulang.
Pendekatan lainnya meliputi:
Untuk sistem inferensi skala besar, manajemen KV-cache bisa sama pentingnya dengan optimasi bobot model.
Ketika server inferensi menerima banyak permintaan pada saat yang sama, ia berusaha memprosesnya bersama-sama agar GPU tetap sibuk. Ini dikenal sebagai batching.
Masalahnya, permintaan LLM jarang selesai pada waktu yang sama.
Satu pengguna mungkin menghasilkan 50 token sementara yang lain 2.000.
Dengan batching tradisional, permintaan yang lebih pendek bisa berakhir menunggu hingga permintaan terpanjang dalam batch selesai.
Continuous batching mengatasinya dengan menghapus permintaan yang selesai dan segera menggantinya dengan yang baru. Ini membuat GPU tetap bekerja alih-alih membiarkan kapasitas menganggur.
Teknik berguna lainnya adalah chunked prefill. Alih-alih memproses satu prompt yang sangat besar sekaligus, server memecahnya menjadi potongan-potongan lebih kecil agar tidak memblokir permintaan lain yang sudah menghasilkan token.
Seiring pertumbuhan trafik, inferensi menjadi masalah penjadwalan. Server harus memutuskan permintaan mana yang diproses, bagaimana mengelompokkannya, dan bagaimana menyeimbangkan memori GPU, panjang sekuens, throughput, dan latensi.
Decoding autoregresif tradisional menghasilkan token satu per satu, yang membuat generasi bersifat sekuensial secara inheren.
Speculative decoding mencoba memecahkan bottleneck ini dengan menghasilkan beberapa kandidat token secara murah lalu membiarkan model target penuh memverifikasinya secara paralel.
Jika beberapa kandidat diterima, generasi dapat maju beberapa token sekaligus tanpa mengubah distribusi keluaran model target.
Beberapa pendekatan mengikuti gagasan ini:
Gagasannya sederhana:
Hasilkan beberapa token masa depan yang mungkin secara murah, lalu verifikasi secara efisien dengan model yang lebih besar.
Speculative decoding bekerja paling baik saat token berikutnya relatif dapat diprediksi dan tingkat penerimaannya tinggi.
Ini membuatnya sangat berguna untuk pengodean dan tugas sekuensial lainnya, di mana bahkan model yang lebih kecil pun sering dapat memprediksi apa yang akan terjadi selanjutnya.
Untuk penalaran kompleks atau generasi yang sangat tidak terduga, lebih sedikit token draf yang mungkin diterima, sehingga mengurangi manfaat kinerja.
Seiring pertumbuhan model dan beban kerja, memori menjadi kendala utama. Di sini, kita akan membahas offloading, inferensi multi-GPU, serving yang terdisagregasi, dan optimasi konteks panjang.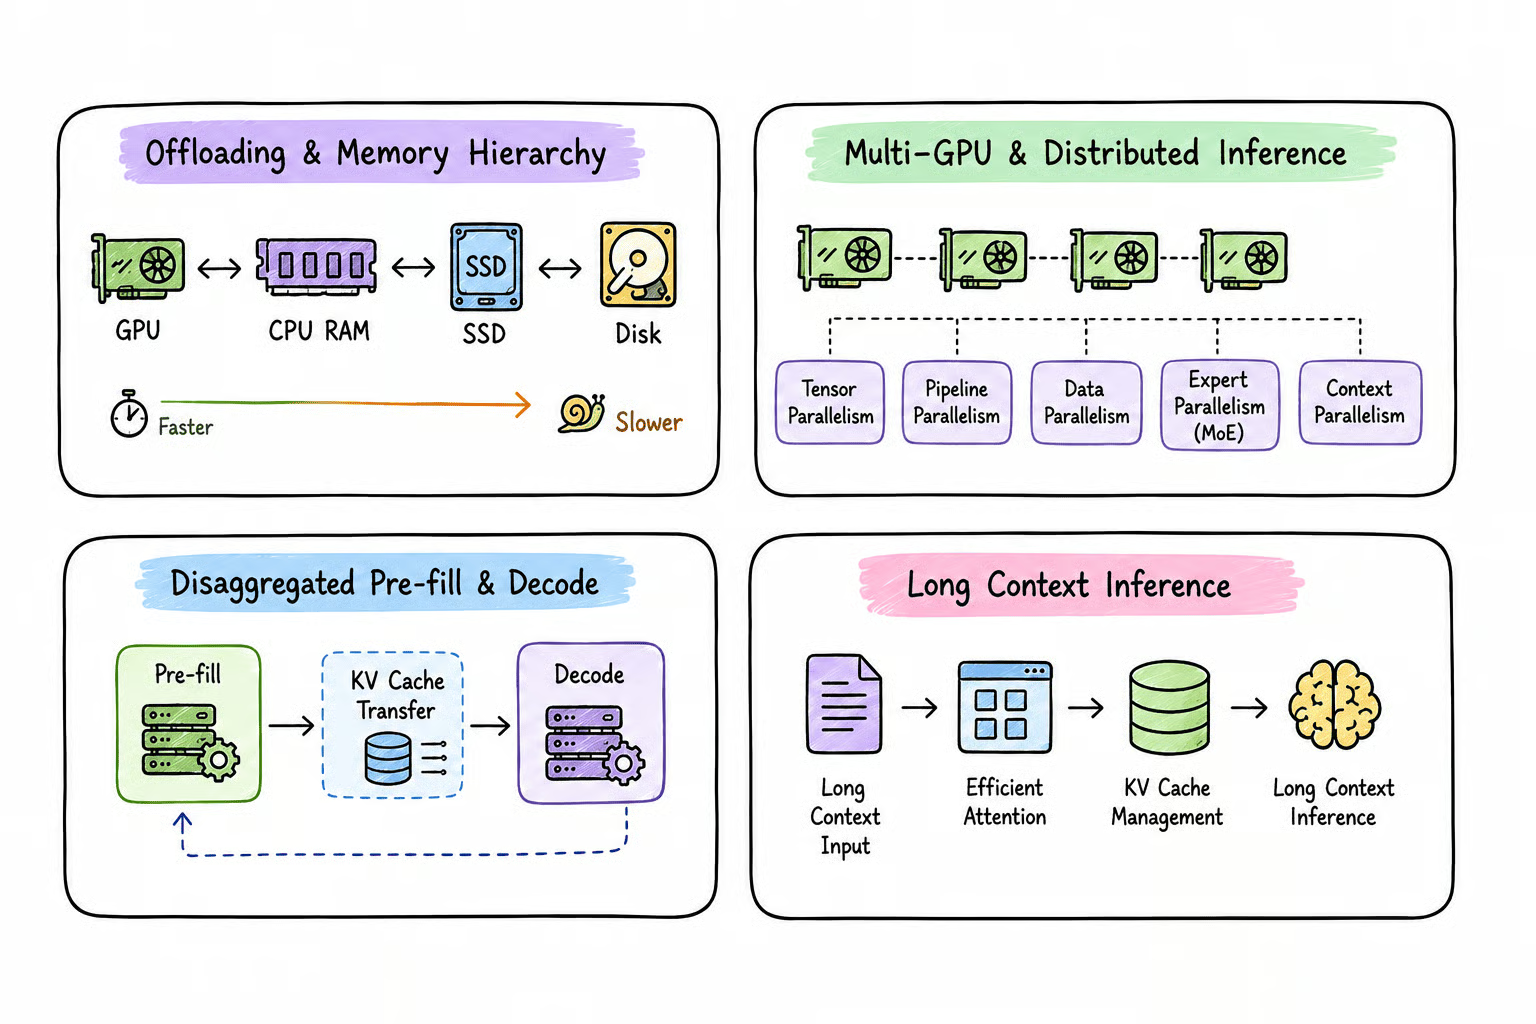
Terkadang tujuannya bukan kecepatan maksimum. Melainkan sekadar membuat model berjalan pada perangkat keras yang Anda miliki.
Sistem inferensi dapat menggunakan berbagai tingkat memori:
GPU HBM → RAM CPU → Penyimpanan NVMe
Memori GPU adalah yang tercepat tetapi juga paling terbatas.
Memori CPU menawarkan kapasitas lebih besar dengan kecepatan lebih rendah, sedangkan penyimpanan NVMe menyediakan ruang lebih banyak lagi namun jauh lebih lambat.
Jika model atau KV-cachenya tidak muat sepenuhnya di VRAM, mesin inferensi dapat memindahkan sebagian beban kerja ke tempat lain menggunakan teknik seperti:
Ini meningkatkan jumlah memori yang tersedia, tetapi biasanya disertai biaya kinerja karena data harus berpindah antar lapisan memori yang lebih lambat, sering kali melintasi PCIe.
Pertukaran dasarnya sederhana: semakin jauh data berpindah dari memori GPU, semakin banyak kapasitas yang Anda peroleh, tetapi inferensi biasanya menjadi lebih lambat.
Model yang sangat besar sering kali memerlukan beberapa akselerator.
Strategi umum meliputi:
Setelah inferensi melibatkan banyak GPU, komunikasi menjadi bottleneck penting.
Teknologi seperti NVLink, NVSwitch, dan jaringan berkecepatan tinggi karenanya dapat berdampak besar pada kinerja.
Prefill dan decode berperilaku sangat berbeda selama inferensi. Prefill biasanya intensif komputasi, karena memproses banyak token prompt secara paralel, sementara decode sering kali intensif bandwidth memori, menghasilkan token satu per satu.
Alih-alih membuat kedua tahap bersaing menggunakan GPU yang sama, sistem serving yang lebih besar dapat memisahkannya:
Prompt → Pekerja Prefill → Transfer KV Cache → Pekerja Decode → Respons
Pekerja prefill memproses prompt dan membangun KV cache, yang kemudian ditransfer ke pekerja decode khusus yang menghasilkan respons. Ini memungkinkan setiap tahap menggunakan perangkat keras, batching, dan strategi paralelisme yang berbeda.
Keuntungan utamanya adalah prefill dan decode dapat dioptimalkan dan diskalakan secara independen, membantu mengendalikan time to first token (TTFT) dan inter-token latency (ITL), terutama untuk prompt panjang dan beban kerja trafik tinggi.
Jendela konteks panjang menciptakan serangkaian tantangan inferensi yang berbeda. Seiring pertambahan masukan, prefill membutuhkan lebih banyak komputasi, sementara KV cache menjadi lebih besar, mengonsumsi memori GPU dan membuat decoding lebih mahal.
Beberapa teknik dapat membantu:
Poin pentingnya adalah bahwa mendukung jendela konteks satu juta token context window tidak berarti melayani satu juta token itu cepat, murah, atau praktis.
Konteks yang lebih panjang meningkatkan penggunaan memori, waktu hingga token pertama, dan biaya inferensi keseluruhan.
Tidak semua model berperilaku sama saat inferensi, jadi kita akan menelaah tantangan unik model MoE, generasi terstruktur, dan beban kerja penalaran.
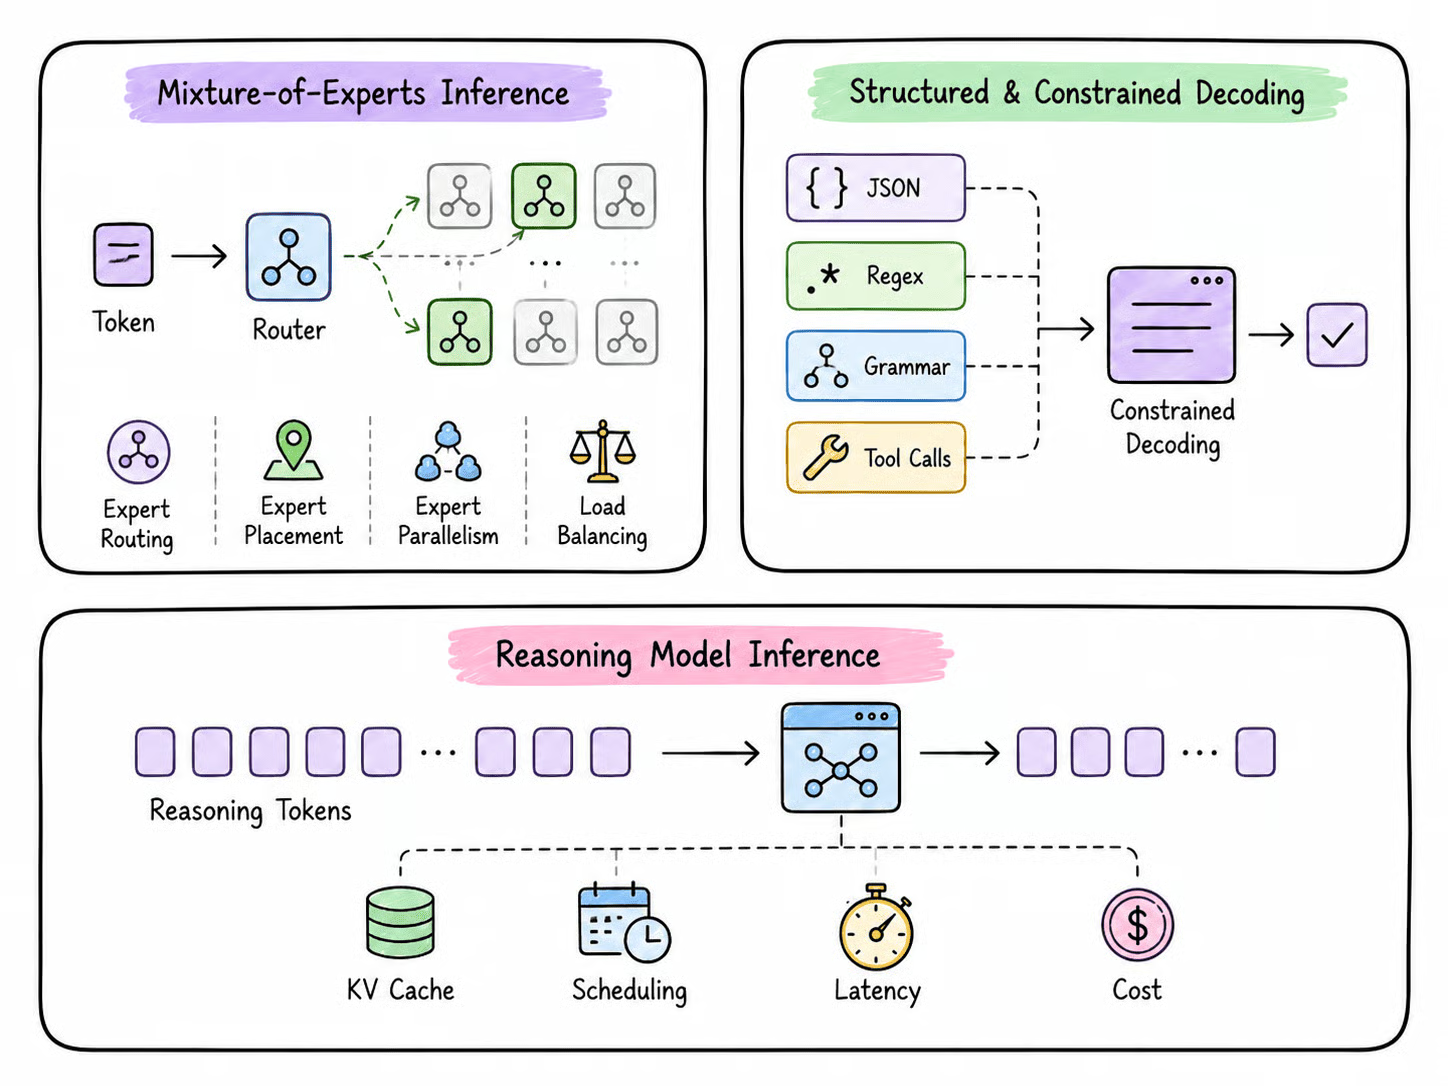
Model Mixture-of-Experts (MoE) berperilaku berbeda dari model dens. Alih-alih menggunakan setiap parameter untuk setiap token, sebuah router memilih hanya sejumlah kecil expert untuk memproses setiap token.
Ini mengurangi komputasi, tetapi seluruh kumpulan expert tetap harus disimpan di suatu tempat dalam perangkat keras serving.
Karenanya, inferensi MoE yang efisien bergantung pada:
Dalam skala besar, komunikasi dapat menjadi bottleneck utama, itulah sebabnya teknologi seperti DeepEP menyediakan kernel ber-throughput tinggi dan berlatensi rendah khusus untuk memindahkan token antar expert.
Pembedaan kunci adalah bahwa total parameter menentukan seberapa banyak kapasitas model yang harus disimpan, sementara parameter aktif memberi gambaran lebih baik tentang seberapa banyak komputasi yang dilakukan untuk setiap token.
Aplikasi LLM modern sering memerlukan sesuatu yang lebih dapat diprediksi daripada teks bebas. Agen, misalnya, mungkin perlu menghasilkan JSON, argumen alat, SQL, atau respons yang mengikuti skema pradefinisi yang valid.
Constrained decoding mengontrol token mana yang boleh dihasilkan model pada setiap langkah, sehingga keluaran akhir mengikuti struktur yang dibutuhkan. Mesin inferensi modern seperti vLLM mendukung batasan, termasuk:
Ini biasanya lebih andal daripada menghasilkan teks tanpa batasan lalu mencoba memperbaikinya setelahnya. Namun, constrained decoding menjamin struktur, bukan necessariamente kebenaran informasi di dalamnya.
Model penalaran menciptakan beban kerja inferensi yang sangat berbeda karena mereka dapat menghasilkan ribuan token penalaran menengah sebelum menghasilkan jawaban akhir.
Tidak seperti beban kerja konteks panjang, di mana sebagian besar biaya mungkin berasal dari pemrosesan masukan besar, beban kerja penalaran dapat tetap mahal sepanjang generasi karena fase decode itu sendiri menjadi sangat panjang.
Jejak penalaran yang panjang memengaruhi:
Tantangan lainnya adalah panjang penalaran sering sulit diperkirakan.
Satu permintaan mungkin selesai cepat, sementara yang lain terus menghasilkan ribuan token. Ini membuat batching, penjadwalan, dan alokasi KV-cache lebih sulit saat banyak pengguna dilayani secara bersamaan.
Akibatnya, melayani chatbot yang menghasilkan beberapa ratus token dan model penalaran yang mungkin menghasilkan 10.000 token dapat memerlukan strategi inferensi, memori, dan penjadwalan yang sangat berbeda.
Optimasi perangkat lunak hanyalah sebagian dari inferensi LLM. Perangkat keras di bawahnya dapat berdampak sama besar pada kecepatan, kapasitas memori, skalabilitas, dan biaya.
Karakteristik perangkat keras yang penting meliputi:
Konsep yang berguna untuk memahami kinerja perangkat keras adalah intensitas aritmetika, yang menggambarkan seberapa banyak komputasi dilakukan relatif terhadap seberapa banyak data yang harus dipindahkan. Beban kerja dengan intensitas aritmetika tinggi cenderung terbatas komputasi, sementara beban kerja dengan intensitas aritmetika rendah sering kali dibatasi oleh bandwidth memori.
Saat prefill, banyak token prompt dapat diproses secara paralel, memungkinkan perangkat keras memanfaatkan sumber daya komputasinya dengan lebih baik. Namun saat decode, token dihasilkan secara sekuensial, dan sistem berulang kali mengakses bobot model dan data KV-cache. Ini membuat bandwidth memori sangat penting untuk kecepatan generasi.
Inilah mengapa kapasitas memori dan bandwidth memori adalah dua hal yang berbeda. Misalnya, baik NVIDIA DGX Spark maupun sistem Apple M4 Max dapat menyediakan hingga 128 GB memori terpadu. Namun, DGX Spark menyediakan 273 GB/dtk bandwidth memori, sedangkan M4 Max mencapai hingga 546 GB/dtk. Jadi meskipun kedua sistem mungkin dapat memuat model besar yang sama di memori, kinerja inferensinya dapat berperilaku sangat berbeda.
Prinsip yang sama berlaku saat membandingkan GPU dan mesin AI lokal: memuat model menyelesaikan masalah kapasitas, bukan berarti masalah kecepatan.
Untuk inferensi LLM, kinerja komputasi, kapasitas memori, bandwidth memori, dan kecepatan interkoneksi semuanya perlu dipertimbangkan bersama.
Dengan begitu banyak teknik inferensi yang tersedia, kuncinya adalah terlebih dahulu mengidentifikasi apa yang sebenarnya membatasi sistem Anda.
Model yang tidak muat di VRAM membutuhkan optimasi yang sangat berbeda dari server yang kesulitan dengan latensi tinggi atau throughput rendah.
|
Masalah / Skenario |
Teknik yang Dipertimbangkan |
|
Model tidak muat di VRAM |
Kuantisasi, offloading ke CPU, paralelisme tensor/pipeline |
|
TTFT tinggi / prefill lambat |
Prefix caching, penyesuaian chunked prefill, atensi yang dioptimalkan |
|
Generasi token lambat |
Speculative decoding, kernel yang dioptimalkan, presisi lebih rendah |
|
Throughput rendah / konkruensi tinggi |
Continuous batching, penjadwalan permintaan, paralelisme data |
|
Tekanan memori KV-cache |
Kuantisasi KV-cache, paging, offloading, pengurangan konteks/konkruensi |
|
Beban kerja konteks panjang |
Chunked prefill, paralelisme konteks, optimasi KV-cache |
|
Model MoE besar |
Paralelisme expert, penempatan expert, penyeimbangan beban, kernel MoE yang dioptimalkan |
|
Prompt berulang atau bersama |
Prefix caching, routing yang sadar prefiks |
|
Lokal / perangkat keras terbatas |
Kuantisasi, llama.cpp/GGUF, MLX di Apple Silicon |
|
Serving produksi skala besar |
vLLM, SGLang, TensorRT-LLM, inferensi terdistribusi, disagregasi prefill/decode |
Poin pentingnya adalah tidak ada satu optimasi terbaik.
Mulailah dengan mengukur metrik seperti TTFT, kecepatan generasi token, throughput, utilisasi GPU, dan penggunaan memori. Lalu terapkan teknik yang menargetkan bottleneck sebenarnya dan lakukan benchmark lagi.
Sebagai contoh, kuantisasi dapat membantu saat memori terbatas, continuous batching dapat meningkatkan throughput, prefix caching dapat mengurangi pekerjaan prefill berulang, dan speculative decoding dapat meningkatkan kecepatan generasi saat token masa depan dapat diprediksi.
Tujuannya bukan sekadar memaksimalkan token per detik, melainkan menemukan keseimbangan terbaik antara latensi, throughput, penggunaan memori, kualitas model, perangkat keras, dan biaya.
Menjalankan LLM secara lokal dan mendapatkan respons dari llama.cpp adalah titik awal yang bagus, tetapi itu tidak otomatis berarti Anda telah membangun sistem inferensi yang efisien.
Untuk proyek pribadi, eksperimen, dan beban kerja yang lebih kecil, penyiapan lokal yang sederhana mungkin sudah cukup.
Namun, begitu Anda mulai melayani banyak pengguna, menangani konteks panjang, atau membangun sistem pengodean dan agen yang kompleks, kebutuhan akan cepat berubah.
Anda memerlukan tumpukan inferensi yang dapat memproses banyak permintaan secara simultan, menjaga kecepatan generasi yang baik, mengelola memori secara efisien, dan tetap responsif bahkan saat beban kerja semakin berat.
Di sinilah konsep seperti continuous batching, prefix caching, manajemen KV-cache, kuantisasi, speculative decoding, kernel yang dioptimalkan, paralelisme, dan penjadwalan permintaan mulai bermakna.
Anda juga perlu memahami metrik seperti TTFT, throughput, latensi, konkruensi, utilisasi GPU, dan biaya per token alih-alih menilai kinerja hanya berdasarkan token per detik.
Tidak ada pula konfigurasi universal yang cocok untuk setiap model atau beban kerja. Teknik yang bekerja baik untuk pengodean mungkin tidak memberikan manfaat yang sama untuk penalaran.
Optimasi yang meningkatkan throughput dapat meningkatkan latensi. Kuantisasi dapat sangat mengurangi kebutuhan memori, tetapi kuantisasi yang lebih agresif juga dapat menurunkan kualitas model.
Pada akhirnya, rekayasa inferensi LLM yang baik adalah tentang keseimbangan. Tujuannya adalah memaksimalkan penggunaan perangkat keras yang sudah Anda miliki sambil menyeimbangkan kecepatan, memori, throughput, latensi, kualitas model, dan biaya.
Itulah mengapa mempelajari inferensi itu penting. Alih-alih sepenuhnya mengandalkan pengaturan default atau sekadar menambah GPU, Anda dapat memahami di mana bottleneck berada, memilih optimasi yang tepat, dan membangun sistem serving yang benar-benar dirancang untuk beban kerja Anda.
Untuk mempelajari lebih lanjut tentang inferensi LLM, saya merekomendasikan untuk melihat webinar kami tentang Memahami Inferensi LLM.
Top DataCamp Courses
Kursus
Program
Kursus
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



