¡Última oportunidad! 50 % de descuento en todo
La oferta termina dentro de
La inferencia de modelos de lenguaje grandes puede volverse cada vez más costosa a medida que crecen los prompts.
Los sistemas RAG, los agentes para programación, los flujos multiagente y las conversaciones largas suelen enviar una y otra vez los mismos documentos, prompts de sistema, definiciones de herramientas o historial de conversación.
Cada vez que ese contexto compartido se procesa durante el prefill, el modelo genera estados clave-valor (KV) que se usan durante la generación de tokens.
Volver a calcular esos estados para el mismo contexto desperdicia cómputo de GPU y aumenta la latencia.
LMCache resuelve esto añadiendo una capa dedicada de caché KV a la pila de inferencia.
Puede almacenar estados KV previamente calculados y hacerlos reutilizables entre solicitudes y workers de inferencia, además de admitir CPU, almacenamiento local, backends remotos y arquitecturas de servicio desagregadas.
En este tutorial, te mostraré cómo funciona LMCache, en qué se diferencia de la caché KV nativa de vLLM y cómo encajan funciones como el almacenamiento multinivel, la caché compartida, CacheBlend y la desagregación de prefill/decode en el servicio moderno de LLM.
Luego conectarás LMCache a vLLM, servirás IBM Granite 4.2 3B y ejecutarás un experimento controlado para medir cómo afecta a la latencia de inferencia la reutilización de un prefijo grande compartido.
LMCache es una capa de gestión de caché KV para la inferencia de LLM de código abierto.
Permite almacenar los estados clave-valor creados durante el prefill y reutilizarlos cuando las solicitudes futuras comparten el mismo prefijo de prompt.
Fuente: LMCache – Building the foundation of AI memory tensor with KV Cache Infrastructure
Esto es distinto a la caché de respuestas tradicional.
Una caché de respuestas almacena la respuesta final generada y la devuelve cuando aparece de nuevo la misma solicitud:
cache = {
    "What is Python?":
        "Python is a general-purpose programming language..."
}
LMCache actúa antes en el proceso de inferencia. En lugar de cachear la respuesta final, guarda los estados de atención KV producidos mientras el modelo procesa el prompt.
Por ejemplo, sin reutilización de KV, un prompt largo compartido debe pasar por prefill cada vez que se añade una nueva pregunta.
Con LMCache, la primera solicitud realiza el prefill completo y almacena los estados KV resultantes. Las solicitudes posteriores con el mismo prefijo pueden cargar esos estados y procesar solo los tokens nuevos.
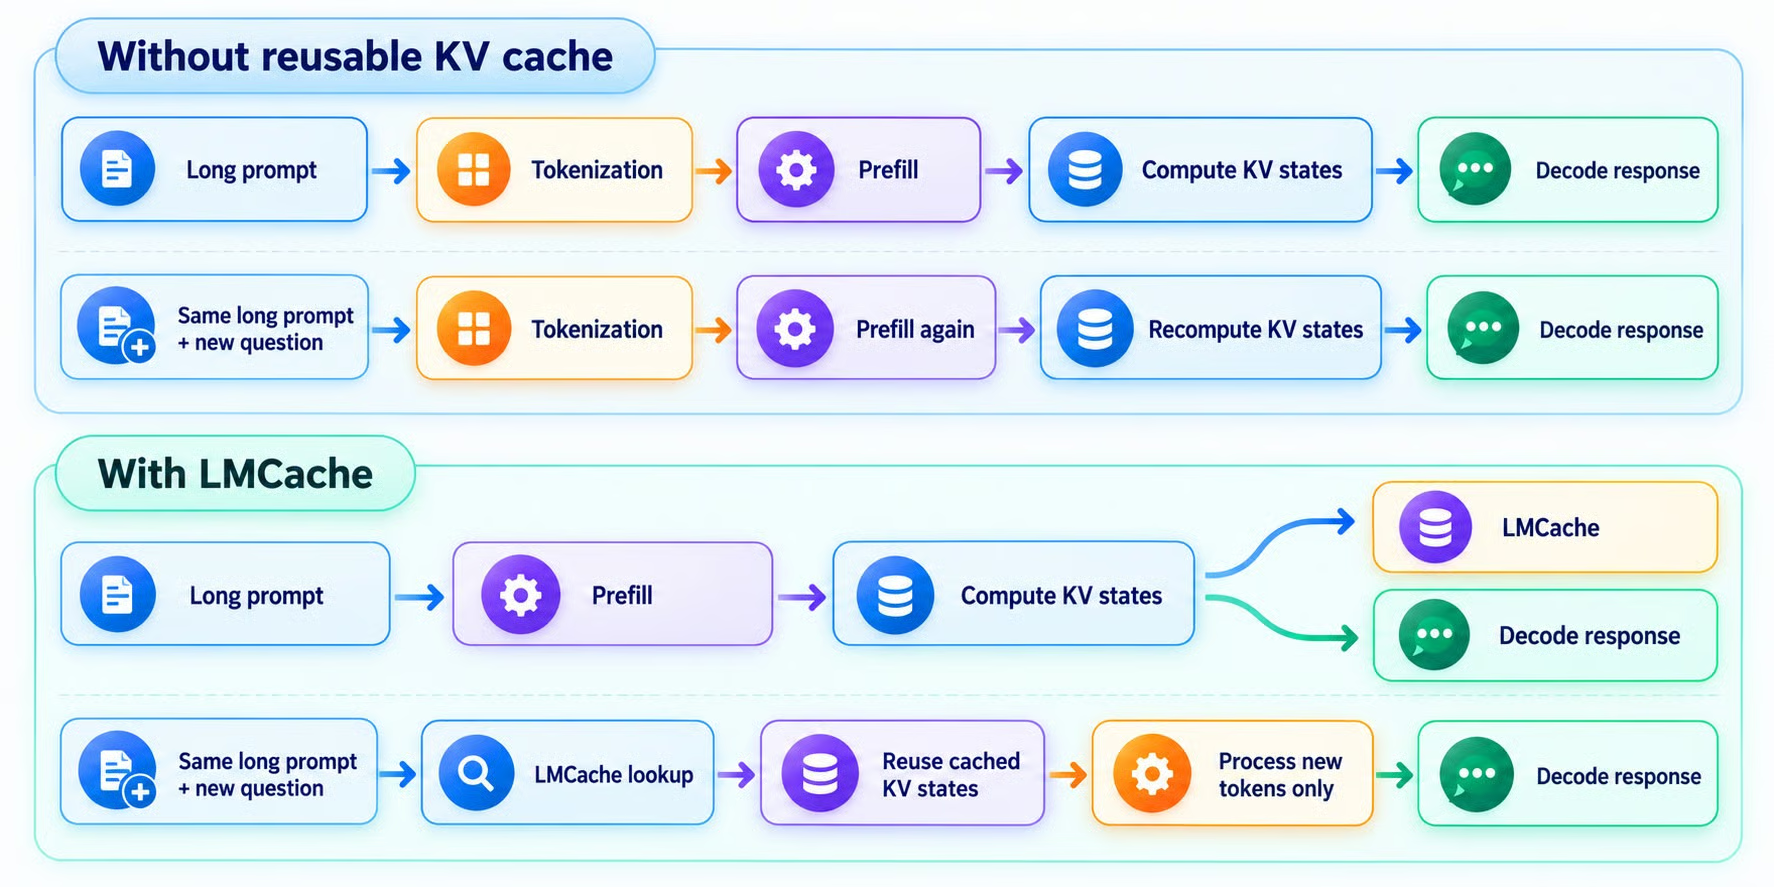
Fig 1: Sin una caché KV reutilizable, se recomputa todo el prompt en cada solicitud; con LMCache, se reutilizan los estados KV en caché y solo se procesan los tokens nuevos.
Esto gana valor a medida que crecen las ventanas de contexto.
Reprocesar unos cientos de tokens puede ser barato, pero procesar repetidamente decenas de miles de tokens compartidos puede incrementar notablemente la latencia y el uso de GPU.
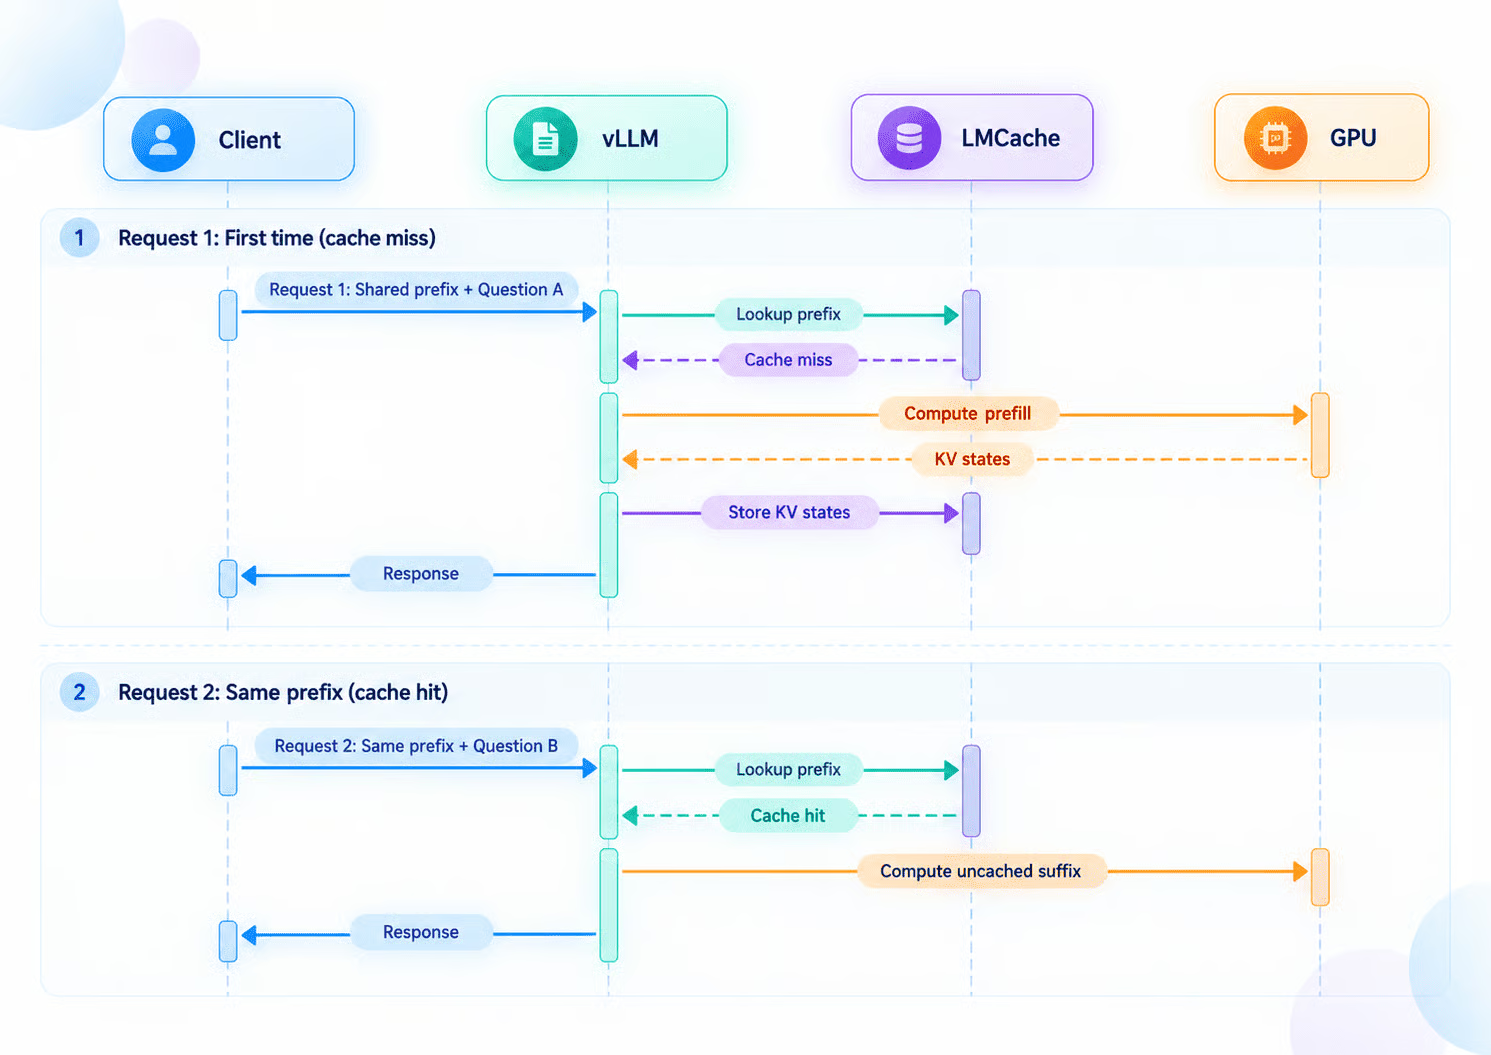
La forma más sencilla de entender LMCache es seguir dos solicitudes que comparten el mismo prefijo.
En la primera solicitud, LMCache comprueba si ya existen estados KV reutilizables. Como es la primera vez que se ve ese prompt, la búsqueda resulta en un fallo de caché.
vLLM realiza entonces el prefill en la GPU, crea los estados KV y se los pasa a LMCache para su almacenamiento.
En la segunda solicitud, el prefijo compartido sigue siendo el mismo, pero cambia la pregunta.
LMCache realiza otra búsqueda. Esta vez, el prefijo ya está disponible y se produce un acierto de caché. Se reutilizan los estados en caché y la GPU solo necesita procesar el sufijo no cacheado.
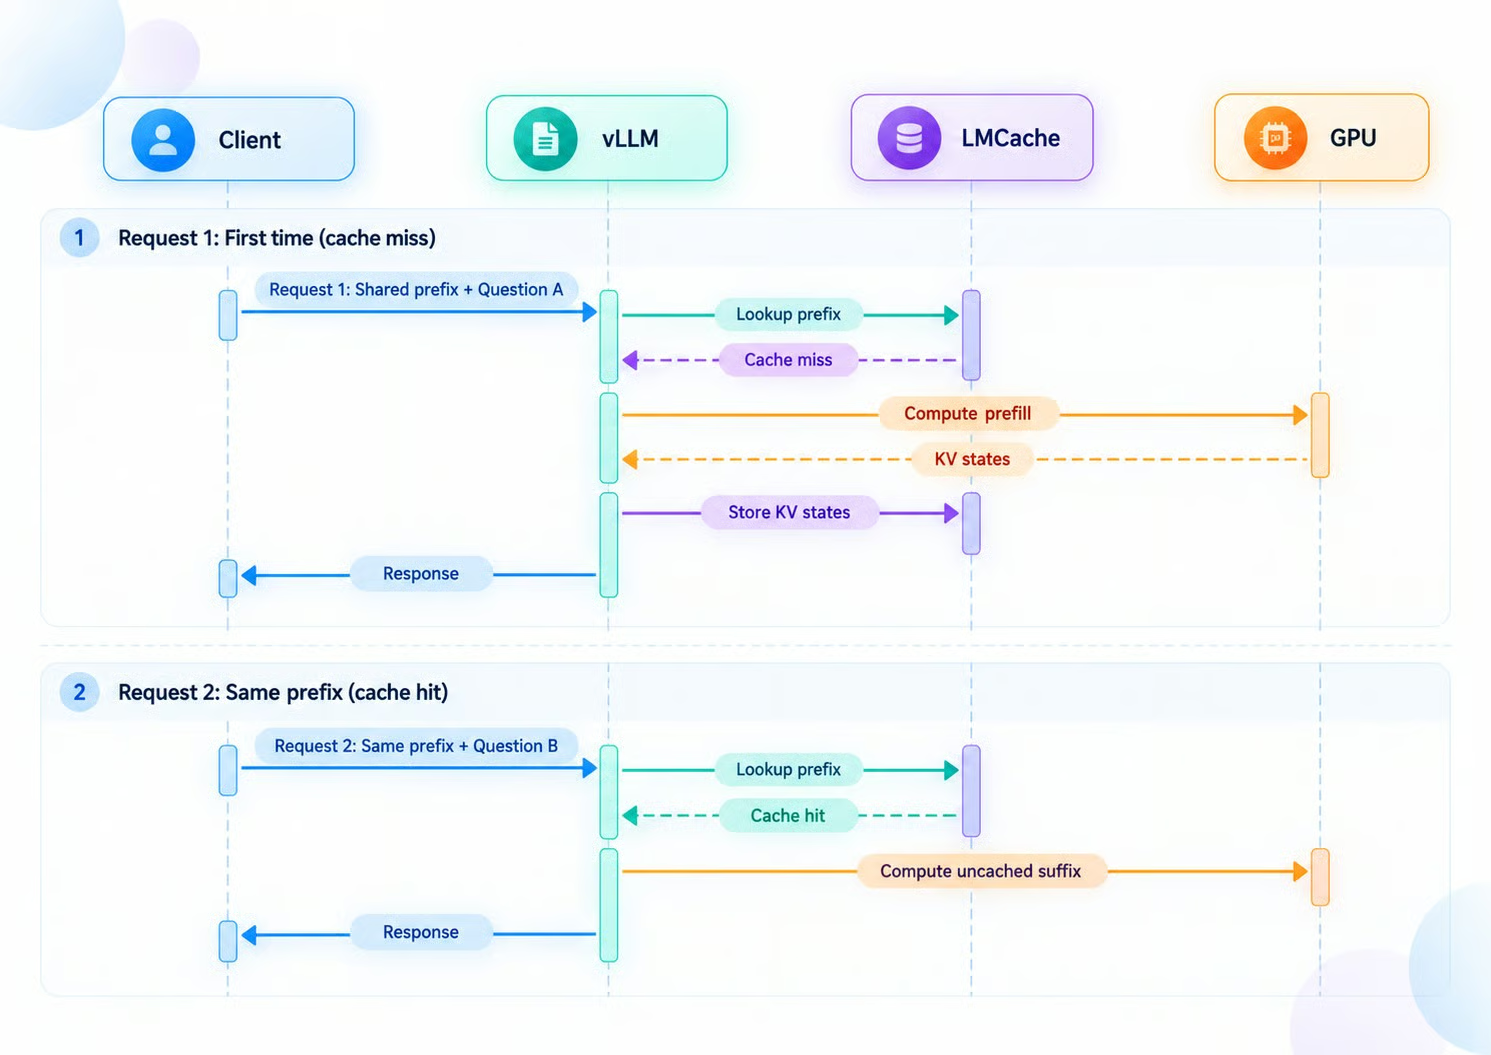
Fig 2: La primera solicitud con un prefijo nuevo falla en la caché, así que vLLM calcula el prefill y guarda los estados KV en LMCache; una repetición con el mismo prefijo acierta en la caché y solo calcula el nuevo sufijo.
Lo importante es que LMCache no requiere que toda la solicitud sea idéntica. Lo que importa es el prefijo reutilizable.
Esto lo hace ideal para aplicaciones en las que el contexto de fondo se mantiene mientras cambia la consulta del usuario.
vLLM ya admite cacheo automático de prefijos, así que es razonable preguntarse por qué hace falta LMCache.
Ambos enfoques intentan evitar recomputar estados KV para prefijos de prompt que el modelo ya ha procesado.
La diferencia principal es dónde vive esa caché y hasta qué punto puede reutilizarse.
|
Función |
Caché KV nativa de vLLM |
LMCache |
|
Reutilización de KV por prefijo |
Sí, mediante Automatic Prefix Caching |
Sí |
|
Reutilización de KV no prefijo |
No |
Sí, con CacheBlend |
|
Caché KV en GPU |
Sí |
Funciona junto con la caché KV en GPU de vLLM |
|
Descarga de KV a CPU |
Sí |
Sí |
|
Almacenamiento en SSD / NVMe |
Compatible mediante niveles de almacenamiento secundarios |
Sí, incluyendo disco local, NVMe y GDS |
|
Almacenamiento remoto |
Admite opciones como almacenamiento de objetos compatible con S3 |
Admite varios backends, incluidos Redis/Valkey, S3, Mooncake, InfiniStore, NIXL y otros |
|
Compartir caché entre procesos |
Compatible en algunas configuraciones, incl. P2P y almacenamiento compartido |
Función clave: varios workers de inferencia pueden usar estados KV compartidos en caché |
|
Servicio de caché independiente |
No, la caché se gestiona dentro de la pila de servicio de vLLM |
Sí, el modo MP de LMCache puede ejecutarse de forma independiente a vLLM |
|
Escalado independiente de la caché |
Los recursos de caché suelen configurarse con el despliegue de inferencia |
La capacidad de caché puede escalarse por separado de los workers de vLLM |
|
Desagregación de prefill/decode |
Compatible mediante conectores KV |
Diseñado específicamente para transferir KV entre workers de prefill y decode |
|
Más adecuado para |
Reutilización eficiente de prefijos y descarga de KV dentro de despliegues vLLM |
Trabajos de caché KV a gran escala, compartidos, multinivel o distribuidos |
La caché de prefijos integrada de vLLM es la opción más simple cuando solicitudes repetidas son atendidas por el mismo servidor de inferencia.
Si varias solicitudes empiezan con los mismos tokens, vLLM puede reutilizar los bloques KV existentes en lugar de realizar todo el prefill de nuevo.
LMCache amplía esta idea más allá del motor de inferencia.
En lugar de mantener los estados KV reutilizables solo dentro de la caché de vLLM, LMCache introduce una capa de caché separada que puede almacenar y mover estados KV por niveles adicionales de almacenamiento y ponerlos a disposición de una arquitectura de servicio más amplia.
Una forma sencilla de pensar en la diferencia es:
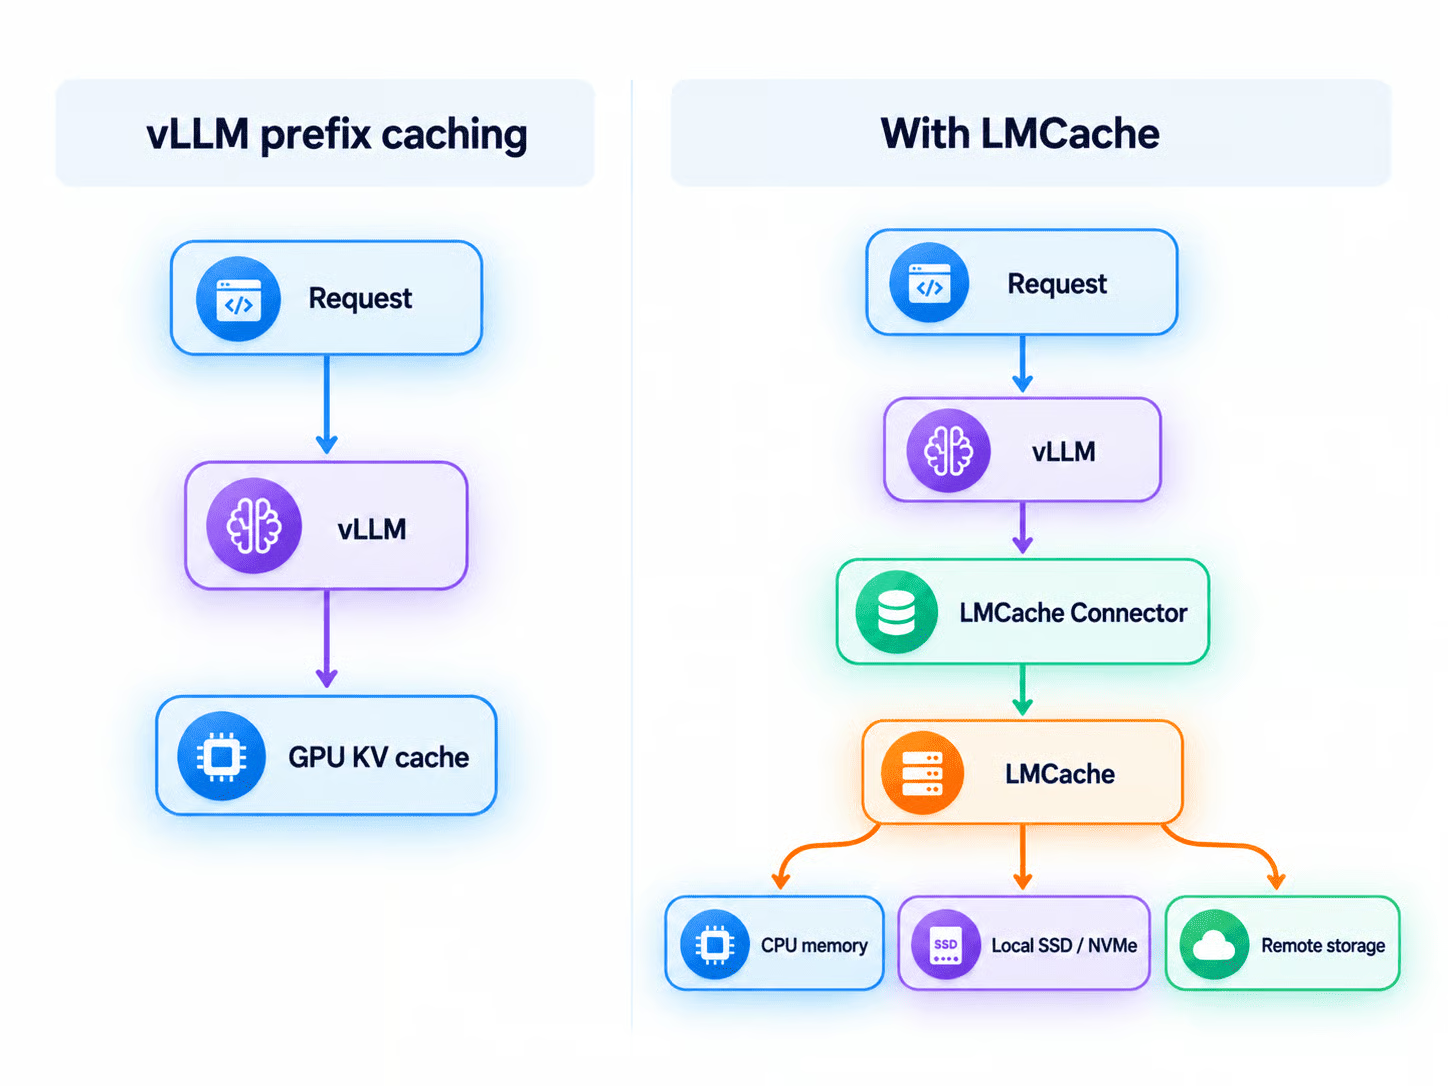
Fig 3: caché de prefijos de vLLM vs LMCache. LMCache añade una capa de caché que escalona estados KV entre memoria de CPU, SSD/NVMe local y almacenamiento remoto, en lugar de solo memoria de GPU.
Así que LMCache no sustituye la idea de la caché KV en vLLM. Amplía la gestión de la caché KV más allá de los límites habituales del motor de inferencia.
LMCache es más que una simple caché en memoria. Está diseñado para almacenar, mover y reutilizar estados KV entre distintos niveles de almacenamiento y workers de inferencia.
La función principal de LMCache es la capacidad de reutilizar estados KV ya calculados en lugar de volver a pasar los mismos tokens por el modelo.
Esto es especialmente útil cuando las solicitudes incluyen repetidamente el mismo contexto o uno similar, como:
Al reutilizar estados KV en caché, LMCache puede reducir el cómputo de prefill repetido y mejorar el tiempo hasta el primer token.
La memoria de GPU es limitada y cara, sobre todo con contextos largos.
LMCache puede sacar estados KV más allá de la GPU y almacenarlos en múltiples niveles, incluyendo memoria de CPU, almacenamiento local en SSD o NVMe y almacenamiento remoto o distribuido.
Esto permite mantener disponible mucho más contexto reutilizable del que cabría íntegramente en la GPU, y al mismo tiempo mover de vuelta a la GPU los estados KV usados con más frecuencia cuando se necesiten.
LMCache puede poner estados KV en caché a disposición de varios workers de inferencia en lugar de mantenerlos ligados a un único proceso del modelo.
Por ejemplo, si un worker de vLLM procesa un documento largo, otro worker puede reutilizar esos estados KV en caché en lugar de recomputar el mismo contexto.
Esto es especialmente útil para servicio distribuido, despliegues multi-GPU y aplicaciones donde las solicitudes se enrutan entre varias réplicas de inferencia.
LMCache se integra con vLLM a través de su interfaz de conectores KV.
La aplicación puede seguir comunicándose con el endpoint de vLLM compatible con OpenAI mientras LMCache opera por debajo de la capa de inferencia.
Esto significa que las aplicaciones existentes no tienen que cambiar cómo envían prompts o reciben respuestas. LMCache gestiona el almacenamiento y la recuperación de KV entre vLLM y el backend de caché configurado.
LMCache puede ejecutarse como un proceso separado de vLLM.
En lugar de mantener la gestión de caché dentro de cada worker de inferencia, un servidor LMCache dedicado puede gestionar estados KV de forma independiente y servir a varios procesos de vLLM.
Esto separa la gestión de caché del servicio del modelo, permite que varios workers compartan la misma caché y facilita escalar la capacidad de caché de forma independiente a los recursos de inferencia en GPU.
El cacheo tradicional por prefijo funciona mejor cuando las solicitudes comparten el inicio del prompt.
LMCache también ofrece CacheBlend para cargas donde el contenido reutilizable puede aparecer en posiciones distintas.
Por ejemplo, una aplicación RAG podría recuperar los mismos documentos en orden diferente para preguntas distintas.
CacheBlend puede reutilizar partes de estados KV ya calculados mientras recomputa selectivamente los tokens que dependen del nuevo contexto.
Esto hace que la reutilización de KV sea más útil para RAG, aplicaciones multidocumento y flujos agentic donde los prompts se reorganizan con frecuencia.
LMCache también puede ayudar a transferir estados KV entre workers separados de prefill y decode.
En esta arquitectura, un grupo de GPU maneja la etapa de procesamiento de prompt (intensiva en cómputo), mientras que otro grupo gestiona la generación de tokens.
LMCache proporciona la capa para mover entre ellos los estados KV resultantes.
Esto permite escalar de forma independiente los recursos de prefill y decodificación y puede mejorar el aprovechamiento de GPU en despliegues de inferencia más grandes.
Ahora que entendemos cómo funciona LMCache, vamos a conectarlo a vLLM, un motor de inferencia de LLM de alto rendimiento diseñado para un servicio eficiente y una buena gestión de memoria.
Para esta guía, usaré IBM Granite 4.2 3B, un modelo compacto que ofrece un rendimiento sólido para su tamaño y es lo bastante ligero para pruebas prácticas.
Ejecutaremos LMCache en modo multiproceso junto con vLLM y verificaremos que los estados KV pueden reutilizarse entre solicitudes.
Para este tutorial, usaremos Python 3.12, uv, vLLM, LMCache, el cliente de Python de OpenAI, pandas y matplotlib.
Antes de empezar, asegúrate de tener:
Puedes instalar uv con:
curl -LsSf https://astral.sh/uv/install.sh | shDespués, crea el proyecto:
mkdir lmcache-tutorial
cd lmcache-tutorial
Crea y activa un entorno virtual de Python 3.12:
uv venv --python 3.12
source .venv/bin/activate
Instala las dependencias necesarias:
uv pip install -U \
    "lmcache==0.5.4" \
    "vllm==0.28.0" \
    openai \
    pandas \
    matplotlib \
    --torch-backend=cu130
Aquí usamos cu130 porque nuestro entorno está configurado con CUDA 13.
Si usas otra versión de CUDA, cambia el valor de --torch-backend al backend de PyTorch compatible con tu entorno.
Granite 4.2 usa un parser de razonamiento personalizado, así que descárgalo de Hugging Face:
hf download ibm-granite/granite-4.2-3b \
    granite_thinking_parser.py \
    --local-dir .
Por último, verifica que tu GPU y la instalación de CUDA se detectan correctamente:
nvidia-smi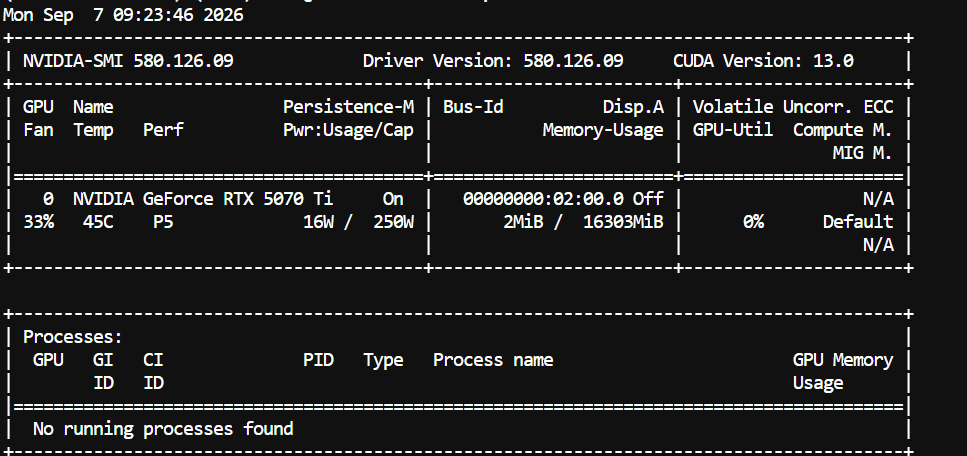
Para este tutorial, usamos una NVIDIA GeForce RTX 5070 Ti con 16 GB de VRAM.
El sistema ejecuta el driver de NVIDIA 580.126.09, con soporte para CUDA 13.0.
Necesitamos dos procesos en ejecución: uno para el servidor de LMCache y otro para vLLM.
Inicia LMCache en la primera terminal:
lmcache server \
    --host localhost \
    --port 6555 \
    --http-port 8081 \
    --l1-size-gb 20 \
    --eviction-policy LRU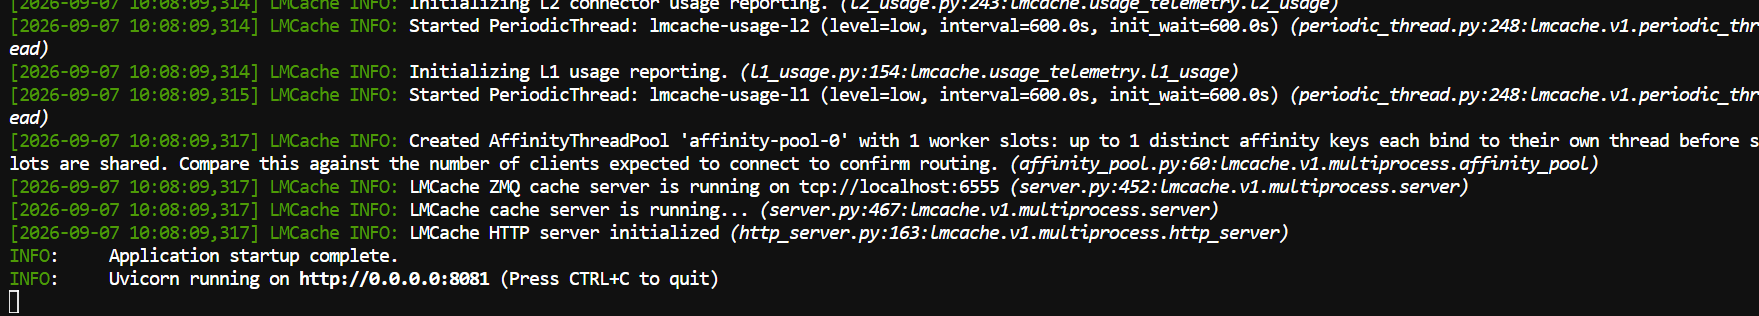
Aquí usamos:
6555 para la comunicación entre vLLM y LMCache8081 para la interfaz HTTP de LMCache20 GB para la caché L1LRU como política de expulsiónDeja esta terminal en ejecución.
Abre una segunda terminal, activa el mismo entorno virtual y deshabilita la configuración del asignador de CUDA expandible si estuviera activada:
cd lmcache-tutorial
source .venv/bin/activate
unset PYTORCH_CUDA_ALLOC_CONF
Ahora inicia vLLM con el conector de LMCache:
vllm serve ibm-granite/granite-4.2-3b \
  --served-model-name granite-4.2-3b \
  --dtype bfloat16 \
  --max-model-len 65536 \
  --kv-cache-dtype fp8 \
  --gpu-memory-utilization 0.90 \
  --enforce-eager \
  --max-num-seqs 1 \
  --max-num-batched-tokens 2048 \
  --no-enable-prefix-caching \
  --reasoning-parser granite_thinking_parser \
  --reasoning-parser-plugin "$(pwd)/granite_thinking_parser.py" \
  --tool-call-parser qwen3_coder \
  --enable-auto-tool-choice \
  --port 8000 \
  --kv-transfer-config \
  '{
    "kv_connector":"LMCacheMPConnector",
    "kv_connector_module_path":"lmcache.integration.vllm.lmcache_mp_connector",
    "kv_role":"kv_both",
    "kv_connector_extra_config":{
      "lmcache.mp.host":"tcp://localhost",
      "lmcache.mp.port":6555,
      "lmcache.mp.mp_transfer_mode":"lmcache_driven"
    }
  }'
Desactivamos la caché de prefijos integrada de vLLM con:
--no-enable-prefix-cachingEsto permite que los experimentos siguientes se centren específicamente en la reutilización de KV a través de LMCache.
Una vez que vLLM termine de cargar, el modelo estará disponible mediante su endpoint compatible con OpenAI:
http://localhost:8000/v1Ahora realizaremos un experimento controlado sencillo para confirmar que LMCache funciona.
Crearemos un prefijo grande compartido, limpiaremos la caché, enviaremos el prefijo una vez para poblar LMCache y luego enviaremos otra solicitud con el mismo prefijo pero una pregunta distinta.
Primero, crea el cliente de OpenAI:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local",
)
A continuación, crea un documento largo compartido:
base_text = """
Large language model inference consists of two main stages:
prefill and decoding.

During prefill, the model processes the input sequence and calculates
the key and value tensors used by the attention mechanism.

During autoregressive decoding, these tensors are reused so the model
does not need to recompute attention states for every previous token.

KV cache management is therefore an important part of modern LLM
serving infrastructure, particularly for long-context applications.
"""

document = base_text * 500

SYSTEM_PROMPT = f"""
You are a technical assistant.

Use only the following document to answer the user's question.

DOCUMENT:

{document}
"""
Repetir el documento 500 veces nos da un prefijo grande compartido lo bastante costoso como para que el efecto de la reutilización de KV sea visible.
Antes de enviar la primera solicitud, limpia LMCache para empezar con la caché vacía:
import subprocess
import time

subprocess.run(
    [
        "lmcache",
        "kvcache",
        "clear",
        "--url",
        "http://localhost:8081",
    ],
    check=True,
)

time.sleep(0.5)
Esto garantiza que la primera solicitud sea un acceso en frío y que no pueda reutilizar estados KV de pruebas anteriores.
Ahora envía la primera solicitud:
prompt_1 = SYSTEM_PROMPT + """

Question:
Explain the purpose of the KV cache.
"""

start = time.perf_counter()

client.completions.create(
    model="granite-4.2-3b",
    prompt=prompt_1,
    max_tokens=100,
    temperature=0,
)

latency_1 = time.perf_counter() - start
Esta es la solicitud de calentamiento de caché. vLLM tiene que procesar el prefijo largo compartido durante el prefill, mientras LMCache guarda los estados KV resultantes.
Después, mantén exactamente el mismo prefijo compartido y cambia solo la pregunta:
prompt_2 = SYSTEM_PROMPT + """

Question:
Explain what happens during prefill.
"""

start = time.perf_counter()

client.completions.create(
    model="granite-4.2-3b",
    prompt=prompt_2,
    max_tokens=100,
    temperature=0,
)

latency_2 = time.perf_counter() - start
Como el prefijo grande no cambia, LMCache puede reutilizar los estados KV generados por la primera solicitud en lugar de recomputar el prefijo completo.
Por último, compara los tiempos de ambas solicitudes:
print(f"Cold request:   {latency_1:.3f}s")
print(f"Warm request:   {latency_2:.3f}s")
print(f"Speedup:        {latency_1 / latency_2:.2f}x")

print(
    f"Latency saved:  "
    f"{((latency_1 - latency_2) / latency_1) * 100:.1f}%"
)
Mi ejecución produjo:
Cold request:   26.276s
Warm request:   4.402s
Speedup:        5.97x
Latency saved:  83.2%
La solicitud en caliente se completó casi 6× más rápido, reduciendo la latencia de extremo a extremo en un 83,2%.
Las preguntas son distintas, así que LMCache no está cacheando la respuesta final. Lo que hace es reutilizar los estados KV generados para el prefijo compartido.
La primera solicitud tiene que procesar todo el prefijo largo durante el prefill y crear esos estados KV desde cero.
En la segunda, LMCache recupera los estados en caché coincidentes, permitiendo a vLLM omitir gran parte de ese trabajo repetido de prefill y centrarse solo en el nuevo sufijo.
Esto confirma que LMCache está reutilizando correctamente el prefijo compartido.
LMCache es especialmente útil cuando una aplicación envía repetidamente grandes cantidades de contexto idéntico.
Algunos ejemplos habituales son:
Una persona puede hacer varias preguntas sobre el mismo documento recuperado.
En lugar de procesar el documento completo desde cero en cada pregunta, se pueden reutilizar sus estados KV.
Los asistentes de código suelen enviar archivos de repositorio, instrucciones de proyecto y otros contextos grandes en cada llamada al modelo.
Buena parte de ese contexto se mantiene idéntico mientras cambia la tarea.
Agents suelen reutilizar prompts de sistema grandes, definiciones de herramientas, memoria, instrucciones y estado del entorno en muchos pasos.
Una conversación prolongada puede enviar repetidamente una parte sustancial de su historial con cada nuevo mensaje.
Varios agentes pueden compartir los mismos documentos de fondo o contexto de sistema mientras trabajan en tareas distintas.
En todos estos casos, el modelo ve repetidamente información que ya procesó en solicitudes anteriores.
LMCache ofrece una forma de reutilizar ese trabajo a nivel de caché KV.
LMCache aborda una fuente importante de desperdicio en inferencias con contexto largo al hacer reutilizables los estados KV creados durante el prefill.
En lugar de procesar el mismo contexto compartido una y otra vez, el modelo puede reutilizar el trabajo ya realizado.
No hemos incluido el código de benchmark ni los resultados detallados en este tutorial, pero ejecutamos un conjunto de pruebas aparte con la misma configuración.
Los resultados fueron significativos. Reutilizar un prefijo grande compartido redujo la latencia total por solicitud de 26,276 segundos a 4,386 segundos.
El tiempo medio hasta el primer token cayó de 22,149 segundos a 0,726 segundos, una mejora de 30,54×. Las ganancias también crecieron con el tamaño del contexto, de 3,55× con unos 12.000 caracteres compartidos a 30,22× con aproximadamente 245.000 caracteres.
En pocas palabras: cuantos más contextos se puedan reutilizar, más trabajo puede evitar LMCache.
DeepSeek es un buen ejemplo real de por qué importa.
Su sistema de caché puede reutilizar prefijos de prompt coincidentes, algo especialmente valioso para agentes de programación que envían repetidamente los mismos prompts de sistema, herramientas, historial de conversación y contexto de código.
Una mayor tasa de aciertos de caché implica menos cómputo repetido y menores costes tanto para el proveedor como para el usuario.
La idea clave de esta guía es que acelerar la inferencia de LLM no va solo de tener mejores GPU o generar tokens más rápido. También va de no repetir trabajo innecesariamente.
Para sistemas RAG, asistentes de código, agentes y otras aplicaciones con contexto largo, la caché KV reutilizable puede ser clave para mejorar la latencia, reducir el uso de GPU y bajar los costes de inferencia.
Los mejores cursos de DataCamp
Programa
Curso
Curso
blog
Stanislav Karzhev
9 min
Tutorial
Moez Ali
12 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Zoumana Keita
8 min
Tutorial
Josep Ferrer
11 min