Programa
Deploy Production-Ready Agents
2 h
A inferência de modelos de linguagem pode ficar cada vez mais cara à medida que os prompts crescem.
Sistemas de RAG, agentes de código, fluxos multiagente e conversas longas costumam enviar repetidamente os mesmos documentos, prompts de sistema, definições de ferramentas ou histórico de conversa para o modelo.
Sempre que esse contexto compartilhado é processado durante o prefill, o modelo gera estados chave-valor (KV) usados durante a geração de tokens.
Recalcular esses estados para o mesmo contexto desperdiça computação de GPU e aumenta a latência.
LMCache resolve isso adicionando uma camada dedicada de cache KV ao stack de inferência.
Ele consegue armazenar estados KV previamente computados e torná-los reutilizáveis entre requisições e workers de inferência, além de oferecer suporte a CPU, armazenamento local, back-ends remotos e arquiteturas de serving desagregadas.
Neste tutorial, vou mostrar como o LMCache funciona, como ele difere do cache KV nativo do vLLM e onde recursos como armazenamento multi-tier, cache compartilhado, CacheBlend e desagregação de prefill/decode se encaixam no serving moderno de LLMs.
Depois, você vai conectar o LMCache ao vLLM, servir o IBM Granite 4.2 3B e rodar um experimento controlado para medir como a reutilização de um grande prefixo compartilhado afeta a latência de inferência.
LMCache é uma camada de gerenciamento de cache KV para inferência de LLM de código aberto.
Ela permite que estados chave-valor criados no prefill sejam armazenados e reutilizados quando futuras requisições compartilham o mesmo prefixo do prompt.
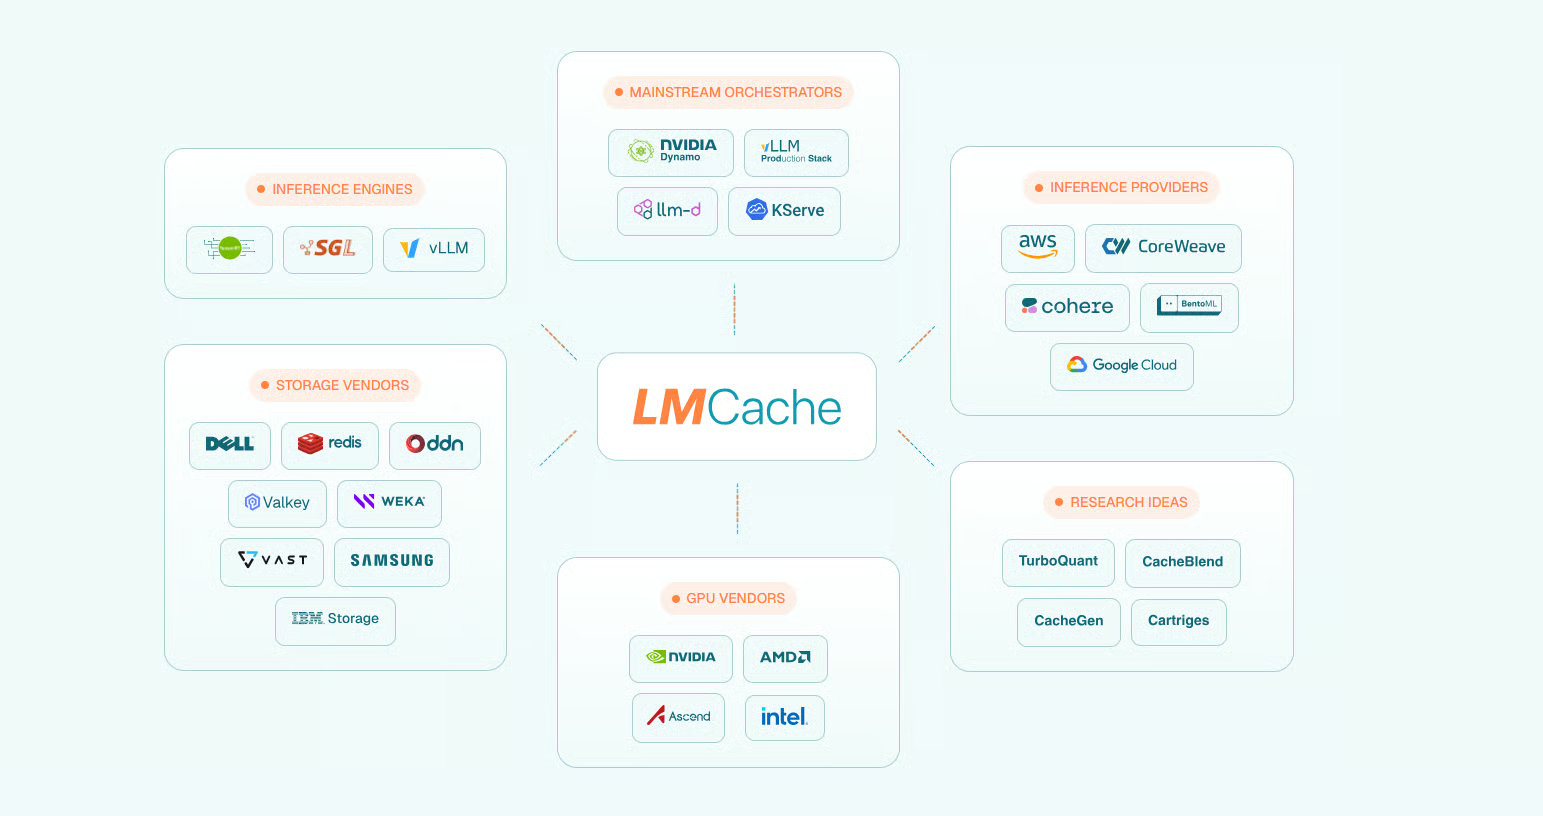
Fonte: LMCache – Building the foundation of AI memory tensor with KV Cache Infrastructure
Isso é diferente do cache tradicional de respostas.
Um cache de respostas armazena a resposta final gerada e a retorna quando a mesma requisição aparece novamente:
cache = {
    "What is Python?":
        "Python is a general-purpose programming language..."
}
O LMCache atua antes, no processo de inferência. Em vez de armazenar a resposta final, ele guarda os estados de atenção KV produzidos enquanto o modelo processa o prompt.
Por exemplo, sem um cache KV reutilizável, um prompt longo e compartilhado precisa passar pelo prefill novamente toda vez que uma nova pergunta é adicionada.
Com o LMCache, a primeira requisição faz todo o prefill e armazena os estados KV resultantes. Requisições posteriores com o mesmo prefixo podem carregar esses estados e processar apenas os tokens novos.
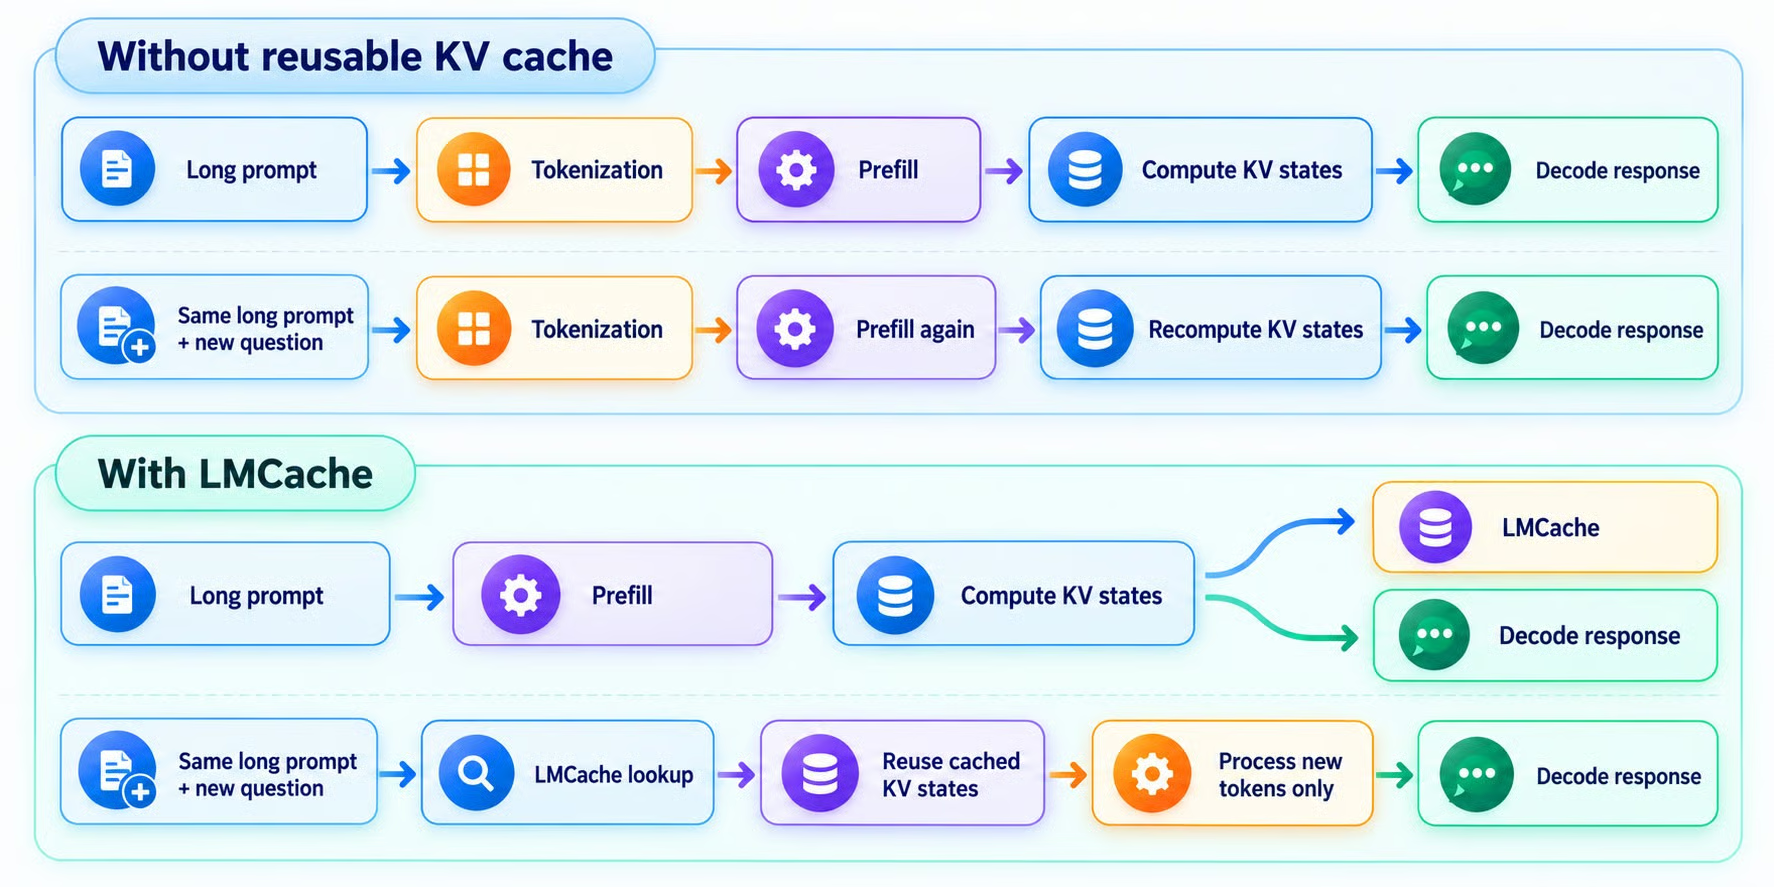
Fig. 1: Sem um cache KV reutilizável, todo o prompt é recomputado a cada requisição; com o LMCache, os estados KV em cache são reutilizados e apenas os tokens novos são processados.
Isso fica ainda mais valioso conforme as janelas de contexto crescem.
Reprocessar algumas centenas de tokens pode ser barato, mas processar repetidamente dezenas de milhares de tokens compartilhados pode aumentar muito a latência e o uso de GPU.
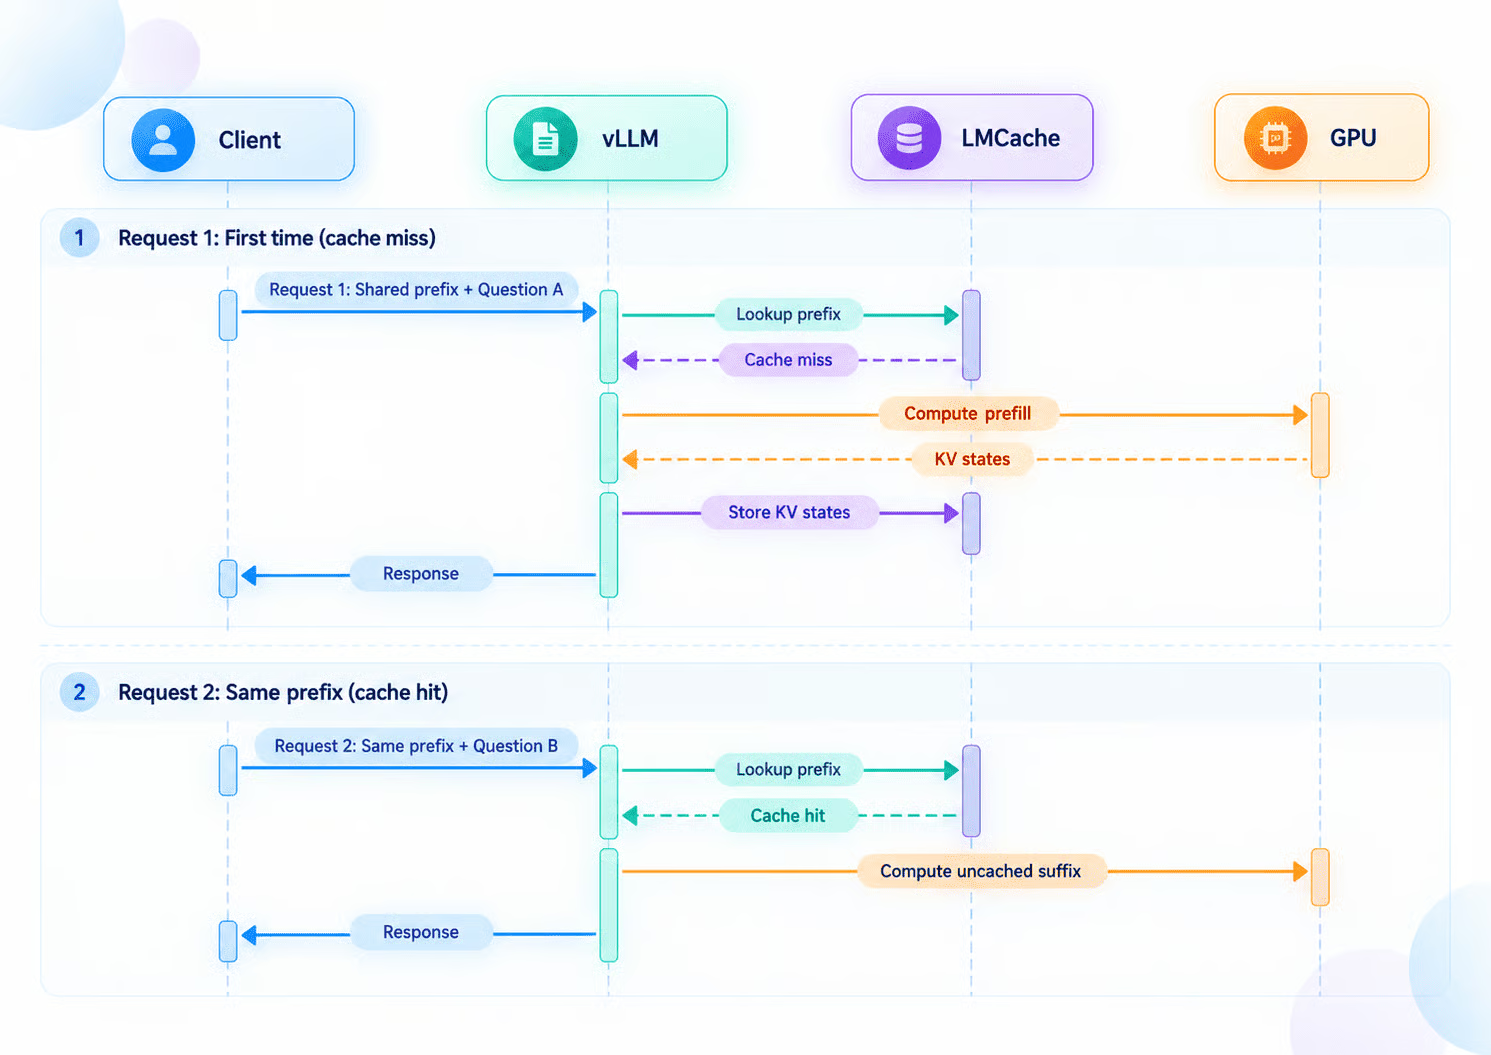
A maneira mais simples de entender o LMCache é acompanhar duas requisições que compartilham o mesmo prefixo.
Na primeira requisição, o LMCache verifica se já existem estados KV reutilizáveis. Como é a primeira vez que o prompt aparece, ocorre um cache miss.
O vLLM então executa o prefill na GPU, cria os estados KV e os repassa ao LMCache para armazenamento.
Na segunda requisição, o prefixo compartilhado permanece igual, mas a pergunta muda.
O LMCache faz uma nova busca. Desta vez, o prefixo já está disponível, resultando em um cache hit. Os estados em cache são reutilizados e a GPU só precisa processar o sufixo não cacheado.
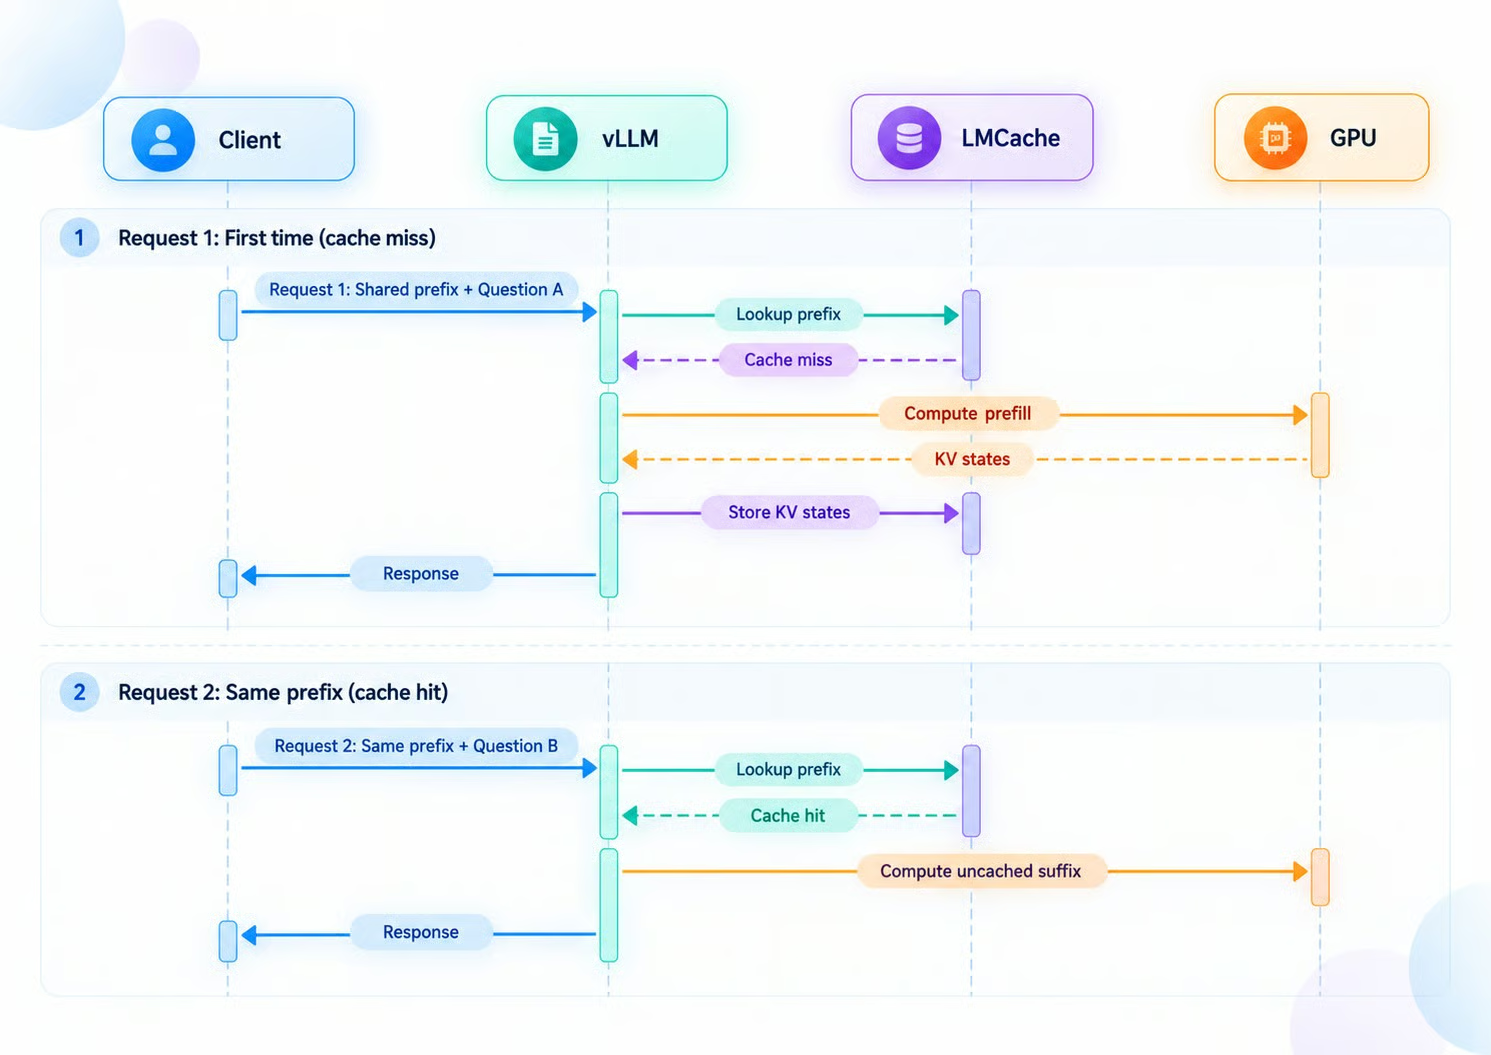
Fig. 2: A primeira requisição com um novo prefixo perde o cache, então o vLLM calcula o prefill e armazena os estados KV no LMCache; uma requisição repetida com o mesmo prefixo acerta o cache e calcula apenas o novo sufixo.
O ponto importante é que o LMCache não exige que a requisição inteira seja idêntica. O que importa é o prefixo reutilizável.
Isso o torna ideal para aplicações em que o contexto de fundo permanece o mesmo enquanto a pergunta do usuário muda.
O vLLM já oferece cache automático de prefixo, então é razoável perguntar por que o LMCache seria necessário.
Ambas as abordagens tentam evitar recomputar estados KV para prefixos de prompt que o modelo já processou.
A principal diferença é onde esse cache vive e quão amplamente ele pode ser reutilizado.
|
Recurso |
KV caching nativo do vLLM |
LMCache |
|
Reuso de KV de prefixo |
Sim, via Automatic Prefix Caching |
Sim |
|
Reuso de KV fora do prefixo |
Não |
Sim, via CacheBlend |
|
Cache KV na GPU |
Sim |
Funciona junto com o cache KV em GPU do vLLM |
|
Offload de KV para CPU |
Sim |
Sim |
|
Armazenamento em SSD / NVMe |
Suportado via tiers de armazenamento secundário |
Sim, incluindo disco local, NVMe e GDS |
|
Armazenamento remoto |
Suporta opções como storage de objetos compatível com S3 |
Suporta vários back-ends, incluindo Redis/Valkey, S3, Mooncake, InfiniStore, NIXL e outros |
|
Compartilhamento de cache entre processos |
Suportado em algumas configurações, incluindo P2P e storage compartilhado |
Recurso central: múltiplos workers de inferência podem usar estados KV em cache compartilhados |
|
Serviço de cache independente |
Não, o cache é gerenciado como parte do stack de serving do vLLM |
Sim, o modo MP do LMCache pode rodar independente do vLLM |
|
Escalonamento independente do cache |
Os recursos de cache são geralmente configurados junto ao deployment de inferência |
A capacidade do cache pode ser escalada separadamente dos workers do vLLM |
|
Desagregação de prefill/decode |
Suportada via conectores de KV |
Projetado especificamente para transferir KV entre workers de prefill e de decode |
|
Mais adequado para |
Reuso eficiente de prefixo e offloading de KV em deployments do vLLM |
Workloads de cache KV em larga escala, compartilhados, multi-tier ou distribuídos |
O prefix caching nativo do vLLM é a opção mais simples quando requisições repetidas são atendidas pelo mesmo servidor de inferência.
Se várias requisições começam com os mesmos tokens, o vLLM pode reutilizar os blocos KV existentes em vez de refazer todo o prefill.
O LMCache amplia essa ideia para além do mecanismo de inferência.
Em vez de manter estados KV reutilizáveis apenas dentro do cache do vLLM, o LMCache introduz uma camada separada que pode armazenar e mover estados KV por tiers adicionais de armazenamento e disponibilizá-los para uma arquitetura de serving mais ampla.
Uma forma simples de pensar na diferença é:
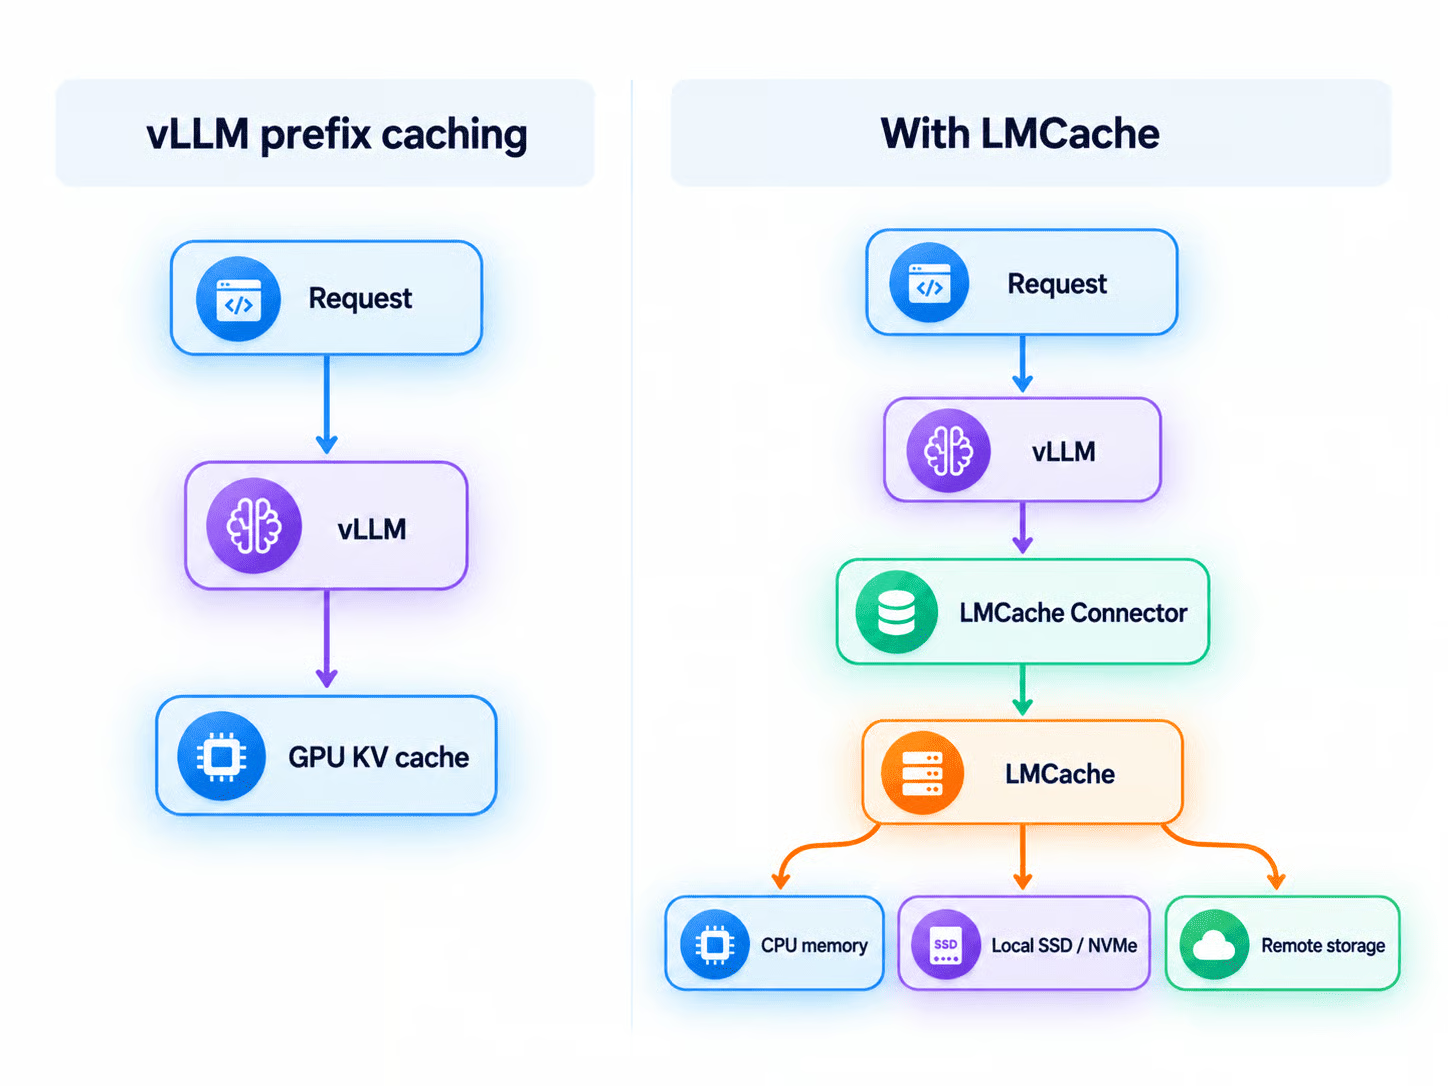
Fig. 3: prefix caching do vLLM vs. LMCache. O LMCache adiciona uma camada de cache que organiza estados KV entre memória da CPU, SSD/NVMe local e armazenamento remoto, em vez de ficar apenas na memória da GPU.
Portanto, o LMCache não substitui o conceito de cache KV no vLLM. Ele estende o gerenciamento do cache KV além dos limites normais do mecanismo de inferência.
O LMCache vai além de um simples cache em memória. Ele foi projetado para armazenar, mover e reutilizar estados KV entre diferentes tiers de armazenamento e workers de inferência.
O recurso principal do LMCache é a capacidade de reutilizar estados KV previamente computados em vez de processar os mesmos tokens no modelo novamente.
Isso é especialmente útil quando as requisições incluem repetidamente o mesmo contexto ou contextos semelhantes, como:
Ao reutilizar estados KV em cache, o LMCache reduz o prefill repetido e melhora o tempo até o primeiro token.
Memória de GPU é limitada e cara, principalmente com contextos longos.
O LMCache pode mover estados KV além da memória da GPU e armazená-los em múltiplos tiers, incluindo memória da CPU, SSD ou NVMe local, e storage remoto ou distribuído.
Isso permite manter muito mais contexto reutilizável do que caberia inteiramente na GPU, trazendo de volta para a GPU os estados KV mais usados quando necessário.
O LMCache pode disponibilizar estados KV em cache para vários workers de inferência, em vez de deixá-los amarrados a um único processo de modelo.
Por exemplo, se um worker do vLLM processa um documento longo, outro worker pode reutilizar os estados KV em cache em vez de recomputar o mesmo contexto.
Isso é especialmente útil para serving distribuído, deployments multi-GPU e aplicações em que as requisições são roteadas por várias réplicas de inferência.
O LMCache se integra ao vLLM por meio da interface de conectores de KV.
O aplicativo continua usando o endpoint do vLLM compatível com OpenAI normalmente enquanto o LMCache opera por baixo da camada de inferência.
Isso significa que aplicações existentes não precisam mudar como enviam prompts ou recebem respostas. O LMCache gerencia o armazenamento e a recuperação de KV entre o vLLM e o back-end de cache configurado.
O LMCache pode rodar como um processo separado do vLLM.
Em vez de manter o gerenciamento de cache dentro de cada worker de inferência, um servidor dedicado do LMCache pode gerenciar estados KV de forma independente e atender múltiplos processos do vLLM.
Isso separa o gerenciamento de cache do serving do modelo, permite que vários workers compartilhem o mesmo cache e facilita escalar a capacidade do cache de forma independente dos recursos de inferência em GPU.
O cache de prefixo tradicional funciona melhor quando as requisições compartilham o mesmo início de prompt.
O LMCache também oferece o CacheBlend para workloads em que conteúdo reutilizável pode aparecer em posições diferentes.
Por exemplo, uma aplicação de RAG pode recuperar os mesmos documentos em ordem diferente para perguntas distintas.
O CacheBlend consegue reutilizar partes de estados KV previamente computados enquanto recomputa seletivamente os tokens que dependem do novo contexto.
Isso torna o reuso de KV mais útil para RAG, aplicações com múltiplos documentos e fluxos agentic em que os prompts são frequentemente rearranjados.
O LMCache também ajuda a transferir estados KV entre workers separados de prefill e de decode.
Nessa arquitetura, um grupo de GPUs cuida da etapa intensiva de processamento do prompt, enquanto outro grupo gera os tokens.
O LMCache provê a camada usada para mover os estados KV resultantes entre eles.
Isso permite escalar recursos de prefill e de decoding de forma independente e pode melhorar a utilização de GPU em deployments maiores de inferência.
Agora que entendemos como o LMCache funciona, vamos conectá-lo ao vLLM, um mecanismo de inferência de LLM de alta performance, pensado para serving eficiente e gestão de memória.
Para este guia, vou usar o IBM Granite 4.2 3B, um modelo compacto que entrega ótima performance para o seu tamanho e é leve o suficiente para testes práticos.
Vamos rodar o LMCache no modo multiprocessos ao lado do vLLM e verificar que os estados KV podem ser reutilizados entre requisições.
Para este tutorial, vamos usar Python 3.12, uv, vLLM, LMCache, o cliente Python da OpenAI, pandas e matplotlib.
Antes de começar, garanta que você tem:
Você pode instalar o uv com:
curl -LsSf https://astral.sh/uv/install.sh | shDepois, crie o projeto:
mkdir lmcache-tutorial
cd lmcache-tutorial
Crie e ative um ambiente virtual com Python 3.12:
uv venv --python 3.12
source .venv/bin/activate
Instale as dependências necessárias:
uv pip install -U \
    "lmcache==0.5.4" \
    "vllm==0.28.0" \
    openai \
    pandas \
    matplotlib \
    --torch-backend=cu130
Aqui usamos cu130 porque o ambiente está configurado com CUDA 13.
Se você estiver usando outra versão do CUDA, ajuste o valor de --torch-backend para o backend do PyTorch compatível com o seu ambiente.
O Granite 4.2 usa um parser de raciocínio personalizado, então baixe-o do Hugging Face:
hf download ibm-granite/granite-4.2-3b \
    granite_thinking_parser.py \
    --local-dir .
Por fim, verifique se sua GPU e a instalação do CUDA foram detectadas:
nvidia-smi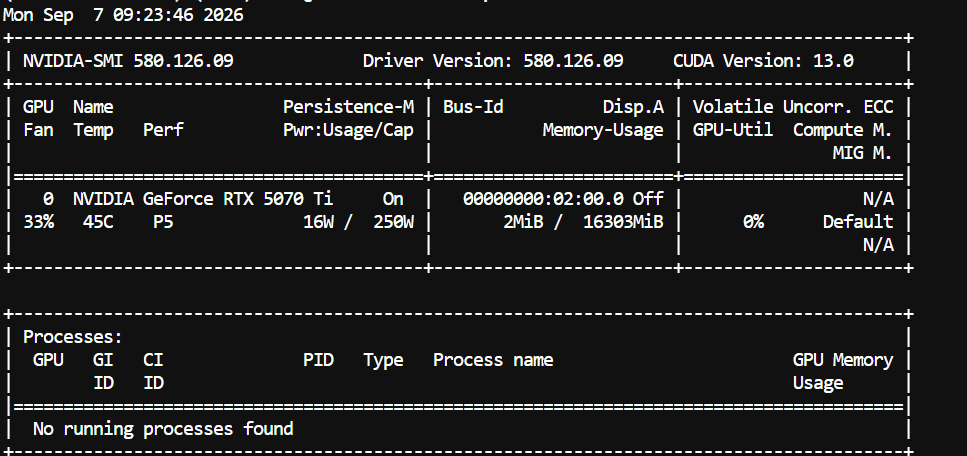
Para este tutorial, estamos usando uma NVIDIA GeForce RTX 5070 Ti com 16 GB de VRAM.
O sistema está rodando o driver NVIDIA 580.126.09, com suporte ao CUDA 13.0.
Precisamos de dois processos em execução: um para o servidor do LMCache e outro para o vLLM.
Inicie o LMCache no primeiro terminal:
lmcache server \
    --host localhost \
    --port 6555 \
    --http-port 8081 \
    --l1-size-gb 20 \
    --eviction-policy LRU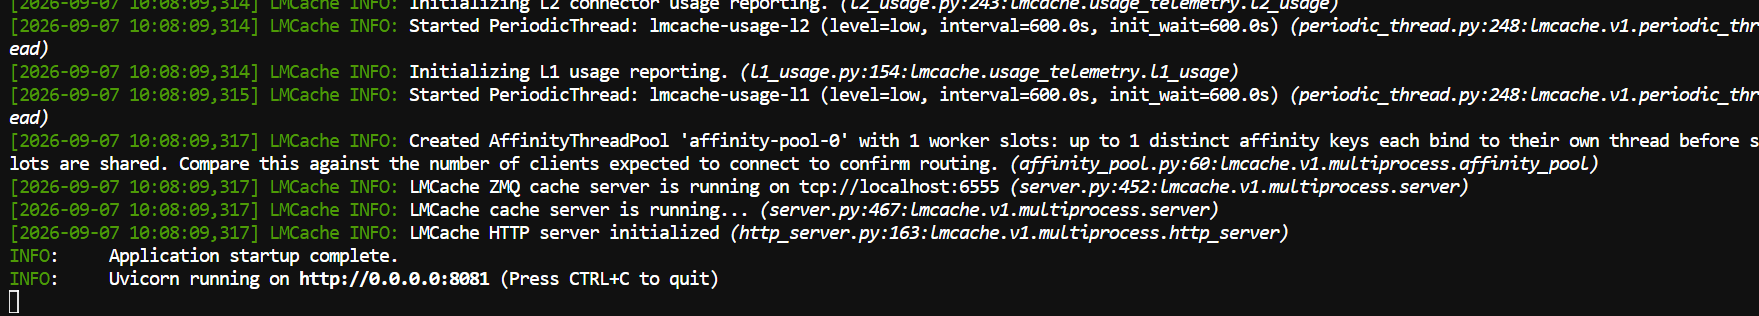
Aqui usamos:
6555 para a comunicação entre vLLM e LMCache8081 para a interface HTTP do LMCache20 GB para o cache L1LRU como política de descarteDeixe este terminal rodando.
Abra um segundo terminal, ative o mesmo ambiente virtual e desabilite a configuração do alocador CUDA expansível, se estiver ativa:
cd lmcache-tutorial
source .venv/bin/activate
unset PYTORCH_CUDA_ALLOC_CONF
Agora inicie o vLLM com o conector do LMCache:
vllm serve ibm-granite/granite-4.2-3b \
  --served-model-name granite-4.2-3b \
  --dtype bfloat16 \
  --max-model-len 65536 \
  --kv-cache-dtype fp8 \
  --gpu-memory-utilization 0.90 \
  --enforce-eager \
  --max-num-seqs 1 \
  --max-num-batched-tokens 2048 \
  --no-enable-prefix-caching \
  --reasoning-parser granite_thinking_parser \
  --reasoning-parser-plugin "$(pwd)/granite_thinking_parser.py" \
  --tool-call-parser qwen3_coder \
  --enable-auto-tool-choice \
  --port 8000 \
  --kv-transfer-config \
  '{
    "kv_connector":"LMCacheMPConnector",
    "kv_connector_module_path":"lmcache.integration.vllm.lmcache_mp_connector",
    "kv_role":"kv_both",
    "kv_connector_extra_config":{
      "lmcache.mp.host":"tcp://localhost",
      "lmcache.mp.port":6555,
      "lmcache.mp.mp_transfer_mode":"lmcache_driven"
    }
  }'
Desativamos o prefix caching embutido do vLLM com:
--no-enable-prefix-cachingAssim, os experimentos a seguir focam especificamente no reuso de KV via LMCache.
Quando o vLLM terminar de carregar, o modelo ficará disponível pelo endpoint compatível com OpenAI:
http://localhost:8000/v1Agora vamos fazer um experimento simples e controlado para confirmar que o LMCache está funcionando.
Vamos criar um grande prefixo compartilhado, limpar o cache, enviar o prefixo uma vez para popular o LMCache e depois enviar outra requisição com o mesmo prefixo, mas uma pergunta diferente.
Primeiro, crie o cliente da OpenAI:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local",
)
Em seguida, crie um documento compartilhado longo:
base_text = """
Large language model inference consists of two main stages:
prefill and decoding.

During prefill, the model processes the input sequence and calculates
the key and value tensors used by the attention mechanism.

During autoregressive decoding, these tensors are reused so the model
does not need to recompute attention states for every previous token.

KV cache management is therefore an important part of modern LLM
serving infrastructure, particularly for long-context applications.
"""

document = base_text * 500

SYSTEM_PROMPT = f"""
You are a technical assistant.

Use only the following document to answer the user's question.

DOCUMENT:

{document}
"""
Repetir o documento 500 vezes cria um grande prefixo compartilhado, caro o suficiente para tornar visível o efeito do reuso de KV.
Antes de enviar a primeira requisição, limpe o LMCache para começar com um cache vazio:
import subprocess
import time

subprocess.run(
    [
        "lmcache",
        "kvcache",
        "clear",
        "--url",
        "http://localhost:8081",
    ],
    check=True,
)

time.sleep(0.5)
Isso garante que a primeira requisição seja um cold-cache request e não consiga reutilizar estados KV de um teste anterior.
Agora envie a primeira requisição:
prompt_1 = SYSTEM_PROMPT + """

Question:
Explain the purpose of the KV cache.
"""

start = time.perf_counter()

client.completions.create(
    model="granite-4.2-3b",
    prompt=prompt_1,
    max_tokens=100,
    temperature=0,
)

latency_1 = time.perf_counter() - start
Esta é a requisição de aquecimento do cache. O vLLM precisa processar o longo prefixo compartilhado no prefill, enquanto o LMCache armazena os estados KV resultantes.
Em seguida, mantenha o prefixo compartilhado exatamente igual e mude apenas a pergunta:
prompt_2 = SYSTEM_PROMPT + """

Question:
Explain what happens during prefill.
"""

start = time.perf_counter()

client.completions.create(
    model="granite-4.2-3b",
    prompt=prompt_2,
    max_tokens=100,
    temperature=0,
)

latency_2 = time.perf_counter() - start
Como o grande prefixo não mudou, o LMCache pode reutilizar os estados KV gerados pela primeira requisição em vez de recomputar o prefixo inteiro.
Por fim, compare os tempos das duas requisições:
print(f"Cold request:   {latency_1:.3f}s")
print(f"Warm request:   {latency_2:.3f}s")
print(f"Speedup:        {latency_1 / latency_2:.2f}x")

print(
    f"Latency saved:  "
    f"{((latency_1 - latency_2) / latency_1) * 100:.1f}%"
)
No meu teste, o resultado foi:
Cold request:   26.276s
Warm request:   4.402s
Speedup:        5.97x
Latency saved:  83.2%
A requisição aquecida terminou quase 6× mais rápido, reduzindo a latência fim a fim em 83,2%.
As perguntas são diferentes, então o LMCache não está armazenando a resposta final. Em vez disso, ele está reutilizando os estados KV gerados para o prefixo compartilhado.
A primeira requisição precisa processar todo o prefixo longo no prefill e criar esses estados KV do zero.
Na segunda requisição, o LMCache recupera os estados em cache correspondentes, permitindo que o vLLM pule a maior parte desse trabalho repetido de prefill e foque apenas no novo sufixo.
Isso confirma que o LMCache está reutilizando com sucesso o prefixo compartilhado.
O LMCache é especialmente útil quando uma aplicação envia repetidamente grandes quantidades de contexto idêntico.
Alguns exemplos comuns:
Um usuário pode fazer várias perguntas sobre o mesmo documento recuperado.
Em vez de processar o documento inteiro do zero a cada pergunta, seus estados KV podem ser reutilizados.
Assistentes de código costumam enviar arquivos do repositório, instruções de projeto e outros trechos grandes de contexto a cada chamada ao modelo.
Grande parte desse contexto permanece idêntica enquanto a tarefa muda.
Agentes frequentemente reutilizam grandes prompts de sistema, definições de ferramentas, memórias, instruções e estado de ambiente ao longo de muitos passos.
Uma conversa de longa duração pode enviar repetidamente uma parte considerável do seu histórico a cada nova mensagem.
Vários agentes podem compartilhar os mesmos documentos de base ou contexto de sistema enquanto trabalham em tarefas diferentes.
Em todos esses casos, o modelo é exposto repetidas vezes a informações que já processou em requisições anteriores.
O LMCache oferece uma forma de reutilizar esse trabalho no nível do cache KV.
O LMCache ataca uma grande fonte de desperdício na inferência com contexto longo ao tornar reutilizáveis os estados KV criados durante o prefill.
Em vez de processar o mesmo contexto compartilhado repetidas vezes, o modelo pode reutilizar o trabalho já feito.
Não incluímos o código de benchmark nem resultados detalhados neste tutorial, mas executamos uma bateria separada de testes com a mesma configuração.
Os resultados foram significativos. Reutilizar um grande prefixo compartilhado reduziu a latência total da requisição de 26,276 segundos para 4,386 segundos.
O tempo médio até o primeiro token caiu de 22,149 segundos para 0,726 segundos, uma melhora de 30,54×. Os ganhos também cresceram com o tamanho do contexto: de 3,55× com cerca de 12.000 caracteres compartilhados para 30,22× com aproximadamente 245.000 caracteres.
Em termos simples: quanto mais contexto puder ser reutilizado, mais trabalho o LMCache evita.
A DeepSeek é um bom exemplo real do porquê isso importa.
O sistema de cache dela reutiliza prefixos de prompt correspondentes, o que é especialmente valioso para agentes de código que enviam repetidamente os mesmos prompts de sistema, ferramentas, histórico de conversa e contexto de código.
Taxas mais altas de acerto no cache significam menos computação repetida e custos menores para o provedor e para o usuário.
A principal lição deste guia é que acelerar a inferência de LLM não é só questão de GPUs melhores ou geração de tokens mais rápida. Também é sobre evitar refazer trabalho desnecessariamente.
Para sistemas de RAG, assistentes de código, agentes e outras aplicações com contexto longo, o cache KV reutilizável pode ser peça-chave para melhorar a latência, reduzir o uso de GPU e diminuir custos de inferência.
Os melhores cursos da DataCamp
Programa
Curso
Curso
blog
Nisha Arya Ahmed
12 min
blog
Stanislav Karzhev
9 min
Tutorial
Moez Ali
12 min
Tutorial
Zoumana Keita
8 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Josep Ferrer
11 min