
Last chance! 50% off DataCamp Premium
Sale ends in
Inferentie met large language models kan steeds duurder worden naarmate prompts groeien.
RAG-systemen, code-agents, multi-agent-workflows en lange gesprekken sturen vaak telkens opnieuw dezelfde documenten, systeem-prompts, tooldefinities of gespreksgeschiedenis naar het model.
Elke keer dat deze gedeelde context tijdens de prefill wordt verwerkt, genereert het model key-value (KV)-states die worden gebruikt tijdens tokengeneratie.
Die states telkens opnieuw berekenen voor dezelfde context verspilt GPU-rekenwerk en verhoogt de latency.
LMCache pakt dit aan door een speciale KV-cachelaag toe te voegen aan de inferentiestack.
Het kan eerder berekende KV-states opslaan en hergebruiken over verzoeken en inference-workers heen, en ondersteunt bovendien CPU, lokale opslag, externe backends en gedisaggregeerde serving-architecturen.
In deze tutorial laat ik je zien hoe LMCache werkt, hoe het verschilt van de native KV-caching van vLLM, en waar features zoals multi-tier-opslag, gedeelde caching, CacheBlend en prefill/decode-disaggregatie passen binnen moderne LLM-serving.
Je koppelt vervolgens LMCache aan vLLM, serveert IBM Granite 4.2 3B en voert een gecontroleerd experiment uit om te meten hoe het hergebruiken van een grote gedeelde prefix de inferentielatency beïnvloedt.
LMCache is een open-source KV-cachemanagementlaag voor LLM-inferentie.
Het maakt het mogelijk om key-value-states die tijdens de prefill zijn gecreëerd op te slaan en te hergebruiken wanneer toekomstige verzoeken dezelfde promptprefix delen.
Bron: LMCache – Building the foundation of AI memory tensor with KV Cache Infrastructure
Dit verschilt van traditionele response-caching.
Een response-cache slaat het uiteindelijke gegenereerde antwoord op en geeft het terug wanneer hetzelfde verzoek opnieuw verschijnt:
cache = {
    "What is Python?":
        "Python is a general-purpose programming language..."
}
LMCache werkt eerder in het inferentieproces. In plaats van de uiteindelijke respons te cachen, slaat het de attention-KV-states op die worden geproduceerd terwijl het model de prompt verwerkt.
Zonder herbruikbare KV-caching moet een lange gedeelde prompt bijvoorbeeld bij elke nieuwe vraag opnieuw door de prefill.
Met LMCache voert het eerste verzoek de volledige prefill uit en slaat het de resulterende KV-states op. Latere verzoeken met dezelfde prefix kunnen die states laden en alleen de nieuwe tokens verwerken.
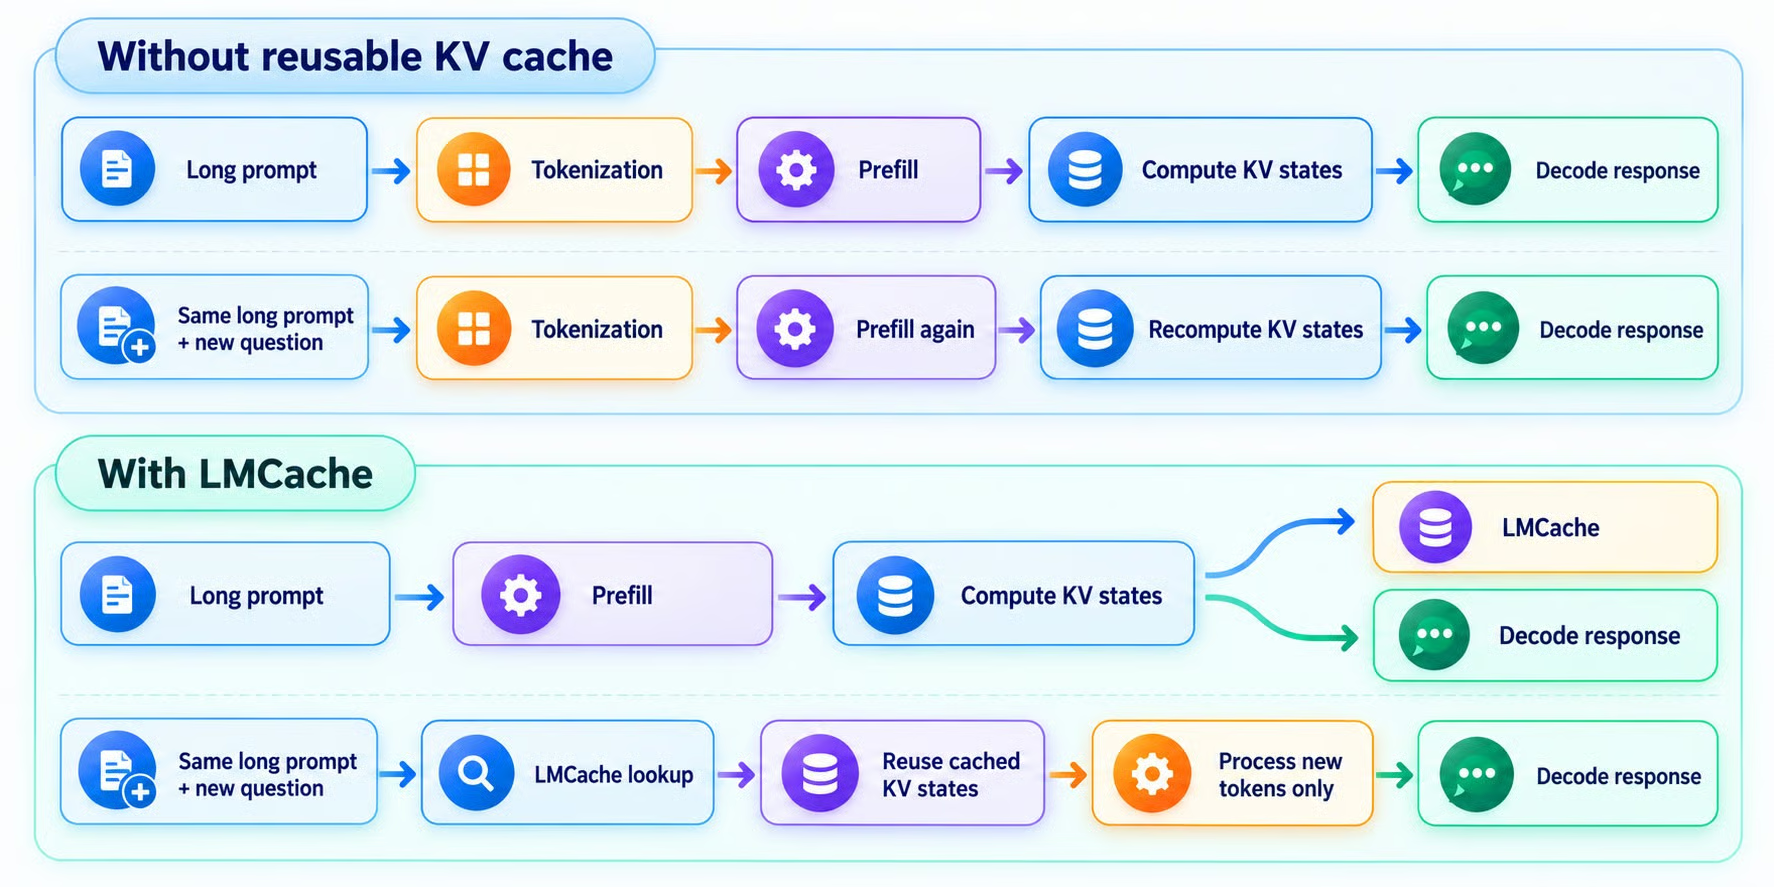
Figuur 1: Zonder een herbruikbare KV-cache wordt de hele prompt voor elk verzoek opnieuw berekend; met LMCache worden gecachte KV-states hergebruikt en worden alleen de nieuwe tokens verwerkt.
Dit wordt waardevoller naarmate contextvensters groeien.
Een paar honderd tokens opnieuw verwerken is misschien goedkoop, maar het herhaaldelijk verwerken van tienduizenden gedeelde tokens kan de latency en GPU-gebruik aanzienlijk verhogen.
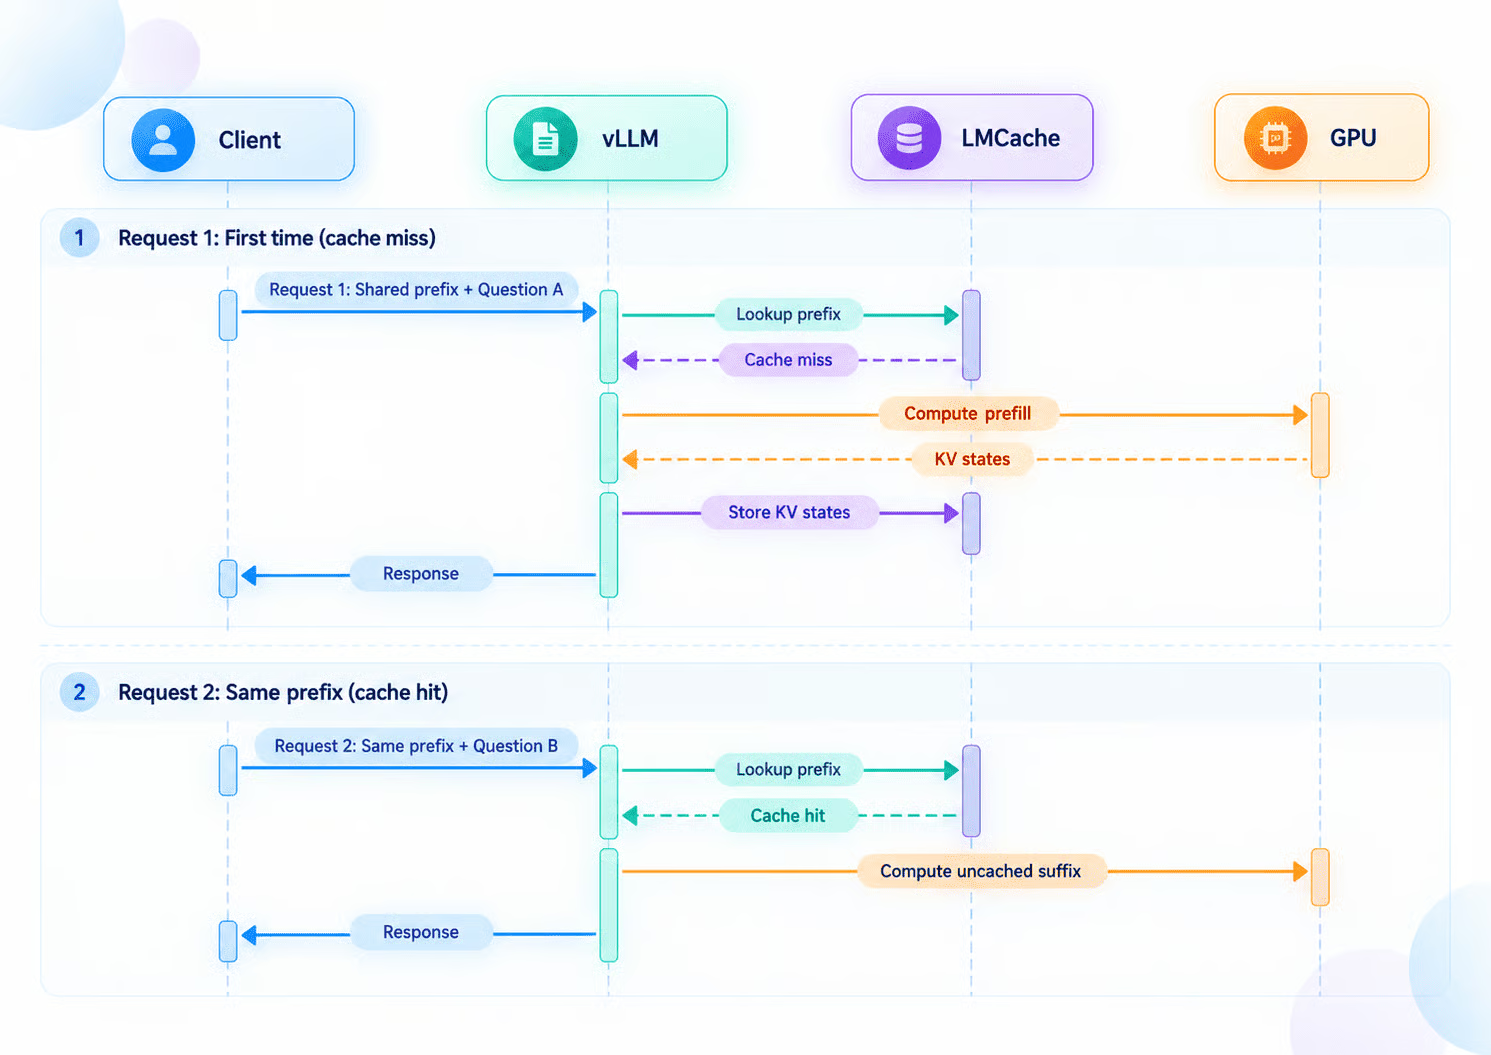
De makkelijkste manier om LMCache te begrijpen is door twee verzoeken te volgen die dezelfde prefix delen.
Voor het eerste verzoek controleert LMCache of er al herbruikbare KV-states bestaan. Omdat dit de eerste keer is dat de prompt wordt gezien, resulteert de lookup in een cache-miss.
vLLM voert vervolgens de prefill uit op de GPU, creëert de KV-states en geeft ze door aan LMCache voor opslag.
Voor het tweede verzoek blijft de gedeelde prefix hetzelfde, maar de vraag verandert.
LMCache voert opnieuw een lookup uit. Dit keer is de prefix al beschikbaar, wat resulteert in een cache-hit. De gecachte states worden hergebruikt en de GPU hoeft alleen het ongecachte suffix te verwerken.
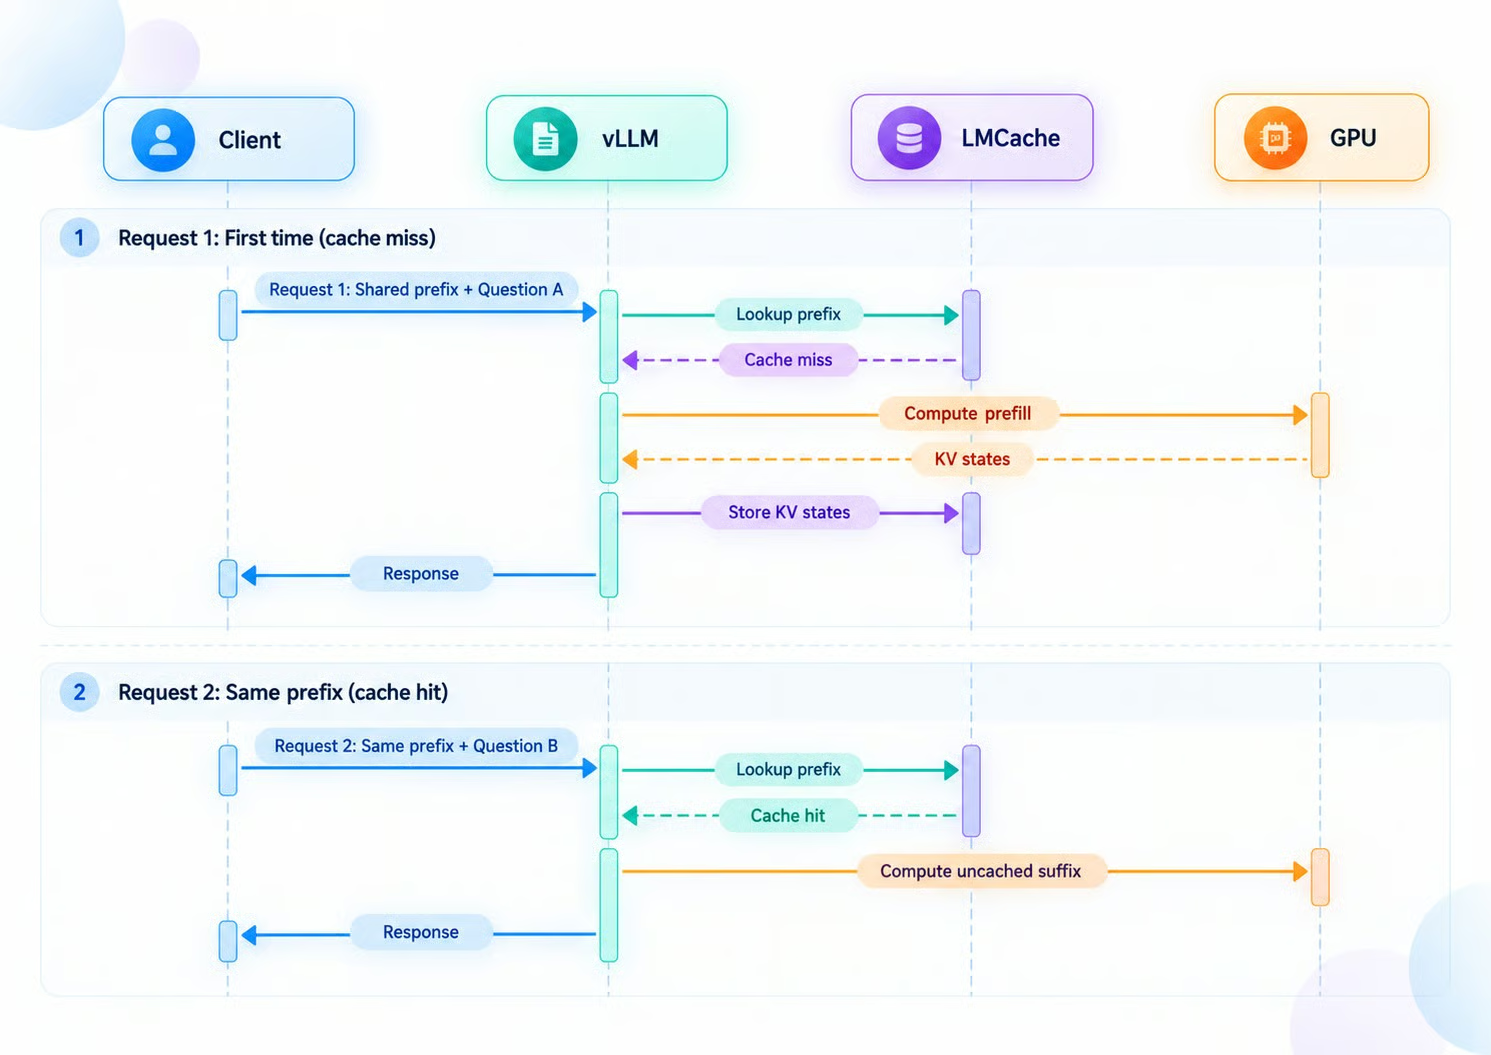
Figuur 2: Eerste verzoek met een nieuwe prefix mist de cache, dus vLLM berekent de prefill en slaat de KV-states op in LMCache; een herhaald verzoek met dezelfde prefix treft de cache en berekent alleen het nieuwe suffix.
Belangrijk is dat LMCache niet vereist dat het volledige verzoek identiek is. Het gaat om de herbruikbare prefix.
Dat maakt het goed geschikt voor toepassingen waarbij de achtergrondcontext hetzelfde blijft terwijl de gebruikersvraag verandert.
vLLM ondersteunt al automatische prefix-caching, dus het is logisch om je af te vragen waarom LMCache überhaupt nodig is.
Beide benaderingen proberen te voorkomen dat KV-states voor promptprefixen die het model al heeft verwerkt, opnieuw worden berekend.
Het belangrijkste verschil is waar die cache zich bevindt en hoe breed hij kan worden hergebruikt.
|
Functie |
vLLM native KV-caching |
LMCache |
|
Prefix-KV-hergebruik |
Ja, via Automatic Prefix Caching |
Ja |
|
Niet-prefix KV-hergebruik |
Nee |
Ja, via CacheBlend |
|
GPU KV-cache |
Ja |
Werkt naast vLLM's GPU KV-cache |
|
CPU KV-offloading |
Ja |
Ja |
|
SSD / NVMe-opslag |
Ondersteund via secundaire opslagniveaus |
Ja, inclusief lokale schijf, NVMe en GDS |
|
Externe opslag |
Ondersteunt opties zoals S3-compatibele objectopslag |
Ondersteunt meerdere backends zoals Redis/Valkey, S3, Mooncake, InfiniStore, NIXL en andere |
|
Procesoverschrijdend cache delen |
Ondersteund in sommige configuraties, inclusief P2P en gedeelde opslag |
Een kerneigenschap, waarbij meerdere inference-workers gedeelde gecachte KV-states kunnen gebruiken |
|
Zelfstandige cacheservice |
Nee, caching wordt beheerd als onderdeel van de vLLM-servingstack |
Ja, LMCache MP-modus kan onafhankelijk van vLLM draaien |
|
Onafhankelijke cache-schaalbaarheid |
Cachebronnen worden doorgaans geconfigureerd met de inferentie-deployment |
Cachecapaciteit kan los van de vLLM-workers worden opgeschaald |
|
Prefill/decode-disaggregatie |
Ondersteund via KV-connectors |
Specifiek gebouwd om KV-overdracht tussen prefill- en decode-workers te ondersteunen |
|
Het meest geschikt voor |
Efficiënt prefix-hergebruik en KV-offloading binnen vLLM-deployments |
Grootschalige, gedeelde, multi-tier of gedistribueerde KV-cache-workloads |
De ingebouwde prefix-caching van vLLM is de eenvoudigere optie wanneer herhaalde verzoeken door dezelfde inferentieserver worden afgehandeld.
Als meerdere verzoeken met dezelfde tokens beginnen, kan vLLM de bestaande KV-blokken hergebruiken in plaats van opnieuw de volledige prefill uit te voeren.
LMCache breidt dit idee uit voorbij de inferentie-engine.
In plaats van herbruikbare KV-states alleen binnen de eigen cache van vLLM te houden, introduceert LMCache een aparte cachelaag die KV-states over extra opslagniveaus kan opslaan en verplaatsen en ze beschikbaar kan maken voor een bredere serving-architectuur.
Een simpele manier om over het verschil na te denken is:
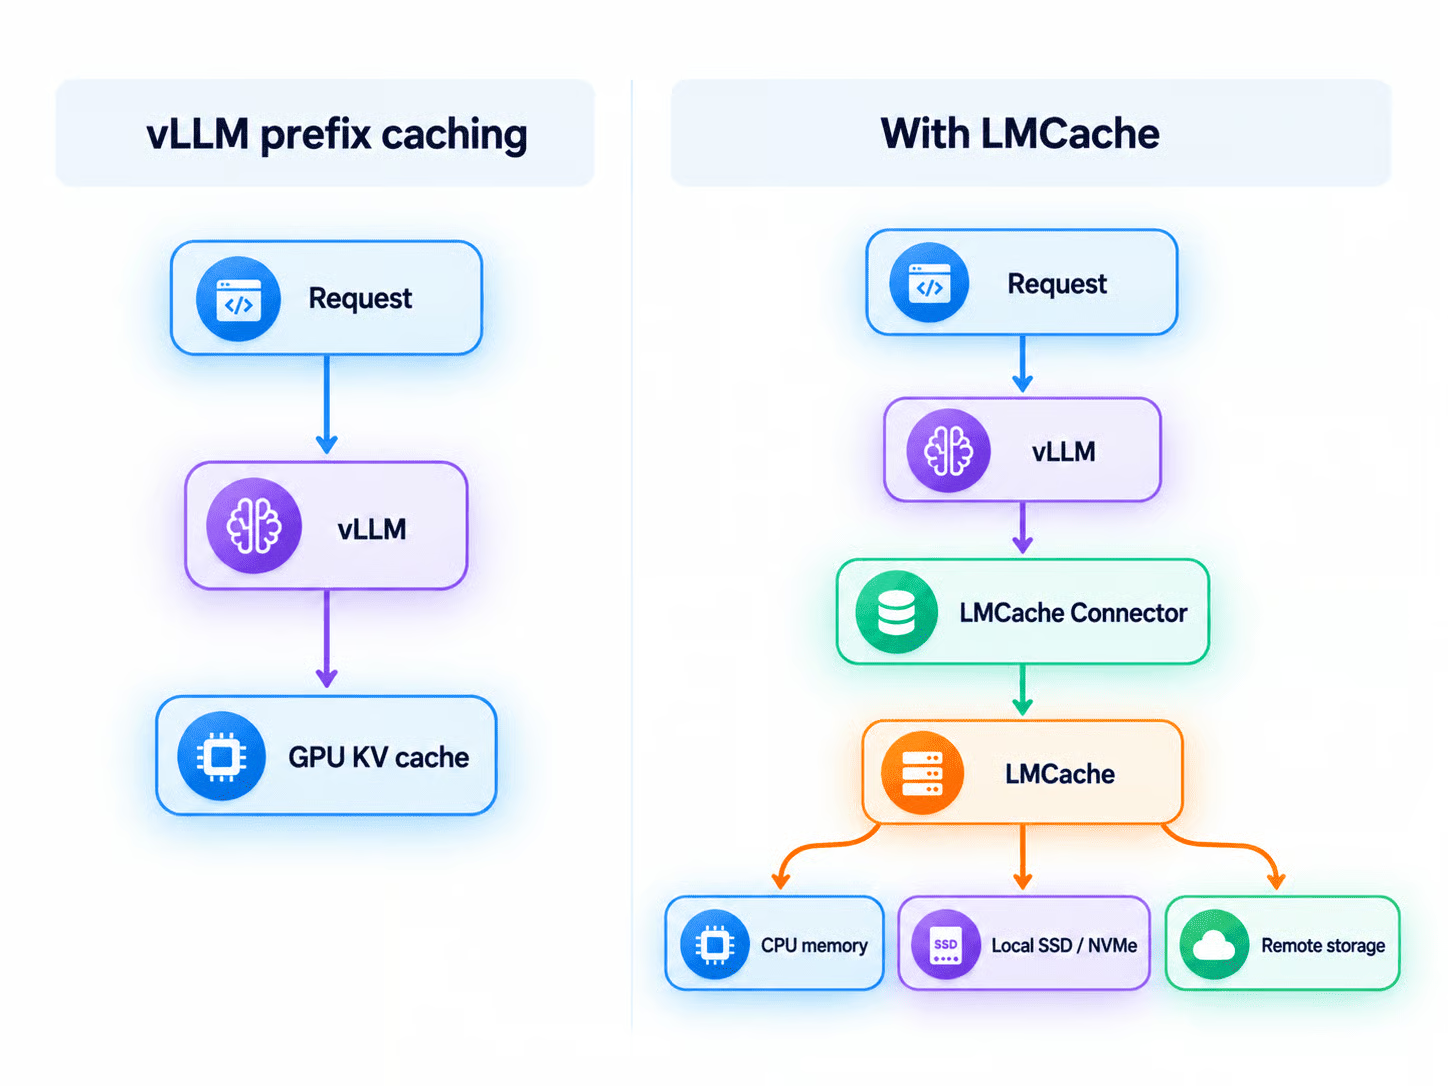
Figuur 3: vLLM prefix-caching vs LMCache. LMCache voegt een cachinglaag toe die KV-states over CPU-geheugen, lokale SSD/NVMe en externe opslag tiered in plaats van alleen GPU-geheugen.
LMCache vervangt dus niet het idee van KV-caching in vLLM. Het breidt KV-cachemanagement uit voorbij de normale grenzen van de inferentie-engine.
LMCache biedt meer dan een simpele in-memory cache. Het is ontworpen om KV-states op te slaan, te verplaatsen en te hergebruiken over verschillende opslagniveaus en inference-workers.
De belangrijkste feature van LMCache is het vermogen om eerder berekende KV-states te hergebruiken in plaats van dezelfde tokens opnieuw door het model te verwerken.
Dit is vooral handig wanneer verzoeken herhaaldelijk dezelfde of vergelijkbare context bevatten, zoals:
Door gecachte KV-states te hergebruiken kan LMCache herhaalde prefill-berekening verminderen en de time to first token verbeteren.
GPU-geheugen is beperkt en duur, vooral bij lange contexten.
LMCache kan KV-states buiten het GPU-geheugen verplaatsen en opslaan over meerdere niveaus, waaronder CPU-geheugen, lokale SSD- of NVMe-opslag en externe of gedistribueerde opslag.
Hierdoor kun je veel meer herbruikbare context beschikbaar houden dan in GPU-geheugen alleen past, terwijl veelgebruikte KV-states desgewenst alsnog terug naar de GPU worden verplaatst.
LMCache kan gecachte KV-states beschikbaar maken voor meerdere inference-workers in plaats van ze te binden aan één modelproces.
Als bijvoorbeeld één vLLM-worker een lang document verwerkt, kan een andere worker mogelijk de gecachte KV-states hergebruiken in plaats van dezelfde context opnieuw te berekenen.
Dit is vooral nuttig voor gedistribueerde serving, multi-GPU-deployments en apps waarbij verzoeken over meerdere inference-replica's worden gerouteerd.
LMCache integreert met vLLM via de KV-connectorinterface.
De applicatie kan blijven communiceren met het normale, OpenAI-compatibele vLLM-endpoint terwijl LMCache onder de inferentielaag opereert.
Dit betekent dat bestaande applicaties niet hoeven te veranderen hoe ze prompts sturen of responses ontvangen. LMCache verzorgt KV-opslag en -opvraging tussen vLLM en de geconfigureerde cache-backend.
LMCache kan als afzonderlijk proces van vLLM draaien.
In plaats van cachemanagement binnen elke inference-worker te houden, kan een dedicated LMCache-server KV-states onafhankelijk beheren en meerdere vLLM-processen bedienen.
Dit scheidt cachemanagement van model-serving, laat meerdere workers dezelfde cache delen en maakt het makkelijker om cachecapaciteit onafhankelijk van GPU-inferentieresources te schalen.
Traditionele prefix-caching werkt het best wanneer verzoeken hetzelfde begin van een prompt delen.
LMCache biedt ook CacheBlend voor workloads waarbij herbruikbare inhoud op verschillende posities kan verschijnen.
Een RAG-app kan bijvoorbeeld dezelfde documenten ophalen in een andere volgorde voor verschillende vragen.
CacheBlend kan delen van eerder berekende KV-states hergebruiken terwijl selectief de tokens opnieuw worden berekend die afhankelijk zijn van de nieuwe context.
Dit maakt KV-hergebruik nuttiger voor RAG, multi-documenttoepassingen en agentische workflows waarbij prompts vaak worden herschikt.
LMCache kan ook helpen KV-states over te dragen tussen aparte prefill- en decode-workers.
In deze architectuur verwerkt één groep GPU's de rekenintensieve promptfase, terwijl een andere groep token-generatie verzorgt.
LMCache levert de laag die wordt gebruikt om de resulterende KV-states tussen hen te verplaatsen.
Dit maakt het mogelijk om prefill- en decode-resources onafhankelijk te schalen en kan de GPU-benutting verbeteren in grotere inferentiedeployments.
Nu we begrijpen hoe LMCache werkt, koppelen we het aan vLLM, een high-performance LLM-inferentie-engine die is ontworpen voor efficiënt serving en geheugengebruik.
Voor deze gids gebruik ik IBM Granite 4.2 3B, een compact model dat sterke prestaties levert voor zijn grootte en toch licht genoeg is voor praktische tests.
We draaien LMCache in multiprocess-modus naast vLLM en verifiëren dat KV-states hergebruikt kunnen worden over verzoeken heen.
Voor deze tutorial gebruiken we Python 3.12, uv, vLLM, LMCache, de OpenAI Python-client, pandas en matplotlib.
Zorg voordat je begint dat je het volgende hebt:
Je kunt uv installeren met:
curl -LsSf https://astral.sh/uv/install.sh | shMaak daarna het project aan:
mkdir lmcache-tutorial
cd lmcache-tutorial
Maak en activeer een Python 3.12 virtual environment:
uv venv --python 3.12
source .venv/bin/activate
Installeer de benodigde dependencies:
uv pip install -U \
    "lmcache==0.5.4" \
    "vllm==0.28.0" \
    openai \
    pandas \
    matplotlib \
    --torch-backend=cu130
Hier gebruiken we cu130 omdat onze omgeving is ingericht met CUDA 13.
Als je een andere CUDA-versie gebruikt, wijzig dan de waarde van --torch-backend naar de compatibele PyTorch-backend voor jouw omgeving.
Granite 4.2 gebruikt een aangepaste reasoning-parser, dus download die van Hugging Face:
hf download ibm-granite/granite-4.2-3b \
    granite_thinking_parser.py \
    --local-dir .
Controleer tot slot of je GPU en CUDA-installatie worden gedetecteerd:
nvidia-smi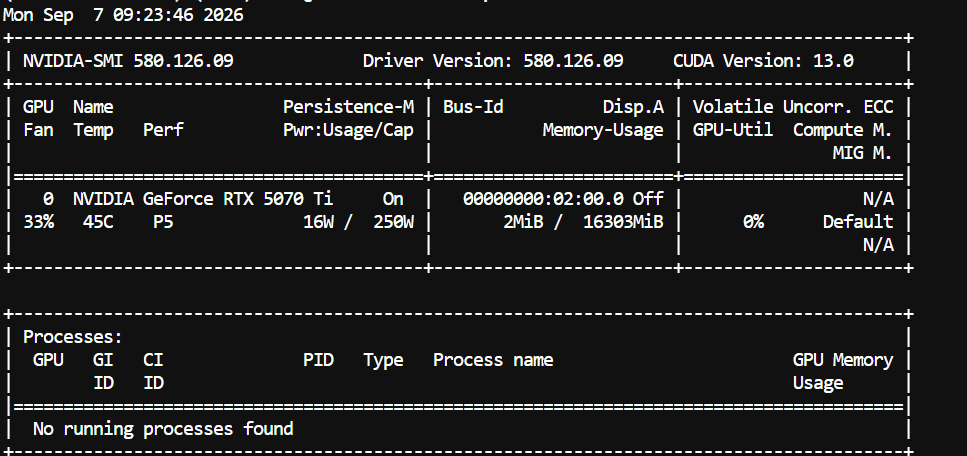
Voor deze tutorial gebruiken we een NVIDIA GeForce RTX 5070 Ti met 16 GB VRAM.
Het systeem draait NVIDIA-driver 580.126.09, met ondersteuning voor CUDA 13.0.
We hebben twee draaiende processen nodig: één voor de LMCache-server en een andere voor vLLM.
Start LMCache in de eerste terminal:
lmcache server \
    --host localhost \
    --port 6555 \
    --http-port 8081 \
    --l1-size-gb 20 \
    --eviction-policy LRU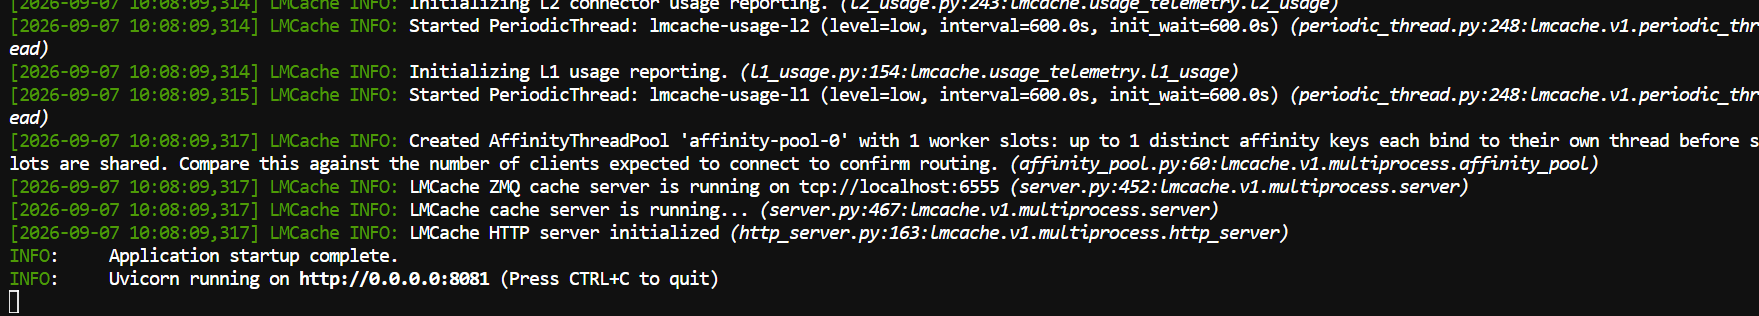
Hier gebruiken we:
6555 voor communicatie tussen vLLM en LMCache8081 voor de LMCache HTTP-interface20 GB voor de L1-cacheLRU als eviction policyLaat deze terminal open staan.
Open een tweede terminal, activeer dezelfde virtual environment en unset de uitbreidbare CUDA-allocatorconfiguratie als die is ingeschakeld:
cd lmcache-tutorial
source .venv/bin/activate
unset PYTORCH_CUDA_ALLOC_CONF
Start nu vLLM met de LMCache-connector:
vllm serve ibm-granite/granite-4.2-3b \
  --served-model-name granite-4.2-3b \
  --dtype bfloat16 \
  --max-model-len 65536 \
  --kv-cache-dtype fp8 \
  --gpu-memory-utilization 0.90 \
  --enforce-eager \
  --max-num-seqs 1 \
  --max-num-batched-tokens 2048 \
  --no-enable-prefix-caching \
  --reasoning-parser granite_thinking_parser \
  --reasoning-parser-plugin "$(pwd)/granite_thinking_parser.py" \
  --tool-call-parser qwen3_coder \
  --enable-auto-tool-choice \
  --port 8000 \
  --kv-transfer-config \
  '{
    "kv_connector":"LMCacheMPConnector",
    "kv_connector_module_path":"lmcache.integration.vllm.lmcache_mp_connector",
    "kv_role":"kv_both",
    "kv_connector_extra_config":{
      "lmcache.mp.host":"tcp://localhost",
      "lmcache.mp.port":6555,
      "lmcache.mp.mp_transfer_mode":"lmcache_driven"
    }
  }'
We schakelen de ingebouwde prefix-caching van vLLM uit met:
--no-enable-prefix-cachingDit zorgt ervoor dat de volgende experimenten zich specifiek richten op KV-hergebruik via LMCache.
Zodra vLLM klaar is met laden, is het model beschikbaar via het OpenAI-compatibele endpoint:
http://localhost:8000/v1We voeren nu een eenvoudig gecontroleerd experiment uit om te bevestigen dat LMCache werkt.
We maken een grote gedeelde prefix, legen de cache, sturen de prefix één keer om LMCache te vullen en sturen daarna een ander verzoek met dezelfde prefix maar een andere vraag.
Maak eerst de OpenAI-client aan:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local",
)
Maak vervolgens een lang gedeeld document:
base_text = """
Large language model inference consists of two main stages:
prefill and decoding.

During prefill, the model processes the input sequence and calculates
the key and value tensors used by the attention mechanism.

During autoregressive decoding, these tensors are reused so the model
does not need to recompute attention states for every previous token.

KV cache management is therefore an important part of modern LLM
serving infrastructure, particularly for long-context applications.
"""

document = base_text * 500

SYSTEM_PROMPT = f"""
You are a technical assistant.

Use only the following document to answer the user's question.

DOCUMENT:

{document}
"""
Door het document 500 keer te herhalen, krijgen we een grote gedeelde prefix die duur genoeg is om het effect van KV-hergebruik zichtbaar te maken.
Voordat je het eerste verzoek stuurt, maak je LMCache leeg zodat we beginnen met een lege cache:
import subprocess
import time

subprocess.run(
    [
        "lmcache",
        "kvcache",
        "clear",
        "--url",
        "http://localhost:8081",
    ],
    check=True,
)

time.sleep(0.5)
Dit zorgt ervoor dat het eerste verzoek een cold-cache-verzoek is en geen KV-states kan hergebruiken die van een eerdere test zijn overgebleven.
Stuur nu het eerste verzoek:
prompt_1 = SYSTEM_PROMPT + """

Question:
Explain the purpose of the KV cache.
"""

start = time.perf_counter()

client.completions.create(
    model="granite-4.2-3b",
    prompt=prompt_1,
    max_tokens=100,
    temperature=0,
)

latency_1 = time.perf_counter() - start
Dit is het cachewarmer-verzoek. vLLM moet de lange gedeelde prefix tijdens de prefill verwerken, terwijl LMCache de resulterende KV-states opslaat.
Houd daarna de gedeelde prefix exact hetzelfde en verander alleen de vraag:
prompt_2 = SYSTEM_PROMPT + """

Question:
Explain what happens during prefill.
"""

start = time.perf_counter()

client.completions.create(
    model="granite-4.2-3b",
    prompt=prompt_2,
    max_tokens=100,
    temperature=0,
)

latency_2 = time.perf_counter() - start
Omdat de grote prefix ongewijzigd is, kan LMCache de KV-states die door het eerste verzoek zijn gegenereerd hergebruiken in plaats van de volledige prefix opnieuw te berekenen.
Vergelijk tot slot de twee verzoektijden:
print(f"Cold request:   {latency_1:.3f}s")
print(f"Warm request:   {latency_2:.3f}s")
print(f"Speedup:        {latency_1 / latency_2:.2f}x")

print(
    f"Latency saved:  "
    f"{((latency_1 - latency_2) / latency_1) * 100:.1f}%"
)
Mijn run leverde op:
Cold request:   26.276s
Warm request:   4.402s
Speedup:        5.97x
Latency saved:  83.2%
Het warme verzoek was bijna 6× sneller en verlaagde de end-to-end latency met 83,2%.
De vragen zijn verschillend, dus LMCache cachet niet de uiteindelijke respons. Het hergebruikt in plaats daarvan de KV-states die voor de gedeelde prefix zijn gegenereerd.
Het eerste verzoek moet de volledige lange prefix tijdens de prefill verwerken en die KV-states vanaf nul aanmaken.
Bij het tweede verzoek haalt LMCache de overeenkomende gecachte states op, waardoor vLLM het grootste deel van dat herhaalde prefill-werk kan overslaan en zich alleen hoeft te richten op het nieuwe suffix.
Dit bevestigt dat LMCache de gedeelde prefix met succes hergebruikt.
LMCache is vooral nuttig wanneer een applicatie herhaaldelijk grote hoeveelheden identieke context verstuurt.
Een paar veelvoorkomende voorbeelden:
Een gebruiker kan meerdere vragen stellen over hetzelfde opgehaalde document.
In plaats van het hele document voor elke vraag vanaf nul te verwerken, kunnen de KV-states worden hergebruikt.
Code-assistenten sturen vaak repository-bestanden, projectinstructies en andere grote stukken context mee met elke modelaanroep.
Veel van die context blijft identiek terwijl de taak verandert.
Agents hergebruiken vaak grote systeem-prompts, tooldefinities, geheugen, instructies en omgevingsstatus over veel stappen heen.
Een langlopend gesprek kan bij elk nieuw bericht herhaaldelijk een groot deel van de geschiedenis meesturen.
Meerdere agents kunnen dezelfde achtergronddocumenten of systeemcontext delen terwijl ze aan verschillende taken werken.
In al deze gevallen krijgt het model herhaaldelijk informatie te zien die het tijdens eerdere verzoeken al heeft verwerkt.
LMCache biedt een manier om dat werk op KV-cache-niveau te hergebruiken.
LMCache pakt een belangrijke bron van verspilling aan bij long-context-inferentie door de KV-states die tijdens de prefill worden gemaakt herbruikbaar te maken.
In plaats van keer op keer dezelfde gedeelde context te verwerken, kan het model werk hergebruiken dat het al heeft gedaan.
We hebben de benchmarkcode of gedetailleerde resultaten niet in deze tutorial opgenomen, maar we hebben wel een aparte testset gedraaid met dezelfde setup.
De resultaten waren significant. Het hergebruiken van een grote gedeelde prefix verlaagde de totale verzoeks-latency van 26,276 seconden naar 4,386 seconden.
De gemiddelde time to first token daalde van 22,149 seconden naar 0,726 seconden, een verbetering van 30,54×. De winst nam ook toe met de contextgrootte, van 3,55× bij circa 12.000 gedeelde tekens tot 30,22× bij ongeveer 245.000 tekens.
Simpel gezegd: hoe meer context kan worden hergebruikt, hoe meer werk LMCache kan vermijden.
DeepSeek is een goed praktijkvoorbeeld van waarom dit ertoe doet.
Het cachesysteem kan overeenkomende promptprefixen hergebruiken, wat vooral waardevol is voor code-agents die herhaaldelijk dezelfde systeem-prompts, tools, gespreksgeschiedenis en codecontext sturen.
Hogere cache-hit-ratio's betekenen minder herhaald rekenwerk en lagere kosten voor zowel aanbieder als gebruiker.
De belangrijkste les uit deze gids is dat snellere LLM-inferentie niet alleen gaat over betere GPU's of snellere tokengeneratie. Het gaat ook over onnodig werk niet herhalen.
Voor RAG-systemen, code-assistenten, agents en andere long-context-toepassingen kan herbruikbare KV-caching een belangrijk onderdeel zijn om latency te verbeteren, GPU-gebruik te verlagen en inferentiekosten te reduceren.
Topcursussen bij DataCamp
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min


