
Last chance! 50% off DataCamp Premium
Sale ends in
L’inferenza dei modelli di grandi dimensioni può diventare sempre più costosa man mano che i prompt crescono.
I sistemi RAG, gli agenti di coding, i workflow multi-agente e le conversazioni lunghe spesso inviano più volte al modello gli stessi documenti, prompt di sistema, definizioni di tool o cronologia della conversazione.
Ogni volta che questo contesto condiviso viene elaborato durante il prefill, il modello genera stati key-value (KV) che vengono usati durante la generazione dei token.
Ricalcolare questi stati per lo stesso contesto spreca compute GPU e aumenta la latenza.
LMCache risolve questo problema aggiungendo un livello dedicato di cache KV allo stack di inferenza.
Può memorizzare stati KV calcolati in precedenza e renderli riutilizzabili tra richieste e worker di inferenza, supportando al contempo CPU, storage locale, backend remoti e architetture di serving disaggregato.
In questo tutorial ti mostrerò come funziona LMCache, in cosa differisce dal KV caching nativo di vLLM e dove si inseriscono, nel serving moderno degli LLM, funzionalità come lo storage multi-tier, la cache condivisa, CacheBlend e la disaggregazione prefill/decode.
Collegherai quindi LMCache a vLLM, servirai IBM Granite 4.2 3B ed eseguirai un esperimento controllato per misurare come il riuso di un ampio prefisso condiviso influenzi la latenza di inferenza.
LMCache è un livello di gestione della cache KV per l’inferenza LLM open source.
Consente di archiviare gli stati key-value creati durante il prefill e di riutilizzarli quando le richieste future condividono lo stesso prefisso del prompt.
Fonte: LMCache – Building the foundation of AI memory tensor with KV Cache Infrastructure
Questo è diverso dal tradizionale caching delle risposte.
Una cache di risposte memorizza la risposta finale generata e la restituisce quando la stessa richiesta ricompare:
cache = {
    "What is Python?":
        "Python is a general-purpose programming language..."
}
LMCache agisce prima nel processo di inferenza. Invece di mettere in cache la risposta finale, archivia gli stati di attenzione KV prodotti mentre il modello elabora il prompt.
Per esempio, senza un KV caching riutilizzabile, un lungo prompt condiviso deve eseguire di nuovo il prefill ogni volta che si aggiunge una nuova domanda.
Con LMCache, la prima richiesta esegue il prefill completo e memorizza gli stati KV risultanti. Le richieste successive con lo stesso prefisso possono caricare quegli stati ed elaborare solo i token nuovi.
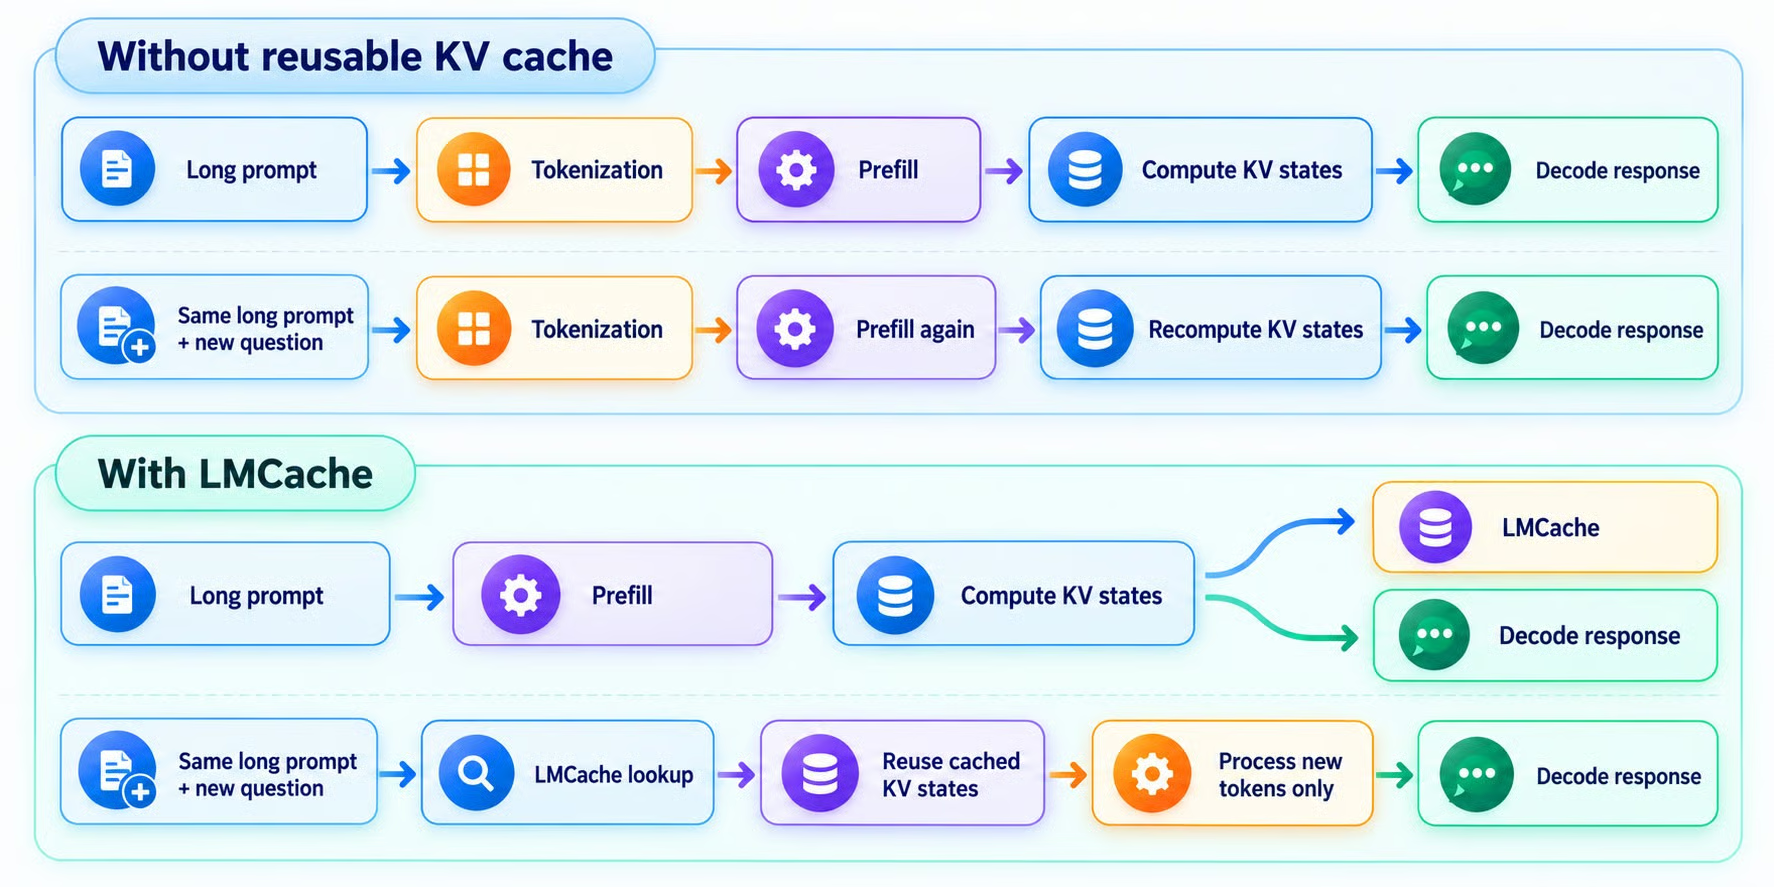
Fig. 1: Senza una cache KV riutilizzabile, l’intero prompt viene ricalcolato per ogni richiesta; con LMCache, gli stati KV in cache vengono riutilizzati e si elaborano solo i token nuovi.
Questo diventa sempre più prezioso man mano che crescono le finestre di contesto.
Rielaborare alcune centinaia di token può costare poco, ma processare ripetutamente decine di migliaia di token condivisi può aumentare sensibilmente la latenza e l’uso della GPU.
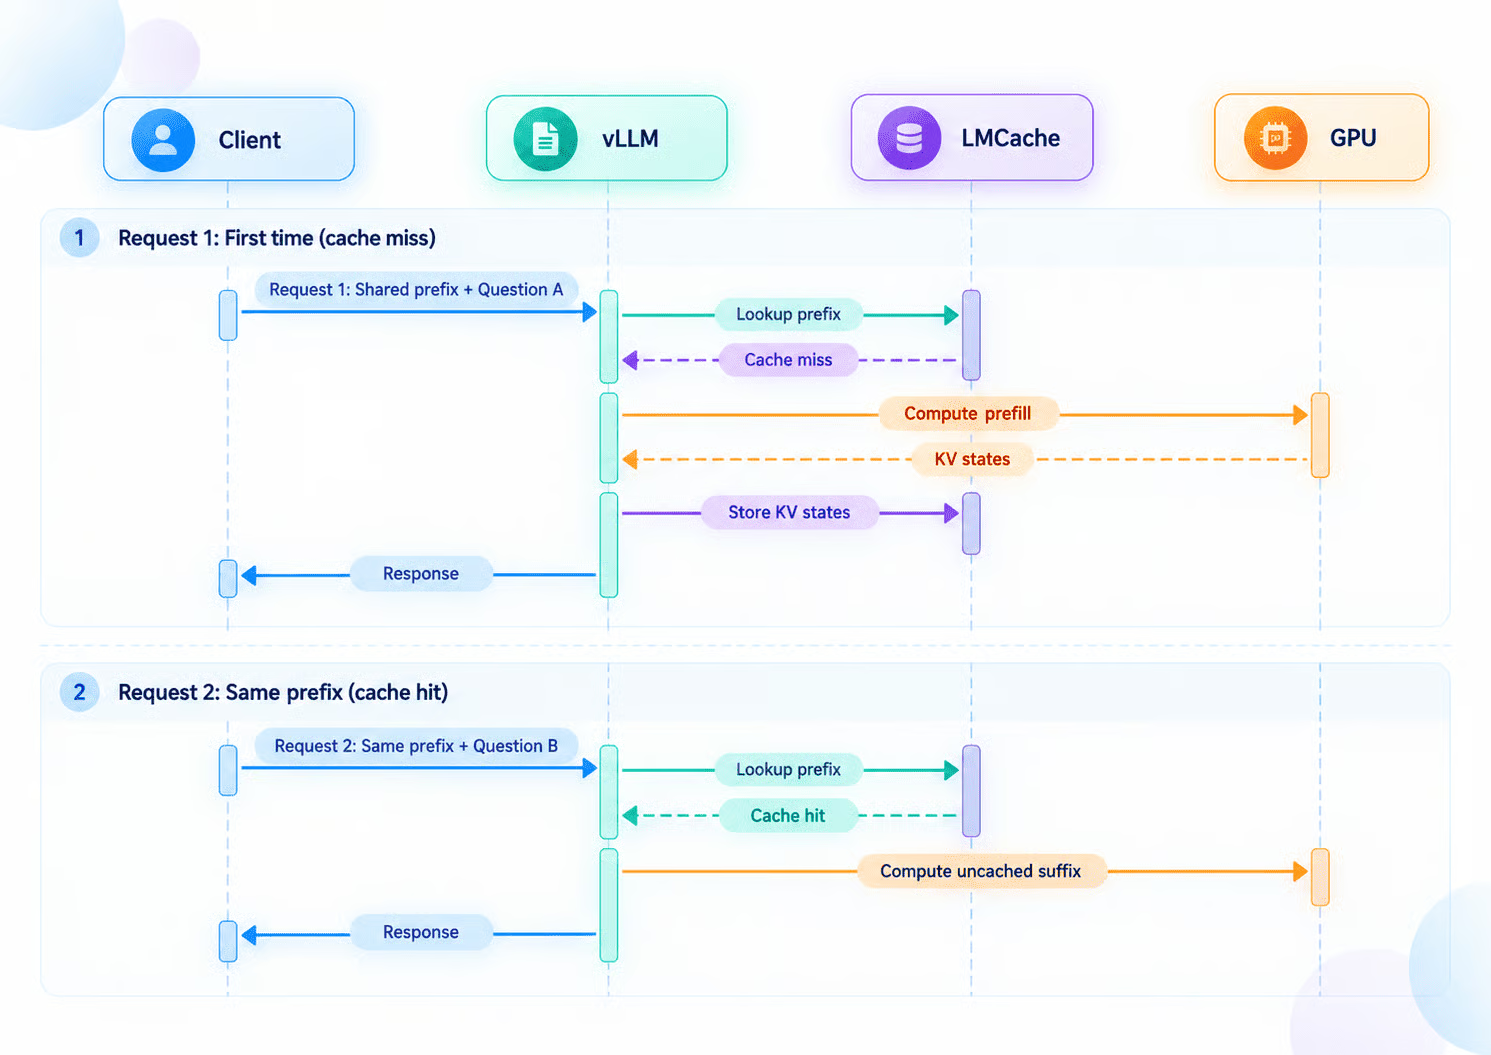
Il modo più semplice per capire LMCache è seguire due richieste che condividono lo stesso prefisso.
Per la prima richiesta, LMCache verifica se esistono già stati KV riutilizzabili. Poiché è la prima volta che il prompt viene visto, la ricerca porta a un mancato riscontro in cache.
vLLM quindi esegue il prefill sulla GPU, crea gli stati KV e li passa a LMCache per l’archiviazione.
Per la seconda richiesta, il prefisso condiviso resta lo stesso, ma la domanda cambia.
LMCache esegue un’altra ricerca. Questa volta il prefisso è già disponibile, risultando in un hit di cache. Gli stati in cache vengono riutilizzati e la GPU deve elaborare solo il suffisso non in cache.
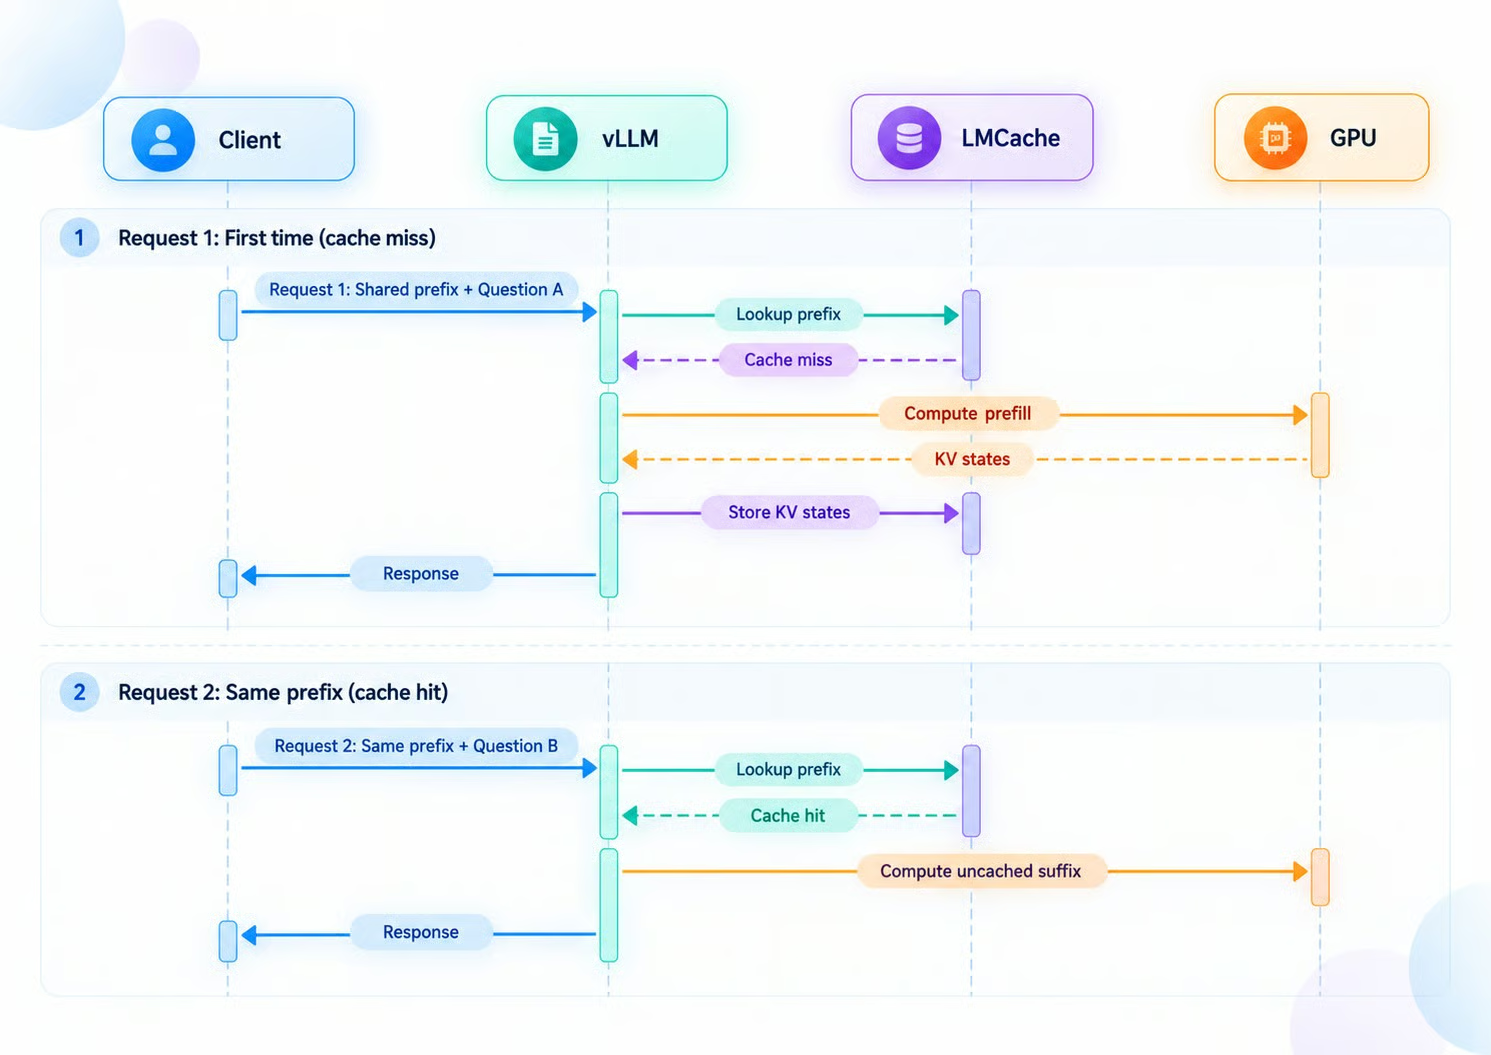
Fig. 2: La prima richiesta con un nuovo prefisso manca la cache, quindi vLLM calcola il prefill e memorizza gli stati KV in LMCache; una richiesta ripetuta con lo stesso prefisso colpisce la cache e calcola solo il nuovo suffisso.
Il punto importante è che LMCache non richiede che l’intera richiesta sia identica. Conta il prefisso riutilizzabile.
Questo lo rende adatto ad applicazioni in cui il contesto di fondo resta uguale mentre cambia la query dell’utente.
vLLM supporta già il caching automatico dei prefissi, quindi è legittimo chiedersi perché serva LMCache.
Entrambi gli approcci cercano di evitare di ricalcolare gli stati KV per i prefissi del prompt che il modello ha già elaborato.
La differenza principale è dove vive quella cache e quanto ampiamente può essere riutilizzata.
|
Funzionalità |
KV caching nativo vLLM |
LMCache |
|
Riutilizzo KV di prefisso |
Sì, tramite Automatic Prefix Caching |
Sì |
|
Riutilizzo KV non di prefisso |
No |
Sì, tramite CacheBlend |
|
Cache KV su GPU |
Sì |
Funziona insieme alla cache KV su GPU di vLLM |
|
Offloading KV su CPU |
Sì |
Sì |
|
Storage SSD / NVMe |
Supportato tramite livelli di storage secondari |
Sì, incluso disco locale, NVMe e GDS |
|
Storage remoto |
Supporta opzioni come object storage compatibile S3 |
Supporta più backend tra cui Redis/Valkey, S3, Mooncake, InfiniStore, NIXL e altri |
|
Condivisione cache cross-process |
Supportata in alcune configurazioni, incluse P2P e storage condiviso |
Funzione centrale, con più worker di inferenza che possono usare KV in cache condivise |
|
Servizio di cache standalone |
No, il caching è gestito come parte dello stack di serving di vLLM |
Sì, la modalità MP di LMCache può girare indipendentemente da vLLM |
|
Scalabilità indipendente della cache |
Le risorse della cache sono in genere configurate con il deployment di inferenza |
La capacità della cache può essere scalata separatamente dai worker vLLM |
|
Disaggregazione prefill/decode |
Supportata tramite connettori KV |
Progettato specificamente per supportare il trasferimento KV tra worker di prefill e di decode |
|
Ideale per |
Riutilizzo efficiente dei prefissi e offloading KV all’interno di deployment vLLM |
Carichi KV-cache su larga scala, condivisi, multi-tier o distribuiti |
Il prefix caching integrato di vLLM è l’opzione più semplice quando le richieste ripetute sono gestite dallo stesso server di inferenza.
Se diverse richieste iniziano con gli stessi token, vLLM può riutilizzare i blocchi KV esistenti invece di eseguire di nuovo l’intero prefill.
LMCache estende questa idea oltre il motore di inferenza.
Invece di mantenere gli stati KV riutilizzabili solo nella cache di vLLM, LMCache introduce un livello di cache separato che può archiviare e spostare stati KV tra ulteriori livelli di storage e renderli disponibili a un’architettura di serving più ampia.
Un modo semplice per pensare alla differenza è:
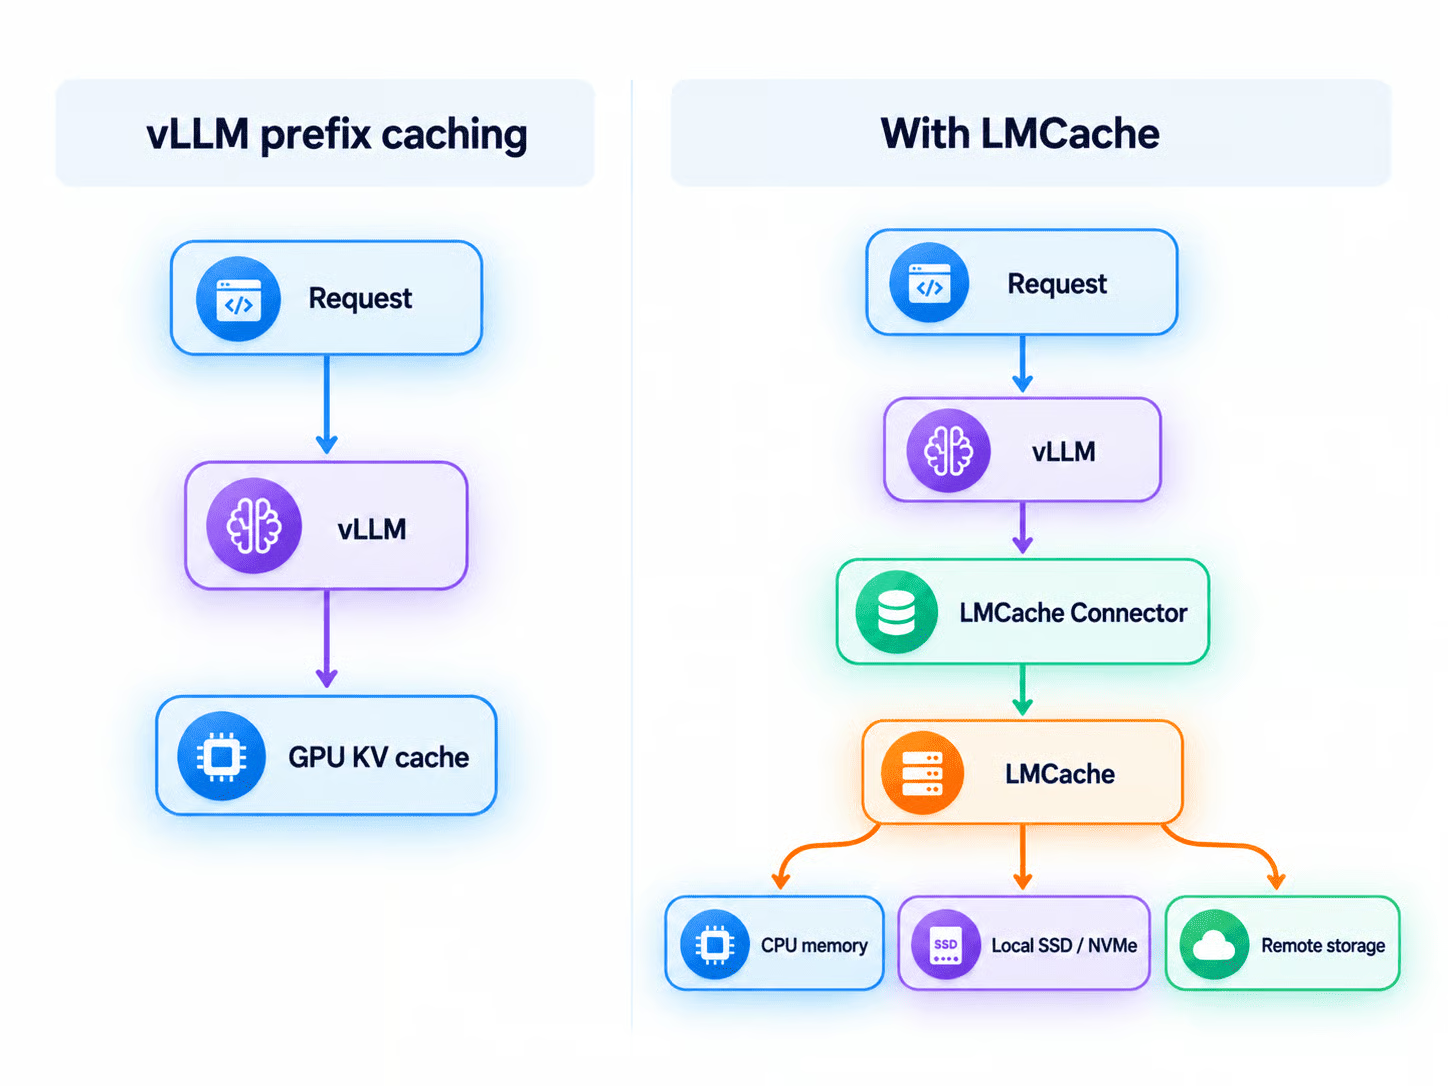
Fig. 3: caching di prefissi vLLM vs LMCache. LMCache aggiunge un livello di caching che stratifica gli stati KV tra memoria CPU, SSD/NVMe locali e storage remoto invece della sola memoria GPU.
Quindi LMCache non sostituisce l’idea del KV caching in vLLM. Estende la gestione della KV-cache oltre i normali confini del motore di inferenza.
LMCache offre più di una semplice cache in memoria. È progettato per archiviare, spostare e riutilizzare stati KV tra diversi livelli di storage e worker di inferenza.
La funzione principale di LMCache è la possibilità di riutilizzare stati KV calcolati in precedenza invece di far passare di nuovo gli stessi token attraverso il modello.
Questo è particolarmente utile quando le richieste includono ripetutamente lo stesso contesto o uno simile, come:
Riutilizzando stati KV in cache, LMCache può ridurre i calcoli di prefill ripetuti e migliorare il time to first token.
La memoria GPU è limitata e costosa, soprattutto con contesti lunghi.
LMCache può spostare gli stati KV oltre la memoria GPU e archiviarli su più livelli, tra cui memoria CPU, storage locale SSD o NVMe e storage remoto o distribuito.
Questo rende possibile mantenere molto più contesto riutilizzabile di quanto potrebbe entrare interamente nella memoria GPU, riportando comunque in GPU gli stati KV usati di frequente quando servono.
LMCache può rendere disponibili gli stati KV in cache a più worker di inferenza invece di tenerli legati a un singolo processo del modello.
Per esempio, se un worker vLLM elabora un documento lungo, un altro worker può potenzialmente riutilizzare gli stati KV in cache invece di ricalcolare lo stesso contesto.
Questo è particolarmente utile per il serving distribuito, i deployment multi-GPU e le applicazioni in cui le richieste sono instradate su diverse repliche di inferenza.
LMCache si integra con vLLM tramite la sua interfaccia di connettore KV.
L’applicazione può continuare a comunicare con il normale endpoint vLLM compatibile con OpenAI mentre LMCache opera sotto il livello di inferenza.
Questo significa che le applicazioni esistenti non devono cambiare il modo in cui inviano prompt o ricevono risposte. LMCache gestisce l’archiviazione e il recupero dei KV tra vLLM e il backend di cache configurato.
LMCache può essere eseguito come processo separato da vLLM.
Invece di mantenere la gestione della cache all’interno di ciascun worker di inferenza, un server LMCache dedicato può gestire gli stati KV in modo indipendente e servire più processi vLLM.
Questo separa la gestione della cache dal serving del modello, consente a più worker di condividere la stessa cache e rende più semplice scalare la capacità di cache indipendentemente dalle risorse di inferenza GPU.
Il caching tradizionale dei prefissi funziona al meglio quando le richieste condividono lo stesso inizio di prompt.
LMCache offre anche CacheBlend per carichi in cui il contenuto riutilizzabile può apparire in posizioni diverse.
Per esempio, un’applicazione RAG potrebbe recuperare gli stessi documenti in un ordine differente per domande diverse.
CacheBlend può riutilizzare parti di stati KV calcolati in precedenza, ricalcolando selettivamente i token che dipendono dal nuovo contesto.
Questo rende il riuso dei KV più utile per RAG, applicazioni multi-documento e workflow agentici in cui i prompt sono spesso riorganizzati.
LMCache può anche aiutare a trasferire stati KV tra worker separati di prefill e di decode.
In questa architettura, un gruppo di GPU gestisce la fase di elaborazione del prompt, intensiva in termini di calcolo, mentre un altro gruppo gestisce la generazione dei token.
LMCache fornisce il livello usato per spostare tra loro gli stati KV risultanti.
Questo consente di scalare in modo indipendente le risorse di prefill e di decoding e può migliorare l’utilizzo della GPU in deployment di inferenza più grandi.
Ora che sappiamo come funziona LMCache, colleghiamolo a vLLM, un motore di inferenza LLM ad alte prestazioni progettato per un serving e una gestione della memoria efficienti.
Per questa guida userò IBM Granite 4.2 3B, un modello compatto che offre prestazioni solide rispetto alle sue dimensioni, rimanendo abbastanza leggero per test pratici.
Eseguiremo LMCache in modalità multiprocesso insieme a vLLM e verificheremo che gli stati KV possano essere riutilizzati tra le richieste.
Per questo tutorial useremo Python 3.12, uv, vLLM, LMCache, il client Python di OpenAI, pandas e matplotlib.
Prima di iniziare, assicurati di avere:
Puoi installare uv con:
curl -LsSf https://astral.sh/uv/install.sh | shQuindi crea il progetto:
mkdir lmcache-tutorial
cd lmcache-tutorial
Crea e attiva un ambiente virtuale Python 3.12:
uv venv --python 3.12
source .venv/bin/activate
Installa le dipendenze richieste:
uv pip install -U \
    "lmcache==0.5.4" \
    "vllm==0.28.0" \
    openai \
    pandas \
    matplotlib \
    --torch-backend=cu130
Qui usiamo cu130 perché il nostro ambiente è configurato con CUDA 13.
Se usi una versione CUDA diversa, cambia il valore di --torch-backend con il backend PyTorch compatibile per il tuo ambiente.
Granite 4.2 usa un parser di reasoning personalizzato, quindi scaricalo da Hugging Face:
hf download ibm-granite/granite-4.2-3b \
    granite_thinking_parser.py \
    --local-dir .
Infine, verifica che la tua GPU e l’installazione di CUDA siano rilevate:
nvidia-smi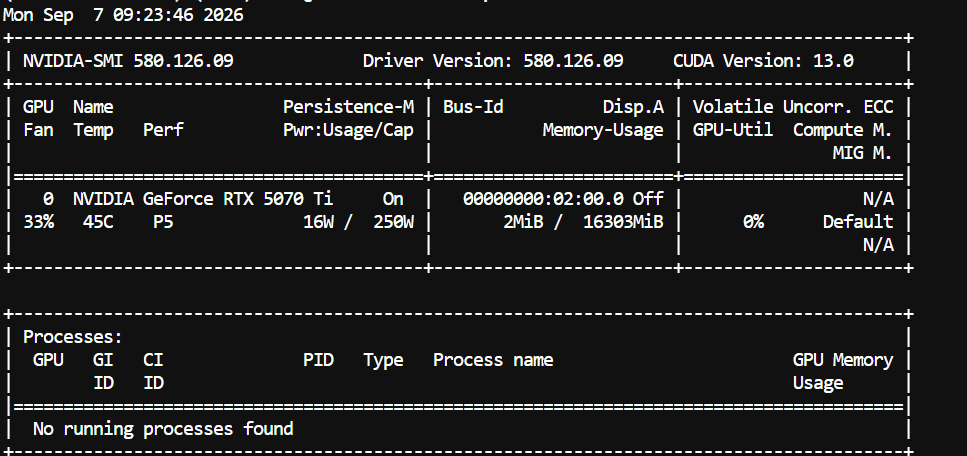
Per questo tutorial usiamo una NVIDIA GeForce RTX 5070 Ti con 16 GB di VRAM.
Il sistema esegue il driver NVIDIA 580.126.09, con supporto CUDA 13.0.
Ci servono due processi in esecuzione: uno per il server LMCache e un altro per vLLM.
Avvia LMCache nel primo terminale:
lmcache server \
    --host localhost \
    --port 6555 \
    --http-port 8081 \
    --l1-size-gb 20 \
    --eviction-policy LRU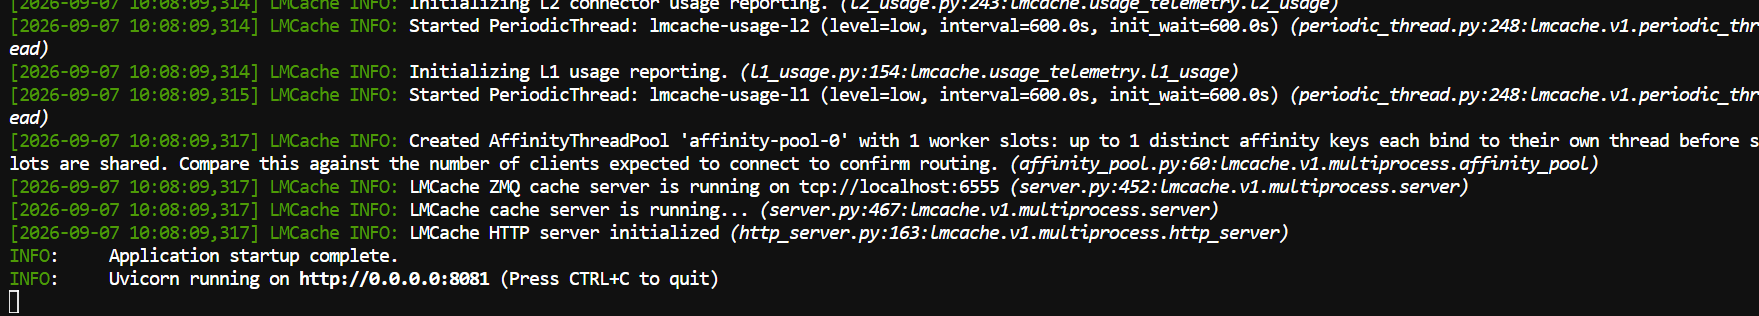
Qui usiamo:
6555 per la comunicazione tra vLLM e LMCache8081 per l’interfaccia HTTP di LMCache20 GB per la cache L1LRU come politica di evictionLascia questo terminale in esecuzione.
Apri un secondo terminale, attiva lo stesso ambiente virtuale e disattiva la configurazione dell’allocatore CUDA espandibile se è abilitata:
cd lmcache-tutorial
source .venv/bin/activate
unset PYTORCH_CUDA_ALLOC_CONF
Ora avvia vLLM con il connettore LMCache:
vllm serve ibm-granite/granite-4.2-3b \
  --served-model-name granite-4.2-3b \
  --dtype bfloat16 \
  --max-model-len 65536 \
  --kv-cache-dtype fp8 \
  --gpu-memory-utilization 0.90 \
  --enforce-eager \
  --max-num-seqs 1 \
  --max-num-batched-tokens 2048 \
  --no-enable-prefix-caching \
  --reasoning-parser granite_thinking_parser \
  --reasoning-parser-plugin "$(pwd)/granite_thinking_parser.py" \
  --tool-call-parser qwen3_coder \
  --enable-auto-tool-choice \
  --port 8000 \
  --kv-transfer-config \
  '{
    "kv_connector":"LMCacheMPConnector",
    "kv_connector_module_path":"lmcache.integration.vllm.lmcache_mp_connector",
    "kv_role":"kv_both",
    "kv_connector_extra_config":{
      "lmcache.mp.host":"tcp://localhost",
      "lmcache.mp.port":6555,
      "lmcache.mp.mp_transfer_mode":"lmcache_driven"
    }
  }'
Disabilitiamo il prefix caching integrato di vLLM con:
--no-enable-prefix-cachingQuesto consente ai seguenti esperimenti di concentrarsi specificamente sul riuso dei KV tramite LMCache.
Una volta che vLLM ha terminato il caricamento, il modello è disponibile tramite il suo endpoint compatibile con OpenAI:
http://localhost:8000/v1Ora eseguiremo un semplice esperimento controllato per confermare che LMCache stia funzionando.
Creeremo un ampio prefisso condiviso, svuoteremo la cache, invieremo il prefisso una volta per popolare LMCache e poi invieremo un’altra richiesta con lo stesso prefisso ma una domanda diversa.
Per prima cosa, crea il client OpenAI:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local",
)
Poi crea un documento condiviso lungo:
base_text = """
Large language model inference consists of two main stages:
prefill and decoding.

During prefill, the model processes the input sequence and calculates
the key and value tensors used by the attention mechanism.

During autoregressive decoding, these tensors are reused so the model
does not need to recompute attention states for every previous token.

KV cache management is therefore an important part of modern LLM
serving infrastructure, particularly for long-context applications.
"""

document = base_text * 500

SYSTEM_PROMPT = f"""
You are a technical assistant.

Use only the following document to answer the user's question.

DOCUMENT:

{document}
"""
Ripetere il documento 500 volte ci dà un ampio prefisso condiviso abbastanza costoso da rendere visibile l’effetto del riuso dei KV.
Prima di inviare la prima richiesta, svuota LMCache così da partire con una cache vuota:
import subprocess
import time

subprocess.run(
    [
        "lmcache",
        "kvcache",
        "clear",
        "--url",
        "http://localhost:8081",
    ],
    check=True,
)

time.sleep(0.5)
Questo assicura che la prima richiesta sia una richiesta a cache fredda e non possa riutilizzare stati KV rimasti da un test precedente.
Ora invia la prima richiesta:
prompt_1 = SYSTEM_PROMPT + """

Question:
Explain the purpose of the KV cache.
"""

start = time.perf_counter()

client.completions.create(
    model="granite-4.2-3b",
    prompt=prompt_1,
    max_tokens=100,
    temperature=0,
)

latency_1 = time.perf_counter() - start
Questa è la richiesta di riscaldamento della cache. vLLM deve elaborare l’ampio prefisso condiviso durante il prefill, mentre LMCache memorizza gli stati KV risultanti.
Poi, mantieni esattamente uguale il prefisso condiviso e cambia solo la domanda:
prompt_2 = SYSTEM_PROMPT + """

Question:
Explain what happens during prefill.
"""

start = time.perf_counter()

client.completions.create(
    model="granite-4.2-3b",
    prompt=prompt_2,
    max_tokens=100,
    temperature=0,
)

latency_2 = time.perf_counter() - start
Poiché l’ampio prefisso è invariato, LMCache può riutilizzare gli stati KV generati dalla prima richiesta invece di ricalcolare di nuovo l’intero prefisso.
Infine, confronta i tempi delle due richieste:
print(f"Cold request:   {latency_1:.3f}s")
print(f"Warm request:   {latency_2:.3f}s")
print(f"Speedup:        {latency_1 / latency_2:.2f}x")

print(
    f"Latency saved:  "
    f"{((latency_1 - latency_2) / latency_1) * 100:.1f}%"
)
La mia esecuzione ha prodotto:
Cold request:   26.276s
Warm request:   4.402s
Speedup:        5.97x
Latency saved:  83.2%
La richiesta calda è stata quasi 6× più veloce, riducendo la latenza end-to-end di 83,2%.
Le domande sono diverse, quindi LMCache non sta mettendo in cache la risposta finale. Sta invece riutilizzando gli stati KV generati per il prefisso condiviso.
La prima richiesta deve elaborare l’intero lungo prefisso durante il prefill e creare da zero quegli stati KV.
Nella seconda richiesta, LMCache recupera gli stati in cache corrispondenti, consentendo a vLLM di saltare gran parte di quel lavoro di prefill ripetuto e concentrarsi solo sul nuovo suffisso.
Questo conferma che LMCache sta riutilizzando correttamente il prefisso condiviso.
LMCache è particolarmente utile quando un’applicazione invia ripetutamente grandi quantità di contesto identico.
Alcuni esempi comuni sono:
Un utente può porre più domande sullo stesso documento recuperato.
Invece di elaborare l’intero documento da zero per ogni domanda, si possono riutilizzare i suoi stati KV.
Gli assistenti di coding inviano spesso file di repository, istruzioni di progetto e altri grandi pezzi di contesto a ogni chiamata del modello.
Gran parte di quel contesto resta identico mentre cambia il task.
Gli agenti spesso riutilizzano ampi prompt di sistema, definizioni di tool, memoria, istruzioni e stato dell’ambiente in molti passaggi.
Una conversazione di lunga durata può inviare ripetutamente una parte sostanziale della sua cronologia a ogni nuovo messaggio.
Più agenti possono condividere gli stessi documenti di background o contesto di sistema mentre lavorano su task diversi.
In tutti questi casi, al modello viene mostrata ripetutamente un’informazione che ha già elaborato in richieste precedenti.
LMCache offre un modo per riutilizzare quel lavoro a livello di KV-cache.
LMCache affronta una grande fonte di spreco nell’inferenza con contesti lunghi rendendo riutilizzabili gli stati KV creati durante il prefill.
Invece di elaborare più e più volte lo stesso contesto condiviso, il modello può riutilizzare il lavoro già fatto.
Non abbiamo incluso in questo tutorial il codice di benchmark o i risultati dettagliati, ma abbiamo eseguito un set separato di test con la stessa configurazione.
I risultati sono stati significativi. Il riuso di un grande prefisso condiviso ha ridotto la latenza totale della richiesta da 26,276 secondi a 4,386 secondi.
Il tempo medio al primo token è passato da 22,149 secondi a 0,726 secondi, un miglioramento di 30,54×. I guadagni sono cresciuti anche con la dimensione del contesto, da 3,55× con circa 12.000 caratteri condivisi a 30,22× con circa 245.000 caratteri.
In parole semplici, più contesto si può riutilizzare, più lavoro LMCache può evitare.
DeepSeek è un buon esempio reale del perché questo conta.
Il suo sistema di caching può riutilizzare prefissi di prompt corrispondenti, cosa particolarmente preziosa per agenti di coding che inviano ripetutamente gli stessi prompt di sistema, tool, cronologia delle conversazioni e contesto di codice.
Tassi di hit più alti significano meno calcoli ripetuti e costi inferiori sia per il provider sia per l’utente.
La lezione principale di questa guida è che rendere più veloce l’inferenza LLM non significa solo avere GPU migliori o generazione di token più rapida. Significa anche non ripetere lavoro inutilmente.
Per i sistemi RAG, gli assistenti di coding, gli agenti e altre applicazioni con contesti lunghi, il KV caching riutilizzabile può essere una parte importante per migliorare la latenza, ridurre l’uso della GPU e abbassare i costi di inferenza.
I migliori corsi DataCamp
Programma
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min




