
Program
Deploy Production-Ready Agents
2 sa
Büyük dil model çıkarımı, istemler büyüdükçe giderek daha pahalı hale gelebilir.
RAG sistemleri, kodlama ajanları, çok ajanlı iş akışları ve uzun sohbetler; aynı belgeleri, sistem istemlerini, araç tanımlarını veya sohbet geçmişini modele sık sık tekrar tekrar gönderir.
Bu paylaşılan bağlam her prefill aşamasında işlendiğinde, model, token üretimi sırasında kullanılan anahtar-değer (KV) durumları üretir.
Aynı bağlam için bu durumları yeniden hesaplamak GPU hesaplamasını boşa harcar ve gecikmeyi artırır.
LMCache, çıkarım yığınına özel bir KV önbellek katmanı ekleyerek bunu ele alır.
Önceden hesaplanmış KV durumlarını depolayabilir ve bunları istekler ve çıkarım işçileri arasında yeniden kullanılabilir hale getirebilir; ayrıca CPU, yerel depolama, uzak arka uçlar ve ayrıştırılmış sunum mimarilerini de destekler.
Bu eğitimde, LMCache'in nasıl çalıştığını, vLLM'in yerel KV önbelleklemesinden nasıl farklılaştığını ve çok katmanlı depolama, paylaşılan önbellekleme, CacheBlend ve prefill/decode ayrıştırma gibi özelliklerin modern LLM sunumuna nasıl oturduğunu göstereceğim.
Ardından LMCache'i vLLM'e bağlayacak, IBM Granite 4.2 3B'yi sunacak ve büyük bir paylaşılan önekin yeniden kullanımının çıkarım gecikmesine etkisini ölçmek için kontrollü bir deney çalıştıracaksınız.
LMCache, açık kaynaklı bir LLM çıkarımı için KV önbellek yönetim katmanıdır.
Prefill sırasında oluşturulan anahtar-değer durumlarının, gelecekteki istekler aynı istem önekini paylaştığında depolanmasını ve yeniden kullanılmasını sağlar.
Kaynak: LMCache – KV Önbellek Altyapısıyla Yapay Zekâ bellek tensörünün temelini inşa etmek
Bu, geleneksel yanıt önbelleklemeden farklıdır.
Yanıt önbelleği, son üretilen cevabı saklar ve aynı istek tekrar geldiğinde onu döndürür:
cache = {
    "What is Python?":
        "Python is a general-purpose programming language..."
}
LMCache, çıkarım sürecinde daha erken çalışır. Nihai yanıtı önbelleğe almak yerine, model istemi işlerken üretilen dikkat KV durumlarını depolar.
Örneğin, yeniden kullanılabilir KV önbellekleme olmadan, uzun bir paylaşılan isteme her yeni soru eklendiğinde prefill aşamasından yeniden geçilmelidir.
LMCache ile ilk istek tam prefill yapar ve ortaya çıkan KV durumlarını depolar. Aynı önekle gelen sonraki istekler bu durumları yükleyebilir ve yalnızca yeni tokenları işleyebilir.
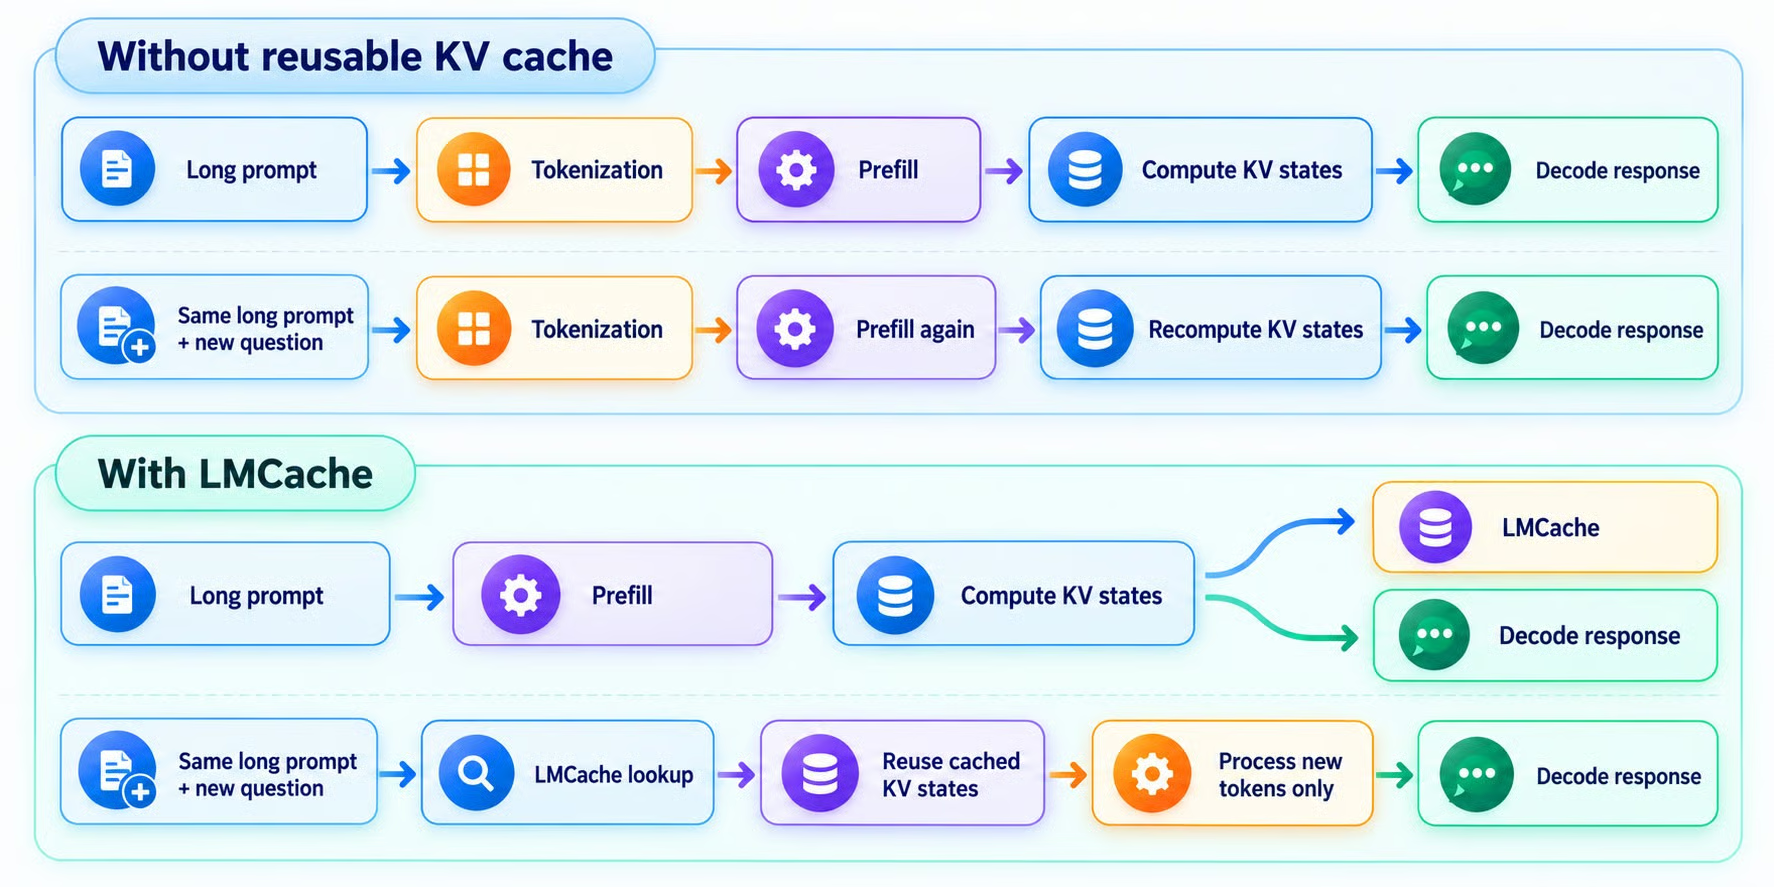
Şekil 1: Yeniden kullanılabilir bir KV önbellek olmadan, her istek için tüm istem yeniden hesaplanır; LMCache ile, önbellekteki KV durumları yeniden kullanılır ve yalnızca yeni tokenlar işlenir.
Bağlam pencereleri büyüdükçe bu giderek daha değerli hale gelir.
Birkaç yüz tokenın yeniden işlenmesi ucuz olabilir, ancak on binlerce paylaşılan tokenın tekrarlı işlenmesi gecikmeyi ve GPU kullanımını ciddi şekilde artırabilir.
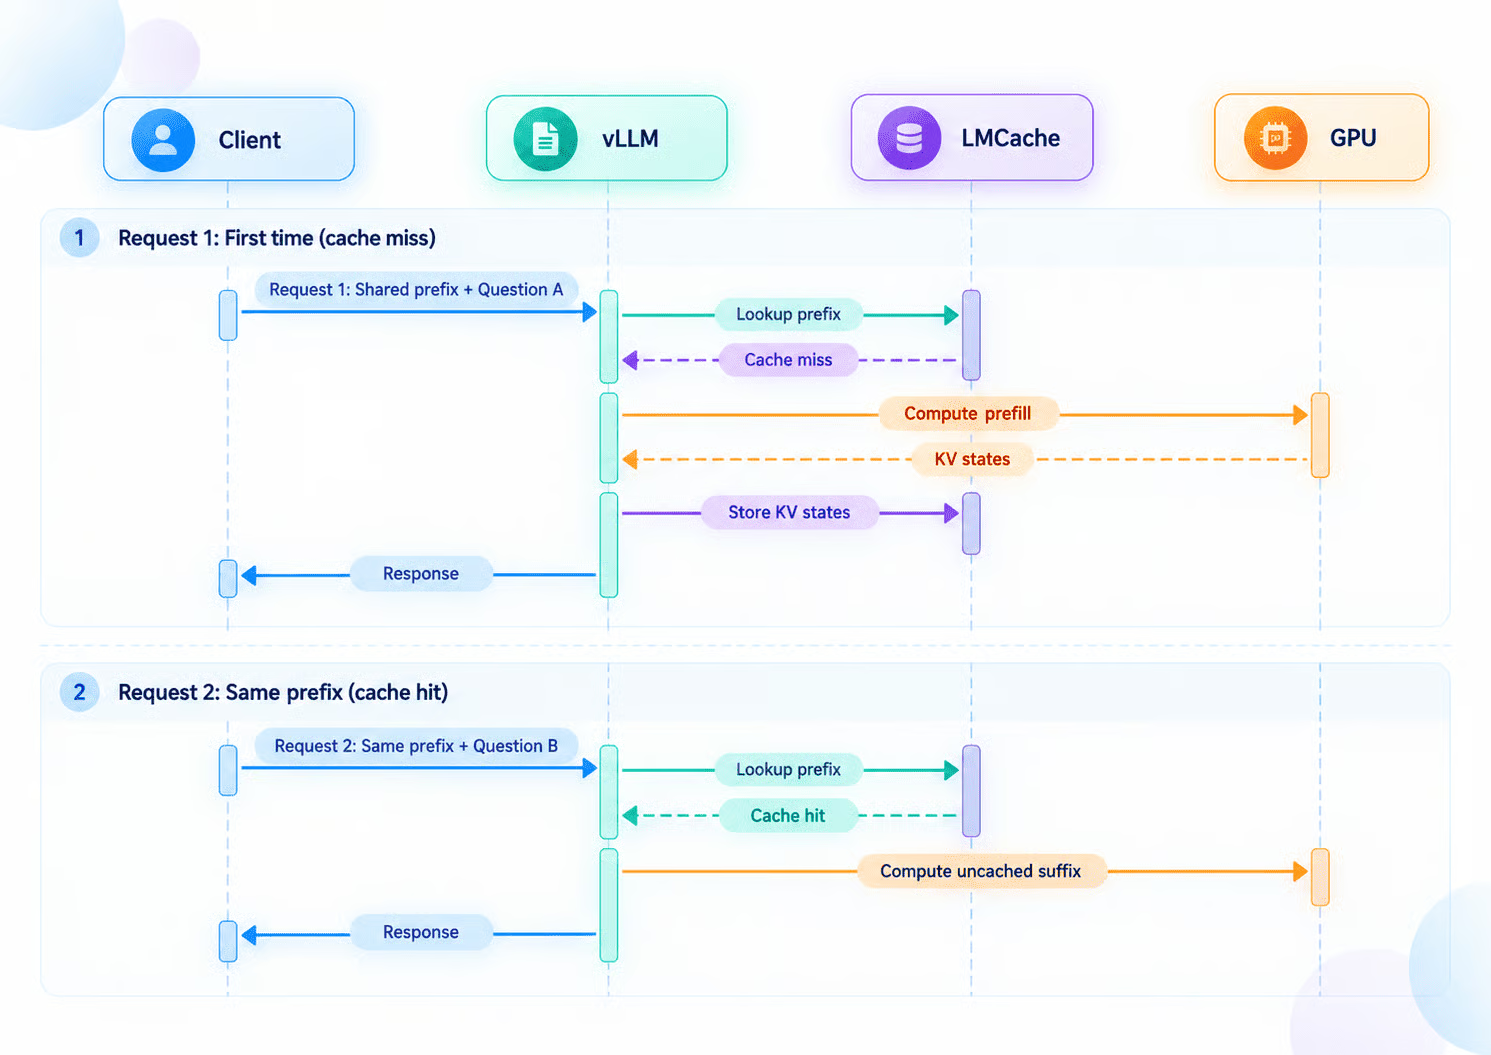
LMCache'i anlamanın en kolay yolu, aynı öneki paylaşan iki isteği takip etmektir.
İlk istek için LMCache, yeniden kullanılabilir KV durumlarının zaten mevcut olup olmadığını kontrol eder. Bu istem ilk kez görüldüğü için arama önbellek kaçırma ile sonuçlanır.
Ardından vLLM, GPU üzerinde prefill gerçekleştirir, KV durumlarını oluşturur ve depolanması için bunları LMCache'e iletir.
İkinci istek için paylaşılan önek aynı kalır, ancak soru değişir.
LMCache bir arama daha yapar. Bu kez önek zaten mevcuttur ve önbellek isabeti elde edilir. Önbelleğe alınmış durumlar yeniden kullanılır ve GPU yalnızca önbellekte olmayan son ek kısmı işlemelidir.
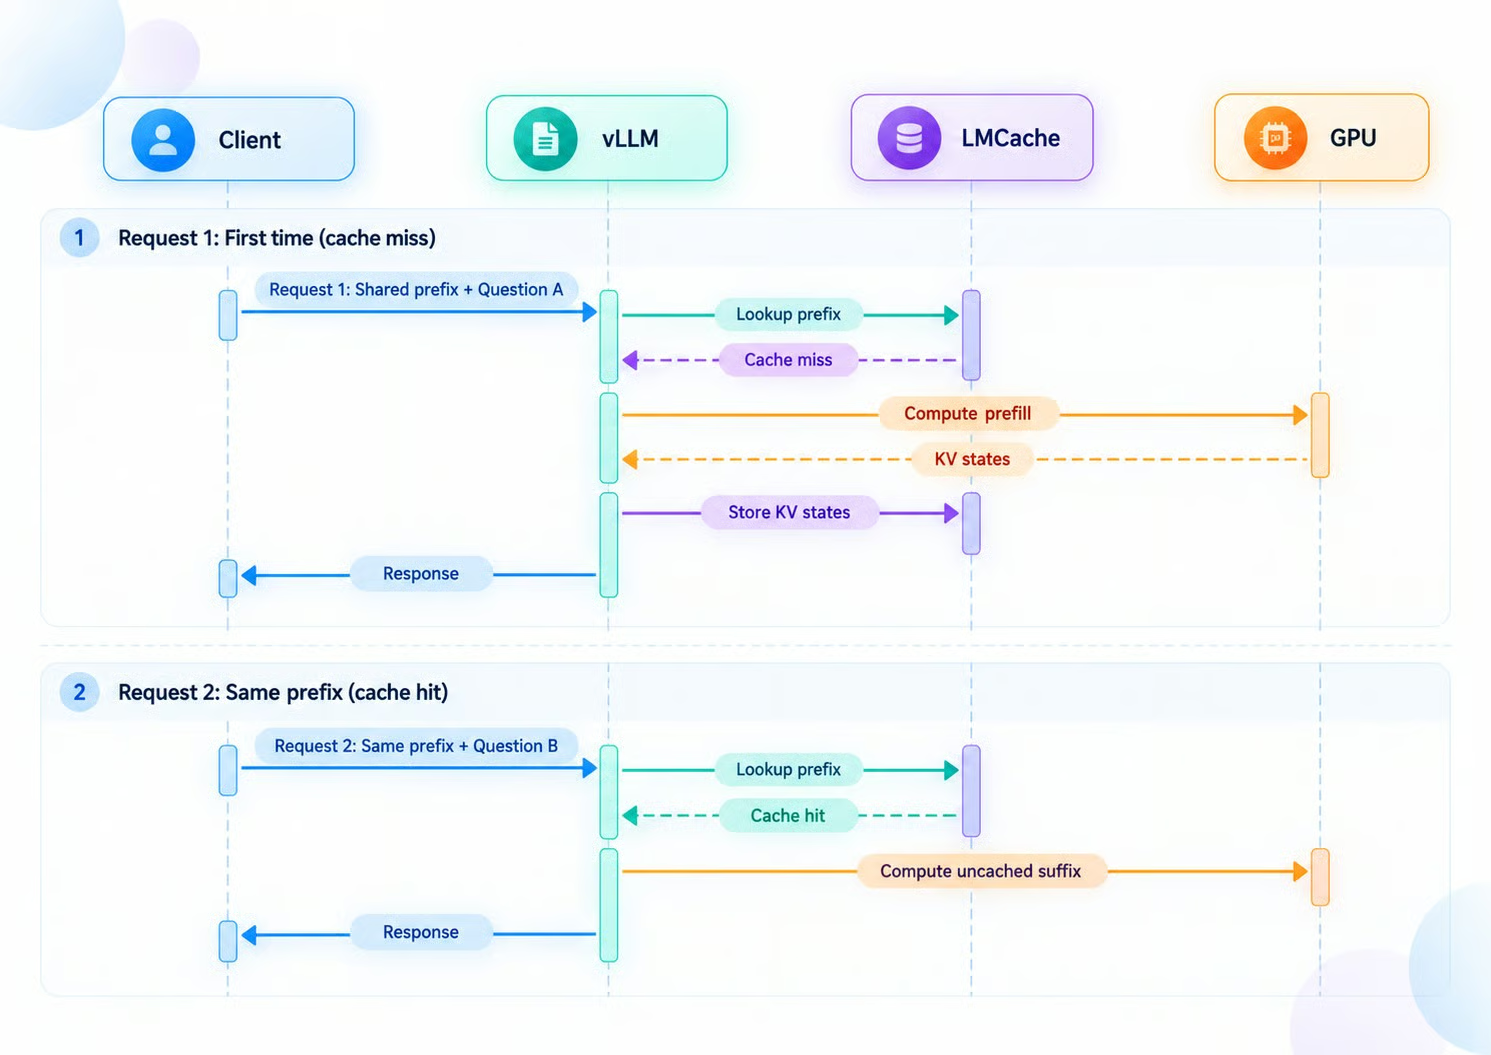
Şekil 2: Yeni bir önekle ilk istek önbelleği ıskalar; bu nedenle vLLM prefill hesaplar ve KV durumlarını LMCache'te depolar; aynı önekle tekrarlanan istek önbelleğe isabet eder ve yalnızca yeni son eki hesaplar.
Önemli nokta, LMCache'in tüm isteğin özdeş olmasını gerektirmemesidir. Önemli olan, yeniden kullanılabilir önektir.
Bu da arka plan bağlamının aynı kaldığı, kullanıcı sorgusunun değiştiği uygulamalar için onu çok uygun kılar.
vLLM zaten otomatik önek önbelleklemesini desteklediğinden, LMCache'in neden gerektiği makul bir sorudur.
Her iki yaklaşım da modelin daha önce işlediği istem önekleri için KV durumlarını yeniden hesaplamaktan kaçınmaya çalışır.
Temel fark, bu önbelleğin nerede bulunduğu ve ne kadar geniş ölçekte yeniden kullanılabildiğidir.
|
Özellik |
vLLM Yerel KV Önbellekleme |
LMCache |
|
Önek KV yeniden kullanımı |
Evet, Otomatik Önek Önbellekleme ile |
Evet |
|
Önek olmayan KV yeniden kullanımı |
Hayır |
Evet, CacheBlend ile |
|
GPU KV önbelleği |
Evet |
vLLM'in GPU KV önbelleğiyle birlikte çalışır |
|
CPU KV offload |
Evet |
Evet |
|
SSD / NVMe depolama |
İkincil depolama katmanları aracılığıyla desteklenir |
Evet, yerel disk, NVMe ve GDS dahil |
|
Uzak depolama |
S3 uyumlu nesne depolama gibi seçenekleri destekler |
Redis/Valkey, S3, Mooncake, InfiniStore, NIXL ve diğerleri dahil birden fazla arka ucu destekler |
|
Süreçler arası önbellek paylaşımı |
P2P ve paylaşılan depolama dahil bazı yapılandırmalarda desteklenir |
Çekirdek bir özelliktir; birden çok çıkarım işçisi paylaşılan önbellekteki KV durumlarını kullanabilir |
|
Bağımsız önbellek hizmeti |
Hayır, önbellekleme vLLM sunum yığınının bir parçası olarak yönetilir |
Evet, LMCache MP modu vLLM'den bağımsız çalışabilir |
|
Bağımsız önbellek ölçekleme |
Önbellek kaynakları genellikle çıkarım dağıtımıyla birlikte yapılandırılır |
Önbellek kapasitesi vLLM işçilerinden ayrı olarak ölçeklenebilir |
|
Prefill/decode ayrıştırma |
KV konektörleri aracılığıyla desteklenir |
Prefill ve decode işçileri arasında KV aktarımını desteklemek için özel olarak geliştirilmiştir |
|
En uygun olduğu durumlar |
vLLM dağıtımları içinde verimli önek yeniden kullanımı ve KV offload |
Büyük ölçekli, paylaşılan, çok katmanlı veya dağıtık KV önbellek iş yükleri |
vLLM'in yerleşik önek önbelleklemesi, tekrarlanan istekler aynı çıkarım sunucusu tarafından işlendiğinde daha basit bir seçenektir.
Birden fazla istek aynı tokenlarla başlıyorsa, vLLM tüm prefill'i yeniden yapmak yerine mevcut KV bloklarını yeniden kullanabilir.
LMCache bu fikri çıkarım motorunun ötesine taşır.
Yeniden kullanılabilir KV durumlarını yalnızca vLLM'in kendi önbelleğinde tutmak yerine, LMCache; KV durumlarını ek depolama katmanları arasında depolayabilen ve taşıyabilen, daha geniş bir sunum mimarisine sunabilen ayrı bir önbellek katmanı sunar.
Farkı düşünmenin basit bir yolu şudur:
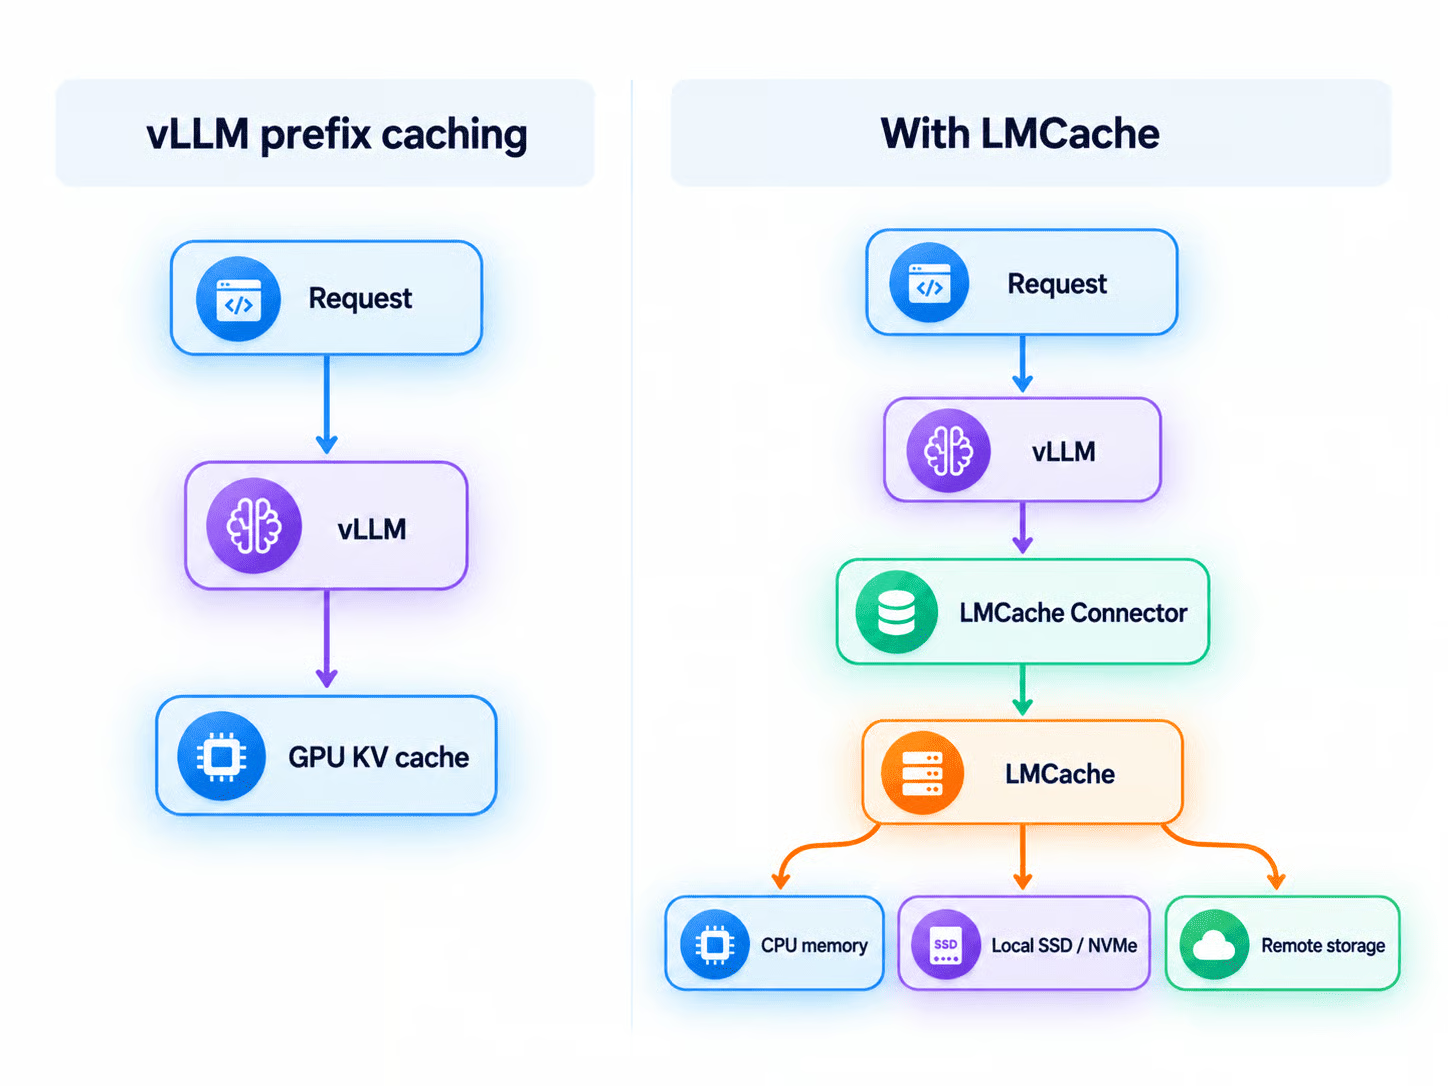
Şekil 3: vLLM önek önbellekleme ve LMCache. LMCache, KV durumlarını yalnızca GPU belleğinde değil; CPU belleği, yerel SSD/NVMe ve uzak depolama arasında katmanlayan bir önbellek katmanı ekler.
Dolayısıyla LMCache, vLLM'deki KV önbellekleme fikrinin yerine geçmez. KV önbellek yönetimini çıkarım motorunun normal sınırlarının ötesine taşır.
LMCache, basit bir bellek içi önbellekten fazlasını sunar. KV durumlarını farklı depolama katmanları ve çıkarım işçileri arasında depolamak, taşımak ve yeniden kullanmak üzere tasarlanmıştır.
LMCache'in ana özelliği, aynı tokenları modeli tekrar tekrar işlemeye gerek kalmadan önceden hesaplanmış KV durumlarını yeniden kullanabilmesidir.
Bu özellikle, isteklerin aynı veya benzer bağlamı tekrar tekrar içerdiği durumlarda yararlıdır; örneğin:
Önbelleğe alınmış KV durumlarını yeniden kullanarak, LMCache tekrarlanan prefill hesaplamasını azaltabilir ve ilk tokena kadar geçen süreyi iyileştirebilir.
GPU belleği sınırlı ve pahalıdır; özellikle uzun bağlamlarla çalışırken.
LMCache, KV durumlarını GPU belleğinin ötesine taşıyabilir ve CPU belleği, yerel SSD veya NVMe depolama ve uzak ya da dağıtık depolama dahil birden çok katmanda saklayabilir.
Bu, tamamı GPU belleğine sığmayacak kadar çok daha fazla yeniden kullanılabilir bağlamı elde tutmayı mümkün kılar; ihtiyaç olduğunda sık kullanılan KV durumlarını yeniden GPU'ya taşırken.
LMCache, önbelleğe alınmış KV durumlarını tek bir model sürecine bağlı tutmak yerine birden çok çıkarım işçisi arasında erişilebilir kılabilir.
Örneğin, bir vLLM işçisi uzun bir belgeyi işlerse, başka bir işçi aynı bağlamı yeniden hesaplamak yerine önbelleğe alınmış KV durumlarını potansiyel olarak yeniden kullanabilir.
Bu; dağıtık sunum, çok GPU'lu dağıtımlar ve isteklerin birden fazla çıkarım replikası arasında yönlendirildiği uygulamalar için özellikle faydalıdır.
LMCache, vLLM ile KV konektör arayüzü üzerinden entegre olur.
Uygulama, LMCache çıkarım katmanının altında çalışırken normal OpenAI uyumlu vLLM uç noktasıyla iletişim kurmaya devam edebilir.
Bu, mevcut uygulamaların istem gönderme veya yanıt alma şeklini değiştirmesine gerek olmadığı anlamına gelir. LMCache, vLLM ile yapılandırılmış önbellek arka ucu arasında KV depolama ve geri almayı yönetir.
LMCache, vLLM'den ayrı bir süreç olarak çalışabilir.
Önbellek yönetimini her çıkarım işçisi içinde tutmak yerine, özel bir LMCache sunucusu KV durumlarını bağımsız olarak yönetebilir ve birden fazla vLLM sürecine hizmet verebilir.
Bu, önbellek yönetimini model sunumundan ayırır; birden çok işçinin aynı önbelleği paylaşmasına olanak tanır ve önbellek kapasitesinin GPU çıkarım kaynaklarından bağımsız olarak ölçeklenmesini kolaylaştırır.
Geleneksel önek önbellekleme, istekler bir istemin aynı başlangıcını paylaştığında en iyi çalışır.
LMCache ayrıca, yeniden kullanılabilir içeriğin farklı pozisyonlarda görünebildiği iş yükleri için CacheBlend sağlar.
Örneğin, bir RAG uygulaması farklı sorular için aynı belgeleri farklı bir sırada getirebilir.
CacheBlend, yeni bağlama bağlı tokenları seçici olarak yeniden hesaplarken daha önce hesaplanmış KV durumlarının parçalarını yeniden kullanabilir.
Bu, istemlerin sık sık yeniden düzenlendiği RAG, çok belgeli uygulamalar ve ajansal iş akışları için KV yeniden kullanımını daha yararlı hale getirir.
LMCache, KV durumlarını ayrı prefill ve decode işçileri arasında aktarmaya da yardımcı olabilir.
Bu mimaride, bir GPU grubu hesaplama yoğun istem işleme aşamasını, diğer grup ise token üretimini yürütür.
LMCache, ortaya çıkan KV durumlarını aralarında taşımak için kullanılan katmanı sağlar.
Bu, prefill ve decode kaynaklarının bağımsız olarak ölçeklenmesine olanak tanır ve daha büyük çıkarım dağıtımlarında GPU kullanımını iyileştirebilir.
Artık LMCache'in nasıl çalıştığını anladığımıza göre, verimli sunum ve bellek yönetimi için tasarlanmış yüksek performanslı bir LLM çıkarım motoru olan vLLM'e bağlayalım.
Bu rehberde, boyutuna göre güçlü performans sunan ve pratik testler için yeterince hafif kalan kompakt bir model olan IBM Granite 4.2 3B'yi kullanacağım.
LMCache'i vLLM ile yan yana çok süreçli modda çalıştıracak ve KV durumlarının istekler arasında yeniden kullanılabildiğini doğrulayacağız.
Bu eğitim için Python 3.12, uv, vLLM, LMCache, OpenAI Python istemcisi, pandas ve matplotlib kullanacağız.
Başlamadan önce şunlara sahip olduğunuzdan emin olun:
uv'yi şu komutla kurabilirsiniz:
curl -LsSf https://astral.sh/uv/install.sh | shArdından projeyi oluşturun:
mkdir lmcache-tutorial
cd lmcache-tutorial
Python 3.12 sanal ortamı oluşturun ve etkinleştirin:
uv venv --python 3.12
source .venv/bin/activate
Gerekli bağımlılıkları yükleyin:
uv pip install -U \
    "lmcache==0.5.4" \
    "vllm==0.28.0" \
    openai \
    pandas \
    matplotlib \
    --torch-backend=cu130
Burada, ortamımız CUDA 13 ile kurulu olduğu için cu130 kullanıyoruz.
Farklı bir CUDA sürümü kullanıyorsanız, --torch-backend değerini ortamınıza uygun PyTorch arka ucuyla değiştirin.
Granite 4.2 özel bir akıl yürütme ayrıştırıcısı kullanır, bu nedenle onu Hugging Face'ten indirin:
hf download ibm-granite/granite-4.2-3b \
    granite_thinking_parser.py \
    --local-dir .
Son olarak, GPU ve CUDA kurulumunuzun algılandığını doğrulayın:
nvidia-smi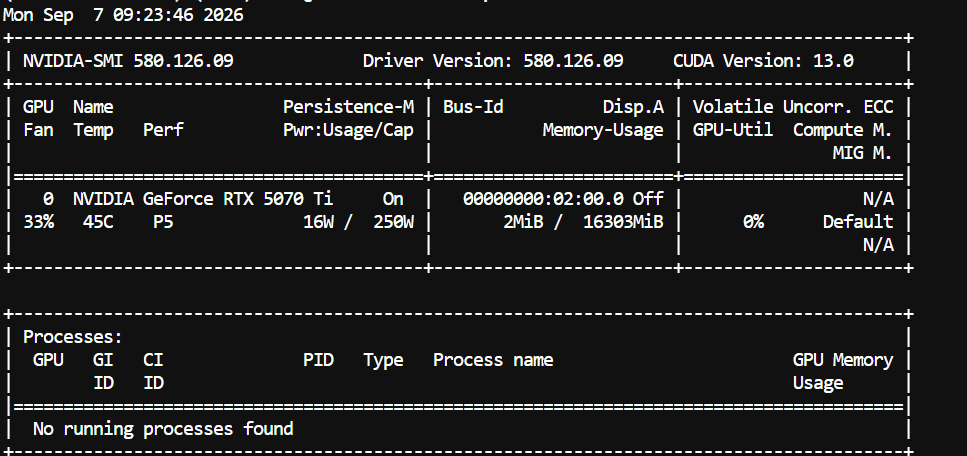
Bu eğitimde 16 GB VRAM'e sahip bir NVIDIA GeForce RTX 5070 Ti kullanıyoruz.
Sistem, CUDA 13.0 desteğiyle NVIDIA sürücüsü 580.126.09 çalıştırıyor.
İki çalışır sürece ihtiyacımız var: biri LMCache sunucusu, diğeri vLLM için.
İlk terminalde LMCache'i başlatın:
lmcache server \
    --host localhost \
    --port 6555 \
    --http-port 8081 \
    --l1-size-gb 20 \
    --eviction-policy LRU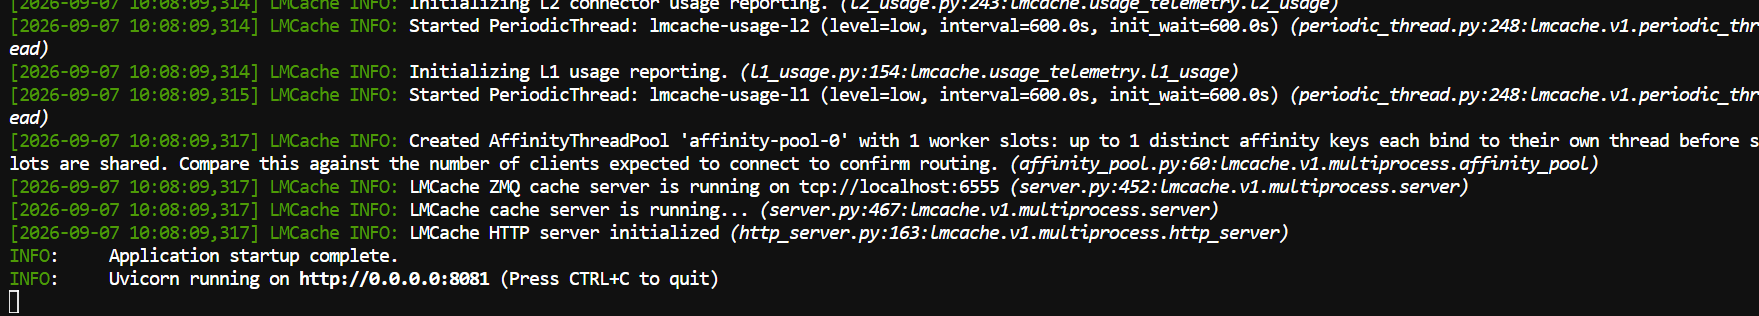
Burada şunları kullanıyoruz:
6555 portu, vLLM ile LMCache arasındaki iletişim için8081 portu, LMCache HTTP arayüzü için20 GB L1 önbellek boyutu olarakLRU çıkarma (eviction) politikası olarakBu terminali açık tutun.
İkinci bir terminal açın, aynı sanal ortamı etkinleştirin ve etkinse genişletilebilir CUDA ayırıcısı yapılandırmasını kaldırın:
cd lmcache-tutorial
source .venv/bin/activate
unset PYTORCH_CUDA_ALLOC_CONF
Şimdi vLLM'i LMCache konektörüyle başlatın:
vllm serve ibm-granite/granite-4.2-3b \
  --served-model-name granite-4.2-3b \
  --dtype bfloat16 \
  --max-model-len 65536 \
  --kv-cache-dtype fp8 \
  --gpu-memory-utilization 0.90 \
  --enforce-eager \
  --max-num-seqs 1 \
  --max-num-batched-tokens 2048 \
  --no-enable-prefix-caching \
  --reasoning-parser granite_thinking_parser \
  --reasoning-parser-plugin "$(pwd)/granite_thinking_parser.py" \
  --tool-call-parser qwen3_coder \
  --enable-auto-tool-choice \
  --port 8000 \
  --kv-transfer-config \
  '{
    "kv_connector":"LMCacheMPConnector",
    "kv_connector_module_path":"lmcache.integration.vllm.lmcache_mp_connector",
    "kv_role":"kv_both",
    "kv_connector_extra_config":{
      "lmcache.mp.host":"tcp://localhost",
      "lmcache.mp.port":6555,
      "lmcache.mp.mp_transfer_mode":"lmcache_driven"
    }
  }'
vLLM'in yerleşik önek önbelleklemesini şu komutla devre dışı bırakıyoruz:
--no-enable-prefix-cachingBu, aşağıdaki deneylerin özellikle LMCache üzerinden KV yeniden kullanımına odaklanmasını sağlar.
vLLM yüklemeyi tamamladığında, model OpenAI uyumlu uç noktası üzerinden kullanılabilir:
http://localhost:8000/v1Şimdi LMCache'in çalıştığını doğrulamak için basit bir kontrollü deney yapacağız.
Büyük bir paylaşılan önek oluşturacak, önbelleği temizleyecek, öneki LMCache'i doldurmak için bir kez gönderecek ve ardından aynı önekle ancak farklı bir soruyla başka bir istek göndereceğiz.
Önce OpenAI istemcisini oluşturun:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local",
)
Sonra uzun bir paylaşılan belge oluşturun:
base_text = """
Large language model inference consists of two main stages:
prefill and decoding.

During prefill, the model processes the input sequence and calculates
the key and value tensors used by the attention mechanism.

During autoregressive decoding, these tensors are reused so the model
does not need to recompute attention states for every previous token.

KV cache management is therefore an important part of modern LLM
serving infrastructure, particularly for long-context applications.
"""

document = base_text * 500

SYSTEM_PROMPT = f"""
You are a technical assistant.

Use only the following document to answer the user's question.

DOCUMENT:

{document}
"""
Belgeyi 500 kez tekrarlamak, KV yeniden kullanımının etkisini görünür kılacak kadar pahalı büyük bir paylaşılan önek elde etmemizi sağlar.
İlk isteği göndermeden önce, boş bir önbellekle başladığımızdan emin olmak için LMCache'i temizleyin:
import subprocess
import time

subprocess.run(
    [
        "lmcache",
        "kvcache",
        "clear",
        "--url",
        "http://localhost:8081",
    ],
    check=True,
)

time.sleep(0.5)
Bu, ilk isteğin bir soğuk önbellek isteği olmasını ve önceki bir testten kalan KV durumlarını yeniden kullanamamasını sağlar.
Şimdi ilk isteği gönderin:
prompt_1 = SYSTEM_PROMPT + """

Question:
Explain the purpose of the KV cache.
"""

start = time.perf_counter()

client.completions.create(
    model="granite-4.2-3b",
    prompt=prompt_1,
    max_tokens=100,
    temperature=0,
)

latency_1 = time.perf_counter() - start
Bu bir önbellek ısıtma isteğidir. vLLM, prefill sırasında uzun paylaşılan öneki işlemek zorundadır; LMCache ise ortaya çıkan KV durumlarını depolar.
Sonraki adımda, paylaşılan öneki aynen koruyun ve yalnızca soruyu değiştirin:
prompt_2 = SYSTEM_PROMPT + """

Question:
Explain what happens during prefill.
"""

start = time.perf_counter()

client.completions.create(
    model="granite-4.2-3b",
    prompt=prompt_2,
    max_tokens=100,
    temperature=0,
)

latency_2 = time.perf_counter() - start
Büyük önek değişmediği için, LMCache ilk istek tarafından üretilen KV durumlarını tüm öneki yeniden hesaplamak yerine yeniden kullanabilir.
Son olarak iki istek süresini karşılaştırın:
print(f"Cold request:   {latency_1:.3f}s")
print(f"Warm request:   {latency_2:.3f}s")
print(f"Speedup:        {latency_1 / latency_2:.2f}x")

print(
    f"Latency saved:  "
    f"{((latency_1 - latency_2) / latency_1) * 100:.1f}%"
)
Benim çalıştırmam şu sonucu verdi:
Cold request:   26.276s
Warm request:   4.402s
Speedup:        5.97x
Latency saved:  83.2%
Sıcak istek neredeyse 6× daha hızlı tamamlandı ve uçtan uca gecikmeyi %83,2 oranında azalttı.
Sorular farklı, dolayısıyla LMCache nihai yanıtı önbelleğe almıyor. Bunun yerine, paylaşılan önek için üretilen KV durumlarını yeniden kullanıyor.
İlk istek, prefill sırasında tüm uzun öneki işlemeli ve bu KV durumlarını sıfırdan oluşturmalıdır.
İkinci istekte LMCache, eşleşen önbellek durumlarını geri getirir; böylece vLLM, bu tekrarlı prefill işinin çoğunu atlayabilir ve yalnızca yeni son eke odaklanabilir.
Bu, LMCache'in paylaşılan öneki başarıyla yeniden kullandığını doğrular.
LMCache, bir uygulama büyük miktarda özdeş bağlamı tekrar tekrar gönderdiğinde özellikle faydalıdır.
Yaygın birkaç örnek şunlardır:
Bir kullanıcı, aynı getirilen belge hakkında birkaç soru sorabilir.
Her soru için tüm belgeyi sıfırdan işlemek yerine, belgede oluşturulan KV durumları yeniden kullanılabilir.
Kodlama asistanları, her model çağrısıyla birlikte depo dosyalarını, proje talimatlarını ve diğer büyük bağlam parçalarını sıkça gönderir.
Bu bağlamın büyük kısmı, görev değişirken özdeş kalır.
Ajanlar genellikle büyük sistem istemlerini, araç tanımlarını, hafızayı, talimatları ve ortam durumunu birçok adım boyunca yeniden kullanır.
Uzun soluklu bir sohbet, her yeni mesajla birlikte geçmişinin önemli bir kısmını tekrar tekrar gönderebilir.
Birkaç ajan, farklı görevler üzerinde çalışırken aynı arka plan belgelerini veya sistem bağlamını paylaşabilir.
Bu durumların tümünde, model daha önceki istekler sırasında zaten işlediği bilgileri tekrar tekrar görür.
LMCache, bu çalışmayı KV önbellek düzeyinde yeniden kullanmanın bir yolunu sunar.
LMCache, prefill sırasında oluşturulan KV durumlarını yeniden kullanılabilir hale getirerek uzun bağlam çıkarımındaki önemli bir israf kaynağını ortadan kaldırır.
Aynı paylaşılan bağlamı tekrar tekrar işlemek yerine, model daha önce tamamladığı çalışmayı yeniden kullanabilir.
Bu eğitimde kıyaslama kodunu veya ayrıntılı sonuçları eklemedik; ancak aynı kurulumla ayrı bir dizi test çalıştırdık.
Sonuçlar belirgindi. Büyük bir paylaşılan önekin yeniden kullanımı, toplam istek gecikmesini 26,276 saniyeden 4,386 saniyeye düşürdü.
İlk tokena kadar ortalama süre 22,149 saniyeden 0,726 saniyeye düştü; bu da 30,54× iyileşme demektir. Kazanımlar bağlam boyutuyla birlikte arttı; yaklaşık 12.000 paylaşılan karakterde 3,55× iken yaklaşık 245.000 karakterde 30,22× oldu.
Basitçe söylemek gerekirse, yeniden kullanılabilecek bağlam ne kadar fazlaysa, LMCache o kadar çok işi önleyebilir.
DeepSeek, bunun neden önemli olduğuna dair iyi bir gerçek dünya örneğidir.
Önbellekleme sistemi, eşleşen istem öneklerini yeniden kullanabilir; bu da özellikle, aynı sistem istemlerini, araçları, sohbet geçmişini ve kod bağlamını tekrar tekrar gönderen kodlama ajanları için değerlidir.
Daha yüksek önbellek isabet oranları, hem sağlayıcı hem de kullanıcı için daha az tekrarlı hesaplama ve daha düşük maliyet anlamına gelir.
Bu rehberden çıkarılacak ana fikir, daha hızlı LLM çıkarımının yalnızca daha iyi GPU'lar veya daha hızlı token üretimiyle ilgili olmadığıdır. Aynı zamanda gereksiz yere işi tekrarlamamakla ilgilidir.
RAG sistemleri, kodlama asistanları, ajanlar ve diğer uzun bağlamlı uygulamalar için, yeniden kullanılabilir KV önbellekleme gecikmeyi iyileştirmenin, GPU kullanımını azaltmanın ve çıkarım maliyetlerini düşürmenin önemli bir parçası olabilir.
Öne Çıkan DataCamp Kursları
Program
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




