Se você é um cientista de dados ou analista de dados já familiarizado com bancos de dados relacionais e não relacionais, como SQL e MongoDB, prepare-se para mergulhar em um novo e empolgante universo de gerenciamento de dados. Neste tutorial, você vai conhecer um novo tipo de armazenamento chamado banco de dados vetorial, um tipo de banco especializado para lidar e processar dados em formato de vetores com eficiência. Neste tutorial do Pinecone, vamos focar especificamente na plataforma de banco de dados vetorial Pinecone.
Para saber mais sobre o Pinecone, não deixe de conferir nosso curso Vector Databases for Embeddings with Pinecone.
O que é um banco de dados vetorial?
Em bancos de dados tradicionais, os dados geralmente são armazenados em linhas e colunas, o que funciona bem para dados estruturados. Porém, à medida que os conjuntos de dados ficam mais complexos e de alta dimensionalidade, surge a necessidade de uma solução mais especializada. É aí que os bancos de dados vetoriais brilham. Em vez de trabalhar com estruturas tradicionais, eles são otimizados para lidar com vetores — representações matemáticas de pontos de dados em espaços multidimensionais.
Dados vetoriais têm uso amplo em várias áreas, como machine learning, ciência de dados, biologia computacional e PLN. Eles podem representar características numéricas, coordenadas, embeddings, texto, imagens e muito mais. Com a ascensão das aplicações orientadas por IA, a demanda por um tratamento eficiente de dados vetorizados disparou, e os bancos de dados vetoriais se tornaram uma ferramenta essencial nesse contexto.
O que é o Pinecone?
Pinecone é uma plataforma gerenciada de banco de dados vetorial, criada especificamente para enfrentar os desafios únicos de dados de alta dimensionalidade. Com recursos avançados de indexação e busca, o Pinecone capacita engenheiros e cientistas de dados a construir e implementar aplicações de machine learning em larga escala que processam e analisam dados de alta dimensionalidade com eficiência.
Principais recursos do Pinecone
Veja o que torna o Pinecone uma ferramenta tão útil:
Serviço totalmente gerenciado
Por ser uma plataforma totalmente gerenciada, o Pinecone cuida de toda a infraestrutura e manutenção. Assim, desenvolvedores podem concentrar esforços no desenvolvimento e na implantação de suas aplicações de machine learning sem se preocupar com a complexidade operacional.
Escalabilidade
O Pinecone oferece escalabilidade excepcional, lidando com bilhões de vetores de alta dimensionalidade e permitindo escalonamento horizontal. Isso o torna ideal para cargas de trabalho de machine learning das mais exigentes.
Ingestão de dados em tempo real
O Pinecone dá suporte à ingestão de dados em tempo real, permitindo armazenar e indexar novos dados assim que ficam disponíveis, sem interrupções ou tempo de inatividade.
Busca de baixa latência
Aproveitando algoritmos sofisticados de indexação, o Pinecone fornece resultados de busca com baixa latência para consultas de vizinho mais próximo e operações de similaridade. Isso garante respostas rápidas e precisas para aplicações sensíveis ao tempo.
Integração sem atrito
A API do Pinecone foi projetada para ser simples e intuitiva, facilitando a integração com fluxos de trabalho de machine learning e pipelines de dados existentes.
Entendendo dados não estruturados e embeddings vetoriais
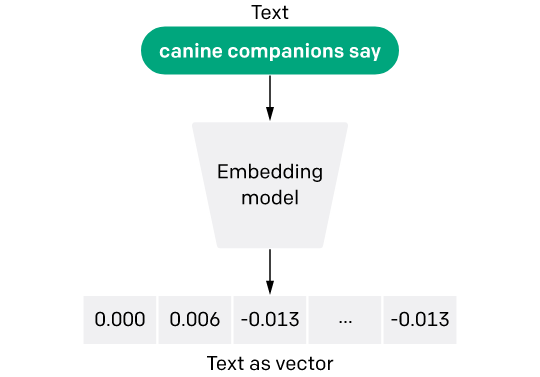
Modelo de embedding de texto - Fonte da imagem
Dados não estruturados são aqueles que não têm um formato pré-definido ou organizado, o que dificulta o armazenamento e o processamento eficiente em bancos tradicionais. Exemplos incluem textos, imagens, áudios e vídeos.
Como não têm uma estrutura rígida, é difícil analisá-los diretamente com métodos tradicionais. Por isso, para usar dados não estruturados em aplicações de machine learning e IA, eles são transformados e armazenados em representações numéricas multidimensionais usando embeddings vetoriais.
Embeddings são fundamentais em inteligência artificial, oferecendo uma técnica poderosa para transformar dados de alta dimensionalidade — como palavras, imagens ou preferências de usuários — em representações numéricas compactas. Esses vetores numéricos permitem que modelos de IA processem e compreendam informações complexas com eficiência.
Fica mais fácil entender embeddings quando pensamos neles como um dicionário especializado para uma tarefa específica. Em projetos de mineração de texto, por exemplo, embeddings ajudam a captar o significado semântico das palavras analisando suas relações com outras palavras. Esse processo gera uma lista de embeddings que funciona como um dicionário orientado à tarefa, fornecendo vetores numéricos que refletem o sentido das palavras. A similaridade e a relação entre termos são medidas pela distância entre seus respectivos embeddings, permitindo que modelos de IA entendam contexto e significado.
A importância dos embeddings está na capacidade de reduzir a dimensionalidade dos dados, tornando mais viável para modelos de machine learning lidar com entradas grandes, como vetores esparsos que representam palavras ou itens. Usando embeddings, evitamos as limitações do one-hot encoding, em que cada categoria vira uma variável dummy separada, o que pode levar a matrizes de entrada enormes em certas tarefas.
Se quiser aprender mais sobre como Word Embeddings funcionam, confira nosso tutorial LDA2vec: Word Embeddings in Topic Models.
Recapitulando:
- Banco de dados vetorial é um tipo de banco especializado para lidar e processar dados em formato de vetores com eficiência
- Pinecone é um serviço de banco de dados vetorial totalmente gerenciado
- Dados não estruturados são dados sem formato pré-definido ou organizado, como imagens, texto, áudio ou vídeo
- Embeddings são uma técnica poderosa para transformar dados de alta dimensionalidade em representações numéricas compactas
Como funciona um banco de dados vetorial?
Você provavelmente já conhece o funcionamento de bancos de dados tradicionais, que armazenam dados escalares como strings e números em linhas e colunas. Bancos de dados vetoriais funcionam de forma diferente: trabalham com vetores e usam métodos específicos de otimização e consulta.
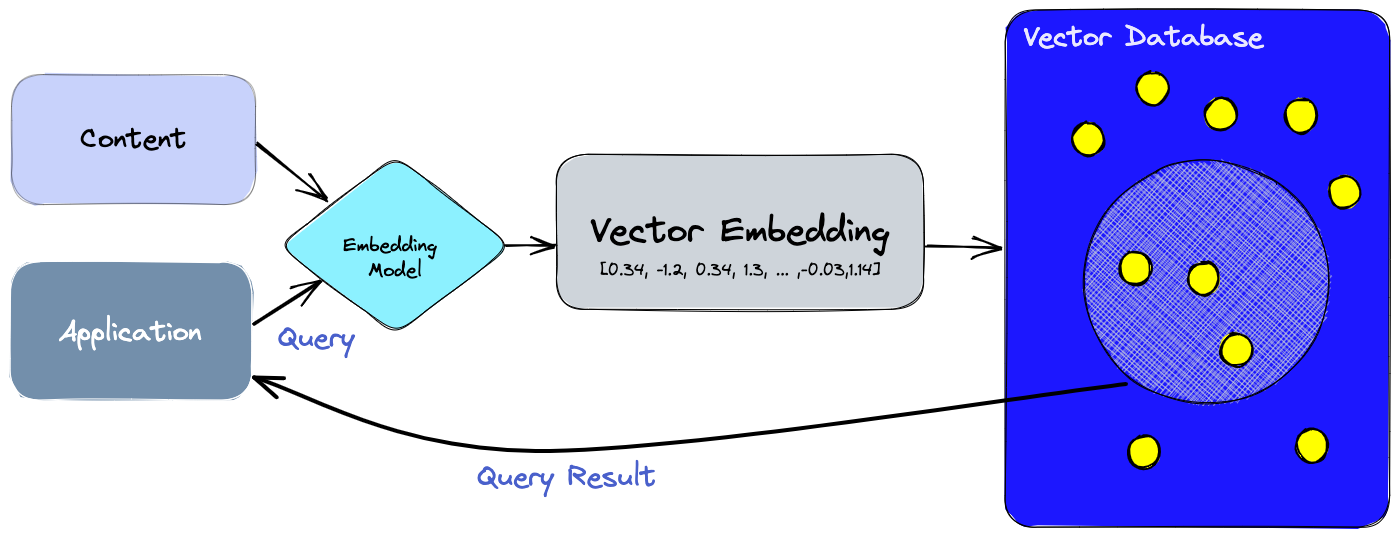
Em bancos de dados tradicionais, as consultas geralmente buscam correspondências exatas. Já os bancos vetoriais usam uma métrica de similaridade para encontrar o vetor que melhor corresponde à nossa consulta.
Bancos de dados vetoriais utilizam um conjunto de algoritmos conhecido como busca por vizinhos mais próximos aproximados (Approximate Nearest Neighbor, ANN). Esses algoritmos otimizam a busca por meio de técnicas como hashing, quantização ou busca baseada em grafos.
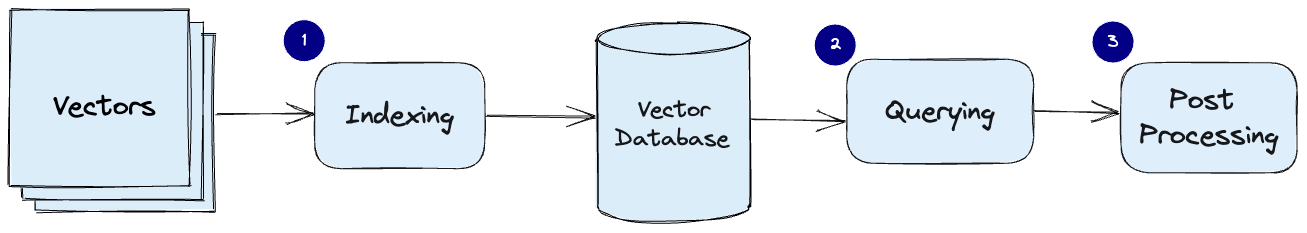
Pipeline comum para banco de dados vetorial (fonte da imagem)
Quer aprender a usar a API da OpenAI para criar embeddings de texto e depois armazená-los em um banco vetorial como o Pinecone? Descubra aplicações em classificação de texto, recuperação de informação e detecção de similaridade semântica no blog Introduction to Text Embeddings with the OpenAI API da DataCamp.
Primeiros passos com o Pinecone
Para começar, acesse pinecone.io e crie uma conta gratuita.
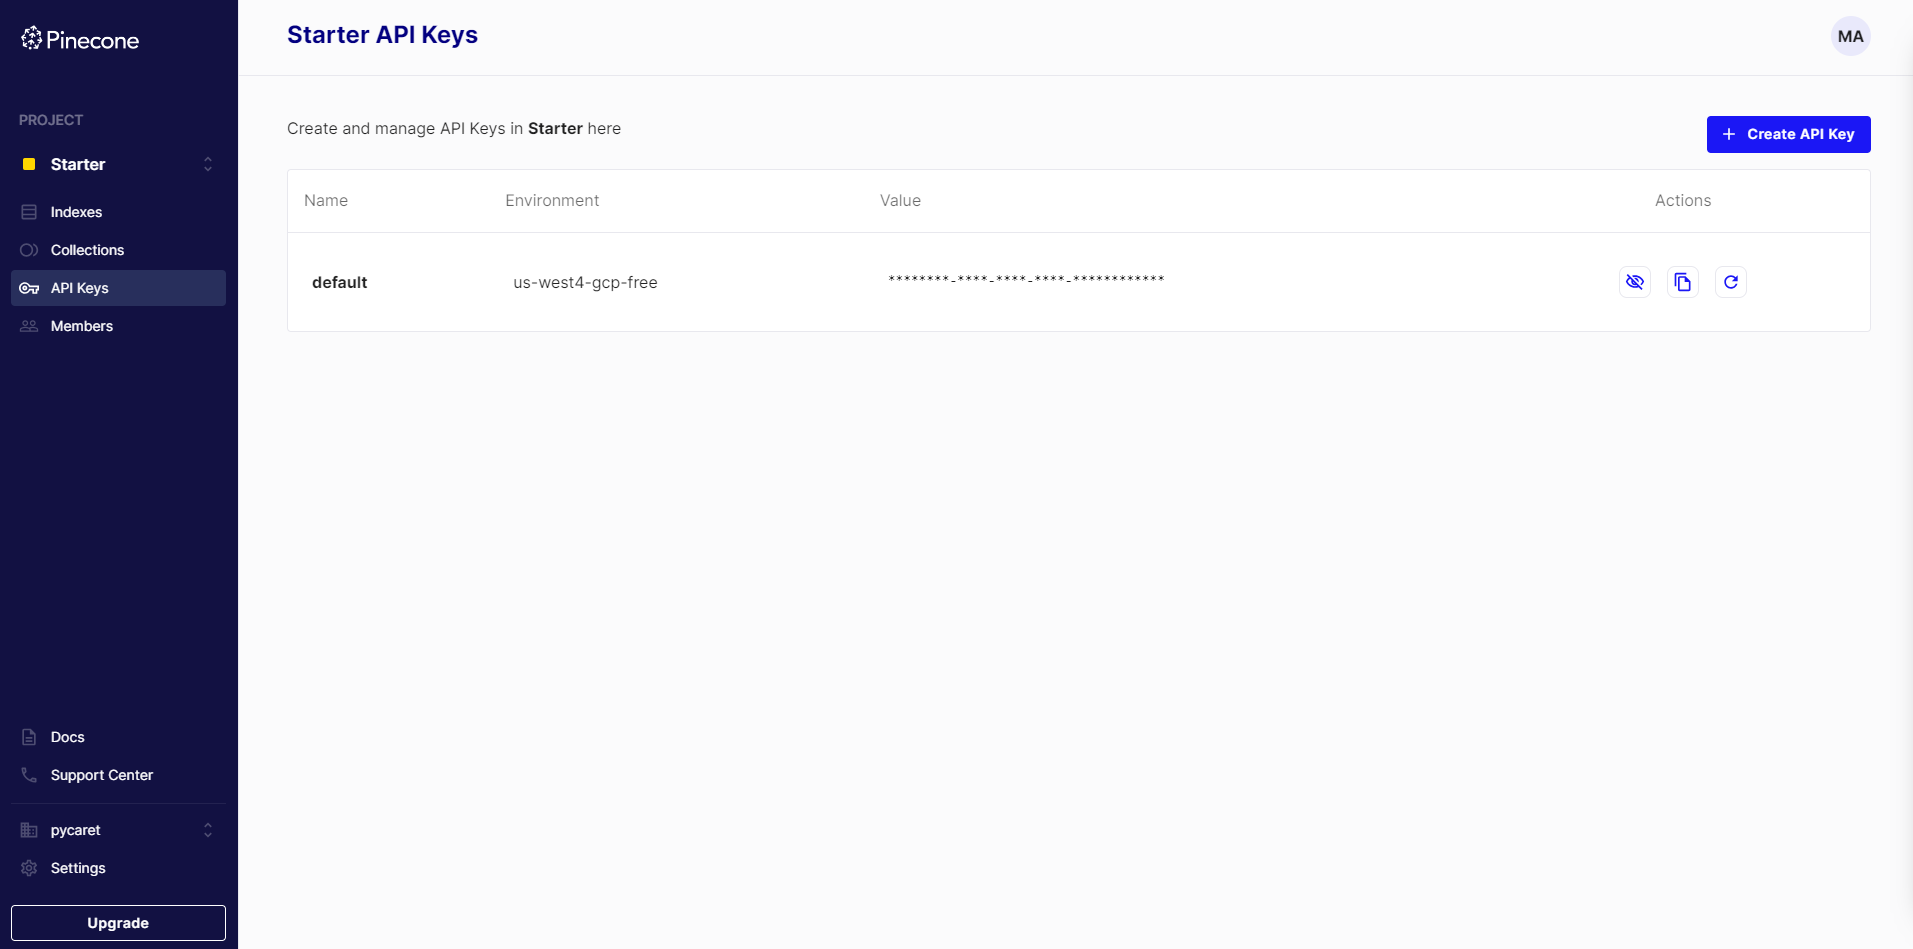
Depois de se cadastrar, clique em API Keys no menu e copie seu environment e sua API key. Você vai usar isso ao trabalhar com o cliente Python do Pinecone.
Você também pode instalar o cliente Python do Pinecone usando pip.
pip install pinecone-clientConceitos-chave no Pinecone
Antes de entrar nos detalhes, vamos revisar alguns termos e conceitos essenciais:
Índice do Pinecone
No Pinecone, um índice representa a estrutura organizacional de nível mais alto para dados vetoriais. Ele recebe e armazena vetores, atende consultas sobre os vetores armazenados e executa diversas operações com esses vetores. Cada índice opera em um ou mais pods para garantir eficiência.
Pods
Pods são unidades de hardware pré-configuradas que hospedam os serviços do Pinecone. Cada índice opera em um ou mais pods; adicionar pods geralmente aumenta a capacidade de armazenamento, reduz a latência e melhora a vazão. Além disso, você pode criar pods de diferentes tamanhos para atender necessidades específicas.
Métricas de distância
Métricas de distância são técnicas matemáticas usadas para avaliar a similaridade entre dois vetores em um espaço vetorial. Em bancos vetoriais, essas medidas são cruciais para comparar os vetores armazenados com um vetor de consulta e identificar os mais semelhantes.
Ao criar um índice vetorial, você pode escolher entre diferentes métricas:
- Cosseno (cosine similarity). Mede o cosseno do ângulo entre dois vetores no espaço vetorial. Varia de -1 a 1: 1 indica vetores idênticos, 0 vetores ortogonais e -1 vetores opostos.
- Distância euclidiana. Calcula a distância em linha reta entre dois vetores no espaço vetorial. Vai de 0 ao infinito: 0 indica vetores idênticos e valores maiores indicam vetores mais diferentes.
- Produto escalar (dot product). Calcula o produto das magnitudes de dois vetores e o cosseno do ângulo entre eles. Varia de -∞ a ∞: valores positivos indicam vetores apontando na mesma direção, 0 indica ortogonalidade e valores negativos indicam direções opostas.
Como verificar a API key do Pinecone
Para usar o Pinecone a partir do Python, é necessária uma API key. Você pode encontrá-la no console do Pinecone, em "API Keys". Na mesma tela, você também encontra o environment associado ao seu projeto.
import pinecone
pinecone.init(api_key="API_KEY", environment = 'ENVIRONMENT')
Como criar um índice no Pinecone
Para criar um índice no Pinecone, execute:
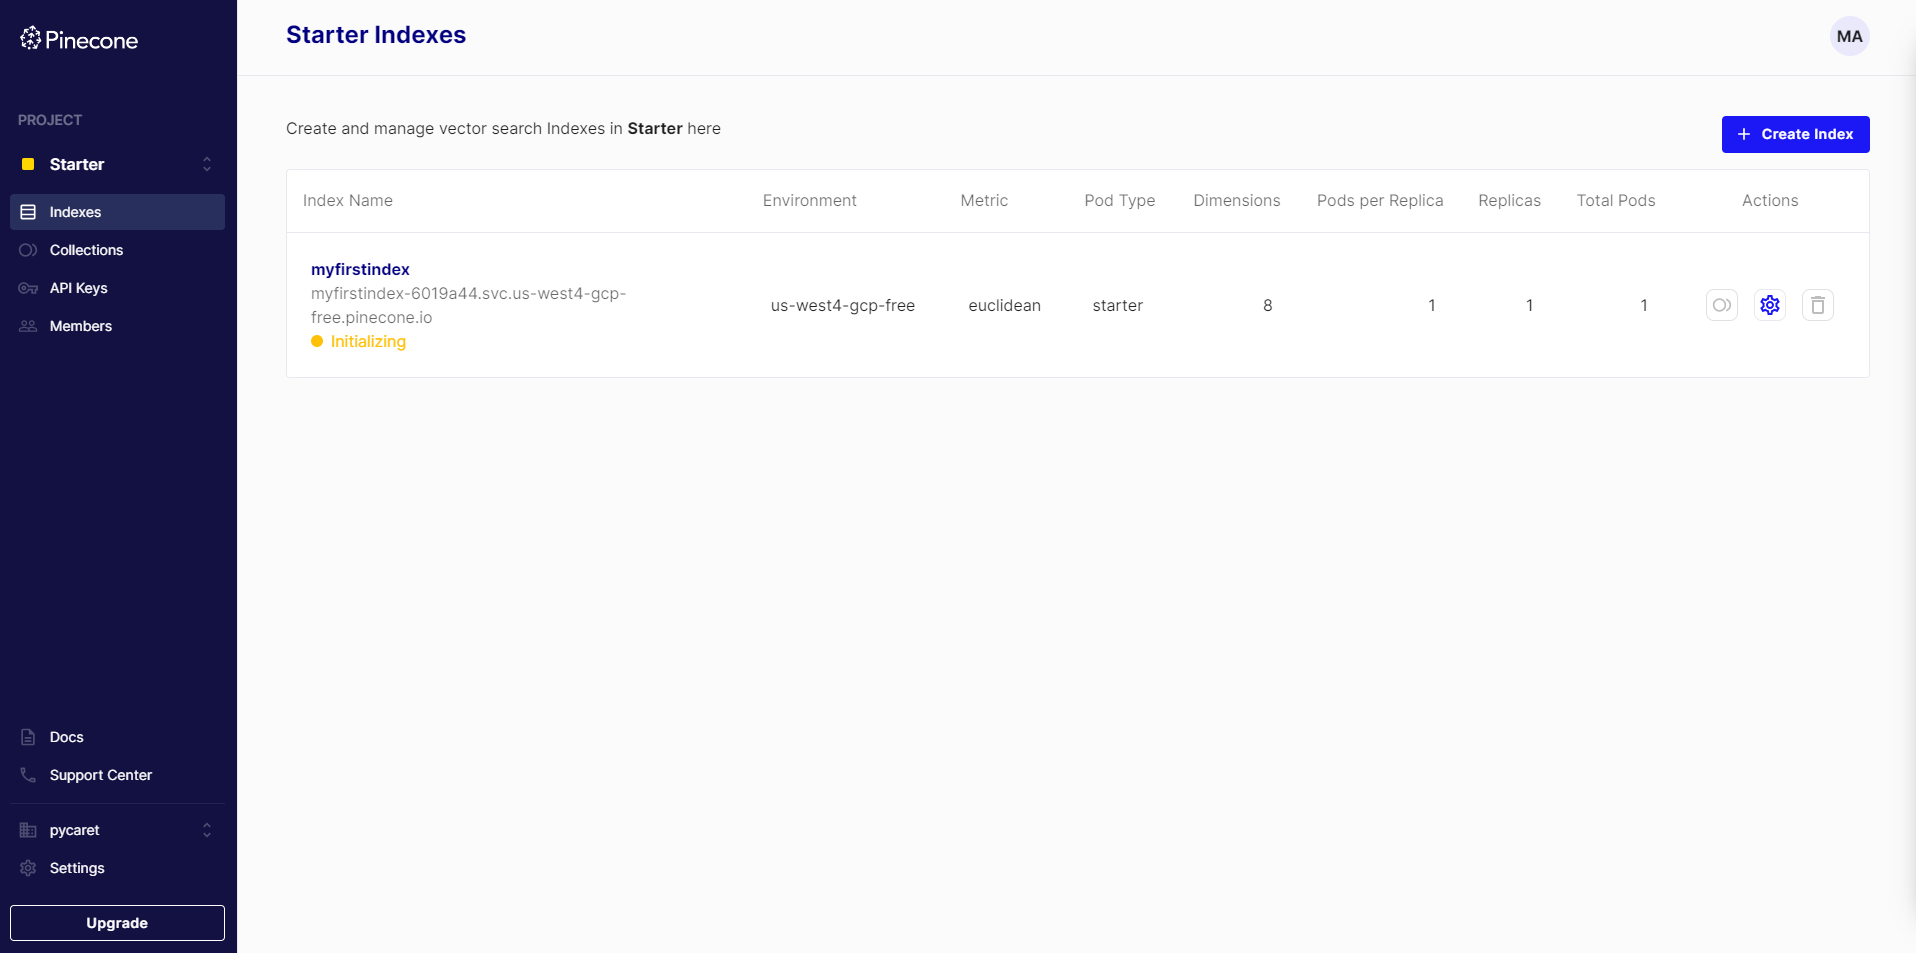
pinecone.create_index("myfirstindex", dimension=8, metric="euclidean")Assim que você rodar esse comando, verá um índice do Pinecone sendo inicializado no console:
Inserção e consulta de dados no Pinecone
Para adicionar vetores ao índice, use a operação upsert. Ela insere um novo vetor no índice ou atualiza um vetor existente caso já haja um com o mesmo ID. Com os comandos abaixo, você faz upsert de cinco vetores de 8 dimensões no seu índice.
index = pinecone.Index("myfirstindex")

index.upsert([
    ("A", [0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1]),
    ("B", [0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2]),
    ("C", [0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3]),
    ("D", [0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4]),
    ("E", [0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5])
])
Se você abrir o console, vai ver os cinco vetores que acabamos de adicionar.
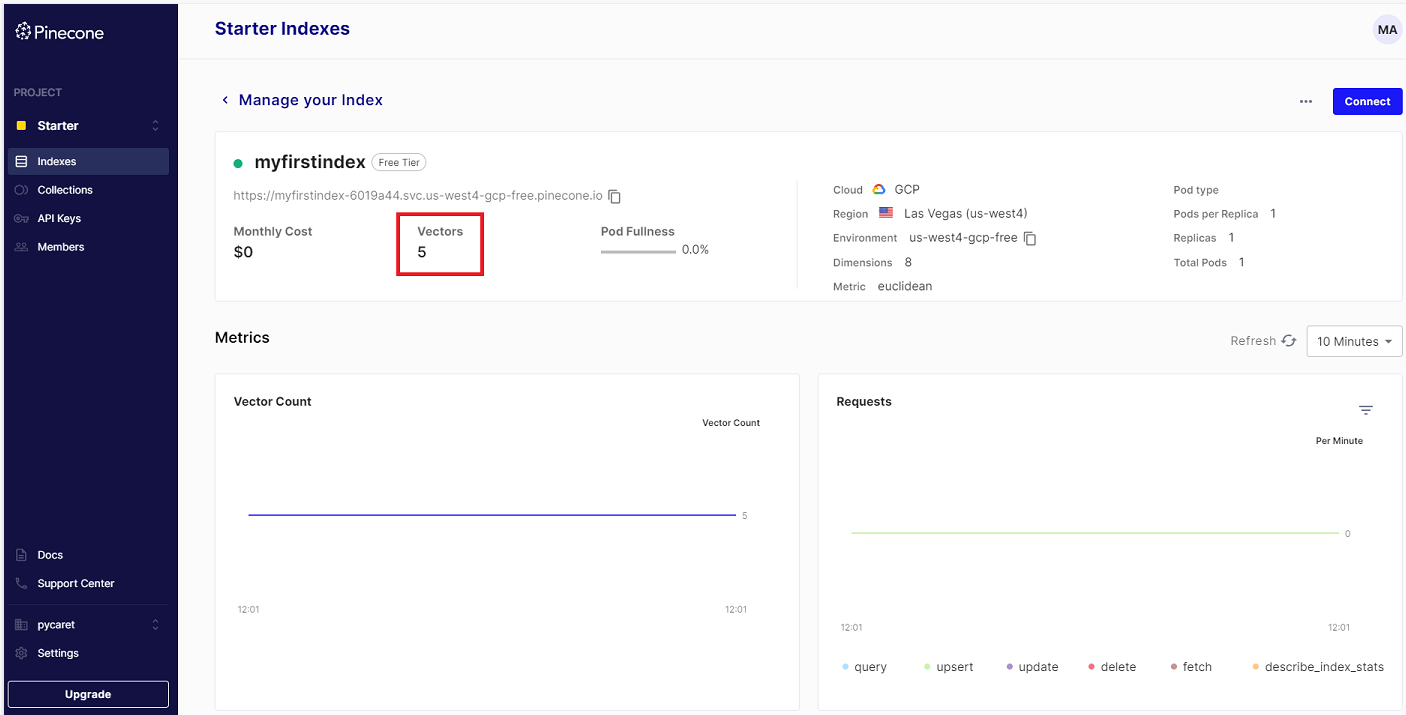
Para verificar a dimensão do vetor, rode:
index.describe_index_stats()
>>> {'dimension': 8,
>>>  'index_fullness': 0.0,
>>>  'namespaces': {'': {'vector_count': 5}},
>>>  'total_vector_count': 5}
Como consultar o índice e obter vetores similares no Pinecone
No exemplo abaixo, consultamos o índice para recuperar os três (3) vetores com maior similaridade em relação a um vetor de 8 dimensões de exemplo. A consulta utiliza a métrica de distância euclidiana definida na criação do índice.
index.query(
  vector=[0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3],
  top_k=3,
  include_values=True
)
>>> {'matches': [{'id': 'C',
>>> 'score': 0.0,
>>> 'values': [0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3]},
>>> {'id': 'D',
>>> 'score': 0.0799999237,
>>> 'values': [0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4]},
>>> {'id': 'B',
>>> 'score': 0.0800000429,
>>> 'values': [0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2]}],
>>> 'namespace': ''}
Excluindo índices no Pinecone
Quando não precisar mais do índice, use a operação delete_index para removê-lo.
pinecone.delete_index("myfirstindex")Conclusão
Este tutorial apresentou o universo dos bancos de dados vetoriais e do Pinecone. Bancos vetoriais oferecem uma solução especializada para lidar com dados de alta dimensionalidade com eficiência — algo cada vez mais essencial em machine learning, ciência de dados e aplicações orientadas por IA.
Como plataforma gerenciada, o Pinecone se destaca como uma ferramenta poderosa para engenheiros e cientistas de dados, oferecendo escalabilidade, busca de baixa latência e ingestão de dados em tempo real. Com integração simples e uma API amigável, o Pinecone facilita a construção e a implantação de aplicações de machine learning em larga escala.
Também exploramos o conceito de dados não estruturados e como embeddings vetoriais desempenham um papel vital ao transformar esse tipo de dado em representações numéricas compactas para análise.
Se você curtiu a ideia de bancos de dados vetoriais e já pensou em um caso de uso, confira nosso curso mão na massa, Vector Databases for Embeddings with Pinecone. Você também pode experimentar o Weaviate — um banco de dados vetorial open source em Python. Para saber mais, assista ao webinar Vector Databases for Data Science with Weaviate in Python na DataCamp.