Nếu bạn là nhà khoa học dữ liệu hoặc nhà phân tích dữ liệu quen thuộc với cơ sở dữ liệu quan hệ và phi quan hệ như SQL và MongoDB, hãy sẵn sàng bước vào một thế giới quản lý dữ liệu mới đầy thú vị. Trong hướng dẫn này, bạn sẽ tìm hiểu về một kiểu kho dữ liệu mới gọi là cơ sở dữ liệu vector, một loại cơ sở dữ liệu chuyên dụng được thiết kế để xử lý và xử lý dữ liệu vector một cách hiệu quả. Trong hướng dẫn về Pinecone này, chúng ta sẽ tập trung vào nền tảng cơ sở dữ liệu vector Pinecone.
Để tìm hiểu thêm về Pinecone, đừng quên xem khóa học của chúng tôi, Vector Databases for Embeddings with Pinecone.
Cơ sở dữ liệu vector là gì?
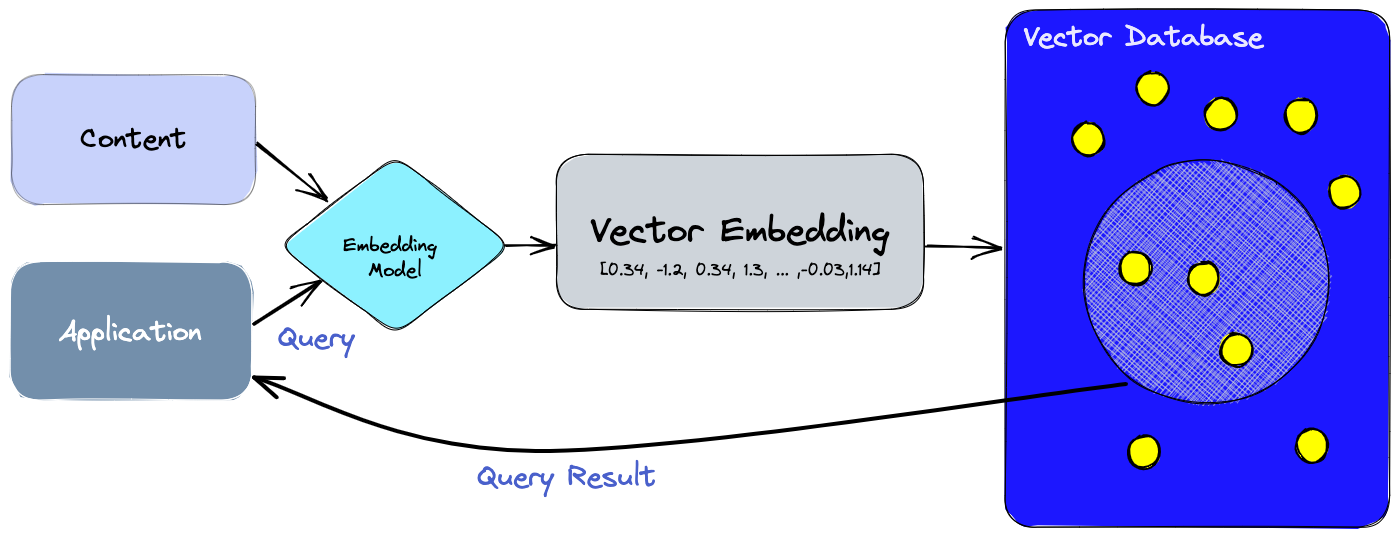
Trong các cơ sở dữ liệu truyền thống, dữ liệu thường được lưu trữ theo hàng và cột, phù hợp với dữ liệu có cấu trúc. Tuy nhiên, khi tập dữ liệu trở nên phức tạp và nhiều chiều hơn, nhu cầu về một giải pháp chuyên biệt xuất hiện. Đây chính là lúc cơ sở dữ liệu vector phát huy tác dụng. Thay vì làm việc với cấu trúc dữ liệu truyền thống, cơ sở dữ liệu vector được tối ưu để xử lý các vector - biểu diễn toán học của các điểm dữ liệu trong không gian đa chiều.
Dữ liệu vector được sử dụng rộng rãi trong nhiều lĩnh vực, bao gồm học máy, khoa học dữ liệu, sinh học tính toán và NLP. Chúng có thể biểu diễn các đặc trưng số, tọa độ, embeddings, văn bản, hình ảnh và nhiều hơn nữa. Với sự trỗi dậy của các ứng dụng vận hành bằng AI, nhu cầu xử lý hiệu quả các tập dữ liệu đã được vector hóa tăng mạnh, và cơ sở dữ liệu vector đã trở thành công cụ then chốt trong bối cảnh này.
Pinecone là gì?
Pinecone là một nền tảng cơ sở dữ liệu vector được quản lý, được xây dựng có chủ đích để giải quyết những thách thức độc nhất gắn với dữ liệu nhiều chiều. Được trang bị các khả năng lập chỉ mục và tìm kiếm tiên tiến, Pinecone giúp kỹ sư dữ liệu và nhà khoa học dữ liệu xây dựng và triển khai các ứng dụng học máy quy mô lớn có thể xử lý và phân tích dữ liệu nhiều chiều một cách hiệu quả.
Tính năng chính của Pinecone
Hãy cùng xem điều gì khiến Pinecone trở thành một công cụ hữu ích như vậy:
Dịch vụ quản lý hoàn toàn
Là một nền tảng được quản lý hoàn toàn, Pinecone xử lý mọi khía cạnh liên quan đến hạ tầng và bảo trì. Điều này cho phép nhà phát triển tập trung vào phát triển và triển khai các ứng dụng học máy mà không phải bận tâm đến sự phức tạp về hạ tầng và vận hành.
Khả năng mở rộng
Pinecone thể hiện khả năng mở rộng vượt trội, dễ dàng quản lý hàng tỷ vector nhiều chiều và hỗ trợ mở rộng theo chiều ngang. Điều này khiến nó phù hợp để xử lý ngay cả những khối lượng công việc học máy đòi hỏi khắt khe nhất.
Nạp dữ liệu thời gian thực
Pinecone hỗ trợ liền mạch việc nạp dữ liệu thời gian thực, cho phép người dùng lưu trữ và lập chỉ mục dữ liệu mới ngay khi có mà không gặp thời gian chết hay gián đoạn.
Tìm kiếm độ trễ thấp
Bằng cách tận dụng các thuật toán lập chỉ mục tinh vi, Pinecone đạt được kết quả tìm kiếm độ trễ thấp cho các truy vấn láng giềng gần nhất và các phép tìm kiếm tương đồng. Điều này đảm bảo kết quả nhanh và chính xác cho các ứng dụng nhạy thời gian.
Tích hợp liền mạch
API của Pinecone được thiết kế chú trọng sự đơn giản và trực quan, giúp hợp lý hóa quá trình tích hợp với các quy trình làm việc học máy và đường ống dữ liệu hiện có.
Hiểu về dữ liệu phi cấu trúc và vector embeddings
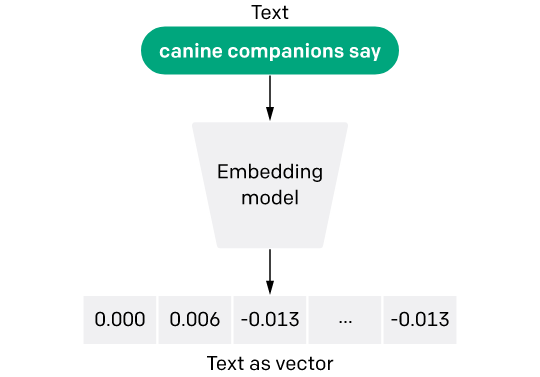
Mô hình nhúng văn bản - Nguồn hình ảnh
Dữ liệu phi cấu trúc là dữ liệu không có định dạng hay tổ chức được xác định trước, khiến cơ sở dữ liệu truyền thống khó lưu trữ và xử lý hiệu quả. Ví dụ về dữ liệu phi cấu trúc gồm văn bản, hình ảnh, âm thanh và tệp video.
Dữ liệu phi cấu trúc thiếu cấu trúc cứng nhắc, khiến khó phân tích trực tiếp bằng các phương pháp truyền thống. Vì vậy để có thể sử dụng dữ liệu phi cấu trúc cho các ứng dụng học máy và AI, dữ liệu này được biến đổi và lưu trữ thành dạng biểu diễn số nhiều chiều bằng cách sử dụng vector embeddings.
Embeddings đóng vai trò then chốt trong lĩnh vực trí tuệ nhân tạo, cung cấp kỹ thuật mạnh mẽ để biến đổi dữ liệu nhiều chiều, như từ ngữ, hình ảnh hoặc sở thích người dùng, thành các biểu diễn số gọn nhẹ. Các embedding số này cho phép mô hình AI xử lý và hiểu thông tin phức tạp một cách hiệu quả.
Việc hiểu embeddings trở nên dễ dàng hơn khi coi chúng như một cuốn từ điển chuyên biệt cho một tác vụ cụ thể. Chẳng hạn, trong các dự án khai phá văn bản, embeddings giúp chúng ta nắm bắt ý nghĩa ngữ nghĩa của từ bằng cách phân tích mối quan hệ của chúng với các từ khác. Quá trình này tạo ra một danh sách embeddings, có thể coi như một từ điển theo tác vụ, cung cấp các vector số phản ánh ý nghĩa ngữ nghĩa của từ. Mức độ tương đồng và quan hệ giữa các từ khác nhau được đo bằng khoảng cách giữa các embedding tương ứng của chúng, giúp mô hình AI hiểu được ngữ cảnh và tầm quan trọng của từ.
Điểm quan trọng của embeddings nằm ở khả năng giảm chiều dữ liệu, giúp mô hình học máy dễ xử lý các đầu vào lớn như các vector thưa biểu diễn từ hoặc vật phẩm. Nhờ embeddings, chúng ta có thể tránh được hạn chế của one-hot-encoding, nơi mỗi hạng mục được chuyển thành một biến giả riêng, có thể dẫn đến ma trận đầu vào quá lớn cho một số tác vụ.
Nếu bạn muốn tìm hiểu thêm về cách Word Embeddings hoạt động, hãy xem hướng dẫn LDA2vec: Word Embeddings in Topic Models của chúng tôi.
Tóm tắt:
- Cơ sở dữ liệu vector là loại cơ sở dữ liệu chuyên dụng được thiết kế để xử lý và xử lý dữ liệu vector hiệu quả
- Pinecone là dịch vụ cơ sở dữ liệu vector được quản lý hoàn toàn
- Dữ liệu phi cấu trúc là dữ liệu không có định dạng hay tổ chức được xác định trước, như hình ảnh, văn bản, âm thanh hoặc video
- Embeddings là kỹ thuật mạnh mẽ để biến đổi dữ liệu nhiều chiều thành các biểu diễn số gọn nhẹ
Cơ sở dữ liệu vector hoạt động như thế nào?
Bạn hẳn đã quen với cách cơ sở dữ liệu truyền thống vận hành, lưu trữ dữ liệu vô hướng như chuỗi và số theo hàng và cột. Tuy nhiên, cơ sở dữ liệu vector hoạt động khác, làm việc với các vector và sử dụng những phương pháp tối ưu hóa và truy vấn riêng.
Trong cơ sở dữ liệu truyền thống, truy vấn thường tìm kiếm sự trùng khớp tuyệt đối trong cơ sở dữ liệu. Ngược lại, cơ sở dữ liệu vector sử dụng thước đo tương đồng để tìm vector phù hợp nhất với truy vấn của chúng ta.
Cơ sở dữ liệu vector sử dụng kết hợp các thuật toán, gọi chung là tìm kiếm Láng giềng Gần đúng (Approximate Nearest Neighbor - ANN). Các thuật toán này tối ưu hóa quá trình tìm kiếm thông qua các kỹ thuật như băm, lượng tử hóa hoặc tìm kiếm dựa trên đồ thị.
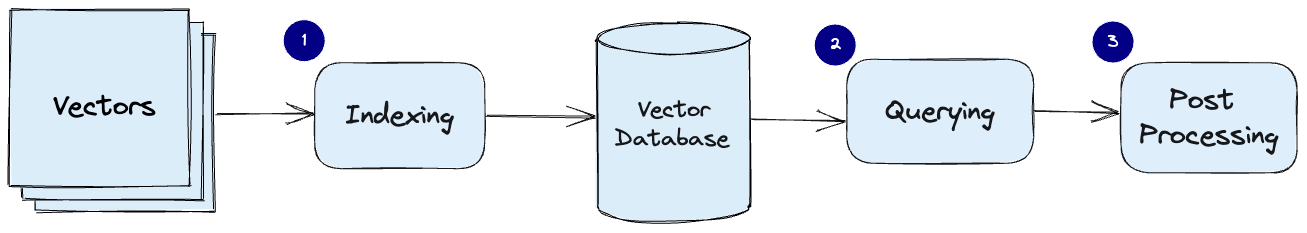
Pipeline phổ biến cho cơ sở dữ liệu vector (Nguồn hình ảnh)
Bạn muốn học cách dùng OpenAI API để tạo text embeddings rồi lưu vào cơ sở dữ liệu vector như Pinecone? Khám phá các ứng dụng của chúng trong phân loại văn bản, truy hồi thông tin và phát hiện tương đồng ngữ nghĩa tại Introduction to Text Embeddings with the OpenAI API trên DataCamp.
Bắt đầu với Pinecone
Để bắt đầu, chỉ cần truy cập pinecone.io và đăng ký một tài khoản miễn phí.
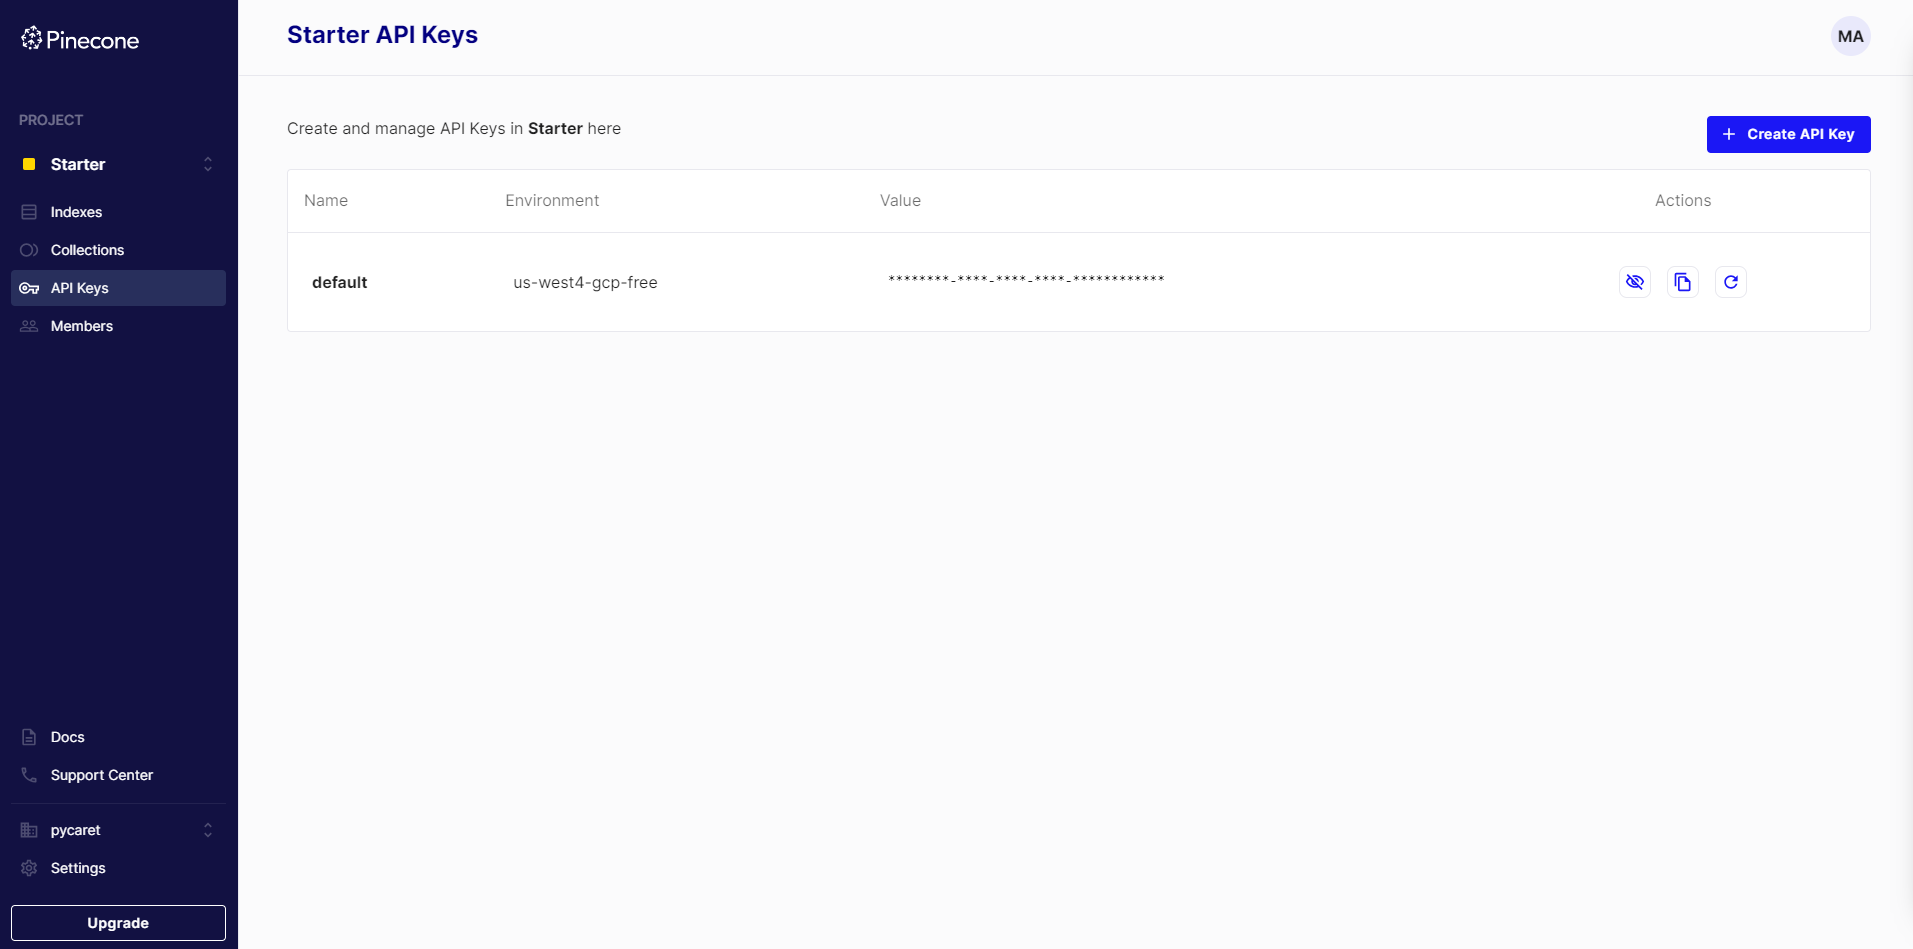
Sau khi đăng ký thành công, hãy nhấp vào API Keys trong menu và sao chép environment và API key của bạn. Thông tin này sẽ được dùng khi làm việc với client Python của Pinecone.
Bạn cũng có thể cài đặt client Python cho Pinecone bằng pip.
pip install pinecone-clientCác khái niệm chính trong Pinecone
Trước khi đi sâu hơn, hãy điểm qua một số thuật ngữ và khái niệm chính bạn cần biết:
Chỉ mục (index) của Pinecone
Trong Pinecone, một index đại diện cho cấu trúc tổ chức cấp cao nhất cho dữ liệu vector. Nó chịu trách nhiệm nhận và lưu trữ vector, xử lý truy vấn trên các vector đã lưu và thực hiện nhiều phép toán vector trong phạm vi dữ liệu của nó. Mỗi index hoạt động trên một hoặc nhiều pod để đảm bảo hiệu năng.
Pods
Pod là các đơn vị phần cứng được cấu hình sẵn để lưu trữ dịch vụ Pinecone. Mỗi index trong Pinecone hoạt động trên một hoặc nhiều pod; có thêm pod thường giúp tăng dung lượng lưu trữ, giảm độ trễ và cải thiện thông lượng. Ngoài ra, người dùng có thể tạo các pod với kích thước khác nhau để đáp ứng yêu cầu cụ thể.
Thước đo khoảng cách (Distance Metrics)
Thước đo khoảng cách là các kỹ thuật toán học được dùng để đánh giá mức độ tương đồng giữa hai vector trong một không gian vector. Trong cơ sở dữ liệu vector, các thước đo này đóng vai trò quan trọng khi so sánh các vector đã lưu với một vector truy vấn nhằm xác định những vector tương tự nhất.
Bạn có thể chọn các thước đo khác nhau khi tạo một chỉ mục vector:
- Cosine similarity. Thước đo này đánh giá cosin của góc giữa hai vector trong không gian vector. Thang đo từ -1 đến 1, trong đó 1 biểu thị vector giống hệt nhau, 0 biểu thị vector trực giao và -1 biểu thị vector đối nghịch.
- Euclidean distance. Thước đo này tính khoảng cách đường thẳng giữa hai vector trong không gian vector. Phạm vi từ 0 đến vô cực, trong đó 0 cho thấy vector giống hệt, còn giá trị lớn hơn thể hiện mức độ khác biệt tăng dần.
- Dot product. Thước đo này tính tích giữa độ lớn của hai vector và cosin của góc giữa chúng. Thang đo trải từ -∞ đến ∞, trong đó giá trị dương cho thấy các vector hướng cùng chiều, 0 biểu thị trực giao và giá trị âm cho thấy các vector hướng ngược chiều.
Cách xác minh API key của Pinecone
Để sử dụng Pinecone từ Python, bạn cần một API key. Bạn có thể tìm API key bằng cách truy cập bảng điều khiển Pinecone và chọn "API Keys." Trong cùng giao diện này, bạn cũng có thể tìm thông tin về environment gắn với dự án của mình.
import pinecone
pinecone.init(api_key="API_KEY", environment = 'ENVIRONMENT')
Cách tạo một chỉ mục Pinecone
Để tạo một index trong Pinecone, chỉ cần chạy:
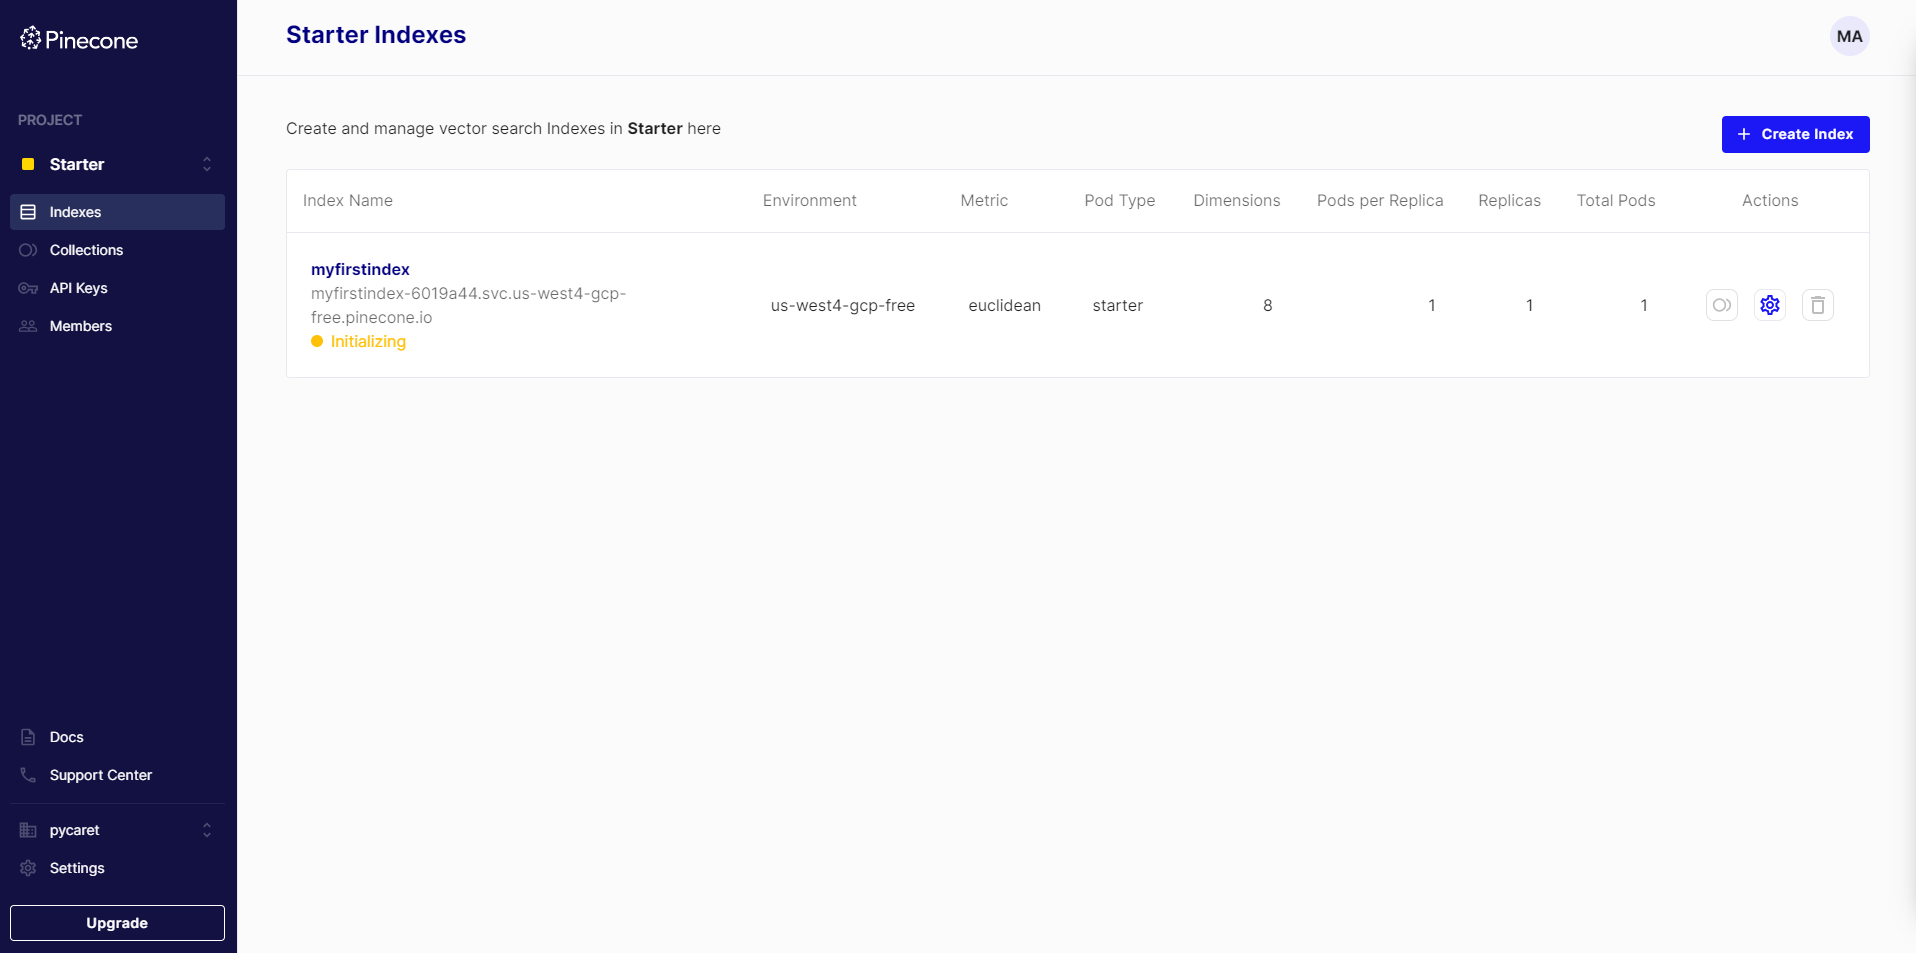
pinecone.create_index("myfirstindex", dimension=8, metric="euclidean")Ngay khi bạn chạy lệnh này, bạn sẽ thấy một chỉ mục Pinecone được khởi tạo trong bảng điều khiển:
Chèn dữ liệu và truy vấn trong Pinecone
Để thêm vector vào index, có thể dùng thao tác upsert. Thao tác upsert sẽ thêm một vector mới vào index hoặc cập nhật vector đã tồn tại nếu đã có vector cùng ID. Bằng các lệnh sau, bạn có thể upsert năm vector 8 chiều vào index của mình.
index = pinecone.Index("myfirstindex")

index.upsert([
    ("A", [0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1]),
    ("B", [0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2]),
    ("C", [0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3]),
    ("D", [0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4]),
    ("E", [0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5])
])
Nếu bạn mở bảng điều khiển, bạn sẽ thấy năm vector vừa được thêm vào.
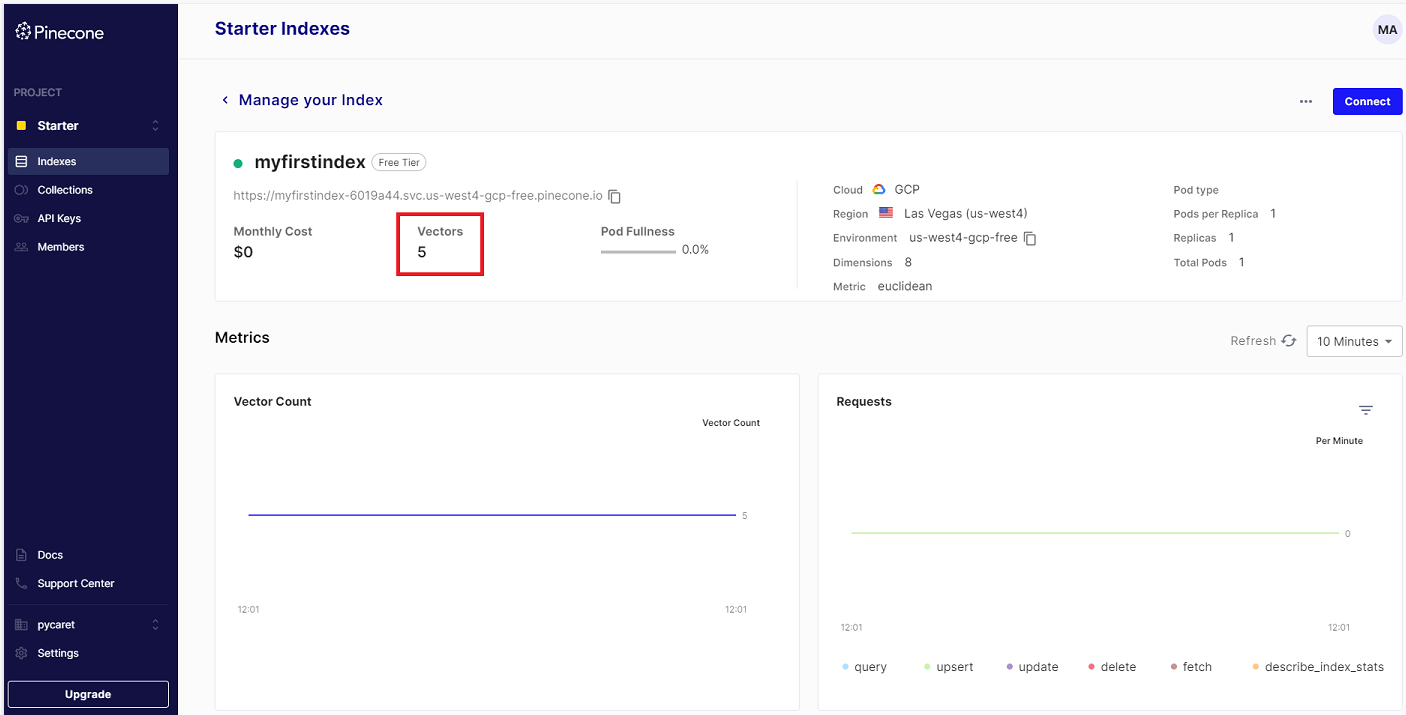
Để kiểm tra số chiều của vector, bạn có thể chạy:
index.describe_index_stats()
>>> {'dimension': 8,
>>>  'index_fullness': 0.0,
>>>  'namespaces': {'': {'vector_count': 5}},
>>>  'total_vector_count': 5}
Cách truy vấn chỉ mục và lấy các vector tương tự trong Pinecone
Trong ví dụ dưới đây, chỉ mục được truy vấn để lấy ba (3) vector có mức độ tương đồng cao nhất với một vector mẫu 8 chiều. Truy vấn sử dụng thước đo khoảng cách Euclid như đã chỉ định khi tạo chỉ mục.
index.query(
  vector=[0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3],
  top_k=3,
  include_values=True
)
>>> {'matches': [{'id': 'C',
>>> 'score': 0.0,
>>> 'values': [0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3]},
>>> {'id': 'D',
>>> 'score': 0.0799999237,
>>> 'values': [0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4]},
>>> {'id': 'B',
>>> 'score': 0.0800000429,
>>> 'values': [0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2]}],
>>> 'namespace': ''}
Xóa chỉ mục trong Pinecone
Khi không còn cần đến index, bạn có thể dùng thao tác delete_index để xóa index đó.
pinecone.delete_index("myfirstindex")Kết luận
Hướng dẫn này đã cung cấp cái nhìn tổng quan về thế giới cơ sở dữ liệu vector và Pinecone. Cơ sở dữ liệu vector mang đến giải pháp chuyên biệt để xử lý hiệu quả dữ liệu nhiều chiều, ngày càng trở nên thiết yếu trong lĩnh vực học máy, khoa học dữ liệu và các ứng dụng vận hành bằng AI.
Pinecone, với vai trò nền tảng cơ sở dữ liệu vector được quản lý, nổi bật như một công cụ mạnh mẽ cho kỹ sư và nhà khoa học dữ liệu, cung cấp khả năng mở rộng, tìm kiếm độ trễ thấp và nạp dữ liệu thời gian thực. Nhờ tích hợp liền mạch và API thân thiện, Pinecone đơn giản hóa quá trình xây dựng và triển khai các ứng dụng học máy quy mô lớn.
Hướng dẫn cũng đã đi sâu vào khái niệm dữ liệu phi cấu trúc và cách Vector Embeddings đóng vai trò quan trọng trong việc biến đổi loại dữ liệu này thành các biểu diễn số gọn nhẹ để phân tích.
Nếu bạn hứng thú với ý tưởng về cơ sở dữ liệu vector và nghĩ rằng mình có trường hợp sử dụng phù hợp, hãy xem khóa học thực hành của chúng tôi, Vector Databases for Embeddings with Pinecone. Bạn cũng có thể thử Weaviate - một cơ sở dữ liệu vector mã nguồn mở trong Python. Nếu muốn tìm hiểu thêm về chủ đề này, hãy xem Webinar Vector Databases for Data Science with Weaviate in Python trên Datacamp.
