Si vous êtes data scientist ou data analyst et que vous maîtrisez déjà des bases de données relationnelles et non relationnelles comme SQL et MongoDB, préparez-vous à découvrir un nouveau monde de gestion des données. Dans ce tutoriel, vous allez découvrir un nouveau type de stockage : les bases de données vectorielles, des bases spécialisées conçues pour traiter efficacement des données sous forme de vecteurs. Dans ce tutoriel Pinecone, nous nous concentrerons spécifiquement sur la plateforme de base de données vectorielle Pinecone.
Pour en savoir plus sur Pinecone, n’hésitez pas à suivre notre cours Vector Databases for Embeddings with Pinecone.
Qu’est-ce qu’une base de données vectorielle ?
Dans les bases de données traditionnelles, les données sont généralement stockées en lignes et colonnes, ce qui convient aux données structurées. Mais à mesure que les jeux de données deviennent plus complexes et de plus haute dimension, des solutions spécialisées s’imposent. C’est là que les bases de données vectorielles excellent. Plutôt que de s’appuyer sur des structures classiques, elles sont optimisées pour manipuler des vecteurs : des représentations mathématiques de points de données dans des espaces multidimensionnels.
Les données vectorielles sont largement utilisées en apprentissage automatique, data science, biologie computationnelle et NLP. Elles peuvent représenter des variables numériques, des coordonnées, des embeddings, du texte, des images, et bien plus encore. Avec la montée en puissance des applications IA, le besoin de gérer efficacement des jeux de données vectorisés a explosé, faisant des bases de données vectorielles un outil incontournable.
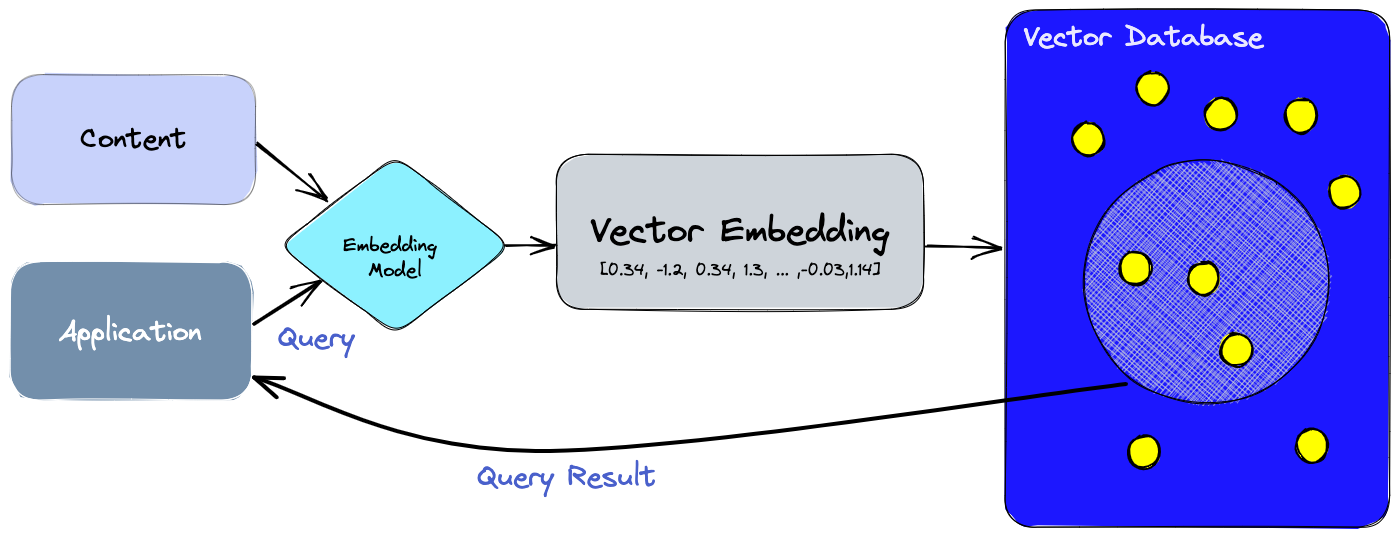
Qu’est-ce que Pinecone ?
Pinecone est une plateforme managée de base de données vectorielle, conçue pour relever les défis propres aux données de haute dimension. Doté de capacités d’indexation et de recherche de pointe, Pinecone permet aux data engineers et data scientists de construire et déployer des applications d’apprentissage automatique à grande échelle capables de traiter et d’analyser efficacement des données de haute dimension.
Fonctionnalités clés de Pinecone
Voici ce qui fait de Pinecone un outil si utile :
Service entièrement managé
En tant que plateforme entièrement managée, Pinecone prend en charge toute l’infrastructure et la maintenance. Les développeurs peuvent ainsi se concentrer sur le développement et le déploiement de leurs applications de machine learning sans se soucier des aspects opérationnels.
Scalabilité
Pinecone offre une scalabilité remarquable, gérant sans effort des milliards de vecteurs de haute dimension et proposant un scaling horizontal. Il est donc parfaitement adapté aux charges de travail de machine learning les plus exigeantes.
Ingestion de données en temps réel
Pinecone gère l’ingestion en temps réel, ce qui permet de stocker et d’indexer les nouvelles données dès qu’elles sont disponibles, sans interruption.
Recherche à faible latence
Grâce à des algorithmes d’indexation avancés, Pinecone fournit des résultats à faible latence pour les requêtes de plus proches voisins et les recherches par similarité. Idéal pour des applications sensibles au temps, avec des résultats rapides et précis.
Intégration fluide
L’API de Pinecone est pensée pour être simple et intuitive, ce qui facilite son intégration dans vos workflows de machine learning et vos pipelines de données existants.
Comprendre les données non structurées et les embeddings vectoriels
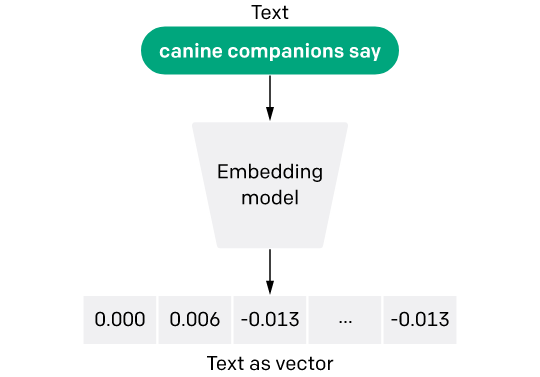
Modèle d’embedding de texte - source de l’image
Les données non structurées sont des données sans format prédéfini ni organisation claire, ce qui complique leur stockage et traitement efficace dans des bases traditionnelles. Exemples : texte, images, audio, vidéo.
Faute de structure rigide, ces données sont difficiles à analyser directement avec des méthodes classiques. Pour les exploiter en apprentissage automatique et en IA, on les transforme en représentations numériques multidimensionnelles à l’aide d’embeddings vectoriels.
Les embeddings jouent un rôle central en IA : ils transforment des données de haute dimension (mots, images, préférences utilisateur, etc.) en représentations numériques compactes. Ces représentations permettent aux modèles d’IA de traiter et de comprendre efficacement des informations complexes.
Pour mieux les appréhender, imaginez des embeddings comme un dictionnaire spécialisé pour une tâche donnée. En text mining, par exemple, ils aident à saisir le sens des mots en analysant leurs relations avec d’autres mots. On obtient ainsi une liste d’embeddings qui fonctionne comme un dictionnaire spécifique à la tâche, fournissant des vecteurs numériques reflétant la sémantique. La similarité et la relation entre mots se mesurent par la distance entre leurs embeddings, ce qui aide les modèles à comprendre le contexte et l’importance des mots.
Leur intérêt tient aussi à la réduction de dimension qu’ils opèrent, rendant les données plus maniables pour les modèles, notamment face à de grands vecteurs clairsemés (par exemple pour représenter des mots ou des items). Les embeddings contournent ainsi les limites du one-hot encoding, où chaque catégorie devient une variable muette séparée, produisant des matrices d’entrée inutilement volumineuses.
Pour approfondir le fonctionnement des word embeddings, consultez notre tutoriel LDA2vec: Word Embeddings in Topic Models.
Récapitulatif :
- Une base de données vectorielle est une base spécialisée pour traiter efficacement des données sous forme de vecteurs
- Pinecone est un service de base de données vectorielle entièrement managé
- Les données non structurées n’ont pas de format prédéfini (images, texte, audio, vidéo, etc.)
- Les embeddings sont une technique puissante pour transformer des données de haute dimension en représentations numériques compactes
Comment fonctionne une base de données vectorielle ?
Vous connaissez sans doute le fonctionnement des bases traditionnelles, qui stockent des scalaires (chaînes, nombres) en lignes et colonnes. Les bases vectorielles, elles, manipulent des vecteurs et reposent sur des méthodes d’optimisation et de requêtage différentes.
Dans une base classique, une requête cherche des correspondances exactes. À l’inverse, une base vectorielle utilise une mesure de similarité pour trouver les vecteurs les plus proches de la requête.
Elles s’appuient sur un ensemble d’algorithmes regroupés sous le terme Approximate Nearest Neighbor (ANN). Ces algorithmes accélèrent la recherche via des techniques comme le hashing, la quantification ou la recherche basée sur des graphes.
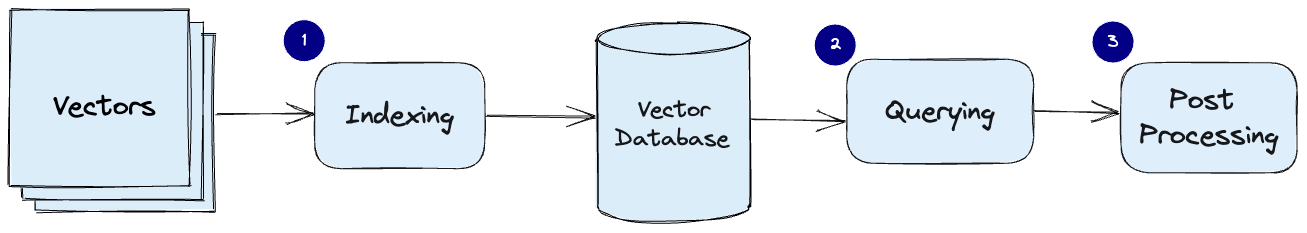
Pipeline courant pour une base vectorielle (source de l’image)
Vous souhaitez apprendre à utiliser l’API OpenAI pour créer des embeddings de texte, puis les stocker dans une base vectorielle comme Pinecone ? Découvrez leurs usages en classification de texte, recherche d’information et détection de similarité sémantique dans l’article Introduction to Text Embeddings with the OpenAI API sur DataCamp.
Premiers pas avec Pinecone
Pour commencer, rendez-vous sur pinecone.io et créez un compte gratuit.
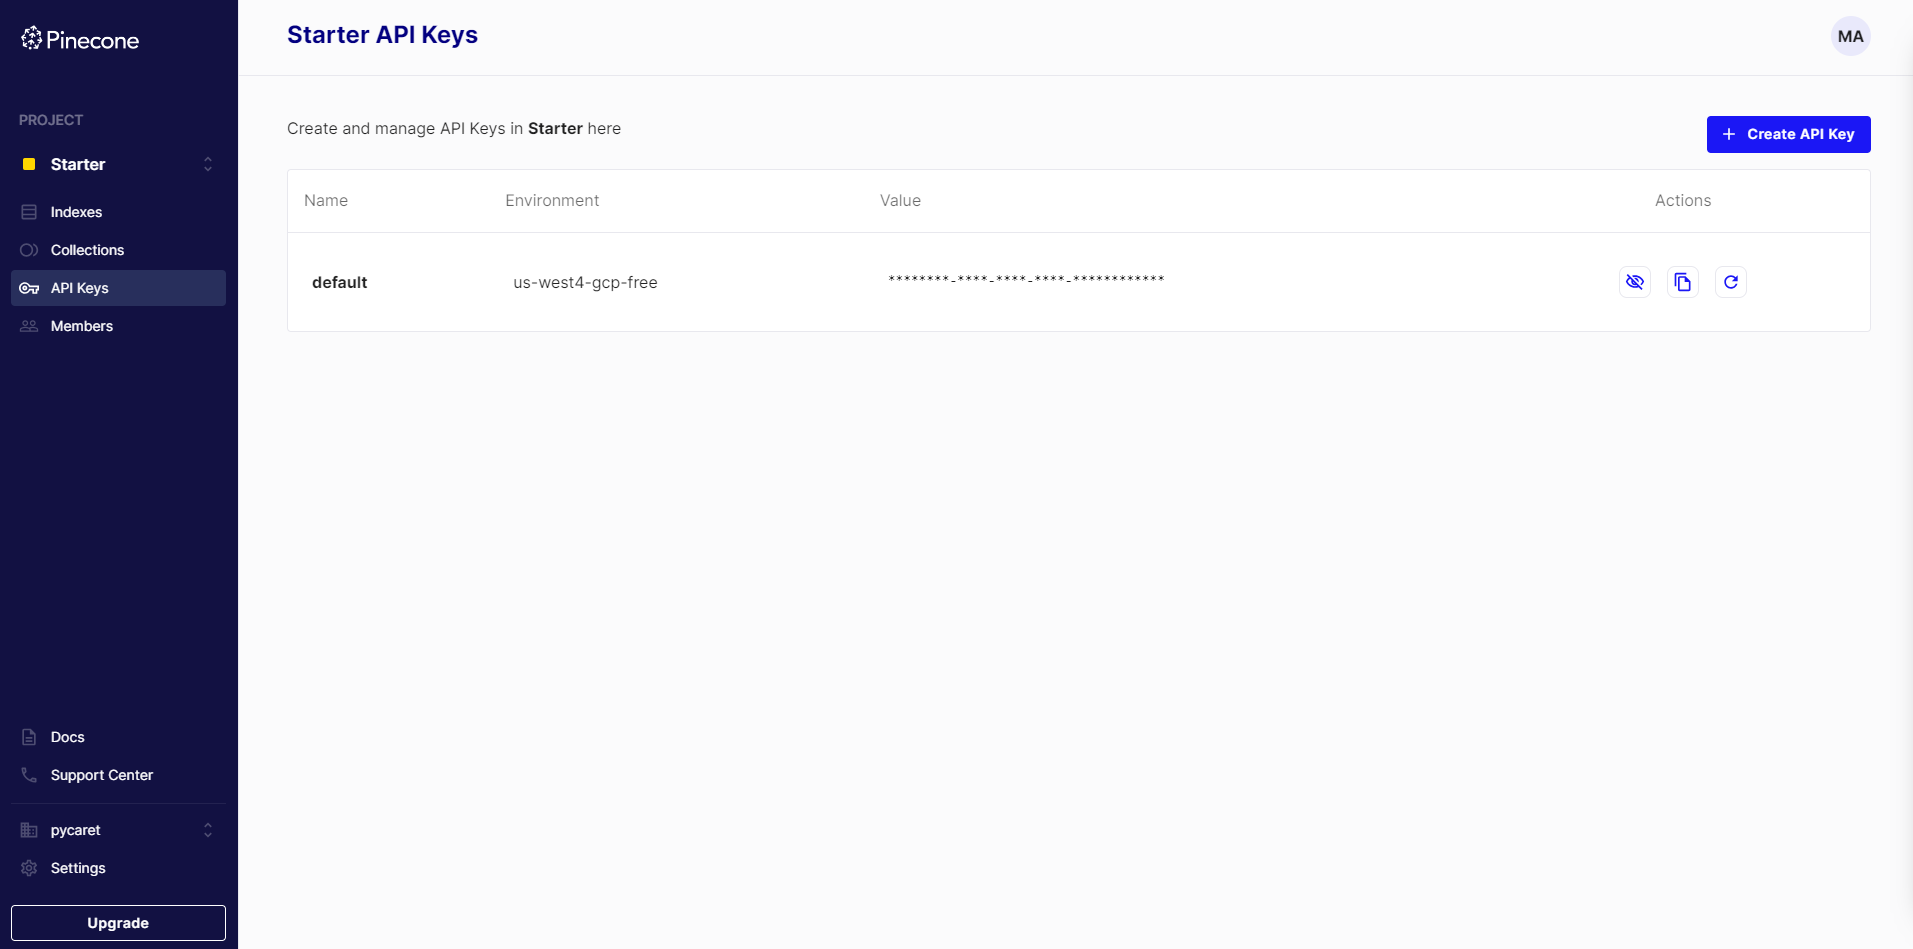
Une fois inscrit, cliquez sur API Keys dans le menu et copiez votre environnement et votre clé API. Vous en aurez besoin avec le client Python de Pinecone.
Vous pouvez aussi installer le client Python de Pinecone via pip.
pip install pinecone-clientConcepts clés dans Pinecone
Avant d’entrer dans le détail, voici quelques notions et termes essentiels :
Index Pinecone
Dans Pinecone, un index représente la structure d’organisation de plus haut niveau pour les données vectorielles. Il reçoit et stocke les vecteurs, gère les requêtes sur ces vecteurs et exécute diverses opérations au sein de ses données. Chaque index fonctionne sur un ou plusieurs pods pour assurer des performances optimales.
Pods
Les pods sont des unités matérielles préconfigurées qui hébergent les services Pinecone. Chaque index s’exécute sur un ou plusieurs pods ; en ajouter augmente généralement la capacité de stockage, réduit la latence et améliore le débit. Les utilisateurs peuvent créer des pods de tailles différentes selon leurs besoins.
Mesures de distance
Les mesures de distance sont des techniques mathématiques utilisées pour évaluer la similarité entre deux vecteurs dans un espace vectoriel. Dans une base vectorielle, elles servent à comparer les vecteurs stockés à un vecteur de requête afin d’identifier les plus proches.
Vous pouvez choisir différentes mesures lors de la création d’un index :
- Similarité cosinus. Elle évalue le cosinus de l’angle entre deux vecteurs. Elle varie de -1 à 1 : 1 pour des vecteurs identiques, 0 pour des vecteurs orthogonaux, -1 pour des vecteurs opposés.
- Distance euclidienne. Elle calcule la distance à vol d’oiseau entre deux vecteurs. Elle varie de 0 à l’infini : 0 pour des vecteurs identiques, des valeurs plus grandes indiquant une moindre similarité.
- Produit scalaire. Il calcule le produit des normes des deux vecteurs et du cosinus de l’angle qui les sépare. Il varie de -∞ à ∞ : valeurs positives pour des vecteurs allant dans la même direction, 0 pour des vecteurs orthogonaux, valeurs négatives pour des vecteurs opposés.
Comment vérifier la clé API Pinecone
Pour utiliser Pinecone depuis Python, vous avez besoin d’une clé API. Vous la trouverez dans la console Pinecone, section « API Keys ». Dans cette vue, vous verrez aussi l’environnement associé à votre projet.
import pinecone
pinecone.init(api_key="API_KEY", environment = 'ENVIRONMENT')
Comment créer un index Pinecone
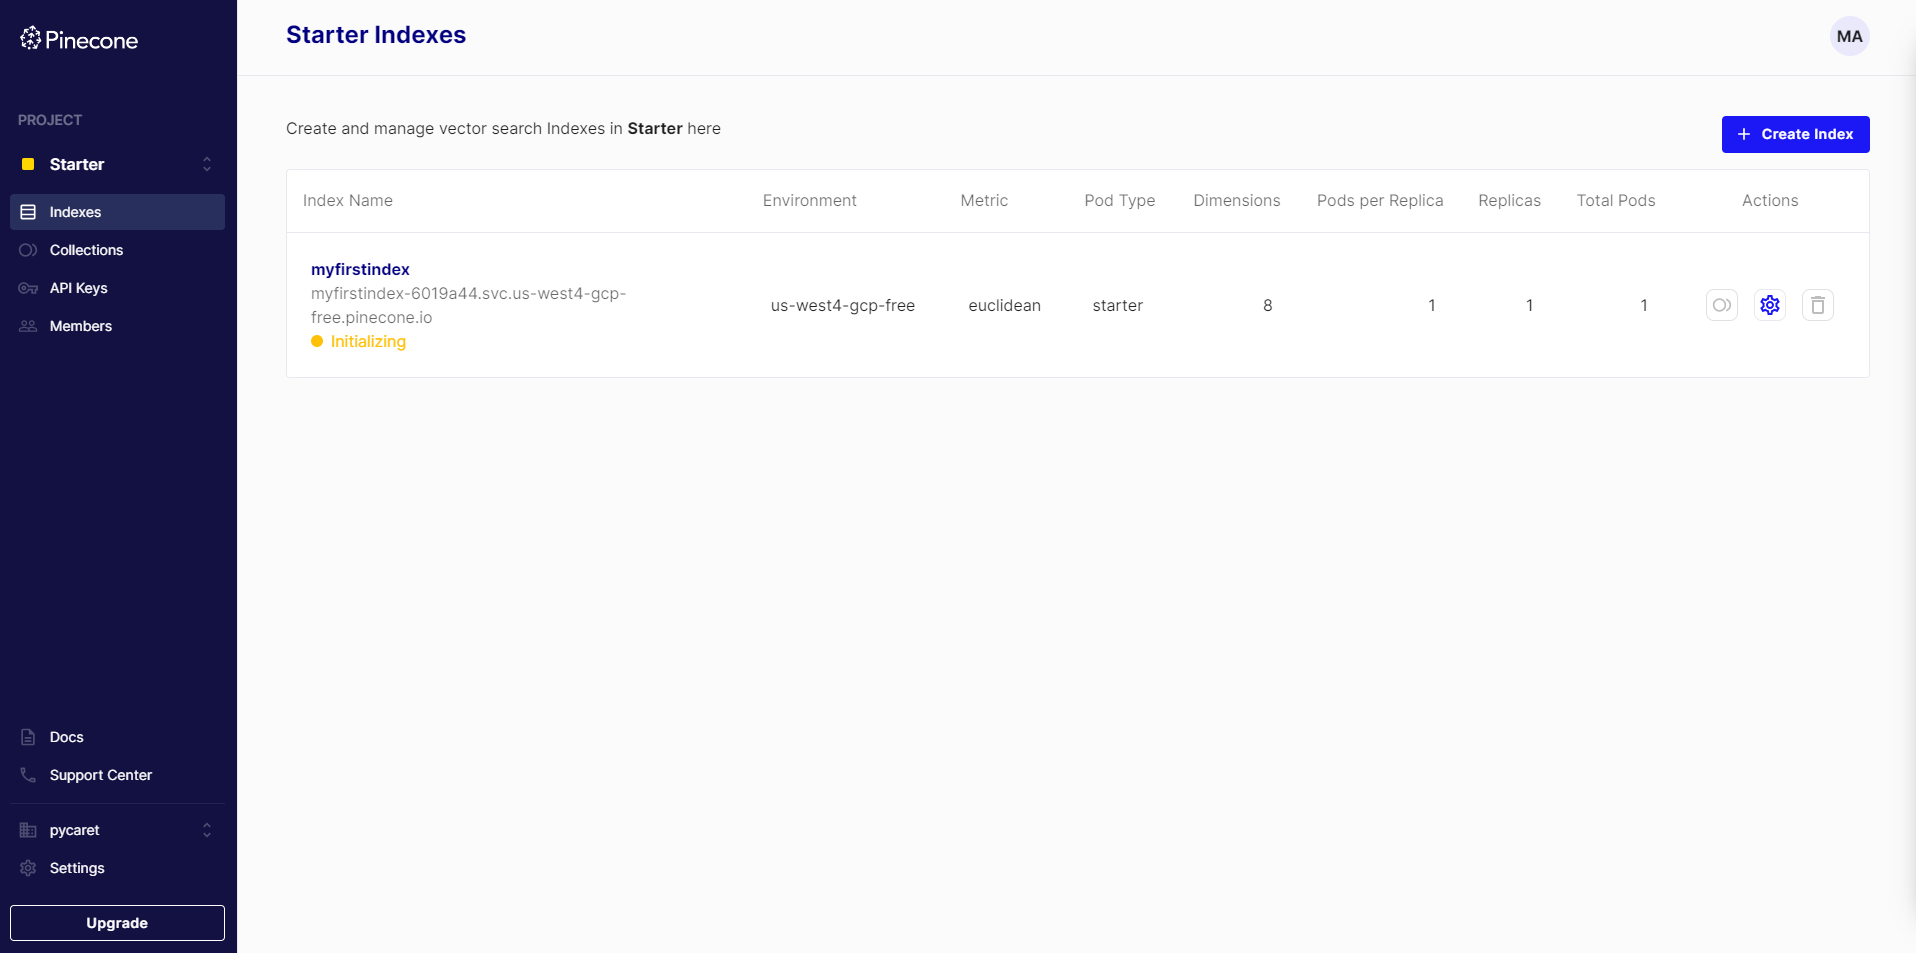
Pour créer un index dans Pinecone, exécutez simplement :
pinecone.create_index("myfirstindex", dimension=8, metric="euclidean")Dès l’exécution de cette commande, vous verrez l’initialisation de l’index Pinecone dans votre console :
Insertion et requêtage des données dans Pinecone
Pour ajouter des vecteurs à l’index, utilisez l’opération upsert. Elle ajoute un nouveau vecteur ou met à jour un vecteur existant s’il porte le même identifiant. Avec les commandes ci-dessous, vous insérez cinq vecteurs de dimension 8 dans votre index.
index = pinecone.Index("myfirstindex")

index.upsert([
    ("A", [0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1]),
    ("B", [0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2]),
    ("C", [0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3]),
    ("D", [0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4]),
    ("E", [0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5])
])
Dans la console, vous verrez les cinq vecteurs qui viennent d’être ajoutés.
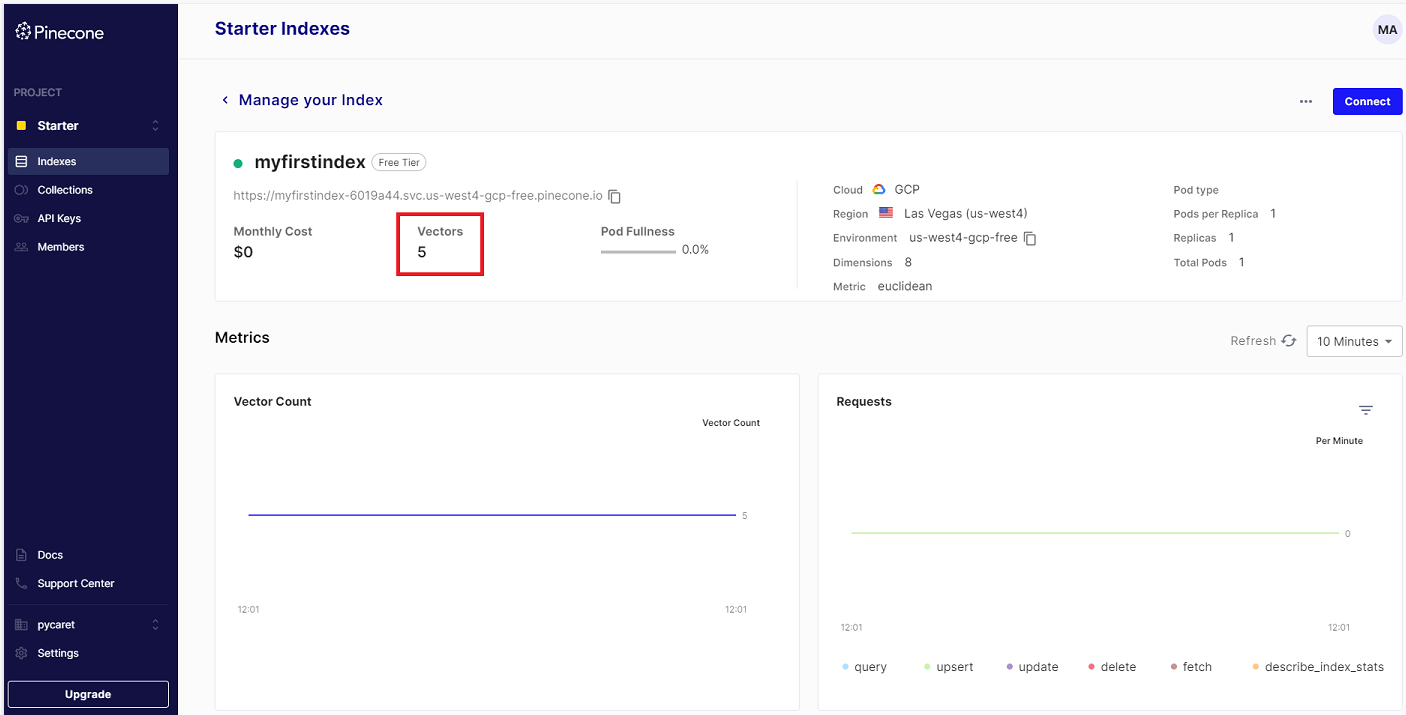
Pour vérifier la dimension du vecteur, exécutez :
index.describe_index_stats()
>>> {'dimension': 8,
>>>  'index_fullness': 0.0,
>>>  'namespaces': {'': {'vector_count': 5}},
>>>  'total_vector_count': 5}
Comment interroger l’index et obtenir des vecteurs similaires dans Pinecone
Dans l’exemple ci-dessous, on interroge l’index pour récupérer les trois (3) vecteurs les plus similaires à un vecteur d’exemple de dimension 8. La requête utilise la distance euclidienne, telle que spécifiée à la création de l’index.
index.query(
  vector=[0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3],
  top_k=3,
  include_values=True
)
>>> {'matches': [{'id': 'C',
>>> 'score': 0.0,
>>> 'values': [0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3]},
>>> {'id': 'D',
>>> 'score': 0.0799999237,
>>> 'values': [0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4]},
>>> {'id': 'B',
>>> 'score': 0.0800000429,
>>> 'values': [0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2]}],
>>> 'namespace': ''}
Suppression d’index dans Pinecone
Quand vous n’avez plus besoin d’un index, utilisez l’opération delete_index pour le supprimer.
pinecone.delete_index("myfirstindex")Conclusion
Ce tutoriel vous a fait découvrir l’univers des bases de données vectorielles et de Pinecone. Les bases de données vectorielles offrent une solution spécialisée pour gérer efficacement des données de haute dimension, devenues essentielles en machine learning, data science et pour les applications pilotées par l’IA.
En tant que plateforme managée, Pinecone s’impose comme un outil puissant pour les ingénieurs et scientifiques des données, avec une scalabilité élevée, une recherche à faible latence et une ingestion temps réel. Son intégration fluide et son API conviviale simplifient la construction et le déploiement d’applications de ML à grande échelle.
Nous avons également abordé la nature des données non structurées et le rôle clé des embeddings vectoriels pour les transformer en représentations numériques compactes prêtes à l’analyse.
Séduit par les bases de données vectorielles et déjà des cas d’usage en tête ? Découvrez notre cours pratique Vector Databases for Embeddings with Pinecone. Vous pouvez aussi essayer Weaviate, une base de données vectorielle open source en Python. Pour en savoir plus, regardez le webinar Vector Databases for Data Science with Weaviate in Python sur DataCamp.
