यदि आप एक डेटा वैज्ञानिक या डेटा विश्लेषक हैं जो SQL और MongoDB जैसी रिलेशनल और नॉन-रिलेशनल डेटाबेस से परिचित हैं, तो डेटा प्रबंधन की एक रोमांचक नई दुनिया में गोता लगाने के लिए तैयार हो जाएँ। इस ट्यूटोरियल में, आप वेक्टर डेटाबेस नामक एक नए प्रकार के डेटा स्टोर के बारे में सीखेंगे—यह एक विशेषीकृत डेटाबेस है जो वेक्टर डेटा को कुशलता से संभालने और प्रोसेस करने के लिए डिज़ाइन किया गया है। इस Pinecone ट्यूटोरियल में, हम विशेष रूप से Pinecone वेक्टर डेटाबेस प्लेटफ़ॉर्म पर नज़र डालेंगे।
Pinecone के बारे में अधिक जानने के लिए, हमारा कोर्स अवश्य देखें: Vector Databases for Embeddings with Pinecone।
Vector Database क्या है?
पारंपरिक डेटाबेस में डेटा आम तौर पर पंक्तियों और स्तंभों में संग्रहीत किया जाता है, जो संरचित डेटा के लिए उपयुक्त है। हालाँकि, जैसे-जैसे डेटासेट अधिक जटिल और उच्च-आयामी होते जाते हैं, एक अधिक विशेषीकृत समाधान की आवश्यकता होती है। यहीं वेक्टर डेटाबेस चमकते हैं। पारंपरिक डेटा संरचनाओं से निपटने के बजाय, वेक्टर डेटाबेस को वेक्टर—यानी बहुआयामी स्थानों में डेटा बिंदुओं के गणितीय निरूपण—को संभालने के लिए अनुकूलित किया गया है।
वेक्टर डेटा का व्यापक उपयोग मशीन लर्निंग, डेटा साइंस, कम्प्यूटेशनल बायोलॉजी और NLP सहित कई क्षेत्रों में होता है। ये संख्यात्मक विशेषताओं, निर्देशांक, एम्बेडिंग्स, टेक्स्ट, छवियाँ और बहुत कुछ का प्रतिनिधित्व कर सकते हैं। AI-चालित अनुप्रयोगों के उभार के साथ, वेक्टराइज़्ड डेटासेट को कुशलतापूर्वक संभालने की मांग बढ़ी है, और इसी संदर्भ में वेक्टर डेटाबेस एक अहम उपकरण बन गए हैं।
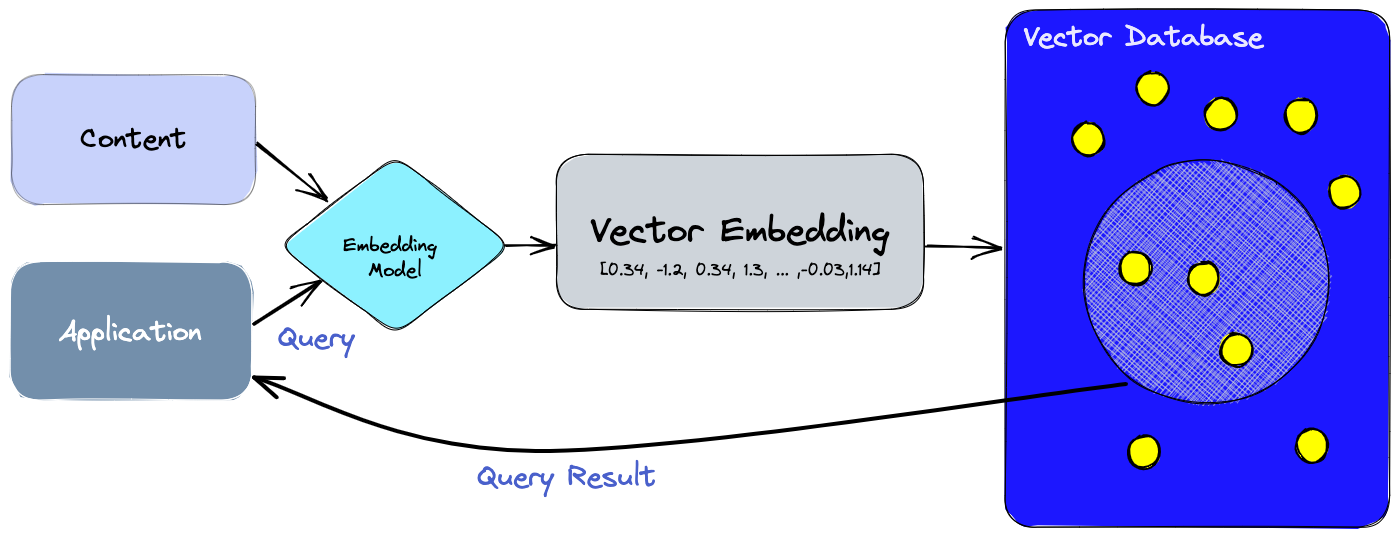
Pinecone क्या है?
Pinecone एक प्रबंधित वेक्टर डेटाबेस प्लेटफ़ॉर्म है जिसे उच्च-आयामी डेटा से जुड़ी विशिष्ट चुनौतियों से निपटने के लिए बनाया गया है। अत्याधुनिक इंडेक्सिंग और सर्च क्षमताओं से सुसज्जित, Pinecone डेटा इंजीनियरों और डेटा वैज्ञानिकों को बड़े पैमाने पर मशीन लर्निंग अनुप्रयोगों का निर्माण और कार्यान्वयन करने में सक्षम बनाता है जो उच्च-आयामी डेटा को प्रभावी ढंग से प्रोसेस और विश्लेषित करते हैं।
Pinecone की प्रमुख विशेषताएँ
आइए देखें कि Pinecone को इतना उपयोगी टूल क्या बनाता है:
पूर्णतः प्रबंधित सेवा
एक पूर्णतः प्रबंधित प्लेटफ़ॉर्म के रूप में, Pinecone इन्फ्रास्ट्रक्चर और रखरखाव से संबंधित हर चीज़ का प्रबंधन करता है। इससे डेवलपर्स अपने मशीन लर्निंग अनुप्रयोगों के विकास और परिनियोजन पर ध्यान केंद्रित कर सकते हैं, बिना इन्फ्रास्ट्रक्चर और ऑपरेशनल जटिलताओं की चिंता किए।
स्केलेबिलिटी
Pinecone असाधारण स्केलेबिलिटी प्रदर्शित करता है—यह अरबों उच्च-आयामी वेक्टर को सहजता से संभालता है और हॉरिज़ॉन्टल स्केलिंग की क्षमता प्रदान करता है। यह सबसे माँग वाले मशीन लर्निंग वर्कलोड्स को संभालने के लिए उपयुक्त बनाता है।
रियल-टाइम डेटा इनजेशन
Pinecone रियल-टाइम डेटा इनजेशन को सहजता से सपोर्ट करता है, जिससे उपयोगकर्ता नए डेटा के उपलब्ध होते ही उसे स्टोर और इंडेक्स कर सकते हैं, वह भी बिना किसी डाउनटाइम या व्यवधान के।
लो-लेटेंसी सर्च
परिष्कृत इंडेक्सिंग एल्गोरिद्म का लाभ उठाकर, Pinecone निकटतम पड़ोसी क्वेरीज़ और समानता खोज संचालन के लिए लो-लेटेंसी परिणाम प्राप्त करता है। यह समय-संवेदी अनुप्रयोगों के लिए तेज़ और सटीक नतीजे सुनिश्चित करता है।
सीमलेस इंटीग्रेशन
Pinecone का API सरलता और सहजता के लिए विचारपूर्वक डिज़ाइन किया गया है, जो मौजूदा मशीन लर्निंग वर्कफ़्लो और डेटा पाइपलाइनों के साथ एकीकरण प्रक्रिया को सरल बनाता है।
असंगठित डेटा और वेक्टर एम्बेडिंग्स को समझना
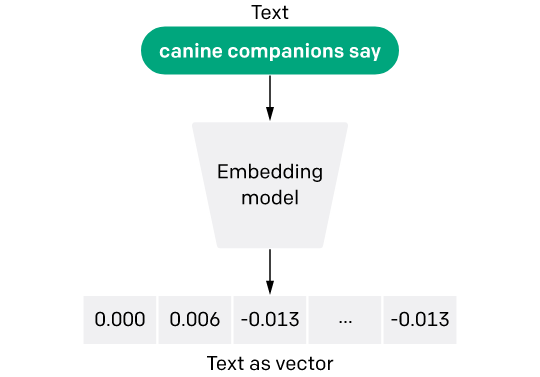
टेक्स्ट एम्बेडिंग मॉडल - छवि स्रोत
असंगठित डेटा वह डेटा है जिसका कोई पूर्वनिर्धारित या संगठित प्रारूप नहीं होता, जिसके कारण पारंपरिक डेटाबेस के लिए उसे कुशलता से स्टोर और प्रोसेस करना चुनौतीपूर्ण हो जाता है। असंगठित डेटा के उदाहरणों में टेक्स्ट, छवियाँ, ऑडियो और वीडियो फ़ाइलें शामिल हैं।
असंगठित डेटा में कठोर संरचना का अभाव होता है, जिससे उसे पारंपरिक विधियों से सीधे विश्लेषित करना कठिन हो जाता है। इसलिए मशीन लर्निंग और AI अनुप्रयोगों में असंगठित डेटा का उपयोग करने के लिए, उसे वेक्टर एम्बेडिंग्स का उपयोग करके बहुआयामी संख्यात्मक निरूपण में बदला और संग्रहीत किया जाता है।
एम्बेडिंग्स कृत्रिम बुद्धिमत्ता के क्षेत्र में अहम भूमिका निभाती हैं—ये शब्दों, छवियों या उपयोगकर्ता वरीयताओं जैसे उच्च-आयामी डेटा को कॉम्पैक्ट संख्यात्मक निरूपण में बदलने की एक शक्तिशाली तकनीक हैं। ये संख्यात्मक एम्बेडिंग्स AI मॉडलों को जटिल जानकारी को कुशलता से प्रोसेस और समझने में सक्षम बनाती हैं।
एम्बेडिंग्स को समझना तब आसान हो जाता है जब हम उन्हें किसी विशिष्ट कार्य के लिए एक विशेष शब्दकोश की तरह सोचते हैं। उदाहरण के लिए, टेक्स्ट माइनिंग प्रोजेक्ट्स में, एम्बेडिंग्स शब्दों के अन्य शब्दों से संबंधों का विश्लेषण करके उनके सैमान्यर्थ (semantic meaning) को समझने में मदद करती हैं। इस प्रक्रिया से एम्बेडिंग्स की एक सूची बनती है, जिसे कार्य-विशिष्ट शब्दकोश की तरह माना जा सकता है—जो शब्दों के अर्थ को दर्शाने वाले संख्यात्मक वेक्टर निरूपण प्रदान करती है। अलग-अलग शब्दों के बीच समानता और संबंध उनके संबंधित एम्बेडिंग्स के बीच की दूरी से मापे जाते हैं, जिससे AI मॉडल शब्दों के संदर्भ और महत्व को समझ पाते हैं।
एम्बेडिंग्स का महत्व इस बात में है कि वे डेटा की आयामीयता घटा देती हैं, जिससे मशीन लर्निंग मॉडल्स के लिए शब्दों या वस्तुओं का प्रतिनिधित्व करने वाले sparse वेक्टर जैसे बड़े इनपुट को संभालना आसान हो जाता है। एम्बेडिंग्स का उपयोग करके हम one-hot-encoding की सीमाओं से बच सकते हैं, जहाँ प्रत्येक श्रेणी को अलग डमी वैरिएबल में बदला जाता है—जो कुछ कार्यों में अत्यधिक बड़े इनपुट मैट्रिसेस का कारण बन सकता है।
यदि आप यह जानना चाहते हैं कि Word Embeddings कैसे काम करती हैं, तो हमारा ट्यूटोरियल LDA2vec: Word Embeddings in Topic Models देखें।
रिकैप:
- वेक्टर डेटाबेस एक विशेषीकृत डेटाबेस है जो वेक्टर डेटा को कुशलता से संभालने और प्रोसेस करने के लिए डिज़ाइन किया गया है
- Pinecone एक पूर्णतः प्रबंधित वेक्टर डेटाबेस सेवा है
- असंगठित डेटा वह डेटा है जिसका कोई पूर्वनिर्धारित या संगठित प्रारूप नहीं होता, जैसे छवियाँ, टेक्स्ट, ऑडियो या वीडियो
- एम्बेडिंग्स उच्च-आयामी डेटा को कॉम्पैक्ट संख्यात्मक निरूपण में बदलने की शक्तिशाली तकनीक है
Vector Database कैसे काम करता है?
आप पारंपरिक डेटाबेस के काम करने के तरीके से परिचित होंगे—जो स्ट्रिंग्स और नंबर्स जैसे स्केलर डेटा को पंक्तियों और स्तंभों में संग्रहीत करते हैं। हालाँकि, वेक्टर डेटाबेस अलग तरह से काम करते हैं—ये वेक्टर के साथ कार्य करते हैं और विशिष्ट ऑप्टिमाइज़ेशन व क्वेरींग विधियाँ अपनाते हैं।
पारंपरिक डेटाबेस में क्वेरीज़ आमतौर पर डेटाबेस में सटीक मिलान ढूँढती हैं। दूसरी ओर, वेक्टर डेटाबेस समानता मीट्रिक का उपयोग करके हमारे क्वेरी से सर्वाधिक मेल खाने वाले वेक्टर को ढूँढते हैं।
वेक्टर डेटाबेस एल्गोरिद्मों के संयोजन का उपयोग करते हैं, जिन्हें सामूहिक रूप से Approximate Nearest Neighbor (ANN) सर्च कहा जाता है। ये एल्गोरिद्म हैशिंग, क्वांटाइज़ेशन या ग्राफ-आधारित सर्च जैसी तकनीकों से खोज प्रक्रिया को अनुकूलित करते हैं।
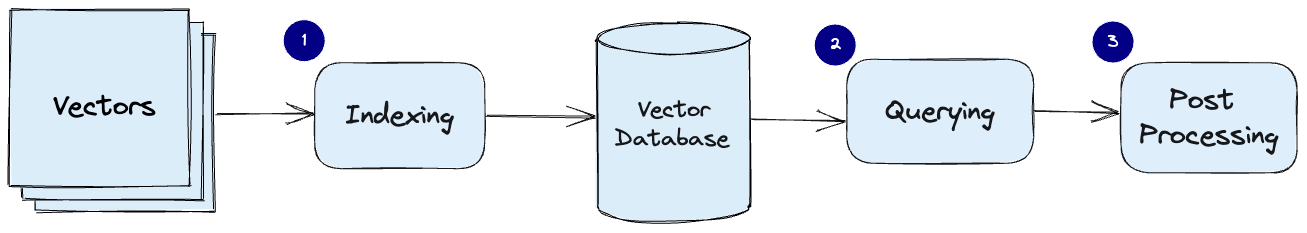
वेक्टर डेटाबेस के लिए सामान्य पाइपलाइन (छवि स्रोत)
OpenAI API का उपयोग करके टेक्स्ट एम्बेडिंग्स बनाना और फिर उन्हें Pinecone जैसे वेक्टर डेटाबेस में स्टोर करना सीखना चाहते हैं? टेक्स्ट वर्गीकरण, सूचना पुनर्प्राप्ति, और सैमान्य समानता पहचान में उनके अनुप्रयोगों की खोज करें DataCamp के Introduction to Text Embeddings with the OpenAI API ब्लॉग में।
Pinecone के साथ शुरुआत करना
शुरू करने के लिए, बस pinecone.io पर जाएँ और एक निःशुल्क खाता बनाएँ।
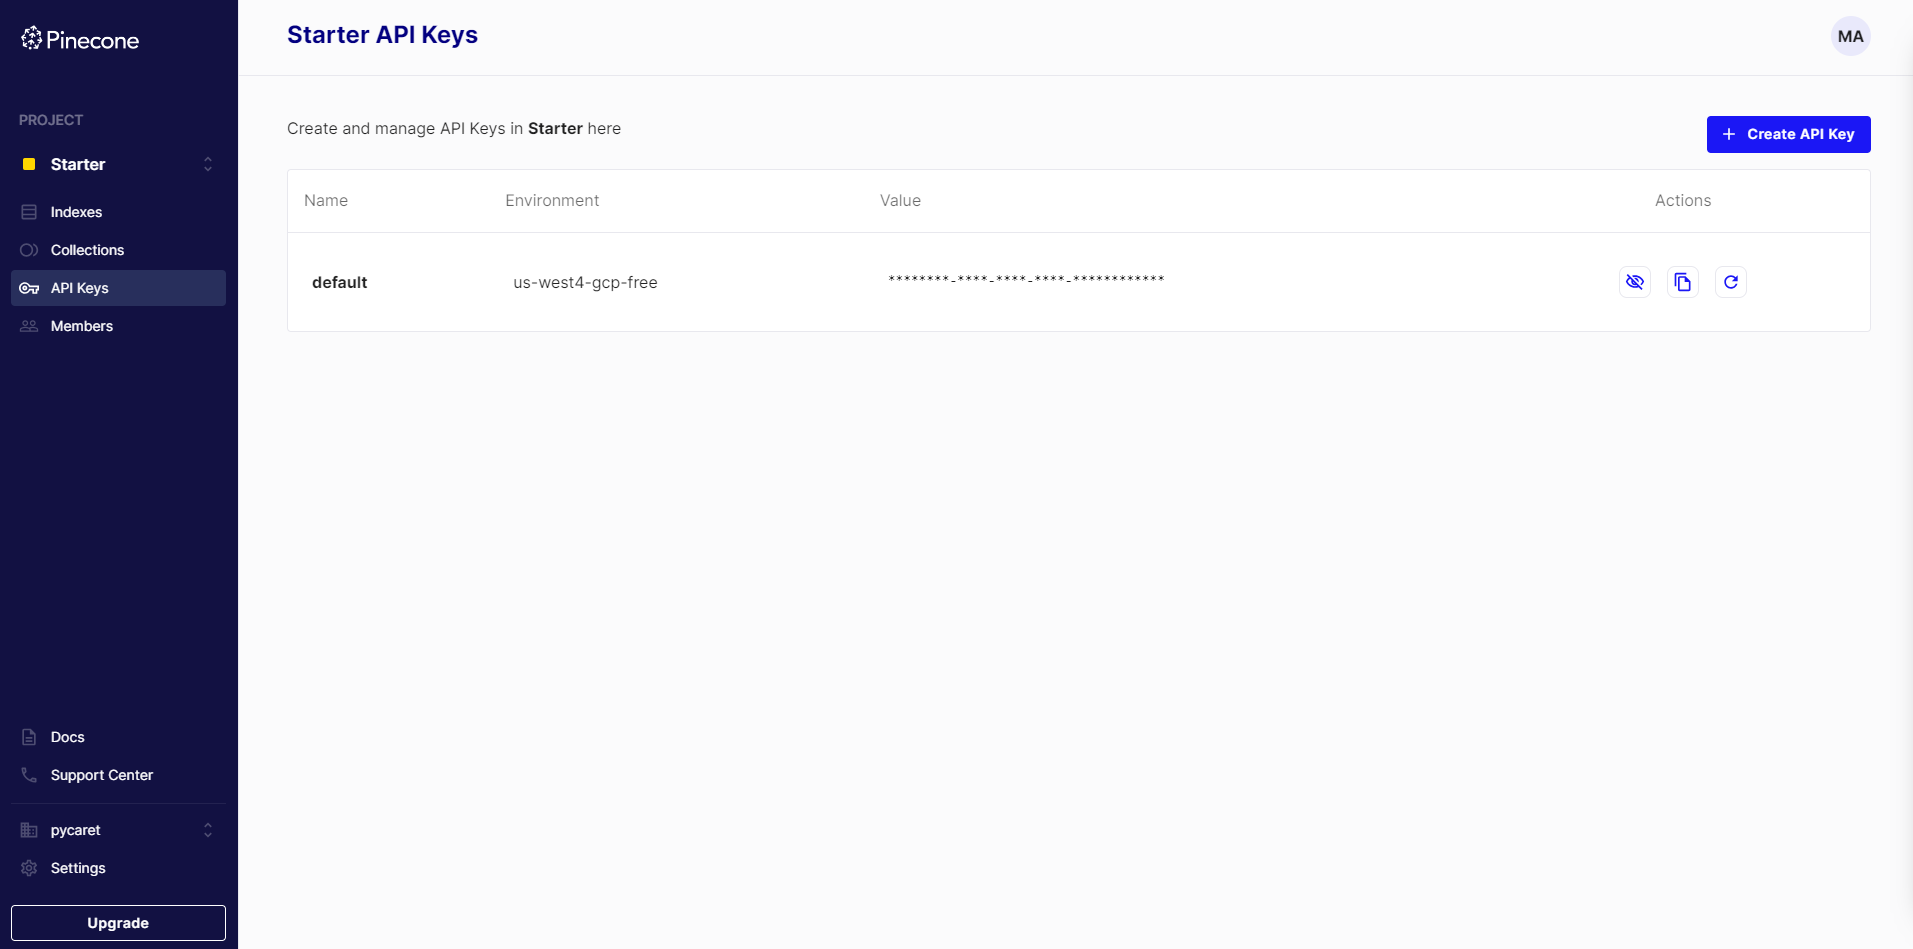
सफलतापूर्वक साइन अप करने के बाद, मेनू में API Keys पर क्लिक करें और अपना environment तथा API key कॉपी करें। यह Pinecone के Python क्लाइंट के साथ काम करते समय उपयोग होगी।
आप pip का उपयोग करके Pinecone का Python क्लाइंट भी इंस्टॉल कर सकते हैं।
pip install pinecone-clientPinecone में प्रमुख अवधारणाएँ
विस्तार में जाने से पहले, आइए कुछ प्रमुख शब्दों और अवधारणाओं को समझें जिन्हें आपको जानना चाहिए:
Pinecone इंडेक्स
Pinecone में, इंडेक्स वेक्टर डेटा के लिए शीर्ष-स्तरीय संगठनात्मक संरचना का प्रतिनिधित्व करता है। यह वेक्टर प्राप्त करने और संग्रहीत करने, संग्रहीत वेक्टर पर क्वेरी संभालने और अपने डेटा के भीतर विभिन्न वेक्टर ऑपरेशनों को निष्पादित करने के लिए जिम्मेदार होता है। प्रत्येक इंडेक्स कुशल कार्यक्षमता सुनिश्चित करने के लिए एक या अधिक pods पर चलता है।
Pods
Pods पूर्व-कॉन्फ़िगर हार्डवेयर यूनिट्स हैं जो Pinecone सेवाओं की होस्टिंग करती हैं। Pinecone में प्रत्येक इंडेक्स एक या एकाधिक pods पर चलता है, और अधिक pods होने से आमतौर पर स्टोरेज क्षमता बढ़ती है, लेटेंसी घटती है और थ्रूपुट बेहतर होता है। इसके अलावा, उपयोगकर्ता विशिष्ट आवश्यकताओं को पूरा करने के लिए अलग-अलग आकार के pods बना सकते हैं।
Distance Metrics
Distance Metrics वे गणितीय तकनीकें हैं जिनका उपयोग वेक्टर स्पेस में दो वेक्टरों के बीच समानता का आकलन करने के लिए किया जाता है। वेक्टर डेटाबेस में, ये मापदंड संग्रहीत वेक्टरों की तुलना किसी दिए गए क्वेरी वेक्टर से करने और सबसे समान वेक्टरों की पहचान करने में महत्वपूर्ण भूमिका निभाते हैं।
वेक्टर इंडेक्स बनाते समय आप विभिन्न मीट्रिक में से चुन सकते हैं:
- Cosine similarity. यह माप वेक्टर स्पेस में दो वेक्टरों के बीच कोण के कोसाइन का मूल्यांकन करता है। इसका पैमाना -1 से 1 तक होता है, जहाँ 1 समान वेक्टर, 0 लम्बवत (orthogonal) वेक्टर और -1 पूर्णतः विपरीत दिशा वाले वेक्टर को दर्शाता है।
- Euclidean distance. यह माप वेक्टर स्पेस में दो वेक्टरों के बीच सीधी रेखा की दूरी की गणना करता है। इसका मान 0 से अनंत तक होता है—0 समान वेक्टरों को और बड़े मान बढ़ती असमानता को दर्शाते हैं।
- Dot product. यह माप दो वेक्टरों के परिमाणों और उनके बीच कोण के कोसाइन के गुणनफल की गणना करता है। इसका पैमाना -∞ से ∞ तक फैला होता है—धनात्मक मान समान दिशा, 0 लम्बवत और ऋणात्मक मान विपरीत दिशा की ओर संकेत करते हैं।
Pinecone API key को कैसे सत्यापित करें
Python से Pinecone का उपयोग करने के लिए API key आवश्यक है। आप Pinecone कंसोल खोलकर और "API Keys" चुनकर अपनी API key ढूँढ सकते हैं। इसी दृश्य में आप अपने प्रोजेक्ट से संबद्ध environment की जानकारी भी पा सकते हैं।
import pinecone
pinecone.init(api_key="API_KEY", environment = 'ENVIRONMENT')
Pinecone इंडेक्स कैसे बनाएँ
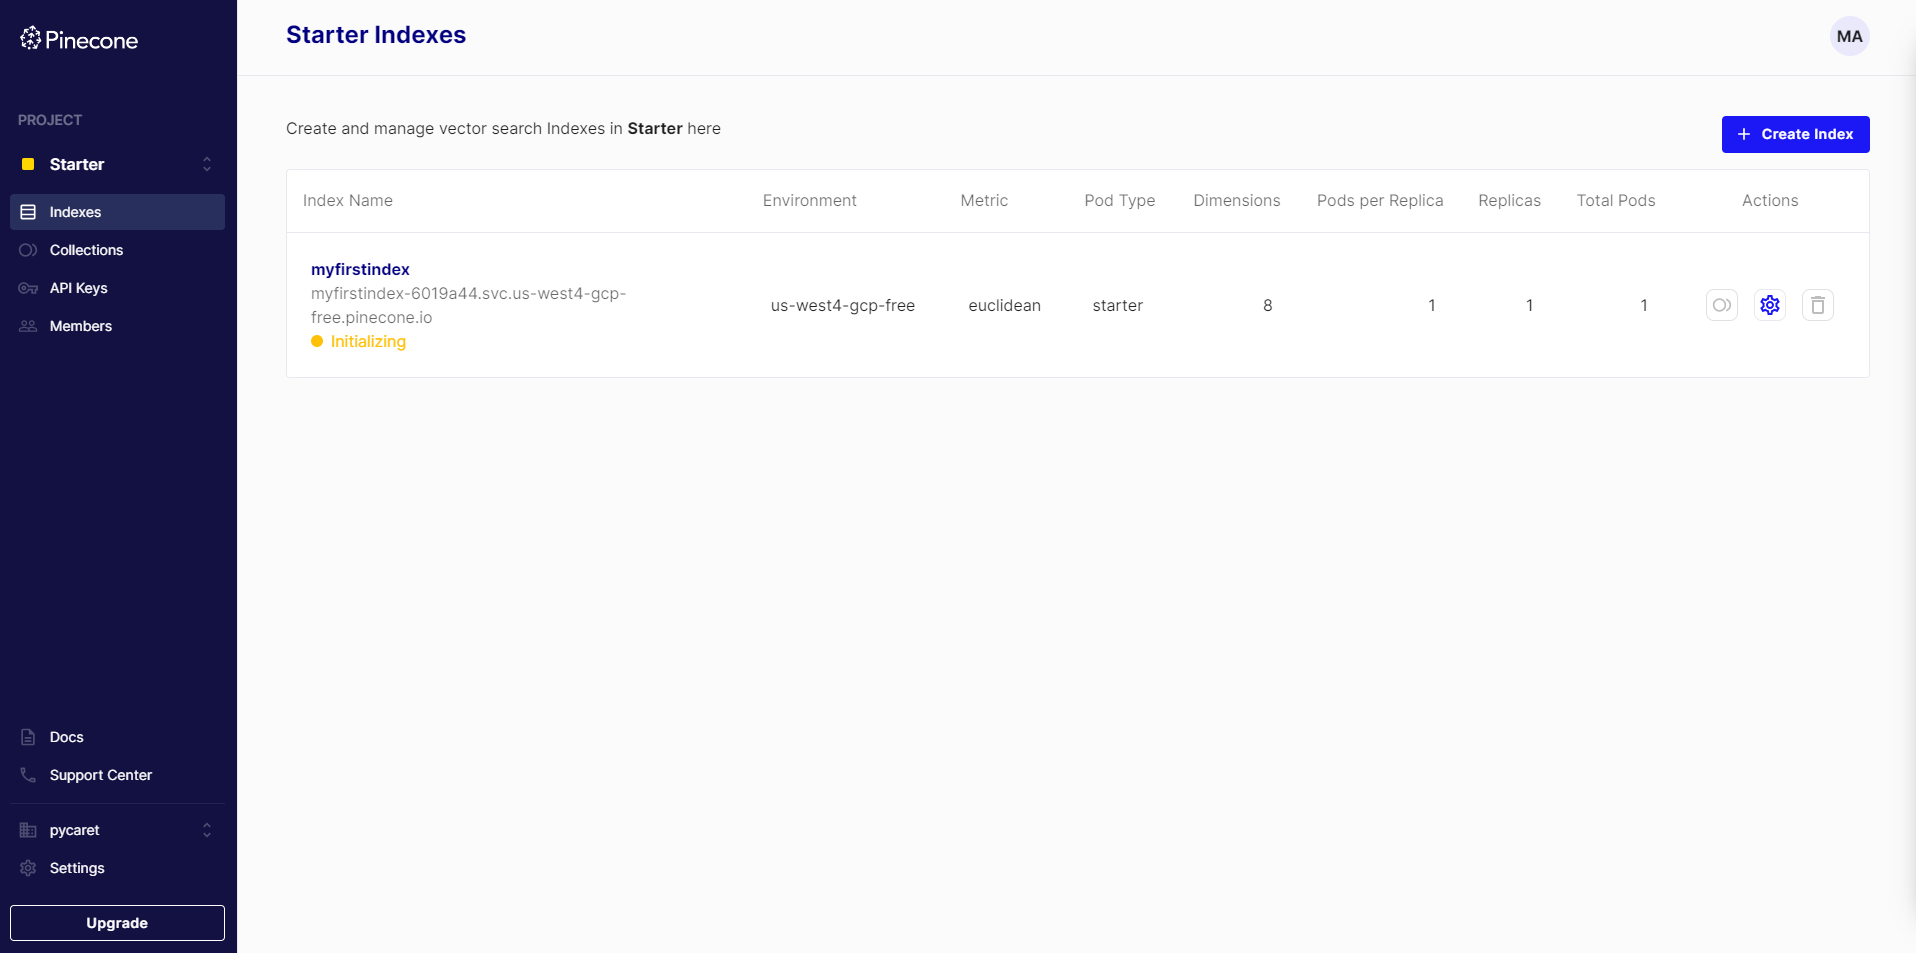
Pinecone में इंडेक्स बनाने के लिए, बस यह चलाएँ:
pinecone.create_index("myfirstindex", dimension=8, metric="euclidean")जैसे ही आप यह कमांड चलाएँगे, आप अपने कंसोल में एक Pinecone इंडेक्स को इनिशियलाइज़ होते हुए देखेंगे:
Pinecone में डेटा डालना और क्वेरी करना
इंडेक्स में वेक्टर जोड़ने के लिए upsert ऑपरेशन का उपयोग किया जा सकता है। upsert ऑपरेशन या तो इंडेक्स में नया वेक्टर जोड़ता है या यदि वही ID वाला वेक्टर पहले से मौजूद है तो उसे अपडेट करता है। निम्नलिखित कमांड्स का उपयोग करके, आप अपने इंडेक्स में पाँच 8-आयामी वेक्टर upsert कर सकते हैं।
index = pinecone.Index("myfirstindex")

index.upsert([
    ("A", [0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1]),
    ("B", [0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2]),
    ("C", [0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3]),
    ("D", [0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4]),
    ("E", [0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5])
])
यदि आप कंसोल पर जाएँगे, तो आपको वे पाँच वेक्टर दिखेंगे जिन्हें हमने अभी जोड़ा है।
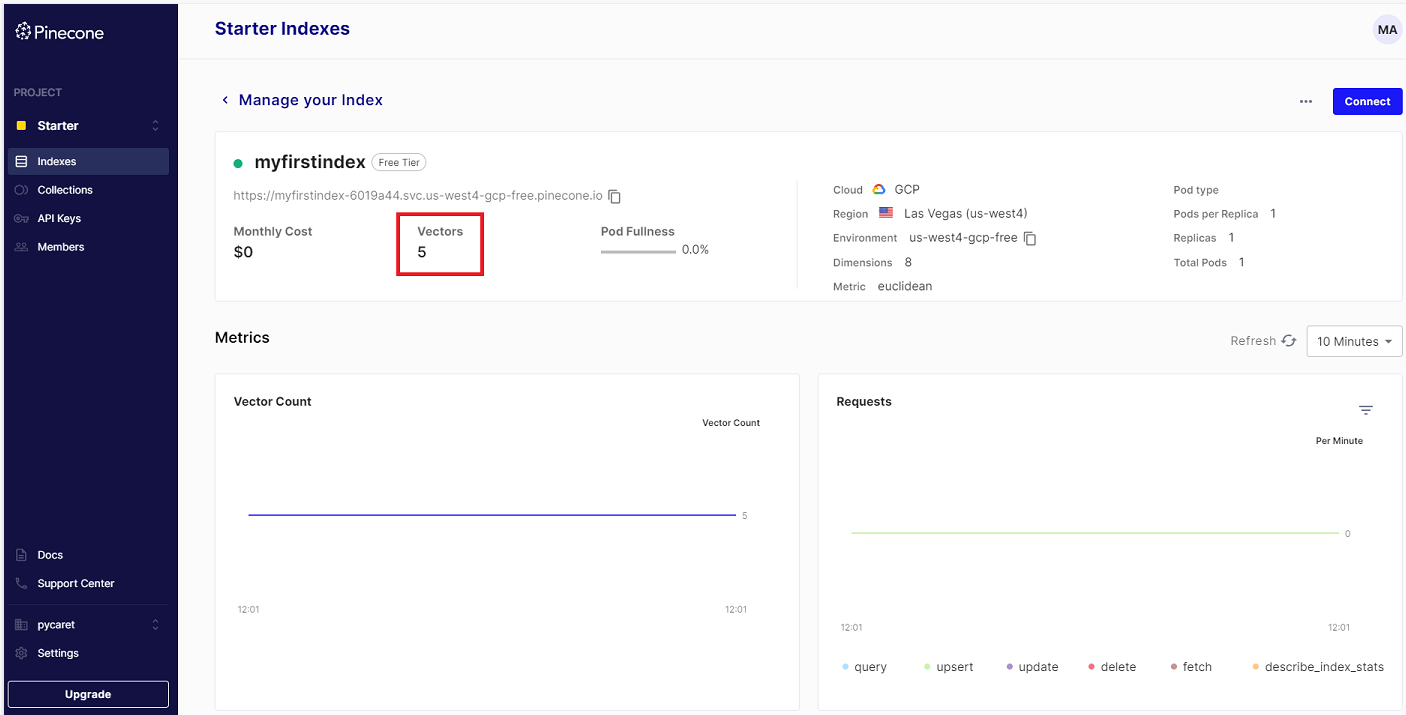
वेक्टर के dimension की जाँच करने के लिए, आप यह चला सकते हैं:
index.describe_index_stats()
>>> {'dimension': 8,
>>>  'index_fullness': 0.0,
>>>  'namespaces': {'': {'vector_count': 5}},
>>>  'total_vector_count': 5}
Pinecone में इंडेक्स को क्वेरी करके समान वेक्टर कैसे प्राप्त करें
नीचे दिए गए उदाहरण में, इंडेक्स से शीर्ष तीन (3) वेक्टर प्राप्त किए जाते हैं जो एक नमूना 8-आयामी वेक्टर के साथ सर्वाधिक समानता प्रदर्शित करते हैं। क्वेरी उस Euclidean distance मीट्रिक का उपयोग करती है जिसे इंडेक्स बनाते समय निर्दिष्ट किया गया था।
index.query(
  vector=[0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3],
  top_k=3,
  include_values=True
)
>>> {'matches': [{'id': 'C',
>>> 'score': 0.0,
>>> 'values': [0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3]},
>>> {'id': 'D',
>>> 'score': 0.0799999237,
>>> 'values': [0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4]},
>>> {'id': 'B',
>>> 'score': 0.0800000429,
>>> 'values': [0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2]}],
>>> 'namespace': ''}
Pinecone में इंडेक्स हटाना
जब इंडेक्स की आवश्यकता न रहे, तो आप delete_index ऑपरेशन का उपयोग करके इंडेक्स हटा सकते हैं।
pinecone.delete_index("myfirstindex")निष्कर्ष
इस ट्यूटोरियल ने वेक्टर डेटाबेस और Pinecone की दुनिया पर प्रकाश डाला है। वेक्टर डेटाबेस उच्च-आयामी डेटा को कुशलता से संभालने के लिए एक विशेषीकृत समाधान प्रदान करते हैं, जिसका महत्व मशीन लर्निंग, डेटा साइंस और AI-चालित अनुप्रयोगों के क्षेत्र में लगातार बढ़ रहा है।
एक प्रबंधित वेक्टर डेटाबेस प्लेटफ़ॉर्म के रूप में, Pinecone डेटा इंजीनियरों और वैज्ञानिकों के लिए एक सशक्त टूल के रूप में उभरता है—जो स्केलेबिलिटी, लो-लेटेंसी सर्च क्षमताएँ और रियल-टाइम डेटा इनजेशन प्रदान करता है। इसके सीमलेस इंटीग्रेशन और उपयोगकर्ता-अनुकूल API के साथ, Pinecone बड़े पैमाने के मशीन लर्निंग अनुप्रयोगों के निर्माण और परिनियोजन की प्रक्रिया को सुगम बनाता है।
ट्यूटोरियल ने असंगठित डेटा की अवधारणा और यह भी समझाया कि ऐसी जानकारी को विश्लेषण हेतु कॉम्पैक्ट संख्यात्मक निरूपण में बदलने में वेक्टर एम्बेडिंग्स कैसे महत्वपूर्ण भूमिका निभाती हैं।
यदि आप वेक्टर डेटाबेस के विचार से आकर्षित हैं और आपको लगता है कि इसका कोई उपयोग-केस आपके पास है, तो हमारा हैंड्स-ऑन कोर्स देखें: Vector Databases for Embeddings with Pinecone। आप Weaviate—Python में एक ओपन-सोर्स वेक्टर डेटाबेस—भी आज़मा सकते हैं। इसके बारे में और जानना चाहते हैं तो Datacamp पर Vector Databases for Data Science with Weaviate in Python वेबिनार देखें।
