Als je een dataspecialist of data-analist bent die bekend is met relationele en niet-relationele databases zoals SQL en MongoDB, maak je dan klaar om een spannende nieuwe wereld van databeheer te verkennen. In deze tutorial leer je over een nieuw type datastore: vector-databases, een gespecialiseerd soort database dat is ontworpen om vectordata efficiënt te verwerken. In deze Pinecone-tutorial kijken we specifiek naar het Pinecone-platform voor vector-databases.
Wil je meer leren over Pinecone? Bekijk dan zeker onze cursus Vector Databases for Embeddings with Pinecone.
Wat is een vector-database?
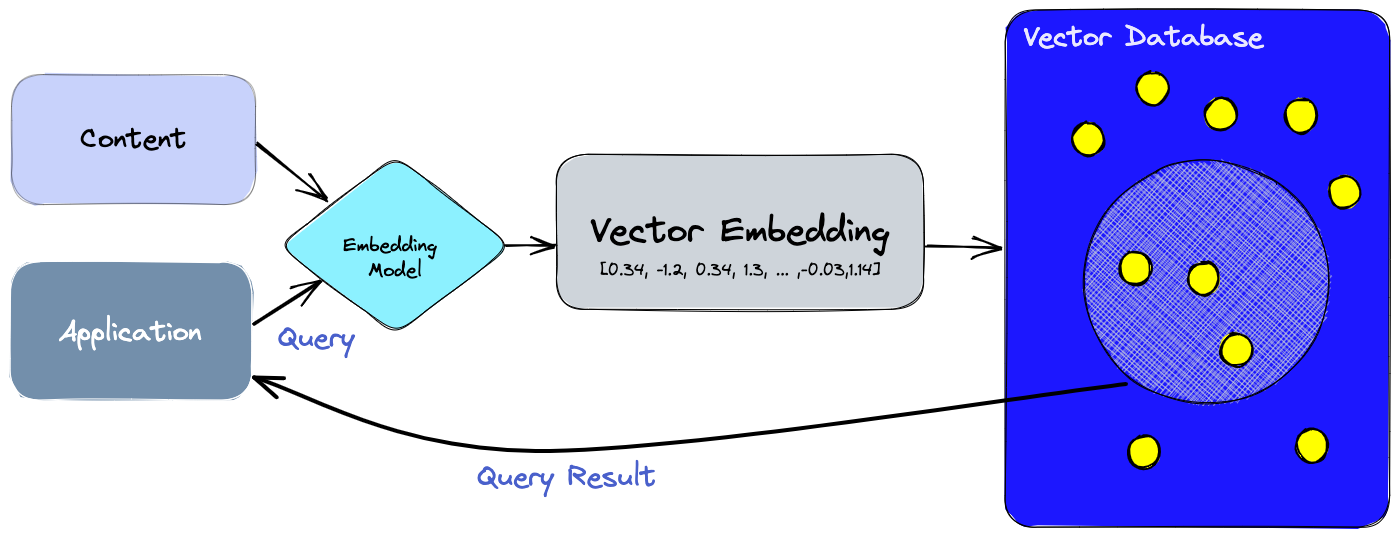
In traditionele databases wordt data meestal opgeslagen in rijen en kolommen, geschikt voor gestructureerde data. Naarmate datasets echter complexer en hoger-dimensionaal worden, ontstaat de behoefte aan een meer gespecialiseerde oplossing. Daar komen vector-databases tot hun recht. In plaats van met traditionele datastructuren te werken, zijn vector-databases geoptimaliseerd om met vectoren om te gaan: wiskundige representaties van datapunten in multidimensionale ruimtes.
Vectordata wordt veel gebruikt in uiteenlopende velden, waaronder machine learning, data science, computationele biologie en NLP. Ze kunnen numerieke features, coördinaten, embeddings, tekst, afbeeldingen en nog veel meer representeren. Met de opkomst van AI-gedreven toepassingen is de vraag naar efficiënte verwerking van gevectoriseerde datasets sterk toegenomen, en vector-databases zijn in deze context een cruciaal hulpmiddel geworden.
Wat is Pinecone?
Pinecone is een beheerd platform voor vector-databases dat speciaal is gebouwd om de unieke uitdagingen van hoge-dimensionale data aan te pakken. Met geavanceerde indexerings- en zoekmogelijkheden stelt Pinecone data engineers en data scientists in staat grootschalige machinelearning-toepassingen te bouwen en te implementeren die hoge-dimensionale data effectief verwerken en analyseren.
Belangrijkste features van Pinecone
Laten we bekijken wat Pinecone zo'n handig hulpmiddel maakt:
Volledig beheerde service
Als volledig beheerd platform regelt Pinecone alles rond infrastructuur en onderhoud. Hierdoor kunnen ontwikkelaars zich richten op de ontwikkeling en uitrol van hun machinelearning-toepassingen zonder zich zorgen te maken over infrastructuur en operationele complexiteit.
Schaalbaarheid
Pinecone is uitzonderlijk schaalbaar, beheert moeiteloos miljarden hoge-dimensionale vectoren en biedt horizontale schaalmogelijkheden. Daardoor is het zeer geschikt voor de meest veeleisende machinelearning-workloads.
Realtime data-ingestie
Pinecone ondersteunt naadloos realtime data-ingestie, zodat je nieuwe data kunt opslaan en indexeren zodra die beschikbaar komt, zonder downtime of onderbrekingen.
Zoeken met lage latency
Door geavanceerde indexeringsalgoritmen te gebruiken, levert Pinecone zoekresultaten met lage latency voor nearest-neighborqueries en gelijkeniszoekopdrachten. Dit zorgt voor snelle en precieze uitkomsten voor tijdkritische toepassingen.
Naadloze integratie
De API van Pinecone is bewust simpel en intuïtief ontworpen, wat de integratie met bestaande machinelearning-workflows en datapijplijnen vereenvoudigt.
On gestructureerde data en vector-embeddings begrijpen
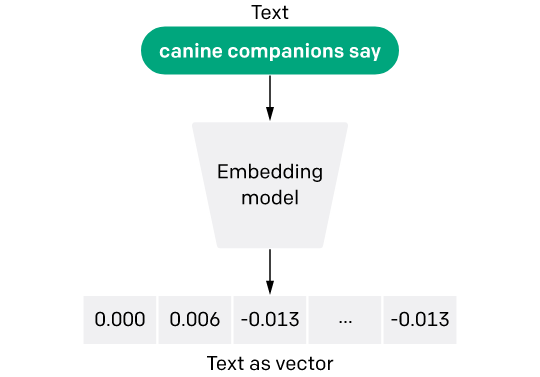
Tekst-embeddingmodel - Beeldbron
Ongestructureerde data is data zonder vooraf gedefinieerde of georganiseerde opmaak, waardoor traditionele databases die niet efficiënt kunnen opslaan en verwerken. Voorbeelden zijn tekst, afbeeldingen, audio en videobestanden.
Omdat ongestructureerde data geen starre structuur heeft, is die lastig direct te analyseren met traditionele methoden. Om ongestructureerde data te kunnen gebruiken voor machinelearning- en AI-toepassingen, wordt die daarom getransformeerd en opgeslagen als een multidimensionale numerieke representatie met behulp van vector-embeddings.
Embeddings spelen een sleutelrol binnen kunstmatige intelligentie. Ze vormen een krachtige techniek om hoge-dimensionale data, zoals woorden, afbeeldingen of gebruikersvoorkeuren, om te zetten in compacte numerieke representaties. Deze numerieke embeddings stellen AI-modellen in staat complexe informatie efficiënt te verwerken en te begrijpen.
Embeddings worden begrijpelijker als je ze ziet als een gespecialiseerd woordenboek voor een bepaalde taak. In tekstminingprojecten helpen embeddings bijvoorbeeld de semantische betekenis van woorden te vatten door hun relaties met andere woorden te analyseren. Dit proces levert een lijst met embeddings op, die je kunt zien als een taakspecifiek woordenboek met numerieke vectorrepresentaties die de semantische betekenis van woorden weerspiegelen. De overeenkomst en relatie tussen verschillende woorden wordt gemeten aan de hand van de afstand tussen hun overeenkomstige embeddings, waardoor AI-modellen de context en betekenis van woorden kunnen begrijpen.
Het belang van embeddings ligt in hun vermogen om de dimensionaliteit van data te reduceren, zodat machinelearning-modellen grote input, zoals spaarzame vectoren die woorden of items representeren, beter aankunnen. Met embeddings vermijden we de beperkingen van one-hot-encoding, waarbij elke categorie wordt omgezet in een aparte dummyvariabele, wat voor bepaalde taken kan leiden tot extreem grote inputmatrices.
Wil je meer leren over hoe word embeddings werken? Bekijk dan onze tutorial LDA2vec: Word Embeddings in Topic Models.
Samenvatting:
- Een vector-database is een gespecialiseerd type database dat vectordata efficiënt kan verwerken
- Pinecone is een volledig beheerde service voor vector-databases
- Ongestructureerde data is data zonder vooraf gedefinieerde of georganiseerde opmaak, zoals afbeeldingen, tekst, audio of video
- Embeddings zijn een krachtige techniek om hoge-dimensionale data om te zetten in compacte numerieke representaties
Hoe werkt een vector-database?
Je kent vast de werking van traditionele databases, die skalare data zoals strings en getallen opslaan in rijen en kolommen. Vector-databases werken echter anders: ze werken met vectoren en gebruiken andere manieren om te optimaliseren en te bevragen.
In traditionele databases zoeken queries meestal naar exacte overeenkomsten in de database. Vector-databases gebruiken daarentegen een gelijkenismetriek om de vector te vinden die het best bij onze query past.
Vector-databases gebruiken een combinatie van algoritmen, samen bekend als Approximate Nearest Neighbor (ANN)-zoektocht. Deze algoritmen optimaliseren het zoekproces via technieken zoals hashing, kwantisatie of graafgebaseerd zoeken.
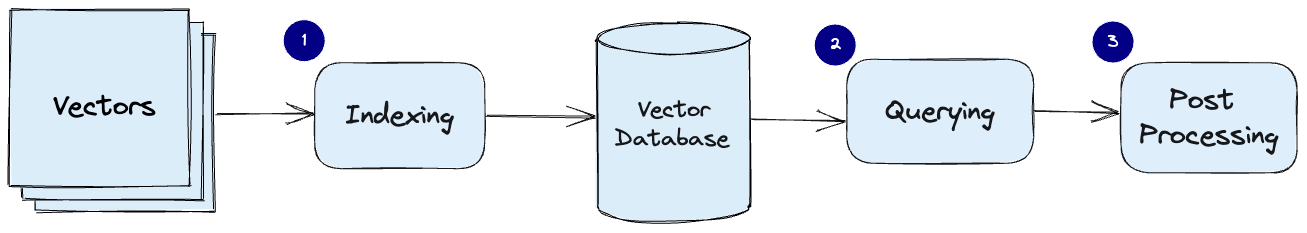
Algemene pijplijn voor een vector-database (Beeldbron)
Wil je leren hoe je de OpenAI API gebruikt om tekst-embeddings te maken en die vervolgens in een vector-database zoals Pinecone op te slaan? Ontdek hun toepassingen in tekstclassificatie, information retrieval en semantische gelijkenis in de Introduction to Text Embeddings with the OpenAI API-blog op DataCamp.
Aan de slag met Pinecone
Ga om te beginnen naar pinecone.io en maak een gratis account aan.
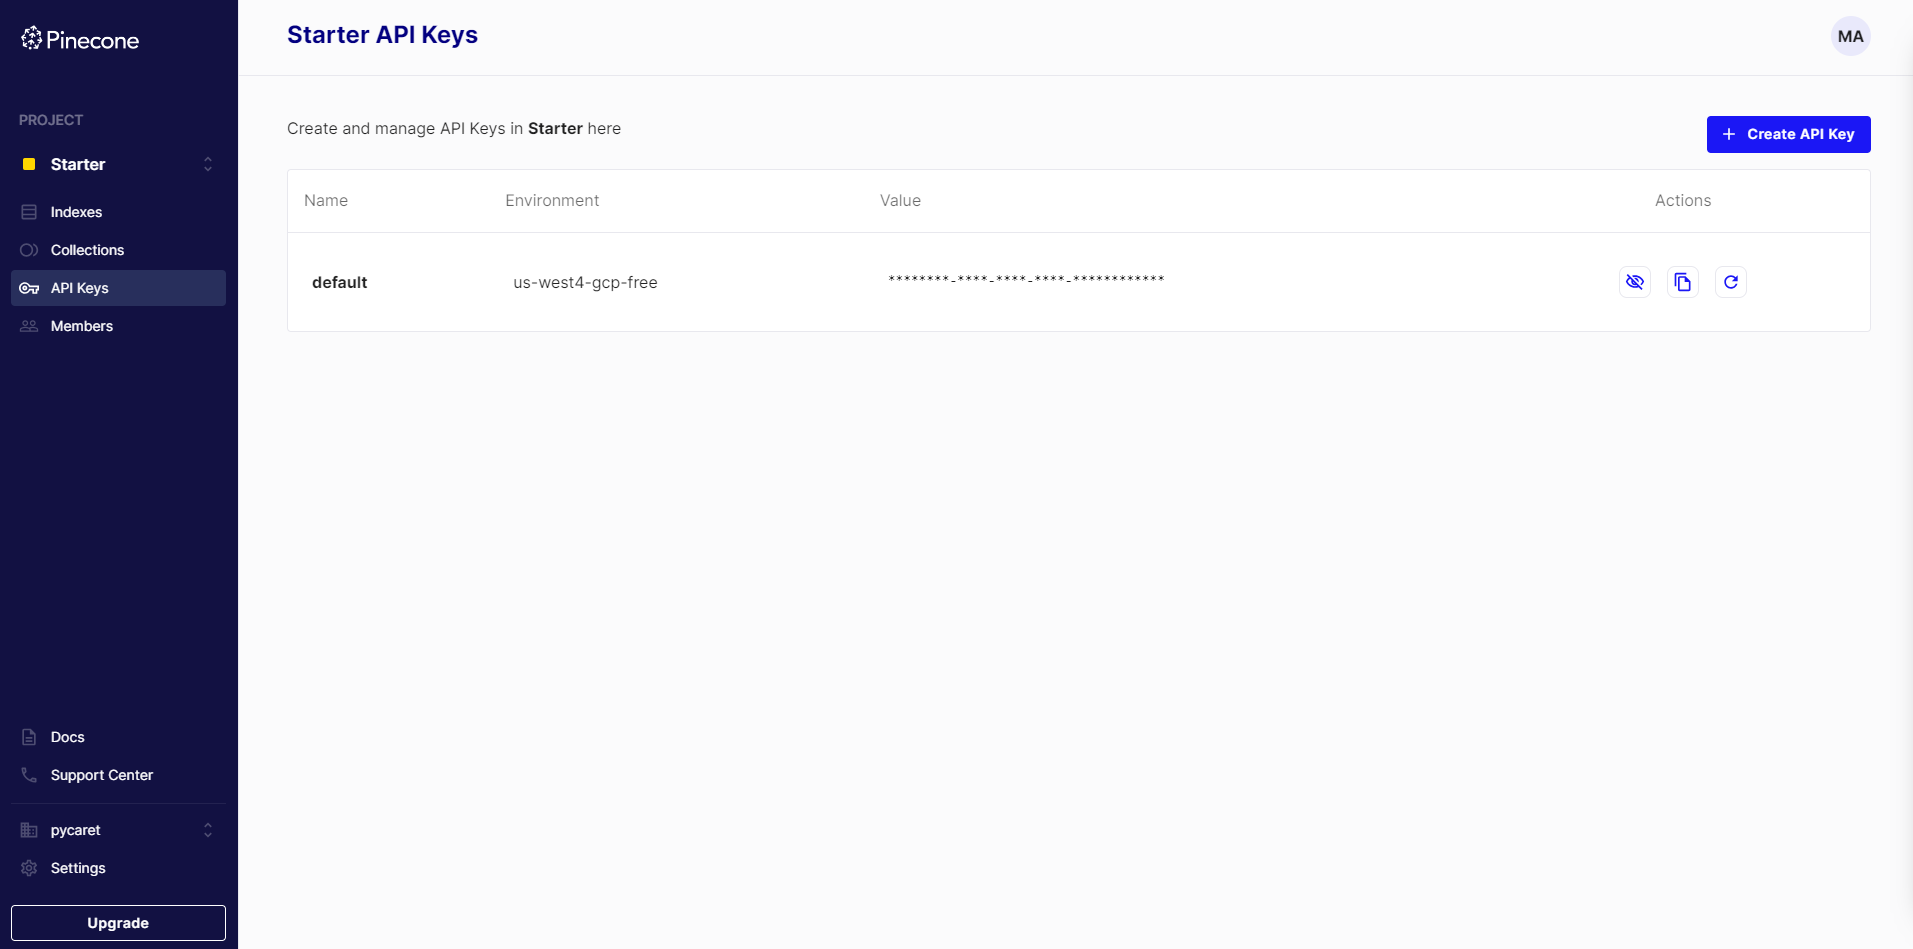
Zodra je je succesvol hebt aangemeld, klik je in het menu op API Keys en kopieer je je environment en API-sleutel. Die gebruik je bij het werken met de Python-client van Pinecone.
Je kunt de Python-client voor Pinecone ook installeren met pip.
pip install pinecone-clientKernbegrippen in Pinecone
Voordat we de diepte ingaan, verkennen we eerst een paar belangrijke termen en concepten die je moet kennen:
Pinecone-index
In Pinecone vertegenwoordigt een index de bovenste organisatielaag voor vectordata. Die ontvangt en bewaart vectoren, verwerkt queries op de opgeslagen vectoren en voert verschillende vectorbewerkingen uit binnen zijn data. Elke index draait op een of meer pods om efficiënt te kunnen functioneren.
Pods
Pods zijn vooraf geconfigureerde hardware-eenheden die Pinecone-services hosten. Elke index in Pinecone draait op één of meerdere pods; extra pods leveren doorgaans meer opslagcapaciteit, lagere latency en hogere throughput op. Bovendien kunnen gebruikers pods in verschillende groottes aanmaken om aan specifieke eisen te voldoen.
Afstandsmetriek
Afstandsmetriek zijn wiskundige technieken om de gelijkenis tussen twee vectoren binnen een vectorruimte te beoordelen. In vector-databases spelen deze maten een cruciale rol bij het vergelijken van de opgeslagen vectoren met een gegeven queryvector om de meest vergelijkbare te identificeren.
Je kunt uit verschillende metriek kiezen wanneer je een vectorindex maakt:
- Cosine similarity. Deze maat evalueert de cosinus van de hoek tussen twee vectoren in de vectorruimte. De schaal loopt van -1 tot 1, waarbij 1 identieke vectoren aangeeft, 0 orthogonale vectoren en -1 tegengesteld gerichte vectoren.
- Euclidische afstand. Deze maat berekent de kortste afstand tussen twee vectoren in de vectorruimte. De schaal loopt van 0 tot oneindig, waarbij 0 identieke vectoren aanduidt en grotere waarden toenemende ongelijkheid.
- Inproduct (dot product). Deze maat berekent het product van de lengtes van twee vectoren en de cosinus van de hoek ertussen. De schaal loopt van -∞ tot ∞, waarbij positieve waarden vectoren aanduiden die in dezelfde richting wijzen, 0 orthogonale vectoren en negatieve waarden tegengesteld gerichte vectoren.
Pinecone API-sleutel verifiëren
Om Pinecone vanuit Python te gebruiken is een API-sleutel nodig. Je vindt je API-sleutel in de Pinecone-console onder "API Keys". In hetzelfde scherm vind je ook informatie over de omgeving die aan je project is gekoppeld.
import pinecone
pinecone.init(api_key="API_KEY", environment = 'ENVIRONMENT')
Een Pinecone-index maken
Om een index in Pinecone te maken, voer je simpelweg uit:
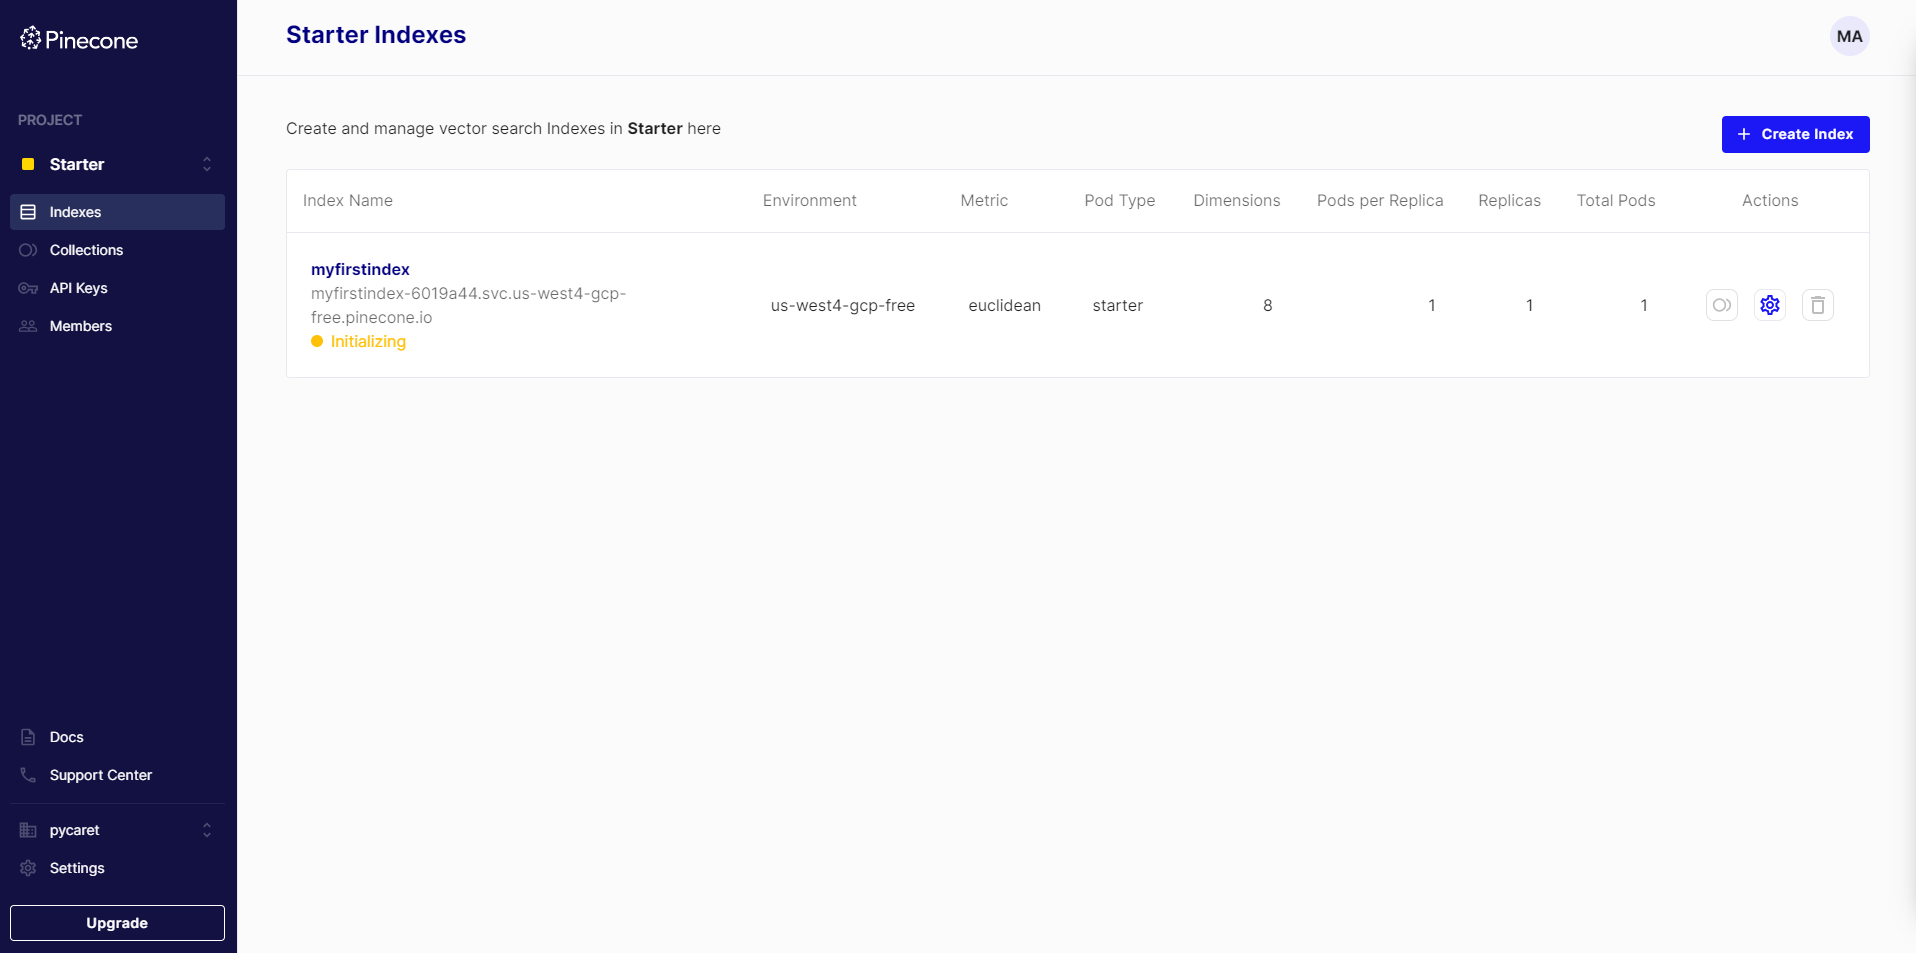
pinecone.create_index("myfirstindex", dimension=8, metric="euclidean")Zodra je dit commando uitvoert, zie je in je console dat er een Pinecone-index wordt geïnitialiseerd:
Data invoegen en bevragen in Pinecone
Om vectoren aan de index toe te voegen, kun je de bewerking upsert gebruiken. Upsert voegt óf een nieuwe vector toe aan de index, óf werkt een bestaande vector bij als er al een vector met dezelfde ID bestaat. Met de volgende opdrachten kun je vijf 8-dimensionale vectoren upserten in je index.
index = pinecone.Index("myfirstindex")

index.upsert([
    ("A", [0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1]),
    ("B", [0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2]),
    ("C", [0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3]),
    ("D", [0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4]),
    ("E", [0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5])
])
Als je naar de console gaat, zie je de vijf vectoren die we zojuist hebben toegevoegd.
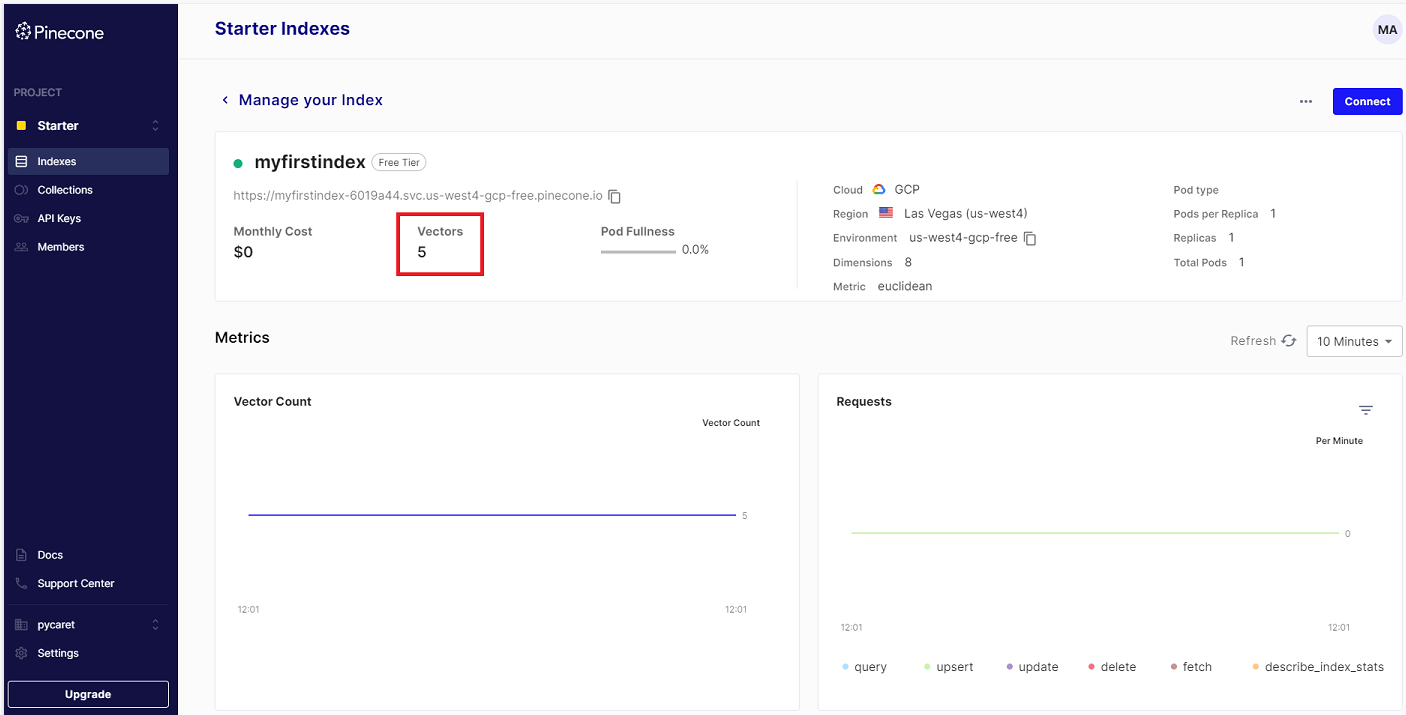
Om de dimensie van de vector te controleren, kun je het volgende uitvoeren:
index.describe_index_stats()
>>> {'dimension': 8,
>>>  'index_fullness': 0.0,
>>>  'namespaces': {'': {'vector_count': 5}},
>>>  'total_vector_count': 5}
De index bevragen en vergelijkbare vectoren ophalen in Pinecone
In onderstaand voorbeeld wordt de index bevraagd om de top drie (3) vectoren op te halen die de hoogste gelijkenis vertonen met een voorbeeldvector van 8 dimensies. De query gebruikt de Euclidische-afstandsmetriek zoals opgegeven bij het aanmaken van de index.
index.query(
  vector=[0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3],
  top_k=3,
  include_values=True
)
>>> {'matches': [{'id': 'C',
>>> 'score': 0.0,
>>> 'values': [0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3]},
>>> {'id': 'D',
>>> 'score': 0.0799999237,
>>> 'values': [0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4]},
>>> {'id': 'B',
>>> 'score': 0.0800000429,
>>> 'values': [0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2]}],
>>> 'namespace': ''}
Indexen verwijderen in Pinecone
Als je de index niet meer nodig hebt, kun je de bewerking delete_index gebruiken om de index te verwijderen.
pinecone.delete_index("myfirstindex")Conclusie
Deze tutorial gaf inzicht in de wereld van vector-databases en Pinecone. Vector-databases bieden een gespecialiseerde oplossing om hoge-dimensionale data efficiënt te verwerken, wat steeds belangrijker wordt binnen machine learning, data science en AI-gedreven toepassingen.
Pinecone, als beheerd platform voor vector-databases, springt eruit als een krachtig hulpmiddel voor data engineers en -wetenschappers, met schaalbaarheid, zoeken met lage latency en realtime data-ingestie. Dankzij de naadloze integratie en gebruiksvriendelijke API versnelt Pinecone het bouwen en uitrollen van grootschalige machinelearning-toepassingen.
De tutorial ging ook in op het concept van ongestructureerde data en hoe vector-embeddings een essentiële rol spelen bij het omzetten van zulke data in compacte numerieke representaties voor analyse.
Ben je gefascineerd door het idee van vector-databases en denk je dat je er een usecase voor hebt? Bekijk dan onze praktijkgerichte cursus Vector Databases for Embeddings with Pinecone. Je kunt ook Weaviate proberen - een open-source vector-database in Python. Wil je hier meer over leren? Bekijk dan het webinar Vector Databases for Data Science with Weaviate in Python op Datacamp.


