Se sei un data scientist o un data analyst che conosce database relazionali e non relazionali come SQL e MongoDB, preparati a entrare in un nuovo e interessante mondo della gestione dei dati. In questo tutorial imparerai un nuovo tipo di data store chiamato database vettoriali, un tipo di database specializzato progettato per gestire ed elaborare i dati vettoriali in modo efficiente. In questo tutorial su Pinecone, vedremo nello specifico la piattaforma di database vettoriale Pinecone.
Per saperne di più su Pinecone, dai un'occhiata al nostro corso Vector Databases for Embeddings with Pinecone.
Che cos'è un database vettoriale?
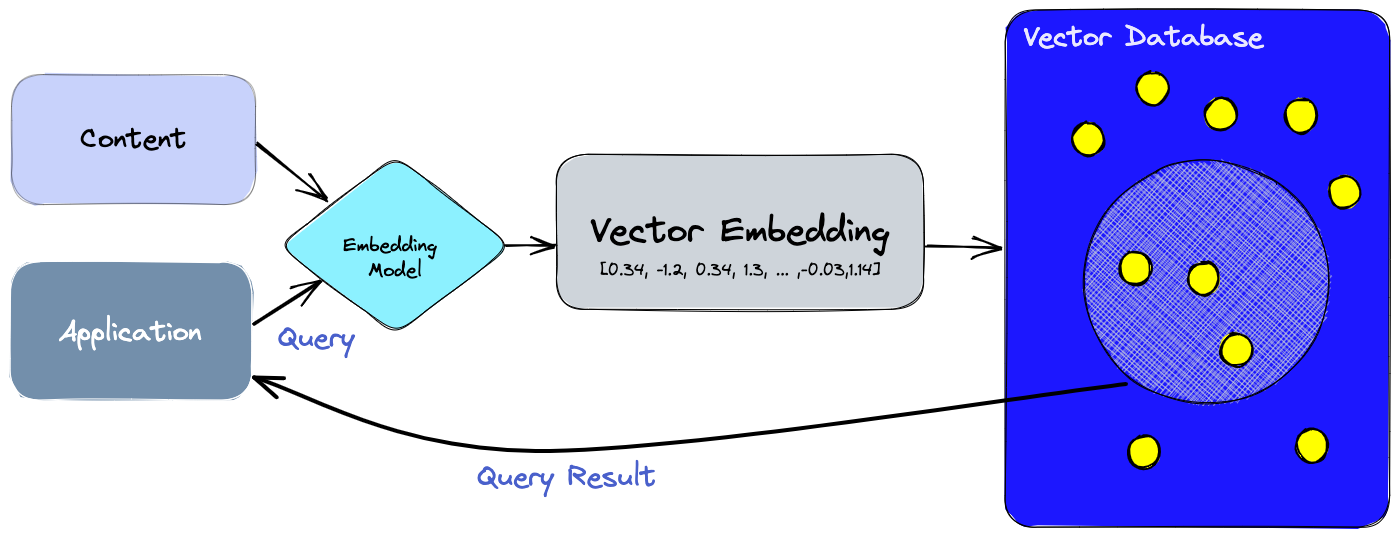
Nei database tradizionali, i dati vengono in genere archiviati in righe e colonne, adatti ai dati strutturati. Tuttavia, man mano che i dataset diventano più complessi e ad alta dimensionalità, emerge la necessità di una soluzione più specializzata. È qui che i database vettoriali danno il meglio. Invece di lavorare con strutture dati tradizionali, i database vettoriali sono ottimizzati per gestire vettori, rappresentazioni matematiche di punti dati in spazi multidimensionali.
I dati vettoriali trovano ampio impiego in vari campi, tra cui machine learning, data science, biologia computazionale e NLP. Possono rappresentare caratteristiche numeriche, coordinate, embedding, testo, immagini e molto altro. Con l'aumento delle applicazioni basate sull'IA, è cresciuta la domanda di una gestione efficiente dei dataset vettorializzati e i database vettoriali sono diventati uno strumento cruciale in questo contesto.
Che cos'è Pinecone?
Pinecone è una piattaforma di database vettoriale gestita, creata appositamente per affrontare le sfide uniche associate ai dati ad alta dimensionalità. Dotato di funzionalità all'avanguardia per indicizzazione e ricerca, Pinecone consente a data engineer e data scientist di costruire e implementare applicazioni di machine learning su larga scala che elaborano e analizzano efficacemente dati ad alta dimensionalità.
Caratteristiche principali di Pinecone
Vediamo cosa rende Pinecone uno strumento così utile:
Servizio completamente gestito
Essendo una piattaforma completamente gestita, Pinecone si occupa di tutto ciò che riguarda infrastruttura e manutenzione. Questo permette agli sviluppatori di concentrarsi sullo sviluppo e il deployment delle loro applicazioni di machine learning senza doversi preoccupare delle complessità operative e dell'infrastruttura.
Scalabilità
Pinecone offre un'eccezionale scalabilità, gestendo senza sforzo miliardi di vettori ad alta dimensionalità e fornendo capacità di scaling orizzontale. È quindi adatto a gestire anche i carichi di lavoro di machine learning più impegnativi.
Ingestione dati in tempo reale
Pinecone supporta senza problemi l'ingestione dei dati in tempo reale, consentendo agli utenti di archiviare e indicizzare nuovi dati man mano che diventano disponibili, senza tempi di inattività o interruzioni.
Ricerca a bassa latenza
Sfruttando algoritmi di indicizzazione sofisticati, Pinecone ottiene risultati di ricerca a bassa latenza per query del vicino più prossimo e operazioni di similarity search. Questo garantisce esiti rapidi e precisi per applicazioni sensibili al tempo.
Integrazione senza attriti
L'API di Pinecone è stata progettata con cura per essere semplice e intuitiva, semplificando l'integrazione con i flussi di lavoro e le pipeline dati di machine learning esistenti.
Comprendere i dati non strutturati e gli embedding vettoriali
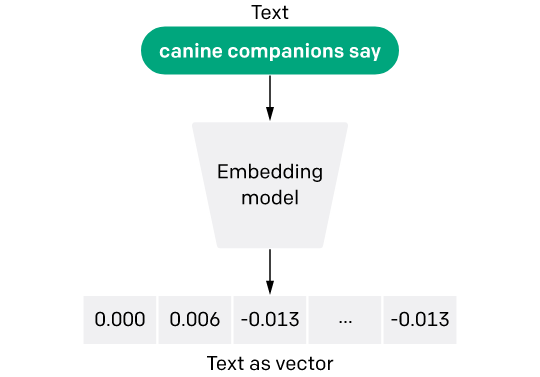
Modello di text embedding - Fonte immagine
Per dati non strutturati si intendono dati che non hanno un formato predefinito o organizzato, il che rende difficile per i database tradizionali archiviare ed elaborare in modo efficiente. Esempi di dati non strutturati includono testo, immagini, file audio e video.
I dati non strutturati non hanno una struttura rigida, il che rende difficile analizzarli direttamente con metodi tradizionali. Per poter utilizzare i dati non strutturati in applicazioni di machine learning e IA, questi vengono trasformati e archiviati in una rappresentazione numerica multidimensionale tramite gli embedding vettoriali.
Gli embedding svolgono un ruolo fondamentale nell'intelligenza artificiale, offrendo una tecnica potente per trasformare dati ad alta dimensionalità, come parole, immagini o preferenze degli utenti, in rappresentazioni numeriche compatte. Questi embedding numerici consentono ai modelli di IA di elaborare e comprendere informazioni complesse in modo efficiente.
Capire gli embedding diventa più facile se li pensi come un dizionario specializzato per un compito specifico. Ad esempio, nei progetti di text mining, gli embedding ci aiutano a cogliere il significato semantico delle parole analizzando le loro relazioni con altre parole. Questo processo genera un elenco di embedding che può essere considerato come un dizionario specifico per il compito, fornendo rappresentazioni vettoriali numeriche che riflettono il significato semantico delle parole. La somiglianza e la relazione tra parole diverse vengono misurate dalla distanza tra i rispettivi embedding, consentendo ai modelli di IA di comprendere il contesto e l'importanza delle parole.
L'importanza degli embedding risiede nella loro capacità di ridurre la dimensionalità dei dati, rendendo più gestibili per i modelli di machine learning input di grandi dimensioni come vettori sparsi che rappresentano parole o oggetti. Usando gli embedding, possiamo evitare i limiti della one-hot encoding, in cui ogni categoria viene convertita in una variabile fittizia separata, con il rischio di matrici di input eccessivamente grandi per alcuni compiti.
Se vuoi approfondire il funzionamento dei word embedding, consulta il nostro tutorial LDA2vec: Word Embeddings in Topic Models.
Riepilogo:
- Un database vettoriale è un tipo di database specializzato progettato per gestire ed elaborare i dati vettoriali in modo efficiente
- Pinecone è un servizio di database vettoriale completamente gestito
- Dati non strutturati sono dati che non hanno un formato predefinito o organizzato, come immagini, testo, audio o video
- Embedding è una tecnica potente per trasformare dati ad alta dimensionalità in rappresentazioni numeriche compatte
Come funziona un database vettoriale?
Conosci già il funzionamento dei database tradizionali, che archiviano dati scalari come stringhe e numeri in righe e colonne. I database vettoriali, invece, operano in modo diverso: lavorano con vettori e utilizzano metodi distinti di ottimizzazione e interrogazione.
Nei database tradizionali, le query cercano in genere corrispondenze esatte nel database. I database vettoriali, invece, usano una metrica di similarità per trovare il vettore che si adatta meglio alla nostra query.
I database vettoriali utilizzano una combinazione di algoritmi, nota collettivamente come ricerca del vicino più prossimo approssimato (Approximate Nearest Neighbor, ANN). Questi algoritmi ottimizzano il processo di ricerca tramite tecniche come hashing, quantizzazione o ricerca basata su grafi.
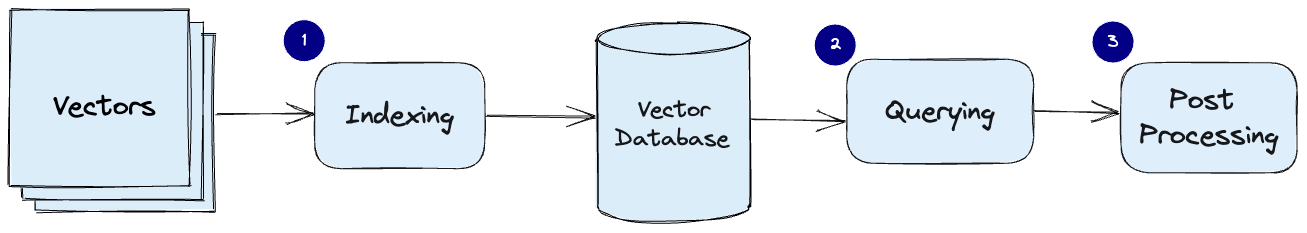
Pipeline comune per un database vettoriale (Fonte immagine)
Vuoi imparare a usare le API di OpenAI per creare text embedding e poi archiviarli in un database vettoriale come Pinecone? Scopri le loro applicazioni in classificazione del testo, information retrieval e rilevamento della similarità semantica nel post Introduction to Text Embeddings with the OpenAI API su DataCamp.
Primi passi con Pinecone
Per iniziare, vai su pinecone.io e registrati per un account gratuito.
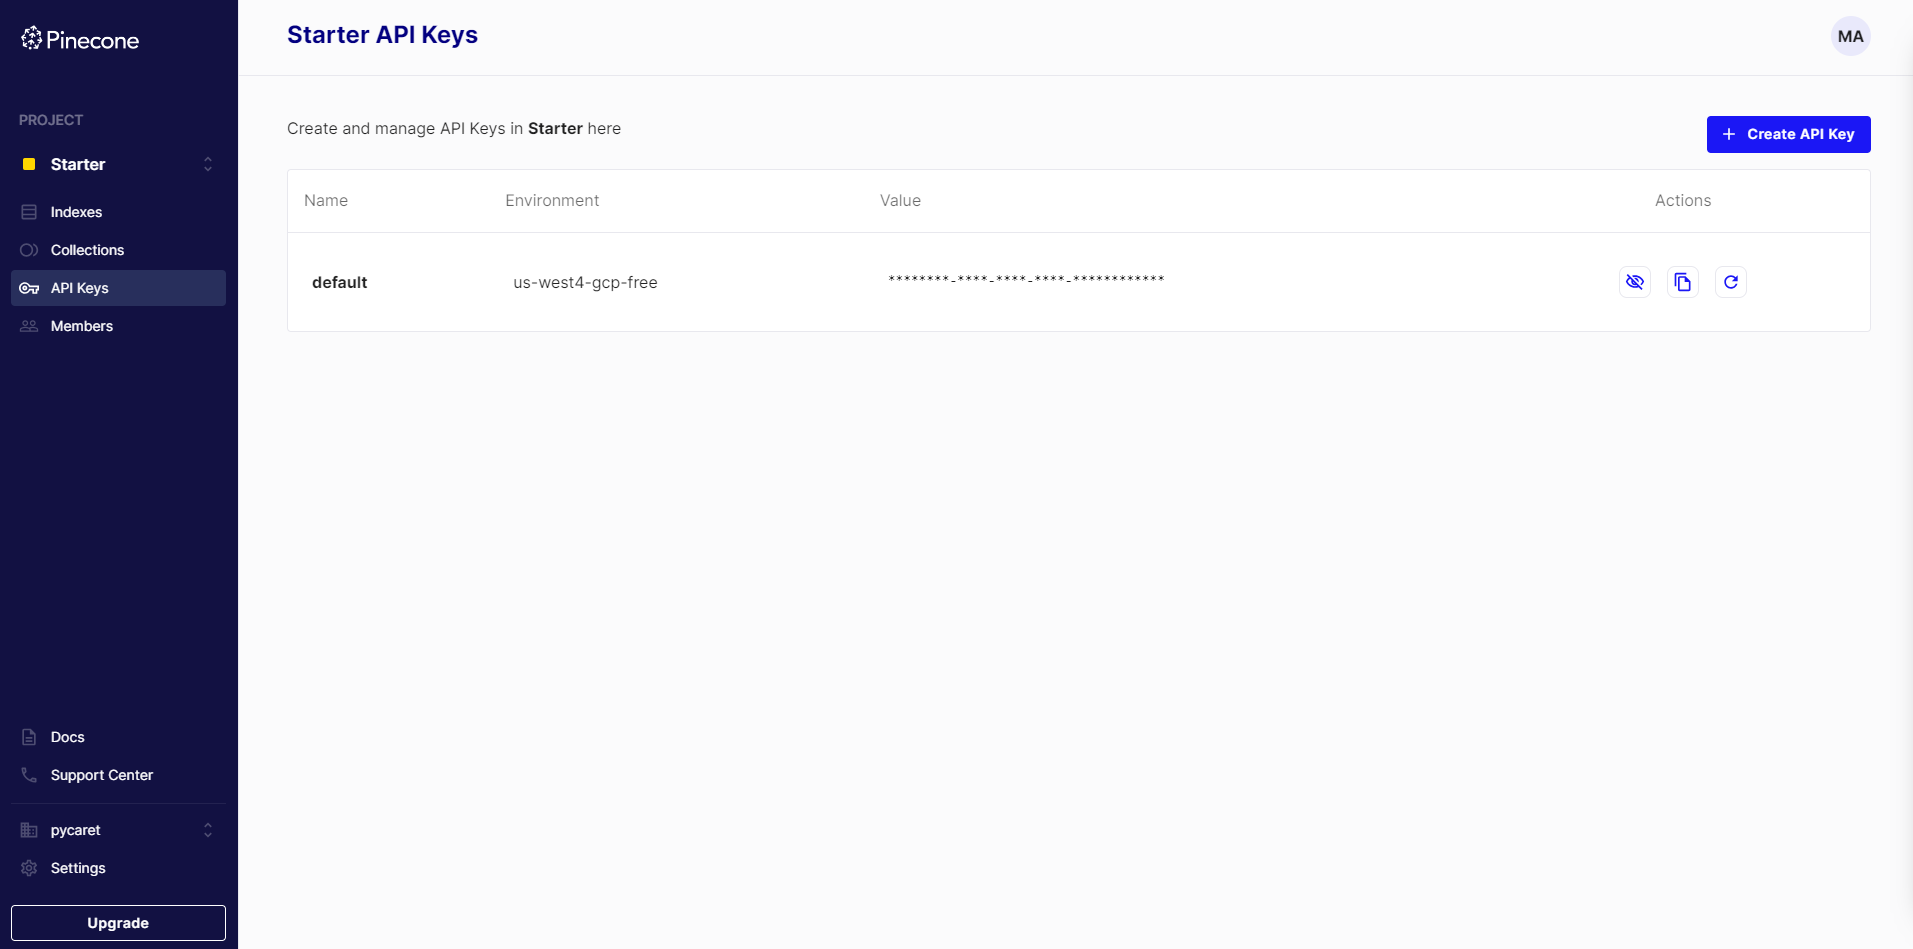
Dopo esserti registrato con successo, clicca su API Keys nel menu e copia il tuo environment e la tua API key. Ti serviranno quando lavori con il client Python di Pinecone.
Puoi anche installare il client Python per Pinecone usando pip.
pip install pinecone-clientConcetti chiave in Pinecone
Prima di entrare nei dettagli, esploriamo alcuni termini e concetti chiave che devi conoscere:
Indice Pinecone
In Pinecone, un indice rappresenta la struttura organizzativa di livello più alto per i dati vettoriali. È responsabile della ricezione e dell'archiviazione dei vettori, della gestione delle query sui vettori archiviati e dell'esecuzione di varie operazioni vettoriali sui propri dati. Ogni indice opera su uno o più pod per garantire un funzionamento efficiente.
Pod
I pod sono unità hardware preconfigurate che ospitano i servizi Pinecone. Ogni indice in Pinecone opera su uno o più pod e, in generale, più pod significano maggiore capacità di archiviazione, minore latenza e migliore throughput. Inoltre, gli utenti hanno la flessibilità di creare pod di dimensioni diverse in base alle esigenze specifiche.
Metriche di distanza
Le metriche di distanza sono tecniche matematiche utilizzate per valutare la similarità tra due vettori all'interno di uno spazio vettoriale. Nei database vettoriali, queste misure svolgono un ruolo cruciale nel confrontare i vettori archiviati con un vettore di query per identificare quelli più simili.
Puoi scegliere tra metriche diverse quando crei un indice vettoriale:
- Similarità del coseno. Questa misura valuta il coseno dell'angolo tra due vettori nello spazio vettoriale. La scala va da -1 a 1, dove 1 indica vettori identici, 0 vettori ortogonali e -1 vettori diametralmente opposti.
- Distanza euclidea. Questa misura calcola la distanza in linea retta tra due vettori nello spazio vettoriale. Va da 0 a infinito, dove 0 indica vettori identici e valori più alti indicano vettori via via meno simili.
- Prodotto scalare. Questa misura calcola il prodotto delle magnitudini di due vettori e del coseno dell'angolo tra di essi. La scala va da -∞ a ∞, dove valori positivi indicano vettori che puntano nella stessa direzione, 0 vettori ortogonali e valori negativi vettori che puntano in direzioni opposte.
Come verificare la API key di Pinecone
Per utilizzare Pinecone da Python è necessaria una API key. Puoi trovare la tua API key accedendo alla console di Pinecone e selezionando "API Keys". Nella stessa schermata puoi anche trovare le informazioni sull'environment associato al tuo progetto.
import pinecone
pinecone.init(api_key="API_KEY", environment = 'ENVIRONMENT')
Come creare un indice Pinecone
Per creare un indice in Pinecone, esegui semplicemente:
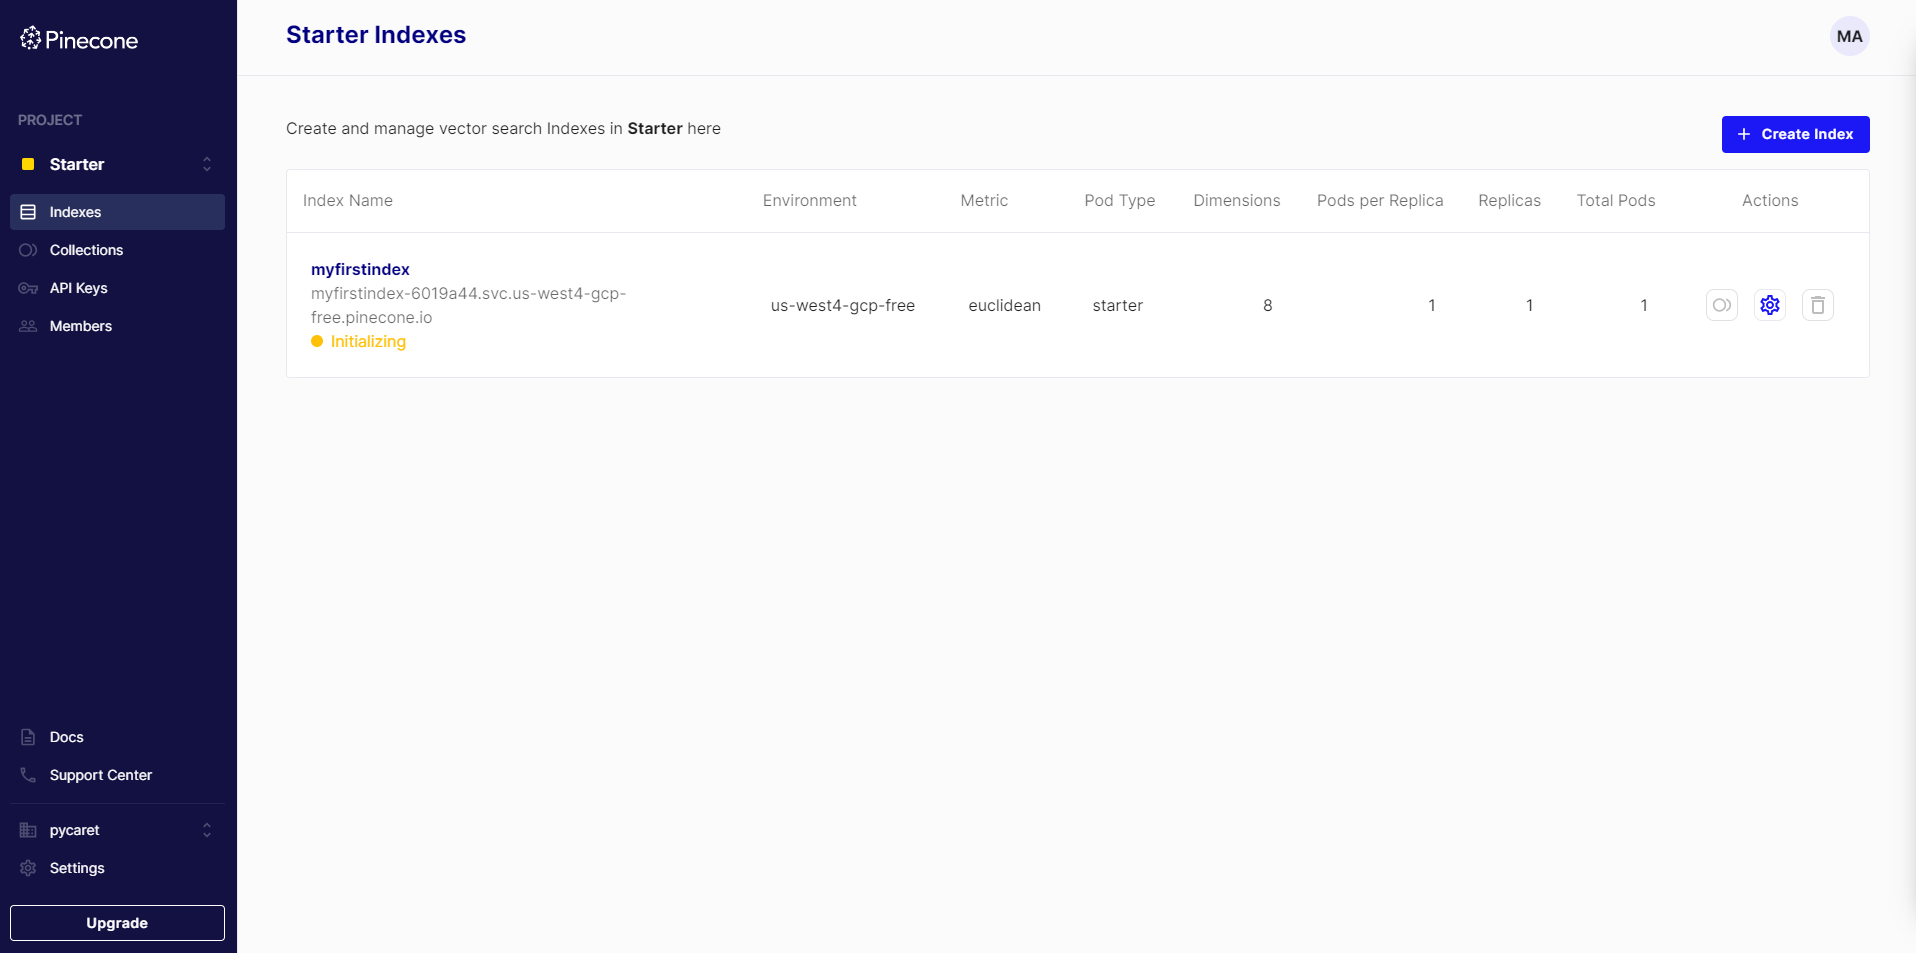
pinecone.create_index("myfirstindex", dimension=8, metric="euclidean")Non appena esegui questo comando, vedrai inizializzare un indice Pinecone nella tua console:
Inserimento e interrogazione dei dati in Pinecone
Per aggiungere vettori all'indice puoi usare l'operazione upsert. L'operazione upsert aggiunge un nuovo vettore all'indice oppure aggiorna un vettore esistente se è già presente un vettore con lo stesso ID. Con i comandi seguenti puoi eseguire l'upsert di cinque vettori a 8 dimensioni nel tuo indice.
index = pinecone.Index("myfirstindex")

index.upsert([
    ("A", [0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1]),
    ("B", [0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2]),
    ("C", [0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3]),
    ("D", [0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4]),
    ("E", [0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5])
])
Se vai nella console, vedrai i cinque vettori che abbiamo appena aggiunto.
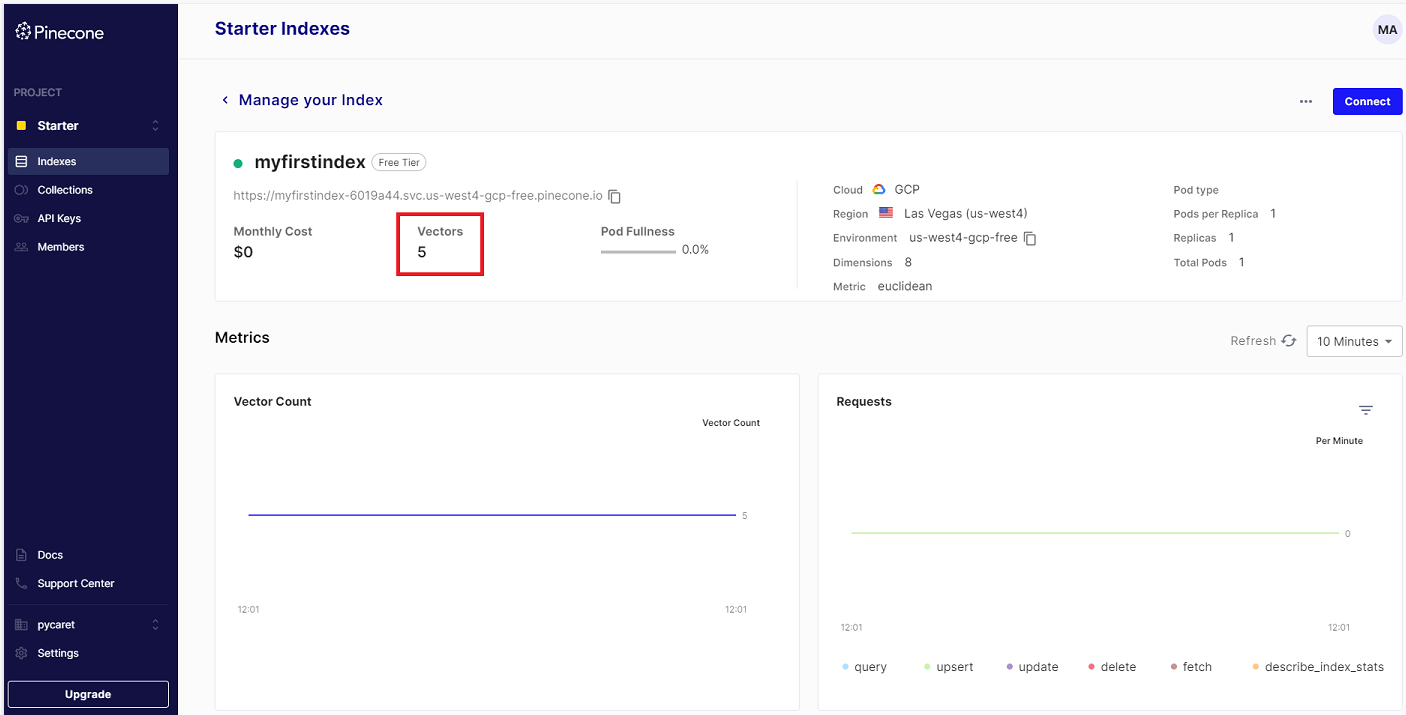
Per verificare la dimensione del vettore, puoi eseguire:
index.describe_index_stats()
>>> {'dimension': 8,
>>>  'index_fullness': 0.0,
>>>  'namespaces': {'': {'vector_count': 5}},
>>>  'total_vector_count': 5}
Come interrogare l'indice e ottenere vettori simili in Pinecone
Nell'esempio qui sotto, l'indice viene interrogato per recuperare i tre (3) vettori con la massima similarità rispetto a un vettore di esempio a 8 dimensioni. La query utilizza la distanza euclidea, come specificato al momento della creazione dell'indice.
index.query(
  vector=[0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3],
  top_k=3,
  include_values=True
)
>>> {'matches': [{'id': 'C',
>>> 'score': 0.0,
>>> 'values': [0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3]},
>>> {'id': 'D',
>>> 'score': 0.0799999237,
>>> 'values': [0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4]},
>>> {'id': 'B',
>>> 'score': 0.0800000429,
>>> 'values': [0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2]}],
>>> 'namespace': ''}
Eliminare indici in Pinecone
Quando l'indice non è più necessario, puoi usare l'operazione delete_index per rimuoverlo.
pinecone.delete_index("myfirstindex")Conclusione
Questo tutorial ha offerto una panoramica sul mondo dei database vettoriali e su Pinecone. I database vettoriali forniscono una soluzione specializzata per gestire in modo efficiente dati ad alta dimensionalità, sempre più essenziali nel campo del machine learning, della data science e delle applicazioni basate sull'IA.
Pinecone, in quanto piattaforma di database vettoriale gestita, si distingue come uno strumento potente per data engineer e data scientist, offrendo scalabilità, funzionalità di ricerca a bassa latenza e ingestione dati in tempo reale. Grazie alla sua integrazione senza attriti e all'API intuitiva, Pinecone semplifica la costruzione e il deployment di applicazioni di machine learning su larga scala.
Il tutorial ha anche approfondito il concetto di dati non strutturati e come i vector embedding svolgano un ruolo fondamentale nel trasformare tali dati in rappresentazioni numeriche compatte per l'analisi.
Se l'idea dei database vettoriali ti affascina e pensi di avere un caso d'uso adatto, dai un'occhiata al nostro corso pratico Vector Databases for Embeddings with Pinecone. Puoi anche provare Weaviate, un database vettoriale open source in Python. Se vuoi saperne di più, guarda il webinar Vector Databases for Data Science with Weaviate in Python su DataCamp.




