SQL ve MongoDB gibi ilişkisel ve ilişkisel olmayan veritabanlarına aşina bir veri bilimci veya veri analistiyseniz, veri yönetiminin heyecan verici bir alanına dalmaya hazır olun. Bu eğitimde, vektör verilerini verimli bir şekilde işlemek ve yönetmek için tasarlanmış, vektör veritabanları adı verilen yeni bir veri deposu türünü öğreneceksiniz. Bu Pinecone eğitiminde, özellikle Pinecone vektör veritabanı platformuna bakacağız.
Pinecone hakkında daha fazla bilgi edinmek için mutlaka şu kursumuzu inceleyin: Pinecone ile Gömlemeler için Vektör Veritabanları.
Vektör Veritabanı Nedir?
Geleneksel veritabanlarında veriler genellikle satır ve sütunlarda saklanır; bu, yapılandırılmış veriler için uygundur. Ancak veri kümeleri daha karmaşık ve yüksek boyutlu hale geldikçe daha özel bir çözüme ihtiyaç duyulur. İşte vektör veritabanlarının parladığı yer burasıdır. Geleneksel veri yapılarıyla uğraşmak yerine, vektör veritabanları çok boyutlu uzaylarda veri noktalarının matematiksel temsilleri olan vektörleri ele almak üzere optimize edilmiştir.
Vektör veriler, makine öğrenimi, veri bilimi, hesaplamalı biyoloji ve NLP dahil olmak üzere çeşitli alanlarda yaygın olarak kullanılır. Sayısal özellikleri, koordinatları, gömlemeleri, metinleri, görselleri ve daha fazlasını temsil edebilirler. Yapay zeka odaklı uygulamaların yükselişiyle birlikte, vektörleştirilmiş veri kümelerinin verimli şekilde işlenmesine olan talep arttı ve Vektör Veritabanları bu bağlamda kritik bir araç haline geldi.
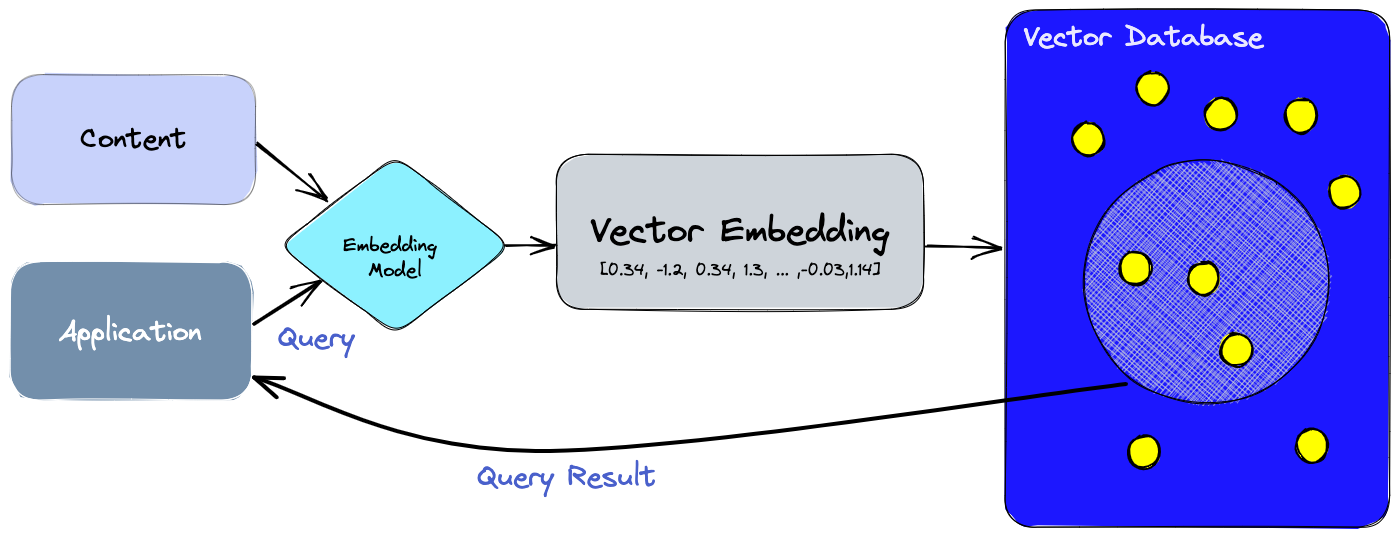
Pinecone Nedir?
Pinecone, yüksek boyutlu verilerle ilişkili benzersiz zorlukların üstesinden gelmek için özel olarak geliştirilmiş, yönetilen bir vektör veritabanı platformudur. En yeni indeksleme ve arama yetenekleriyle donatılan Pinecone, veri mühendisleri ve veri bilimcilerinin, yüksek boyutlu verileri etkili biçimde işleyen ve analiz eden, büyük ölçekli makine öğrenimi uygulamaları oluşturmasına ve uygulamasına olanak tanır.
Pinecone’un temel özellikleri
Pinecone’u bu kadar kullanışlı bir araç yapan şeylere bakalım:
Tamamen yönetilen hizmet
Tamamen yönetilen bir platform olarak Pinecone, altyapı ve bakıma ilişkin her şeyi yönetir. Bu sayede geliştiriciler, altyapı ve operasyonel karmaşıklıkları dert etmeden makine öğrenimi uygulamalarını geliştirme ve devreye almaya odaklanabilirler.
Ölçeklenebilirlik
Pinecone olağanüstü bir ölçeklenebilirlik sergiler; milyarlarca yüksek boyutlu vektörü zahmetsizce yönetir ve yatay ölçekleme yetenekleri sunar. Bu da onu en zorlu makine öğrenimi iş yüklerini ele almak için son derece uygun kılar.
Gerçek zamanlı veri alımı
Pinecone, gerçek zamanlı veri alımını sorunsuz şekilde destekler; kullanıcıların yeni verileri herhangi bir kesinti ya da aksama olmaksızın kullanılabilir hale geldikçe depolayıp dizine eklemesine olanak tanır.
Düşük gecikmeli arama
Gelişmiş indeksleme algoritmalarından yararlanan Pinecone, en yakın komşu sorguları ve benzerlik aramaları için düşük gecikmeli sonuçlar elde eder. Bu, zaman kritik uygulamalar için hızlı ve isabetli sonuçlar sağlar.
Sorunsuz entegrasyon
Pinecone’un API’si, basitlik ve sezgisellik gözetilerek tasarlanmıştır; bu da mevcut makine öğrenimi iş akışları ve veri hatlarıyla entegrasyon sürecini kolaylaştırır.
Yapılandırılmamış Veri ve Vektör Gömlemelerini Anlamak
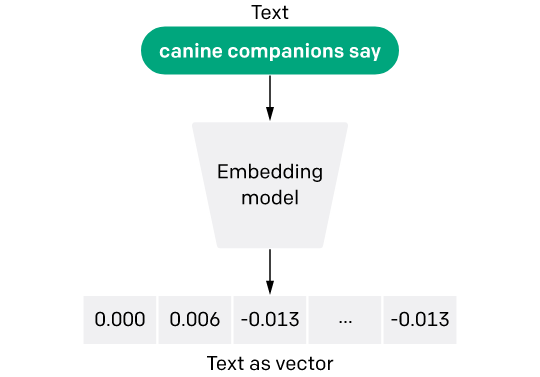
Metin Gömleme Modeli - Görsel Kaynağı
Yapılandırılmamış veri, önceden tanımlı ya da düzenli bir formata sahip olmayan ve bu nedenle geleneksel veritabanlarının verimli şekilde depalayıp işlemesini zorlaştıran veriler için kullanılır. Yapılandırılmamış veriye örnek olarak metin, görseller, ses ve video dosyaları verilebilir.
Yapılandırılmamış verinin katı bir yapısı olmadığı için, geleneksel yöntemlerle doğrudan analiz edilmesi zordur. Bu nedenle, yapılandırılmamış veriyi makine öğrenimi ve yapay zeka uygulamalarında kullanabilmek için, bu veriler vektör gömlemeleri kullanılarak çok boyutlu sayısal temsillere dönüştürülüp saklanır.
Gömlemeler, kelimeler, görseller veya kullanıcı tercihleri gibi yüksek boyutlu verileri kompakt sayısal temsillere dönüştürmek için güçlü bir teknik sunarak yapay zekâ alanında kilit bir rol oynar. Bu sayısal gömlemeler, yapay zekâ modellerinin karmaşık bilgileri verimli biçimde işlemesini ve anlamasını sağlar.
Gömlemeleri, belirli bir görev için uzmanlaşmış bir sözlük gibi düşünmek işin anlaşılmasını kolaylaştırır. Örneğin metin madenciliği projelerinde, gömlemeler, kelimelerin diğer kelimelerle ilişkilerini analiz ederek anlamsal içeriğini kavramamıza yardımcı olur. Bu süreç, kelimelerin anlamsal anlamını yansıtan sayısal vektör temsilleri sağlayan ve görev özelinde bir sözlük gibi değerlendirilebilen bir gömleme listesi üretir. Farklı kelimeler arasındaki benzerlik ve ilişki, karşılık gelen gömlemeleri arasındaki mesafe ile ölçülür; bu da yapay zekâ modellerinin kelimelerin bağlamını ve önemini anlamasını mümkün kılar.
Gömlemelerin önemi, verinin boyutunu azaltabilmelerinde yatar; bu da kelimeleri veya öğeleri temsil eden seyrek vektörler gibi büyük girdileri makine öğrenimi modelleri için daha yönetilebilir kılar. Gömlemeler kullanarak, her kategorinin ayrı bir kukla değişkene dönüştürüldüğü ve bazı görevlerde aşırı büyük giriş matrislerine yol açabilen one-hot-encoding sınırlamalarından kaçınabiliriz.
Kelime Gömlemelerinin nasıl çalıştığı hakkında daha fazla bilgi edinmek isterseniz, LDA2vec: Konu Modellerinde Kelime Gömlemeleri adlı eğitimimize göz atın.
Özet:
- Vektör veritabanı, vektör verilerini verimli biçimde ele almak ve işlemek için tasarlanmış özel bir veritabanı türüdür
- Pinecone, tamamen yönetilen bir vektör veritabanı hizmetidir
- Yapılandırılmamış veri, görseller, metin, ses veya video gibi önceden tanımlı ya da düzenli bir formata sahip olmayan verileri ifade eder
- Gömlemeler, yüksek boyutlu verileri kompakt sayısal temsillere dönüştürmek için güçlü bir tekniktir
Bir Vektör Veritabanı Nasıl Çalışır?
Geleneksel veritabanlarının nasıl çalıştığına, yani dizelerde ve sayılarda gibi skaler verileri satır ve sütunlarda depoladığına aşina olmalısınız. Ancak vektör veritabanları farklı şekilde çalışır; vektörlerle çalışır ve farklı optimizasyon ve sorgulama yöntemleri kullanır.
Geleneksel veritabanlarında sorgular tipik olarak veritabanında tam eşleşmeler arar. Öte yandan, vektör veritabanları sorgumuza en iyi uyan vektörü bulmak için bir benzerlik metriği kullanır.
Vektör veritabanları, yaklaşık en yakın komşu (ANN) araması olarak bilinen algoritmalar kombinasyonundan yararlanır. Bu algoritmalar, karma, niceleme veya grafik tabanlı arama gibi tekniklerle arama sürecini optimize eder.
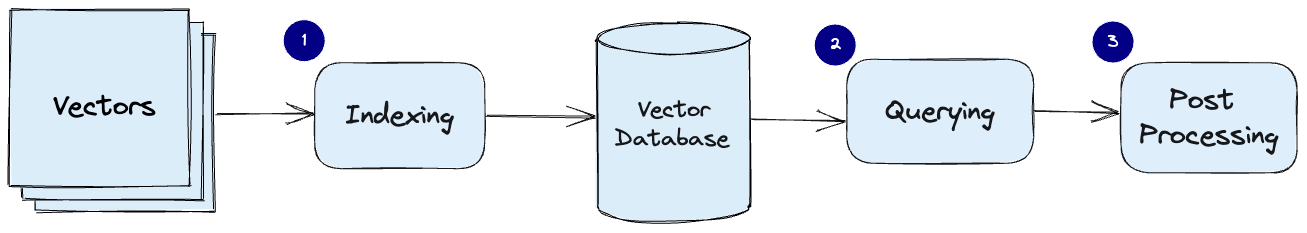
Vektör veritabanı için yaygın işlem hattı (Görsel Kaynağı)
OpenAI API’yi kullanarak metin gömlemeleri oluşturmayı ve ardından bunları Pinecone gibi bir vektör veritabanında saklamayı öğrenmek ister misiniz? Metin sınıflandırma, bilgi erişimi ve anlamsal benzerlik tespiti uygulamalarını DataCamp’teki OpenAI API ile Metin Gömlemelerine Giriş blog yazısında keşfedin.
Pinecone ile Başlarken
Başlamak için pinecone.io adresine gidip ücretsiz bir hesap açmanız yeterlidir.
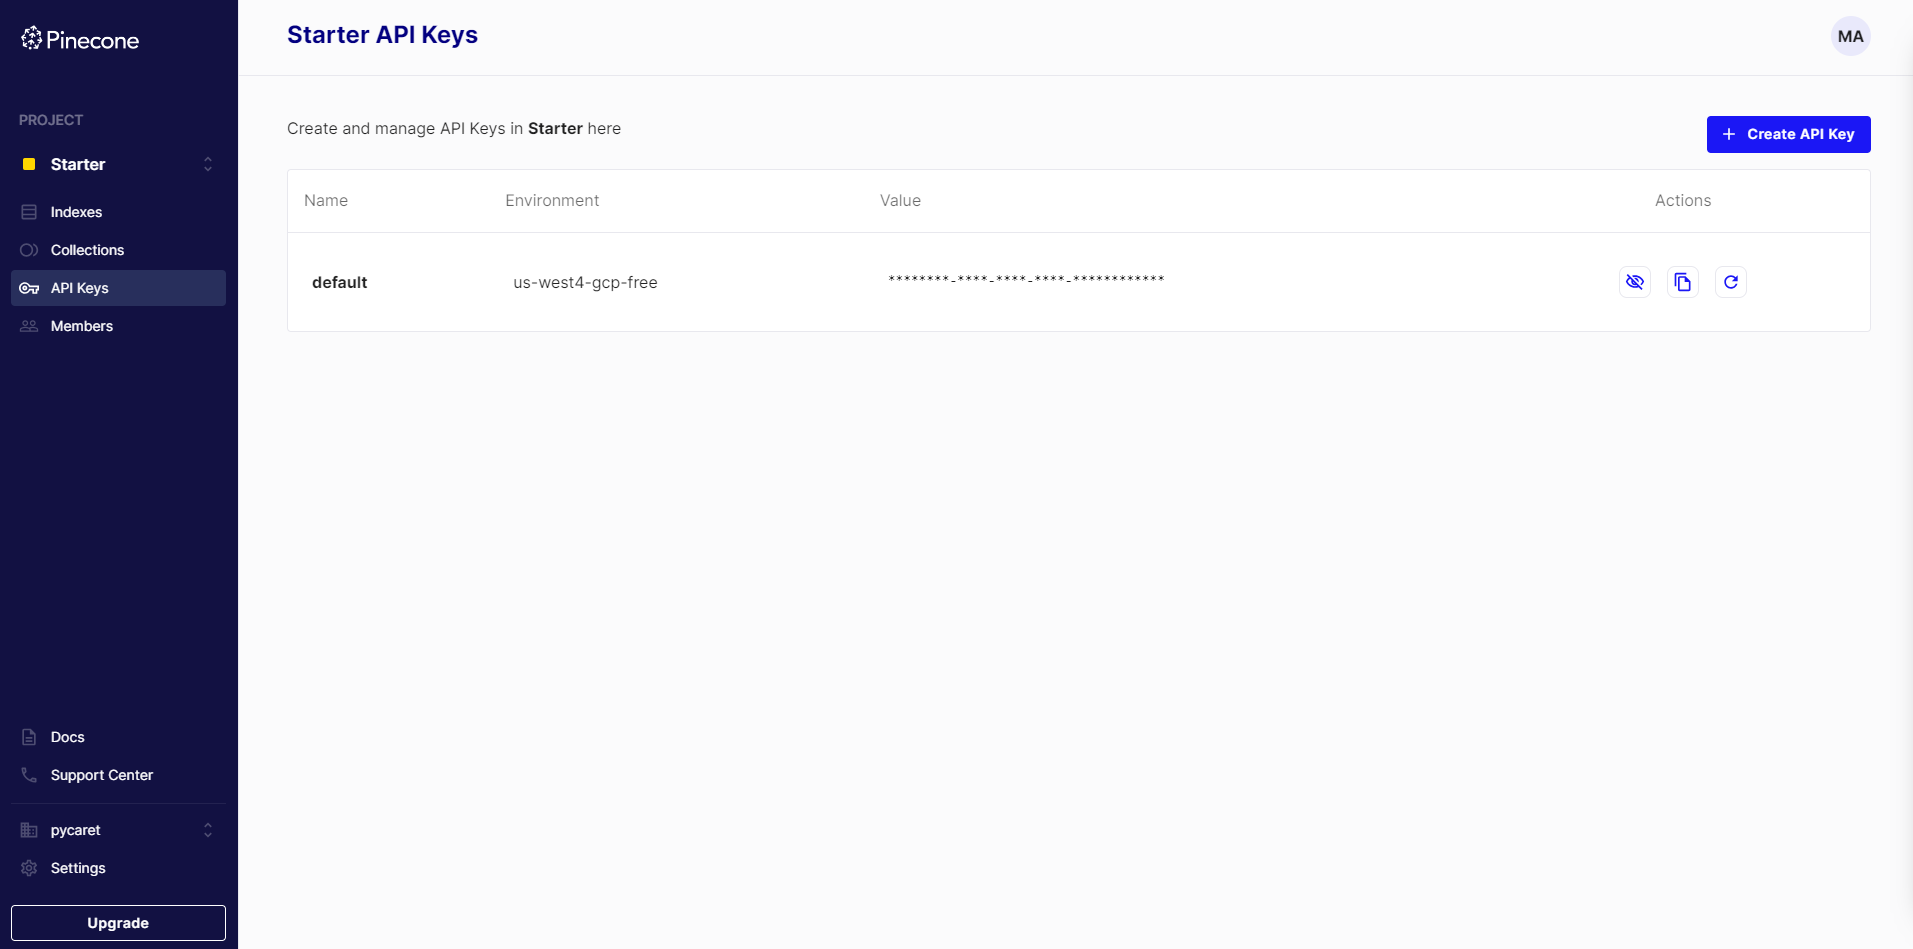
Başarıyla kaydolduktan sonra menüden API Keys’e tıklayın ve ortamınızı ve API anahtarınızı kopyalayın. Bu bilgiler, Pinecone’un Python istemcisiyle çalışırken kullanılacaktır.
Pinecone için Python istemcisini pip ile de kurabilirsiniz.
pip install pinecone-clientPinecone’da Temel Kavramlar
Daha ayrıntıya inmeden önce, bilmeniz gereken bazı temel terim ve kavramları inceleyelim:
Pinecone index
Pinecone’da bir index, vektör verileri için en üst düzey örgütsel yapıyı temsil eder. Vektörleri almak ve depolamak, depolanan vektörler üzerinde sorguları ele almak ve verileri içinde çeşitli vektör işlemlerini gerçekleştirmekten sorumludur. Her index, etkin işlevselliği sağlamak için bir veya daha fazla pod üzerinde çalışır.
Pods
Pod’lar, Pinecone hizmetlerini barındıran önceden yapılandırılmış donanım birimleridir. Pinecone’daki her index bir veya birden fazla pod üzerinde çalışır ve ek pod’lara sahip olmak genellikle artan depolama kapasitesi, azalan gecikme ve iyileştirilmiş throughput ile sonuçlanır. Ayrıca kullanıcılar, belirli gereksinimleri karşılamak için farklı boyutlarda pod’lar oluşturma esnekliğine sahiptir.
Mesafe Metrikleri
Mesafe Metrikleri, bir vektör uzayında iki vektör arasındaki benzerliği değerlendirmek için kullanılan matematiksel tekniklerdir. Vektör veritabanlarında bu ölçüler, depolanan vektörleri verilen bir sorgu vektörüyle karşılaştırarak en benzer olanları belirlemede kritik rol oynar.
Bir vektör index’i oluştururken farklı metrikler arasından seçim yapabilirsiniz:
- Kosinüs benzerliği. Bu ölçü, vektör uzayında iki vektör arasındaki açının kosinüsünü değerlendirir. Ölçek -1 ile 1 arasındadır; 1 özdeş vektörleri, 0 dik vektörleri, -1 ise tam zıt yönlü vektörleri ifade eder.
- Öklidyen mesafe. Bu ölçü, vektör uzayında iki vektör arasındaki doğru çizgi mesafesini hesaplar. 0 ile sonsuz arasında değişir; 0 özdeş vektörleri, daha büyük değerler ise giderek daha farklı vektörleri ifade eder.
- Skaler çarpım. Bu ölçü, iki vektörün büyüklüklerinin ve aralarındaki açının kosinüsünün çarpımını hesaplar. Ölçek -∞ ile ∞ arasındadır; pozitif değerler aynı yöne işaret eden vektörleri, 0 dik vektörleri, negatif değerler ise zıt yöne işaret eden vektörleri ifade eder.
Pinecone API Anahtarı Nasıl Doğrulanır
Pinecone’u Python üzerinden kullanmak için bir API anahtarı gerekir. API anahtarınızı Pinecone konsoluna erişip "API Keys"i seçerek bulabilirsiniz. Aynı görünümde, projenizle ilişkili ortam bilgilerini de görebilirsiniz.
import pinecone
pinecone.init(api_key="API_KEY", environment = 'ENVIRONMENT')
Pinecone Index Nasıl Oluşturulur
Pinecone’da bir index oluşturmak için sadece şunu çalıştırın:
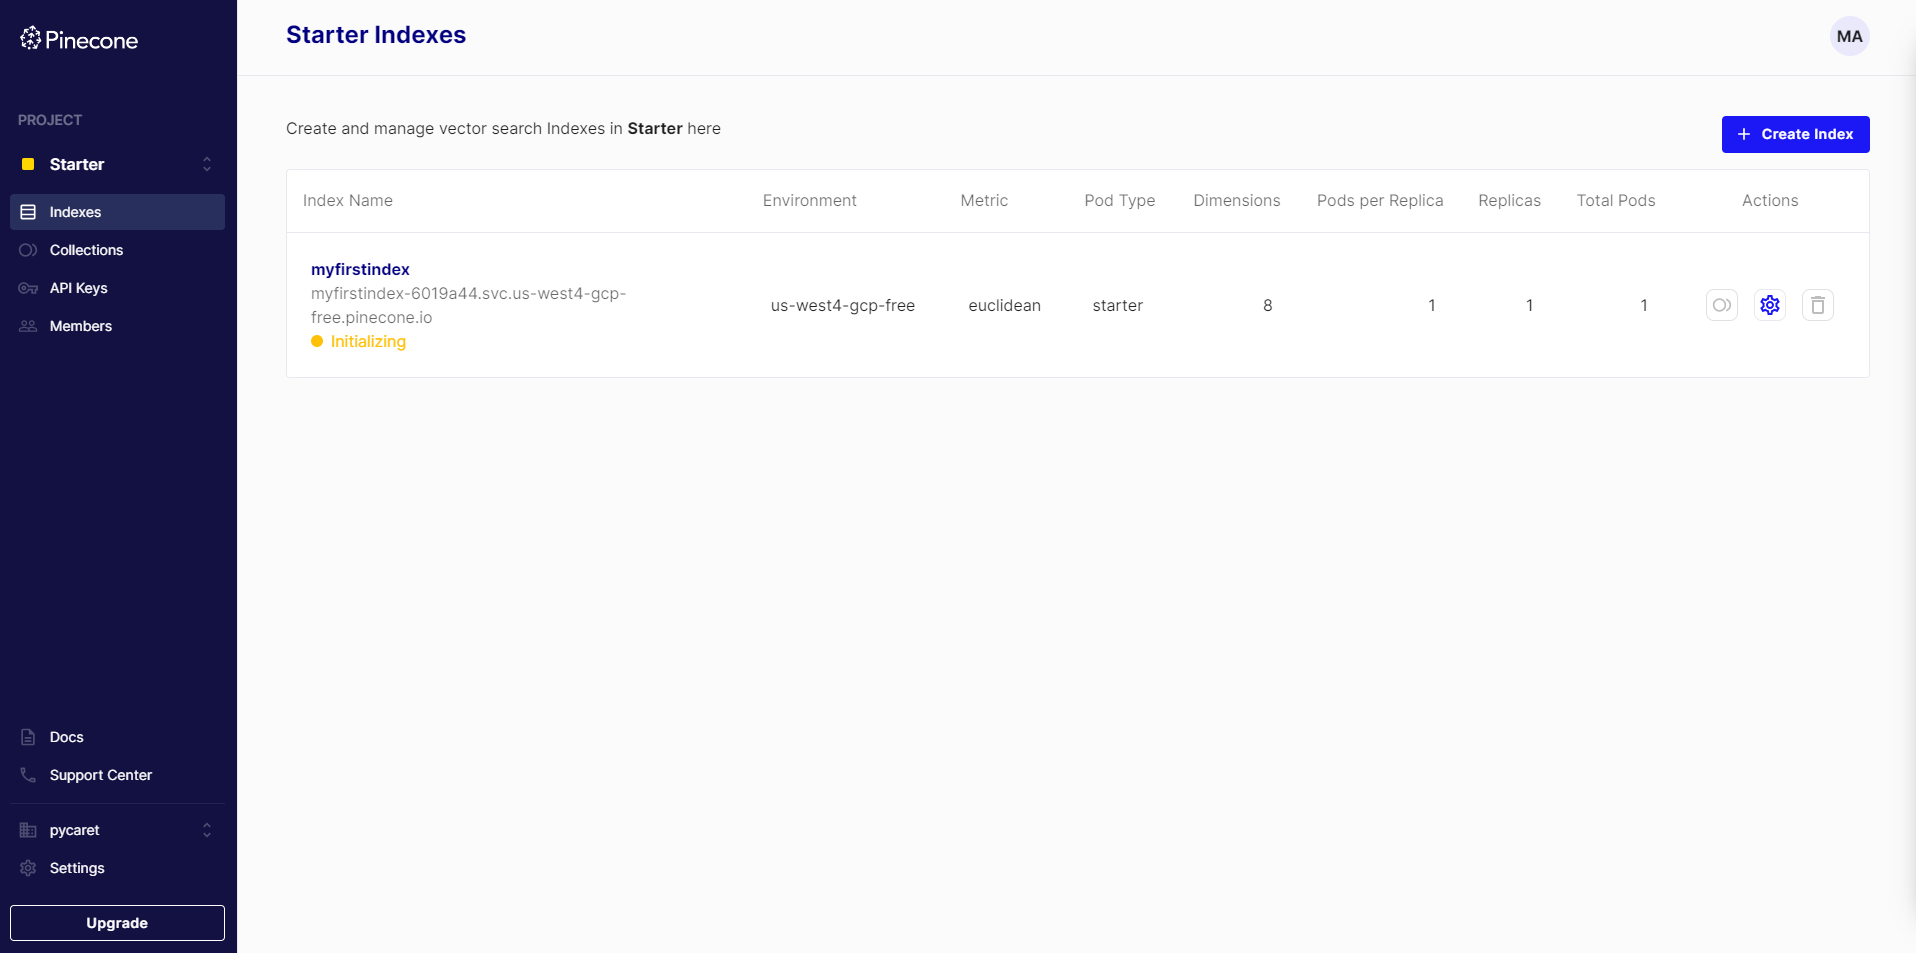
pinecone.create_index("myfirstindex", dimension=8, metric="euclidean")Bu komutu çalıştırır çalıştırmaz, konsolunuzda bir Pinecone index’inin başlatıldığını göreceksiniz:
Pinecone’da Veri Ekleme ve Sorgulama
İndekse vektör eklemek için upsert işlemi kullanılabilir. Upsert işlemi, indekse yeni bir vektör ekler veya aynı kimliğe sahip bir vektör zaten varsa mevcut vektörü günceller. Aşağıdaki komutları kullanarak indekse beş adet 8 boyutlu vektörü upsert edebilirsiniz.
index = pinecone.Index("myfirstindex")

index.upsert([
    ("A", [0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1]),
    ("B", [0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2]),
    ("C", [0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3]),
    ("D", [0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4]),
    ("E", [0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5])
])
Konsola giderseniz, az önce eklediğimiz beş vektörü göreceksiniz.
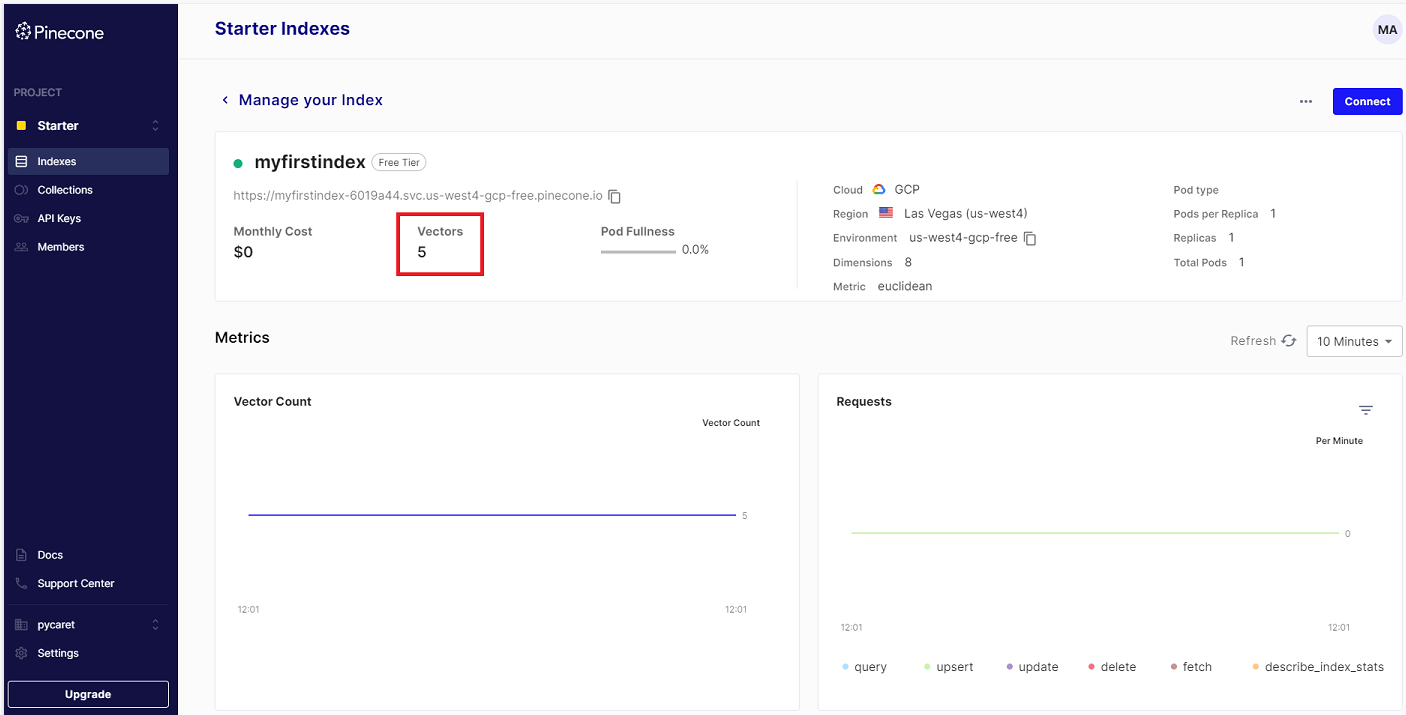
Vektörün boyutunu kontrol etmek için şunu çalıştırabilirsiniz:
index.describe_index_stats()
>>> {'dimension': 8,
>>>  'index_fullness': 0.0,
>>>  'namespaces': {'': {'vector_count': 5}},
>>>  'total_vector_count': 5}
Pinecone’da İndeksi Sorgulama ve Benzer Vektörleri Alma
Aşağıdaki örnekte, indeks, örnek bir 8 boyutlu vektörle en yüksek benzerliği gösteren ilk üç (3) vektörü getirmek için sorgulanır. Sorgu, indeks oluşturma sırasında belirtildiği gibi Öklidyen mesafe metriğini kullanır.
index.query(
  vector=[0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3],
  top_k=3,
  include_values=True
)
>>> {'matches': [{'id': 'C',
>>> 'score': 0.0,
>>> 'values': [0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3]},
>>> {'id': 'D',
>>> 'score': 0.0799999237,
>>> 'values': [0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4]},
>>> {'id': 'B',
>>> 'score': 0.0800000429,
>>> 'values': [0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2]}],
>>> 'namespace': ''}
Pinecone’da İndeks Silme
İndekse artık ihtiyaç kalmadığında, indeksi kaldırmak için delete_index işlemini kullanabilirsiniz.
pinecone.delete_index("myfirstindex")Sonuç
Bu eğitim, vektör veritabanları ve Pinecone dünyasına dair içgörüler sundu. Vektör veritabanları, makine öğrenimi, veri bilimi ve yapay zekâ odaklı uygulamalar alanında giderek daha gerekli hale gelen yüksek boyutlu verileri verimli bir şekilde ele almak için özel bir çözüm sunar.
Yönetilen bir vektör veritabanı platformu olarak Pinecone, ölçeklenebilirlik, düşük gecikmeli arama yetenekleri ve gerçek zamanlı veri alımı sunarak veri mühendisleri ve bilimcileri için güçlü bir araç olarak öne çıkar. Sorunsuz entegrasyonu ve kullanıcı dostu API’siyle Pinecone, büyük ölçekli makine öğrenimi uygulamalarını oluşturma ve devreye alma sürecini sadeleştirir.
Eğitim ayrıca, yapılandırılmamış veri kavramına ve Vektör Gömlemelerinin bu tür verileri analiz için kompakt sayısal temsillere dönüştürmedeki kritik rolüne de değindi.
Vektör veritabanı fikri sizi cezbediyorsa ve bunun için bir kullanım senaryonuz olduğunu düşünüyorsanız, uygulamalı kursumuz Pinecone ile Gömlemeler için Vektör Veritabanları’na göz atın. Python’da açık kaynaklı bir vektör veritabanı olan Weaviate’i de deneyebilirsiniz. Bunun hakkında daha fazla bilgi edinmek isterseniz, Datacamp’teki Python’da Weaviate ile Veri Bilimi için Vektör Veritabanları Web Seminerine göz atın.




