Wenn du als Data Scientist oder Data Analyst relationale und nicht-relationale Datenbanken wie SQL und MongoDB kennst, tauchst du jetzt in eine spannende neue Welt des Datenmanagements ein. In diesem Tutorial lernst du einen neuen Datenspeichertyp kennen: Vector-Datenbanken – spezialisierte Datenbanken, die Vektordaten besonders effizient verarbeiten. In diesem Pinecone-Tutorial schauen wir uns konkret die Vector-Datenbank-Plattform Pinecone an.
Wenn du mehr über Pinecone erfahren möchtest, sieh dir unbedingt unseren Kurs Vector Databases for Embeddings with Pinecone an.
Was ist eine Vector-Datenbank?
In klassischen Datenbanken werden Daten meist in Zeilen und Spalten gespeichert – ideal für strukturierte Daten. Doch mit wachsenden, komplexen und hochdimensionalen Datensätzen braucht es spezialisierte Lösungen. Hier spielen Vector-Datenbanken ihre Stärken aus. Statt klassischer Datenstrukturen arbeiten sie mit Vektoren – mathematischen Repräsentationen von Datenpunkten in mehrdimensionalen Räumen – und sind dafür optimal ausgelegt.
Vektordaten kommen in vielen Bereichen zum Einsatz, etwa im maschinellen Lernen, in der Data Science, der computergestützten Biologie oder im NLP. Sie können numerische Merkmale, Koordinaten, Embeddings, Text, Bilder und vieles mehr abbilden. Mit dem Aufschwung KI-getriebener Anwendungen ist die effiziente Verarbeitung vektorisierter Datensätze stark gefragt – Vector-Datenbanken sind dafür unverzichtbar geworden.
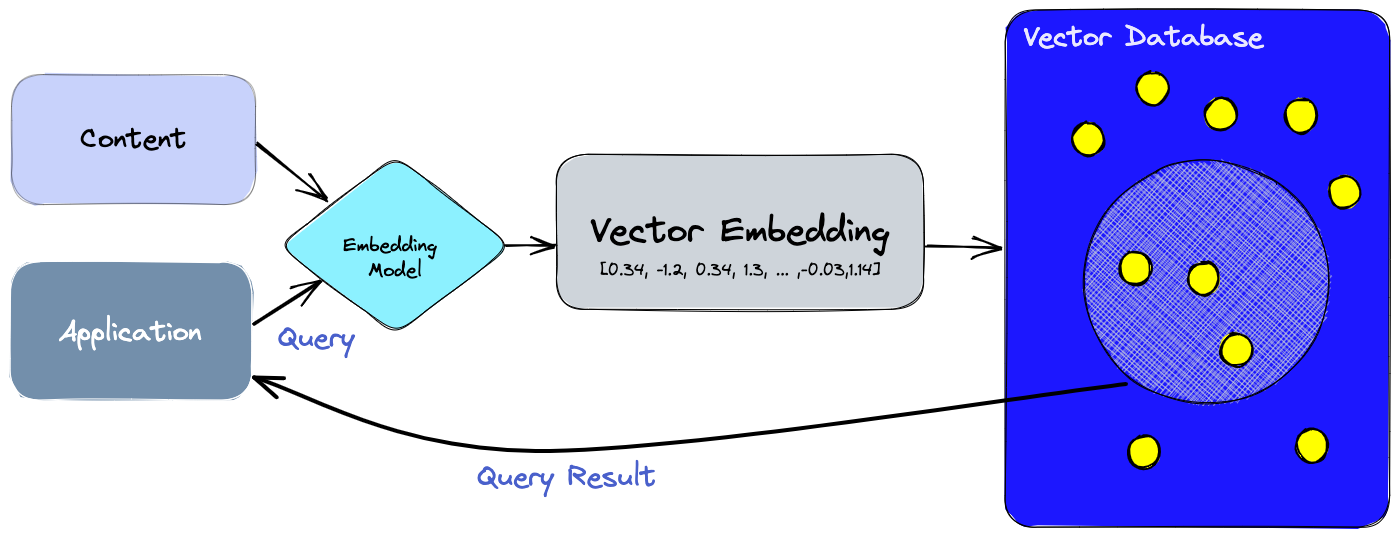
Was ist Pinecone?
Pinecone ist eine gemanagte Vector-Datenbank-Plattform, die speziell für die Herausforderungen hochdimensionaler Daten entwickelt wurde. Mit modernsten Indexierungs- und Suchfunktionen unterstützt Pinecone Data Engineers und Data Scientists beim Aufbau und Betrieb großskaliger Machine-Learning-Anwendungen, die hochdimensionale Daten effizient verarbeiten und analysieren.
Die wichtigsten Features von Pinecone
Das macht Pinecone so hilfreich:
Voll gemanagter Service
Als voll gemanagte Plattform übernimmt Pinecone Infrastruktur und Wartung. So kannst du dich voll auf die Entwicklung und Bereitstellung deiner ML-Anwendungen konzentrieren, ohne dir über Betrieb und Infrastruktur Gedanken machen zu müssen.
Skalierbarkeit
Pinecone skaliert außergewöhnlich gut: Milliarden hochdimensionaler Vektoren und horizontale Skalierung sind problemlos möglich. Ideal für selbst die anspruchsvollsten ML-Workloads.
Echtzeit-Datenaufnahme
Pinecone unterstützt die Aufnahme von Daten in Echtzeit. Neue Daten lassen sich ohne Ausfallzeiten speichern und indexieren.
Niedrige Latenz bei der Suche
Dank ausgefeilter Indexierungsalgorithmen liefert Pinecone Suchergebnisse mit geringer Latenz bei Next-Neighbor-Abfragen und Ähnlichkeitssuchen. Zeitkritische Anwendungen profitieren von schnellen und präzisen Ergebnissen.
Nahtlose Integration
Die API von Pinecone ist bewusst einfach und intuitiv gehalten. Das erleichtert die Integration in bestehende ML-Workflows und Datenpipelines.
Unstrukturierte Daten und Vektorembeddings verstehen
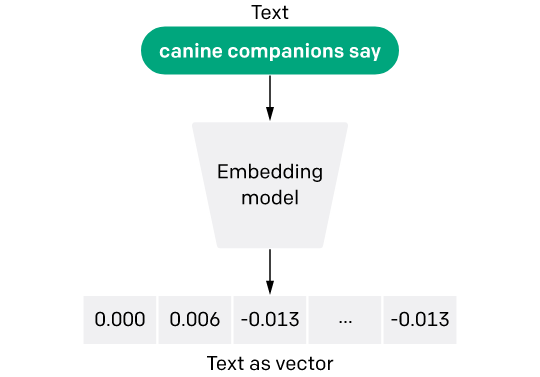
Text-Embedding-Modell – Bildquelle
Unstrukturierte Daten haben kein vordefiniertes oder organisiertes Format und lassen sich daher in klassischen Datenbanken nur schwer effizient speichern und verarbeiten. Beispiele sind Text, Bilder, Audio und Video.
Weil unstrukturierte Daten keine feste Struktur haben, sind sie mit herkömmlichen Methoden schwer direkt zu analysieren. Für ML- und KI-Anwendungen werden sie daher in mehrdimensionale numerische Repräsentationen überführt und gespeichert – mit Vektorembeddings.
Embeddings spielen in der KI eine zentrale Rolle. Sie wandeln hochdimensionale Daten wie Wörter, Bilder oder Nutzerpräferenzen in kompakte Zahlenvektoren um. So können KI-Modelle komplexe Informationen effizient verarbeiten und besser verstehen.
Am einfachsten lässt sich das mit einem spezialisierten Wörterbuch für eine konkrete Aufgabe vergleichen. In Text-Mining-Projekten erfassen Embeddings zum Beispiel die semantische Bedeutung von Wörtern, indem sie deren Beziehungen zu anderen Wörtern analysieren. Daraus entsteht eine Liste von Embeddings – quasi ein aufgabenbezogenes Wörterbuch –, das numerische Vektoren liefert, die die semantische Bedeutung widerspiegeln. Die Ähnlichkeit und Beziehung zwischen Wörtern bemisst sich über die Distanz ihrer Embeddings. So erschließen KI-Modelle Kontext und Bedeutung.
Der große Vorteil von Embeddings liegt in der Dimensionsreduktion. Modelle können dadurch große Eingaben wie spärliche Vektoren für Wörter oder Items besser handhaben. So entgehen wir auch den Grenzen des One-Hot-Encodings, bei dem für jede Kategorie eine Dummy-Variable entsteht und die Eingabematrizen schnell riesig werden.
Wenn du tiefer verstehen möchtest, wie Word Embeddings funktionieren, schau dir unser Tutorial LDA2vec: Word Embeddings in Topic Models an.
Zusammenfassung:
- Eine Vector-Datenbank ist eine spezialisierte Datenbank für die effiziente Verarbeitung von Vektordaten.
- Pinecone ist ein voll gemanagter Vector-Datenbank-Service.
- Unstrukturierte Daten haben kein vordefiniertes Format, etwa Bilder, Text, Audio oder Video.
- Embeddings transformieren hochdimensionale Daten in kompakte numerische Repräsentationen.
Wie funktioniert eine Vector-Datenbank?
Klassische Datenbanken speichern skalare Daten wie Strings und Zahlen in Zeilen und Spalten. Vector-Datenbanken arbeiten anders: Sie operieren mit Vektoren und nutzen eigene Verfahren für Optimierung und Abfragen.
Während klassische Datenbanken bei Abfragen meist exakte Übereinstimmungen suchen, verwenden Vector-Datenbanken eine Ähnlichkeitsmetrik, um den Vektor zu finden, der unserer Anfrage am nächsten kommt.
Dazu setzen Vector-Datenbanken auf Algorithmen, die zusammen als Approximate Nearest Neighbor (ANN) Search bekannt sind. Sie beschleunigen die Suche mit Techniken wie Hashing, Quantisierung oder graphbasierten Verfahren.
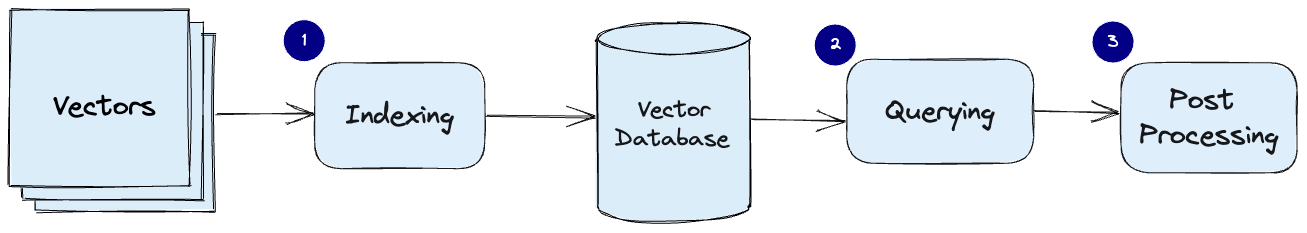
Typische Pipeline einer Vector-Datenbank (Bildquelle)
Möchtest du lernen, wie du mit der OpenAI API Text-Embeddings erstellst und sie in einer Vector-Datenbank wie Pinecone speicherst? Entdecke Anwendungsfälle in Textklassifikation, Information Retrieval und semantischer Ähnlichkeit in unserem Introduction to Text Embeddings with the OpenAI API Blog bei DataCamp.
Erste Schritte mit Pinecone
Starte einfach auf pinecone.io und registriere dich für ein kostenloses Konto.
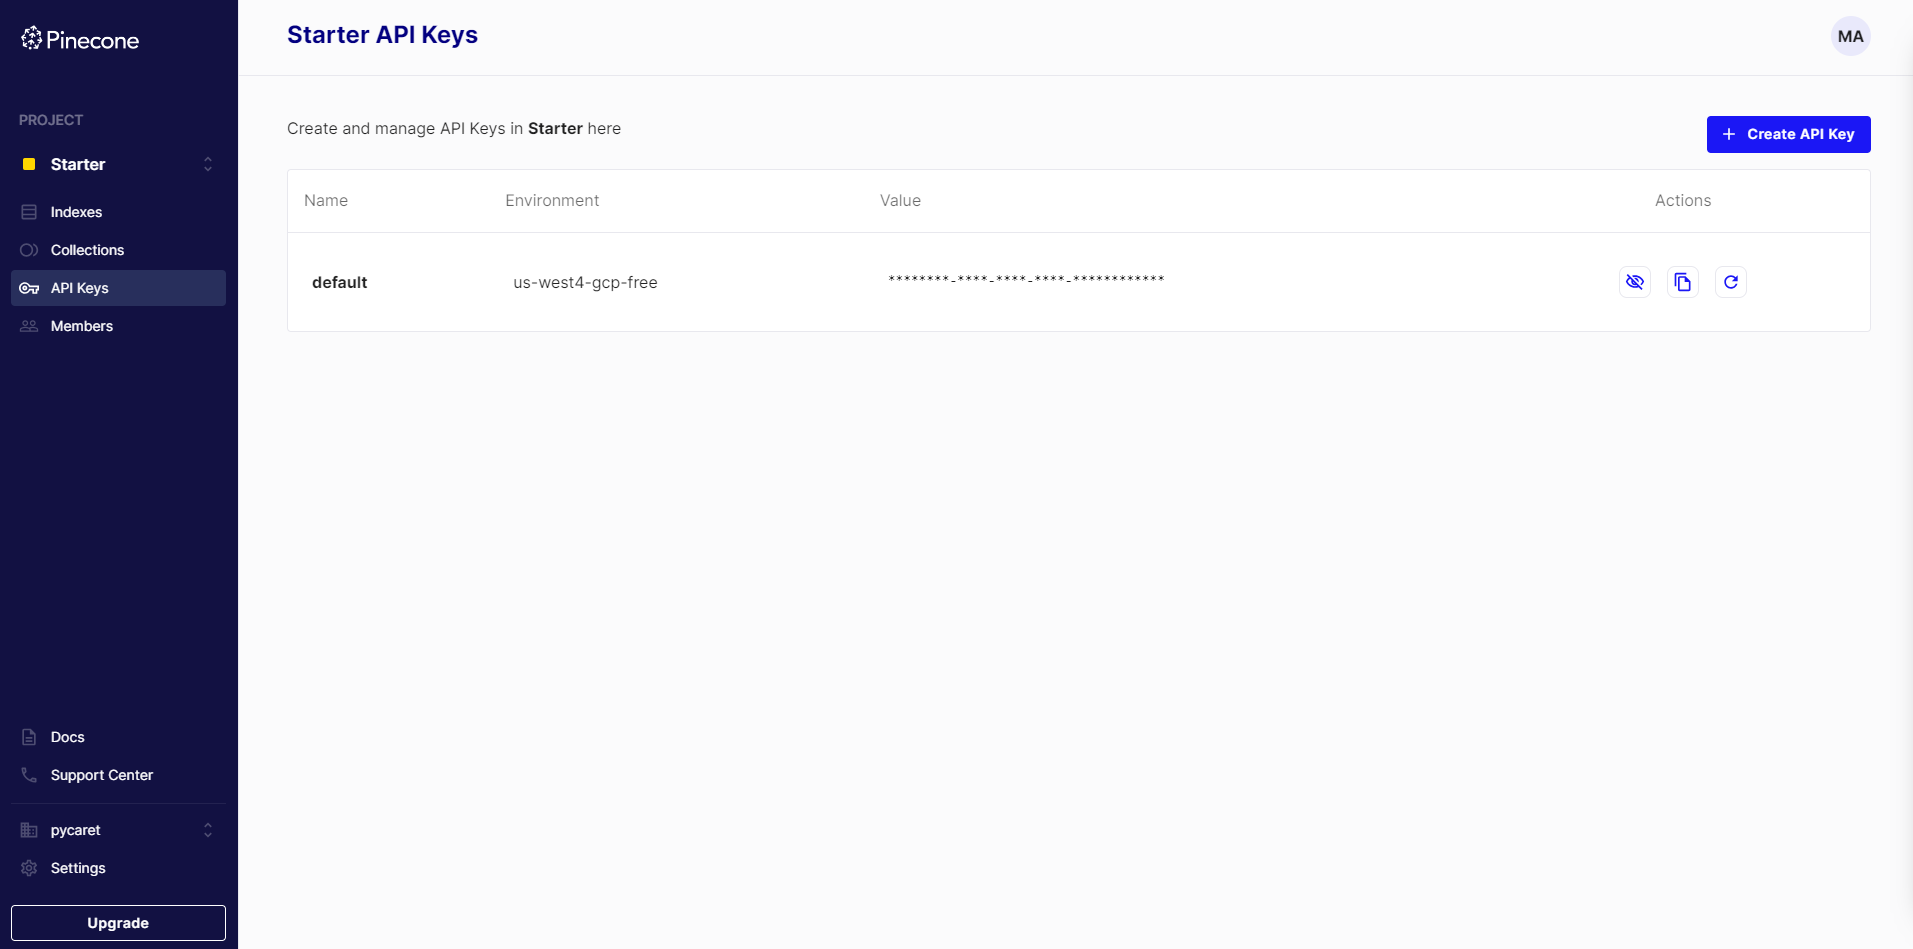
Nach der Anmeldung klickst du im Menü auf API Keys und kopierst Umgebung und API-Schlüssel. Beides brauchst du für den Python-Client von Pinecone.
Den Python-Client für Pinecone kannst du per pip installieren.
pip install pinecone-clientZentrale Konzepte in Pinecone
Bevor wir einsteigen, hier die wichtigsten Begriffe und Konzepte:
Pinecone-Index
Ein Index ist in Pinecone die oberste Organisationseinheit für Vektordaten. Er nimmt Vektoren entgegen und speichert sie, beantwortet Abfragen darauf und führt Vektoroperationen innerhalb seiner Daten aus. Jeder Index läuft auf einem oder mehreren Pods, um eine effiziente Arbeitsweise sicherzustellen.
Pods
Pods sind vorkonfigurierte Hardwareeinheiten, die Pinecone-Services hosten. Jeder Index läuft auf einem oder mehreren Pods. Zusätzliche Pods erhöhen in der Regel die Speicherkapazität, senken die Latenz und verbessern den Durchsatz. Außerdem kannst du Pods in unterschiedlichen Größen erstellen, um spezifische Anforderungen zu erfüllen.
Distanzmetriken
Distanzmetriken sind mathematische Verfahren, um die Ähnlichkeit zweier Vektoren in einem Vektorraum zu bewerten. In Vector-Datenbanken sind sie entscheidend, um gespeicherte Vektoren mit einem Query-Vektor zu vergleichen und die ähnlichsten zu finden.
Du kannst beim Erstellen eines Vector-Index zwischen verschiedenen Metriken wählen:
- Kosinus-Ähnlichkeit. Misst den Kosinus des Winkels zwischen zwei Vektoren. Skala von -1 bis 1: 1 bedeutet identisch, 0 orthogonal, -1 entgegengesetzt.
- Euklidische Distanz. Misst die Luftliniendistanz zwischen zwei Vektoren. Skala von 0 bis unendlich: 0 bedeutet identisch, größere Werte bedeuten unähnlicher.
- Skalarprodukt (Dot Product). Produkt der Beträge zweier Vektoren und des Kosinus des Winkels dazwischen. Skala von -∞ bis ∞: Positive Werte zeigen gleiche Richtung, 0 orthogonal, negative entgegengesetzte Richtung.
So prüfst du den Pinecone-API-Schlüssel
Für die Nutzung von Pinecone in Python brauchst du einen API-Schlüssel. Du findest ihn in der Pinecone-Konsole unter "API Keys". In derselben Ansicht steht auch die Umgebung deines Projekts.
import pinecone
pinecone.init(api_key="API_KEY", environment = 'ENVIRONMENT')
So erstellst du einen Pinecone-Index
Zum Erstellen eines Index in Pinecone führe einfach aus:
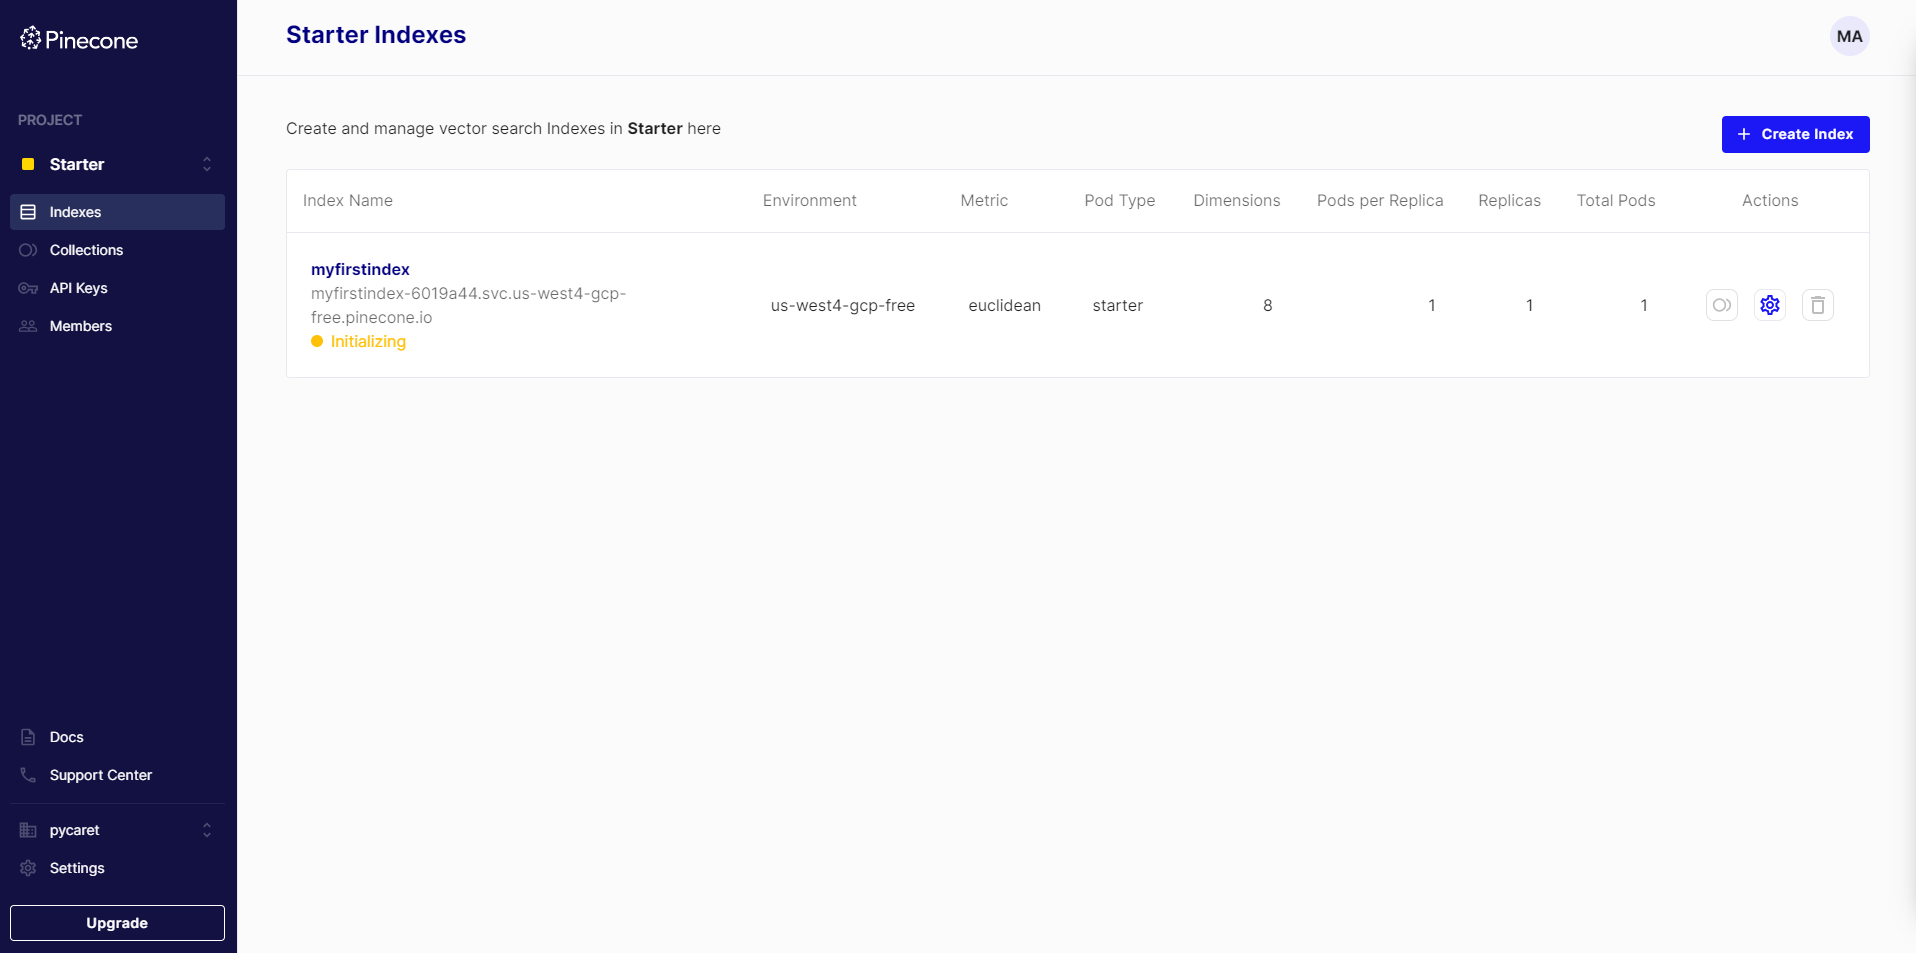
pinecone.create_index("myfirstindex", dimension=8, metric="euclidean")Direkt nach dem Ausführen siehst du in der Konsole, wie der Pinecone-Index initialisiert wird:
Daten einfügen und abfragen in Pinecone
Zum Hinzufügen von Vektoren nutzt du upsert. Der Upsert-Vorgang fügt entweder einen neuen Vektor hinzu oder aktualisiert einen bestehenden, wenn bereits ein Vektor mit derselben ID existiert. Mit den folgenden Befehlen fügst du fünf 8-dimensionale Vektoren in deinen Index ein.
index = pinecone.Index("myfirstindex")

index.upsert([
    ("A", [0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1]),
    ("B", [0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2]),
    ("C", [0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3]),
    ("D", [0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4]),
    ("E", [0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5])
])
In der Konsole siehst du nun die fünf gerade hinzugefügten Vektoren.
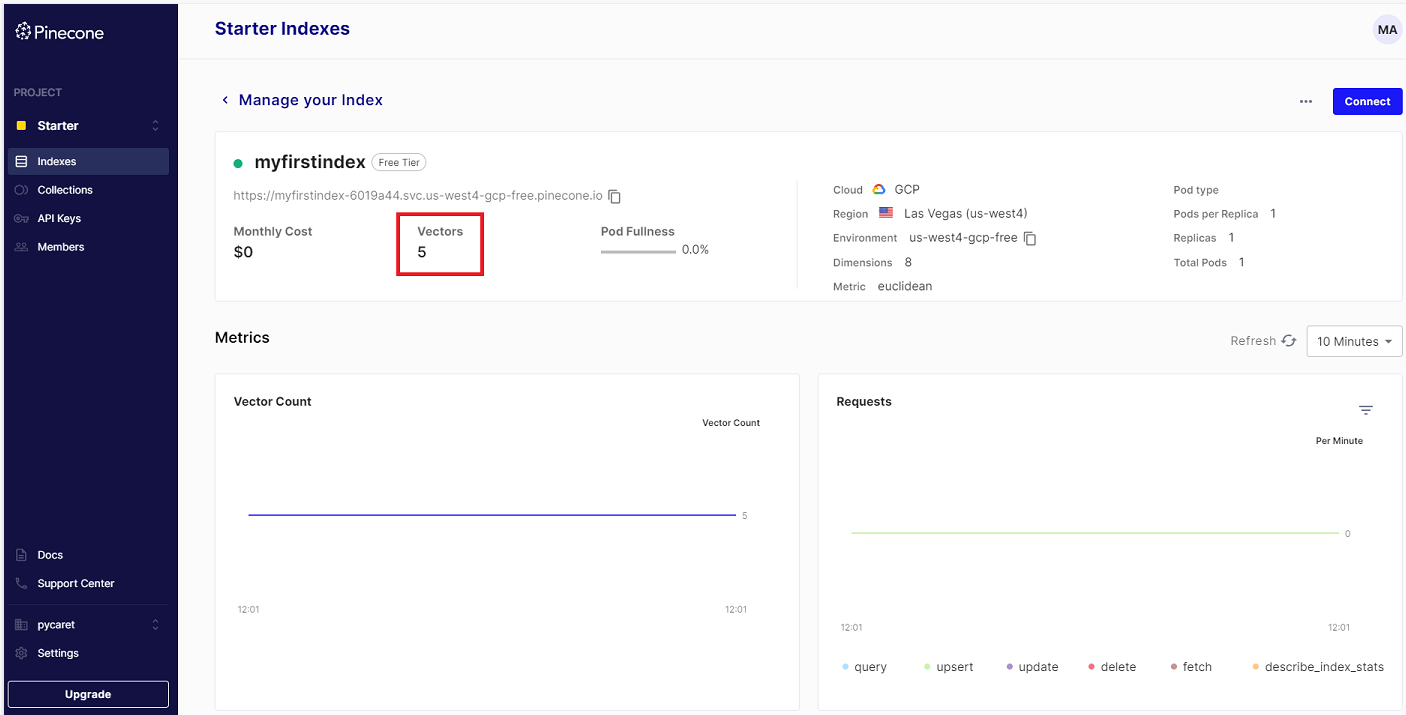
Die Dimension des Vektors prüfst du mit:
index.describe_index_stats()
>>> {'dimension': 8,
>>>  'index_fullness': 0.0,
>>>  'namespaces': {'': {'vector_count': 5}},
>>>  'total_vector_count': 5}
Den Index abfragen und ähnliche Vektoren in Pinecone finden
Im folgenden Beispiel wird der Index abgefragt, um die drei Vektoren mit der höchsten Ähnlichkeit zu einem Beispielvektor mit acht Dimensionen zu ermitteln. Dabei kommt die euklidische Distanz zum Einsatz, wie bei der Indexerstellung festgelegt.
index.query(
  vector=[0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3],
  top_k=3,
  include_values=True
)
>>> {'matches': [{'id': 'C',
>>> 'score': 0.0,
>>> 'values': [0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3]},
>>> {'id': 'D',
>>> 'score': 0.0799999237,
>>> 'values': [0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4]},
>>> {'id': 'B',
>>> 'score': 0.0800000429,
>>> 'values': [0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2]}],
>>> 'namespace': ''}
Indizes in Pinecone löschen
Wenn du den Index nicht mehr brauchst, kannst du ihn mit delete_index entfernen.
pinecone.delete_index("myfirstindex")Fazit
Dieses Tutorial hat dir einen Einblick in die Welt der Vector-Datenbanken und in Pinecone gegeben. Vector-Datenbanken sind die spezialisierte Lösung, um hochdimensionale Daten effizient zu verarbeiten – eine Fähigkeit, die in Machine Learning, Data Science und KI-Anwendungen immer wichtiger wird.
Als gemanagte Vector-Datenbank-Plattform ist Pinecone ein mächtiges Tool für Data Engineers und Data Scientists: skalierbar, mit niedriger Suchlatenz und Echtzeit-Datenaufnahme. Dank nahtloser Integration und einer leicht verständlichen API beschleunigt Pinecone den Aufbau und die Bereitstellung großskaliger ML-Anwendungen.
Außerdem hast du gesehen, wie unstrukturierte Daten funktionieren und welche zentrale Rolle Vektorembeddings bei der Umwandlung in kompakte numerische Repräsentationen für die Analyse spielen.
Wenn dich Vector-Datenbanken faszinieren und du einen Anwendungsfall siehst, probiere unseren praxisnahen Kurs Vector Databases for Embeddings with Pinecone aus. Du kannst auch Weaviate testen – eine Open-Source-Vector-Datenbank in Python. Mehr dazu erfährst du im Webinar Vector Databases for Data Science with Weaviate in Python auf DataCamp.





