Kursus
Memahami Machine Learning
2 jam
313.8K
Postingan blog ini akan memperkenalkan konsep "transfer learning" dan bagaimana konsep ini digunakan dalam aplikasi machine learning. Transfer learning bukanlah model atau teknik machine learning; melainkan sebuah "metodologi perancangan" dalam machine learning. Jenis "metodologi perancangan" lain adalah, misalnya, active learning.
Posting blog berikutnya akan menjelaskan bagaimana Anda dapat menggunakan active learning bersama transfer learning untuk memanfaatkan data yang sudah ada (dan yang baru) secara optimal. Secara luas, aplikasi machine learning yang memanfaatkan informasi eksternal untuk meningkatkan kinerja atau kemampuan generalisasi menggunakan transfer learning.
Gagasan umum dari transfer learning adalah menggunakan pengetahuan yang dipelajari dari tugas-tugas yang memiliki banyak data berlabel dalam pengaturan yang hanya memiliki sedikit data berlabel. Membuat data berlabel itu mahal, jadi memanfaatkan dataset yang ada secara optimal adalah kunci.
Dalam model machine learning tradisional, tujuan utamanya adalah melakukan generalisasi ke data yang belum pernah dilihat berdasarkan pola yang dipelajari dari data pelatihan. Dengan transfer learning, Anda mencoba memulai proses generalisasi ini dengan memanfaatkan pola yang telah dipelajari untuk tugas yang berbeda. Pada dasarnya, alih-alih memulai proses pembelajaran dari lembar kosong (sering kali diinisialisasi secara acak), Anda memulai dari pola yang telah dipelajari untuk menyelesaikan tugas lain.
Transfer pengetahuan dan pola dimungkinkan di berbagai domain. Postingan hari ini akan mengilustrasikan transfer learning dengan melihat beberapa contoh dari berbagai domain tersebut. Tujuannya adalah mendorong data scientist untuk bereksperimen dengan transfer learning dalam proyek machine learning mereka dan menyadari kelebihan serta kekurangannya.
Ada tiga alasan mengapa saya percaya pemahaman yang baik tentang transfer learning adalah keterampilan penting bagi seorang data scientist:
 |
 |
Transfer learning, seperti namanya, memerlukan kemampuan untuk mentransfer pengetahuan dari satu domain ke domain lain. Transfer learning dapat ditafsirkan pada tingkat tinggi, yakni arsitektur model NLP dapat digunakan kembali dalam masalah prediksi urutan, karena banyak masalah NLP secara inheren dapat direduksi menjadi masalah prediksi urutan. Transfer learning juga dapat ditafsirkan pada tingkat rendah, di mana Anda benar-benar menggunakan kembali parameter dari satu model dalam model lain (skip-gram, continuous bag-of-words, dll.). Persyaratan transfer learning di satu sisi spesifik masalah dan di sisi lain spesifik model. Dua bagian berikut akan membahas pendekatan tingkat tinggi dan tingkat rendah untuk transfer learning. Meskipun Anda biasanya menemukan konsep-konsep ini dengan nama yang berbeda dalam literatur, konsep payung transfer learning tetap ada.
Dalam multi-task learning, Anda melatih sebuah model pada berbagai tugas secara bersamaan. Biasanya, model deep learning digunakan karena dapat diadaptasi dengan fleksibel.
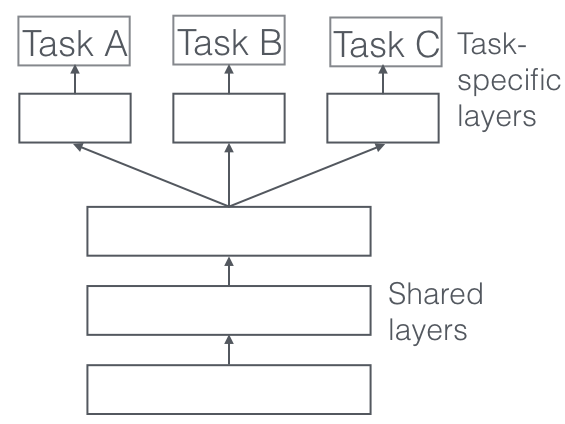
Arsitektur jaringan diadaptasi sedemikian rupa sehingga lapisan-lapisan awal digunakan di berbagai tugas, kemudian diikuti dengan lapisan dan keluaran yang spesifik untuk setiap tugas. Gagasan umum adalah bahwa dengan melatih jaringan pada berbagai tugas, jaringan akan melakukan generalisasi lebih baik, karena model dituntut berkinerja baik pada tugas-tugas yang memerlukan "pengetahuan" atau "pemrosesan" yang serupa.
Contoh dalam kasus Natural Language Processing adalah model yang tujuan akhirnya melakukan pengenalan entitas. Alih-alih melatih model semata-mata pada tugas pengenalan entitas, Anda juga menggunakannya untuk melakukan klasifikasi part-of-speech, prediksi kata berikutnya, ... Dengan demikian, model akan diuntungkan dari struktur yang dipelajari dari tugas-tugas tersebut dan dari berbagai dataset. Saya sangat merekomendasikan blog ini oleh Sebastian Rude dan blog ini, yang keduanya membahas multi-task learning untuk mempelajari lebih lanjut tentang multi-task learning.
Salah satu keunggulan besar model deep learning adalah bahwa ekstraksi fitur bersifat "otomatis". Berdasarkan data berlabel dan backpropagation, jaringan mampu menentukan fitur yang berguna untuk suatu tugas. Jaringan "menemukan" bagian input mana yang penting untuk, misalnya, mengklasifikasikan sebuah gambar. Ini berarti pekerjaan manual dalam mendefinisikan fitur dapat diabstraksikan. Jaringan deep learning dapat digunakan kembali pada masalah lain, karena jenis fitur yang diekstraksi sering kali berguna untuk masalah lain juga. Pada intinya, dalam featuriser Anda menggunakan lapisan awal jaringan untuk menentukan fitur yang berguna, tetapi Anda tidak menggunakan keluaran jaringan, karena terlalu spesifik terhadap tugas.
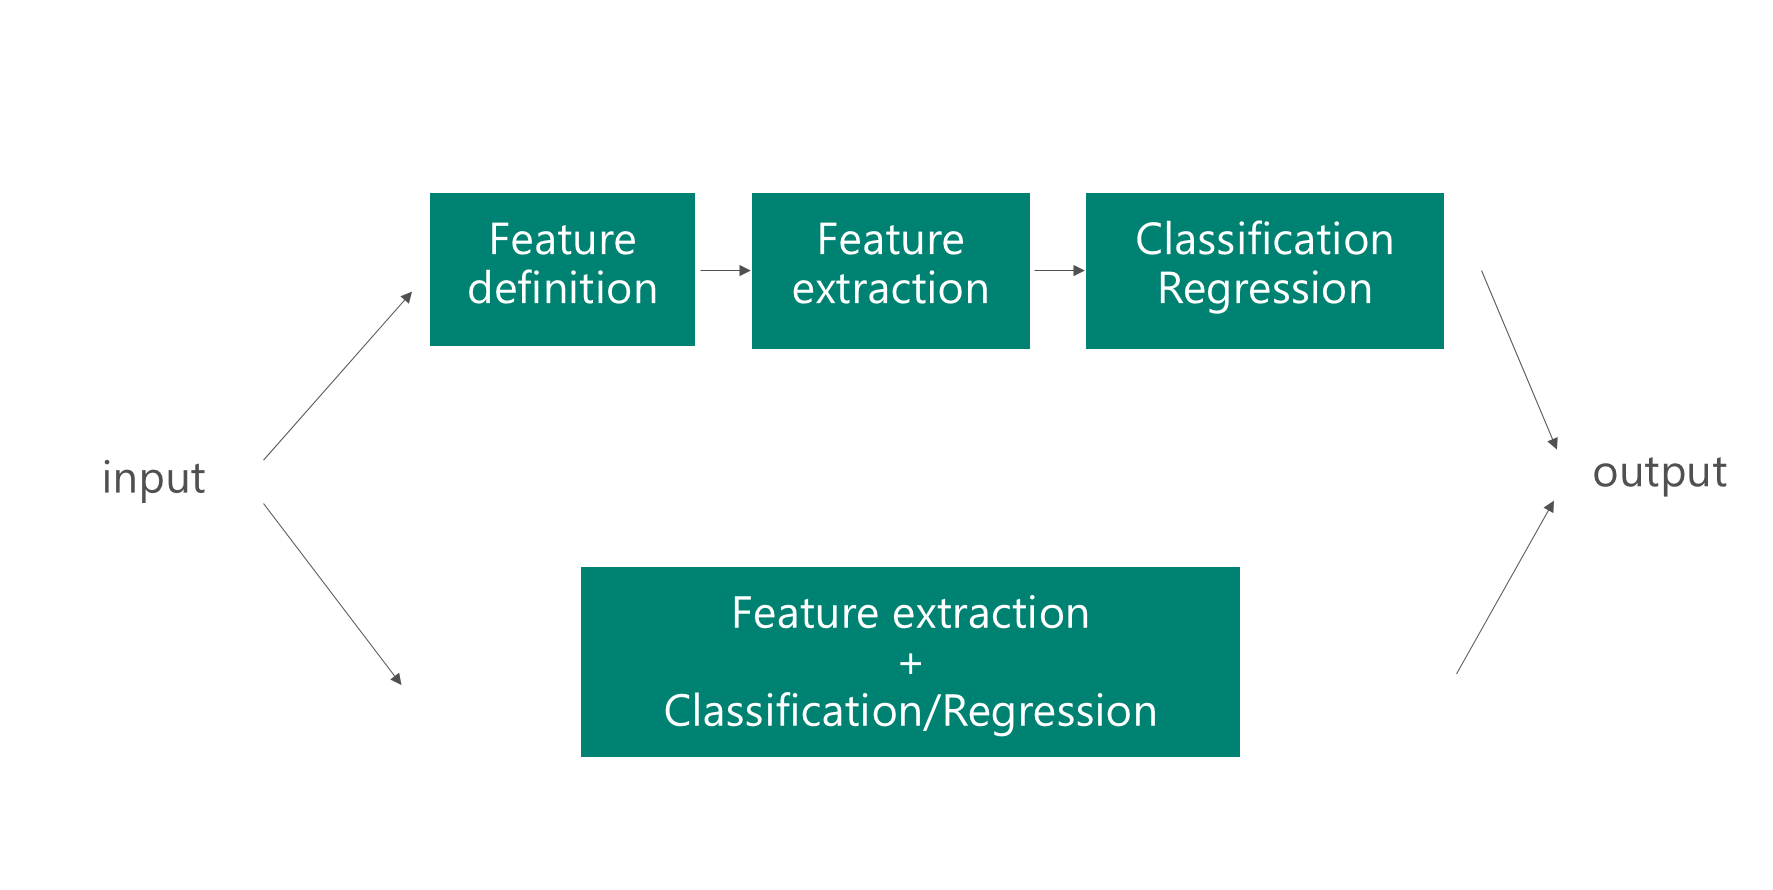
Mengingat bahwa sistem deep learning unggul dalam ekstraksi fitur, bagaimana Anda dapat menggunakan kembali jaringan yang ada untuk melakukan ekstraksi fitur bagi tugas lain? Dimungkinkan untuk memberi umpan sebuah sampel data ke dalam jaringan, dan mengambil salah satu lapisan perantara dalam jaringan sebagai keluaran. Lapisan perantara ini dapat ditafsirkan sebagai representasi tetap berdimensi tertentu dari data mentah. Biasanya, konsep featuriser digunakan dalam konteks computer vision. Gambar kemudian dimasukkan ke jaringan yang telah dilatih sebelumnya (misalnya, VGG atau AlexNet) dan metode machine learning lain digunakan pada representasi data yang baru. Mengekstraksi lapisan perantara sebagai representasi gambar secara signifikan mengurangi ukuran data asli, sehingga lebih cocok untuk teknik machine learning tradisional (misalnya, regresi logistik atau SVM bekerja lebih baik dengan representasi gambar yang kecil, seperti berdimensi 128, dibandingkan dengan dimensi asli, misalnya 128x128=16384).
Salah satu postingan blog saya sebelumnya membahas bagaimana banyak pipeline NLP saat ini menggunakan word embedding. Word embedding merupakan cara merepresentasikan kata yang lebih informatif dibandingkan one-hot encoding. Ini banyak digunakan, dan terdapat berbagai variannya. Biasanya varian-varian ini berbeda pada korpus asalnya, seperti Wikipedia, artikel berita, dll., serta perbedaan pada model embedding. Penting untuk memahami latar belakang model dan korpus ini untuk mengetahui apakah transfer learning dengan word embedding masuk akal. Orang biasanya tidak akan menyebut penggunaan word embedding sebagai transfer learning, namun saya tidak setuju, mengingat kesamaannya dengan transfer learning dalam computer vision. Pada dasarnya, menggunakan word embedding berarti Anda menggunakan featuriser atau jaringan embedding untuk mengonversi kata menjadi vektor.
Meskipun word2vec sudah berusia 4 tahun, ini masih merupakan pendekatan word embedding yang sangat berpengaruh. Di sisi lain, pendekatan terbaru seperti FastText telah membuat word embedding tersedia dalam banyak bahasa. Embedding dari word2vec atau FastText merupakan langkah maju yang signifikan dibandingkan pendekatan bag-of-words. Namun demikian, kegunaannya biasanya ditentukan oleh domain masalah.
Bayangkan Anda membangun layanan rekomendasi berita untuk tenaga penjualan. Para tenaga penjualan ingin menerima berita tentang perusahaan yang mungkin tertarik pada produk yang mereka jual. Kosakata yang digunakan dalam artikel berita biasanya cukup generik atau umum, artinya kosakata yang digunakan sering kali didukung oleh sebagian besar word embedding (tergantung pada korpus tempat mereka dilatih). Selain itu, jika Anda meminta tenaga penjualan mengumpulkan artikel berita yang mereka baca selama beberapa minggu, maka Anda langsung memiliki korpus berlabel yang besar. Dengan dapat menggunakan kembali word embedding, ada kemungkinan mesin rekomendasi akan berkinerja jauh lebih baik.
Di sisi lain, bayangkan Anda harus melakukan klasifikasi topik pada kontrak hukum. Bukan sembarang kontrak hukum, tetapi kontrak hukum berbahasa Prancis dalam konteks hukum persaingan. Dataset semacam ini biasanya tidak berlabel, atau hanya tersedia sejumlah kecil dokumen berlabel. Bagian berikut akan menjelaskan mengapa transfer learning siap pakai hanya akan membawa Anda sejauh ini dalam kasus ini:
Saya sangat menyarankan Anda membaca postingan blog yang sangat baik ini tentang kondisi terkini word embedding. Mempertimbangkan masalah dan solusi yang disebutkan dalam postingan blog ini adalah kunci untuk membuat sistem NLP dan word embedding yang andal saat bekerja dengan jumlah data terbatas.
Gensim, spacy, dan FastText adalah tiga kerangka kerja hebat yang memungkinkan Anda dengan cepat menggunakan word embedding dalam aplikasi machine learning Anda. Selain itu, mereka juga mendukung pelatihan word embedding kustom. Lihat gensim, spacy, atau tutorial FastText ini untuk mengetahui lebih lanjut!
Metode deep learning telah menghasilkan keberhasilan signifikan dalam computer vision. Alih-alih harus mendefinisikan fitur spesifik masalah secara manual, misalnya fitur Histogram of Oriented Gradients (HoG), fitur histogram, dll., deep learning memungkinkan praktisi melatih model yang mengambil gambar mentah sebagai masukan. Kompleksitas asli dalam pendefinisian fitur kini bergeser ke kompleksitas dalam mendefinisikan jaringan. Meskipun arsitektur sering digunakan kembali, tidak ada satu strategi tunggal dalam menyusun arsitektur jaringan. Biasanya, teknik deep learning ditemukan dan diterapkan dalam lingkungan riset pada dataset yang sangat besar (seperti Imagenet atau MS Coco). Untuk meningkatkan performa pada dataset besar ini, peneliti menghadirkan arsitektur jaringan dengan kedalaman dan kompleksitas yang meningkat. Arsitektur ini menghasilkan model dengan jutaan parameter yang (biasanya) tidak dapat diskalakan ke dataset gambar kecil. Melatih arsitektur seperti residual network (ResNet) atau VGG net pada dataset dengan kurang dari 5.000 gambar akan mengarah pada overfitting yang signifikan. Tren deep learning terbaru telah membawa kemajuan besar, namun tampaknya data scientist dengan dataset kecil dibiarkan kedinginan.
Ternyata, jaringan deep learning mempelajari representasi fitur hierarkis (lihat postingan blog ini oleh Distill). Ini berarti lapisan tingkat bawah mempelajari fitur tingkat rendah, seperti tepi, sedangkan lapisan tingkat atas mempelajari konsep tingkat lebih tinggi namun sulit diinterpretasikan, seperti bentuk. Gagasan representasi fitur hierarkis ini juga muncul ketika jaringan dilatih pada dataset yang berbeda, menunjukkan bahwa jaringan dapat digunakan kembali di domain masalah yang berbeda.
Dua pendekatan digunakan ketika menerapkan transfer learning pada masalah computer vision.
API Keras memungkinkan Anda memuat jaringan pra-latih dan mempertahankan beberapa lapisan tetap selama pelatihan. Pada bagian berikut, saya akan kembali membahas dua use case, masing-masing satu di mana transfer learning berguna, dan satu lagi di mana tidak.
Bayangkan Anda bekerja dalam pelestarian satwa liar, dan Anda ingin mengklasifikasikan berbagai hewan yang muncul pada umpan kamera langsung. Terutama jika Anda mencoba memantau spesies yang hampir punah, ada kemungkinan Anda tidak dapat mengumpulkan banyak data berlabel. Mengingat jaringan pra-latih sering dilatih pada domain konsep yang luas (mulai dari makanan, hewan, hingga objek), menggunakan jaringan pra-latih sebagai featuriser atau inisialisasi jelas merupakan opsi.
Di sisi lain, bayangkan Anda perlu menganalisis gambar radiografi untuk ahli onkologi. Gambar-gambar ini bukan gambar kucing-anjing pada umumnya, karena merupakan keluaran dari pemindaian yang dilakukan pada pasien. Gambar-gambar ini, meskipun dikonversi ke gambar RGB, biasanya dalam gradasi abu-abu untuk menggambarkan hasil pemindaian. Meskipun jaringan pra-latih mampu mendeteksi bentuk dan tepi dari gambar RGB, mereka kemungkinan akan kesulitan mendeteksinya pada gambar radiografi karena jenis gambar tersebut tidak ada dalam data pelatihan model pra-latih. Selain itu, dalam skenario medis, jumlah data berlabel biasanya rendah. Ada beberapa teknik untuk memanfaatkan data tanpa label (yang berpotensi melimpah), tetapi biasanya memerlukan lebih banyak pekerjaan dan penyetelan. Biasanya, teknik-teknik ini mencoba melakukan pra-pelatihan bobot jaringan klasifikasi, dengan melatih setiap lapisan secara iteratif untuk merekonstruksi gambar (menggunakan lapisan konvolusional dan dekonvolusional). Kombinasi teknik-teknik ini dan jaringan pra-latih sering digunakan untuk meningkatkan konvergensi.
Kedua metode dalam computer vision yang disebutkan di atas bergantung pada asumsi penting: pola yang diekstraksi dalam dataset asli berguna dalam konteks dataset baru. Kegunaan ini sulit diukur, namun merupakan asumsi penting yang perlu diperhatikan. Citra seismik, hiperspektral, atau bahkan medis menunjukkan kemiripan terbatas dengan gambar di ImageNet. Menentukan rambu lalu lintas mana yang terdapat dalam sebuah gambar, bagaimanapun, bergantung pada pola yang cukup serupa. Memahami domain masalah computer vision sangat penting untuk penerapannya yang sukses. Dengan mengetahui latar belakang model (dataset, teknik, dll.) yang digunakan dalam transfer learning, Anda dapat menghindari pemborosan waktu selama eksperimen dan fokus menyetel model yang berpotensi memberikan perbedaan.
Kursus Machine Learning
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



