Curso
Trabalhar com a API da OpenAI
3 h
172.6K
Após o lançamento do DeepSeek R1, a OpenAI respondeu com seu próprio modelo de raciocínio de última geração, o o3-mini. Esse novo modelo foi projetado para ser menor, mais rápido e mais eficiente que seu antecessor, o o1, enquanto se destaca em tarefas de código, STEM e resolução lógica de problemas.
A OpenAI disponibilizou esse modelo gratuitamente para todos os usuários, incluindo quem usa o ChatGPT e outras plataformas, deixando capacidades avançadas de raciocínio mais acessíveis do que nunca.
Para mais detalhes sobre o o3-mini, confira o post do blog, OpenAI’s O3: Features, O1 Comparison, Release Date & More.
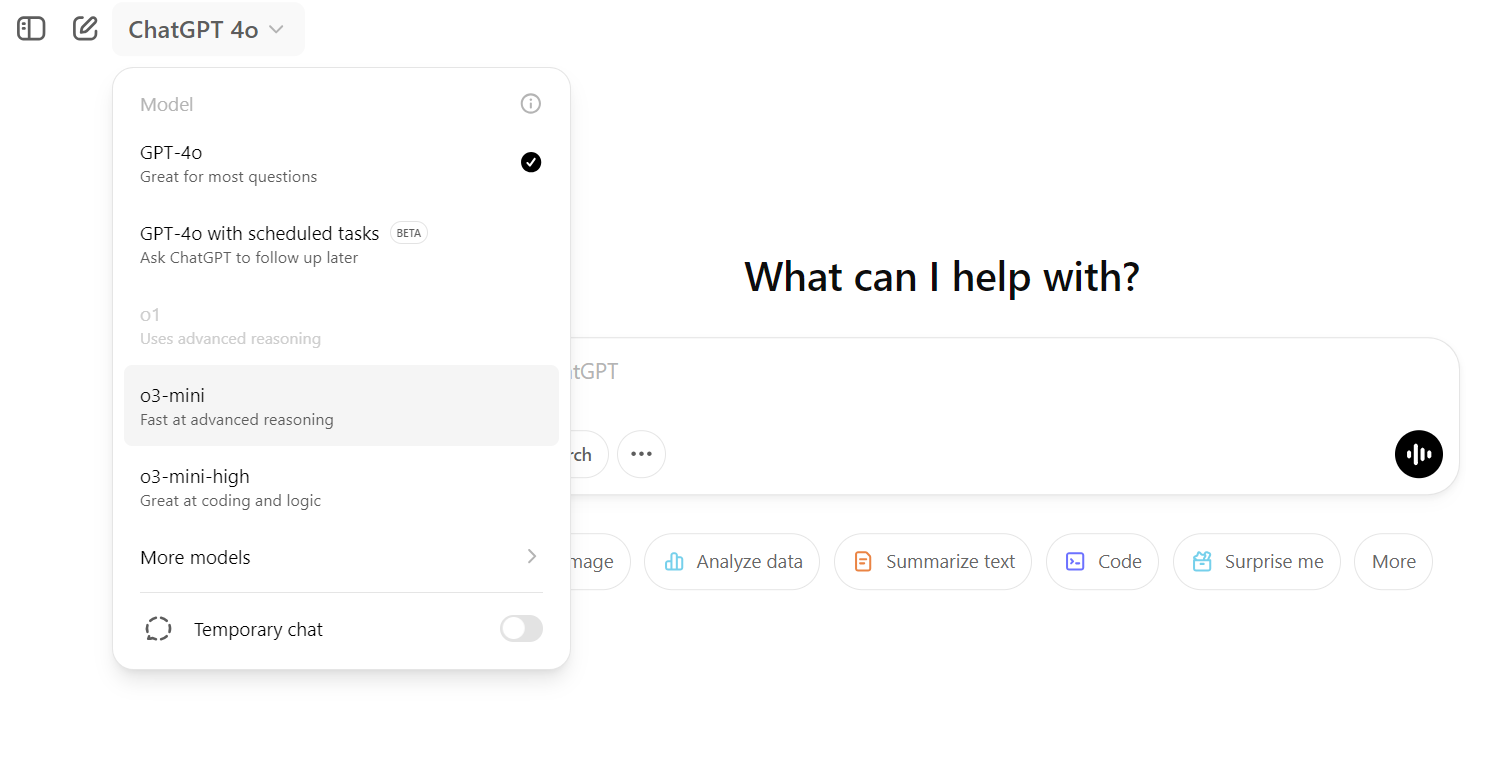
Fonte: ChatGPT
Neste tutorial, vamos explorar as capacidades técnicas do modelo o3-mini. Especificamente, vamos testar sua habilidade de lidar com tarefas técnicas complexas, gerar código confiável e fornecer instruções claras para construir, testar e fazer o deployment de um modelo de machine learning completo. Ao final, queremos entender se o o3-mini cumpre a promessa de ser um modelo de raciocínio de ponta para tarefas técnicas e lógicas.
Imagem do autor
Vamos pedir ao o3-mini para usar o dataset Placement Prediction para construir uma aplicação de machine learning que determine se um estudante é elegível para colocação profissional ou não. Do planejamento ao deployment, vamos buscar o apoio do modelo o3-mini no ChatGPT.
Na fase de planejamento, vamos fornecer ao o3-mini todas as informações necessárias e definir nossos objetivos. Vamos pedir que ele crie todas as pastas e arquivos necessários para construir, treinar e fazer o deployment da aplicação Placement Prediction.
Especificamente, vamos:
Aqui está o prompt:
“I want to build a machine learning project to predict whether a student will be placed or not based on their academic and extracurricular data. The dataset contains the following columns:

- **StudentID**: Unique identifier for each student.

- **CGPA**: The overall grades achieved by the student.

- **Internships**: Number of internships a student has completed.

- **Projects**: Number of projects a student has completed.

- **Workshops/Certifications**: Indicates whether the student has attended workshops or completed certifications to upskill themselves.

- **AptitudeTestScore**: Score achieved in an aptitude test, which evaluates quantitative and logical thinking.

- **SoftSkillRating**: A rating of the student’s communication and interpersonal skills.

- **ExtraCurricularActivities**: Indicates whether the student is active in extracurricular activities (Yes/No).

- **PlacementTraining**: Indicates whether the student has undergone placement training (Yes/No).

- **SSC and HSC**: Senior Secondary and Higher Secondary marks.

- **PlacementStatus**: The target column, which has two classes: "Placed" and "Not Placed."

Here is a sample dataset row:

StudentID,CGPA,Internships,Projects,Workshops/Certifications,AptitudeTestScore,SoftSkillsRating,ExtracurricularActivities,PlacementTraining,SSC_Marks,HSC_Marks,PlacementStatus

1,7.5,1,1,1,65,4.4,No,No,61,79,NotPlaced

I need help creating a structured project with the following components:

1. **Data Analysis**: Perform exploratory data analysis (EDA) to understand the dataset, visualize trends, and identify correlations between features and the target variable.

2. **Model Building**: Create a machine learning pipeline to preprocess the data and train a model to predict the placement status.

3. **Experiment Tracking**: Set up a system to track experiments, including model performance metrics, hyperparameters, and results.

4. **Model Training**: Train the model using appropriate algorithms and evaluate its performance using metrics like accuracy, precision, recall, and F1-score.

5. **Hyperparameter Tuning**: Optimize the model’s performance by tuning hyperparameters using techniques like grid search or random search.

6. **Model Inference Application**: Build an application (e.g., a web app or API) to allow users to input student data and get predictions on placement status.

7. **Dockerfile for Containerization**: Create a Dockerfile to containerize the application for easy deployment.

8. **Cloud Deployment**: Deploy the application on a cloud platform (e.g., AWS, Azure, or Google Cloud) to make it accessible online.

9. **Accessing the Model**: Provide a way to access the deployed model via an API or web interface.

Please provide the following:

- A folder structure for organizing the project files. (Also provide bash command for creating the folders and files.)

- Python scripts or code snippets for each of the above components.

- Suggestions for tools and libraries to use (e.g., pandas, scikit-learn, Flask, Docker, etc.).

- Guidance on setting up experiment tracking (using MLflow).

- Steps for deploying the model on a Hugging Face Space.”
Em resposta, você vai receber um guia detalhado sobre a estrutura do projeto e como construir tudo do zero.
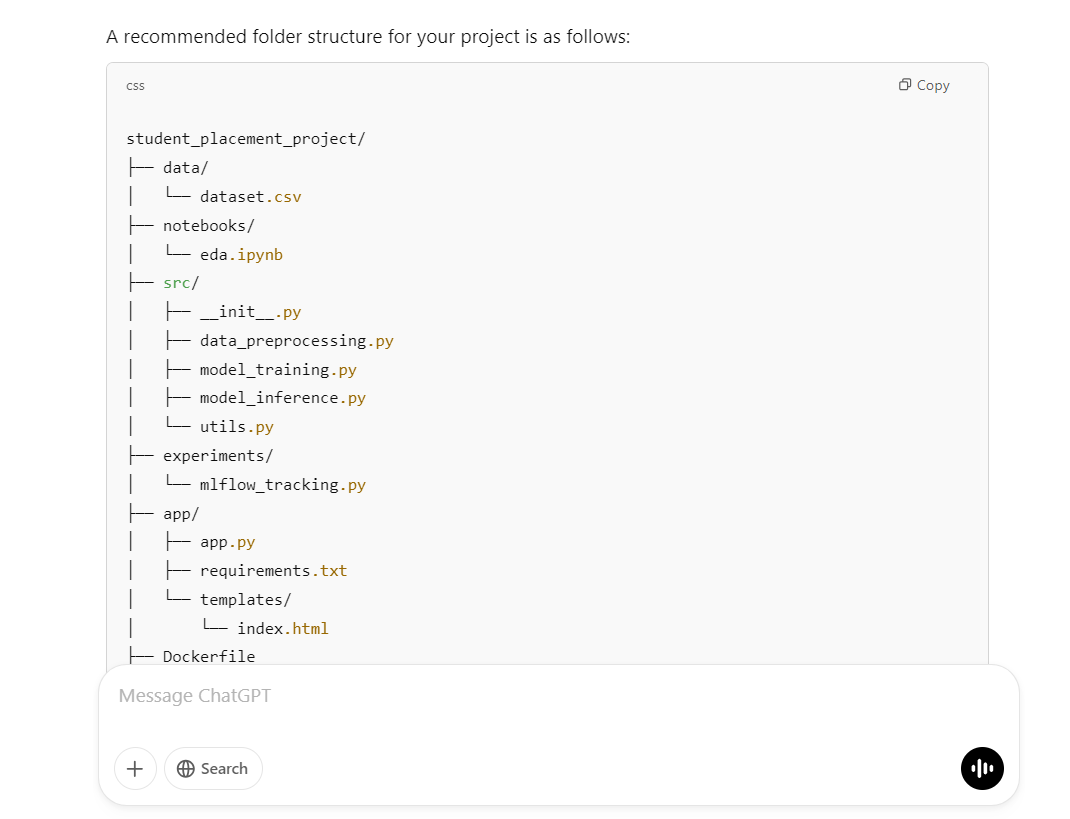
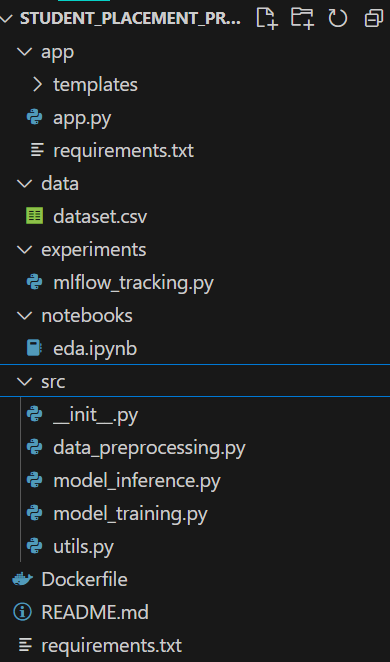
O script fornecido vai criar o diretório do projeto, as pastas e todos os arquivos necessários:
mkdir -p student_placement_project/{data,notebooks,src,experiments,app/templates}
touch student_placement_project/data/dataset.csv \
      student_placement_project/notebooks/eda.ipynb \
      student_placement_project/src/{__init__.py,data_preprocessing.py,model_training.py,model_inference.py,utils.py} \
      student_placement_project/experiments/mlflow_tracking.py \
      student_placement_project/app/{app.py,requirements.txt} \
      student_placement_project/app/templates/index.html \
      student_placement_project/{Dockerfile,requirements.txt,README.md}
Como podemos ver, esse script concluiu todas as tarefas necessárias para a gente.
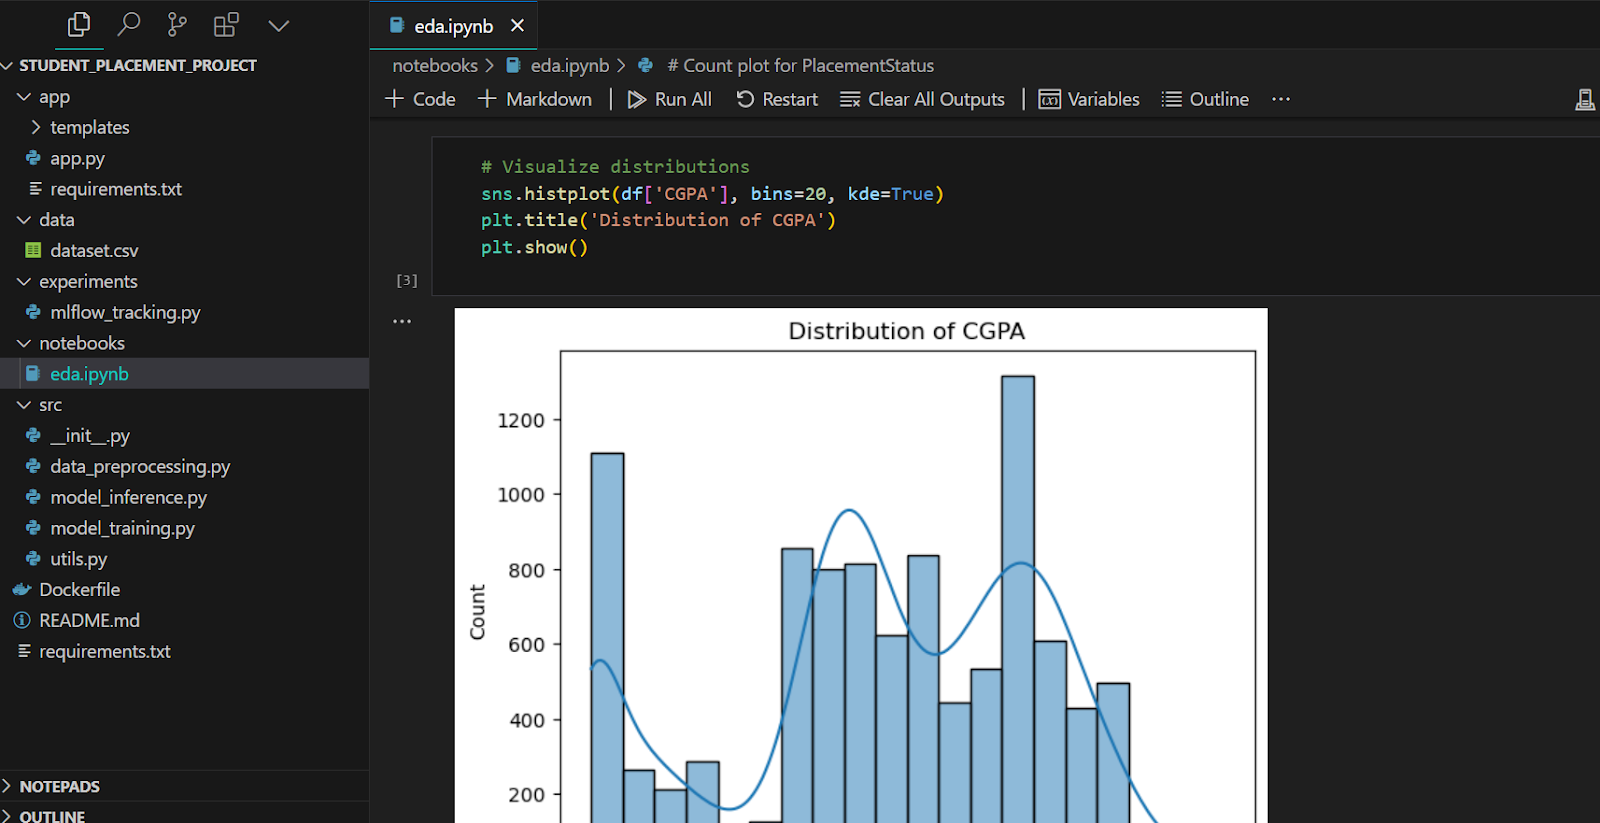
A resposta trouxe o código para o arquivo do Jupyter Notebook. Tudo o que você precisa fazer é colar o código, bloco a bloco, e executar para ver o resultado.
# notebooks/eda.ipynb
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
import numpy as np

# Load dataset
df = pd.read_csv('../data/dataset.csv')

# Basic info and descriptive statistics
print(df.info())
print(df.describe())

# Visualize distributions
sns.histplot(df['CGPA'], bins=20, kde=True)
plt.title('Distribution of CGPA')
plt.show()

# Correlation matrix
plt.figure(figsize=(10, 8))

# Compute correlation matrix only on numeric columns
numeric_df = df.select_dtypes(include=[np.number])
plt.figure(figsize=(10, 8))
corr = numeric_df.corr()
sns.heatmap(corr, annot=True, cmap="coolwarm")
plt.title("Feature Correlation Matrix")


# Count plot for PlacementStatus
sns.countplot(x='PlacementStatus', data=df)
plt.title('Placement Status Count')
plt.show()
Fica assim: toda a análise e os gráficos em um único arquivo para qualquer pessoa revisar.
Em seguida, vamos criar o arquivo de pré-processamento de dados. Tirando alguns ajustes pontuais, esse código roda sem problemas.
# src/data_preprocessing.py
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler


def load_and_preprocess_data(filepath):
    df = pd.read_csv(filepath)

    # Convert categorical columns
    df["ExtracurricularActivities"] = df["ExtracurricularActivities"].map(
        {"Yes": 1, "No": 0}
    )
    df["PlacementTraining"] = df["PlacementTraining"].map({"Yes": 1, "No": 0})
    df["Workshops/Certifications"] = df["Workshops/Certifications"].astype(
        int
    )  # assuming it's already 0/1

    # Convert target column to binary
    df["PlacementStatus"] = df["PlacementStatus"].map({"Placed": 1, "NotPlaced": 0})

    # Feature selection (excluding StudentID)
    X = df.drop(["StudentID", "PlacementStatus"], axis=1)
    y = df["PlacementStatus"]

    # Split dataset
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42
    )

    # Scaling numeric features (optional)
    scaler = StandardScaler()
    X_train_scaled = scaler.fit_transform(X_train)
    X_test_scaled = scaler.transform(X_test)

return X_train_scaled, X_test_scaled, y_train, y_test, scalerO script de treinamento importa a função de processamento, prepara os dados e depois treina o modelo de random forest. No fim, exibe as métricas de desempenho do modelo.
# src/model_training.py
import joblib
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
from data_preprocessing import load_and_preprocess_data


def train_model(data_path):
    X_train, X_test, y_train, y_test, scaler = load_and_preprocess_data(data_path)

    # Initialize and train classifier
    clf = RandomForestClassifier(n_estimators=100, random_state=42)
    clf.fit(X_train, y_train)

    # Predictions and evaluation
    y_pred = clf.predict(X_test)
    metrics = {
        "accuracy": accuracy_score(y_test, y_pred),
        "precision": precision_score(y_test, y_pred),
        "recall": recall_score(y_test, y_pred),
        "f1_score": f1_score(y_test, y_pred),
    }
    print("Model Evaluation Metrics:", metrics)

    # Save model and scaler
    joblib.dump(clf, "model_rf.joblib")
    joblib.dump(scaler, "scaler.joblib")

    return clf, scaler, metrics


if __name__ == "__main__":
    train_model("data/dataset.csv")
Uma acurácia de 78% não é nada mal.
$ python .\src\model_training.py

Model Evaluation Metrics: {'accuracy': 0.781, 'precision': 0.7462121212121212, 'recall': 0.7137681159420289, 'f1_score': 0.7296296296296296}
Se você quer se aprofundar mais no tema, confira nosso tutorial de LLMs, Fine-Tuning DeepSeek R1 (Reasoning Model). Ele aborda o fine-tuning do primeiro modelo de raciocínio open source do mundo em um dataset de cadeia de pensamento médica para desenvolver futuros médicos de IA mais eficientes.
Não queremos manter os scripts Python em uma pasta separada. Vamos mover o arquivo mlflow_tracking.py para a pasta src e remover a pasta de experimentos. Observe que você precisará fazer alguns ajustes manuais em vez de pedir ao o3-mini.
# src/mlflow_tracking.py
import mlflow
import mlflow.sklearn
from model_training import train_model


def run_experiment(data_path):
    mlflow.set_experiment("Student_Placement_Prediction")

    with mlflow.start_run():
        # Train the model
        clf, scaler, metrics = train_model(data_path)

        # Log parameters (example)
        mlflow.log_param("model_type", "RandomForest")
        mlflow.log_param("n_estimators", 100)

        # Log metrics
        mlflow.log_metric("accuracy", metrics["accuracy"])
        mlflow.log_metric("precision", metrics["precision"])
        mlflow.log_metric("recall", metrics["recall"])
        mlflow.log_metric("f1_score", metrics["f1_score"])

        # Log the model
        mlflow.sklearn.log_model(clf, "model")

        print("Experiment logged in MLflow.")


if __name__ == "__main__":
    run_experiment("data/dataset.csv")
O script Python rodou liso e gerou todas as informações.
$ python .\src\mlflow_tracking.py
Model Evaluation Metrics: {'accuracy': 0.781, 'precision': 0.7462121212121212, 'recall': 0.7137681159420289, 'f1_score': 0.7296296296296296}
2025/02/17 00:03:34 WARNING mlflow.models.model: Model logged without a signature and input example. Please set `input_example` parameter when logging the model to auto infer the model signature.
Experiment logged in MLflow.
Todos os experimentos de machine learning ficam salvos localmente e você pode visualizá-los pela interface do MLflow.
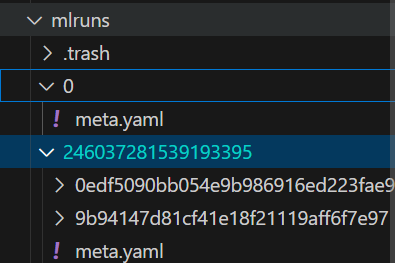
A resposta do o3-mini também traz um passo opcional para incluir no model_training.py. Adicionamos esse passo para verificar se o desempenho melhora.
# src/model_training.py
import joblib
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
from data_preprocessing import load_and_preprocess_data
from sklearn.model_selection import GridSearchCV


def tune_model(X_train, y_train):
    param_grid = {"n_estimators": [50, 100, 150], "max_depth": [None, 5, 10]}
    clf = RandomForestClassifier(random_state=42)
    grid_search = GridSearchCV(clf, param_grid, cv=5, scoring="f1")
    grid_search.fit(X_train, y_train)
    print("Best parameters:", grid_search.best_params_)
    return grid_search.best_estimator_

def train_model(data_path):
    X_train, X_test, y_train, y_test, scaler = load_and_preprocess_data(data_path)

    # Initialize and train classifier
    clf = tune_model(X_train, y_train)

    # Predictions and evaluation
    y_pred = clf.predict(X_test)
    metrics = {
        "accuracy": accuracy_score(y_test, y_pred),
        "precision": precision_score(y_test, y_pred),
        "recall": recall_score(y_test, y_pred),
        "f1_score": f1_score(y_test, y_pred),
    }
    print("Model Evaluation Metrics:", metrics)

    # Save model and scaler
    joblib.dump(clf, "model_rf.joblib")
    joblib.dump(scaler, "scaler.joblib")

    return clf, scaler, metrics


if __name__ == "__main__":
    train_model("data/dataset.csv")
Como dá para ver, o desempenho do modelo aumentou um pouco com a otimização de hiperparâmetros.
$ python .\src\model_training.py
Best parameters: {'max_depth': 5, 'n_estimators': 150}
Model Evaluation Metrics: {'accuracy': 0.791, 'precision': 0.7493917274939172, 'recall': 0.7439613526570048, 'f1_score': 0.7466666666666667}Hora de criar a inferência do modelo. Vamos desenvolver uma aplicação web em Flask.
Primeiro, precisamos carregar o modelo e o scaler. Depois, vamos processar a entrada do usuário e passá-la para o modelo gerar a predição. É uma aplicação bem simples.
import joblib
import numpy as np

app = Flask(__name__)

# Load the trained model and scaler (update paths as necessary)
model = joblib.load("model_rf.joblib")
scaler = joblib.load("scaler.joblib")


@app.route("/")
def home():
    return render_template("index.html")


@app.route("/predict", methods=["POST"])
def predict():
    try:
        # Expecting form data from the HTML template
        CGPA = float(request.form.get("CGPA"))
        Internships = int(request.form.get("Internships"))
        Projects = int(request.form.get("Projects"))
        Workshops_Certifications = int(request.form.get("Workshops_Certifications"))
        AptitudeTestScore = float(request.form.get("AptitudeTestScore"))
        SoftSkillRating = float(request.form.get("SoftSkillRating"))
        ExtracurricularActivities = request.form.get("ExtracurricularActivities")
        PlacementTraining = request.form.get("PlacementTraining")
        SSC_Marks = float(request.form.get("SSC_Marks"))
        HSC_Marks = float(request.form.get("HSC_Marks"))

        # Convert categorical fields to numerical
        extra_act = 1 if ExtracurricularActivities.lower() == "yes" else 0
        placement_training = 1 if PlacementTraining.lower() == "yes" else 0

        # Construct feature vector
        features = [
            CGPA,
            Internships,
            Projects,
            Workshops_Certifications,
            AptitudeTestScore,
            SoftSkillRating,
            extra_act,
            placement_training,
            SSC_Marks,
            HSC_Marks,
        ]

        # Scale features and make prediction
        features_scaled = scaler.transform(np.array(features).reshape(1, -1))
        prediction = model.predict(features_scaled)
        result = "Placed" if prediction[0] == 1 else "Not Placed"

        return render_template("index.html", prediction=result)
    except Exception as e:
        return render_template("index.html", prediction=f"Error: {e}")


if __name__ == "__main__":
    app.run(host='0.0.0.0', port=5000, debug=True)
Para criar a interface da aplicação, colamos o código HTML no arquivo index.html. Tudo foi fornecido pelo o3-mini. Você também pode pedir ao o3-mini para melhorar a interface.
<!-- app/templates/index.html -->
<!DOCTYPE html>
<html>
<head>
    <title>Student Placement Prediction</title>
</head>
<body>
    <h1>Student Placement Prediction</h1>
    <form action="/predict" method="post" id="predictForm">
        <!-- Create inputs for each feature. Example for CGPA: -->
        <label for="CGPA">CGPA:</label>
        <input type="number" step="0.1" id="CGPA" name="CGPA" required><br><br>
        <!-- Add more inputs as per features -->
        <button type="submit">Predict</button>
    </form>
    <div id="result"></div>
    <script>
      document.getElementById('predictForm').addEventListener('submit', async (e) => {
          e.preventDefault();
          const formData = new FormData(e.target);
          const data = Object.fromEntries(formData.entries());
          // Adjust keys to match what the API expects
          data.ExtracurricularActivities = data.ExtracurricularActivities || 'No';
          data.PlacementTraining = data.PlacementTraining || 'No';

          const response = await fetch('/predict', {
              method: 'POST',
              headers: {'Content-Type': 'application/json'},
              body: JSON.stringify(data)
          });
          const result = await response.json();
          document.getElementById('result').innerText = JSON.stringify(result);
      });
    </script>
</body>
</html>
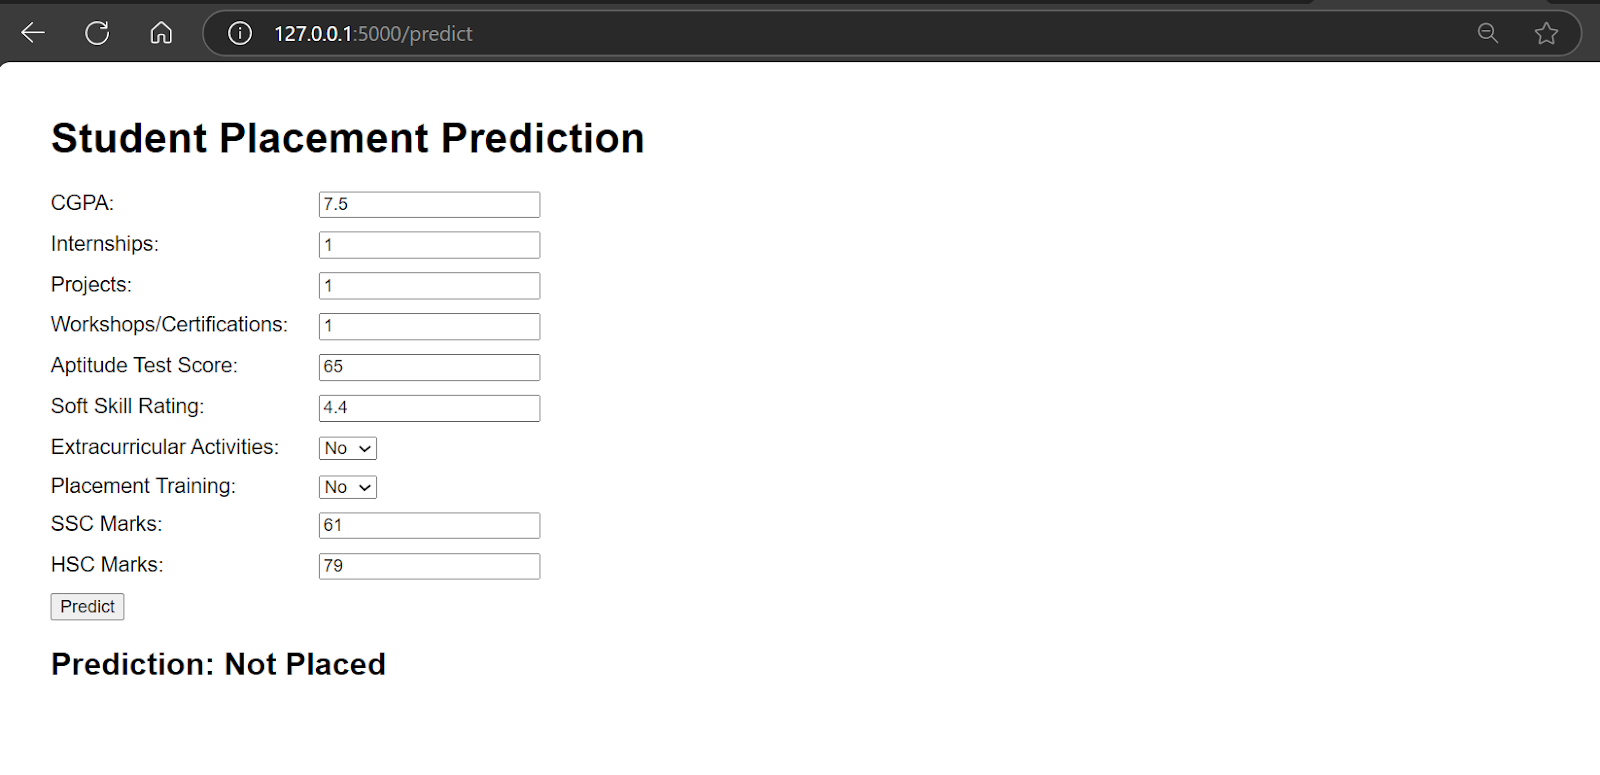
Com tudo configurado, rode o app e clique na URL gerada pelo Flask.
$ python .\app\app.py

 * Running on all addresses (0.0.0.0)
 * Running on http://127.0.0.1:5000
 * Running on http://192.168.100.41:5000
Nossa aplicação web está funcionando sem problemas.
O modelo o3-mini também nos forneceu o Dockerfile; basta construir localmente e testar antes de fazer o deployment na nuvem.
# Use an official Python runtime as a parent image
FROM python:3.12-slim

# Set the working directory in the container
WORKDIR /app

# Copy the requirements file and install dependencies
COPY requirements.txt ./
RUN pip install --upgrade pip && pip install -r requirements.txt

# Copy the entire project
COPY . .

# Expose port (adjust as necessary)
EXPOSE 5000

# Command to run the Flask app
CMD ["python", "app/app.py"]
Construa a imagem Docker com o comando abaixo.
$ docker build -t kingabzpro/student_placement . 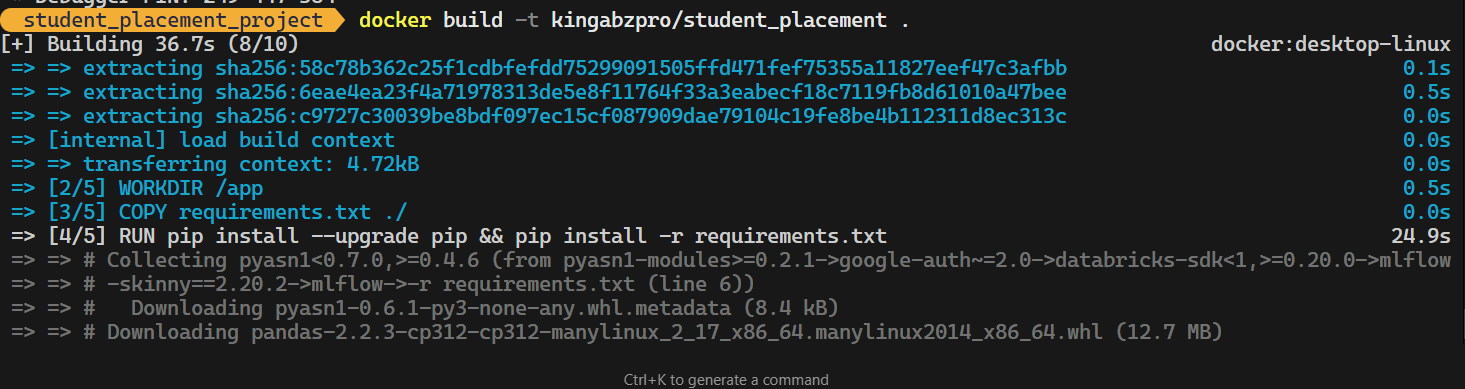
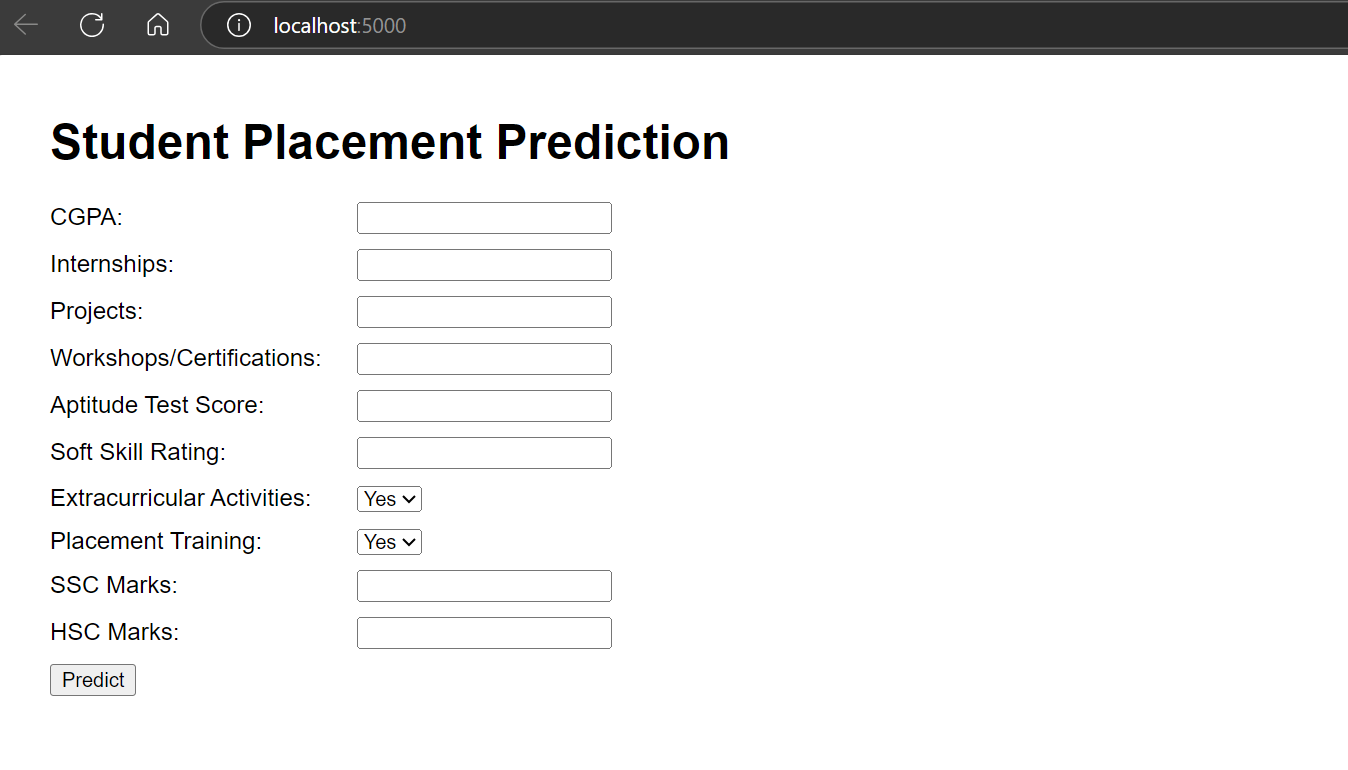
Rode a imagem Docker localmente.
$ docker run -p 5000:5000 kingabzpro/student_placementVocê pode ver que nosso Docker está rodando perfeitamente.
Chegou a hora de fazer o deployment da nossa aplicação de machine learning na nuvem da Hugging Face (Space).
Para começar, você pode criar um novo Space. Adicione todas as informações necessárias da aplicação e selecione Docker como SDK.
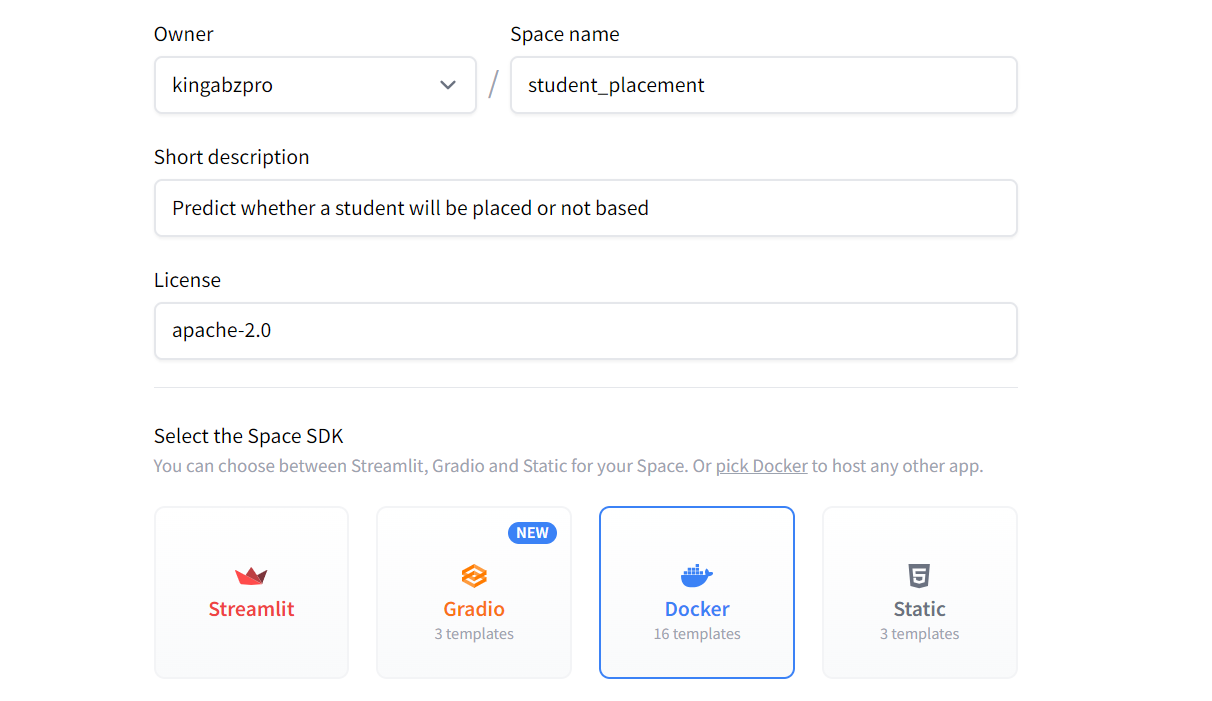
Depois disso, será gerada uma URL para você clonar a aplicação localmente.
$ git clone https://huggingface.co/spaces/kingabzpro/student_placementEm seguida, mova o modelo, o scaler, a pasta app, o Dockerfile e o requirements.txt para o repositório da aplicação.
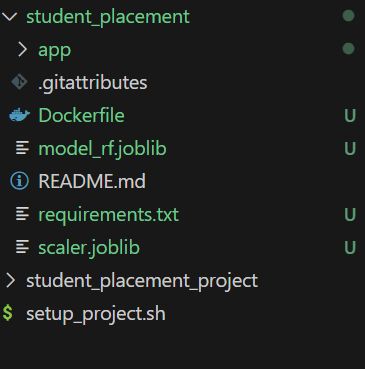
Você pode alterar o arquivo app.py atualizando a última linha para:
app.run(host="0.0.0.0", port=7860, debug=True)Verifique a porta exposta no Dockerfile. Precisamos disso para evitar erros ou conflitos de porta:
# Expose port (adjust as necessary)
EXPOSE 7860
Quando terminar as mudanças, faça o commit e dê push para o repositório remoto:
$ cd .\student_placement\
$ git add .
$ git commit -m "Initial commit of Dockerized student placement app"
$ git push
Assim que você fizer o push das alterações, a build começa e, na sequência, a interface da sua aplicação é disponibilizada.
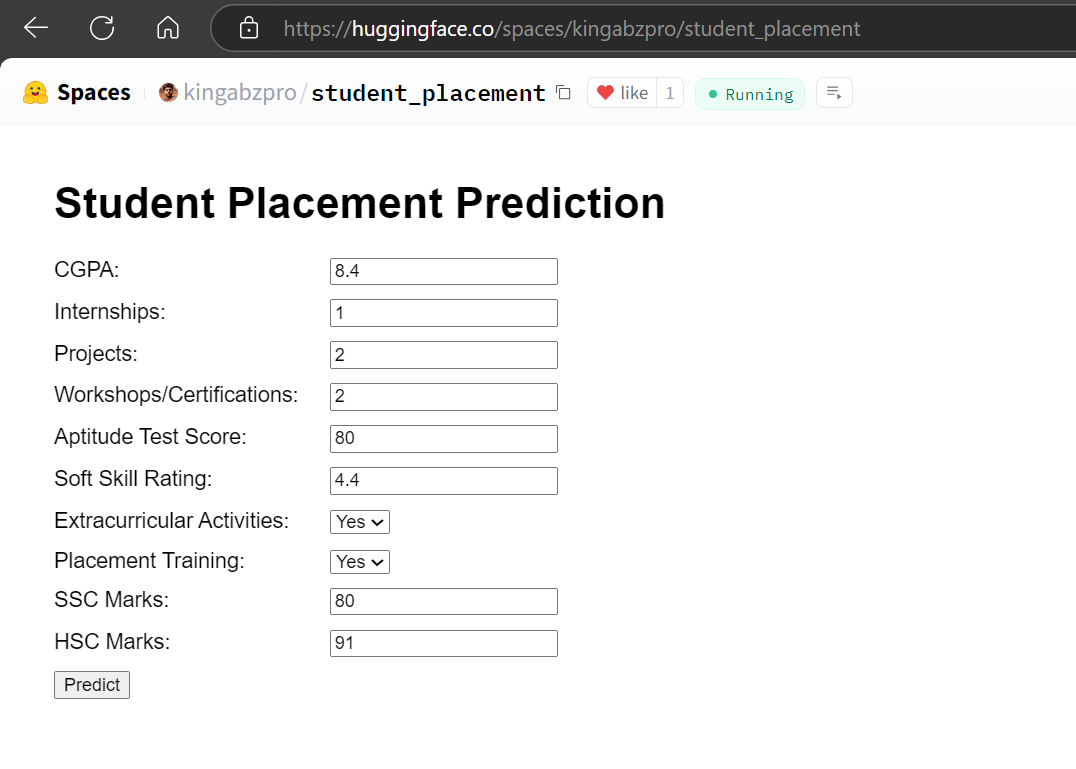
Fonte: Student Placement
O o3-mini mandou muito bem, do gerenciamento do diretório do projeto ao deployment bem-sucedido da aplicação web na nuvem.
Você também pode conhecer o modelo de ponta do Google e aprender a construir sua própria aplicação de IA seguindo o tutorial Building Multimodal AI Application with Gemini 2.0 Pro.
O modelo o3-mini é único, então é preciso cuidado ao fazer pedidos de continuação e ao depurar código. Aqui vão algumas dicas para trabalhar bem com ele:
Ao dar instruções, garanta que sejam claras e consistentes. Se você fornecer vários comandos, o o3-mini prioriza o mais recente. Isso significa que o último comando em uma sequência longa de prompts pode prevalecer e sobrescrever instruções anteriores.
Alguns problemas de código podem precisar ser resolvidos manualmente, em vez de depender do modelo. Se você pedir para o o3-mini corrigir apenas uma parte específica, ele vai alterar só aquela seção. Porém, isso pode quebrar trechos relacionados, já que o modelo nem sempre considera dependências ou o contexto mais amplo.
Inclua todos os detalhes relevantes no seu prompt, como dados brutos, linhas e colunas bem definidas e qualquer contexto adicional. Isso ajuda o modelo a entender melhor seu pedido e gerar resultados superiores.
Deixe claro o que você quer receber. Por exemplo, diga se precisa de pastas, arquivos, comandos Docker ou um passo a passo de implementação. Assim, a saída fica alinhada às suas expectativas.
Comece com um prompt base bem estruturado que cubra 90% do que você precisa. Depois que a base estiver pronta, complemente com comandos de refinamento, correções ou passos adicionais.
O o3-mini se destaca como uma escolha superior em relação ao GPT-4o, entregando desempenho mais rápido que o o1 e brilhando em tarefas como programação em Python e HTML. De forma impressionante, o código Python gerado pelo o3-mini roda sem problemas na maior parte do tempo. Ele também é capaz de aprimorar HTML, ajudando você a melhorar a interface do usuário e deixá-la mais atraente.
Neste tutorial, exploramos o poder do o3-mini no contexto de um projeto de machine learning. O o3-mini se mostra uma ótima ferramenta para cientistas de dados, engenheiros de ML e profissionais técnicos. Sua capacidade de lidar com tarefas complexas de forma eficiente o torna um ativo valioso em qualquer fluxo de trabalho.
Para obter os melhores resultados, basta fornecer um contexto completo, incluindo todo o conteúdo relevante e os entregáveis, já no prompt inicial. Depois que o modelo gerar a saída, vá para o seu editor de código, comece a executar os scripts e implemente o código e as instruções fornecidas.
Agora, você precisa aprender a fazer o deployment dos seus próprios LLMs de ponta na nuvem. Em vez de depender da OpenAI, isso te dá controle total sobre preço, acurácia e acesso aos seus dados. Siga o tutorial How to Deploy LLMs with BentoML para aprender tudo sobre esse processo.
Principais cursos da DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
15 min
blog
Kurtis Pykes
8 min
blog
Adel Nehme
15 min
blog
Abid Ali Awan
5 min
Tutorial
Zoumana Keita
14 min
Tutorial
Abid Ali Awan
12 min