
Cursus
Werken met de OpenAI API
3 uur
184.8K
Na de lancering van DeepSeek R1 heeft OpenAI gereageerd met een eigen geavanceerd redeneermodel: o3-mini. Dit nieuwe model is ontworpen om kleiner, sneller en efficiënter te zijn dan zijn voorganger, het o1-model, en blinkt uit in taken rond coderen, STEM en logisch probleemoplossen.
OpenAI heeft dit model gratis beschikbaar gemaakt voor alle gebruikers, ook voor wie ChatGPT en andere platformen gebruikt, waardoor geavanceerde redeneercapaciteiten toegankelijker zijn dan ooit.
Voor meer details over de o3-mini kun je de blogpost raadplegen, OpenAI’s O3: Features, O1 Comparison, Release Date & More.
Bron: ChatGPT
In deze tutorial verkennen we de technische capaciteiten van het o3-mini-model. We testen specifiek het vermogen om complexe technische taken aan te kunnen, nauwkeurige code te genereren en duidelijke instructies te geven voor het bouwen, testen en uitrollen van een degelijk machinelearningmodel. Aan het einde willen we bepalen of de o3-mini zijn belofte waarmaakt als toonaangevend redeneermodel voor technische en logische probleemoplossingstaken.
Afbeelding door de auteur
We vragen o3-mini om de Placement Prediction-dataset te gebruiken om een machinelearningapplicatie te bouwen die kan bepalen of een student in aanmerking komt voor plaatsing in een baan of niet. Van planning tot het uitrollen van de oplossing vragen we hulp aan het o3-mini-model op ChatGPT.
In de projectplanningsfase geven we het o3-mini-model alle benodigde informatie en schetsen we onze doelen. We vragen het om alle vereiste mappen en bestanden te maken voor het bouwen, trainen en uitrollen van de Placement Prediction-applicatie.
Concreet zullen we:
Hier is de prompt:
“I want to build a machine learning project to predict whether a student will be placed or not based on their academic and extracurricular data. The dataset contains the following columns:

- **StudentID**: Unique identifier for each student.

- **CGPA**: The overall grades achieved by the student.

- **Internships**: Number of internships a student has completed.

- **Projects**: Number of projects a student has completed.

- **Workshops/Certifications**: Indicates whether the student has attended workshops or completed certifications to upskill themselves.

- **AptitudeTestScore**: Score achieved in an aptitude test, which evaluates quantitative and logical thinking.

- **SoftSkillRating**: A rating of the student’s communication and interpersonal skills.

- **ExtraCurricularActivities**: Indicates whether the student is active in extracurricular activities (Yes/No).

- **PlacementTraining**: Indicates whether the student has undergone placement training (Yes/No).

- **SSC and HSC**: Senior Secondary and Higher Secondary marks.

- **PlacementStatus**: The target column, which has two classes: "Placed" and "Not Placed."

Here is a sample dataset row:

StudentID,CGPA,Internships,Projects,Workshops/Certifications,AptitudeTestScore,SoftSkillsRating,ExtracurricularActivities,PlacementTraining,SSC_Marks,HSC_Marks,PlacementStatus

1,7.5,1,1,1,65,4.4,No,No,61,79,NotPlaced

I need help creating a structured project with the following components:

1. **Data Analysis**: Perform exploratory data analysis (EDA) to understand the dataset, visualize trends, and identify correlations between features and the target variable.

2. **Model Building**: Create a machine learning pipeline to preprocess the data and train a model to predict the placement status.

3. **Experiment Tracking**: Set up a system to track experiments, including model performance metrics, hyperparameters, and results.

4. **Model Training**: Train the model using appropriate algorithms and evaluate its performance using metrics like accuracy, precision, recall, and F1-score.

5. **Hyperparameter Tuning**: Optimize the model’s performance by tuning hyperparameters using techniques like grid search or random search.

6. **Model Inference Application**: Build an application (e.g., a web app or API) to allow users to input student data and get predictions on placement status.

7. **Dockerfile for Containerization**: Create a Dockerfile to containerize the application for easy deployment.

8. **Cloud Deployment**: Deploy the application on a cloud platform (e.g., AWS, Azure, or Google Cloud) to make it accessible online.

9. **Accessing the Model**: Provide a way to access the deployed model via an API or web interface.

Please provide the following:

- A folder structure for organizing the project files. (Also provide bash command for creating the folders and files.)

- Python scripts or code snippets for each of the above components.

- Suggestions for tools and libraries to use (e.g., pandas, scikit-learn, Flask, Docker, etc.).

- Guidance on setting up experiment tracking (using MLflow).

- Steps for deploying the model on a Hugging Face Space.”
In ruil daarvoor krijg je een gedetailleerde reactie over de projectstructuur en hoe je alles vanaf nul opbouwt.
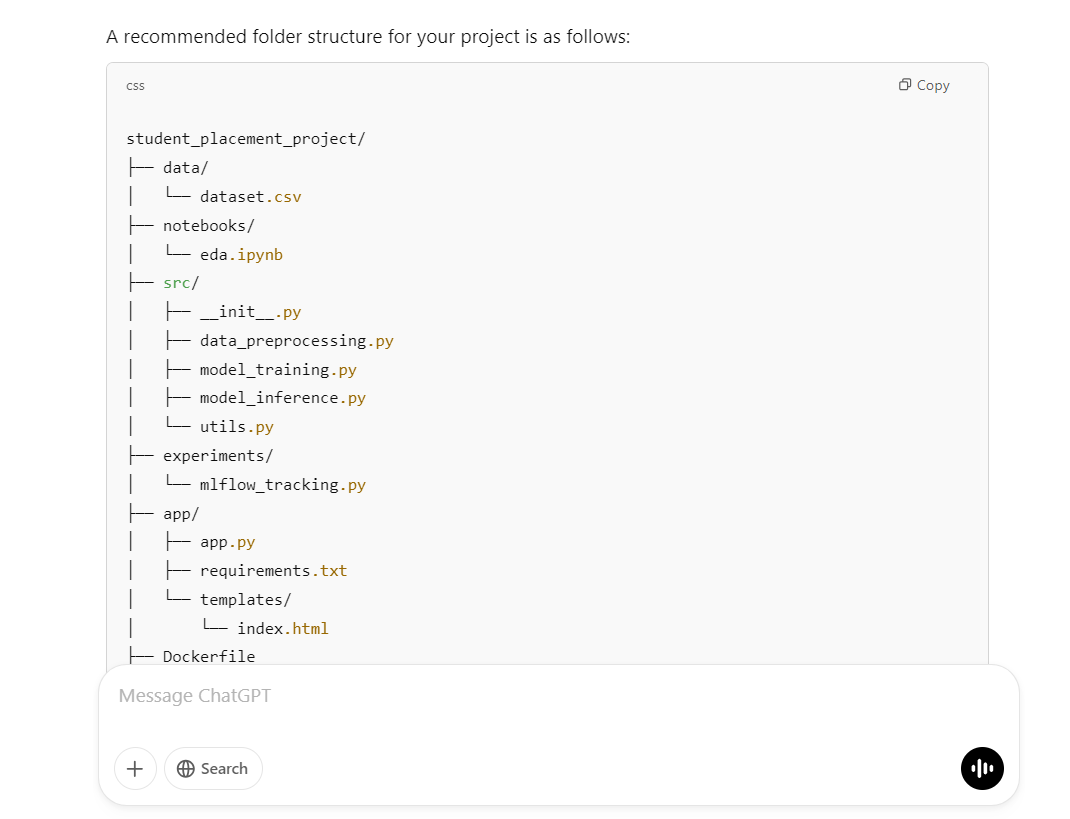
Het aangeleverde script maakt de projectmap, submappen en alle benodigde bestanden aan:
mkdir -p student_placement_project/{data,notebooks,src,experiments,app/templates}
touch student_placement_project/data/dataset.csv \
      student_placement_project/notebooks/eda.ipynb \
      student_placement_project/src/{__init__.py,data_preprocessing.py,model_training.py,model_inference.py,utils.py} \
      student_placement_project/experiments/mlflow_tracking.py \
      student_placement_project/app/{app.py,requirements.txt} \
      student_placement_project/app/templates/index.html \
      student_placement_project/{Dockerfile,requirements.txt,README.md}
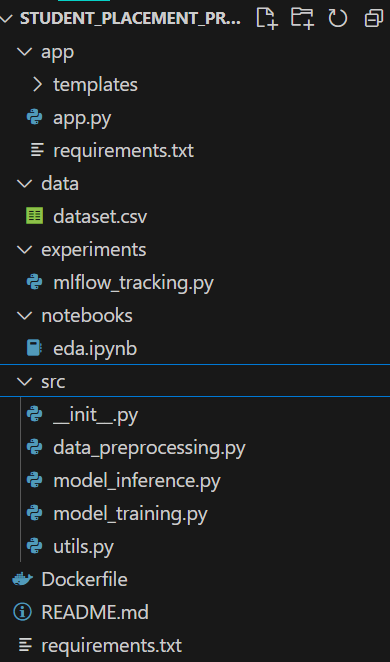
Zoals je ziet, heeft dit script alle noodzakelijke taken voor ons uitgevoerd.
De reactie bevat de code voor het Jupyter-notebookbestand. Je hoeft de code alleen maar stuk voor stuk te plakken en uit te voeren om de output te zien.
# notebooks/eda.ipynb
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
import numpy as np

# Load dataset
df = pd.read_csv('../data/dataset.csv')

# Basic info and descriptive statistics
print(df.info())
print(df.describe())

# Visualize distributions
sns.histplot(df['CGPA'], bins=20, kde=True)
plt.title('Distribution of CGPA')
plt.show()

# Correlation matrix
plt.figure(figsize=(10, 8))

# Compute correlation matrix only on numeric columns
numeric_df = df.select_dtypes(include=[np.number])
plt.figure(figsize=(10, 8))
corr = numeric_df.corr()
sns.heatmap(corr, annot=True, cmap="coolwarm")
plt.title("Feature Correlation Matrix")


# Count plot for PlacementStatus
sns.countplot(x='PlacementStatus', data=df)
plt.title('Placement Status Count')
plt.show()
Zo ziet het eruit. Alle data-analyses en grafieken staan in één bestand voor iedereen om te bekijken.
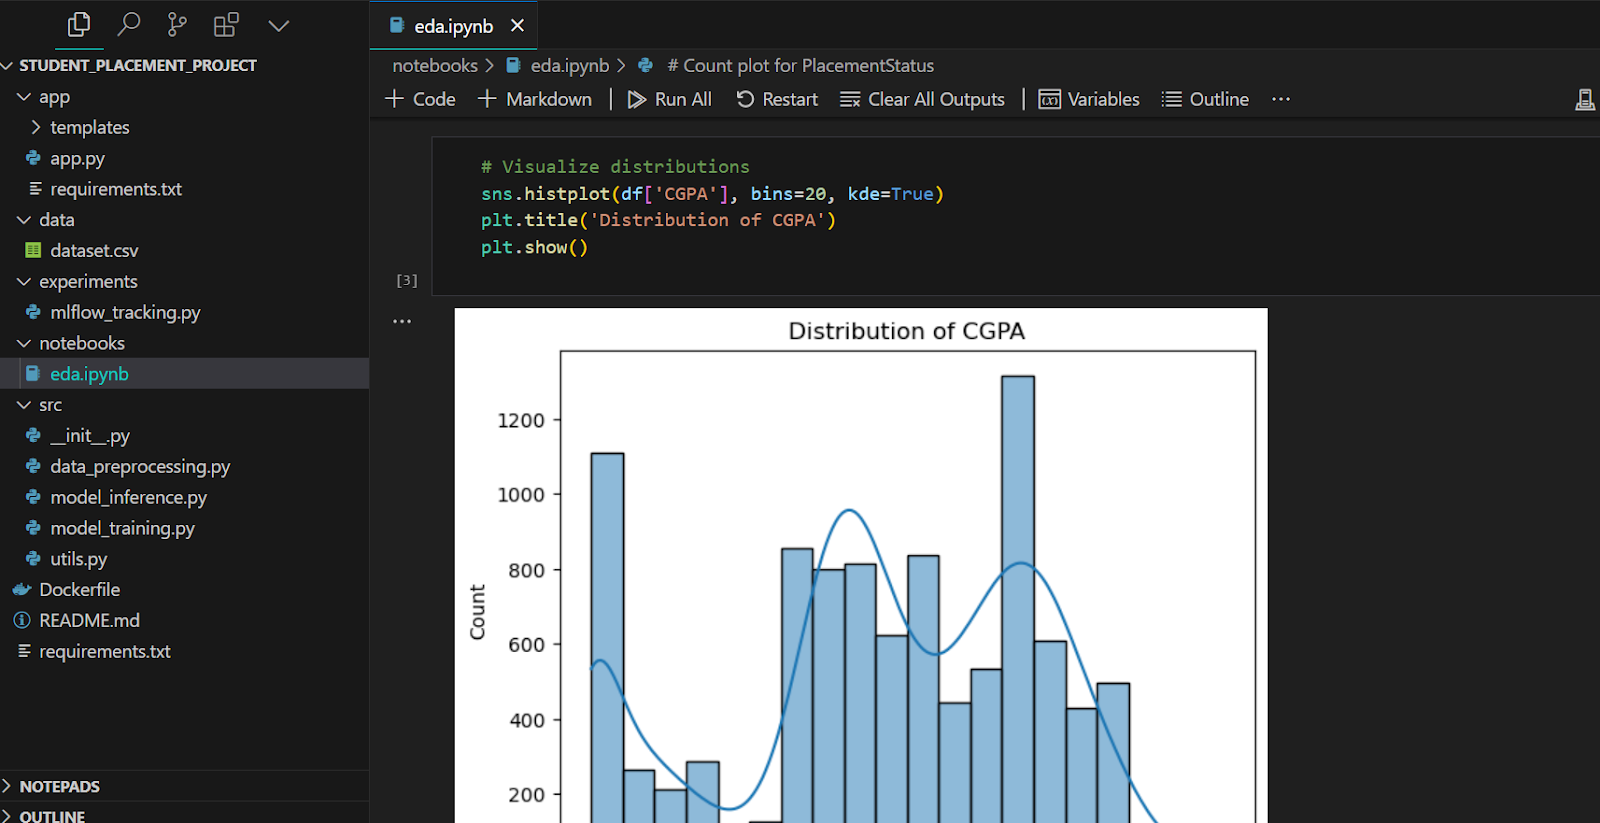
Vervolgens maken we het datavoorbewerkingbestand. Afgezien van een paar kleine aanpassingen werkt deze code soepel.
# src/data_preprocessing.py
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler


def load_and_preprocess_data(filepath):
    df = pd.read_csv(filepath)

    # Convert categorical columns
    df["ExtracurricularActivities"] = df["ExtracurricularActivities"].map(
        {"Yes": 1, "No": 0}
    )
    df["PlacementTraining"] = df["PlacementTraining"].map({"Yes": 1, "No": 0})
    df["Workshops/Certifications"] = df["Workshops/Certifications"].astype(
        int
    )  # assuming it's already 0/1

    # Convert target column to binary
    df["PlacementStatus"] = df["PlacementStatus"].map({"Placed": 1, "NotPlaced": 0})

    # Feature selection (excluding StudentID)
    X = df.drop(["StudentID", "PlacementStatus"], axis=1)
    y = df["PlacementStatus"]

    # Split dataset
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42
    )

    # Scaling numeric features (optional)
    scaler = StandardScaler()
    X_train_scaled = scaler.fit_transform(X_train)
    X_test_scaled = scaler.transform(X_test)

return X_train_scaled, X_test_scaled, y_train, y_test, scalerHet trainingsscript importeert de dataverwerkingsfunctie, verwerkt eerst de data en traint daarna het random-forestmodel. Tot slot toont het de prestatiemetrics van het model.
# src/model_training.py
import joblib
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
from data_preprocessing import load_and_preprocess_data


def train_model(data_path):
    X_train, X_test, y_train, y_test, scaler = load_and_preprocess_data(data_path)

    # Initialize and train classifier
    clf = RandomForestClassifier(n_estimators=100, random_state=42)
    clf.fit(X_train, y_train)

    # Predictions and evaluation
    y_pred = clf.predict(X_test)
    metrics = {
        "accuracy": accuracy_score(y_test, y_pred),
        "precision": precision_score(y_test, y_pred),
        "recall": recall_score(y_test, y_pred),
        "f1_score": f1_score(y_test, y_pred),
    }
    print("Model Evaluation Metrics:", metrics)

    # Save model and scaler
    joblib.dump(clf, "model_rf.joblib")
    joblib.dump(scaler, "scaler.joblib")

    return clf, scaler, metrics


if __name__ == "__main__":
    train_model("data/dataset.csv")
De nauwkeurigheid van 78% is helemaal niet slecht.
$ python .\src\model_training.py

Model Evaluation Metrics: {'accuracy': 0.781, 'precision': 0.7462121212121212, 'recall': 0.7137681159420289, 'f1_score': 0.7296296296296296}
Als je meer over dit onderwerp wilt leren, bekijk dan onze populaire LLM-tutorial, Fine-Tuning DeepSeek R1 (Reasoning Model). Het behandelt het fine-tunen van ’s werelds eerste opensource-redeneermodel op de medische chain-of-thought-dataset om in de toekomst betere AI-artsen te ontwikkelen.
We willen de Python-scripts niet in een andere map houden. We verplaatsen het bestand mlflow_tracking.py naar de map src en verwijderen de experimentmap. Let op: je moet een paar kleine wijzigingen handmatig doorvoeren in plaats van dit aan het o3-mini-model te vragen.
# src/mlflow_tracking.py
import mlflow
import mlflow.sklearn
from model_training import train_model


def run_experiment(data_path):
    mlflow.set_experiment("Student_Placement_Prediction")

    with mlflow.start_run():
        # Train the model
        clf, scaler, metrics = train_model(data_path)

        # Log parameters (example)
        mlflow.log_param("model_type", "RandomForest")
        mlflow.log_param("n_estimators", 100)

        # Log metrics
        mlflow.log_metric("accuracy", metrics["accuracy"])
        mlflow.log_metric("precision", metrics["precision"])
        mlflow.log_metric("recall", metrics["recall"])
        mlflow.log_metric("f1_score", metrics["f1_score"])

        # Log the model
        mlflow.sklearn.log_model(clf, "model")

        print("Experiment logged in MLflow.")


if __name__ == "__main__":
    run_experiment("data/dataset.csv")
Het Python-script draaide soepel en genereerde alle informatie.
$ python .\src\mlflow_tracking.py
Model Evaluation Metrics: {'accuracy': 0.781, 'precision': 0.7462121212121212, 'recall': 0.7137681159420289, 'f1_score': 0.7296296296296296}
2025/02/17 00:03:34 WARNING mlflow.models.model: Model logged without a signature and input example. Please set `input_example` parameter when logging the model to auto infer the model signature.
Experiment logged in MLflow.
Alle machinelearning-experimenten worden lokaal opgeslagen, die je kunt visualiseren met de MLflow-UI.
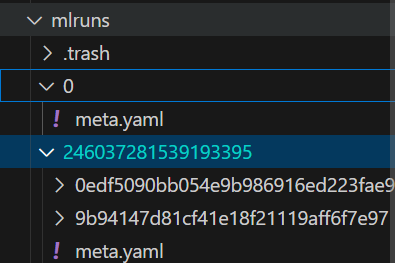
De o3-mini-reactie geeft ook een optionele stap die je kunt toevoegen aan het script model_training.py. We hebben deze stap opgenomen om te zien of de modelprestatie toeneemt.
# src/model_training.py
import joblib
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
from data_preprocessing import load_and_preprocess_data
from sklearn.model_selection import GridSearchCV


def tune_model(X_train, y_train):
    param_grid = {"n_estimators": [50, 100, 150], "max_depth": [None, 5, 10]}
    clf = RandomForestClassifier(random_state=42)
    grid_search = GridSearchCV(clf, param_grid, cv=5, scoring="f1")
    grid_search.fit(X_train, y_train)
    print("Best parameters:", grid_search.best_params_)
    return grid_search.best_estimator_

def train_model(data_path):
    X_train, X_test, y_train, y_test, scaler = load_and_preprocess_data(data_path)

    # Initialize and train classifier
    clf = tune_model(X_train, y_train)

    # Predictions and evaluation
    y_pred = clf.predict(X_test)
    metrics = {
        "accuracy": accuracy_score(y_test, y_pred),
        "precision": precision_score(y_test, y_pred),
        "recall": recall_score(y_test, y_pred),
        "f1_score": f1_score(y_test, y_pred),
    }
    print("Model Evaluation Metrics:", metrics)

    # Save model and scaler
    joblib.dump(clf, "model_rf.joblib")
    joblib.dump(scaler, "scaler.joblib")

    return clf, scaler, metrics


if __name__ == "__main__":
    train_model("data/dataset.csv")
Zoals je ziet, is onze modelprestatie licht toegenomen met hyperparameteroptimalisatie.
$ python .\src\model_training.py
Best parameters: {'max_depth': 5, 'n_estimators': 150}
Model Evaluation Metrics: {'accuracy': 0.791, 'precision': 0.7493917274939172, 'recall': 0.7439613526570048, 'f1_score': 0.7466666666666667}Tijd om de modelinference te maken. We ontwikkelen een Flask-webapplicatie.
Eerst laden we het model en de scaler. Daarna verwerken we de gebruikersinput en voeren die aan het model om de voorspelling te genereren. Het is een vrij eenvoudige applicatie.
import joblib
import numpy as np

app = Flask(__name__)

# Load the trained model and scaler (update paths as necessary)
model = joblib.load("model_rf.joblib")
scaler = joblib.load("scaler.joblib")


@app.route("/")
def home():
    return render_template("index.html")


@app.route("/predict", methods=["POST"])
def predict():
    try:
        # Expecting form data from the HTML template
        CGPA = float(request.form.get("CGPA"))
        Internships = int(request.form.get("Internships"))
        Projects = int(request.form.get("Projects"))
        Workshops_Certifications = int(request.form.get("Workshops_Certifications"))
        AptitudeTestScore = float(request.form.get("AptitudeTestScore"))
        SoftSkillRating = float(request.form.get("SoftSkillRating"))
        ExtracurricularActivities = request.form.get("ExtracurricularActivities")
        PlacementTraining = request.form.get("PlacementTraining")
        SSC_Marks = float(request.form.get("SSC_Marks"))
        HSC_Marks = float(request.form.get("HSC_Marks"))

        # Convert categorical fields to numerical
        extra_act = 1 if ExtracurricularActivities.lower() == "yes" else 0
        placement_training = 1 if PlacementTraining.lower() == "yes" else 0

        # Construct feature vector
        features = [
            CGPA,
            Internships,
            Projects,
            Workshops_Certifications,
            AptitudeTestScore,
            SoftSkillRating,
            extra_act,
            placement_training,
            SSC_Marks,
            HSC_Marks,
        ]

        # Scale features and make prediction
        features_scaled = scaler.transform(np.array(features).reshape(1, -1))
        prediction = model.predict(features_scaled)
        result = "Placed" if prediction[0] == 1 else "Not Placed"

        return render_template("index.html", prediction=result)
    except Exception as e:
        return render_template("index.html", prediction=f"Error: {e}")


if __name__ == "__main__":
    app.run(host='0.0.0.0', port=5000, debug=True)
Voor de gebruikersinterface van de applicatie hebben we de HTML-code in het bestand index.html geplakt. Alles is aangeleverd door het o3-mini-model. Je kunt o3-mini zelfs vragen om de gebruikersinterface te verbeteren.
<!-- app/templates/index.html -->
<!DOCTYPE html>
<html>
<head>
    <title>Student Placement Prediction</title>
</head>
<body>
    <h1>Student Placement Prediction</h1>
    <form action="/predict" method="post" id="predictForm">
        <!-- Create inputs for each feature. Example for CGPA: -->
        <label for="CGPA">CGPA:</label>
        <input type="number" step="0.1" id="CGPA" name="CGPA" required><br><br>
        <!-- Add more inputs as per features -->
        <button type="submit">Predict</button>
    </form>
    <div id="result"></div>
    <script>
      document.getElementById('predictForm').addEventListener('submit', async (e) => {
          e.preventDefault();
          const formData = new FormData(e.target);
          const data = Object.fromEntries(formData.entries());
          // Adjust keys to match what the API expects
          data.ExtracurricularActivities = data.ExtracurricularActivities || 'No';
          data.PlacementTraining = data.PlacementTraining || 'No';

          const response = await fetch('/predict', {
              method: 'POST',
              headers: {'Content-Type': 'application/json'},
              body: JSON.stringify(data)
          });
          const result = await response.json();
          document.getElementById('result').innerText = JSON.stringify(result);
      });
    </script>
</body>
</html>
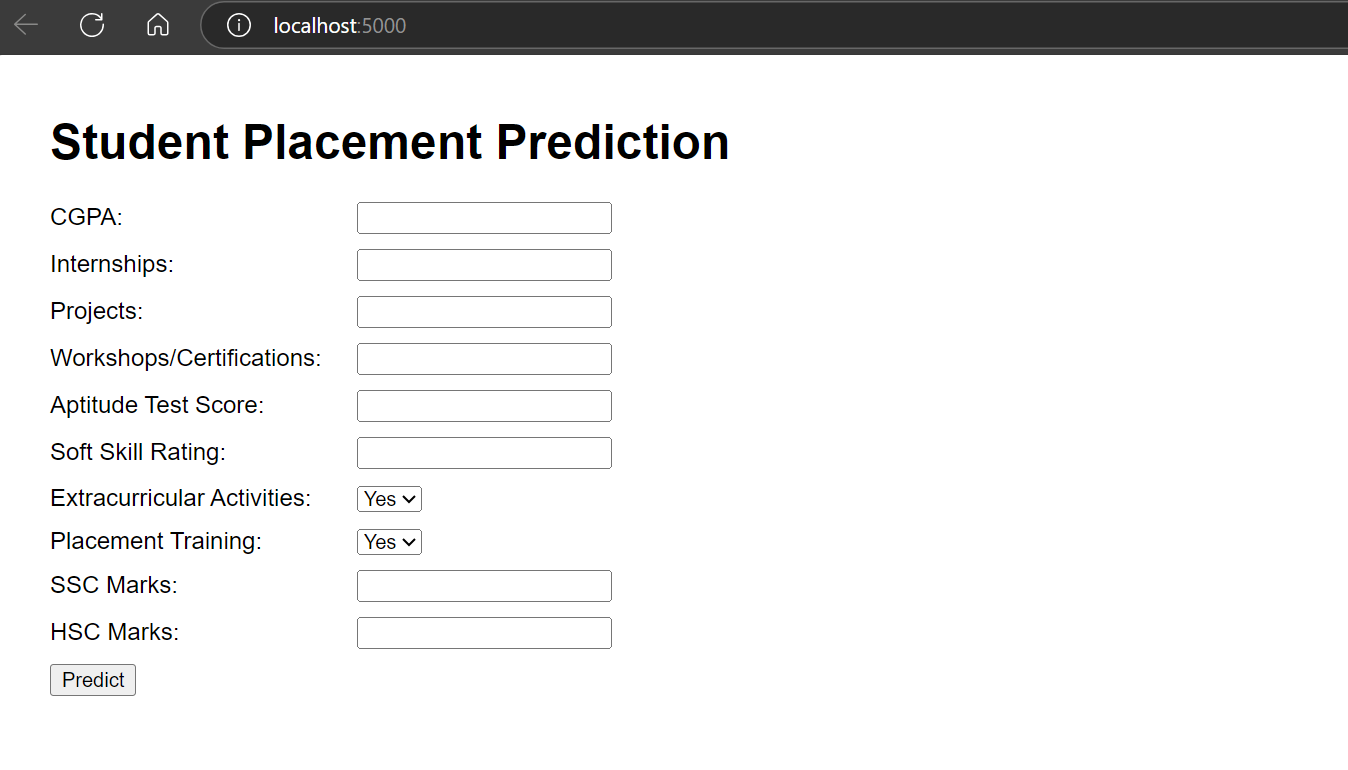
Als alles is ingesteld, start je de app en klik je op de URL die door Flask is gegenereerd.
$ python .\app\app.py

 * Running on all addresses (0.0.0.0)
 * Running on http://127.0.0.1:5000
 * Running on http://192.168.100.41:5000
Onze webapplicatie werkt probleemloos.
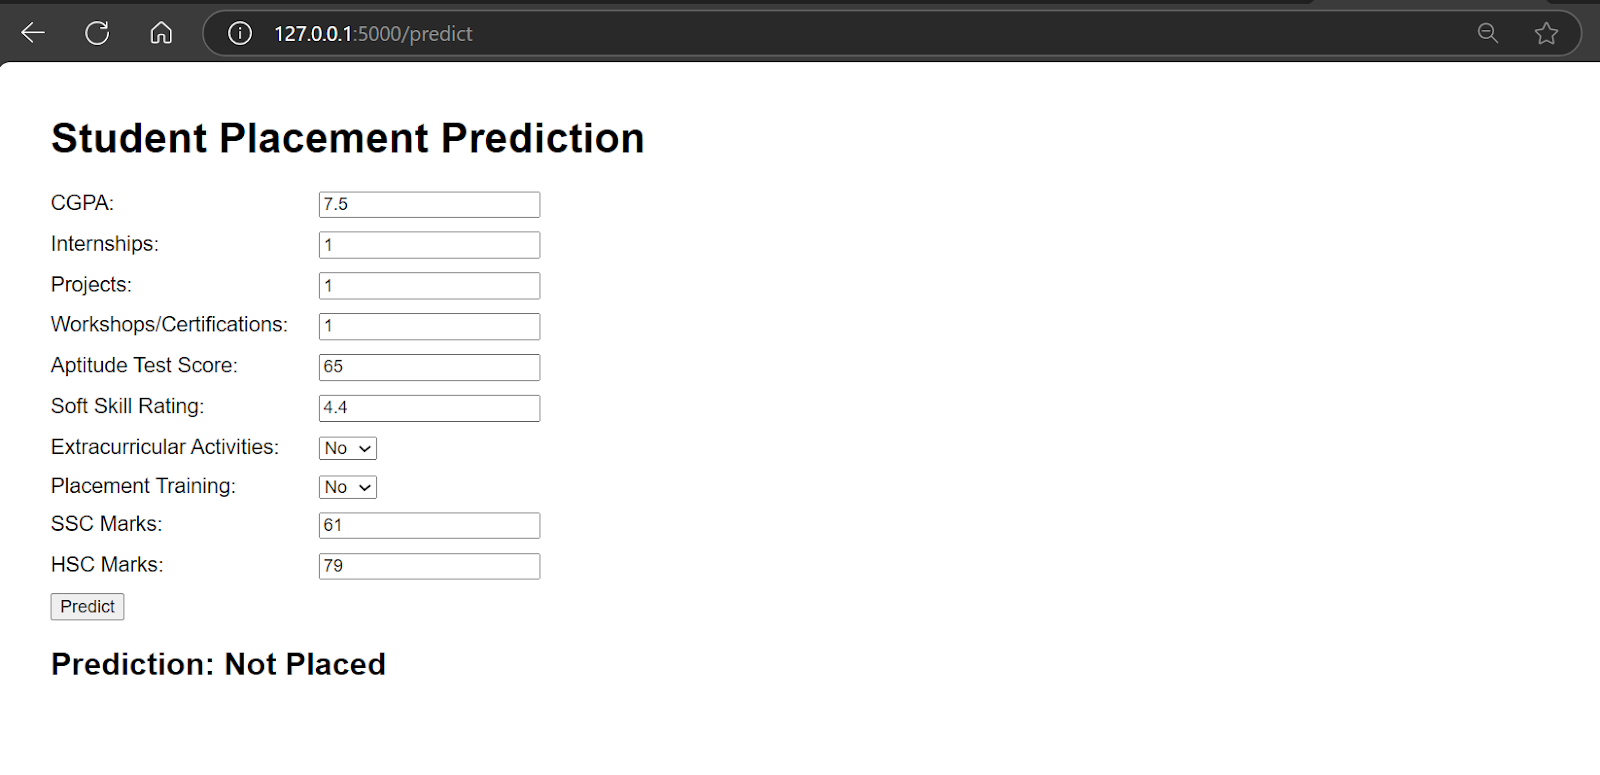
Het o3-mini-model heeft ons ook de Dockerfile geleverd; wij hoeven hem alleen lokaal te bouwen en te testen voordat we naar de cloud uitrollen.
# Use an official Python runtime as a parent image
FROM python:3.12-slim

# Set the working directory in the container
WORKDIR /app

# Copy the requirements file and install dependencies
COPY requirements.txt ./
RUN pip install --upgrade pip && pip install -r requirements.txt

# Copy the entire project
COPY . .

# Expose port (adjust as necessary)
EXPOSE 5000

# Command to run the Flask app
CMD ["python", "app/app.py"]
Bouw de Docker-image met het volgende commando.
$ docker build -t kingabzpro/student_placement . 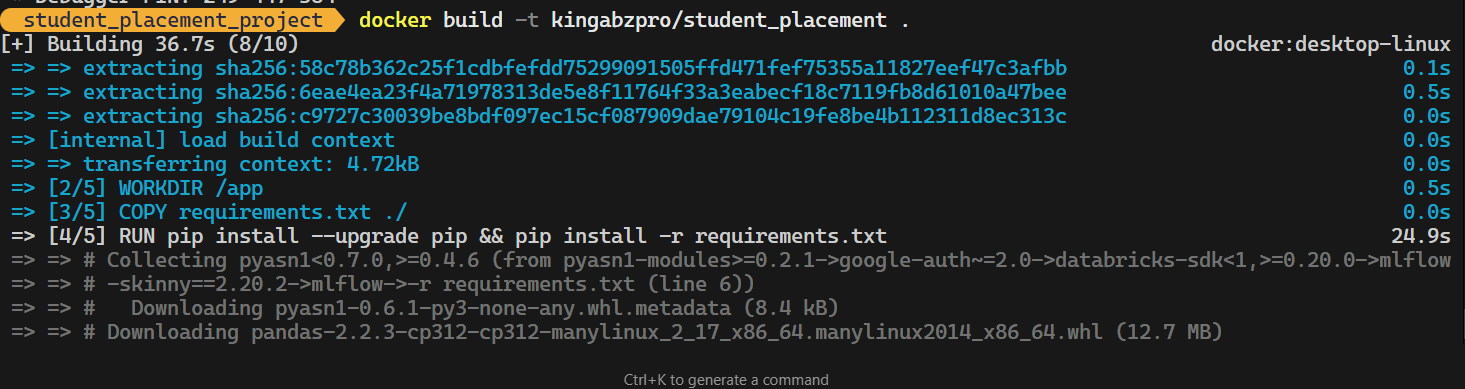
Draai de Docker-image lokaal.
$ docker run -p 5000:5000 kingabzpro/student_placementJe ziet dat onze Docker perfect draait.
9. Cloudimplementatie
Tijd om onze machinelearningapplicatie te deployen op Hugging Face Cloud (Space).
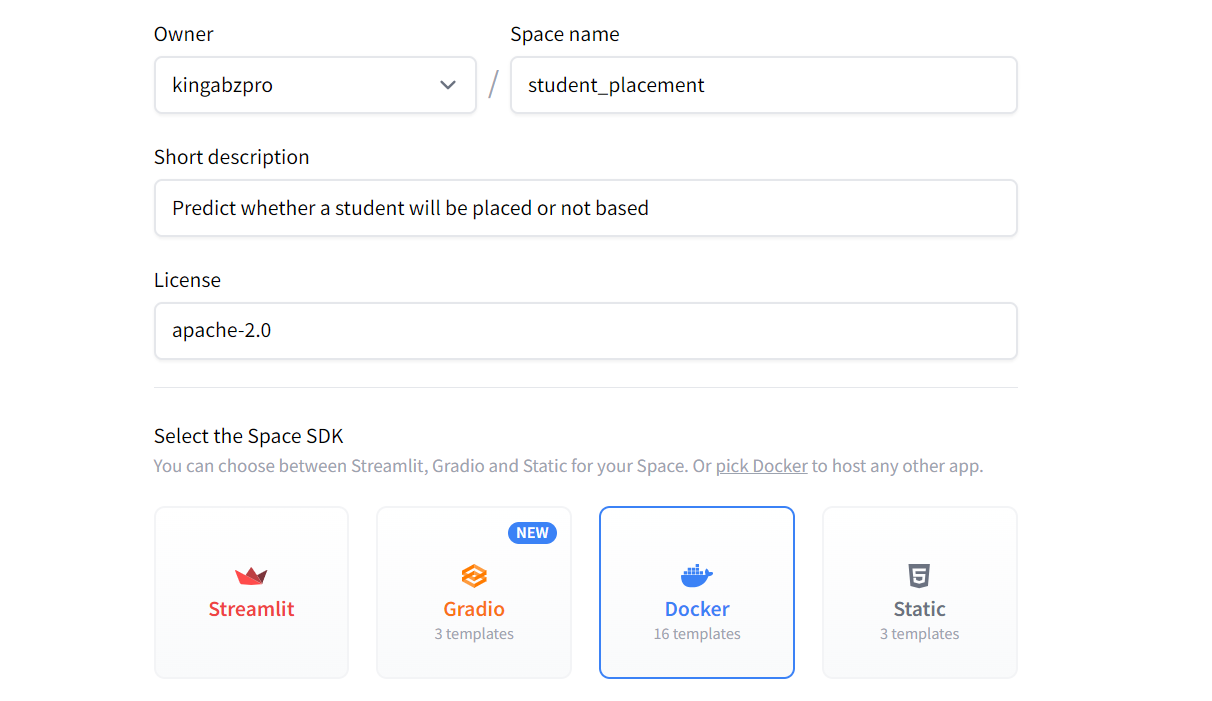
Om te starten kun je een nieuwe Space aanmaken. Vul alle benodigde informatie over de applicatie in en kies Docker als SDK.
Daarna wordt er een URL gegenereerd waarmee je de applicatie lokaal kunt clonen.
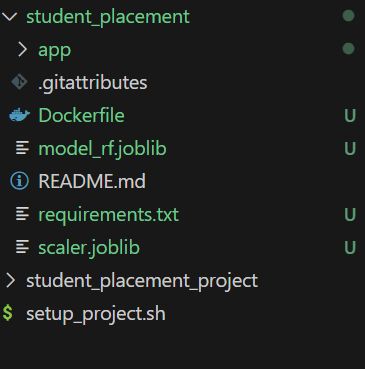
$ git clone https://huggingface.co/spaces/kingabzpro/student_placementVerplaats vervolgens het model, de scaler, de map app, de Dockerfile en requirements.txt naar de applicatierepository.
Je kunt wijzigingen aanbrengen in het bestand
app.pydoor de laatste regel te updaten naar:app.run(host="0.0.0.0", port=7860, debug=True)Controleer de blootgestelde poort in de Dockerfile. Dit moet om poortfouten of -problemen te voorkomen:
# Expose port (adjust as necessary) EXPOSE 7860Zodra je alle wijzigingen hebt doorgevoerd, commit je updates en push je ze naar de remote repository:
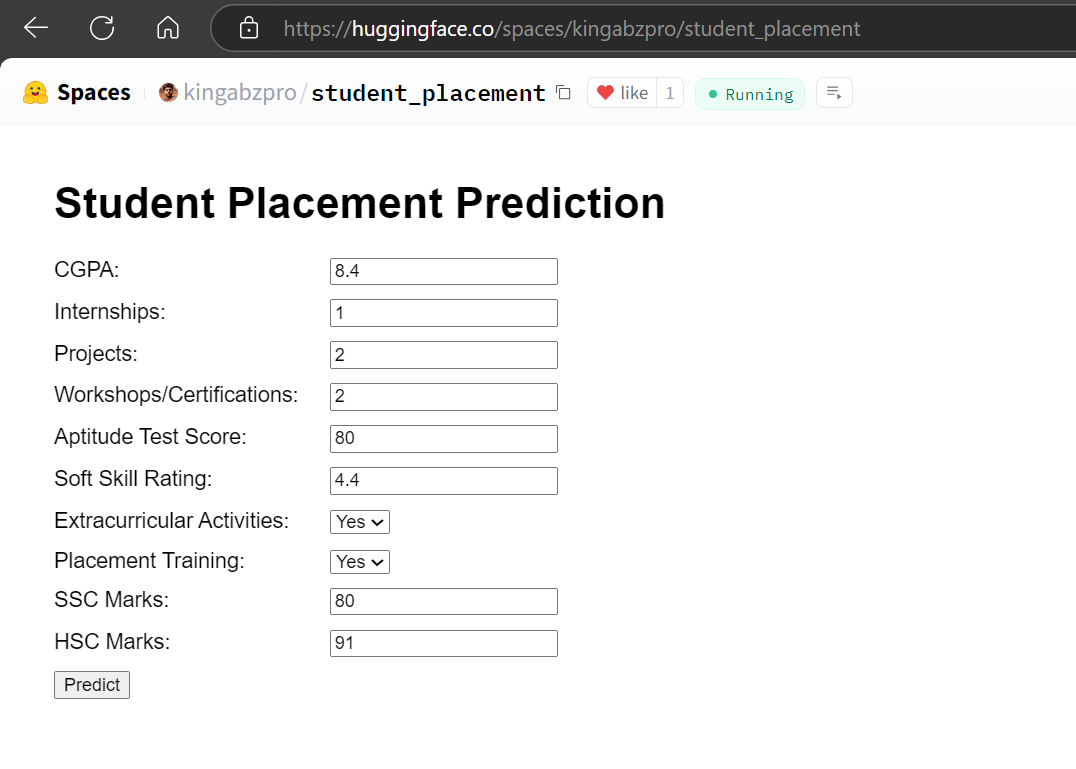
$ cd .\student_placement\ $ git add . $ git commit -m "Initial commit of Dockerized student placement app" $ git pushZodra je de wijzigingen pusht, begint de build en wordt de gebruikersinterface van je applicatie uitgerold.
Bron: Student Placement
o3-mini heeft uitstekend werk geleverd, van projectmapbeheer tot het succesvol uitrollen van de webapplicatie naar de cloud.
Je kunt ook lezen over Google’s state-of-the-artmodel en leren hoe je je eigen AI-applicatie bouwt met de tutorial Building Multimodal AI Application with Gemini 2.0 Pro.
Tips voor het schrijven van effectieve o3-mini-prompts
Het o3-mini-model is uniek, wat betekent dat je voorzichtig moet zijn bij vervolgverzoeken en het debuggen van code. Hier zijn een paar tips om er effectief mee te werken:
1. Vermijd tegenstrijdige instructies
Zorg dat je instructies duidelijk en consistent zijn. Als je meerdere opdrachten geeft, zal o3-mini de meest recente instructie prioriteren. Dit betekent dat de laatste opdracht in een lange keten van prompts voorrang krijgt en eerdere kan overschrijven.
2. Handmatig debuggen kan nodig zijn
Sommige codeproblemen moet je mogelijk handmatig oplossen in plaats van op het model te vertrouwen. Als je o3-mini vraagt om een specifiek deel van de code te fixen, zal het alleen dat stuk aanpassen. Dit kan er echter toe leiden dat gerelateerde delen van de code breken, omdat het model niet altijd rekening houdt met afhankelijkheden of de bredere context.
3. Geef volledige context
Neem alle relevante details op in je prompt, zoals ruwe data, duidelijk gedefinieerde rijen en kolommen en eventuele extra context. Dit helpt het model je verzoek nauwkeuriger te begrijpen en betere resultaten te leveren.
4. Specificeer deliverables
Beschrijf duidelijk wat je van het model verwacht. Geef bijvoorbeeld aan of je mappen, bestanden, Docker-commando’s of een stapsgewijze handleiding voor de implementatie nodig hebt. Zo sluit de output beter aan op je verwachtingen.
5. Bouw een sterke basesprompt
Begin met een goed gestructureerde basesprompt die 90% van je behoeften dekt. Als de basis staat, kun je vervolginstructies geven om te verfijnen, te repareren of extra stappen toe te voegen.
Conclusie
Het o3-mini-model steekt boven GPT-4o uit, biedt snellere prestaties dan o1 en blinkt uit in taken als Python- en HTML-codering. Opvallend is dat Python-code die door o3-mini wordt gegenereerd, meestal soepel draait zonder problemen. Het kan zelfs HTML-code verbeteren, zodat je je gebruikersinterface aantrekkelijker kunt maken.
In deze tutorial hebben we de kracht van het o3-mini-model verkend in de context van een machinelearningproject. Het o3-mini-model blijkt een uitstekend hulpmiddel voor data scientists, machinelearning engineers en technische professionals. Dankzij het vermogen om complexe taken efficiënt af te handelen is het een waardevolle aanwinst voor elke workflow.
Om de beste resultaten te krijgen, hoef je alleen maar in je initiële prompt volledige context te geven, inclusief alle relevante inhoud en deliverables. Zodra het model de output genereert, kun je naar je code-editor gaan, scripts uitvoeren en de geleverde code met de bijbehorende instructies implementeren.
Vervolgens moet je leren hoe je je eigen state-of-the-art LLM’s in de cloud uitrolt. In plaats van te vertrouwen op OpenAI, geeft dit je volledige controle over prijs, nauwkeurigheid en toegankelijkheid van je data. Volg de tutorial How to Deploy LLMs with BentoML om alles over dit proces te leren.
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

