
Cours
Travailler avec l'API OpenAI
3 h
173.1K
Après la sortie de DeepSeek R1, OpenAI a répliqué avec son propre modèle de raisonnement de pointe, o3-mini. Ce nouveau modèle a été conçu pour être plus petit, plus rapide et plus efficace que son prédécesseur, le modèle o1, tout en excellent dans les tâches liées au code, aux disciplines STEM et à la résolution logique de problèmes.
OpenAI a rendu ce modèle accessible gratuitement à tous, y compris aux utilisateurs de ChatGPT et d’autres plateformes, rendant les capacités de raisonnement avancé plus accessibles que jamais.
Pour en savoir plus sur o3-mini, consultez l’article de blog OpenAI’s O3: Features, O1 Comparison, Release Date & More.
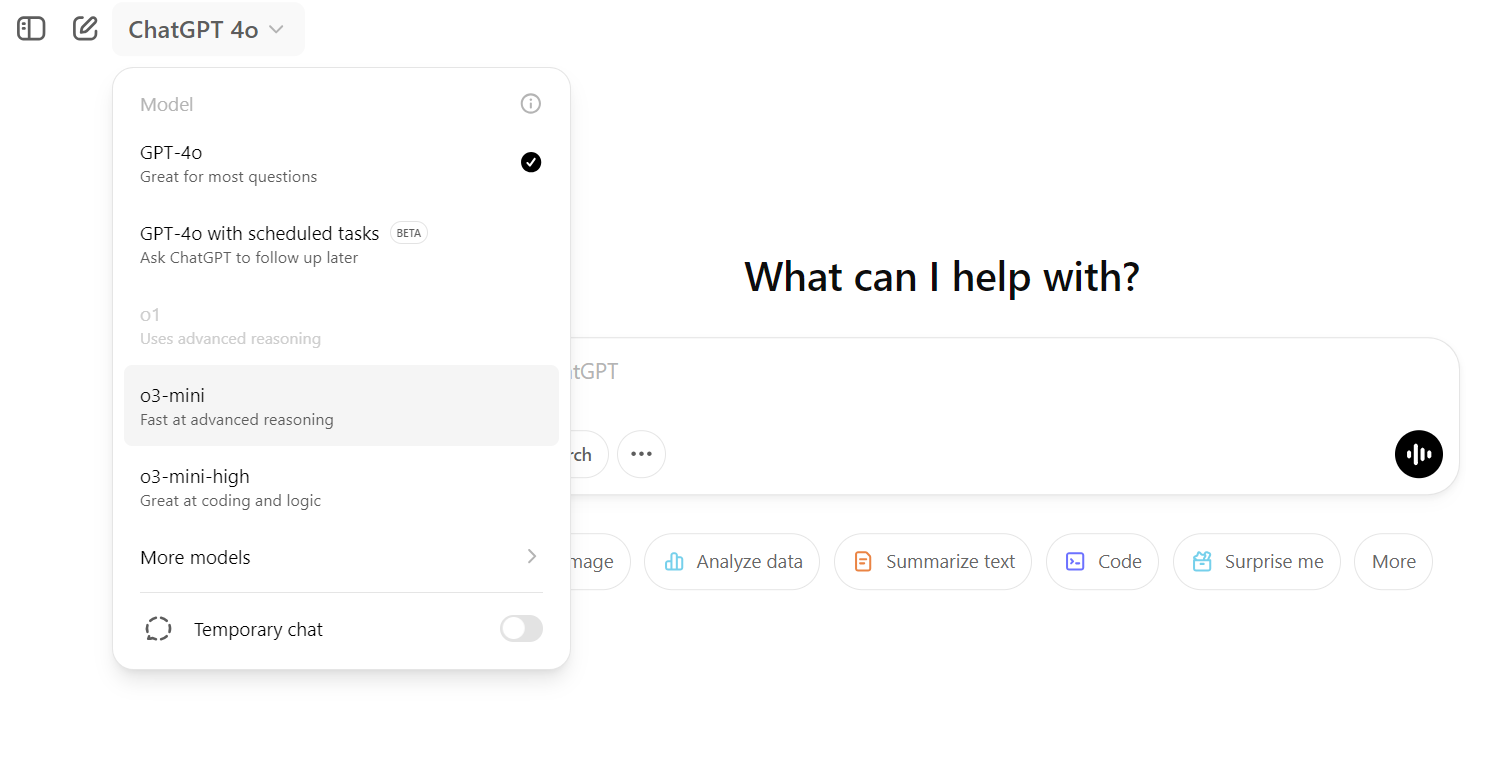
Source : ChatGPT
Dans ce tutoriel, nous allons explorer les capacités techniques du modèle o3-mini. Nous évaluerons notamment sa capacité à gérer des tâches techniques complexes, à générer du code fiable et à fournir des instructions claires pour construire, tester et déployer un véritable modèle d’apprentissage automatique. À la fin, nous déterminerons si o3-mini tient ses promesses en tant que modèle de raisonnement de pointe pour les tâches techniques et logiques.
Image par l’auteur
Nous demanderons à o3-mini d’exploiter le jeu de données Placement Prediction pour construire une application de machine learning capable de déterminer si un étudiant est éligible à une embauche ou non. De la planification au déploiement, nous solliciterons l’aide du modèle o3-mini sur ChatGPT.
Dans la phase de planification, nous fournirons à o3-mini toutes les informations nécessaires et préciserons nos objectifs. Nous lui demanderons de créer tous les dossiers et fichiers requis pour construire, entraîner et déployer l’application Placement Prediction.
Plus précisément, nous allons :
Voici le prompt :
“I want to build a machine learning project to predict whether a student will be placed or not based on their academic and extracurricular data. The dataset contains the following columns:

- **StudentID**: Unique identifier for each student.

- **CGPA**: The overall grades achieved by the student.

- **Internships**: Number of internships a student has completed.

- **Projects**: Number of projects a student has completed.

- **Workshops/Certifications**: Indicates whether the student has attended workshops or completed certifications to upskill themselves.

- **AptitudeTestScore**: Score achieved in an aptitude test, which evaluates quantitative and logical thinking.

- **SoftSkillRating**: A rating of the student’s communication and interpersonal skills.

- **ExtraCurricularActivities**: Indicates whether the student is active in extracurricular activities (Yes/No).

- **PlacementTraining**: Indicates whether the student has undergone placement training (Yes/No).

- **SSC and HSC**: Senior Secondary and Higher Secondary marks.

- **PlacementStatus**: The target column, which has two classes: "Placed" and "Not Placed."

Here is a sample dataset row:

StudentID,CGPA,Internships,Projects,Workshops/Certifications,AptitudeTestScore,SoftSkillsRating,ExtracurricularActivities,PlacementTraining,SSC_Marks,HSC_Marks,PlacementStatus

1,7.5,1,1,1,65,4.4,No,No,61,79,NotPlaced

I need help creating a structured project with the following components:

1. **Data Analysis**: Perform exploratory data analysis (EDA) to understand the dataset, visualize trends, and identify correlations between features and the target variable.

2. **Model Building**: Create a machine learning pipeline to preprocess the data and train a model to predict the placement status.

3. **Experiment Tracking**: Set up a system to track experiments, including model performance metrics, hyperparameters, and results.

4. **Model Training**: Train the model using appropriate algorithms and evaluate its performance using metrics like accuracy, precision, recall, and F1-score.

5. **Hyperparameter Tuning**: Optimize the model’s performance by tuning hyperparameters using techniques like grid search or random search.

6. **Model Inference Application**: Build an application (e.g., a web app or API) to allow users to input student data and get predictions on placement status.

7. **Dockerfile for Containerization**: Create a Dockerfile to containerize the application for easy deployment.

8. **Cloud Deployment**: Deploy the application on a cloud platform (e.g., AWS, Azure, or Google Cloud) to make it accessible online.

9. **Accessing the Model**: Provide a way to access the deployed model via an API or web interface.

Please provide the following:

- A folder structure for organizing the project files. (Also provide bash command for creating the folders and files.)

- Python scripts or code snippets for each of the above components.

- Suggestions for tools and libraries to use (e.g., pandas, scikit-learn, Flask, Docker, etc.).

- Guidance on setting up experiment tracking (using MLflow).

- Steps for deploying the model on a Hugging Face Space.”
En retour, vous obtiendrez une réponse détaillée sur la structure du projet et la façon de tout construire depuis zéro.
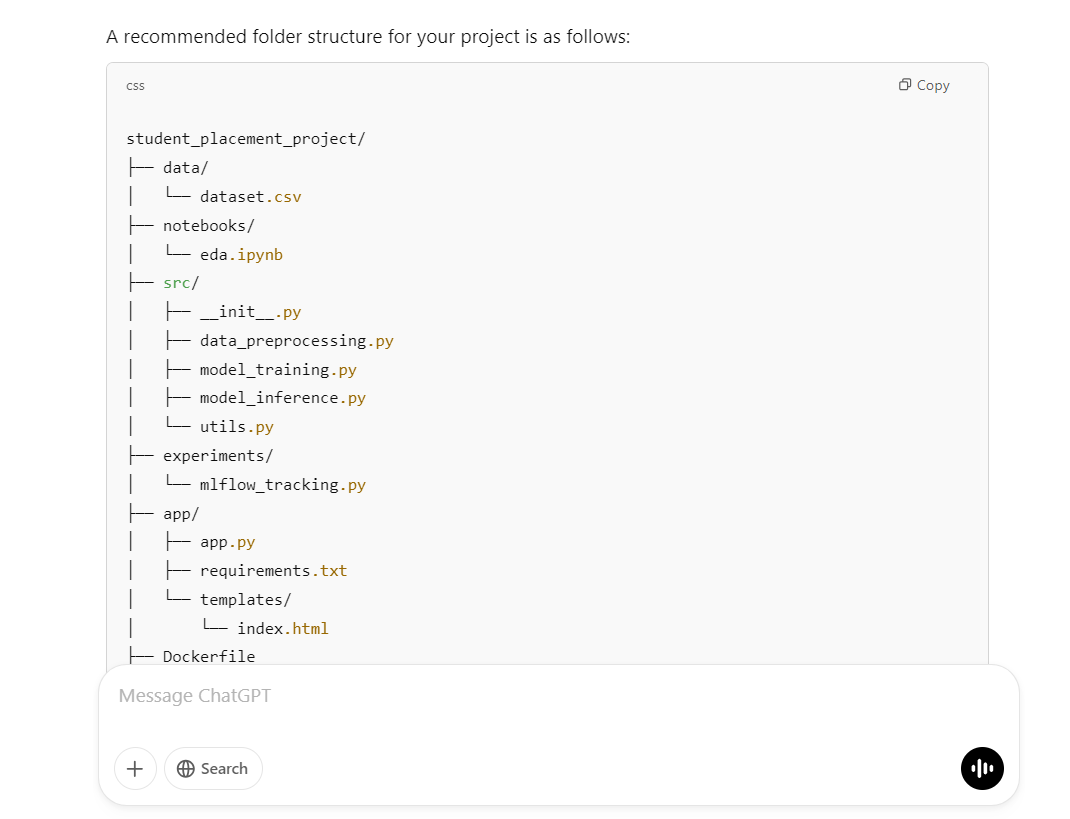
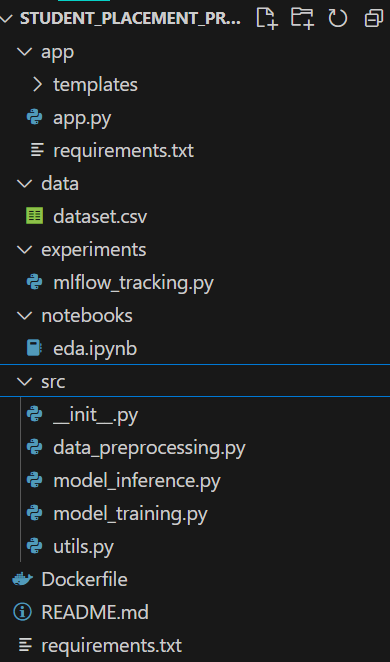
Le script fourni crée le répertoire du projet, les dossiers et tous les fichiers nécessaires :
mkdir -p student_placement_project/{data,notebooks,src,experiments,app/templates}
touch student_placement_project/data/dataset.csv \
      student_placement_project/notebooks/eda.ipynb \
      student_placement_project/src/{__init__.py,data_preprocessing.py,model_training.py,model_inference.py,utils.py} \
      student_placement_project/experiments/mlflow_tracking.py \
      student_placement_project/app/{app.py,requirements.txt} \
      student_placement_project/app/templates/index.html \
      student_placement_project/{Dockerfile,requirements.txt,README.md}
Comme on le voit, ce script a réalisé toutes les tâches nécessaires pour nous.
La réponse a fourni le code pour le notebook Jupyter. Il vous suffit de coller le code pas à pas et de l’exécuter pour voir les résultats.
# notebooks/eda.ipynb
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
import numpy as np

# Load dataset
df = pd.read_csv('../data/dataset.csv')

# Basic info and descriptive statistics
print(df.info())
print(df.describe())

# Visualize distributions
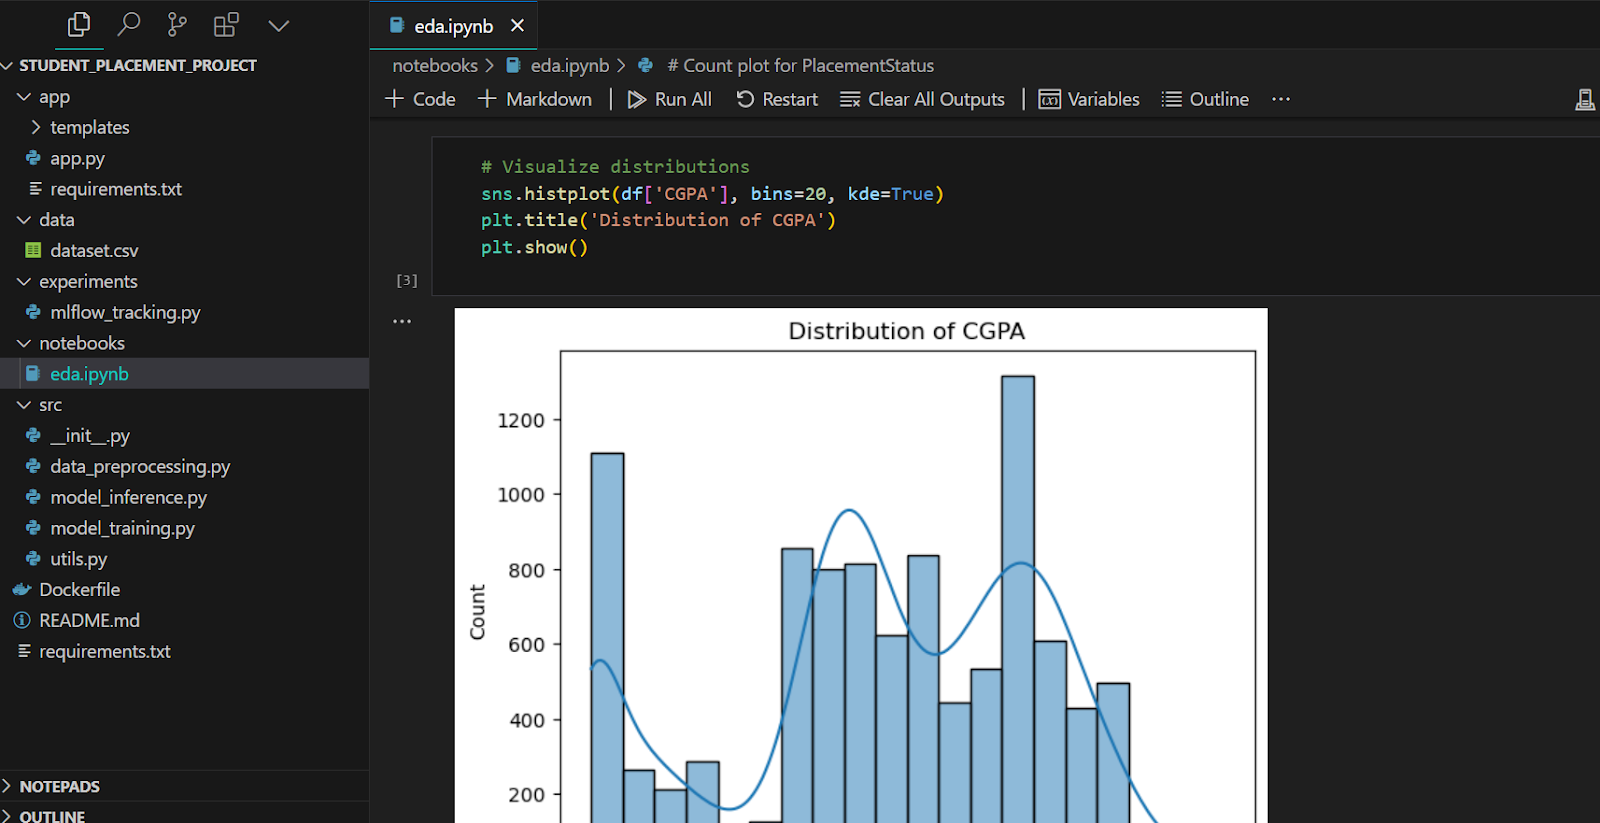
sns.histplot(df['CGPA'], bins=20, kde=True)
plt.title('Distribution of CGPA')
plt.show()

# Correlation matrix
plt.figure(figsize=(10, 8))

# Compute correlation matrix only on numeric columns
numeric_df = df.select_dtypes(include=[np.number])
plt.figure(figsize=(10, 8))
corr = numeric_df.corr()
sns.heatmap(corr, annot=True, cmap="coolwarm")
plt.title("Feature Correlation Matrix")


# Count plot for PlacementStatus
sns.countplot(x='PlacementStatus', data=df)
plt.title('Placement Status Count')
plt.show()
Voici à quoi cela ressemble. Toute l’analyse et les graphiques sont regroupés dans un seul fichier pour une relecture aisée.
Ensuite, nous allons créer le fichier de prétraitement des données. À part quelques ajustements mineurs, ce code fonctionne sans accroc.
# src/data_preprocessing.py
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler


def load_and_preprocess_data(filepath):
    df = pd.read_csv(filepath)

    # Convert categorical columns
    df["ExtracurricularActivities"] = df["ExtracurricularActivities"].map(
        {"Yes": 1, "No": 0}
    )
    df["PlacementTraining"] = df["PlacementTraining"].map({"Yes": 1, "No": 0})
    df["Workshops/Certifications"] = df["Workshops/Certifications"].astype(
        int
    )  # assuming it's already 0/1

    # Convert target column to binary
    df["PlacementStatus"] = df["PlacementStatus"].map({"Placed": 1, "NotPlaced": 0})

    # Feature selection (excluding StudentID)
    X = df.drop(["StudentID", "PlacementStatus"], axis=1)
    y = df["PlacementStatus"]

    # Split dataset
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42
    )

    # Scaling numeric features (optional)
    scaler = StandardScaler()
    X_train_scaled = scaler.fit_transform(X_train)
    X_test_scaled = scaler.transform(X_test)

return X_train_scaled, X_test_scaled, y_train, y_test, scalerLe script d’entraînement importe la fonction de traitement des données, prépare les données puis entraîne un modèle de forêts aléatoires. Il affiche ensuite les métriques de performance.
# src/model_training.py
import joblib
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
from data_preprocessing import load_and_preprocess_data


def train_model(data_path):
    X_train, X_test, y_train, y_test, scaler = load_and_preprocess_data(data_path)

    # Initialize and train classifier
    clf = RandomForestClassifier(n_estimators=100, random_state=42)
    clf.fit(X_train, y_train)

    # Predictions and evaluation
    y_pred = clf.predict(X_test)
    metrics = {
        "accuracy": accuracy_score(y_test, y_pred),
        "precision": precision_score(y_test, y_pred),
        "recall": recall_score(y_test, y_pred),
        "f1_score": f1_score(y_test, y_pred),
    }
    print("Model Evaluation Metrics:", metrics)

    # Save model and scaler
    joblib.dump(clf, "model_rf.joblib")
    joblib.dump(scaler, "scaler.joblib")

    return clf, scaler, metrics


if __name__ == "__main__":
    train_model("data/dataset.csv")
Une précision de 78 % est déjà correcte.
$ python .\src\model_training.py

Model Evaluation Metrics: {'accuracy': 0.781, 'precision': 0.7462121212121212, 'recall': 0.7137681159420289, 'f1_score': 0.7296296296296296}
Si vous souhaitez approfondir le sujet, découvrez notre tutoriel LLM très apprécié :Fine-Tuning DeepSeek R1 (Reasoning Model). Il couvre l’ajustement fin du premier modèle de raisonnement open source au monde sur un dataset de raisonnement médical afin de développer de meilleurs assistants médicaux IA.
Nous ne souhaitons pas conserver les scripts Python dans un dossier séparé. Nous allons déplacer le fichier mlflow_tracking.py dans le dossier src et supprimer le dossier experiments. Notez que vous devrez effectuer quelques petits changements manuels au lieu de solliciter le modèle o3-mini.
# src/mlflow_tracking.py
import mlflow
import mlflow.sklearn
from model_training import train_model


def run_experiment(data_path):
    mlflow.set_experiment("Student_Placement_Prediction")

    with mlflow.start_run():
        # Train the model
        clf, scaler, metrics = train_model(data_path)

        # Log parameters (example)
        mlflow.log_param("model_type", "RandomForest")
        mlflow.log_param("n_estimators", 100)

        # Log metrics
        mlflow.log_metric("accuracy", metrics["accuracy"])
        mlflow.log_metric("precision", metrics["precision"])
        mlflow.log_metric("recall", metrics["recall"])
        mlflow.log_metric("f1_score", metrics["f1_score"])

        # Log the model
        mlflow.sklearn.log_model(clf, "model")

        print("Experiment logged in MLflow.")


if __name__ == "__main__":
    run_experiment("data/dataset.csv")
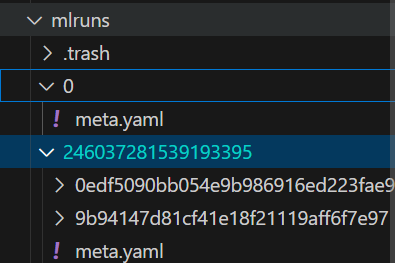
Le script Python s’est exécuté sans problème et a généré toutes les informations.
$ python .\src\mlflow_tracking.py
Model Evaluation Metrics: {'accuracy': 0.781, 'precision': 0.7462121212121212, 'recall': 0.7137681159420289, 'f1_score': 0.7296296296296296}
2025/02/17 00:03:34 WARNING mlflow.models.model: Model logged without a signature and input example. Please set `input_example` parameter when logging the model to auto infer the model signature.
Experiment logged in MLflow.
Toutes les expériences de machine learning sont stockées en local, que vous pouvez visualiser via l’interface MLflow.
La réponse d’o3-mini propose également une étape optionnelle à ajouter au script model_training.py. Nous l’avons intégrée pour vérifier si la performance du modèle s’améliore.
# src/model_training.py
import joblib
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
from data_preprocessing import load_and_preprocess_data
from sklearn.model_selection import GridSearchCV


def tune_model(X_train, y_train):
    param_grid = {"n_estimators": [50, 100, 150], "max_depth": [None, 5, 10]}
    clf = RandomForestClassifier(random_state=42)
    grid_search = GridSearchCV(clf, param_grid, cv=5, scoring="f1")
    grid_search.fit(X_train, y_train)
    print("Best parameters:", grid_search.best_params_)
    return grid_search.best_estimator_

def train_model(data_path):
    X_train, X_test, y_train, y_test, scaler = load_and_preprocess_data(data_path)

    # Initialize and train classifier
    clf = tune_model(X_train, y_train)

    # Predictions and evaluation
    y_pred = clf.predict(X_test)
    metrics = {
        "accuracy": accuracy_score(y_test, y_pred),
        "precision": precision_score(y_test, y_pred),
        "recall": recall_score(y_test, y_pred),
        "f1_score": f1_score(y_test, y_pred),
    }
    print("Model Evaluation Metrics:", metrics)

    # Save model and scaler
    joblib.dump(clf, "model_rf.joblib")
    joblib.dump(scaler, "scaler.joblib")

    return clf, scaler, metrics


if __name__ == "__main__":
    train_model("data/dataset.csv")
Comme vous pouvez le voir, les performances ont légèrement progressé grâce à l’optimisation des hyperparamètres.
$ python .\src\model_training.py
Best parameters: {'max_depth': 5, 'n_estimators': 150}
Model Evaluation Metrics: {'accuracy': 0.791, 'precision': 0.7493917274939172, 'recall': 0.7439613526570048, 'f1_score': 0.7466666666666667}Il est temps de créer l’inférence du modèle. Nous allons développer une application web Flask.
Nous devons d’abord charger le modèle et le scaler. Ensuite, nous traiterons les saisies de l’utilisateur pour les fournir au modèle et générer la prédiction. L’application est assez simple.
import joblib
import numpy as np

app = Flask(__name__)

# Load the trained model and scaler (update paths as necessary)
model = joblib.load("model_rf.joblib")
scaler = joblib.load("scaler.joblib")


@app.route("/")
def home():
    return render_template("index.html")


@app.route("/predict", methods=["POST"])
def predict():
    try:
        # Expecting form data from the HTML template
        CGPA = float(request.form.get("CGPA"))
        Internships = int(request.form.get("Internships"))
        Projects = int(request.form.get("Projects"))
        Workshops_Certifications = int(request.form.get("Workshops_Certifications"))
        AptitudeTestScore = float(request.form.get("AptitudeTestScore"))
        SoftSkillRating = float(request.form.get("SoftSkillRating"))
        ExtracurricularActivities = request.form.get("ExtracurricularActivities")
        PlacementTraining = request.form.get("PlacementTraining")
        SSC_Marks = float(request.form.get("SSC_Marks"))
        HSC_Marks = float(request.form.get("HSC_Marks"))

        # Convert categorical fields to numerical
        extra_act = 1 if ExtracurricularActivities.lower() == "yes" else 0
        placement_training = 1 if PlacementTraining.lower() == "yes" else 0

        # Construct feature vector
        features = [
            CGPA,
            Internships,
            Projects,
            Workshops_Certifications,
            AptitudeTestScore,
            SoftSkillRating,
            extra_act,
            placement_training,
            SSC_Marks,
            HSC_Marks,
        ]

        # Scale features and make prediction
        features_scaled = scaler.transform(np.array(features).reshape(1, -1))
        prediction = model.predict(features_scaled)
        result = "Placed" if prediction[0] == 1 else "Not Placed"

        return render_template("index.html", prediction=result)
    except Exception as e:
        return render_template("index.html", prediction=f"Error: {e}")


if __name__ == "__main__":
    app.run(host='0.0.0.0', port=5000, debug=True)
Pour créer l’interface utilisateur de l’application, nous avons collé le code HTML dans le fichier index.html. Tout est fourni par le modèle o3-mini. Vous pouvez même demander à o3-mini d’améliorer l’interface.
<!-- app/templates/index.html -->
<!DOCTYPE html>
<html>
<head>
    <title>Student Placement Prediction</title>
</head>
<body>
    <h1>Student Placement Prediction</h1>
    <form action="/predict" method="post" id="predictForm">
        <!-- Create inputs for each feature. Example for CGPA: -->
        <label for="CGPA">CGPA:</label>
        <input type="number" step="0.1" id="CGPA" name="CGPA" required><br><br>
        <!-- Add more inputs as per features -->
        <button type="submit">Predict</button>
    </form>
    <div id="result"></div>
    <script>
      document.getElementById('predictForm').addEventListener('submit', async (e) => {
          e.preventDefault();
          const formData = new FormData(e.target);
          const data = Object.fromEntries(formData.entries());
          // Adjust keys to match what the API expects
          data.ExtracurricularActivities = data.ExtracurricularActivities || 'No';
          data.PlacementTraining = data.PlacementTraining || 'No';

          const response = await fetch('/predict', {
              method: 'POST',
              headers: {'Content-Type': 'application/json'},
              body: JSON.stringify(data)
          });
          const result = await response.json();
          document.getElementById('result').innerText = JSON.stringify(result);
      });
    </script>
</body>
</html>
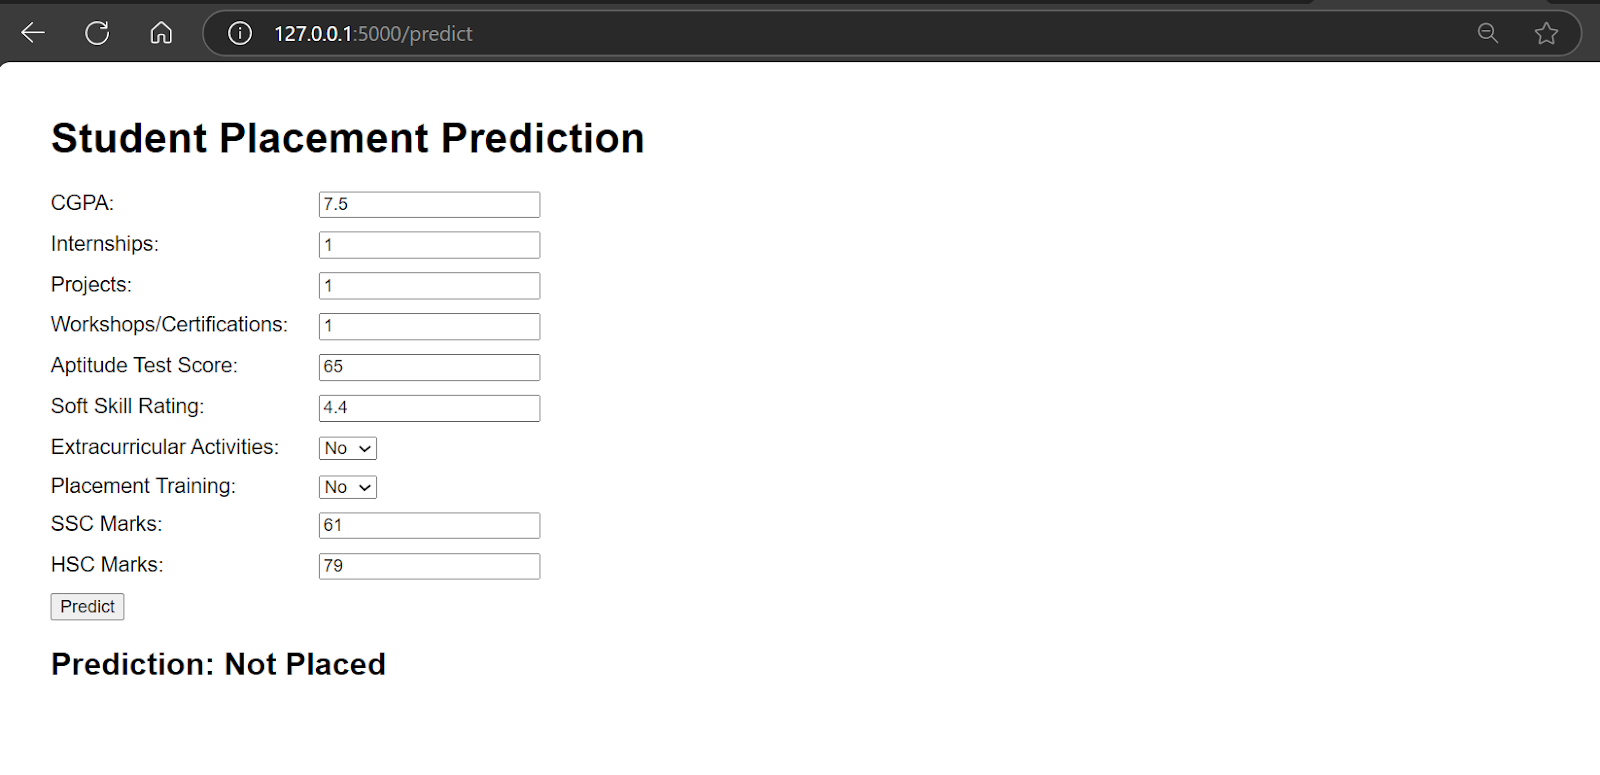
Une fois tout en place, exécutez l’app et cliquez sur l’URL générée par Flask.
$ python .\app\app.py

 * Running on all addresses (0.0.0.0)
 * Running on http://127.0.0.1:5000
 * Running on http://192.168.100.41:5000
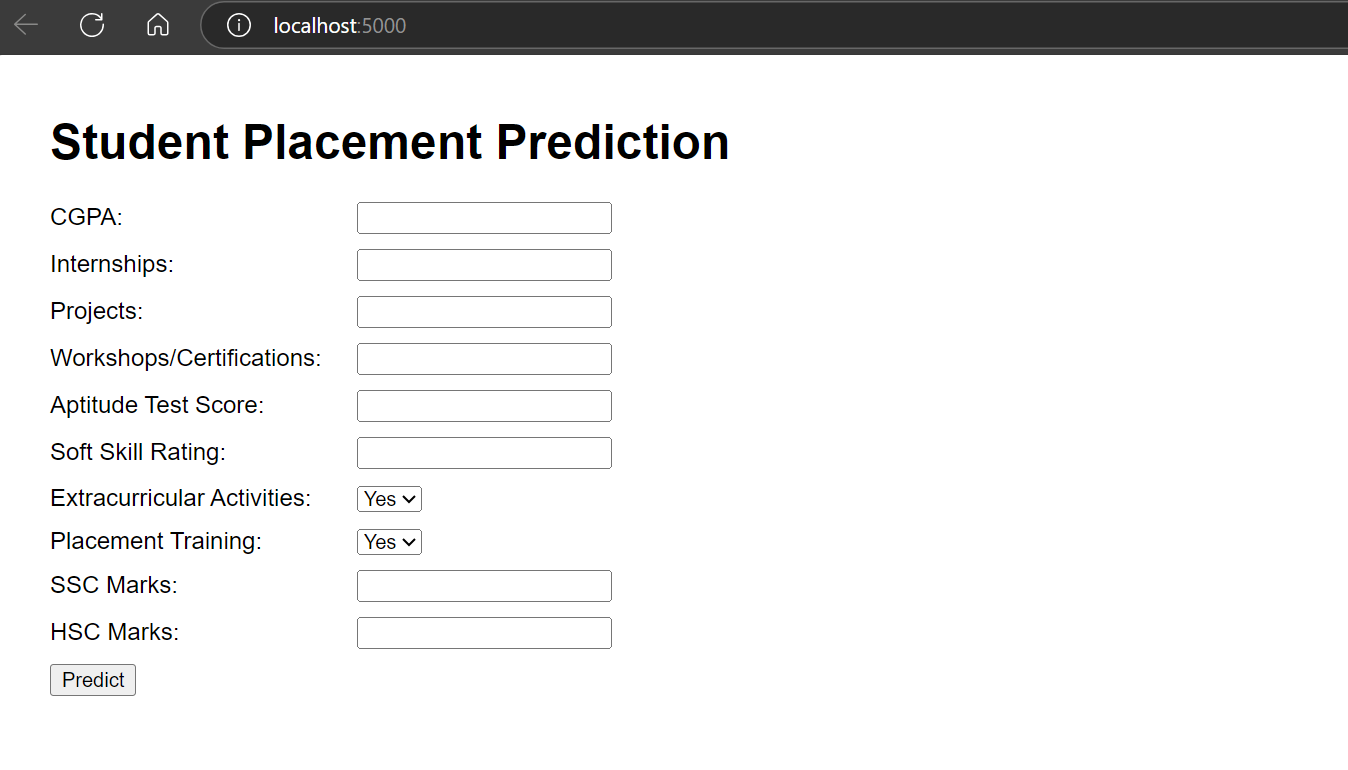
Notre application web fonctionne sans accroc.
Le modèle o3-mini nous a également fourni le Dockerfile, il ne nous reste plus qu’à le construire en local et à le tester avant de le déployer dans le cloud.
# Use an official Python runtime as a parent image
FROM python:3.12-slim

# Set the working directory in the container
WORKDIR /app

# Copy the requirements file and install dependencies
COPY requirements.txt ./
RUN pip install --upgrade pip && pip install -r requirements.txt

# Copy the entire project
COPY . .

# Expose port (adjust as necessary)
EXPOSE 5000

# Command to run the Flask app
CMD ["python", "app/app.py"]
Construisez l’image Docker avec la commande suivante.
$ docker build -t kingabzpro/student_placement . 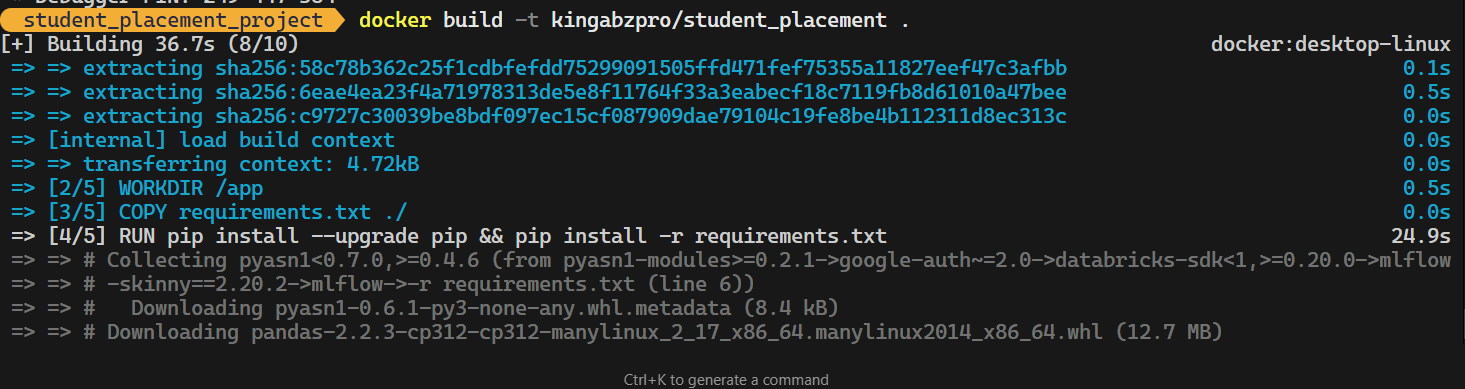
Exécutez l’image Docker en local.
$ docker run -p 5000:5000 kingabzpro/student_placementVous pouvez constater que notre conteneur Docker tourne parfaitement.
Il est temps de déployer notre application de machine learning sur le cloud Hugging Face (Space).
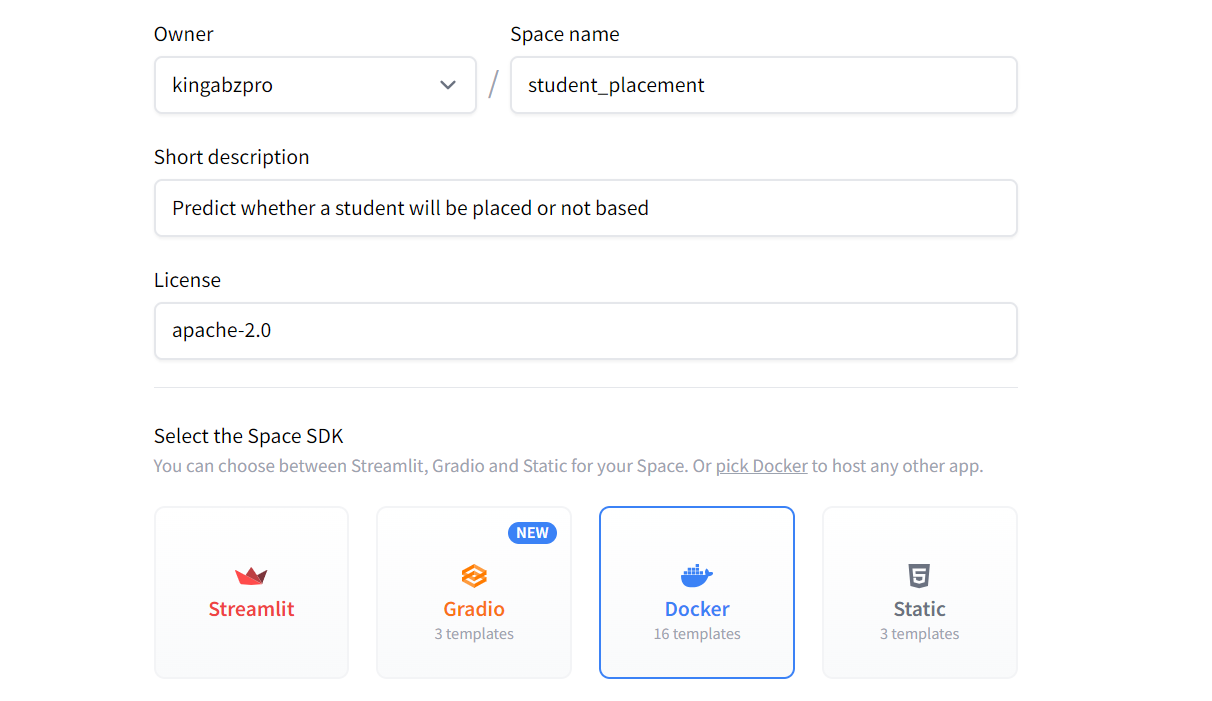
Pour commencer, vous pouvez créer un nouvel espace. Ajoutez toutes les informations nécessaires sur l’application et sélectionnez Docker comme SDK.
Ensuite, une URL sera générée pour cloner l’application en local.
$ git clone https://huggingface.co/spaces/kingabzpro/student_placementDéplacez ensuite le modèle, le scaler, le dossier app, le Dockerfile et le requirements.txt dans le dépôt de l’application.
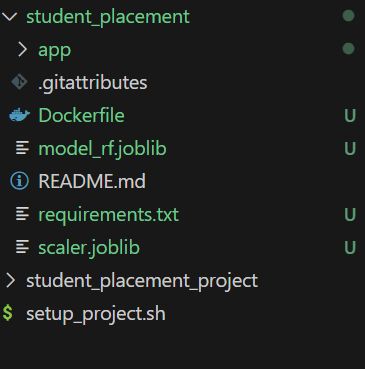
Vous pouvez modifier le fichier app.py en mettant à jour la dernière ligne comme suit :
app.run(host="0.0.0.0", port=7860, debug=True)Vérifiez le port exposé dans le Dockerfile. Nous devons le faire pour éviter les erreurs de port :
# Expose port (adjust as necessary)
EXPOSE 7860
Une fois les changements effectués, validez vos mises à jour et poussez-les vers le dépôt distant :
$ cd .\student_placement\
$ git add .
$ git commit -m "Initial commit of Dockerized student placement app"
$ git push
Dès que vous poussez les changements, la construction démarre puis l’interface de votre application est déployée.
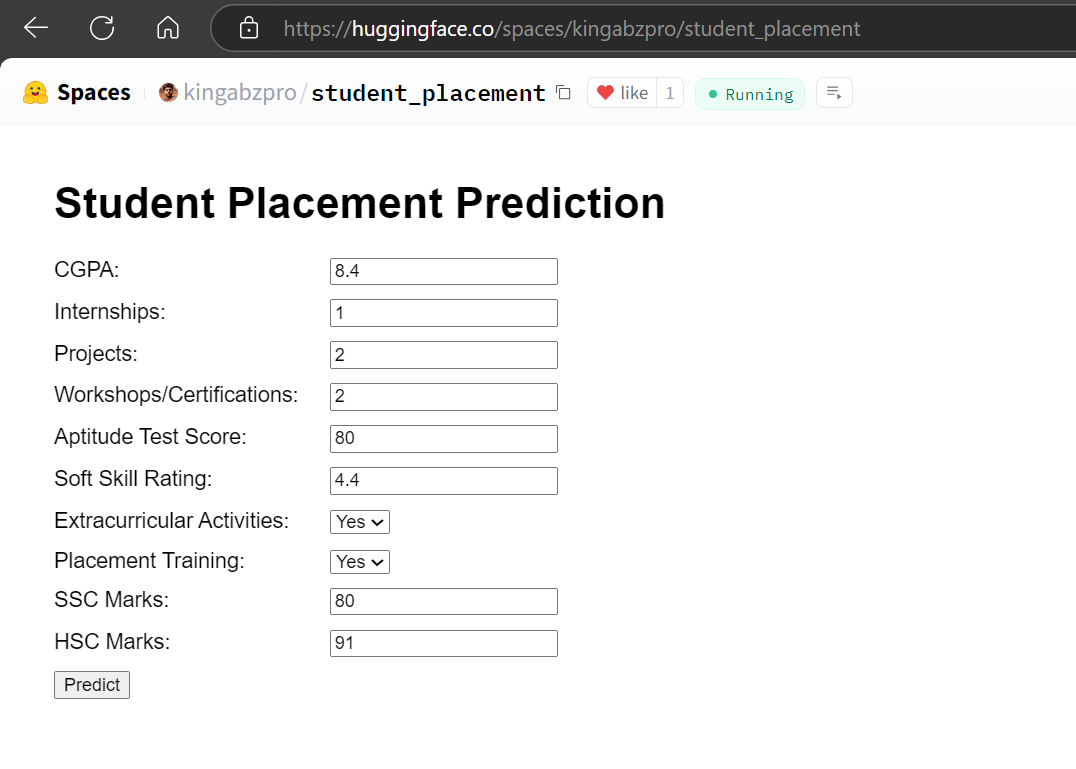
Source : Student Placement
o3-mini a fait un excellent travail, de la structuration du projet jusqu’au déploiement réussi de l’application web dans le cloud.
Vous pouvez aussi découvrir le modèle de pointe de Google et apprendre à créer votre propre application d’IA en suivant le tutoriel Building Multimodal AI Application with Gemini 2.0 Pro.
Le modèle o3-mini a ses spécificités, ce qui implique d’être vigilant lors des demandes de suivi et du débogage de code. Voici quelques conseils pour travailler efficacement avec lui :
Lorsque vous donnez des consignes, assurez-vous qu’elles soient claires et cohérentes. Si vous fournissez plusieurs instructions, o3-mini priorise la plus récente. Cela signifie que la dernière instruction d’une longue chaîne peut prendre le dessus et annuler les précédentes.
Certains problèmes de code devront être corrigés manuellement plutôt que de compter sur le modèle. Si vous demandez à o3-mini de corriger une partie précise du code, il ne modifiera que cette section. Cela peut entraîner des ruptures ailleurs si les dépendances ou le contexte global ne sont pas pris en compte.
Incluez tous les détails pertinents dans votre prompt, comme les données brutes, la définition claire des lignes et des colonnes, ainsi que tout contexte additionnel. Cela aide le modèle à mieux comprendre votre demande et à produire de meilleurs résultats.
Indiquez précisément ce que vous attendez en sortie. Par exemple, précisez si vous avez besoin de dossiers, de fichiers, de commandes Docker ou d’un guide étape par étape pour mettre en œuvre la solution. Vous garantissez ainsi une réponse alignée avec vos attentes.
Commencez par un prompt bien structuré qui couvre 90 % de vos besoins. Une fois cette base posée, vous pourrez affiner, corriger ou ajouter des étapes par des demandes complémentaires.
Le modèle o3-mini s’impose comme un excellent choix face à GPT-4o, plus rapide que o1 et particulièrement performant pour le code Python et HTML. De manière remarquable, le code Python généré par o3-mini s’exécute la plupart du temps sans problème. Il peut même améliorer du code HTML, pour optimiser votre interface et la rendre plus attrayante.
Dans ce tutoriel, nous avons exploré la puissance d’o3-mini dans le cadre d’un projet de machine learning. Le modèle o3-mini se révèle être un excellent outil pour les data scientists, les ingénieurs en machine learning et les professionnels techniques. Sa capacité à gérer efficacement des tâches complexes en fait un atout précieux dans tout flux de travail.
Pour obtenir les meilleurs résultats, il suffit de fournir, dès le départ, un contexte complet incluant tous les contenus et livrables pertinents. Une fois la sortie générée, passez à votre éditeur, exécutez les scripts et implémentez le code fourni avec ses instructions.
Prochaine étape : apprenez à déployer vos propres LLM de pointe dans le cloud. Plutôt que de dépendre d’OpenAI, vous gardez la main sur les coûts, la précision et l’accessibilité de vos données. Suivez le tutoriel How to Deploy LLMs with BentoML pour découvrir l’ensemble du processus.
Meilleures formations DataCamp
Cours
Cours
Cours