
Corso
Lavorare con l'API di OpenAI
3 ore
184.8K
Dopo il lancio di DeepSeek R1, OpenAI ha risposto con il proprio modello di ragionamento all’avanguardia, o3-mini. Questo nuovo modello è pensato per essere più piccolo, veloce ed efficiente del suo predecessore, il modello o1, eccellendo al contempo in compiti legati al coding, alle materie STEM e alla risoluzione logica di problemi.
OpenAI ha reso questo modello disponibile gratuitamente a tutti gli utenti, inclusi quelli che usano ChatGPT e altre piattaforme, rendendo le capacità avanzate di ragionamento più accessibili che mai.
Per maggiori dettagli su o3-mini, puoi consultare l’articolo, OpenAI’s O3: Features, O1 Comparison, Release Date & More.
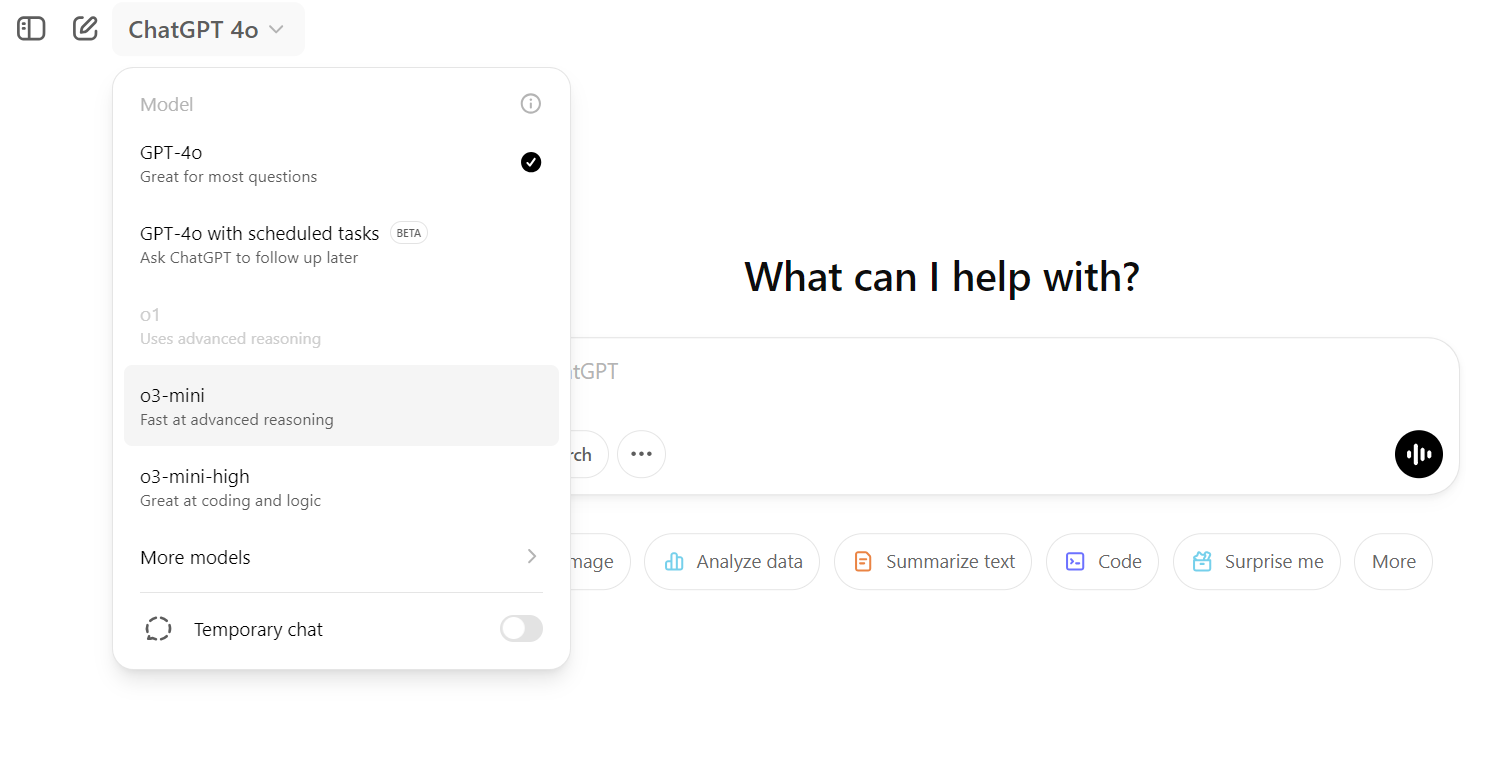
Fonte: ChatGPT
In questo tutorial esploreremo le capacità tecniche del modello o3-mini. In particolare, testeremo la sua abilità nel gestire compiti tecnici complessi, generare codice accurato e fornire istruzioni chiare per costruire, testare e distribuire un vero modello di machine learning. Al termine, vogliamo capire se o3-mini sia all’altezza della promessa di modello di ragionamento all’avanguardia per attività tecniche e di problem solving logico.
Immagine dell’autore
Chiederemo a o3-mini di usare il dataset Placement Prediction per costruire un’applicazione di machine learning in grado di determinare se uno studente è idoneo al job placement o meno. Dalla pianificazione al deployment della soluzione, cercheremo l’assistenza del modello o3-mini su ChatGPT.
Nella fase di pianificazione forniremo al modello o3-mini tutte le informazioni necessarie e definiremo i nostri obiettivi. Gli chiederemo di creare tutte le cartelle e i file richiesti per costruire, addestrare e distribuire l’applicazione Placement Prediction.
In particolare, faremo:
Ecco il prompt:
“I want to build a machine learning project to predict whether a student will be placed or not based on their academic and extracurricular data. The dataset contains the following columns:

- **StudentID**: Unique identifier for each student.

- **CGPA**: The overall grades achieved by the student.

- **Internships**: Number of internships a student has completed.

- **Projects**: Number of projects a student has completed.

- **Workshops/Certifications**: Indicates whether the student has attended workshops or completed certifications to upskill themselves.

- **AptitudeTestScore**: Score achieved in an aptitude test, which evaluates quantitative and logical thinking.

- **SoftSkillRating**: A rating of the student’s communication and interpersonal skills.

- **ExtraCurricularActivities**: Indicates whether the student is active in extracurricular activities (Yes/No).

- **PlacementTraining**: Indicates whether the student has undergone placement training (Yes/No).

- **SSC and HSC**: Senior Secondary and Higher Secondary marks.

- **PlacementStatus**: The target column, which has two classes: "Placed" and "Not Placed."

Here is a sample dataset row:

StudentID,CGPA,Internships,Projects,Workshops/Certifications,AptitudeTestScore,SoftSkillsRating,ExtracurricularActivities,PlacementTraining,SSC_Marks,HSC_Marks,PlacementStatus

1,7.5,1,1,1,65,4.4,No,No,61,79,NotPlaced

I need help creating a structured project with the following components:

1. **Data Analysis**: Perform exploratory data analysis (EDA) to understand the dataset, visualize trends, and identify correlations between features and the target variable.

2. **Model Building**: Create a machine learning pipeline to preprocess the data and train a model to predict the placement status.

3. **Experiment Tracking**: Set up a system to track experiments, including model performance metrics, hyperparameters, and results.

4. **Model Training**: Train the model using appropriate algorithms and evaluate its performance using metrics like accuracy, precision, recall, and F1-score.

5. **Hyperparameter Tuning**: Optimize the model’s performance by tuning hyperparameters using techniques like grid search or random search.

6. **Model Inference Application**: Build an application (e.g., a web app or API) to allow users to input student data and get predictions on placement status.

7. **Dockerfile for Containerization**: Create a Dockerfile to containerize the application for easy deployment.

8. **Cloud Deployment**: Deploy the application on a cloud platform (e.g., AWS, Azure, or Google Cloud) to make it accessible online.

9. **Accessing the Model**: Provide a way to access the deployed model via an API or web interface.

Please provide the following:

- A folder structure for organizing the project files. (Also provide bash command for creating the folders and files.)

- Python scripts or code snippets for each of the above components.

- Suggestions for tools and libraries to use (e.g., pandas, scikit-learn, Flask, Docker, etc.).

- Guidance on setting up experiment tracking (using MLflow).

- Steps for deploying the model on a Hugging Face Space.”
In cambio, riceverai una risposta dettagliata sulla struttura del progetto e su come costruire tutto da zero.
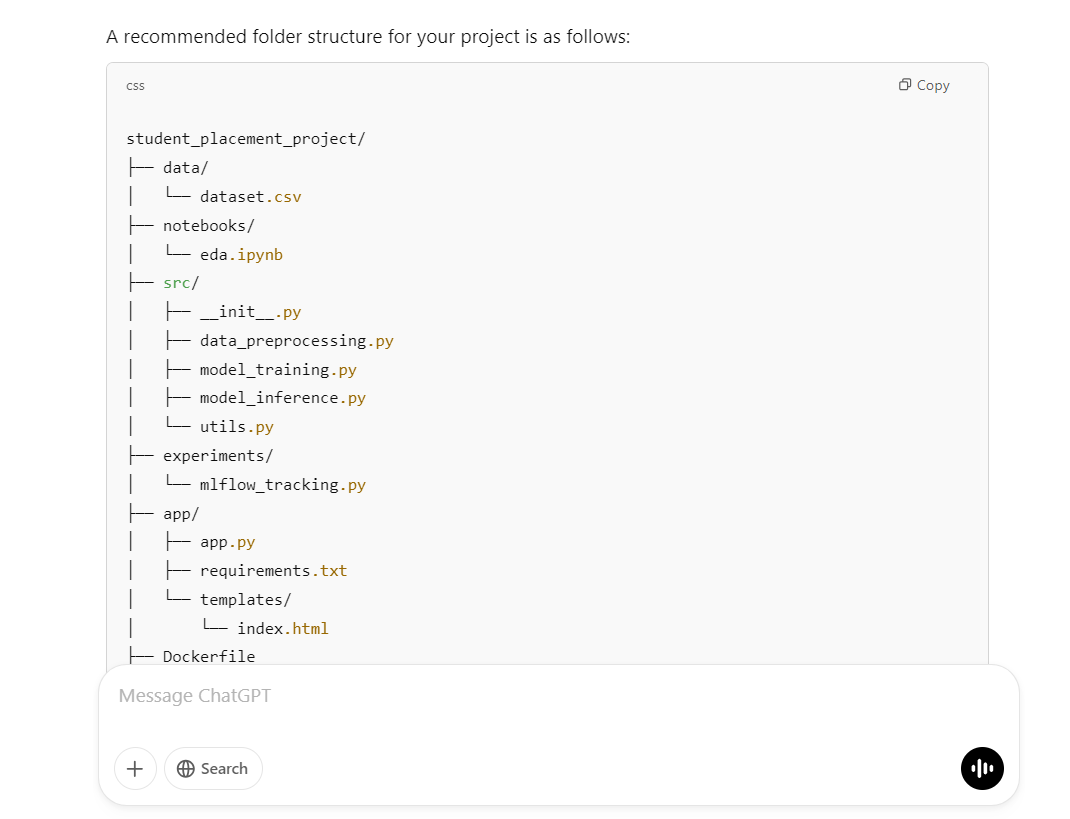
Lo script fornito creerà la directory del progetto, le cartelle e tutti i file necessari:
mkdir -p student_placement_project/{data,notebooks,src,experiments,app/templates}
touch student_placement_project/data/dataset.csv \
      student_placement_project/notebooks/eda.ipynb \
      student_placement_project/src/{__init__.py,data_preprocessing.py,model_training.py,model_inference.py,utils.py} \
      student_placement_project/experiments/mlflow_tracking.py \
      student_placement_project/app/{app.py,requirements.txt} \
      student_placement_project/app/templates/index.html \
      student_placement_project/{Dockerfile,requirements.txt,README.md}
Come possiamo vedere, questo script ha completato per noi tutte le attività necessarie.
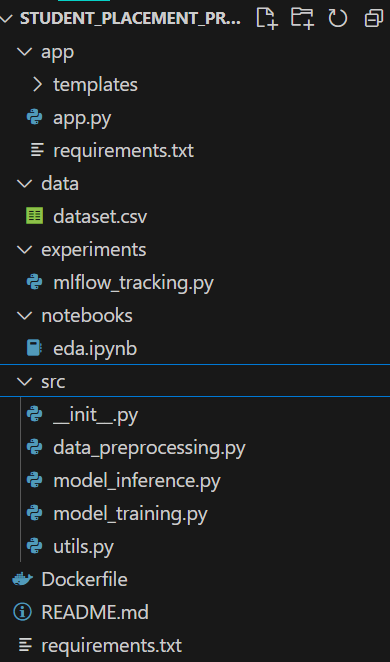
La risposta ha fornito il codice per il file Jupyter notebook. Tutto ciò che devi fare è incollare il codice, blocco per blocco, ed eseguirlo per vedere l’output.
# notebooks/eda.ipynb
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
import numpy as np

# Load dataset
df = pd.read_csv('../data/dataset.csv')

# Basic info and descriptive statistics
print(df.info())
print(df.describe())

# Visualize distributions
sns.histplot(df['CGPA'], bins=20, kde=True)
plt.title('Distribution of CGPA')
plt.show()

# Correlation matrix
plt.figure(figsize=(10, 8))

# Compute correlation matrix only on numeric columns
numeric_df = df.select_dtypes(include=[np.number])
plt.figure(figsize=(10, 8))
corr = numeric_df.corr()
sns.heatmap(corr, annot=True, cmap="coolwarm")
plt.title("Feature Correlation Matrix")


# Count plot for PlacementStatus
sns.countplot(x='PlacementStatus', data=df)
plt.title('Placement Status Count')
plt.show()
Ecco come si presenta. Tutta l’analisi dei dati e i grafici sono in un unico file, facilmente consultabile da chiunque.
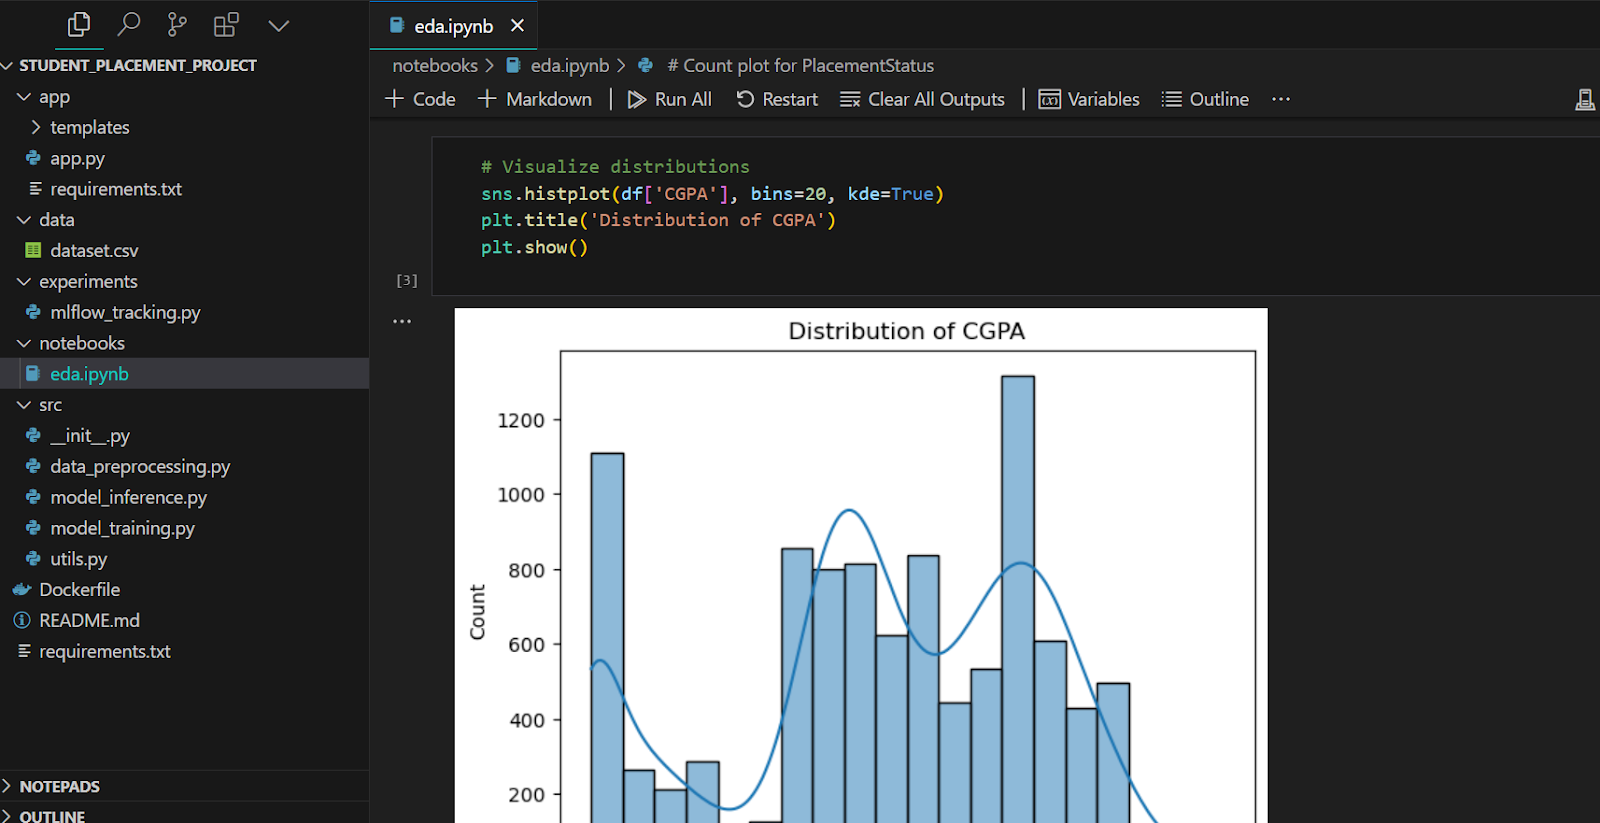
Successivamente, creeremo il file per il preprocessing dei dati. A parte qualche piccola modifica, questo codice funziona senza problemi.
# src/data_preprocessing.py
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler


def load_and_preprocess_data(filepath):
    df = pd.read_csv(filepath)

    # Convert categorical columns
    df["ExtracurricularActivities"] = df["ExtracurricularActivities"].map(
        {"Yes": 1, "No": 0}
    )
    df["PlacementTraining"] = df["PlacementTraining"].map({"Yes": 1, "No": 0})
    df["Workshops/Certifications"] = df["Workshops/Certifications"].astype(
        int
    )  # assuming it's already 0/1

    # Convert target column to binary
    df["PlacementStatus"] = df["PlacementStatus"].map({"Placed": 1, "NotPlaced": 0})

    # Feature selection (excluding StudentID)
    X = df.drop(["StudentID", "PlacementStatus"], axis=1)
    y = df["PlacementStatus"]

    # Split dataset
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42
    )

    # Scaling numeric features (optional)
    scaler = StandardScaler()
    X_train_scaled = scaler.fit_transform(X_train)
    X_test_scaled = scaler.transform(X_test)

return X_train_scaled, X_test_scaled, y_train, y_test, scalerLo script di training importa la funzione di preprocessing, elabora prima i dati e poi addestra il modello random forest. Infine, mostra le metriche di prestazione del modello.
# src/model_training.py
import joblib
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
from data_preprocessing import load_and_preprocess_data


def train_model(data_path):
    X_train, X_test, y_train, y_test, scaler = load_and_preprocess_data(data_path)

    # Initialize and train classifier
    clf = RandomForestClassifier(n_estimators=100, random_state=42)
    clf.fit(X_train, y_train)

    # Predictions and evaluation
    y_pred = clf.predict(X_test)
    metrics = {
        "accuracy": accuracy_score(y_test, y_pred),
        "precision": precision_score(y_test, y_pred),
        "recall": recall_score(y_test, y_pred),
        "f1_score": f1_score(y_test, y_pred),
    }
    print("Model Evaluation Metrics:", metrics)

    # Save model and scaler
    joblib.dump(clf, "model_rf.joblib")
    joblib.dump(scaler, "scaler.joblib")

    return clf, scaler, metrics


if __name__ == "__main__":
    train_model("data/dataset.csv")
Il 78% di accuratezza non è affatto male.
$ python .\src\model_training.py

Model Evaluation Metrics: {'accuracy': 0.781, 'precision': 0.7462121212121212, 'recall': 0.7137681159420289, 'f1_score': 0.7296296296296296}
Se vuoi approfondire altri argomenti in quest’area, dai un’occhiata al nostro popolare tutorial sugli LLM, Fine-Tuning DeepSeek R1 (Reasoning Model). Copre il fine-tuning del primo modello di ragionamento open source al mondo sul dataset medico chain of thought per sviluppare migliori AI per la salute del futuro.
Non vogliamo mantenere gli script Python in una cartella diversa. Sposteremo il file mlflow_tracking.py nella cartella src e rimuoveremo la cartella degli esperimenti. Nota che dovrai apportare manualmente alcune piccole modifiche invece di chiederle al modello o3-mini.
# src/mlflow_tracking.py
import mlflow
import mlflow.sklearn
from model_training import train_model


def run_experiment(data_path):
    mlflow.set_experiment("Student_Placement_Prediction")

    with mlflow.start_run():
        # Train the model
        clf, scaler, metrics = train_model(data_path)

        # Log parameters (example)
        mlflow.log_param("model_type", "RandomForest")
        mlflow.log_param("n_estimators", 100)

        # Log metrics
        mlflow.log_metric("accuracy", metrics["accuracy"])
        mlflow.log_metric("precision", metrics["precision"])
        mlflow.log_metric("recall", metrics["recall"])
        mlflow.log_metric("f1_score", metrics["f1_score"])

        # Log the model
        mlflow.sklearn.log_model(clf, "model")

        print("Experiment logged in MLflow.")


if __name__ == "__main__":
    run_experiment("data/dataset.csv")
Lo script Python è stato eseguito correttamente e ha generato tutte le informazioni.
$ python .\src\mlflow_tracking.py
Model Evaluation Metrics: {'accuracy': 0.781, 'precision': 0.7462121212121212, 'recall': 0.7137681159420289, 'f1_score': 0.7296296296296296}
2025/02/17 00:03:34 WARNING mlflow.models.model: Model logged without a signature and input example. Please set `input_example` parameter when logging the model to auto infer the model signature.
Experiment logged in MLflow.
Tutti gli esperimenti di machine learning sono archiviati in locale e puoi visualizzarli tramite l’interfaccia di MLflow.
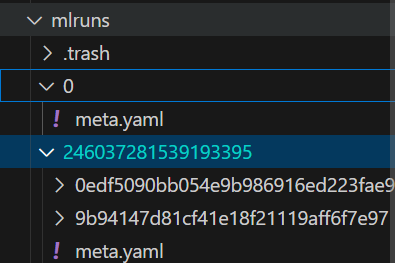
La risposta di o3-mini fornisce anche un passaggio opzionale che puoi aggiungere allo script model_training.py. Lo abbiamo incluso per vedere se le prestazioni del modello migliorano.
# src/model_training.py
import joblib
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
from data_preprocessing import load_and_preprocess_data
from sklearn.model_selection import GridSearchCV


def tune_model(X_train, y_train):
    param_grid = {"n_estimators": [50, 100, 150], "max_depth": [None, 5, 10]}
    clf = RandomForestClassifier(random_state=42)
    grid_search = GridSearchCV(clf, param_grid, cv=5, scoring="f1")
    grid_search.fit(X_train, y_train)
    print("Best parameters:", grid_search.best_params_)
    return grid_search.best_estimator_

def train_model(data_path):
    X_train, X_test, y_train, y_test, scaler = load_and_preprocess_data(data_path)

    # Initialize and train classifier
    clf = tune_model(X_train, y_train)

    # Predictions and evaluation
    y_pred = clf.predict(X_test)
    metrics = {
        "accuracy": accuracy_score(y_test, y_pred),
        "precision": precision_score(y_test, y_pred),
        "recall": recall_score(y_test, y_pred),
        "f1_score": f1_score(y_test, y_pred),
    }
    print("Model Evaluation Metrics:", metrics)

    # Save model and scaler
    joblib.dump(clf, "model_rf.joblib")
    joblib.dump(scaler, "scaler.joblib")

    return clf, scaler, metrics


if __name__ == "__main__":
    train_model("data/dataset.csv")
Come puoi vedere, le prestazioni del nostro modello sono leggermente aumentate grazie all’ottimizzazione degli iperparametri.
$ python .\src\model_training.py
Best parameters: {'max_depth': 5, 'n_estimators': 150}
Model Evaluation Metrics: {'accuracy': 0.791, 'precision': 0.7493917274939172, 'recall': 0.7439613526570048, 'f1_score': 0.7466666666666667}È il momento di creare l’inferenza del modello. Svilupperemo un’applicazione web Flask.
Per prima cosa dobbiamo caricare il modello e lo scaler. Dopo, elaboreremo l’input dell’utente e lo passeremo al modello per generare la previsione. È un’applicazione piuttosto semplice.
import joblib
import numpy as np

app = Flask(__name__)

# Load the trained model and scaler (update paths as necessary)
model = joblib.load("model_rf.joblib")
scaler = joblib.load("scaler.joblib")


@app.route("/")
def home():
    return render_template("index.html")


@app.route("/predict", methods=["POST"])
def predict():
    try:
        # Expecting form data from the HTML template
        CGPA = float(request.form.get("CGPA"))
        Internships = int(request.form.get("Internships"))
        Projects = int(request.form.get("Projects"))
        Workshops_Certifications = int(request.form.get("Workshops_Certifications"))
        AptitudeTestScore = float(request.form.get("AptitudeTestScore"))
        SoftSkillRating = float(request.form.get("SoftSkillRating"))
        ExtracurricularActivities = request.form.get("ExtracurricularActivities")
        PlacementTraining = request.form.get("PlacementTraining")
        SSC_Marks = float(request.form.get("SSC_Marks"))
        HSC_Marks = float(request.form.get("HSC_Marks"))

        # Convert categorical fields to numerical
        extra_act = 1 if ExtracurricularActivities.lower() == "yes" else 0
        placement_training = 1 if PlacementTraining.lower() == "yes" else 0

        # Construct feature vector
        features = [
            CGPA,
            Internships,
            Projects,
            Workshops_Certifications,
            AptitudeTestScore,
            SoftSkillRating,
            extra_act,
            placement_training,
            SSC_Marks,
            HSC_Marks,
        ]

        # Scale features and make prediction
        features_scaled = scaler.transform(np.array(features).reshape(1, -1))
        prediction = model.predict(features_scaled)
        result = "Placed" if prediction[0] == 1 else "Not Placed"

        return render_template("index.html", prediction=result)
    except Exception as e:
        return render_template("index.html", prediction=f"Error: {e}")


if __name__ == "__main__":
    app.run(host='0.0.0.0', port=5000, debug=True)
Per creare l’interfaccia utente dell’applicazione, abbiamo incollato il codice HTML nel file index.html. Tutto è fornito dal modello o3-mini. Puoi anche chiedere al modello o3-mini di migliorare l’interfaccia utente.
<!-- app/templates/index.html -->
<!DOCTYPE html>
<html>
<head>
    <title>Student Placement Prediction</title>
</head>
<body>
    <h1>Student Placement Prediction</h1>
    <form action="/predict" method="post" id="predictForm">
        <!-- Create inputs for each feature. Example for CGPA: -->
        <label for="CGPA">CGPA:</label>
        <input type="number" step="0.1" id="CGPA" name="CGPA" required><br><br>
        <!-- Add more inputs as per features -->
        <button type="submit">Predict</button>
    </form>
    <div id="result"></div>
    <script>
      document.getElementById('predictForm').addEventListener('submit', async (e) => {
          e.preventDefault();
          const formData = new FormData(e.target);
          const data = Object.fromEntries(formData.entries());
          // Adjust keys to match what the API expects
          data.ExtracurricularActivities = data.ExtracurricularActivities || 'No';
          data.PlacementTraining = data.PlacementTraining || 'No';

          const response = await fetch('/predict', {
              method: 'POST',
              headers: {'Content-Type': 'application/json'},
              body: JSON.stringify(data)
          });
          const result = await response.json();
          document.getElementById('result').innerText = JSON.stringify(result);
      });
    </script>
</body>
</html>
Una volta configurato tutto, esegui l’app e clicca sull’URL generato da Flask.
$ python .\app\app.py

 * Running on all addresses (0.0.0.0)
 * Running on http://127.0.0.1:5000
 * Running on http://192.168.100.41:5000
La nostra applicazione web funziona senza intoppi.
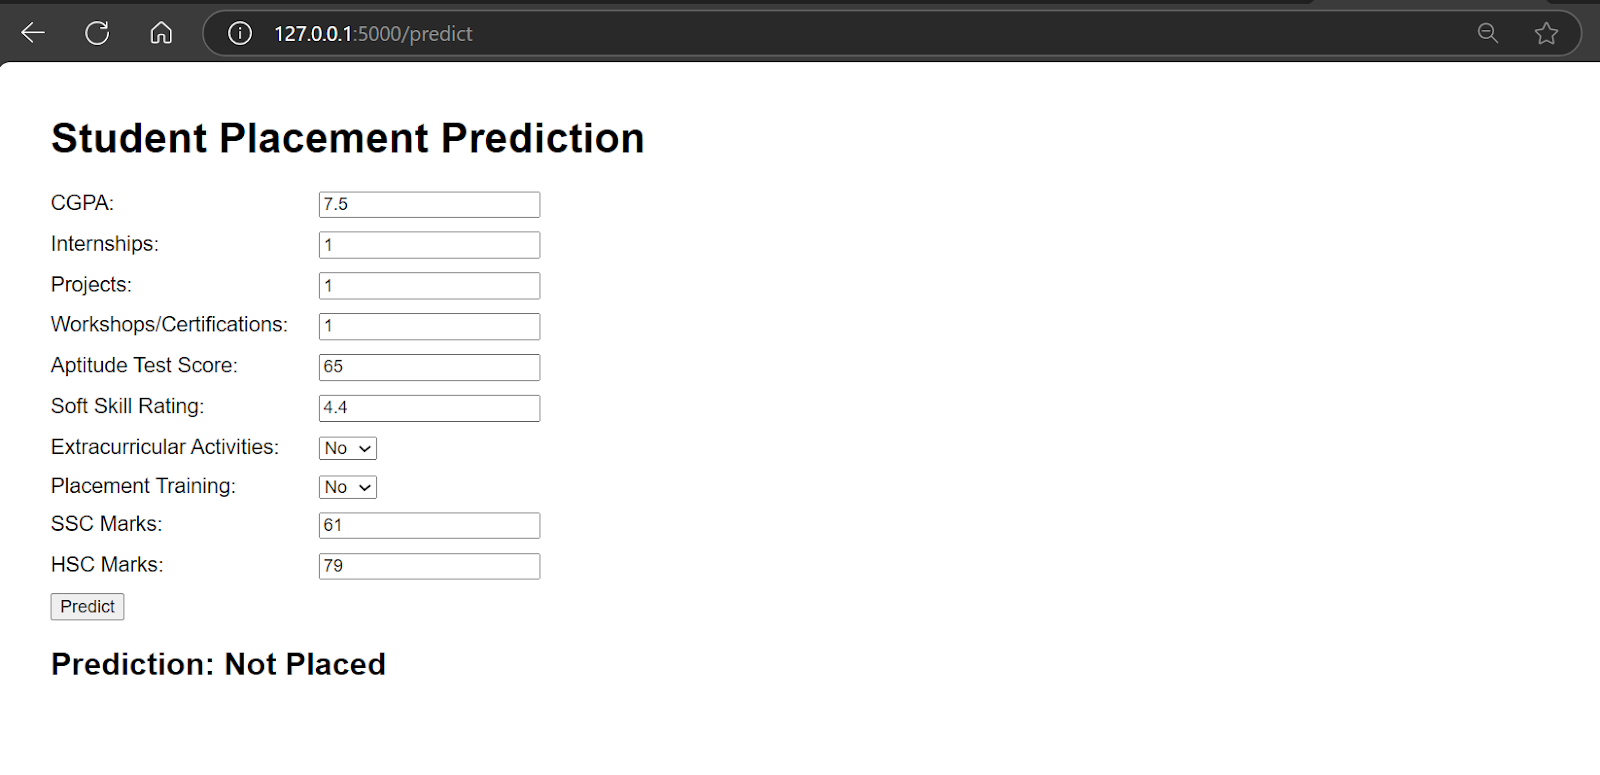
Il modello o3-mini ci ha fornito anche il Dockerfile: dobbiamo solo buildarlo in locale e testarlo prima di distribuirlo sul cloud.
# Use an official Python runtime as a parent image
FROM python:3.12-slim

# Set the working directory in the container
WORKDIR /app

# Copy the requirements file and install dependencies
COPY requirements.txt ./
RUN pip install --upgrade pip && pip install -r requirements.txt

# Copy the entire project
COPY . .

# Expose port (adjust as necessary)
EXPOSE 5000

# Command to run the Flask app
CMD ["python", "app/app.py"]
Crea l’immagine Docker con il seguente comando.
$ docker build -t kingabzpro/student_placement . 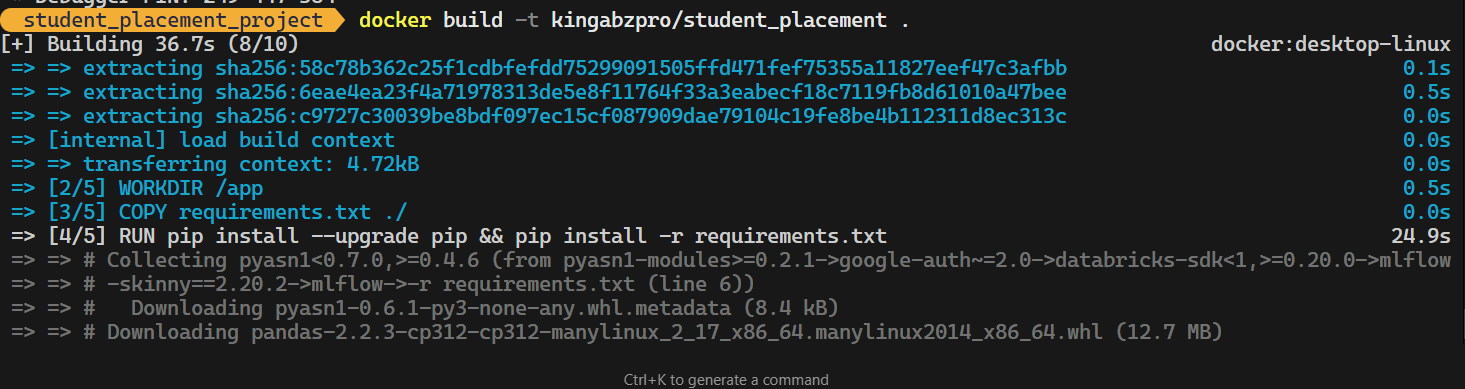
Esegui l’immagine Docker in locale.
$ docker run -p 5000:5000 kingabzpro/student_placementPuoi vedere che il nostro Docker è in esecuzione perfettamente.
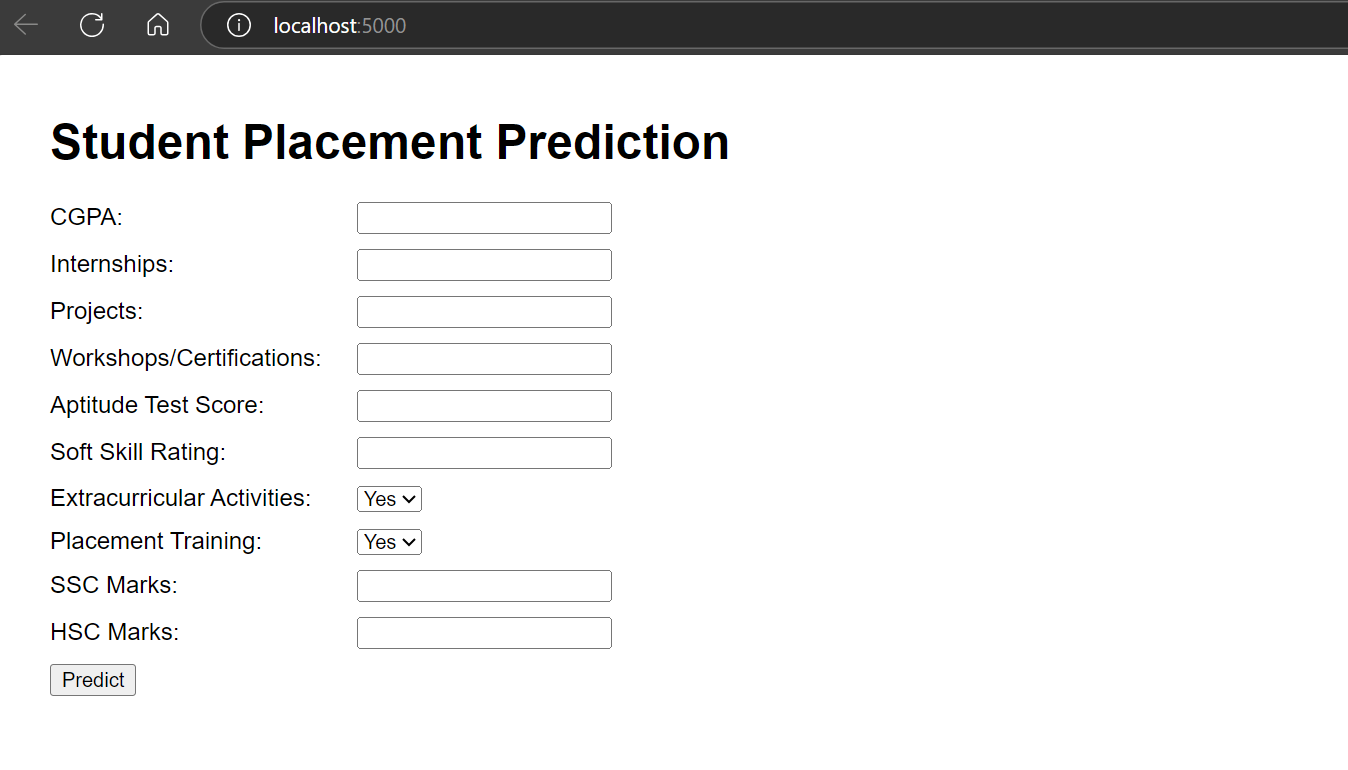
È il momento di distribuire la nostra applicazione di machine learning su Hugging Face Cloud (Space).
Per iniziare, puoi creare un nuovo space. Aggiungi tutte le informazioni necessarie sull’applicazione e seleziona Docker come SDK.
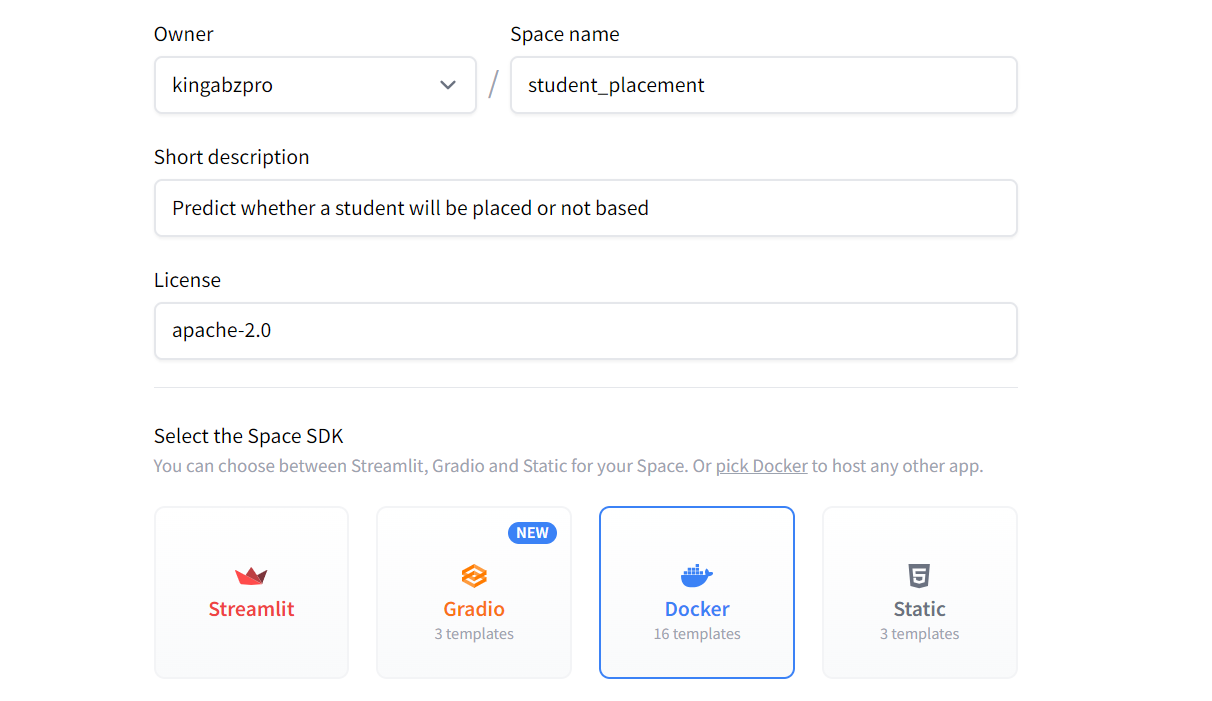
Dopo di che, verrà generato un URL per clonare l’applicazione in locale.
$ git clone https://huggingface.co/spaces/kingabzpro/student_placementPoi, sposta modello, scaler, la cartella app, il Dockerfile e requirements.txt nel repository dell’applicazione.
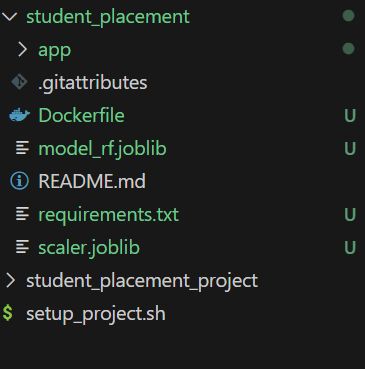
Puoi modificare il file app.py aggiornando l’ultima riga in:
app.run(host="0.0.0.0", port=7860, debug=True)Controlla la porta esposta nel Dockerfile. Dobbiamo farlo per evitare errori o problemi di porta:
# Expose port (adjust as necessary)
EXPOSE 7860
Una volta fatte tutte le modifiche, effettua il commit degli aggiornamenti e inviali al repository remoto:
$ cd .\student_placement\
$ git add .
$ git commit -m "Initial commit of Dockerized student placement app"
$ git push
Non appena effettui il push delle modifiche, inizierà il build e poi distribuirà l’interfaccia utente per la tua applicazione.
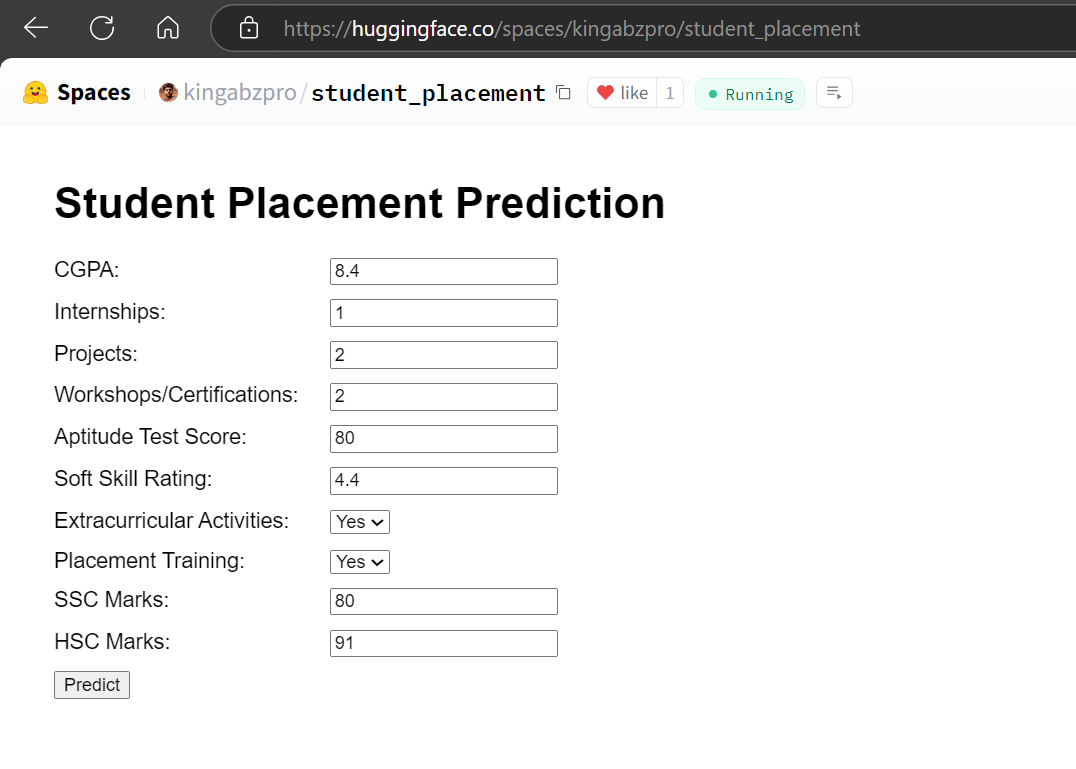
Fonte: Student Placement
o3-mini ha fatto un lavoro eccellente, dalla gestione della directory del progetto fino al deployment dell’applicazione web sul cloud.
Puoi anche leggere del modello all’avanguardia di Google e imparare a creare la tua applicazione di AI seguendo il tutorial Building Multimodal AI Application with Gemini 2.0 Pro.
Il modello o3-mini è particolare, il che significa che devi prestare attenzione quando fai richieste successive e quando effettui il debug del codice. Ecco alcuni consigli per lavorare al meglio con lui:
Quando fornisci istruzioni, assicurati che siano chiare e coerenti. Se dai più comandi, o3-mini darà priorità all’istruzione più recente. Questo significa che l’ultimo comando in una lunga catena di prompt avrà la precedenza, potenzialmente sovrascrivendo quelli precedenti.
Alcuni problemi di codice potrebbero dover essere risolti manualmente invece di affidarti al modello. Se chiedi a o3-mini di correggere una parte specifica del codice, modificherà solo quella sezione. Tuttavia, questo può portare alla rottura di parti correlate del codice, perché il modello non sempre considera dipendenze o contesto più ampio.
Includi tutti i dettagli rilevanti nel tuo prompt, come dati grezzi, righe e colonne ben definite e qualsiasi contesto aggiuntivo. Questo aiuta il modello a comprendere meglio la tua richiesta e a produrre risultati superiori.
Indica chiaramente cosa vuoi che il modello restituisca. Ad esempio, specifica se ti servono cartelle, file, comandi Docker o una guida passo passo su come implementare la soluzione. Questo assicura che l’output sia in linea con le tue aspettative.
Inizia con un prompt base ben strutturato che copra il 90% di ciò che ti serve. Una volta stabilita la base, puoi fornire comandi successivi per rifinire, correggere o aggiungere altri passaggi al processo.
Il modello o3-mini si distingue come scelta superiore rispetto a GPT-4o, offrendo prestazioni più rapide di o1 ed eccellendo in compiti come la scrittura di codice Python e HTML. Sorprendentemente, il codice Python generato da o3-mini gira per lo più senza problemi. Può persino migliorare il codice HTML, aiutandoti a ottimizzare l’interfaccia utente e a renderla più gradevole visivamente.
In questo tutorial abbiamo esplorato la potenza del modello o3-mini nel contesto di un progetto di machine learning. o3-mini si dimostra un ottimo strumento per data scientist, machine learning engineer e professionisti tecnici. La sua capacità di gestire compiti complessi in modo efficiente lo rende una risorsa preziosa in qualsiasi workflow.
Per ottenere i risultati migliori, ti basta fornire nel prompt iniziale un contesto completo, con tutti i contenuti e i deliverable rilevanti. Una volta che il modello genera l’output, puoi passare al tuo editor di codice, iniziare a eseguire gli script e implementare il codice fornito insieme alle sue istruzioni.
Il prossimo passo è imparare come distribuire i tuoi LLM all’avanguardia sul cloud. Invece di dipendere da OpenAI, questo ti dà pieno controllo su costi, accuratezza e accessibilità dei tuoi dati. Segui il tutorial How to Deploy LLMs with BentoML per imparare tutto il processo.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



