
Kurs
Arbeiten mit der OpenAI-API
3 Std.
172.6K
Nach dem Launch von DeepSeek R1 hat OpenAI mit seinem eigenen, hochmodernen Reasoning-Modell reagiert: o3-mini. Das neue Modell ist kleiner, schneller und effizienter als sein Vorgänger o1 und überzeugt vor allem bei Aufgaben rund um Coding, MINT-Themen und logisches Problemlösen.
OpenAI stellt dieses Modell allen Nutzenden kostenlos zur Verfügung – auch in ChatGPT und auf anderen Plattformen. Damit sind fortgeschrittene Reasoning-Fähigkeiten so zugänglich wie nie zuvor.
Weitere Details zu o3-mini findest du im Blogbeitrag OpenAI’s O3: Features, O1 Comparison, Release Date & More.
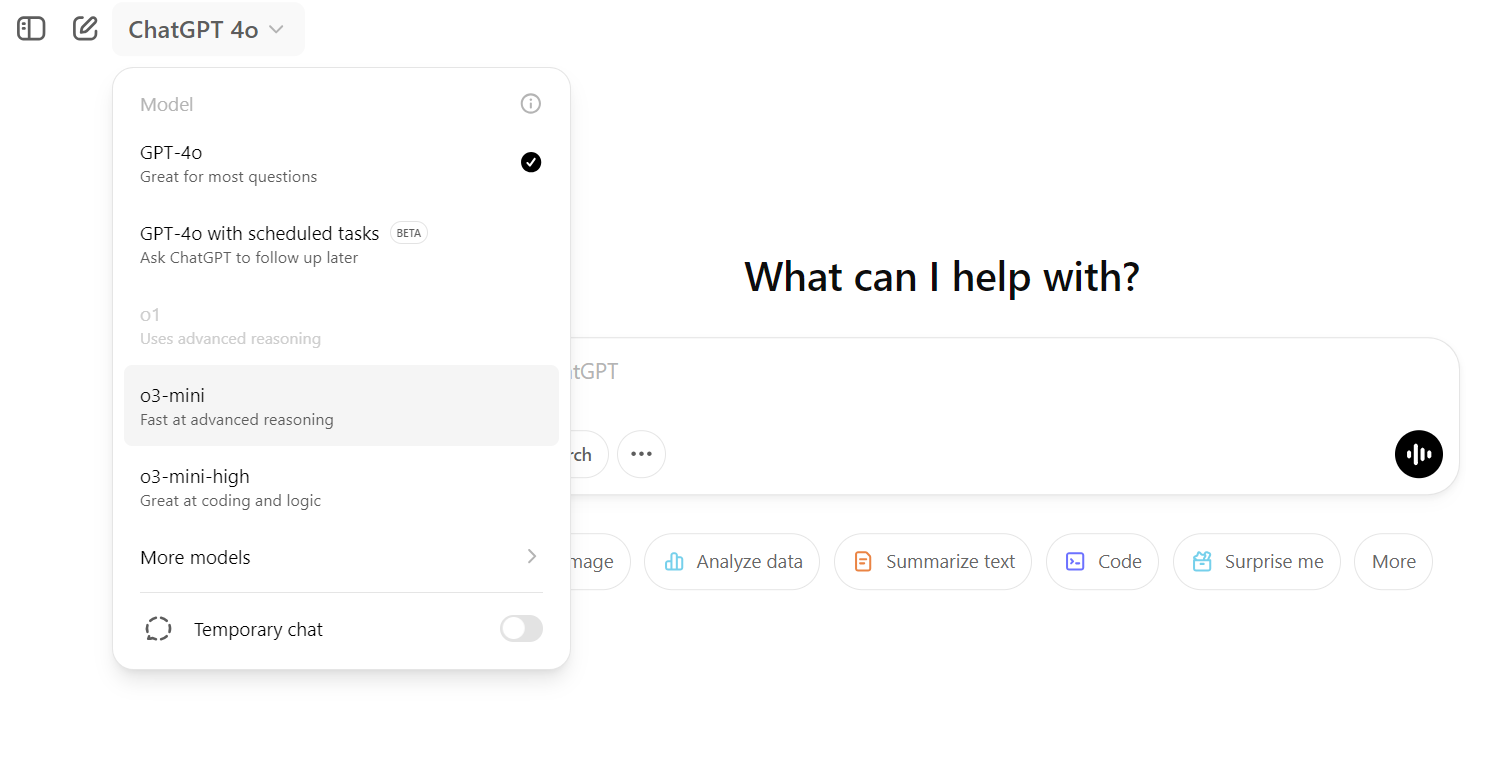
Quelle: ChatGPT
In diesem Tutorial erkunden wir die technischen Fähigkeiten von o3-mini. Konkret prüfen wir, wie gut es komplexe technische Aufgaben bewältigt, sauberen Code generiert und klare Anleitungen für Aufbau, Test und Deployment eines vollwertigen Machine-Learning-Modells liefert. Am Ende wollen wir klären, ob o3-mini seinem Anspruch als modernes Reasoning-Modell für technische und logische Aufgaben gerecht wird.
Bild: Autor
Wir bitten o3-mini, das Placement Prediction-Datenset zu nutzen, um eine Machine-Learning-App zu bauen, die vorhersagt, ob ein Student für eine Jobplatzierung infrage kommt oder nicht. Von der Planung bis zum Deployment holen wir uns Unterstützung vom o3-mini-Modell in ChatGPT.
In der Planungsphase versorgen wir o3-mini mit allen nötigen Infos und formulieren unsere Ziele. Wir lassen es alle Ordner und Dateien anlegen, die wir für Aufbau, Training und Deployment der Placement-Prediction-App brauchen.
Konkret werden wir:
Hier ist der Prompt:
“I want to build a machine learning project to predict whether a student will be placed or not based on their academic and extracurricular data. The dataset contains the following columns:

- **StudentID**: Unique identifier for each student.

- **CGPA**: The overall grades achieved by the student.

- **Internships**: Number of internships a student has completed.

- **Projects**: Number of projects a student has completed.

- **Workshops/Certifications**: Indicates whether the student has attended workshops or completed certifications to upskill themselves.

- **AptitudeTestScore**: Score achieved in an aptitude test, which evaluates quantitative and logical thinking.

- **SoftSkillRating**: A rating of the student’s communication and interpersonal skills.

- **ExtraCurricularActivities**: Indicates whether the student is active in extracurricular activities (Yes/No).

- **PlacementTraining**: Indicates whether the student has undergone placement training (Yes/No).

- **SSC and HSC**: Senior Secondary and Higher Secondary marks.

- **PlacementStatus**: The target column, which has two classes: "Placed" and "Not Placed."

Here is a sample dataset row:

StudentID,CGPA,Internships,Projects,Workshops/Certifications,AptitudeTestScore,SoftSkillsRating,ExtracurricularActivities,PlacementTraining,SSC_Marks,HSC_Marks,PlacementStatus

1,7.5,1,1,1,65,4.4,No,No,61,79,NotPlaced

I need help creating a structured project with the following components:

1. **Data Analysis**: Perform exploratory data analysis (EDA) to understand the dataset, visualize trends, and identify correlations between features and the target variable.

2. **Model Building**: Create a machine learning pipeline to preprocess the data and train a model to predict the placement status.

3. **Experiment Tracking**: Set up a system to track experiments, including model performance metrics, hyperparameters, and results.

4. **Model Training**: Train the model using appropriate algorithms and evaluate its performance using metrics like accuracy, precision, recall, and F1-score.

5. **Hyperparameter Tuning**: Optimize the model’s performance by tuning hyperparameters using techniques like grid search or random search.

6. **Model Inference Application**: Build an application (e.g., a web app or API) to allow users to input student data and get predictions on placement status.

7. **Dockerfile for Containerization**: Create a Dockerfile to containerize the application for easy deployment.

8. **Cloud Deployment**: Deploy the application on a cloud platform (e.g., AWS, Azure, or Google Cloud) to make it accessible online.

9. **Accessing the Model**: Provide a way to access the deployed model via an API or web interface.

Please provide the following:

- A folder structure for organizing the project files. (Also provide bash command for creating the folders and files.)

- Python scripts or code snippets for each of the above components.

- Suggestions for tools and libraries to use (e.g., pandas, scikit-learn, Flask, Docker, etc.).

- Guidance on setting up experiment tracking (using MLflow).

- Steps for deploying the model on a Hugging Face Space.”
Im Gegenzug erhältst du eine detaillierte Antwort zur Projektstruktur und dazu, wie du alles von Grund auf aufbaust.
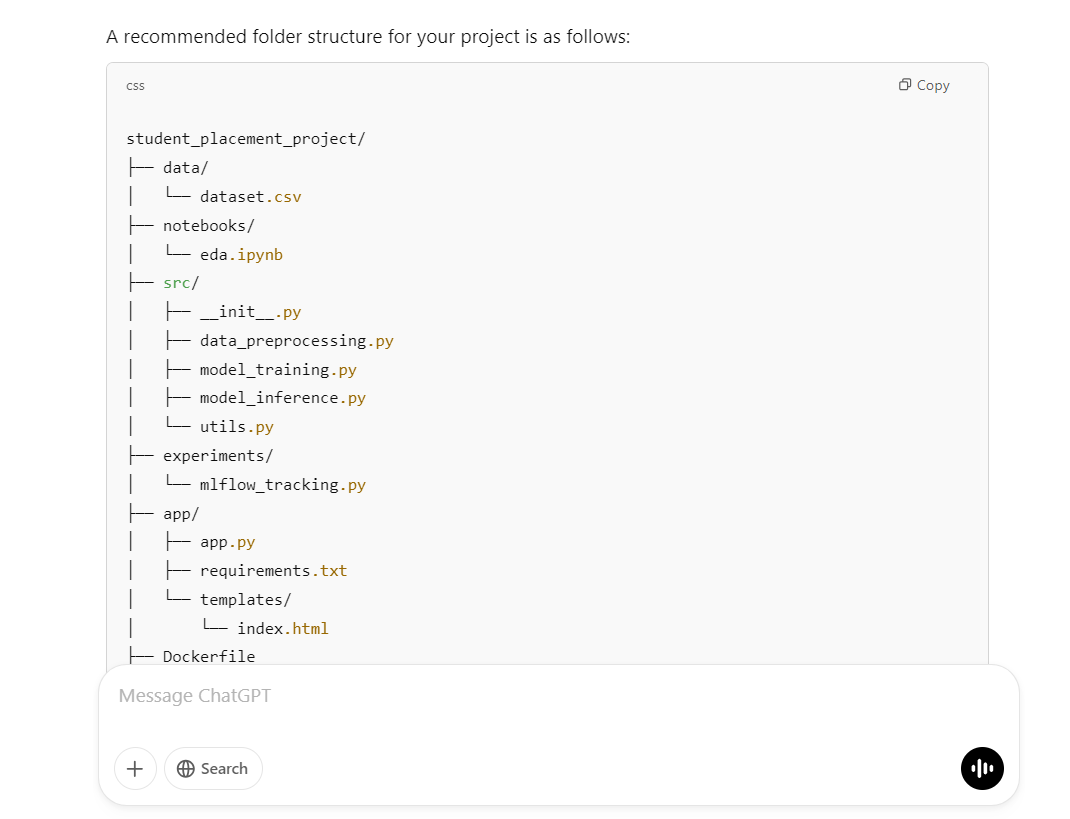
Das bereitgestellte Skript legt das Projektverzeichnis, die Ordner und alle notwendigen Dateien an:
mkdir -p student_placement_project/{data,notebooks,src,experiments,app/templates}
touch student_placement_project/data/dataset.csv \
      student_placement_project/notebooks/eda.ipynb \
      student_placement_project/src/{__init__.py,data_preprocessing.py,model_training.py,model_inference.py,utils.py} \
      student_placement_project/experiments/mlflow_tracking.py \
      student_placement_project/app/{app.py,requirements.txt} \
      student_placement_project/app/templates/index.html \
      student_placement_project/{Dockerfile,requirements.txt,README.md}
Wie du siehst, erledigt dieses Skript alle nötigen Schritte für uns.
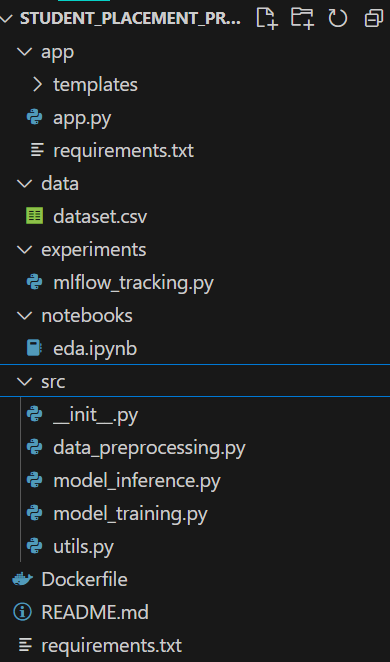
Die Antwort enthält den Code für das Jupyter-Notebook. Du musst den Code nur nacheinander einfügen und ausführen, um die Ergebnisse zu sehen.
# notebooks/eda.ipynb
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
import numpy as np

# Load dataset
df = pd.read_csv('../data/dataset.csv')

# Basic info and descriptive statistics
print(df.info())
print(df.describe())

# Visualize distributions
sns.histplot(df['CGPA'], bins=20, kde=True)
plt.title('Distribution of CGPA')
plt.show()

# Correlation matrix
plt.figure(figsize=(10, 8))

# Compute correlation matrix only on numeric columns
numeric_df = df.select_dtypes(include=[np.number])
plt.figure(figsize=(10, 8))
corr = numeric_df.corr()
sns.heatmap(corr, annot=True, cmap="coolwarm")
plt.title("Feature Correlation Matrix")


# Count plot for PlacementStatus
sns.countplot(x='PlacementStatus', data=df)
plt.title('Placement Status Count')
plt.show()
So sieht das Ergebnis aus. Alle Analysen und Diagramme liegen übersichtlich in einer Datei – ideal zur Durchsicht.
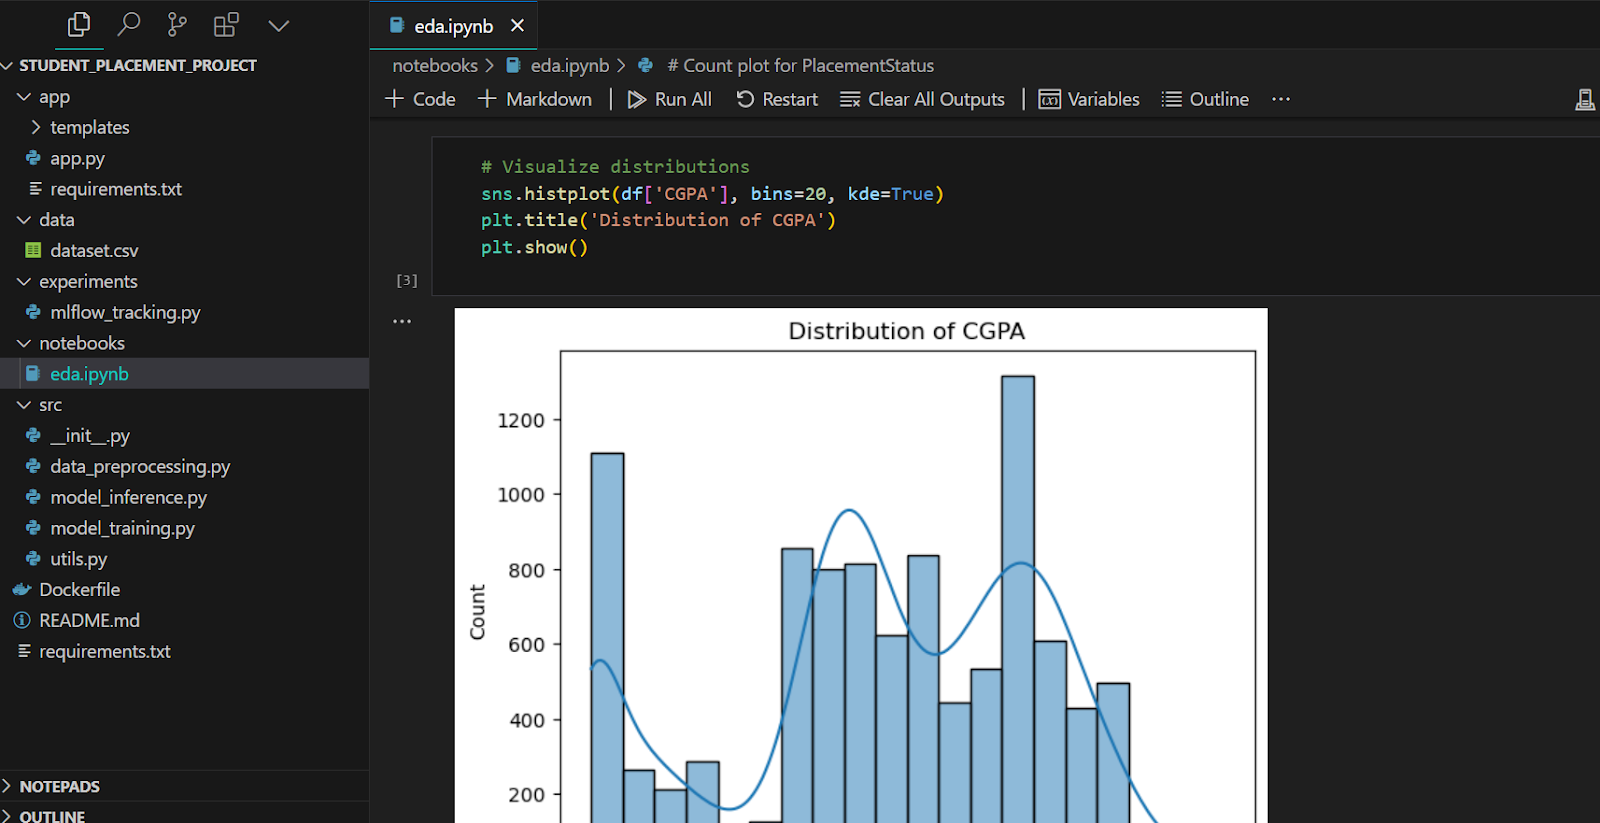
Als Nächstes erstellen wir die Datei zur Datenvorverarbeitung. Abgesehen von ein paar kleinen Anpassungen läuft der Code reibungslos.
# src/data_preprocessing.py
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler


def load_and_preprocess_data(filepath):
    df = pd.read_csv(filepath)

    # Convert categorical columns
    df["ExtracurricularActivities"] = df["ExtracurricularActivities"].map(
        {"Yes": 1, "No": 0}
    )
    df["PlacementTraining"] = df["PlacementTraining"].map({"Yes": 1, "No": 0})
    df["Workshops/Certifications"] = df["Workshops/Certifications"].astype(
        int
    )  # assuming it's already 0/1

    # Convert target column to binary
    df["PlacementStatus"] = df["PlacementStatus"].map({"Placed": 1, "NotPlaced": 0})

    # Feature selection (excluding StudentID)
    X = df.drop(["StudentID", "PlacementStatus"], axis=1)
    y = df["PlacementStatus"]

    # Split dataset
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42
    )

    # Scaling numeric features (optional)
    scaler = StandardScaler()
    X_train_scaled = scaler.fit_transform(X_train)
    X_test_scaled = scaler.transform(X_test)

return X_train_scaled, X_test_scaled, y_train, y_test, scalerDas Trainingsskript importiert die Datenverarbeitung, bereitet die Daten auf und trainiert anschließend ein Random-Forest-Modell. Zum Schluss werden die Leistungskennzahlen ausgegeben.
# src/model_training.py
import joblib
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
from data_preprocessing import load_and_preprocess_data


def train_model(data_path):
    X_train, X_test, y_train, y_test, scaler = load_and_preprocess_data(data_path)

    # Initialize and train classifier
    clf = RandomForestClassifier(n_estimators=100, random_state=42)
    clf.fit(X_train, y_train)

    # Predictions and evaluation
    y_pred = clf.predict(X_test)
    metrics = {
        "accuracy": accuracy_score(y_test, y_pred),
        "precision": precision_score(y_test, y_pred),
        "recall": recall_score(y_test, y_pred),
        "f1_score": f1_score(y_test, y_pred),
    }
    print("Model Evaluation Metrics:", metrics)

    # Save model and scaler
    joblib.dump(clf, "model_rf.joblib")
    joblib.dump(scaler, "scaler.joblib")

    return clf, scaler, metrics


if __name__ == "__main__":
    train_model("data/dataset.csv")
Eine Genauigkeit von 78% ist ein solider Start.
$ python .\src\model_training.py

Model Evaluation Metrics: {'accuracy': 0.781, 'precision': 0.7462121212121212, 'recall': 0.7137681159420289, 'f1_score': 0.7296296296296296}
Wenn du tiefer in das Thema einsteigen willst, schau dir unser beliebtes LLM-Tutorial Fine-Tuning DeepSeek R1 (Reasoning Model) an. Darin wird gezeigt, wie das weltweit erste Open-Source-Reasoning-Modell auf einem medizinischen Chain-of-Thought-Datensatz feinjustiert wird – ein Schritt zu besseren KI-Ärztinnen und -Ärzten der Zukunft.
Wir möchten die Python-Skripte nicht in einem separaten Ordner behalten. Wir verschieben die Datei mlflow_tracking.py in den Ordner src und entfernen den Ordner experiments. Bitte beachte, dass du dafür ein paar kleinere Änderungen manuell vornehmen musst, statt o3-mini zu bitten.
# src/mlflow_tracking.py
import mlflow
import mlflow.sklearn
from model_training import train_model


def run_experiment(data_path):
    mlflow.set_experiment("Student_Placement_Prediction")

    with mlflow.start_run():
        # Train the model
        clf, scaler, metrics = train_model(data_path)

        # Log parameters (example)
        mlflow.log_param("model_type", "RandomForest")
        mlflow.log_param("n_estimators", 100)

        # Log metrics
        mlflow.log_metric("accuracy", metrics["accuracy"])
        mlflow.log_metric("precision", metrics["precision"])
        mlflow.log_metric("recall", metrics["recall"])
        mlflow.log_metric("f1_score", metrics["f1_score"])

        # Log the model
        mlflow.sklearn.log_model(clf, "model")

        print("Experiment logged in MLflow.")


if __name__ == "__main__":
    run_experiment("data/dataset.csv")
Das Python-Skript lief ohne Probleme und hat alle Informationen erfasst.
$ python .\src\mlflow_tracking.py
Model Evaluation Metrics: {'accuracy': 0.781, 'precision': 0.7462121212121212, 'recall': 0.7137681159420289, 'f1_score': 0.7296296296296296}
2025/02/17 00:03:34 WARNING mlflow.models.model: Model logged without a signature and input example. Please set `input_example` parameter when logging the model to auto infer the model signature.
Experiment logged in MLflow.
Alle Machine-Learning-Experimente werden lokal gespeichert und können über die MLflow-UI visualisiert werden.
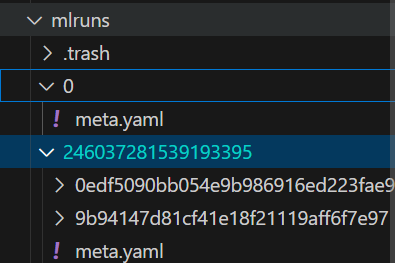
Die o3-mini-Antwort liefert auch einen optionalen Schritt, den du in model_training.py ergänzen kannst. Wir haben ihn aufgenommen, um zu sehen, ob sich die Modellleistung verbessert.
# src/model_training.py
import joblib
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
from data_preprocessing import load_and_preprocess_data
from sklearn.model_selection import GridSearchCV


def tune_model(X_train, y_train):
    param_grid = {"n_estimators": [50, 100, 150], "max_depth": [None, 5, 10]}
    clf = RandomForestClassifier(random_state=42)
    grid_search = GridSearchCV(clf, param_grid, cv=5, scoring="f1")
    grid_search.fit(X_train, y_train)
    print("Best parameters:", grid_search.best_params_)
    return grid_search.best_estimator_

def train_model(data_path):
    X_train, X_test, y_train, y_test, scaler = load_and_preprocess_data(data_path)

    # Initialize and train classifier
    clf = tune_model(X_train, y_train)

    # Predictions and evaluation
    y_pred = clf.predict(X_test)
    metrics = {
        "accuracy": accuracy_score(y_test, y_pred),
        "precision": precision_score(y_test, y_pred),
        "recall": recall_score(y_test, y_pred),
        "f1_score": f1_score(y_test, y_pred),
    }
    print("Model Evaluation Metrics:", metrics)

    # Save model and scaler
    joblib.dump(clf, "model_rf.joblib")
    joblib.dump(scaler, "scaler.joblib")

    return clf, scaler, metrics


if __name__ == "__main__":
    train_model("data/dataset.csv")
Wie du siehst, hat sich die Modellleistung durch Hyperparameter-Optimierung leicht verbessert.
$ python .\src\model_training.py
Best parameters: {'max_depth': 5, 'n_estimators': 150}
Model Evaluation Metrics: {'accuracy': 0.791, 'precision': 0.7493917274939172, 'recall': 0.7439613526570048, 'f1_score': 0.7466666666666667}Jetzt erstellen wir die Modellinferenz. Wir entwickeln eine Flask-Webanwendung.
Zuerst laden wir Modell und Scaler. Anschließend verarbeiten wir die Nutzereingaben und übergeben sie an das Modell, um eine Vorhersage zu erzeugen. Die Anwendung ist bewusst schlank gehalten.
import joblib
import numpy as np

app = Flask(__name__)

# Load the trained model and scaler (update paths as necessary)
model = joblib.load("model_rf.joblib")
scaler = joblib.load("scaler.joblib")


@app.route("/")
def home():
    return render_template("index.html")


@app.route("/predict", methods=["POST"])
def predict():
    try:
        # Expecting form data from the HTML template
        CGPA = float(request.form.get("CGPA"))
        Internships = int(request.form.get("Internships"))
        Projects = int(request.form.get("Projects"))
        Workshops_Certifications = int(request.form.get("Workshops_Certifications"))
        AptitudeTestScore = float(request.form.get("AptitudeTestScore"))
        SoftSkillRating = float(request.form.get("SoftSkillRating"))
        ExtracurricularActivities = request.form.get("ExtracurricularActivities")
        PlacementTraining = request.form.get("PlacementTraining")
        SSC_Marks = float(request.form.get("SSC_Marks"))
        HSC_Marks = float(request.form.get("HSC_Marks"))

        # Convert categorical fields to numerical
        extra_act = 1 if ExtracurricularActivities.lower() == "yes" else 0
        placement_training = 1 if PlacementTraining.lower() == "yes" else 0

        # Construct feature vector
        features = [
            CGPA,
            Internships,
            Projects,
            Workshops_Certifications,
            AptitudeTestScore,
            SoftSkillRating,
            extra_act,
            placement_training,
            SSC_Marks,
            HSC_Marks,
        ]

        # Scale features and make prediction
        features_scaled = scaler.transform(np.array(features).reshape(1, -1))
        prediction = model.predict(features_scaled)
        result = "Placed" if prediction[0] == 1 else "Not Placed"

        return render_template("index.html", prediction=result)
    except Exception as e:
        return render_template("index.html", prediction=f"Error: {e}")


if __name__ == "__main__":
    app.run(host='0.0.0.0', port=5000, debug=True)
Für die Benutzeroberfläche fügen wir den HTML-Code in die Datei index.html ein. Alles stammt aus der o3-mini-Antwort. Du kannst o3-mini auch bitten, das UI zu verbessern.
<!-- app/templates/index.html -->
<!DOCTYPE html>
<html>
<head>
    <title>Student Placement Prediction</title>
</head>
<body>
    <h1>Student Placement Prediction</h1>
    <form action="/predict" method="post" id="predictForm">
        <!-- Create inputs for each feature. Example for CGPA: -->
        <label for="CGPA">CGPA:</label>
        <input type="number" step="0.1" id="CGPA" name="CGPA" required><br><br>
        <!-- Add more inputs as per features -->
        <button type="submit">Predict</button>
    </form>
    <div id="result"></div>
    <script>
      document.getElementById('predictForm').addEventListener('submit', async (e) => {
          e.preventDefault();
          const formData = new FormData(e.target);
          const data = Object.fromEntries(formData.entries());
          // Adjust keys to match what the API expects
          data.ExtracurricularActivities = data.ExtracurricularActivities || 'No';
          data.PlacementTraining = data.PlacementTraining || 'No';

          const response = await fetch('/predict', {
              method: 'POST',
              headers: {'Content-Type': 'application/json'},
              body: JSON.stringify(data)
          });
          const result = await response.json();
          document.getElementById('result').innerText = JSON.stringify(result);
      });
    </script>
</body>
</html>
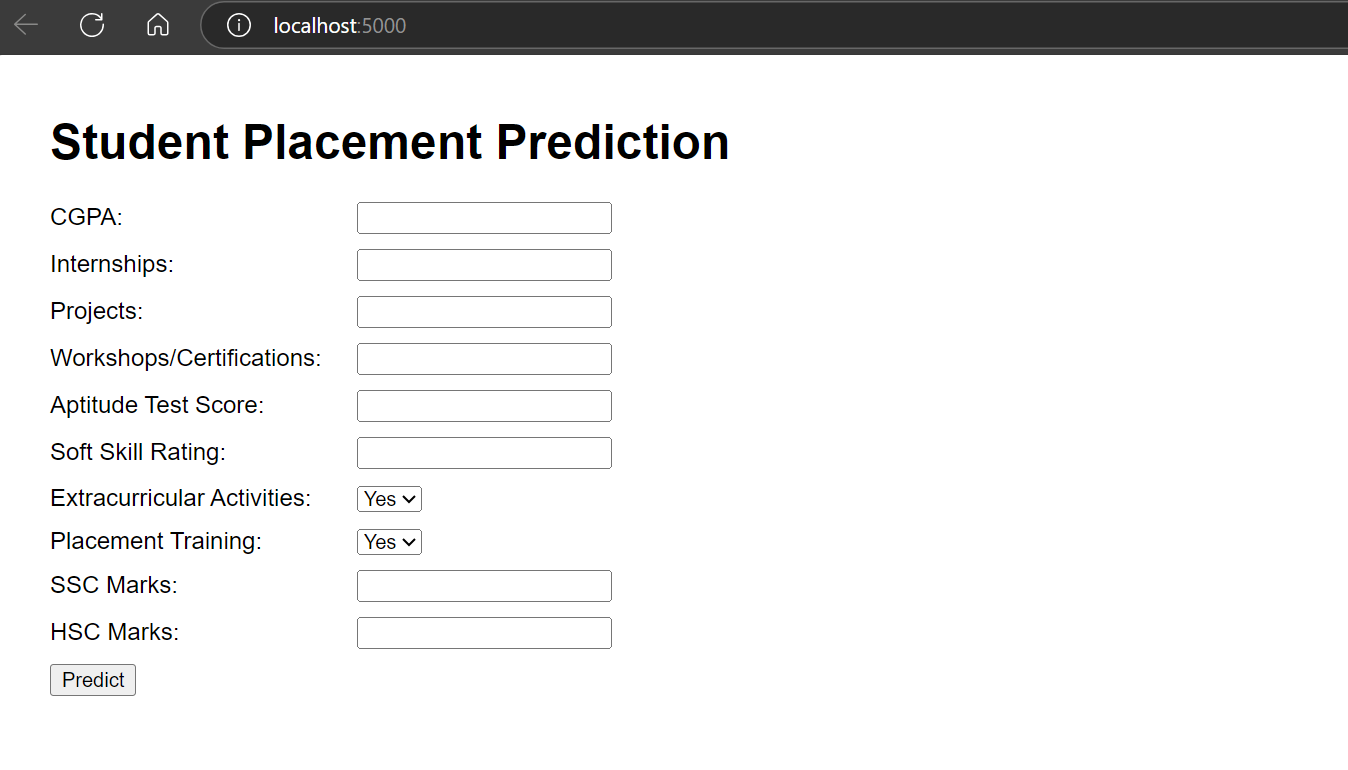
Sobald alles eingerichtet ist, starte die App und klicke auf die von Flask ausgegebene URL.
$ python .\app\app.py

 * Running on all addresses (0.0.0.0)
 * Running on http://127.0.0.1:5000
 * Running on http://192.168.100.41:5000
Unsere Web-App läuft einwandfrei.
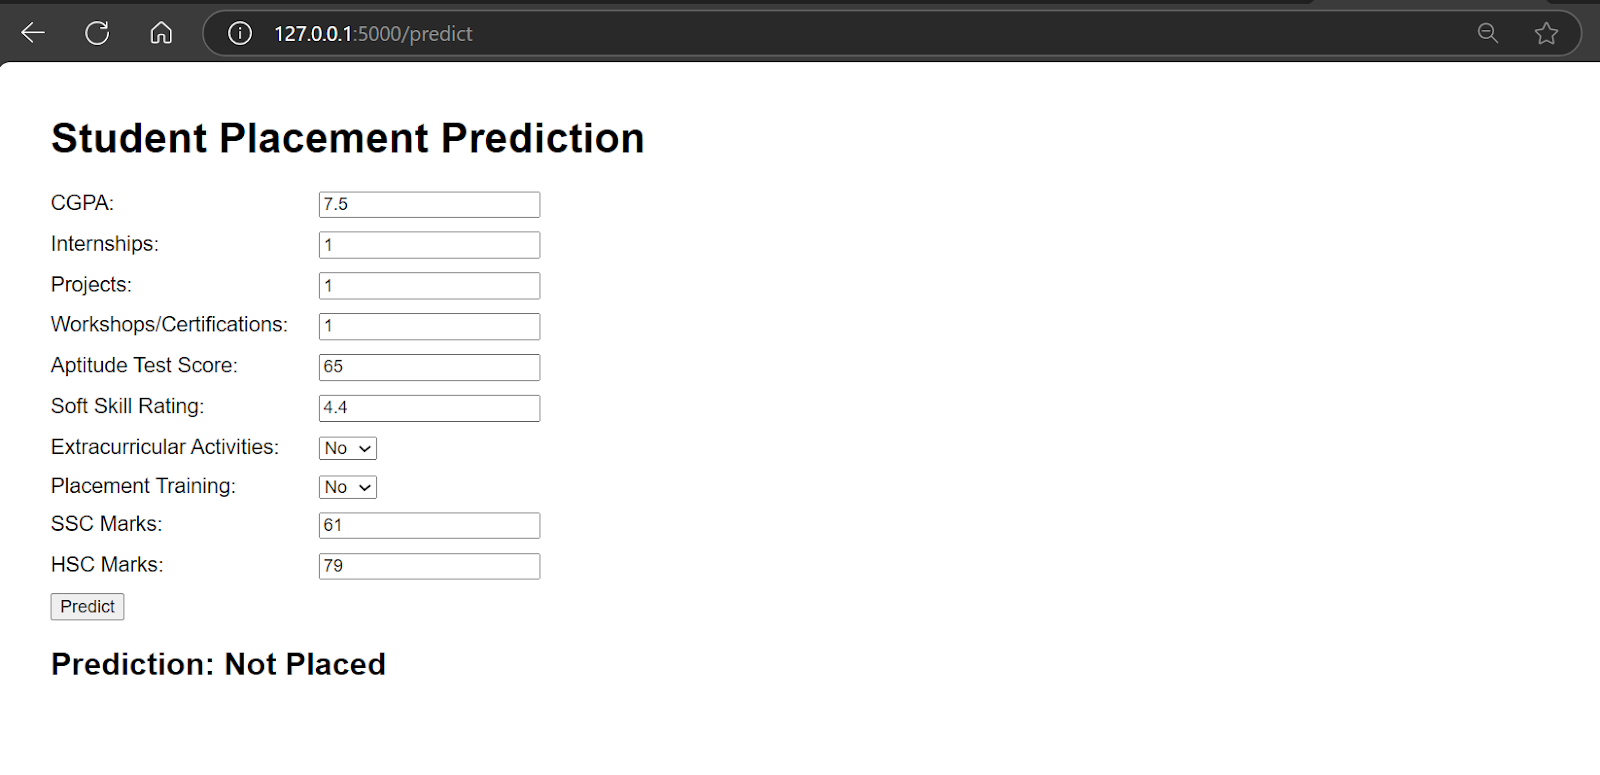
Das o3-mini-Modell hat uns auch ein Dockerfile geliefert. Wir müssen es nur lokal bauen und testen, bevor wir in die Cloud deployen.
# Use an official Python runtime as a parent image
FROM python:3.12-slim

# Set the working directory in the container
WORKDIR /app

# Copy the requirements file and install dependencies
COPY requirements.txt ./
RUN pip install --upgrade pip && pip install -r requirements.txt

# Copy the entire project
COPY . .

# Expose port (adjust as necessary)
EXPOSE 5000

# Command to run the Flask app
CMD ["python", "app/app.py"]
Baue das Docker-Image mit folgendem Befehl.
$ docker build -t kingabzpro/student_placement . 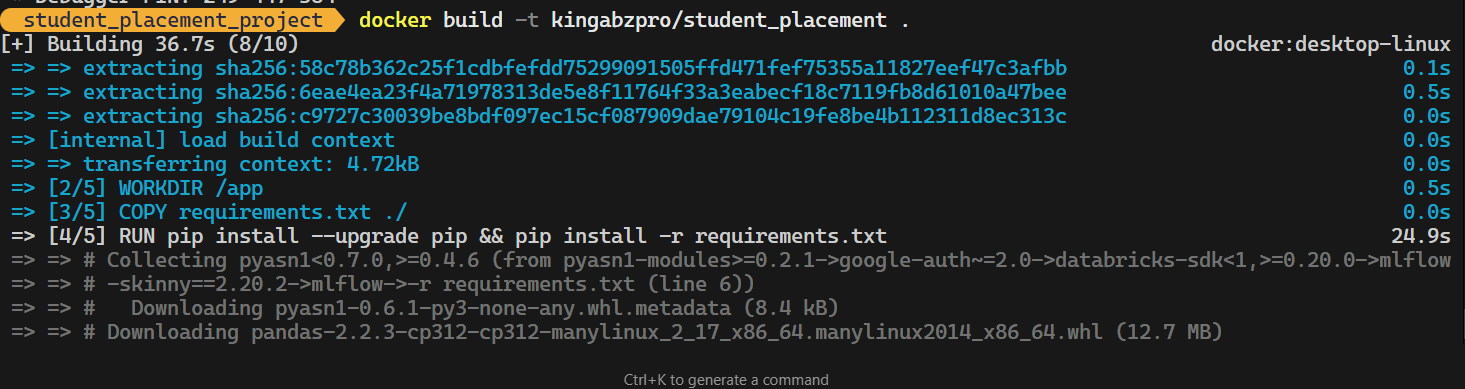
Starte das Docker-Image lokal.
$ docker run -p 5000:5000 kingabzpro/student_placementWie du siehst, läuft unser Docker-Container einwandfrei.
9. Cloud-Deployment
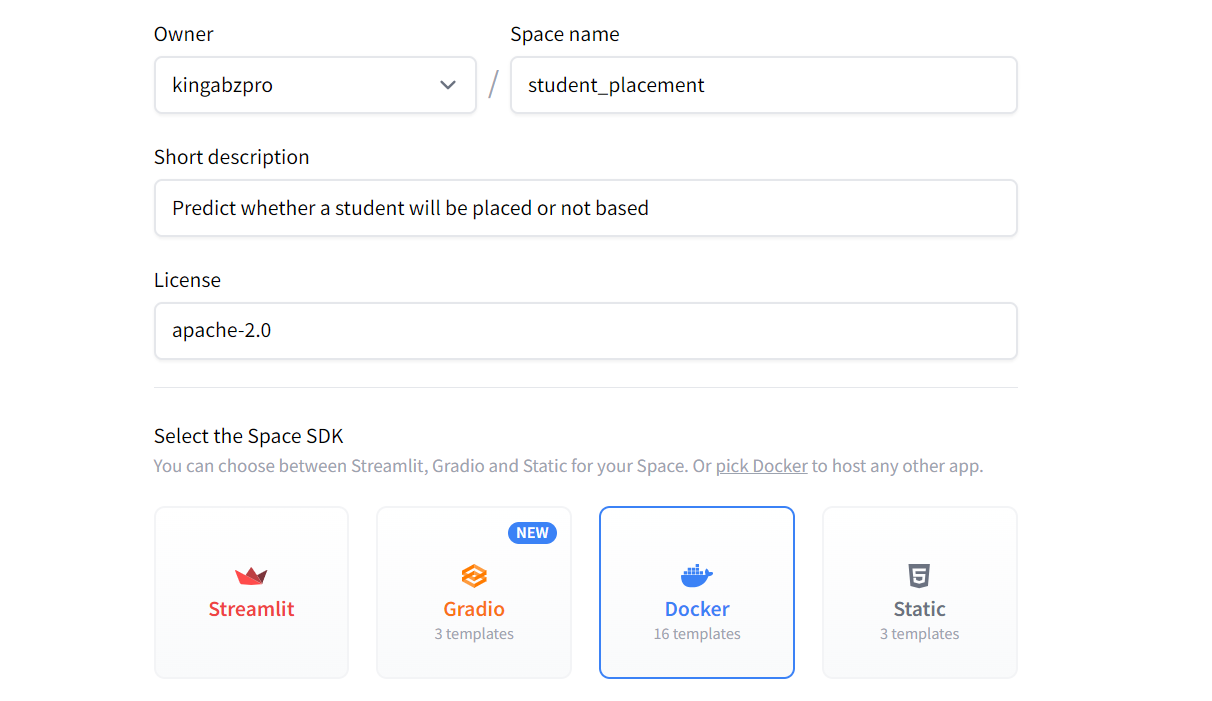
Jetzt deployen wir unsere Machine-Learning-Anwendung in der Hugging Face Cloud (Space).
Lege dazu zunächst einen neuen Space an. Trage die nötigen Infos zur Anwendung ein und wähle Docker als SDK.
Anschließend erhältst du eine URL, um die Anwendung lokal zu klonen.
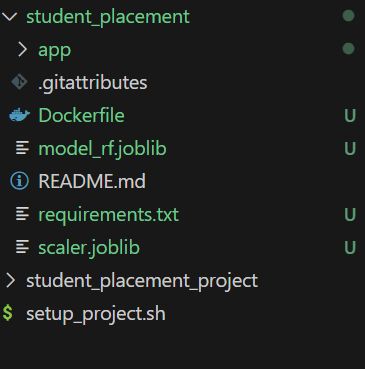
$ git clone https://huggingface.co/spaces/kingabzpro/student_placementVerschiebe dann Modell, Scaler, den Ordner
app, das Dockerfile und dierequirements.txtins App-Repository.
Du kannst in der
app.pydie letzte Zeile wie folgt anpassen:app.run(host="0.0.0.0", port=7860, debug=True)Prüfe außerdem den im Dockerfile freigegebenen Port. So vermeidest du Portkonflikte:
# Expose port (adjust as necessary) EXPOSE 7860Sobald alles passt, committe deine Änderungen und pushe sie ins Remote-Repository:
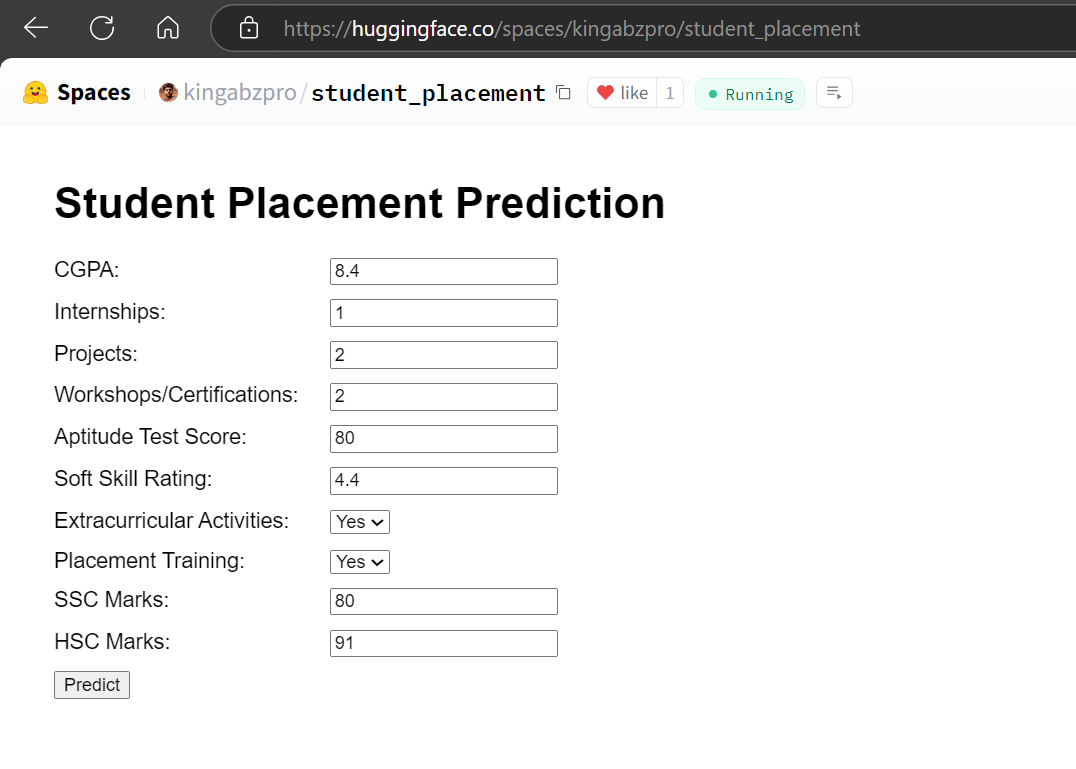
$ cd .\student_placement\ $ git add . $ git commit -m "Initial commit of Dockerized student placement app" $ git pushDirekt nach dem Push startet der Build und anschließend wird die Benutzeroberfläche deiner Anwendung bereitgestellt.
Quelle: Student Placement
o3-mini hat hier ganze Arbeit geleistet – von der Verzeichnisstruktur bis zum erfolgreichen Cloud-Deployment der Web-App.
Mehr zu Googles State-of-the-Art-Modell und wie du damit eine eigene KI-Anwendung baust, erfährst du im Tutorial Building Multimodal AI Application with Gemini 2.0 Pro.
Tipps für wirksame o3-mini-Prompts
o3-mini ist besonders – deshalb solltest du bei Folgeanfragen und beim Debuggen genau vorgehen. Diese Tipps helfen dir bei der Zusammenarbeit:
1. Widersprüchliche Anweisungen vermeiden
Formuliere klare, konsistente Anweisungen. Gibst du mehrere Befehle, priorisiert o3-mini den jüngsten. In langen Prompt-Ketten kann der letzte Befehl frühere Vorgaben überlagern.
2. Manuelles Debugging kann nötig sein
Einige Codeprobleme solltest du manuell lösen statt sie vom Modell fixen zu lassen. Wenn du o3-mini bittest, einen bestimmten Abschnitt zu korrigieren, ändert es nur diesen Teil. Abhängigkeiten oder der Gesamtkontext werden nicht immer berücksichtigt – dadurch können andere Stellen brechen.
3. Umfassenden Kontext bereitstellen
Füge alle relevanten Details in deinen Prompt ein – Rohdaten, klar definierte Zeilen und Spalten sowie zusätzlichen Kontext. So versteht das Modell deine Anfrage besser und liefert treffendere Ergebnisse.
4. Deliverables präzise angeben
Sage genau, was du zurückbekommen willst: Ordner, Dateien, Docker-Befehle oder eine Schritt-für-Schritt-Anleitung zur Umsetzung. So stellst du sicher, dass das Ergebnis deinen Erwartungen entspricht.
5. Einen starken Basis-Prompt bauen
Starte mit einem gut strukturierten Basis-Prompt, der 90% deines Bedarfs abdeckt. Danach kannst du mit Folgeanweisungen verfeinern, korrigieren oder weitere Schritte ergänzen.
Fazit
Das o3-mini-Modell ist eine hervorragende Wahl im Vergleich zu GPT-4o, schneller als o1 und stark bei Aufgaben wie Python- und HTML-Coding. Bemerkenswert: Von o3-mini generierter Python-Code läuft in den meisten Fällen direkt problemlos. Außerdem kann es HTML verbessern, um dein UI ansprechender zu gestalten.
In diesem Tutorial haben wir die Stärken von o3-mini im Kontext eines Machine-Learning-Projekts gezeigt. o3-mini ist ein wertvolles Werkzeug für Data Scientists, ML Engineers und technische Profis. Die Fähigkeit, komplexe Aufgaben effizient zu meistern, macht es zu einer echten Bereicherung für jeden Workflow.
Für bestmögliche Ergebnisse lieferst du im ersten Prompt umfassenden Kontext – inklusive aller relevanten Inhalte und Deliverables. Anschließend wechselst du in deinen Code-Editor, führst die Skripte aus und setzt den gelieferten Code samt Anleitung um.
Als Nächstes solltest du lernen, wie du eigene State-of-the-Art-LLMs in der Cloud bereitstellst. Statt dich auf OpenAI zu verlassen, behältst du so die volle Kontrolle über Preis, Genauigkeit und Datenzugriff. Folge dem Tutorial How to Deploy LLMs with BentoML und lerne den gesamten Prozess kennen.
Top-DataCamp-Kurse
Kurs
Kurs
Kurs