Curso
Trabajar con la API de OpenAI
3 h
172.6K
Tras el lanzamiento de DeepSeek R1, OpenAI ha respondido con su propio modelo de razonamiento de última generación: o3-mini. Este nuevo modelo está diseñado para ser más pequeño, rápido y eficiente que su predecesor, el modelo o1, y destaca en tareas de programación, STEM y resolución lógica de problemas.
OpenAI ha puesto este modelo a disposición de todos los usuarios de forma gratuita, incluidos quienes usan ChatGPT y otras plataformas, haciendo que las capacidades avanzadas de razonamiento estén más al alcance que nunca.
Para más detalles sobre o3-mini, puedes consultar la entrada del blog, OpenAI’s O3: Features, O1 Comparison, Release Date & More.
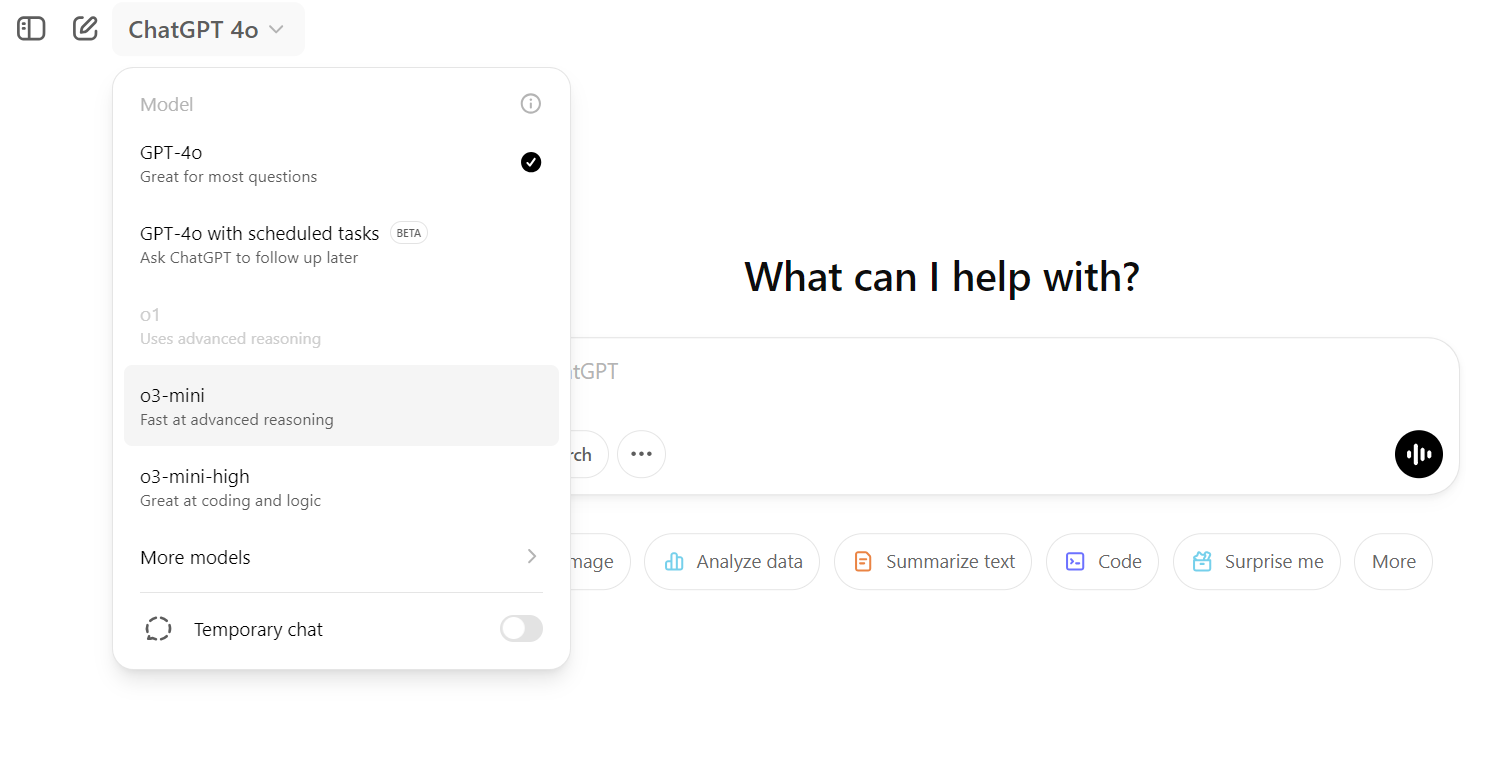
Fuente: ChatGPT
En este tutorial, exploraremos las capacidades técnicas del modelo o3-mini. En concreto, pondremos a prueba su habilidad para abordar tareas técnicas complejas, generar código preciso y ofrecer instrucciones claras para crear, probar y desplegar un modelo de machine learning en condiciones. Al final, queremos determinar si o3-mini está a la altura de su promesa como modelo puntero de razonamiento para tareas técnicas y de resolución lógica de problemas.
Imagen del autor
Pediremos a o3-mini que use el conjunto de datos Placement Prediction para construir una aplicación de machine learning que determine si un estudiante es apto para la inserción laboral o no. Desde la planificación hasta el despliegue de la solución, nos apoyaremos en el modelo o3-mini en ChatGPT.
En la fase de planificación, proporcionaremos al modelo o3-mini toda la información necesaria y definiremos nuestros objetivos. Le pediremos que cree todas las carpetas y archivos necesarios para construir, entrenar y desplegar la aplicación Placement Prediction.
En concreto, vamos a:
Este es el prompt:
“I want to build a machine learning project to predict whether a student will be placed or not based on their academic and extracurricular data. The dataset contains the following columns:

- **StudentID**: Unique identifier for each student.

- **CGPA**: The overall grades achieved by the student.

- **Internships**: Number of internships a student has completed.

- **Projects**: Number of projects a student has completed.

- **Workshops/Certifications**: Indicates whether the student has attended workshops or completed certifications to upskill themselves.

- **AptitudeTestScore**: Score achieved in an aptitude test, which evaluates quantitative and logical thinking.

- **SoftSkillRating**: A rating of the student’s communication and interpersonal skills.

- **ExtraCurricularActivities**: Indicates whether the student is active in extracurricular activities (Yes/No).

- **PlacementTraining**: Indicates whether the student has undergone placement training (Yes/No).

- **SSC and HSC**: Senior Secondary and Higher Secondary marks.

- **PlacementStatus**: The target column, which has two classes: "Placed" and "Not Placed."

Here is a sample dataset row:

StudentID,CGPA,Internships,Projects,Workshops/Certifications,AptitudeTestScore,SoftSkillsRating,ExtracurricularActivities,PlacementTraining,SSC_Marks,HSC_Marks,PlacementStatus

1,7.5,1,1,1,65,4.4,No,No,61,79,NotPlaced

I need help creating a structured project with the following components:

1. **Data Analysis**: Perform exploratory data analysis (EDA) to understand the dataset, visualize trends, and identify correlations between features and the target variable.

2. **Model Building**: Create a machine learning pipeline to preprocess the data and train a model to predict the placement status.

3. **Experiment Tracking**: Set up a system to track experiments, including model performance metrics, hyperparameters, and results.

4. **Model Training**: Train the model using appropriate algorithms and evaluate its performance using metrics like accuracy, precision, recall, and F1-score.

5. **Hyperparameter Tuning**: Optimize the model’s performance by tuning hyperparameters using techniques like grid search or random search.

6. **Model Inference Application**: Build an application (e.g., a web app or API) to allow users to input student data and get predictions on placement status.

7. **Dockerfile for Containerization**: Create a Dockerfile to containerize the application for easy deployment.

8. **Cloud Deployment**: Deploy the application on a cloud platform (e.g., AWS, Azure, or Google Cloud) to make it accessible online.

9. **Accessing the Model**: Provide a way to access the deployed model via an API or web interface.

Please provide the following:

- A folder structure for organizing the project files. (Also provide bash command for creating the folders and files.)

- Python scripts or code snippets for each of the above components.

- Suggestions for tools and libraries to use (e.g., pandas, scikit-learn, Flask, Docker, etc.).

- Guidance on setting up experiment tracking (using MLflow).

- Steps for deploying the model on a Hugging Face Space.”
A cambio, recibirás una respuesta detallada sobre la estructura del proyecto y cómo construirlo todo desde cero.
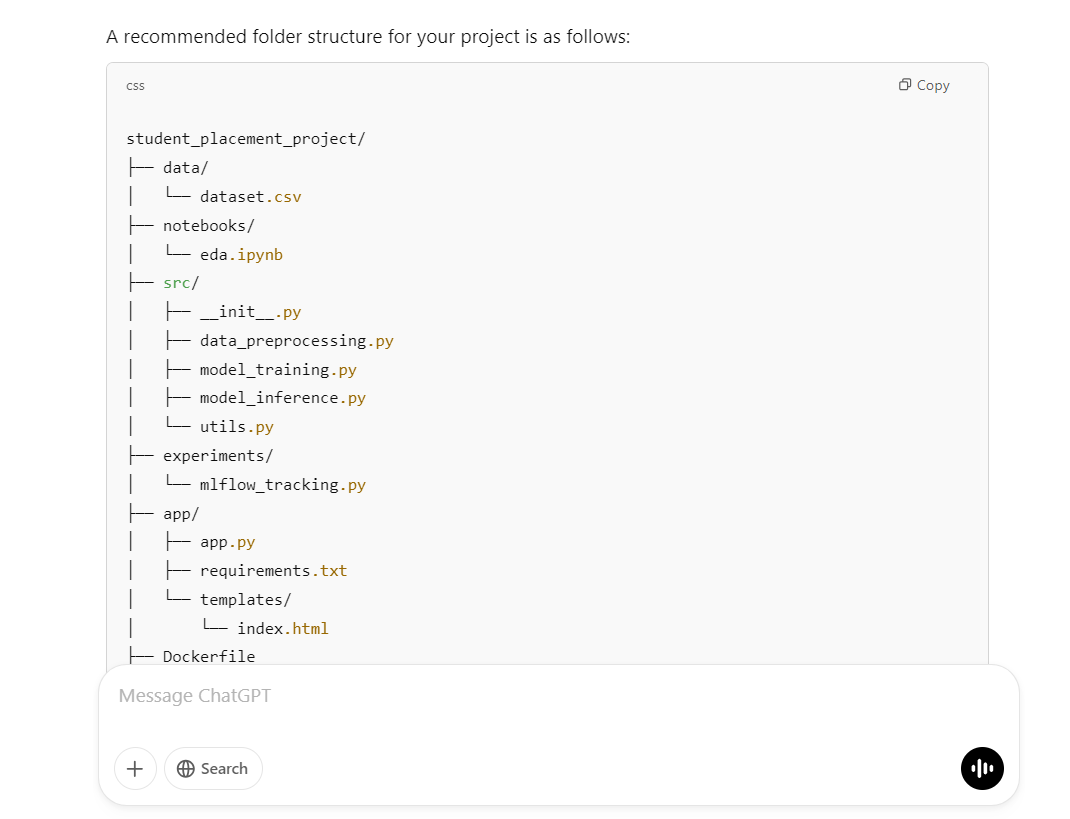
El script proporcionado creará el directorio del proyecto, las carpetas y todos los archivos necesarios:
mkdir -p student_placement_project/{data,notebooks,src,experiments,app/templates}
touch student_placement_project/data/dataset.csv \
      student_placement_project/notebooks/eda.ipynb \
      student_placement_project/src/{__init__.py,data_preprocessing.py,model_training.py,model_inference.py,utils.py} \
      student_placement_project/experiments/mlflow_tracking.py \
      student_placement_project/app/{app.py,requirements.txt} \
      student_placement_project/app/templates/index.html \
      student_placement_project/{Dockerfile,requirements.txt,README.md}
Como vemos, este script ha completado por nosotros todas las tareas necesarias.
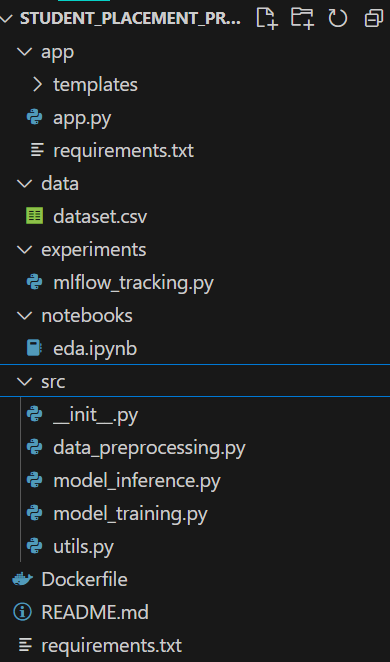
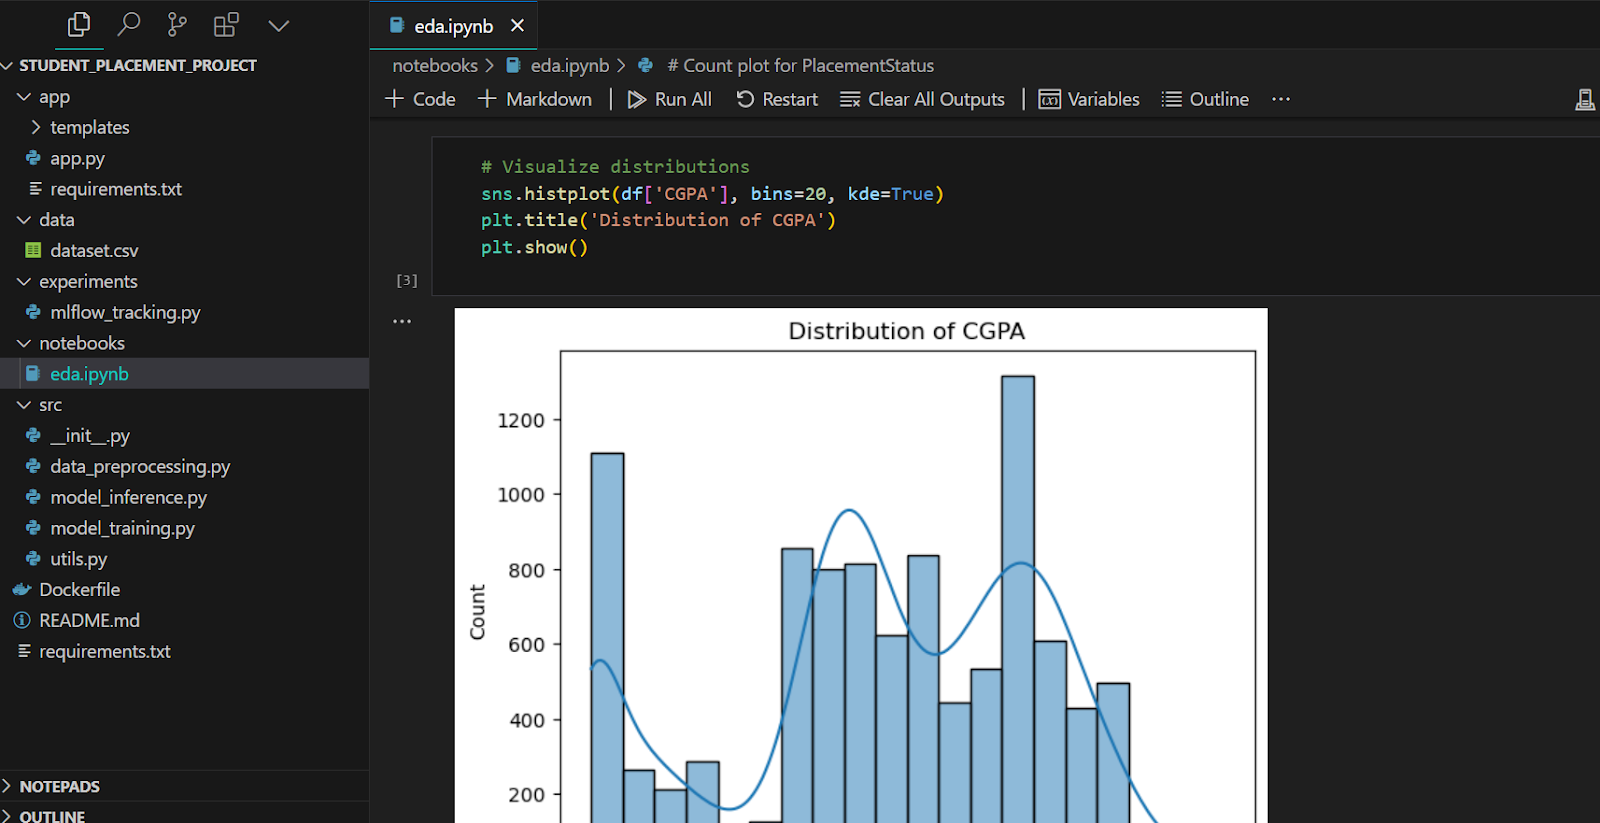
La respuesta incluye el código para el cuaderno de Jupyter. Solo tienes que pegar el código paso a paso y ejecutarlo para ver los resultados.
# notebooks/eda.ipynb
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
import numpy as np

# Load dataset
df = pd.read_csv('../data/dataset.csv')

# Basic info and descriptive statistics
print(df.info())
print(df.describe())

# Visualize distributions
sns.histplot(df['CGPA'], bins=20, kde=True)
plt.title('Distribution of CGPA')
plt.show()

# Correlation matrix
plt.figure(figsize=(10, 8))

# Compute correlation matrix only on numeric columns
numeric_df = df.select_dtypes(include=[np.number])
plt.figure(figsize=(10, 8))
corr = numeric_df.corr()
sns.heatmap(corr, annot=True, cmap="coolwarm")
plt.title("Feature Correlation Matrix")


# Count plot for PlacementStatus
sns.countplot(x='PlacementStatus', data=df)
plt.title('Placement Status Count')
plt.show()
Así queda. Todo el análisis y los gráficos están en un único archivo para que cualquiera los revise.
A continuación, crearemos el archivo de preprocesado. Salvo unos pequeños ajustes, este código funciona sin problema.
# src/data_preprocessing.py
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler


def load_and_preprocess_data(filepath):
    df = pd.read_csv(filepath)

    # Convert categorical columns
    df["ExtracurricularActivities"] = df["ExtracurricularActivities"].map(
        {"Yes": 1, "No": 0}
    )
    df["PlacementTraining"] = df["PlacementTraining"].map({"Yes": 1, "No": 0})
    df["Workshops/Certifications"] = df["Workshops/Certifications"].astype(
        int
    )  # assuming it's already 0/1

    # Convert target column to binary
    df["PlacementStatus"] = df["PlacementStatus"].map({"Placed": 1, "NotPlaced": 0})

    # Feature selection (excluding StudentID)
    X = df.drop(["StudentID", "PlacementStatus"], axis=1)
    y = df["PlacementStatus"]

    # Split dataset
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42
    )

    # Scaling numeric features (optional)
    scaler = StandardScaler()
    X_train_scaled = scaler.fit_transform(X_train)
    X_test_scaled = scaler.transform(X_test)

return X_train_scaled, X_test_scaled, y_train, y_test, scalerEl script de entrenamiento importa la función de procesamiento, prepara los datos y entrena un modelo de random forest. Al final, muestra las métricas de rendimiento del modelo.
# src/model_training.py
import joblib
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
from data_preprocessing import load_and_preprocess_data


def train_model(data_path):
    X_train, X_test, y_train, y_test, scaler = load_and_preprocess_data(data_path)

    # Initialize and train classifier
    clf = RandomForestClassifier(n_estimators=100, random_state=42)
    clf.fit(X_train, y_train)

    # Predictions and evaluation
    y_pred = clf.predict(X_test)
    metrics = {
        "accuracy": accuracy_score(y_test, y_pred),
        "precision": precision_score(y_test, y_pred),
        "recall": recall_score(y_test, y_pred),
        "f1_score": f1_score(y_test, y_pred),
    }
    print("Model Evaluation Metrics:", metrics)

    # Save model and scaler
    joblib.dump(clf, "model_rf.joblib")
    joblib.dump(scaler, "scaler.joblib")

    return clf, scaler, metrics


if __name__ == "__main__":
    train_model("data/dataset.csv")
Un 78% de accuracy no está nada mal.
$ python .\src\model_training.py

Model Evaluation Metrics: {'accuracy': 0.781, 'precision': 0.7462121212121212, 'recall': 0.7137681159420289, 'f1_score': 0.7296296296296296}
Si te apetece profundizar en este ámbito, échale un vistazo a nuestro tutorial de LLM más popular, Fine-Tuning DeepSeek R1 (Reasoning Model). Cubre el fine-tuning del primer modelo de razonamiento de código abierto del mundo con un dataset de razonamiento médico para crear mejores médicos de IA en el futuro.
No queremos mantener los scripts de Python en una carpeta distinta. Vamos a mover el archivo mlflow_tracking.py a la carpeta src y eliminar la carpeta de experimentos. Ten en cuenta que tendrás que hacer algunos cambios menores manualmente en lugar de pedírselos al modelo o3-mini.
# src/mlflow_tracking.py
import mlflow
import mlflow.sklearn
from model_training import train_model


def run_experiment(data_path):
    mlflow.set_experiment("Student_Placement_Prediction")

    with mlflow.start_run():
        # Train the model
        clf, scaler, metrics = train_model(data_path)

        # Log parameters (example)
        mlflow.log_param("model_type", "RandomForest")
        mlflow.log_param("n_estimators", 100)

        # Log metrics
        mlflow.log_metric("accuracy", metrics["accuracy"])
        mlflow.log_metric("precision", metrics["precision"])
        mlflow.log_metric("recall", metrics["recall"])
        mlflow.log_metric("f1_score", metrics["f1_score"])

        # Log the model
        mlflow.sklearn.log_model(clf, "model")

        print("Experiment logged in MLflow.")


if __name__ == "__main__":
    run_experiment("data/dataset.csv")
El script se ejecutó sin problemas y generó toda la información.
$ python .\src\mlflow_tracking.py
Model Evaluation Metrics: {'accuracy': 0.781, 'precision': 0.7462121212121212, 'recall': 0.7137681159420289, 'f1_score': 0.7296296296296296}
2025/02/17 00:03:34 WARNING mlflow.models.model: Model logged without a signature and input example. Please set `input_example` parameter when logging the model to auto infer the model signature.
Experiment logged in MLflow.
Todos los experimentos de machine learning se guardan en local y puedes visualizarlos con la interfaz de MLflow.
La respuesta de o3-mini también propone un paso opcional que puedes añadir al script model_training.py. Lo hemos incluido para comprobar si mejora el rendimiento del modelo.
# src/model_training.py
import joblib
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
from data_preprocessing import load_and_preprocess_data
from sklearn.model_selection import GridSearchCV


def tune_model(X_train, y_train):
    param_grid = {"n_estimators": [50, 100, 150], "max_depth": [None, 5, 10]}
    clf = RandomForestClassifier(random_state=42)
    grid_search = GridSearchCV(clf, param_grid, cv=5, scoring="f1")
    grid_search.fit(X_train, y_train)
    print("Best parameters:", grid_search.best_params_)
    return grid_search.best_estimator_

def train_model(data_path):
    X_train, X_test, y_train, y_test, scaler = load_and_preprocess_data(data_path)

    # Initialize and train classifier
    clf = tune_model(X_train, y_train)

    # Predictions and evaluation
    y_pred = clf.predict(X_test)
    metrics = {
        "accuracy": accuracy_score(y_test, y_pred),
        "precision": precision_score(y_test, y_pred),
        "recall": recall_score(y_test, y_pred),
        "f1_score": f1_score(y_test, y_pred),
    }
    print("Model Evaluation Metrics:", metrics)

    # Save model and scaler
    joblib.dump(clf, "model_rf.joblib")
    joblib.dump(scaler, "scaler.joblib")

    return clf, scaler, metrics


if __name__ == "__main__":
    train_model("data/dataset.csv")
Como ves, el rendimiento ha mejorado ligeramente gracias a la optimización de hiperparámetros.
$ python .\src\model_training.py
Best parameters: {'max_depth': 5, 'n_estimators': 150}
Model Evaluation Metrics: {'accuracy': 0.791, 'precision': 0.7493917274939172, 'recall': 0.7439613526570048, 'f1_score': 0.7466666666666667}Es hora de crear la inferencia del modelo. Desarrollaremos una aplicación web con Flask.
Primero cargaremos el modelo y el scaler. Después procesaremos los datos de entrada del usuario y se los pasaremos al modelo para generar la predicción. Es una aplicación bastante sencilla.
import joblib
import numpy as np

app = Flask(__name__)

# Load the trained model and scaler (update paths as necessary)
model = joblib.load("model_rf.joblib")
scaler = joblib.load("scaler.joblib")


@app.route("/")
def home():
    return render_template("index.html")


@app.route("/predict", methods=["POST"])
def predict():
    try:
        # Expecting form data from the HTML template
        CGPA = float(request.form.get("CGPA"))
        Internships = int(request.form.get("Internships"))
        Projects = int(request.form.get("Projects"))
        Workshops_Certifications = int(request.form.get("Workshops_Certifications"))
        AptitudeTestScore = float(request.form.get("AptitudeTestScore"))
        SoftSkillRating = float(request.form.get("SoftSkillRating"))
        ExtracurricularActivities = request.form.get("ExtracurricularActivities")
        PlacementTraining = request.form.get("PlacementTraining")
        SSC_Marks = float(request.form.get("SSC_Marks"))
        HSC_Marks = float(request.form.get("HSC_Marks"))

        # Convert categorical fields to numerical
        extra_act = 1 if ExtracurricularActivities.lower() == "yes" else 0
        placement_training = 1 if PlacementTraining.lower() == "yes" else 0

        # Construct feature vector
        features = [
            CGPA,
            Internships,
            Projects,
            Workshops_Certifications,
            AptitudeTestScore,
            SoftSkillRating,
            extra_act,
            placement_training,
            SSC_Marks,
            HSC_Marks,
        ]

        # Scale features and make prediction
        features_scaled = scaler.transform(np.array(features).reshape(1, -1))
        prediction = model.predict(features_scaled)
        result = "Placed" if prediction[0] == 1 else "Not Placed"

        return render_template("index.html", prediction=result)
    except Exception as e:
        return render_template("index.html", prediction=f"Error: {e}")


if __name__ == "__main__":
    app.run(host='0.0.0.0', port=5000, debug=True)
Para crear la interfaz de usuario, hemos pegado el código HTML en el archivo index.html. Todo lo proporciona el modelo o3-mini. Incluso puedes pedirle que mejore la interfaz.
<!-- app/templates/index.html -->
<!DOCTYPE html>
<html>
<head>
    <title>Student Placement Prediction</title>
</head>
<body>
    <h1>Student Placement Prediction</h1>
    <form action="/predict" method="post" id="predictForm">
        <!-- Create inputs for each feature. Example for CGPA: -->
        <label for="CGPA">CGPA:</label>
        <input type="number" step="0.1" id="CGPA" name="CGPA" required><br><br>
        <!-- Add more inputs as per features -->
        <button type="submit">Predict</button>
    </form>
    <div id="result"></div>
    <script>
      document.getElementById('predictForm').addEventListener('submit', async (e) => {
          e.preventDefault();
          const formData = new FormData(e.target);
          const data = Object.fromEntries(formData.entries());
          // Adjust keys to match what the API expects
          data.ExtracurricularActivities = data.ExtracurricularActivities || 'No';
          data.PlacementTraining = data.PlacementTraining || 'No';

          const response = await fetch('/predict', {
              method: 'POST',
              headers: {'Content-Type': 'application/json'},
              body: JSON.stringify(data)
          });
          const result = await response.json();
          document.getElementById('result').innerText = JSON.stringify(result);
      });
    </script>
</body>
</html>
Cuando esté todo listo, ejecuta la app y haz clic en la URL que genera Flask.
$ python .\app\app.py

 * Running on all addresses (0.0.0.0)
 * Running on http://127.0.0.1:5000
 * Running on http://192.168.100.41:5000
Nuestra aplicación web funciona sin problemas.
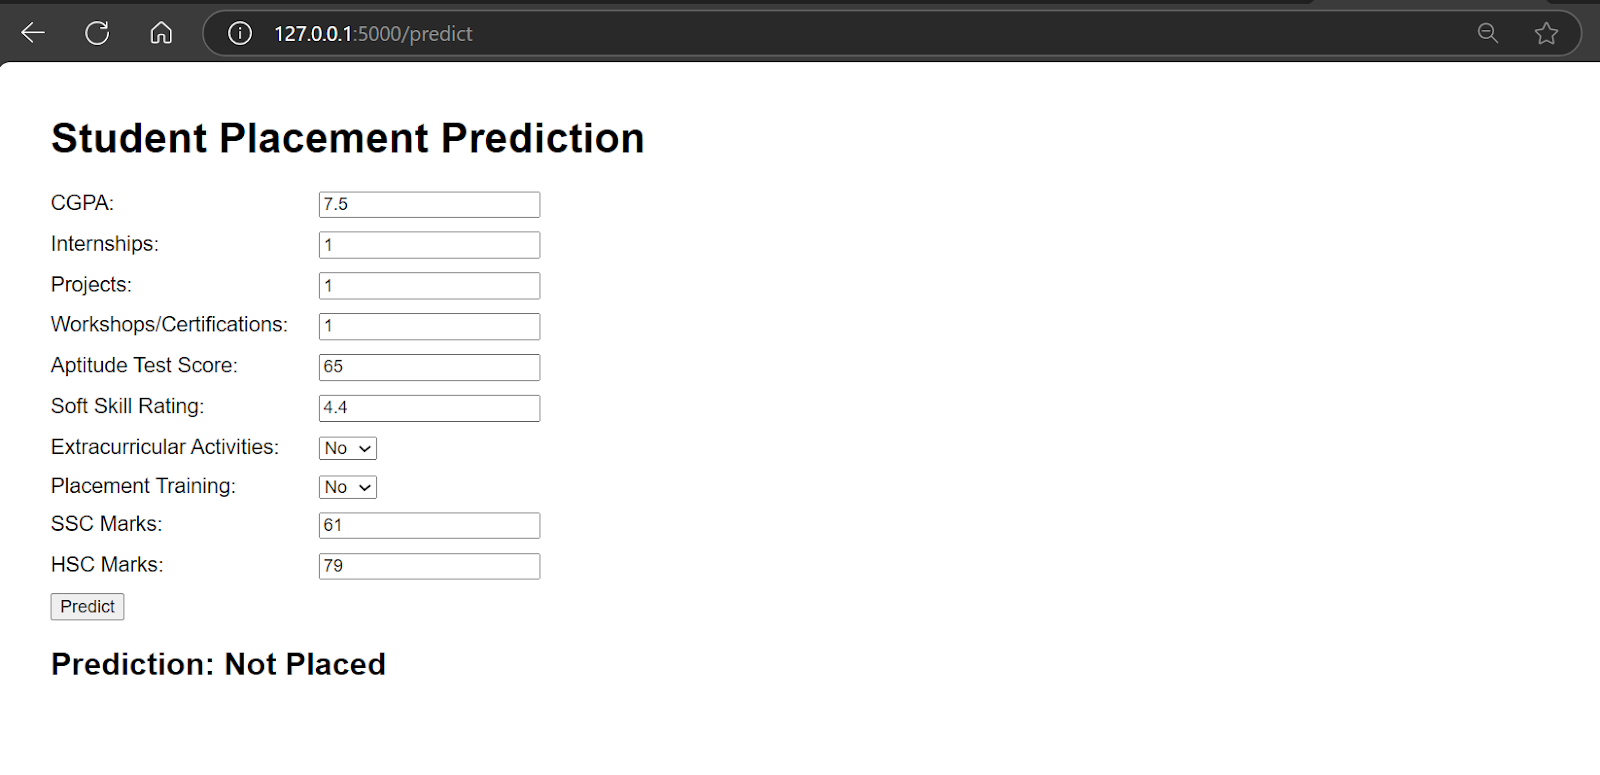
El modelo o3-mini también nos ha proporcionado el Dockerfile; solo tenemos que construirlo en local y probarlo antes de desplegarlo en la nube.
# Use an official Python runtime as a parent image
FROM python:3.12-slim

# Set the working directory in the container
WORKDIR /app

# Copy the requirements file and install dependencies
COPY requirements.txt ./
RUN pip install --upgrade pip && pip install -r requirements.txt

# Copy the entire project
COPY . .

# Expose port (adjust as necessary)
EXPOSE 5000

# Command to run the Flask app
CMD ["python", "app/app.py"]
Compila la imagen de Docker con el siguiente comando.
$ docker build -t kingabzpro/student_placement . 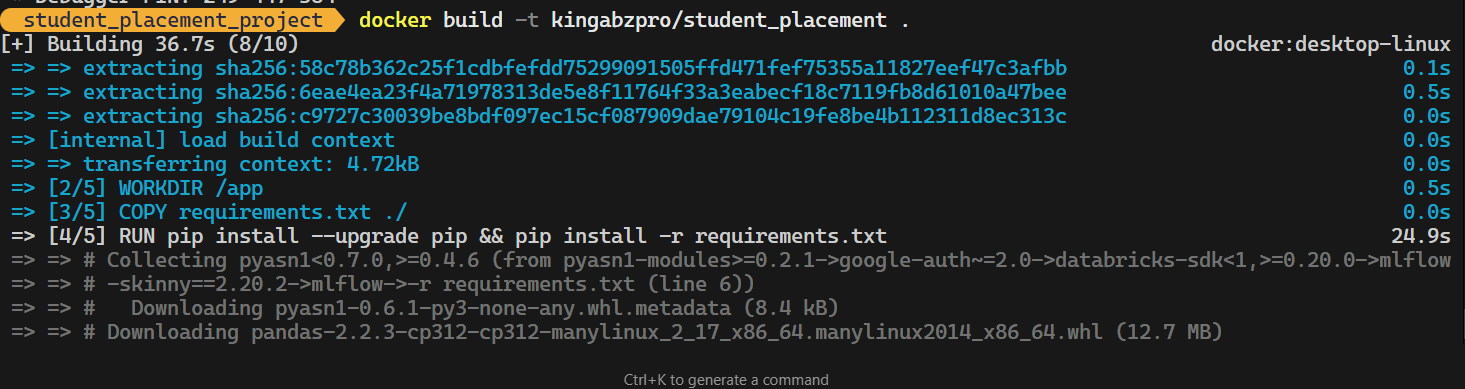
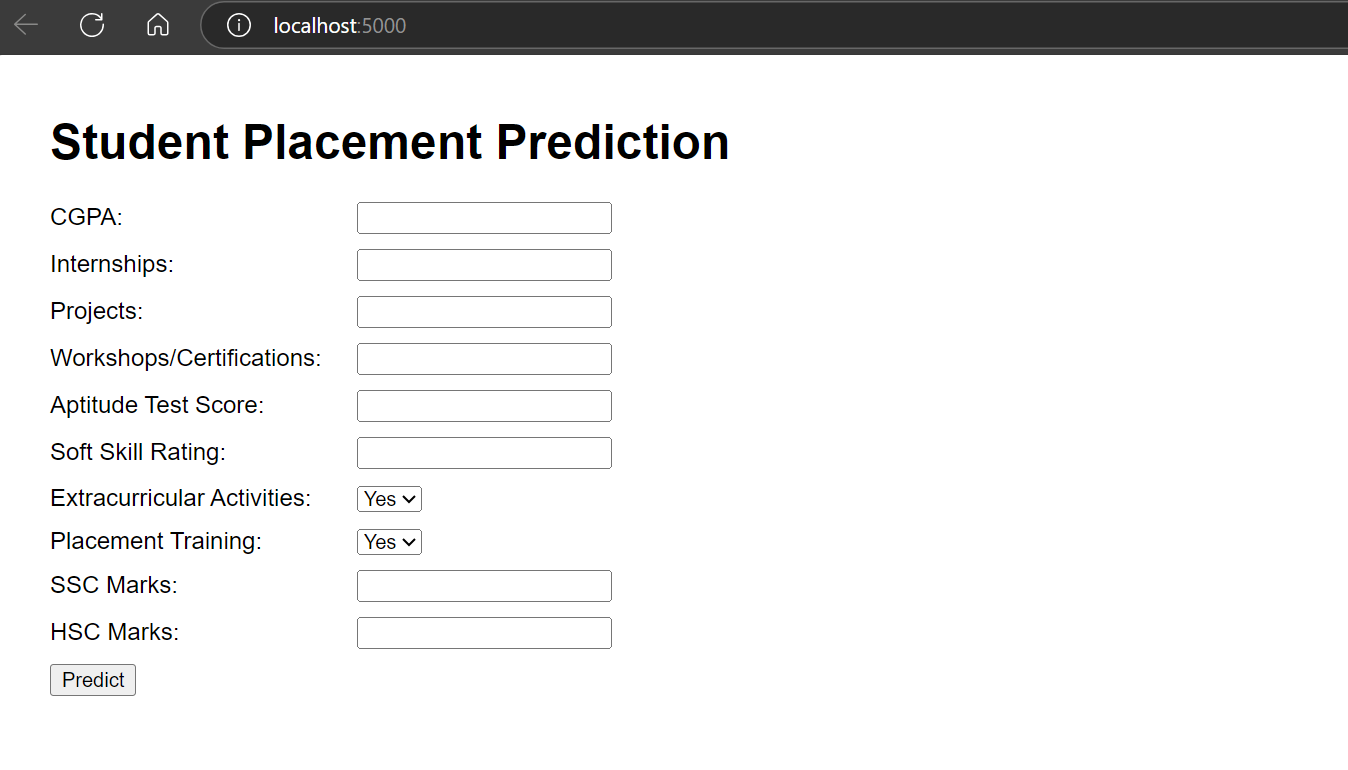
Ejecuta la imagen de Docker en local.
$ docker run -p 5000:5000 kingabzpro/student_placementPuedes ver que nuestro Docker se está ejecutando perfectamente.
Es momento de desplegar nuestra aplicación de machine learning en Hugging Face Cloud (Space).
Para empezar, puedes crear un nuevo Space. Añade toda la información necesaria de la aplicación y selecciona Docker como SDK.
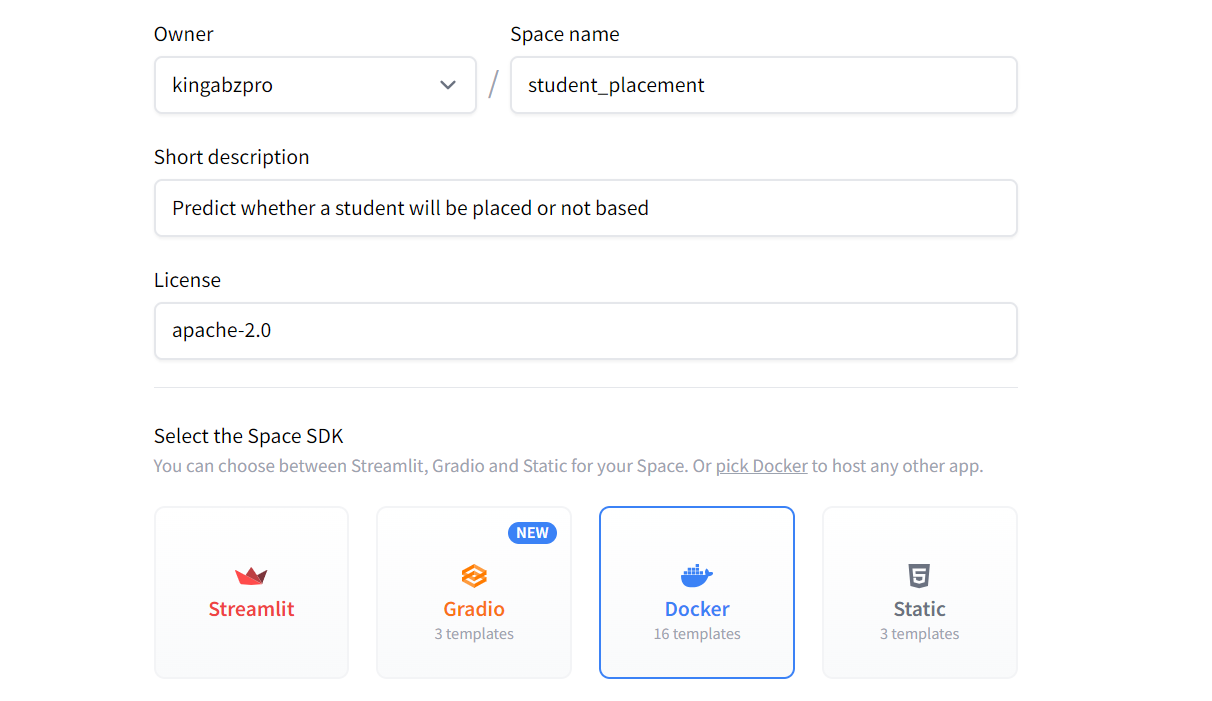
Después, se generará una URL para que clones la aplicación en local.
$ git clone https://huggingface.co/spaces/kingabzpro/student_placementA continuación, mueve el modelo, el scaler, la carpeta app, el Dockerfile y requirements.txt al repositorio de la aplicación.
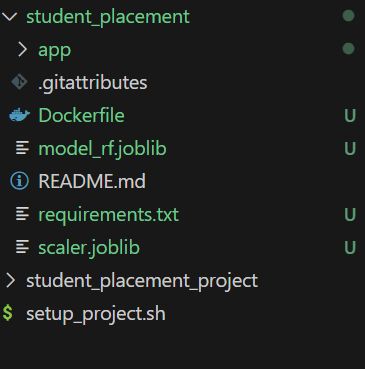
Puedes cambiar el archivo app.py actualizando la última línea a:
app.run(host="0.0.0.0", port=7860, debug=True)Revisa el puerto expuesto en el Dockerfile. Hay que hacerlo para evitar errores o conflictos de puertos:
# Expose port (adjust as necessary)
EXPOSE 7860
Cuando termines los cambios, haz commit y súbelos al repositorio remoto:
$ cd .\student_placement\
$ git add .
$ git commit -m "Initial commit of Dockerized student placement app"
$ git push
En cuanto hagas push, comenzará la compilación y luego se desplegará la interfaz de tu aplicación.
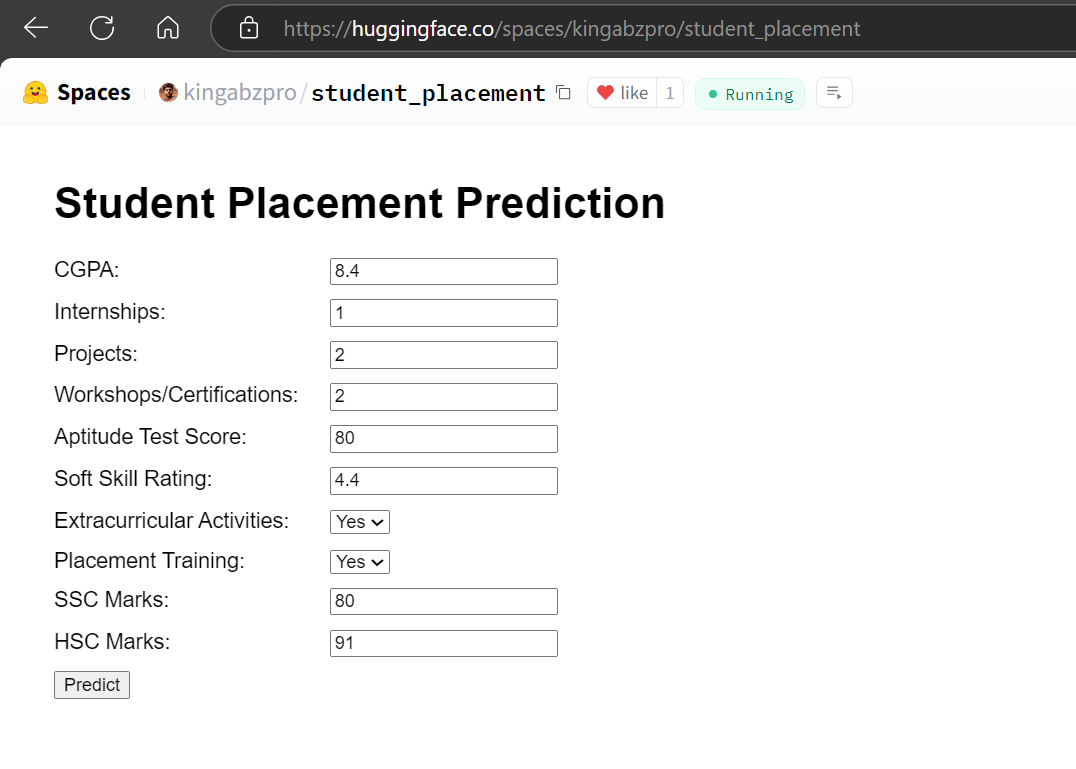
Fuente: Student Placement
o3-mini ha hecho un trabajo excelente: desde la gestión del directorio del proyecto hasta el despliegue con éxito de la aplicación web en la nube.
También puedes conocer el modelo de vanguardia de Google y aprender a crear tu propia aplicación de IA con el tutorial Building Multimodal AI Application with Gemini 2.0 Pro.
El modelo o3-mini es particular, así que conviene tener cuidado al hacer peticiones de seguimiento y depurar código. Aquí tienes algunos consejos para trabajar con él de forma efectiva:
Cuando des instrucciones, asegúrate de que sean claras y coherentes. Si das varias órdenes, o3-mini priorizará la más reciente. Es decir, el último mandato en una cadena larga de prompts tendrá preferencia y podría anular los anteriores.
Algunos problemas de código quizá tengas que resolverlos manualmente en lugar de confiar en el modelo. Si pides a o3-mini que arregle una parte concreta, solo modificará esa sección. Esto puede romper partes relacionadas, ya que no siempre tiene en cuenta dependencias o el contexto global.
Incluye todos los detalles relevantes en tu prompt: datos en bruto, filas y columnas bien definidas y cualquier contexto adicional. Así el modelo entiende mejor tu solicitud y ofrece mejores resultados.
Detalla qué quieres que devuelva el modelo. Por ejemplo, si necesitas carpetas, archivos, comandos de Docker o una guía paso a paso para implementar la solución. Así te aseguras de que el resultado se ajuste a tus expectativas.
Empieza con un prompt bien estructurado que cubra el 90% de lo que necesitas. Una vez tengas la base, añade indicaciones de seguimiento para refinar, corregir o ampliar el proceso.
El modelo o3-mini destaca frente a GPT-4o, ofrece un rendimiento más rápido que o1 y brilla en tareas como programar en Python y HTML. De forma notable, el código Python que genera o3-mini suele ejecutarse sin problemas. Incluso puede mejorar código HTML, ayudándote a optimizar la interfaz y hacerla más atractiva.
En este tutorial, hemos visto el potencial de o3-mini en el contexto de un proyecto de machine learning. El modelo o3-mini es una gran herramienta para data scientists, ingenieros de machine learning y perfiles técnicos. Su capacidad para manejar tareas complejas con eficiencia lo convierte en un activo valioso en cualquier flujo de trabajo.
Para obtener los mejores resultados, basta con proporcionar un contexto completo —incluyendo todo el contenido y los entregables relevantes— en tu prompt inicial. Una vez el modelo genere la salida, pasa a tu editor de código, empieza a ejecutar scripts e implementa el código y las instrucciones proporcionadas.
Tu siguiente paso es aprender a desplegar tus propios LLM de última generación en la nube. En lugar de depender de OpenAI, así tendrás control total sobre el precio, la precisión y el acceso a tus datos. Sigue el tutorial How to Deploy LLMs with BentoML para conocer todo el proceso.
Los mejores cursos de DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Kurtis Pykes
8 min
Tutorial
Arunn Thevapalan
13 min
Tutorial
Zoumana Keita
12 min
Tutorial
Zoumana Keita
14 min