
Kurs
OpenAI API ile Çalışmak
3 sa
184.5K
DeepSeek R1’ın lansmanının ardından, OpenAI kendi son teknoloji akıl yürütme modeli o3-mini ile yanıt verdi. Bu yeni model, selefi o1 modelinden daha küçük, daha hızlı ve daha verimli olacak şekilde tasarlandı ve kodlama, STEM ve mantıksal problem çözme ile ilgili görevlerde üstün performans gösteriyor.
OpenAI bu modeli, ChatGPT ve diğer platformları kullananlar da dahil olmak üzere tüm kullanıcılara ücretsiz olarak sundu; böylece gelişmiş akıl yürütme yetenekleri her zamankinden daha erişilebilir hale geldi.
o3-mini hakkında daha fazla ayrıntı için şu blog yazısına bakabilirsiniz: OpenAI’nin O3’ü: Özellikler, O1 Karşılaştırması, Çıkış Tarihi ve Daha Fazlası.
Kaynak: ChatGPT
Bu eğitimde o3-mini modelinin teknik yeteneklerini inceleyeceğiz. Özellikle, karmaşık teknik görevleri ele alma, doğru kod üretme ve uygun bir makine öğrenimi modelini oluşturma, test etme ve dağıtma için net talimatlar sağlama becerisini test edeceğiz. Sonunda, o3-mini’nin teknik ve mantıksal problem çözme görevleri için son teknoloji bir akıl yürütme modeli olma vaadini yerine getirip getirmediğini belirlemeyi amaçlıyoruz.
Görsel: Yazar
o3-mini’den, bir öğrencinin iş yerleştirmesine uygun olup olmadığını belirleyebilen bir makine öğrenimi uygulaması oluşturmak için Placement Prediction veri setini kullanmasını isteyeceğiz. Planlamadan çözümü dağıtmaya kadar, ChatGPT üzerindeki o3-mini modelinden destek alacağız.
Proje planlama aşamasında, o3-mini modeline gerekli tüm bilgileri sağlayacak ve hedeflerimizi belirteceğiz. Yerleştirme Tahmini uygulamasını oluşturmak, eğitmek ve dağıtmak için gerekli tüm klasör ve dosyaları oluşturmasını isteyeceğiz.
Özellikle şunları yapacağız:
İşte istem:
“I want to build a machine learning project to predict whether a student will be placed or not based on their academic and extracurricular data. The dataset contains the following columns:

- **StudentID**: Unique identifier for each student.

- **CGPA**: The overall grades achieved by the student.

- **Internships**: Number of internships a student has completed.

- **Projects**: Number of projects a student has completed.

- **Workshops/Certifications**: Indicates whether the student has attended workshops or completed certifications to upskill themselves.

- **AptitudeTestScore**: Score achieved in an aptitude test, which evaluates quantitative and logical thinking.

- **SoftSkillRating**: A rating of the student’s communication and interpersonal skills.

- **ExtraCurricularActivities**: Indicates whether the student is active in extracurricular activities (Yes/No).

- **PlacementTraining**: Indicates whether the student has undergone placement training (Yes/No).

- **SSC and HSC**: Senior Secondary and Higher Secondary marks.

- **PlacementStatus**: The target column, which has two classes: "Placed" and "Not Placed."

Here is a sample dataset row:

StudentID,CGPA,Internships,Projects,Workshops/Certifications,AptitudeTestScore,SoftSkillsRating,ExtracurricularActivities,PlacementTraining,SSC_Marks,HSC_Marks,PlacementStatus

1,7.5,1,1,1,65,4.4,No,No,61,79,NotPlaced

I need help creating a structured project with the following components:

1. **Data Analysis**: Perform exploratory data analysis (EDA) to understand the dataset, visualize trends, and identify correlations between features and the target variable.

2. **Model Building**: Create a machine learning pipeline to preprocess the data and train a model to predict the placement status.

3. **Experiment Tracking**: Set up a system to track experiments, including model performance metrics, hyperparameters, and results.

4. **Model Training**: Train the model using appropriate algorithms and evaluate its performance using metrics like accuracy, precision, recall, and F1-score.

5. **Hyperparameter Tuning**: Optimize the model’s performance by tuning hyperparameters using techniques like grid search or random search.

6. **Model Inference Application**: Build an application (e.g., a web app or API) to allow users to input student data and get predictions on placement status.

7. **Dockerfile for Containerization**: Create a Dockerfile to containerize the application for easy deployment.

8. **Cloud Deployment**: Deploy the application on a cloud platform (e.g., AWS, Azure, or Google Cloud) to make it accessible online.

9. **Accessing the Model**: Provide a way to access the deployed model via an API or web interface.

Please provide the following:

- A folder structure for organizing the project files. (Also provide bash command for creating the folders and files.)

- Python scripts or code snippets for each of the above components.

- Suggestions for tools and libraries to use (e.g., pandas, scikit-learn, Flask, Docker, etc.).

- Guidance on setting up experiment tracking (using MLflow).

- Steps for deploying the model on a Hugging Face Space.”
Karşılığında, proje yapısı ve her şeyi sıfırdan nasıl inşa edeceğiniz hakkında ayrıntılı bir yanıt alacaksınız.
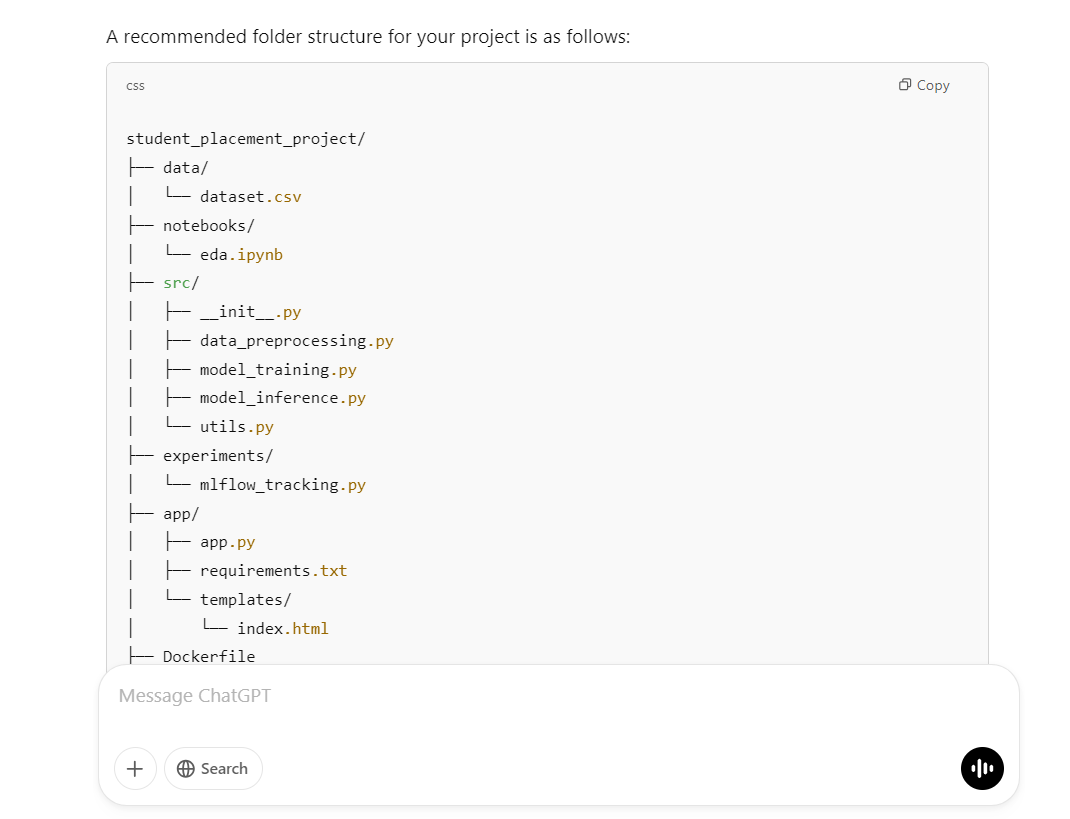
Sağlanan komut dosyası, proje dizinini, klasörleri ve gerekli tüm dosyaları oluşturacaktır:
mkdir -p student_placement_project/{data,notebooks,src,experiments,app/templates}
touch student_placement_project/data/dataset.csv \
      student_placement_project/notebooks/eda.ipynb \
      student_placement_project/src/{__init__.py,data_preprocessing.py,model_training.py,model_inference.py,utils.py} \
      student_placement_project/experiments/mlflow_tracking.py \
      student_placement_project/app/{app.py,requirements.txt} \
      student_placement_project/app/templates/index.html \
      student_placement_project/{Dockerfile,requirements.txt,README.md}
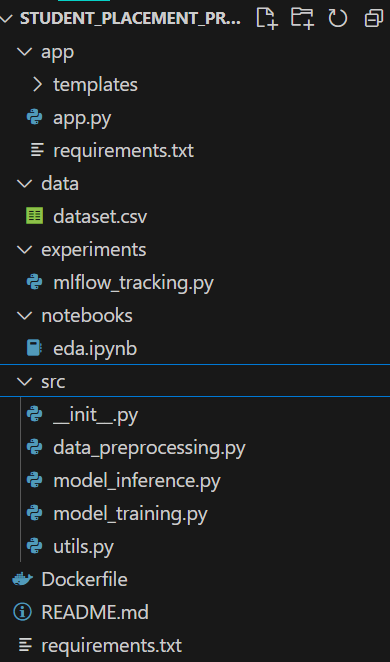
Gördüğünüz gibi, bu komut dosyası bizim için gerekli tüm görevleri tamamladı.
Yanıtta, Jupyter defteri dosyası için kod sağlandı. Tek yapmanız gereken kodu sırayla yapıştırıp çalıştırarak çıktıyı görmek.
# notebooks/eda.ipynb
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
import numpy as np

# Load dataset
df = pd.read_csv('../data/dataset.csv')

# Basic info and descriptive statistics
print(df.info())
print(df.describe())

# Visualize distributions
sns.histplot(df['CGPA'], bins=20, kde=True)
plt.title('Distribution of CGPA')
plt.show()

# Correlation matrix
plt.figure(figsize=(10, 8))

# Compute correlation matrix only on numeric columns
numeric_df = df.select_dtypes(include=[np.number])
plt.figure(figsize=(10, 8))
corr = numeric_df.corr()
sns.heatmap(corr, annot=True, cmap="coolwarm")
plt.title("Feature Correlation Matrix")


# Count plot for PlacementStatus
sns.countplot(x='PlacementStatus', data=df)
plt.title('Placement Status Count')
plt.show()
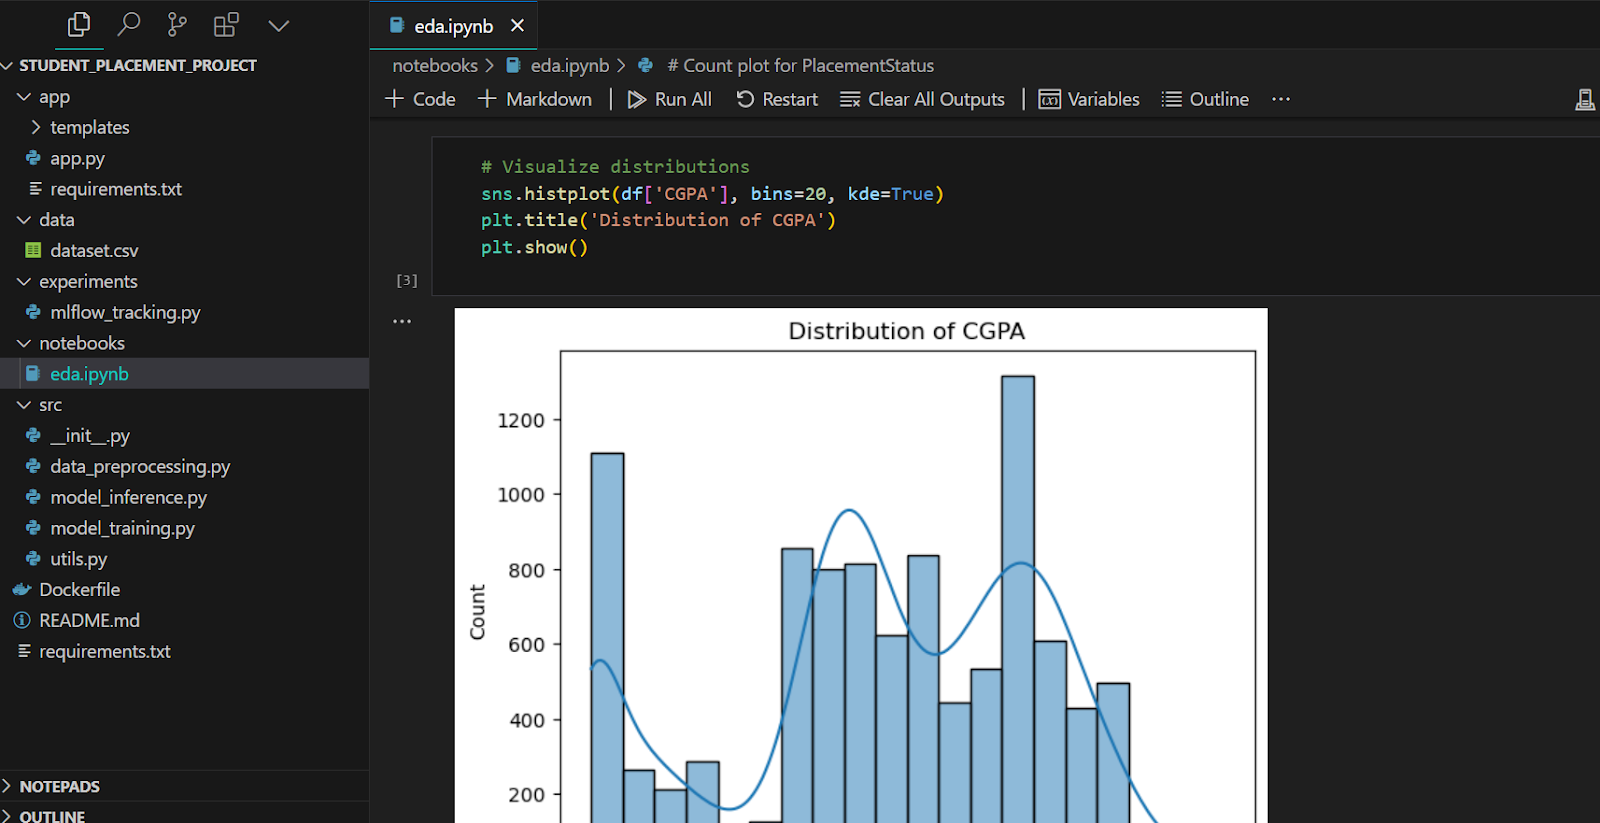
Görüntü bu şekilde. Tüm veri analitiği ve grafikler herkesin inceleyebilmesi için tek bir dosyada.
Sırada veri ön işleme dosyasını oluşturmak var. Birkaç küçük değişiklik dışında bu kod sorunsuz çalışıyor.
# src/data_preprocessing.py
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler


def load_and_preprocess_data(filepath):
    df = pd.read_csv(filepath)

    # Convert categorical columns
    df["ExtracurricularActivities"] = df["ExtracurricularActivities"].map(
        {"Yes": 1, "No": 0}
    )
    df["PlacementTraining"] = df["PlacementTraining"].map({"Yes": 1, "No": 0})
    df["Workshops/Certifications"] = df["Workshops/Certifications"].astype(
        int
    )  # assuming it's already 0/1

    # Convert target column to binary
    df["PlacementStatus"] = df["PlacementStatus"].map({"Placed": 1, "NotPlaced": 0})

    # Feature selection (excluding StudentID)
    X = df.drop(["StudentID", "PlacementStatus"], axis=1)
    y = df["PlacementStatus"]

    # Split dataset
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42
    )

    # Scaling numeric features (optional)
    scaler = StandardScaler()
    X_train_scaled = scaler.fit_transform(X_train)
    X_test_scaled = scaler.transform(X_test)

return X_train_scaled, X_test_scaled, y_train, y_test, scalerEğitim betiği, veri işleme fonksiyonunu içe aktarır; önce veriyi işler, ardından rastgele orman modelini eğitir. Sonunda model performans metriklerini görüntüler.
# src/model_training.py
import joblib
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
from data_preprocessing import load_and_preprocess_data


def train_model(data_path):
    X_train, X_test, y_train, y_test, scaler = load_and_preprocess_data(data_path)

    # Initialize and train classifier
    clf = RandomForestClassifier(n_estimators=100, random_state=42)
    clf.fit(X_train, y_train)

    # Predictions and evaluation
    y_pred = clf.predict(X_test)
    metrics = {
        "accuracy": accuracy_score(y_test, y_pred),
        "precision": precision_score(y_test, y_pred),
        "recall": recall_score(y_test, y_pred),
        "f1_score": f1_score(y_test, y_pred),
    }
    print("Model Evaluation Metrics:", metrics)

    # Save model and scaler
    joblib.dump(clf, "model_rf.joblib")
    joblib.dump(scaler, "scaler.joblib")

    return clf, scaler, metrics


if __name__ == "__main__":
    train_model("data/dataset.csv")
Yüzde 78 doğruluk fena değil.
$ python .\src\model_training.py

Model Evaluation Metrics: {'accuracy': 0.781, 'precision': 0.7462121212121212, 'recall': 0.7137681159420289, 'f1_score': 0.7296296296296296}
Bu alandaki diğer konuları öğrenmeye hevesliyseniz, popüler LLM eğitimimize göz atın: DeepSeek R1’ı İnce Ayarlama (Akıl Yürütme Modeli). Dünyanın ilk açık kaynak akıl yürütme modelini, geleceğin daha iyi yapay zekâ doktorlarını geliştirmek için tıbbi düşünce zinciri veri seti üzerinde ince ayarlamayı ele alır.
Python betiklerini farklı bir klasörde tutmak istemiyoruz. mlflow_tracking.py dosyasını src klasörüne taşıyacağız ve experiments klasörünü kaldıracağız. Lütfen bunu o3-mini modelinden istemek yerine birkaç küçük değişikliği manuel olarak yapmanız gerekeceğini unutmayın.
# src/mlflow_tracking.py
import mlflow
import mlflow.sklearn
from model_training import train_model


def run_experiment(data_path):
    mlflow.set_experiment("Student_Placement_Prediction")

    with mlflow.start_run():
        # Train the model
        clf, scaler, metrics = train_model(data_path)

        # Log parameters (example)
        mlflow.log_param("model_type", "RandomForest")
        mlflow.log_param("n_estimators", 100)

        # Log metrics
        mlflow.log_metric("accuracy", metrics["accuracy"])
        mlflow.log_metric("precision", metrics["precision"])
        mlflow.log_metric("recall", metrics["recall"])
        mlflow.log_metric("f1_score", metrics["f1_score"])

        # Log the model
        mlflow.sklearn.log_model(clf, "model")

        print("Experiment logged in MLflow.")


if __name__ == "__main__":
    run_experiment("data/dataset.csv")
Python betiği sorunsuz çalıştı ve tüm bilgileri üretti.
$ python .\src\mlflow_tracking.py
Model Evaluation Metrics: {'accuracy': 0.781, 'precision': 0.7462121212121212, 'recall': 0.7137681159420289, 'f1_score': 0.7296296296296296}
2025/02/17 00:03:34 WARNING mlflow.models.model: Model logged without a signature and input example. Please set `input_example` parameter when logging the model to auto infer the model signature.
Experiment logged in MLflow.
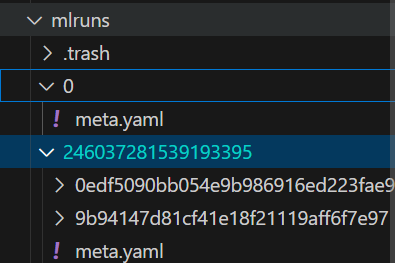
Tüm makine öğrenimi deneyleri yerel olarak depolanır; bunları MLflow arayüzüyle görselleştirebilirsiniz.
o3-mini yanıtı ayrıca model_training.py betiğine ekleyebileceğiniz isteğe bağlı bir adım sağlıyor. Model performansınızın artıp artmayacağını görmek için bu adımı ekledik.
# src/model_training.py
import joblib
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
from data_preprocessing import load_and_preprocess_data
from sklearn.model_selection import GridSearchCV


def tune_model(X_train, y_train):
    param_grid = {"n_estimators": [50, 100, 150], "max_depth": [None, 5, 10]}
    clf = RandomForestClassifier(random_state=42)
    grid_search = GridSearchCV(clf, param_grid, cv=5, scoring="f1")
    grid_search.fit(X_train, y_train)
    print("Best parameters:", grid_search.best_params_)
    return grid_search.best_estimator_

def train_model(data_path):
    X_train, X_test, y_train, y_test, scaler = load_and_preprocess_data(data_path)

    # Initialize and train classifier
    clf = tune_model(X_train, y_train)

    # Predictions and evaluation
    y_pred = clf.predict(X_test)
    metrics = {
        "accuracy": accuracy_score(y_test, y_pred),
        "precision": precision_score(y_test, y_pred),
        "recall": recall_score(y_test, y_pred),
        "f1_score": f1_score(y_test, y_pred),
    }
    print("Model Evaluation Metrics:", metrics)

    # Save model and scaler
    joblib.dump(clf, "model_rf.joblib")
    joblib.dump(scaler, "scaler.joblib")

    return clf, scaler, metrics


if __name__ == "__main__":
    train_model("data/dataset.csv")
Gördüğünüz gibi, hiperparametre optimizasyonu kullanarak model performansımız biraz arttı.
$ python .\src\model_training.py
Best parameters: {'max_depth': 5, 'n_estimators': 150}
Model Evaluation Metrics: {'accuracy': 0.791, 'precision': 0.7493917274939172, 'recall': 0.7439613526570048, 'f1_score': 0.7466666666666667}Sıra model çıkarımı oluşturmada. Bir Flask web uygulaması geliştireceğiz.
Önce modeli ve ölçekleyiciyi yüklememiz gerekiyor. Sonrasında kullanıcı girdisini işleyip tahmin üretmesi için modele ileteceğiz. Oldukça basit bir uygulama.
import joblib
import numpy as np

app = Flask(__name__)

# Load the trained model and scaler (update paths as necessary)
model = joblib.load("model_rf.joblib")
scaler = joblib.load("scaler.joblib")


@app.route("/")
def home():
    return render_template("index.html")


@app.route("/predict", methods=["POST"])
def predict():
    try:
        # Expecting form data from the HTML template
        CGPA = float(request.form.get("CGPA"))
        Internships = int(request.form.get("Internships"))
        Projects = int(request.form.get("Projects"))
        Workshops_Certifications = int(request.form.get("Workshops_Certifications"))
        AptitudeTestScore = float(request.form.get("AptitudeTestScore"))
        SoftSkillRating = float(request.form.get("SoftSkillRating"))
        ExtracurricularActivities = request.form.get("ExtracurricularActivities")
        PlacementTraining = request.form.get("PlacementTraining")
        SSC_Marks = float(request.form.get("SSC_Marks"))
        HSC_Marks = float(request.form.get("HSC_Marks"))

        # Convert categorical fields to numerical
        extra_act = 1 if ExtracurricularActivities.lower() == "yes" else 0
        placement_training = 1 if PlacementTraining.lower() == "yes" else 0

        # Construct feature vector
        features = [
            CGPA,
            Internships,
            Projects,
            Workshops_Certifications,
            AptitudeTestScore,
            SoftSkillRating,
            extra_act,
            placement_training,
            SSC_Marks,
            HSC_Marks,
        ]

        # Scale features and make prediction
        features_scaled = scaler.transform(np.array(features).reshape(1, -1))
        prediction = model.predict(features_scaled)
        result = "Placed" if prediction[0] == 1 else "Not Placed"

        return render_template("index.html", prediction=result)
    except Exception as e:
        return render_template("index.html", prediction=f"Error: {e}")


if __name__ == "__main__":
    app.run(host='0.0.0.0', port=5000, debug=True)
Uygulama kullanıcı arayüzünü oluşturmak için HTML kodunu index.html dosyasına yapıştırdık. Her şey o3-mini modeli tarafından sağlandı. Hatta kullanıcı arayüzünü iyileştirmesi için o3-mini’den istekte bulunabilirsiniz.
<!-- app/templates/index.html -->
<!DOCTYPE html>
<html>
<head>
    <title>Student Placement Prediction</title>
</head>
<body>
    <h1>Student Placement Prediction</h1>
    <form action="/predict" method="post" id="predictForm">
        <!-- Create inputs for each feature. Example for CGPA: -->
        <label for="CGPA">CGPA:</label>
        <input type="number" step="0.1" id="CGPA" name="CGPA" required><br><br>
        <!-- Add more inputs as per features -->
        <button type="submit">Predict</button>
    </form>
    <div id="result"></div>
    <script>
      document.getElementById('predictForm').addEventListener('submit', async (e) => {
          e.preventDefault();
          const formData = new FormData(e.target);
          const data = Object.fromEntries(formData.entries());
          // Adjust keys to match what the API expects
          data.ExtracurricularActivities = data.ExtracurricularActivities || 'No';
          data.PlacementTraining = data.PlacementTraining || 'No';

          const response = await fetch('/predict', {
              method: 'POST',
              headers: {'Content-Type': 'application/json'},
              body: JSON.stringify(data)
          });
          const result = await response.json();
          document.getElementById('result').innerText = JSON.stringify(result);
      });
    </script>
</body>
</html>
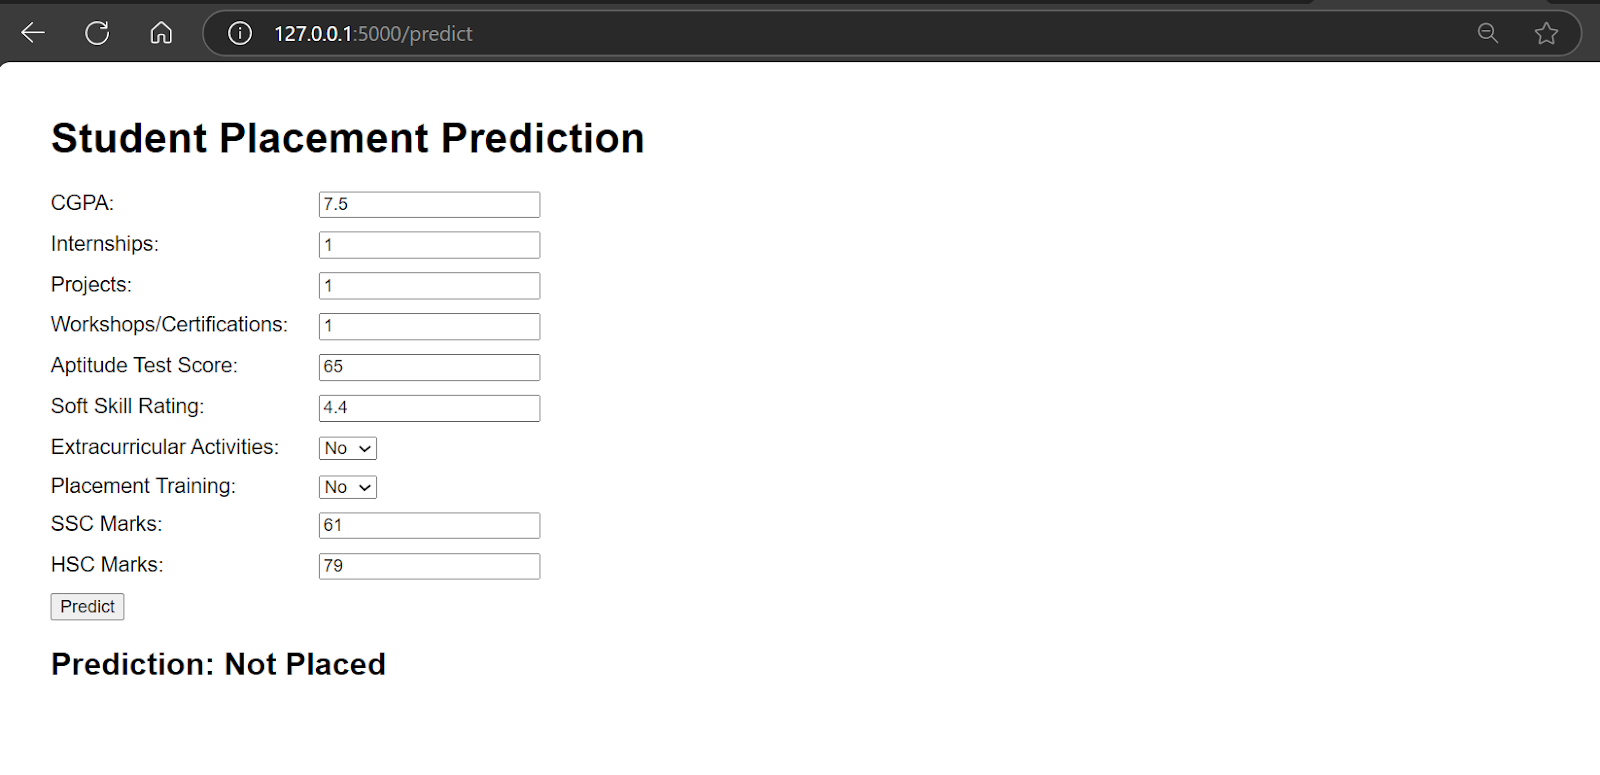
Her şey hazır olduğunda uygulamayı çalıştırın ve Flask’ın ürettiği URL’ye tıklayın.
$ python .\app\app.py

 * Running on all addresses (0.0.0.0)
 * Running on http://127.0.0.1:5000
 * Running on http://192.168.100.41:5000
Web uygulamamız sorunsuz çalışıyor.
o3-mini modeli bize Dockerfile’ı da sağladı; bizim yapmamız gereken tek şey, buluta dağıtmadan önce yerelde inşa edip test etmek.
# Use an official Python runtime as a parent image
FROM python:3.12-slim

# Set the working directory in the container
WORKDIR /app

# Copy the requirements file and install dependencies
COPY requirements.txt ./
RUN pip install --upgrade pip && pip install -r requirements.txt

# Copy the entire project
COPY . .

# Expose port (adjust as necessary)
EXPOSE 5000

# Command to run the Flask app
CMD ["python", "app/app.py"]
Docker imajını şu komutla oluşturun.
$ docker build -t kingabzpro/student_placement . 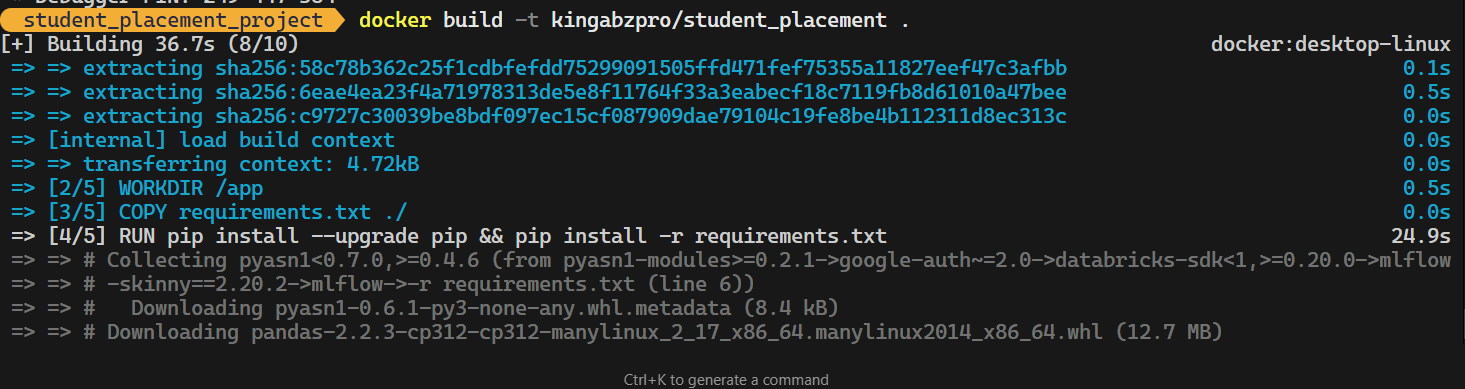
Docker imajını yerelde çalıştırın.
$ docker run -p 5000:5000 kingabzpro/student_placementDocker’ımızın mükemmel şekilde çalıştığını görebilirsiniz.
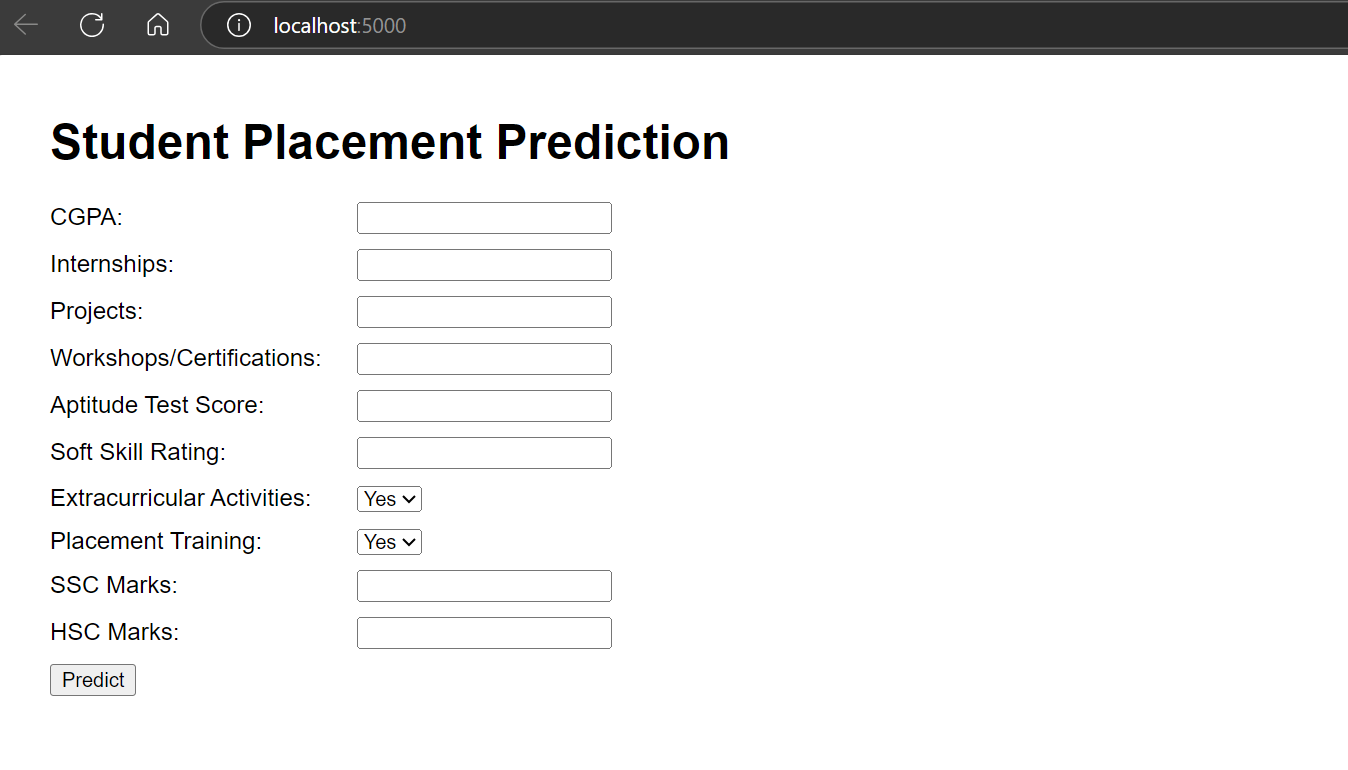
Makine öğrenimi uygulamamızı Hugging Face Cloud’a (Space) dağıtma zamanı.
Başlamak için yeni bir Space oluşturabilirsiniz. Uygulama hakkında gerekli tüm bilgileri ekleyin ve SDK olarak Docker’ı seçin.
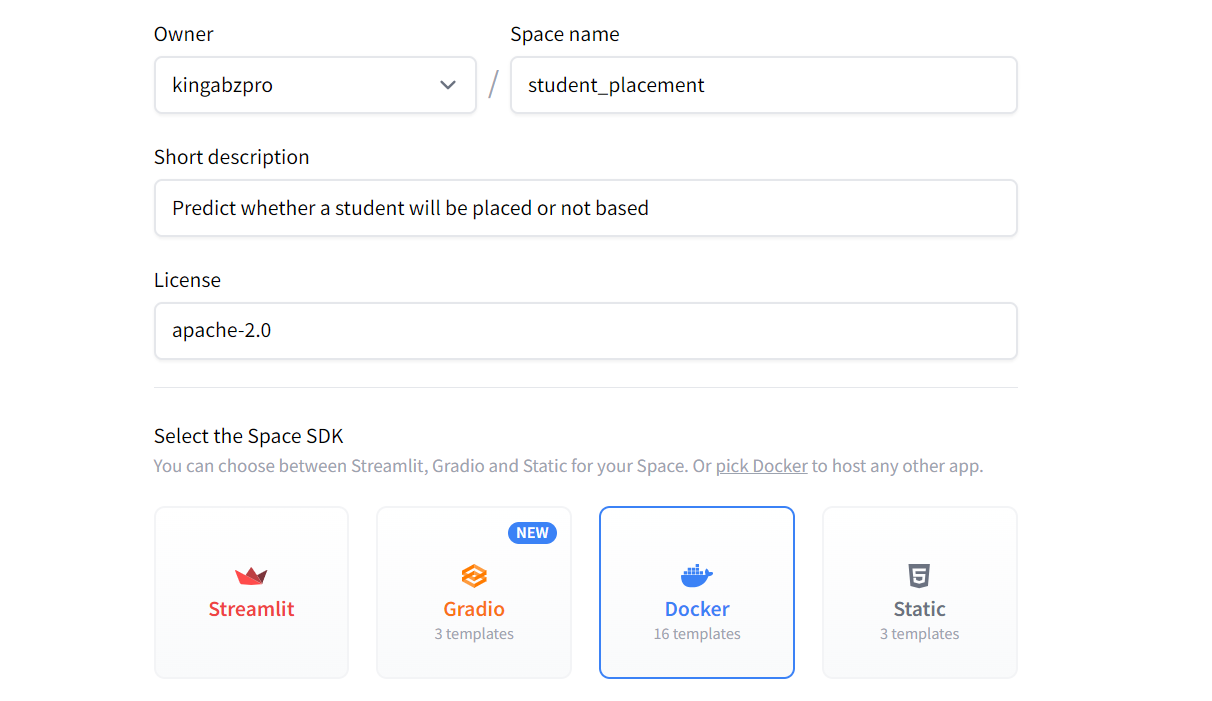
Ardından, uygulamayı yerelde klonlamanız için bir URL oluşturulacaktır.
$ git clone https://huggingface.co/spaces/kingabzpro/student_placementSonraki adımda modeli, ölçekleyiciyi, app klasörünü, Dockerfile’ı ve requirements.txt’yi uygulama deposuna taşıyın.
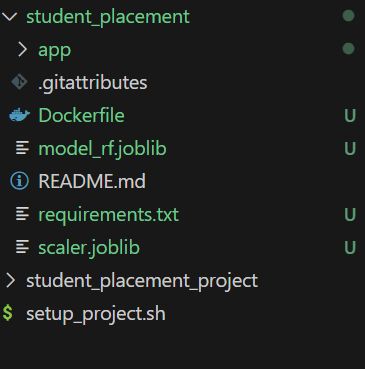
app.py dosyasında son satırı şu şekilde güncelleyerek değişiklik yapabilirsiniz:
app.run(host="0.0.0.0", port=7860, debug=True)Dockerfile içindeki açık porta bakın. Herhangi bir port hatası veya sorununu önlemek için bunu yapmamız gerekiyor:
# Expose port (adjust as necessary)
EXPOSE 7860
Tüm değişiklikleri yaptıktan sonra güncellemeleri commit edin ve uzak depoya gönderin:
$ cd .\student_placement\
$ git add .
$ git commit -m "Initial commit of Dockerized student placement app"
$ git push
Değişiklikleri gönderir göndermez, derleme başlayacak ve ardından uygulamanızın kullanıcı arayüzü dağıtılacaktır.
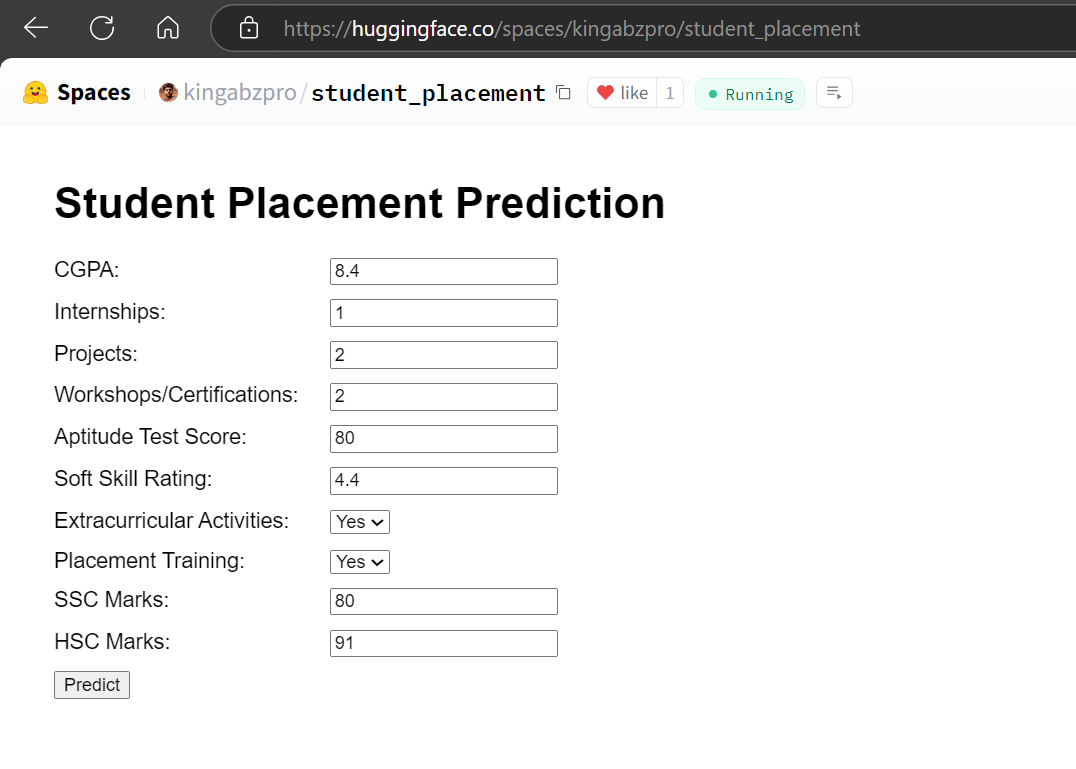
Kaynak: Student Placement
o3-mini, proje dizini yönetiminden web uygulamasını buluta başarıyla dağıtmaya kadar mükemmel bir iş çıkardı.
Ayrıca Google’ın son teknoloji modelini okuyabilir ve Gemini 2.0 Pro ile Çok Modlu Yapay Zeka Uygulaması Geliştirme eğitimini takip ederek kendi yapay zekâ uygulamanızı nasıl oluşturacağınızı öğrenebilirsiniz.
o3-mini modeli benzersizdir; bu da takip istekleri yaparken ve kod hata ayıklarken dikkatli olmanız gerektiği anlamına gelir. Onunla etkili çalışmanıza yardımcı olacak birkaç ipucu:
Talimat verirken net ve tutarlı olmalarını sağlayın. Birden fazla komut verirseniz, o3-mini en güncel talimata öncelik verecektir. Bu, uzun bir istem zincirindeki en son komutun öncelik kazanacağı ve önceki komutları geçersiz kılabileceği anlamına gelir.
Bazı kod sorunlarının modelin düzeltmesine güvenmek yerine manuel olarak çözülmesi gerekebilir. o3-mini’den kodun belirli bir bölümünü düzeltmesini isterseniz yalnızca o bölümü değiştirecektir. Ancak bu, model her zaman bağımlılıkları veya daha geniş bağlamı hesaba katmadığından, kodun ilgili kısımlarının bozulmasına yol açabilir.
İsteminize ham veriler, açıkça tanımlanmış satırlar ve sütunlar ve diğer ilgili ayrıntılar gibi tüm önemli bilgileri ekleyin. Bu, modelin isteğinizi daha doğru anlamasına ve daha iyi sonuçlar üretmesine yardımcı olur.
Modelden ne dönmesini istediğinizi açıkça belirtin. Örneğin, klasörler, dosyalar, Docker komutları veya çözümün nasıl uygulanacağına dair adım adım bir rehber isteyip istemediğinizi netleştirin. Bu, çıktının beklentilerinizle uyumlu olmasını sağlar.
İhtiyaçlarınızın %90’ını kapsayan iyi yapılandırılmış bir temel istemle başlayın. Temel oluşturulduktan sonra, süreci iyileştirmek, düzeltmek veya daha fazla adım eklemek için takip komutları verebilirsiniz.
o3-mini modeli, GPT-4o’a kıyasla üstün bir seçenek olarak öne çıkıyor; o1’den daha hızlı performans sunuyor ve Python ile HTML kodlama gibi görevlerde başarılı. Dikkat çekici biçimde, o3-mini tarafından üretilen Python kodu çoğu zaman sorunsuz çalışıyor. Hatta HTML kodunu da iyileştirerek kullanıcı arayüzünüzü geliştirmenize ve daha görsel çekicilik katmanıza yardımcı olabilir.
Bu eğitimde, bir makine öğrenimi projesi bağlamında o3-mini modelinin gücünü keşfettik. o3-mini modeli, veri bilimciler, makine öğrenimi mühendisleri ve teknik profesyoneller için mükemmel bir araç olduğunu kanıtlıyor. Karmaşık görevleri verimli bir şekilde ele alma yeteneği, onu her iş akışında değerli bir varlık haline getiriyor.
En iyi sonuçları almak için yapmanız gereken tek şey, başlangıç isteminizde ilgili tüm içerik ve teslimatları içeren kapsamlı bir bağlam sağlamak. Model çıktıyı oluşturduktan sonra kod düzenleyicinize geçebilir, betikleri çalıştırmaya başlayabilir ve verilen talimatlarla birlikte sağlanan kodu uygulayabilirsiniz.
Sırada, kendi son teknoloji LLM’lerinizi buluta nasıl dağıtacağınızı öğrenmeniz var. OpenAI’a güvenmek yerine, bu size fiyatlandırma, doğruluk ve verilerinize erişilebilirlik üzerinde tam kontrol sağlar. Bu sürecin tamamını öğrenmek için BentoML ile LLM’ler Nasıl Dağıtılır eğitimini takip edin.
En İyi DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



