
Program
Dasar-Dasar Kecerdasan Buatan
10 jam
Edo Liberty adalah mantan direktur riset di AWS dan Yahoo. Selama masa itu, ia segera menyadari besarnya kekuatan mengombinasikan model kecerdasan buatan (AI) dengan penelusuran vektor untuk meningkatkan aplikasi seperti sistem rekomendasi dan detektor spam secara signifikan.
Saat ia mendalami pekerjaannya dengan sistem penelusuran vektor kustom dalam skala besar, ia melihat belum ada solusi siap pakai untuk orang yang tidak memiliki sumber daya rekayasa dan data science seperti di AWS dan Yahoo. Maka, pada 2019, ia mendirikan Pinecone, dan basis data vektor pun lahir.
Tujuan Pinecone adalah menyediakan infrastruktur penyimpanan dan pengambilan data yang krusial untuk mengembangkan dan menjalankan aplikasi AI mutakhir. Menurut Pinecone, prinsip pendiriannya adalah untuk “membuat solusi ini dapat diakses oleh tim rekayasa dari berbagai ukuran dan tingkat keahlian AI.”
Hasilnya adalah layanan terkelola penuh yang mudah digunakan seperti Pinecone saat ini. Empat tahun berlalu, kini hadir Pinecone Canopy, sebuah kerangka kerja yang memanfaatkan Retrieval Augmented Generation (RAG) untuk memberdayakan developer membuat aplikasi AI Generatif dengan mudah.
Pada sisa tutorial ini, kita akan mendalami:
Dokumentasi Canopy mendeskripsikan Canopy sebagai “kerangka kerja dan konteks Retrieval Augmented Generation (RAG) sumber terbuka yang dibangun di atas basis data vektor Pinecone.”
Perlu dicatat, RAG adalah kerangka AI tingkat lanjut yang diperkenalkan oleh Meta (saat itu Facebook) AI Research pada 2020. Dengan data dinamis yang spesifik domain, RAG membantu mengoptimalkan keluaran Large Language Model (LLM) tanpa perlu melatih ulang model.
Canopy menangani semua tugas berat dalam pengembangan aplikasi RAG. Ini mencakup pengelolaan riwayat chat, pemecahan (chunking) dan embedding data teks, optimasi kueri, pengambilan konteks (termasuk rekayasa prompt), dan augmented generation.
Dengan demikian, developer dapat dengan cepat dan mudah bereksperimen dan membuat aplikasi RAG menggunakan Canopy. Menurut blog rilis pada November 2023, “Dengan Canopy, Anda dapat menyiapkan aplikasi berbasis RAG yang siap produksi dalam waktu kurang dari satu jam. Dan karena dibangun dan didukung oleh Pinecone, Anda mendapatkan pengalaman developer dan performa hebat yang sama seperti basis data vektor terkelola penuh kami.”
Bagi developer yang ingin bereksperimen dengan RAG, Canopy menawarkan solusi yang:
Pengguna dapat menyimpan hingga 100 ribu embedding menggunakan Pinecone tanpa biaya. Ini setara kurang lebih 15 juta kata atau 30 ribu halaman tulisan. Selain itu, blog rilis menyatakan, “Opsi gratis untuk model embedding dan LLM akan segera hadir.”
Data teks dapat berupa JSONL, Parquet, atau teks biasa, dan Canopy akan menangani sisanya. Perlu dicatat dukungan untuk PDF juga akan ditambahkan di masa depan. Setiap LLM OpenAI, termasuk GPT-4 Turbo, kompatibel dengan Canopy. Dukungan untuk LLM lain dan model embedding, seperti model sumber terbuka populer dari Anyscale Endpoints, juga akan segera ditambahkan. Pengguna yang ingin data teksnya dalam format JSONL dapat mentransformasikannya menggunakan notebook Pinecone.
Aplikasi GenAI yang siap produksi dan didukung basis data vektor Pinecone dapat dibangun dengan cepat, akurat, dan andal.
Library Canopy dapat dimanfaatkan untuk membuat aplikasi unik. Pengguna juga dapat menjalankan Canopy sebagai layanan web atau aplikasi melalui REST API sederhana. Canopy juga dapat ditambahkan ke aplikasi OpenAI yang ada dengan mengganti Chat Completions API dengan endpoint server Canopy.
CLI Canopy dapat berkomunikasi dengan data teks menggunakan perintah sederhana. Ini memungkinkan pengguna dengan mudah membandingkan RAG dengan alur kerja non-RAG untuk mengevaluasi hasil augmented secara interaktif sebelum masuk ke produksi.
Memulai dengan Pinecone Canopy relatif mudah. Sebelum mulai, Anda harus mendaftar untuk Standard atau Enterprise. Pengguna baru mendapatkan kredit serverless senilai $100 untuk mencoba dan membiasakan diri dengan alat ini.
Perlu dicatat, jika Anda tidak ingin memberikan kartu kredit, Anda dapat membuat indeks berbasis pod gratis.
Setelah Anda mendaftarkan akun, Anda siap untuk memulai…
Instal paket Canopy menggunakan:
pip install canopy-sdkJika Anda ingin melakukannya di lingkungan virtual, jalankan perintah berikut sebelum memasang paket:
python3 -m venv canopy-env
source canopy-env/bin/activate
Ini membuat lingkungan virtual dan mengaktifkannya. Lihat tutorial Virtual Environment in Python kami untuk mempelajari lebih lanjut cara kerjanya.
Selanjutnya, Anda harus menyiapkan variabel lingkungan Anda. Untuk melakukannya, Anda memerlukan beberapa kunci API.
Untuk menemukan PINECONE_API_KEY Anda, cukup:
Variabel lingkungan wajib lainnya termasuk:
OPENAI_API_KEY → Digunakan untuk mengautentikasi ke layanan OpenAI untuk embedding dan chat API. Temukan di sini. Perlu dicatat Anda mungkin perlu masuk atau mendaftar layanan OpenAI terlebih dahulu.INDEX_NAME → Nama indeks Pinecone yang akan digunakan Canopy – akan dibahas lebih lanjut nanti di tutorial ini.CANOPY_CONFIG_FILE → Jalur ke file konfigurasi yaml yang akan digunakan oleh server Canopy. Jika tidak disediakan, konfigurasi default akan digunakan.Berikut cara menyiapkan variabel lingkungan Anda - jalankan perintah berikut dari terminal:
export PINECONE_API_KEY="<PINECONE_API_KEY>"
export OPENAI_API_KEY="<OPENAI_API_KEY>"
export CANOPY_CONFIG_FILE="<CANOPY_CONFIG_FILE >"
export INDEX_NAME="<INDEX_NAME>"Jika Anda mengikuti semua langkah hingga tahap ini maka Canopy seharusnya telah terpasang di sistem Anda.
Untuk memastikan, jalankan perintah berikut:
canopy Ini akan menampilkan keluaran seperti:
Canopy: Ready

Usage: canopy [OPTIONS] COMMAND [ARGS]...
# rest of the help message
Sekarang Anda siap memulai proyek Pinecone Canopy pertama Anda.
Di Pinecone, embedding vektor disimpan dalam indeks – ini adalah unit organisasi tertinggi untuk data vektor di platform. Indeks menerima dan menyimpan vektor, melayani kueri atas vektor yang dikandungnya, dan melakukan operasi vektor lainnya terhadap isinya.
Saat menggunakan Canopy, Anda harus menyiapkan indeks Pinecone baru yang dikonfigurasi untuk bekerja dengan Canopy. Lakukan dengan menjalankan:
canopy newSetelah menjalankan perintah itu, ikuti instruksi di CLI.
Indeks yang dibuat akan memiliki awalan canopy--<INDEX_NAME>.
Perlu dicatat, Anda hanya perlu melakukan proses ini sekali untuk setiap indeks Canopy yang ingin Anda buat.
Setelah Anda membuat indeks, Anda siap memuat data ke dalam indeks Canopy Anda.
Berikut beberapa contoh cara melakukannya, tergantung pada data Anda:
canopy upsert /path/to/data_directory
# or
canopy upsert /path/to/data_directory/file.parquet
# or
canopy upsert /path/to/data_directory/file.jsonl
# or
canopy upsert /path/to/directory_of_txt_files/
# ...
Menurut dokumentasi, “Canopy mendukung file dalam format jsonl, parquet dan csv. Selain itu, Anda dapat memuat file data teks biasa dalam format .txt. Dalam hal ini, setiap file akan diperlakukan sebagai satu dokumen. ID dokumen akan berupa nama file, dan sumbernya adalah path lengkap file.”
Perhatikan penggunaan perintah upsert. Operasi upsert sekadar menulis record ke dalam namespace indeks. Jika ID record sudah ada, maka operasi upsert akan menimpa seluruh record.
Jika Anda ingin melakukan pembaruan parsial, gunakan operasi update untuk mengubah sebagian record.
Server Canopy menggunakan REST API untuk menyediakan fungsionalitasnya. Secara khusus, ini memungkinkan Anda bercakap dengan data Anda, mengunggah dokumen, dan mendapatkan dokumen relevan untuk kueri tertentu. Aplikasi chat apa pun dapat dengan mudah dihubungkan dengan endpoint /chat.completion milik server.
Untuk meluncurkan server, jalankan:
canopy startIni akan menampilkan pesan standar Uvicorn:
...

INFO:     Uvicorn running on http://0.0.0.0:8000 (Press CTRL+C to quit)
Setelah Anda mendapatkan pesan itu, Anda siap mulai menggunakan server Canopy dengan aplikasi chat apa pun yang mendukung endpoint /chat.completion.
Canopy dikemas sebagai layanan web (melalui Canopy Server) dan library yang dapat digunakan untuk membuat aplikasi kustom. Library ini terdiri dari tiga komponen, atau kelas, yang dapat digunakan secara terpisah atau sebagai paket lengkap. Masing-masing komponen bertanggung jawab atas bagian yang berbeda dari alur kerja RAG:
Data disiapkan untuk alur kerja RAG menggunakan Knowledge Base. Masukan teks secara otomatis dipecah menjadi potongan dan diubah menjadi embedding teks sebelum di-upsert ke basis data vektor Pinecone.
Bagian “retrieval” dari RAG ditangani oleh context engine. Dengan memanfaatkan Knowledge Base, Context Engine menemukan dokumen paling relevan dari Pinecone dan menyusunnya menjadi konteks untuk digunakan sebagai prompt LLM.
Seluruh alur kerja RAG diimplementasikan oleh Canopy Chat Engine. Ia memahami riwayat chat sebelumnya, mengenali pertanyaan multi-bagian, menghasilkan beberapa kueri relevan dari satu prompt, dan mengubahnya menjadi embedding. Setelah selesai, pengguna akhir disajikan jawaban yang sangat relevan dengan memanfaatkan konteks yang dihasilkan untuk LLM melalui Context Engine.
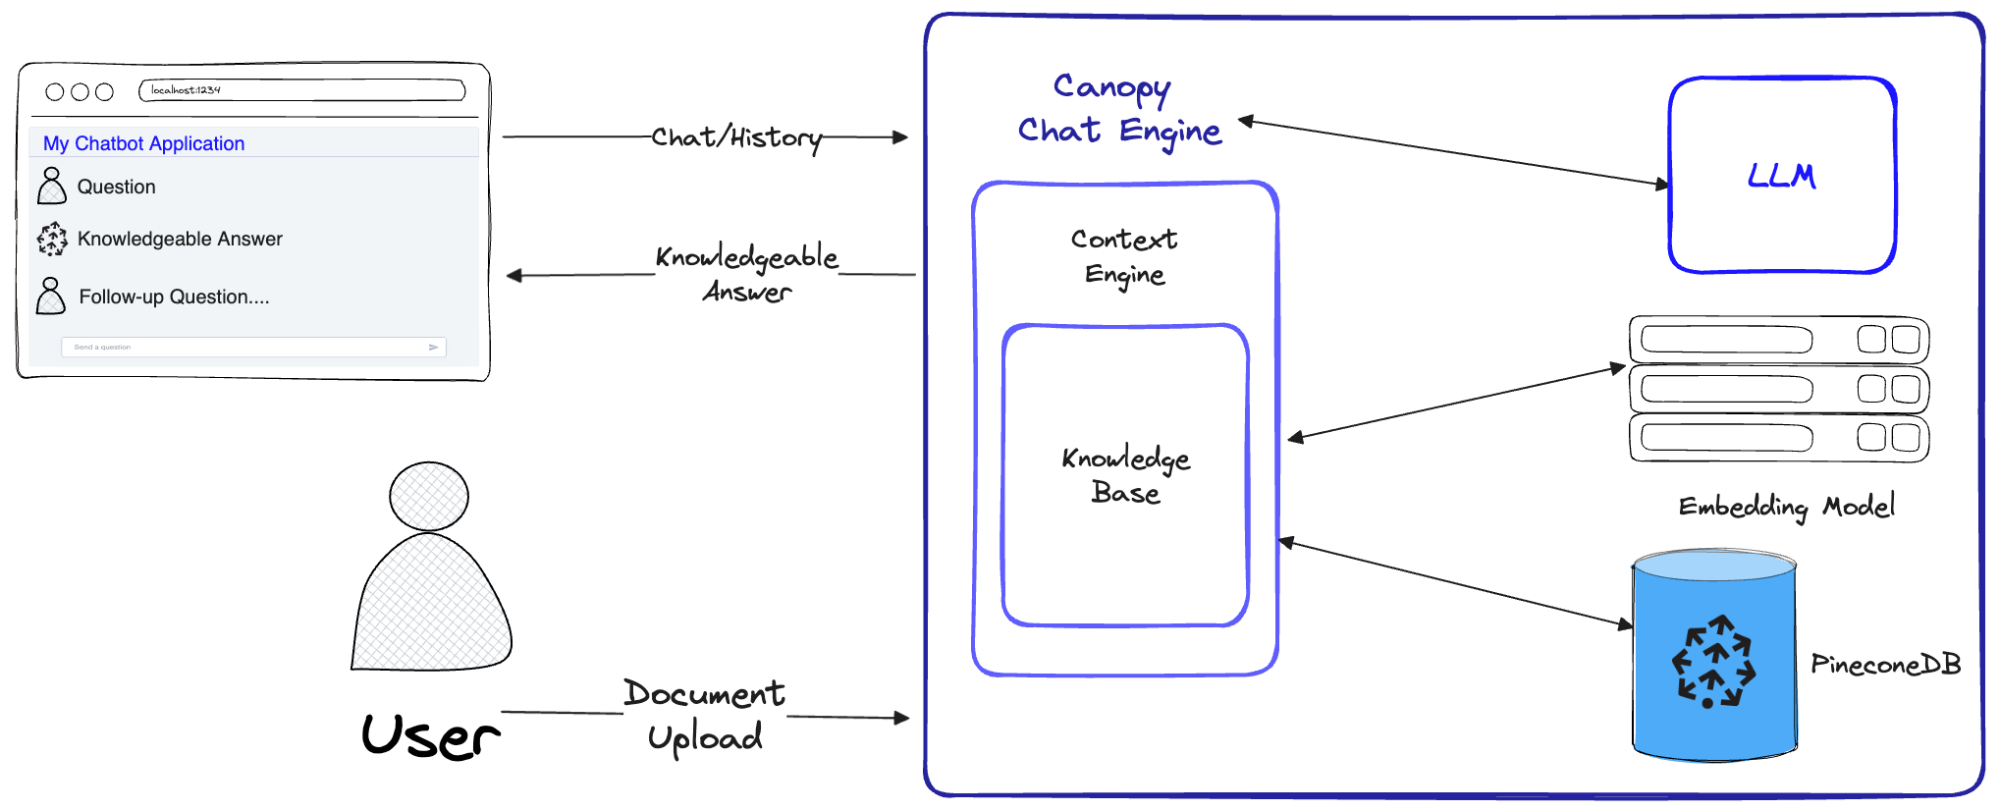
Diagram yang menunjukkan bagaimana Canopy Chat Engine mengimplementasikan seluruh alur kerja RAG. Sumber - Introducing Canopy: An easy, free, and flexible RAG framework powered by Pinecone
Pengguna Canopy dapat memanfaatkan Pinecone untuk melakukan penskalaan indeks secara vertikal atau horizontal. Penskalaan vertikal (alias scale up) menambah sumber daya komputasi, dan penskalaan horizontal (alias scale out) menambah jumlah mesin yang bisa digunakan untuk mendistribusikan beban.
Fitur lanjutan lain adalah partisi record dalam sebuah indeks ke dalam namespace. Ini membatasi kueri dan operasi lainnya pada satu namespace, sehingga permintaan berbeda dapat menelusuri subset berbeda dari indeks Anda.
Sebagai contoh, Anda mungkin ingin mendefinisikan satu namespace untuk mengindeks lagu berdasarkan genre dan satu lagi untuk mengindeks lagu berdasarkan tahun rilis. Berikut sebuah tutorial mendalam tentang cara melakukannya.
Terakhir, ada batch upsert. Perlu dicatat, operasi upsert memungkinkan pengguna menulis sebuah record ke dalam namespace. Namun, saat Anda melakukan upsert data dalam jumlah besar, dokumentasi mengarahkan pengguna untuk “melakukan upsert record dalam batch berisi 100 atau kurang melalui beberapa permintaan upsert.”
Berikut contohnya:
# Source: https://docs.pinecone.io/docs/upsert-data
import random
import itertools
from pinecone import Pinecone

pc = Pinecone(api_key="YOUR_API_KEY")
index = pc.Index("pinecone-index")

def chunks(iterable, batch_size=100):
    """A helper function to break an iterable into chunks of size batch_size."""
    it = iter(iterable)
    chunk = tuple(itertools.islice(it, batch_size))
    while chunk:
        yield chunk
        chunk = tuple(itertools.islice(it, batch_size))

vector_dim = 128
vector_count = 10000

# Example generator that generates many (id, vector) pairs
example_data_generator = map(lambda i: (f'id-{i}', [random.random() for _ in range(vector_dim)]), range(vector_count))

# Upsert data with 100 vectors per upsert request
for ids_vectors_chunk in chunks(example_data_generator, batch_size=100):
index.upsert(vectors=ids_vectors_chunk) Meskipun LLM adalah penemuan hebat, ada kelemahan besar: mereka dapat mengarang. RAG dapat digunakan untuk meningkatkan kegunaannya dengan menyediakan konteks faktual yang dapat digunakan saat menjawab pertanyaan.
Salah satu teknik yang bisa Anda coba adalah chunking untuk mengoptimalkan alur kerja RAG demi kinerja dan akurasi. Ini adalah komponen mendasar saat mengembangkan sistem RAG, tetapi kerangka kerja seperti Canopy biasanya mengabstraksikan proses ini agar pengguna tidak perlu memikirkannya. Namun, ukuran chunk penting, dan Anda sebaiknya mempertimbangkannya untuk meningkatkan performa RAG Anda – lihat blog Pinecone ini untuk mempelajari metode chunking.
Canopy dari Pinecone menyederhanakan proses membangun aplikasi RAG dengan menangani semua tugas berat yang terlibat dalam pengembangan aplikasi RAG, seperti mengelola riwayat chat, pemecahan dan embedding data teks, optimasi kueri, pengambilan konteks (termasuk rekayasa prompt), dan augmented generation. Ini memudahkan siapa pun yang ingin membangun dan bereksperimen dengan RAG untuk mulai melangkah.
Dalam tutorial ini, kita telah membahas semua yang perlu Anda ketahui untuk mulai bereksperimen dan membuat aplikasi RAG. Janji para pengembang Canopy adalah Anda dapat menyiapkan aplikasi berbasis RAG yang siap produksi dalam waktu kurang dari satu jam. Cobalah sendiri.
Untuk melanjutkan pembelajaran Anda, lihat:
Mulai Perjalanan AI Anda Hari Ini!
Program
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt




