
Cursus
Principes fondamentaux de l'IA
10 h
Edo Liberty a été directeur de la recherche chez AWS et Yahoo. Il n’a pas fallu longtemps pour qu’il mesure l’immense puissance de l’association des modèles d’intelligence artificielle (IA) et de la recherche vectorielle pour améliorer sensiblement des applications comme les systèmes de recommandation et les détecteurs de spam.
En approfondissant ses travaux sur des systèmes de recherche vectorielle personnalisés à très grande échelle, il a constaté qu’il n’existait aucune solution prête à l’emploi pour celles et ceux qui n’avaient pas les mêmes ressources en ingénierie et en data science qu’AWS et Yahoo. C’est ainsi qu’en 2019, il a fondé Pinecone, donnant naissance à la base de données vectorielle.
L’objectif de Pinecone était de fournir l’infrastructure essentielle de stockage et de recherche nécessaire pour concevoir et exécuter des applications d’IA de pointe. Selon Pinecone, son principe fondateur était de « rendre la solution accessible aux équipes d’ingénierie de toutes tailles et de tous niveaux d’expertise en IA ».
Résultat : le service entièrement managé et facile à utiliser qu’est Pinecone aujourd’hui. Quatre ans plus tard, voici Pinecone Canopy, un framework qui exploite la Retrieval Augmented Generation (RAG) pour permettre aux développeurs de créer des applications d’IA générative en toute simplicité.
Dans la suite de ce tutoriel, nous allons approfondir :
La documentation décrit Canopy comme « un framework open source de Retrieval Augmented Generation (RAG) et une couche de contexte construits au‑dessus de la base de données vectorielle Pinecone. »
Rappel : RAG est un cadre avancé d’IA introduit en 2020 par Meta (alors Facebook) AI Research. En s’appuyant sur des données dynamiques et spécifiques au domaine, RAG optimise la production des grands modèles de langage (LLM) sans nécessiter de réentraîner le modèle.
Canopy prend en charge toutes les tâches laborieuses liées au développement d’applications RAG : gestion des historiques de conversation, découpage et embedding des textes, optimisation des requêtes, récupération de contexte (y compris l’ingénierie de prompt) et génération augmentée.
Les développeurs peuvent ainsi expérimenter et créer rapidement des applications RAG avec Canopy. D’après l’article de lancement de novembre 2023, « avec Canopy, vous pouvez mettre en production une application propulsée par RAG en moins d’une heure. Et comme c’est construit et soutenu par Pinecone, vous retrouvez la même excellente expérience développeur et les performances de notre base de données vectorielle entièrement managée. »
Pour les développeurs qui souhaitent expérimenter RAG, Canopy propose une solution :
Les utilisateurs peuvent stocker jusqu’à 100 000 embeddings avec Pinecone sans frais. Cela représente environ 15 millions de mots ou 30 000 pages de texte. L’article de lancement précise également : « Des options gratuites pour les modèles d’embedding et les LLM arrivent bientôt. »
Les données textuelles peuvent être en JSONL, Parquet ou texte brut, et Canopy s’occupe du reste. La prise en charge des PDF sera ajoutée ultérieurement. Tout LLM d’OpenAI, y compris GPT‑4 Turbo, est compatible avec Canopy. La compatibilité avec d’autres LLM et modèles d’embedding, dont des modèles open source connus via Anyscale Endpoints, sera bientôt disponible. Les utilisateurs qui souhaitent convertir leurs textes au format JSONL peuvent le faire via le notebook de Pinecone.
Des applications GenAI prêtes pour la production et adossées à la base de données vectorielle de Pinecone peuvent être construites rapidement, avec précision et fiabilité.
La bibliothèque Canopy peut servir à créer des applications uniques. Les utilisateurs peuvent aussi exécuter Canopy en tant que service ou application web via une simple API REST. Elle peut être ajoutée à des applications OpenAI existantes en remplaçant la Chat Completions API par l’endpoint serveur de Canopy.
La CLI Canopy permet d’interagir avec des données textuelles via des commandes simples. Les utilisateurs peuvent ainsi comparer facilement des workflows RAG et non‑RAG pour évaluer de manière interactive les résultats augmentés avant la mise en production.
Prendre en main Pinecone Canopy est relativement simple. Avant de commencer, vous devez vous inscrire à une offre Standard ou Enterprise. Les nouveaux utilisateurs reçoivent 100 $ de crédits serverless pour tester et se familiariser avec l’outil.
Si vous ne souhaitez pas fournir de carte bancaire, vous pouvez créer un index gratuit basé sur pods.
Une fois votre compte créé, vous pouvez démarrer…
Installez le package Canopy avec :
pip install canopy-sdkSi vous préférez le faire dans un environnement virtuel, exécutez la commande suivante avant d’installer le package :
python3 -m venv canopy-env
source canopy-env/bin/activate
Cela crée un environnement virtuel et l’active. Consultez notre tutoriel Virtual Environment in Python pour en savoir plus sur leur fonctionnement.
Ensuite, vous devez configurer vos variables d’environnement. Pour cela, il vous faut quelques clés d’API.
Pour trouver votre PINECONE_API_KEY, il suffit de :
Autres variables d’environnement obligatoires :
OPENAI_API_KEY → utilisée pour s’authentifier auprès des services d’OpenAI (embedding et chat API). Retrouvez-la ici. Vous devrez peut‑être vous connecter ou vous inscrire au préalable.INDEX_NAME → nom de l’index Pinecone avec lequel Canopy va travailler – nous y reviendrons plus loin.CANOPY_CONFIG_FILE → chemin vers le fichier de configuration yaml utilisé par le serveur Canopy. S’il n’est pas fourni, la configuration par défaut sera utilisée.Voici comment définir vos variables d’environnement : exécutez la commande suivante dans votre terminal :
export PINECONE_API_KEY="<PINECONE_API_KEY>"
export OPENAI_API_KEY="<OPENAI_API_KEY>"
export CANOPY_CONFIG_FILE="<CANOPY_CONFIG_FILE >"
export INDEX_NAME="<INDEX_NAME>"Si vous avez suivi toutes les étapes jusqu’ici, Canopy devrait être installé sur votre machine.
Pour vous en assurer, exécutez :
canopy Vous devriez obtenir un résultat du type :
Canopy: Ready

Usage: canopy [OPTIONS] COMMAND [ARGS]...
# rest of the help message
Vous êtes maintenant prêt à démarrer votre premier projet Pinecone Canopy.
Dans Pinecone, les embeddings vectoriels sont stockés dans des index : c’est l’unité d’organisation la plus élevée pour les données vectorielles sur la plateforme. Ils reçoivent et stockent des vecteurs, servent des requêtes sur ces vecteurs et opèrent d’autres traitements vectoriels sur leur contenu.
Avec Canopy, vous devez créer un nouvel index Pinecone configuré pour fonctionner avec Canopy. Pour ce faire, exécutez :
canopy newAprès avoir lancé la commande, suivez les instructions de la CLI.
L’index créé aura le préfixe canopy--<INDEX_NAME>.
Vous n’avez à effectuer ce processus qu’une seule fois pour chaque index Canopy que vous souhaitez créer.
Une fois votre index créé, vous pouvez charger les données dans votre index Canopy.
Voici quelques exemples selon la nature de vos données :
canopy upsert /path/to/data_directory
# ou
canopy upsert /path/to/data_directory/file.parquet
# ou
canopy upsert /path/to/data_directory/file.jsonl
# ou
canopy upsert /path/to/directory_of_txt_files/
# ...
Selon la documentation, « Canopy prend en charge les fichiers au format jsonl, parquet et csv. Vous pouvez également charger des fichiers texte en .txt. Dans ce cas, chaque fichier est traité comme un document unique. L’identifiant du document sera le nom du fichier et la source, son chemin d’accès complet. »
Remarquez l’usage de la commande upsert. L’opération upsert écrit simplement des enregistrements dans un namespace d’index. Si un identifiant existe déjà, l’opération upsert écrase l’enregistrement entier.
Si vous souhaitez effectuer des modifications partielles, utilisez l’opération update.
Le serveur Canopy expose ses fonctionnalités via une API REST. Concrètement, il vous permet de dialoguer avec vos données, de téléverser des documents et de récupérer les documents pertinents pour une requête donnée. Toute application de chat peut se connecter facilement à l’endpoint /chat.completion du serveur.
Pour lancer le serveur, exécutez :
canopy startVous verrez alors le message standard d’Uvicorn :
...

INFO:     Uvicorn running on http://0.0.0.0:8000 (Press CTRL+C to quit)
Une fois ce message affiché, vous pouvez utiliser le serveur Canopy avec toute application de chat compatible avec un endpoint /chat.completion.
Canopy est fourni à la fois comme service web (via le serveur Canopy) et comme bibliothèque permettant de créer des applications personnalisées. La bibliothèque se compose de trois éléments, ou classes, utilisables séparément ou ensemble. Chaque composant prend en charge une partie distincte du workflow RAG :
La Knowledge Base prépare les données pour le workflow RAG. Le texte est automatiquement découpé en segments puis transformé en embeddings avant d’être upsert dans la base de données vectorielle Pinecone.
Le Context Engine gère la partie « recherche » de RAG. En s’appuyant sur la Knowledge Base, il identifie les documents les plus pertinents dans Pinecone et les organise en un contexte destiné au prompt du LLM.
Le Canopy Chat Engine orchestre l’ensemble du workflow RAG. Il tient compte de l’historique des conversations, reconnaît les questions en plusieurs parties, génère plusieurs requêtes pertinentes à partir d’un seul prompt et les convertit en embeddings. À l’issue du processus, l’utilisateur final reçoit une réponse hautement pertinente grâce au contexte généré pour le LLM via le Context Engine.
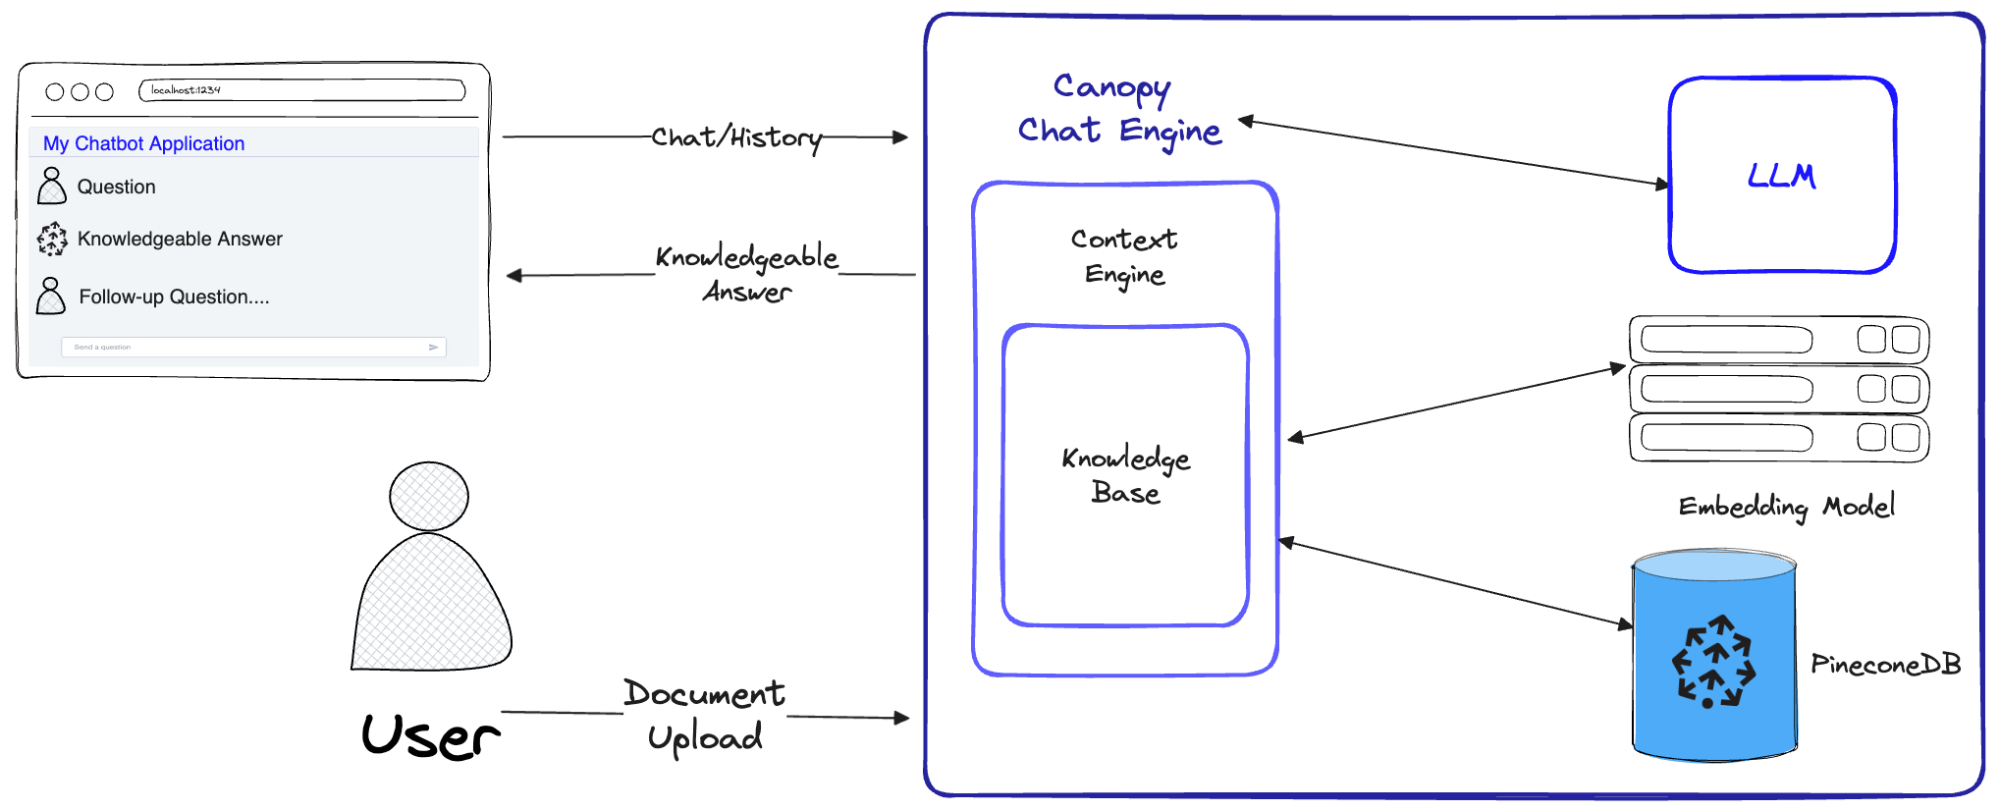
Schéma illustrant comment le Canopy Chat Engine implémente l’ensemble du workflow RAG. Source - Introducing Canopy: An easy, free, and flexible RAG framework powered by Pinecone
Les utilisateurs de Canopy peuvent s’appuyer sur Pinecone pour mettre leurs index à l’échelle verticalement ou horizontalement. La montée en puissance (scaling up) ajoute des ressources de calcul, tandis que la montée en charge horizontale (scaling out) ajoute des machines pour répartir les charges.
Autre fonctionnalité avancée : le partitionnement des enregistrements d’un index en namespaces. Cela limite les requêtes et autres opérations à un namespace donné, de sorte que différentes demandes explorent des sous‑ensembles distincts de votre index.
Par exemple, vous pouvez définir un namespace pour indexer des chansons par genre et un autre par année de sortie. Voici un tutoriel détaillé pour y parvenir.
Enfin, pensez à l’upsert par lot (batch upsert). L’opération upsert permet d’écrire un enregistrement dans un namespace. Toutefois, pour de gros volumes de données, la documentation recommande d’« upserter les enregistrements par lots de 100 ou moins, via plusieurs requêtes upsert ».
Exemple :
# Source: https://docs.pinecone.io/docs/upsert-data
import random
import itertools
from pinecone import Pinecone

pc = Pinecone(api_key="YOUR_API_KEY")
index = pc.Index("pinecone-index")

def chunks(iterable, batch_size=100):
    """A helper function to break an iterable into chunks of size batch_size."""
    it = iter(iterable)
    chunk = tuple(itertools.islice(it, batch_size))
    while chunk:
        yield chunk
        chunk = tuple(itertools.islice(it, batch_size))

vector_dim = 128
vector_count = 10000

# Example generator that generates many (id, vector) pairs
example_data_generator = map(lambda i: (f'id-{i}', [random.random() for _ in range(vector_dim)]), range(vector_count))

# Upsert data with 100 vectors per upsert request
for ids_vectors_chunk in chunks(example_data_generator, batch_size=100):
index.upsert(vectors=ids_vectors_chunk) Même si les LLM sont une avancée majeure, ils ont un défaut : ils peuvent inventer des informations. RAG permet d’accroître leur utilité en leur fournissant un contexte factuel pour répondre aux requêtes.
Parmi les techniques à essayer : le découpage (chunking) pour optimiser les workflows RAG en performance et en précision. C’est un composant fondamental des systèmes RAG, généralement masqué par des frameworks comme Canopy pour simplifier la vie des utilisateurs. Néanmoins, la taille des segments compte et mérite d’être étudiée pour améliorer vos performances RAG – consultez cet article du blog Pinecone pour découvrir les méthodes de chunking.
Canopy de Pinecone simplifie la création d’applications RAG en prenant en charge toutes les tâches lourdes : gestion des historiques de chat, découpage et embedding des textes, optimisation des requêtes, récupération de contexte (y compris l’ingénierie de prompt) et génération augmentée. Cela facilite grandement les premiers pas pour toute personne souhaitant créer et expérimenter des applications RAG.
Dans ce tutoriel, nous avons passé en revue tout ce qu’il faut pour commencer à expérimenter et à créer des applications RAG. Les équipes de Canopy promettent qu’il est possible de mettre en route une application RAG prête pour la production en moins d’une heure. À vous de jouer.
Pour aller plus loin, découvrez :
Commencez votre parcours IA dès aujourd’hui !
Cursus
Cours