Programa
Fundamentos da IA
10 h
Edo Liberty foi diretor de pesquisa na AWS e no Yahoo. Nesse período, não demorou para ele perceber o enorme poder de combinar modelos de inteligência artificial (IA) com busca vetorial para melhorar significativamente aplicativos como sistemas de recomendação e detectores de spam.
Ao se aprofundar no trabalho com sistemas personalizados de busca vetorial em grande escala, notou que não havia uma solução pronta para quem não tinha os mesmos recursos de engenharia e ciência de dados disponíveis na AWS e no Yahoo. Assim, em 2019, ele fundou a Pinecone, e o banco de dados vetorial nasceu.
O objetivo da Pinecone era oferecer a infraestrutura essencial de armazenamento e recuperação necessária para desenvolver e operar aplicativos de IA de última geração. Segundo a Pinecone, seu princípio fundador era “tornar a solução acessível para times de engenharia de todos os tamanhos e níveis de expertise em IA”.
Isso resultou no serviço totalmente gerenciado e fácil de usar que a Pinecone é hoje. Quatro anos depois, temos o Pinecone Canopy, um framework que utiliza Retrieval Augmented Generation (RAG) para permitir que desenvolvedores criem aplicativos de IA generativa sem esforço.
No restante deste tutorial, vamos nos aprofundar em:
A documentação descreve o Canopy como “um framework open-source de Retrieval Augmented Generation (RAG) e contexto construído sobre o banco de dados vetorial Pinecone.”
Observação: RAG é um framework avançado de IA introduzido pela Meta (então Facebook) AI Research em 2020. Usando dados dinâmicos e específicos de domínio, o RAG ajuda a otimizar a saída de Large Language Models (LLMs) sem precisar retreinar o modelo.
O Canopy cuida de todas as tarefas trabalhosas envolvidas no desenvolvimento de aplicações RAG. Isso inclui gerenciar históricos de chat, fazer chunking e embedding de dados de texto, otimização de consultas, recuperação de contexto (incluindo prompt engineering) e geração aumentada.
Assim, desenvolvedores podem experimentar e criar aplicações RAG de forma rápida e simples com o Canopy. Segundo o post de lançamento de novembro de 2023, “Com o Canopy, você consegue colocar no ar, em menos de uma hora, um aplicativo pronto para produção e turbinado por RAG. E como ele é construído e suportado pela Pinecone, você tem a mesma ótima experiência do desenvolvedor e performance do nosso banco de dados vetorial totalmente gerenciado.”
Para desenvolvedores que desejam experimentar RAG, o Canopy oferece uma solução:
Usuários podem armazenar até 100 mil embeddings na Pinecone sem custo. Isso equivale a aproximadamente 15 milhões de palavras ou 30 mil páginas de texto. Além disso, o post de lançamento afirma: “Opções gratuitas para modelos de embedding e LLMs estão chegando em breve.”
Os dados de texto podem vir em JSONL, Parquet ou texto puro, e o Canopy cuida do restante. Observação: suporte a PDF será adicionado no futuro. Qualquer LLM da OpenAI, incluindo o GPT-4 Turbo, é compatível com o Canopy. Suporte para outros LLMs e modelos de embedding, como modelos open-source conhecidos no Anyscale Endpoints, será adicionado em breve. Usuários que quiserem converter seus dados de texto para JSONL podem usar o notebook da Pinecone.
Aplicativos de IA generativa prontos para produção e apoiados pelo banco de dados vetorial da Pinecone podem ser construídos com rapidez, precisão e confiabilidade.
A biblioteca do Canopy pode ser utilizada para criar aplicativos únicos. Você também pode executar o Canopy como um serviço web ou aplicativo via uma API REST simples. Ele também pode ser adicionado a aplicativos existentes da OpenAI substituindo a Chat Completions API pelo endpoint de servidor do Canopy.
A CLI do Canopy pode interagir com dados de texto por meio de comandos simples. Isso permite comparar facilmente fluxos RAG com fluxos sem RAG para avaliar de forma interativa os resultados aumentados antes de ir para produção.
Começar com o Pinecone Canopy é relativamente simples. Antes de iniciar, você precisa criar uma conta Standard ou Enterprise. Novos usuários recebem US$ 100 em créditos serverless para explorar e se familiarizar com a ferramenta.
Observação: se você não quiser informar um cartão de crédito, pode criar um índice gratuito baseado em pod.
Depois de registrar sua conta, você já pode começar…
Instale o pacote Canopy usando:
pip install canopy-sdkSe quiser fazer isso em um ambiente virtual, execute o comando abaixo antes de instalar o pacote:
python3 -m venv canopy-env
source canopy-env/bin/activate
Isso cria um ambiente virtual e o ativa. Confira nosso tutorial Ambiente virtual em Python para entender melhor como funciona.
Em seguida, você precisa configurar suas variáveis de ambiente. Para isso, você vai precisar de algumas chaves de API.
Para encontrar sua PINECONE_API_KEY, basta:
Outras variáveis de ambiente obrigatórias incluem:
OPENAI_API_KEY → usada para autenticar nos serviços da OpenAI para embedding e chat API. Encontre aqui. Observação: talvez seja necessário fazer login ou se registrar previamente nos serviços da OpenAI.INDEX_NAME → nome do índice Pinecone com o qual o Canopy vai trabalhar – mais sobre isso adiante no tutorial.CANOPY_CONFIG_FILE → caminho para o arquivo yaml de configuração que será usado pelo servidor do Canopy. Se não for informado, a configuração padrão será utilizada.Veja como configurar suas variáveis de ambiente — execute o comando abaixo no terminal:
export PINECONE_API_KEY="<PINECONE_API_KEY>"
export OPENAI_API_KEY="<OPENAI_API_KEY>"
export CANOPY_CONFIG_FILE="<CANOPY_CONFIG_FILE >"
export INDEX_NAME="<INDEX_NAME>"Se você seguiu tudo até aqui, o Canopy deve estar instalado no seu sistema.
Para confirmar, execute o comando:
canopy A saída deve ser algo como:
Canopy: Ready

Usage: canopy [OPTIONS] COMMAND [ARGS]...
# rest of the help message
Agora você está pronto para começar seu primeiro projeto com o Pinecone Canopy.
Na Pinecone, embeddings vetoriais são armazenados em índices — esta é a unidade organizacional de mais alto nível para dados vetoriais na plataforma. Em resumo, eles recebem e armazenam vetores, atendem consultas sobre os vetores que contêm e executam outras operações vetoriais sobre seus conteúdos.
Ao usar o Canopy, você precisa configurar um novo índice da Pinecone preparado para funcionar com o Canopy. Para isso, execute:
canopy newDepois de rodar esse comando, siga as instruções da CLI.
O índice criado terá o prefixo canopy--<INDEX_NAME>.
Observação: você só precisa fazer esse processo uma vez para cada índice do Canopy que deseja criar.
Depois de criar seu índice, você já pode carregar dados no seu índice do Canopy.
Aqui vão alguns exemplos de maneiras de fazer isso, dependendo do seu dado:
canopy upsert /path/to/data_directory
# ou
canopy upsert /path/to/data_directory/file.parquet
# ou
canopy upsert /path/to/data_directory/file.jsonl
# ou
canopy upsert /path/to/directory_of_txt_files/
# ...
Segundo a documentação, “O Canopy suporta arquivos nos formatos jsonl, parquet e csv. Além disso, você pode carregar arquivos de dados em texto puro no formato .txt. Nesse caso, cada arquivo será tratado como um documento único. O id do documento será o nome do arquivo, e a fonte será o caminho completo do arquivo.”
Note o uso do comando upsert. A operação upsert simplesmente grava registros em um namespace do índice. Se um ID de registro já existir, a operação upsert substituirá todo o registro.
Se quiser fazer atualizações parciais, use a operação update para alterar parte de um registro.
O servidor do Canopy expõe suas funcionalidades via uma API REST. Em especial, ele permite conversar com seus dados, enviar documentos e obter documentos relevantes para uma consulta específica. Qualquer aplicativo de chat pode ser facilmente conectado ao endpoint /chat.completion do servidor.
Para iniciar o servidor, execute:
canopy startIsso exibirá a mensagem padrão do Uvicorn:
...

INFO:     Uvicorn running on http://0.0.0.0:8000 (Press CTRL+C to quit)
Ao ver essa mensagem, você já pode começar a usar o servidor do Canopy com qualquer aplicativo de chat que suporte um endpoint /chat.completion.
O Canopy vem empacotado como um serviço web (via Canopy Server) e como uma biblioteca que pode ser usada para criar aplicativos personalizados. A biblioteca é composta por três componentes, ou classes, que podem ser usados separadamente ou como um pacote completo. Cada componente é responsável por uma parte distinta do fluxo de trabalho RAG:
Os dados são preparados para o fluxo RAG usando a Knowledge Base. A entrada de texto é automaticamente dividida em chunks e transformada em embeddings de texto antes de ser inserida (upsert) no banco de dados vetorial Pinecone.
A parte de “recuperação” do RAG é tratada pelo Context Engine. Usando a Knowledge Base, o Context Engine localiza os documentos mais relevantes no Pinecone e os organiza em um contexto para uso como prompt de um LLM.
Todo o fluxo RAG é implementado pelo Canopy Chat Engine. Ele entende o histórico de chat, reconhece perguntas multipartes, gera várias consultas relevantes a partir de um único prompt e as transforma em embeddings. Ao final, o usuário recebe uma resposta altamente pertinente usando o contexto gerado para o LLM via o Context Engine.
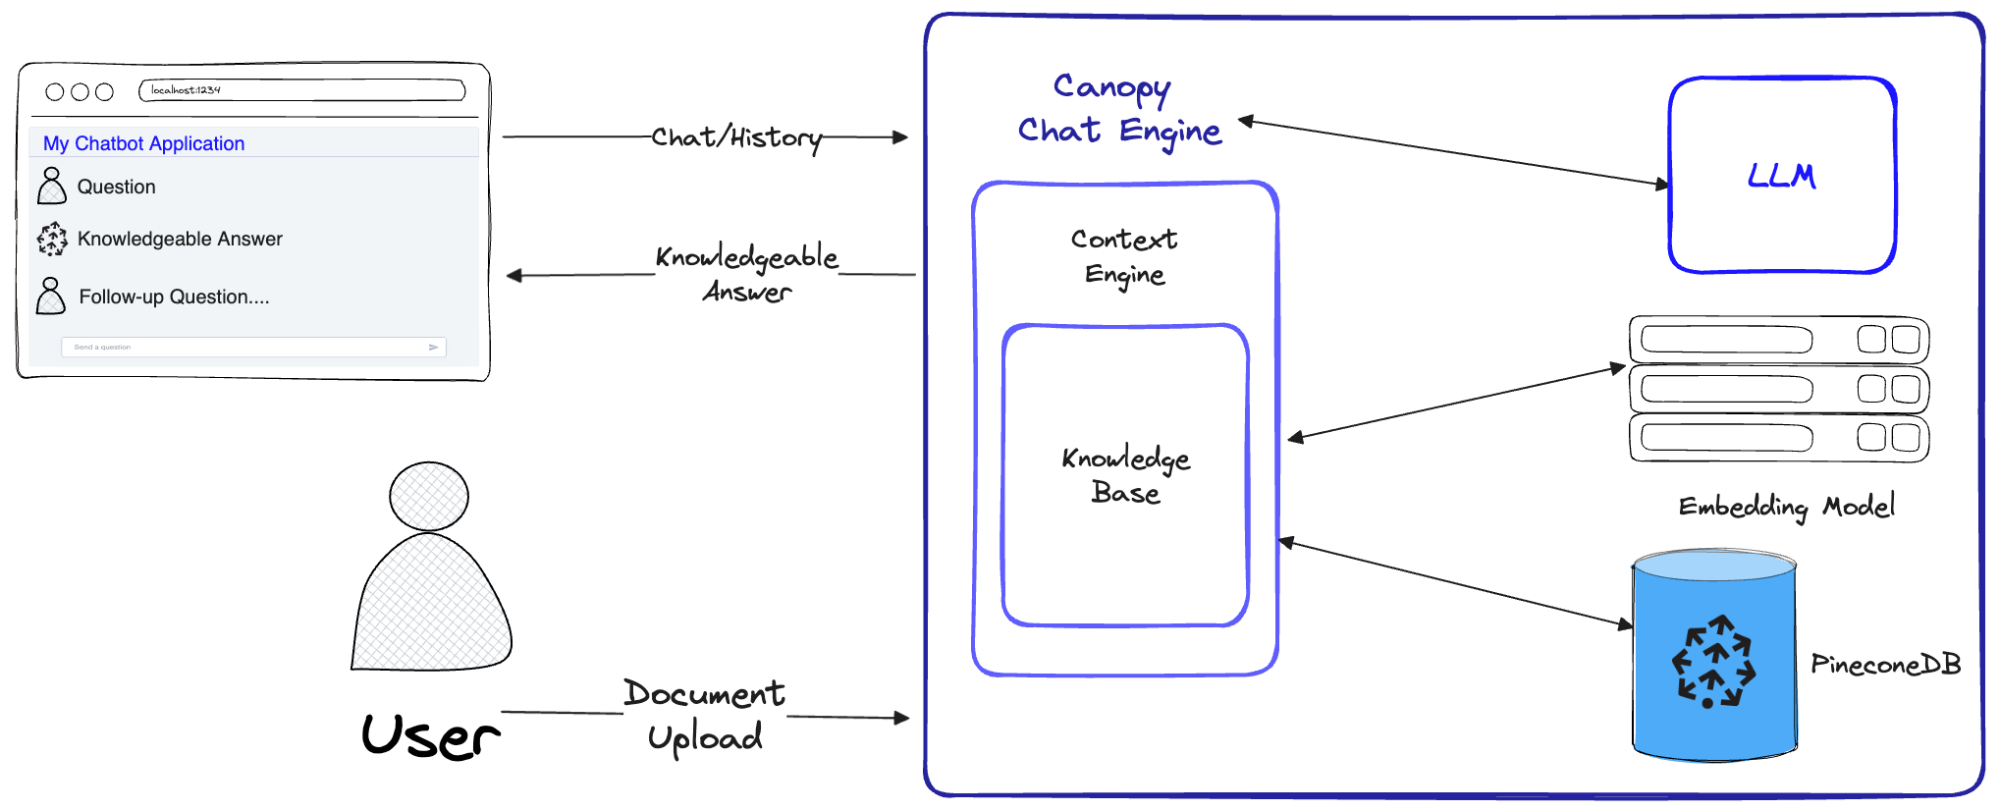
Um diagrama que mostra como o Canopy Chat Engine implementa todo o fluxo RAG. Fonte - Introducing Canopy: An easy, free, and flexible RAG framework powered by Pinecone
Usuários do Canopy podem aproveitar a Pinecone para escalar seus índices vertical ou horizontalmente. A escala vertical (scale up) disponibiliza mais recursos de computação, enquanto a escala horizontal (scale out) adiciona mais máquinas para distribuir carga.
Outro recurso avançado é particionar registros de um índice em namespaces. Isso limita consultas e outras operações a um único namespace, permitindo que diferentes requisições pesquisem subconjuntos diferentes do seu índice.
Por exemplo, você pode definir um namespace para indexar músicas por gênero e outro para indexar músicas por ano de lançamento. Aqui está um tutorial detalhado de como fazer.
Por fim, temos o upsert em lote. Observe que a operação upsert permite gravar um registro em um namespace. Porém, ao inserir grandes volumes de dados, a documentação orienta: “faça upsert de registros em lotes de 100 ou menos ao longo de múltiplas requisições de upsert.”
Exemplo:
# Source: https://docs.pinecone.io/docs/upsert-data
import random
import itertools
from pinecone import Pinecone

pc = Pinecone(api_key="YOUR_API_KEY")
index = pc.Index("pinecone-index")

def chunks(iterable, batch_size=100):
    """A helper function to break an iterable into chunks of size batch_size."""
    it = iter(iterable)
    chunk = tuple(itertools.islice(it, batch_size))
    while chunk:
        yield chunk
        chunk = tuple(itertools.islice(it, batch_size))

vector_dim = 128
vector_count = 10000

# Example generator that generates many (id, vector) pairs
example_data_generator = map(lambda i: (f'id-{i}', [random.random() for _ in range(vector_dim)]), range(vector_count))

# Upsert data with 100 vectors per upsert request
for ids_vectors_chunk in chunks(example_data_generator, batch_size=100):
index.upsert(vectors=ids_vectors_chunk) Embora os LLMs sejam uma grande invenção, eles têm uma falha importante: podem “alucinar”. O RAG aumenta sua utilidade ao fornecer contexto factual para usar ao responder perguntas.
Uma técnica que você pode testar é o chunking para otimizar os fluxos RAG em desempenho e precisão. Isso é um componente fundamental no desenvolvimento de sistemas RAG, mas frameworks como o Canopy normalmente abstraem esse processo para que os usuários não precisem se preocupar. No entanto, o tamanho do chunk faz diferença e deve ser considerado para melhorar sua performance em RAG — confira este post no blog da Pinecone para aprender métodos de chunking.
O Canopy, da Pinecone, simplifica a criação de aplicações RAG ao cuidar de todas as tarefas trabalhosas do desenvolvimento, como gerenciar históricos de chat, fazer chunking e embedding de texto, otimizar consultas, recuperar contexto (incluindo prompt engineering) e gerar respostas aumentadas. Isso facilita a vida de quem quer construir e experimentar com RAG.
Neste tutorial, vimos tudo o que você precisa para começar a experimentar e criar aplicações RAG. A promessa dos desenvolvedores do Canopy é que você consegue colocar no ar um aplicativo com RAG pronto para produção em menos de uma hora. Teste você mesmo.
Para continuar aprendendo, confira:
Comece sua jornada em IA hoje!
Programa
Curso
blog
Natassha Selvaraj
10 min
Tutorial
Ryan Ong
12 min
Tutorial
Moez Ali
12 min
Tutorial
Zoumana Keita
14 min
Tutorial
Arunn Thevapalan
15 min
Tutorial
Moez Ali
11 min