
Leerpad
AI-basisprincipes
10 uur
Edo Liberty is voormalig onderzoeksdirecteur bij AWS en Yahoo. In die periode merkte hij al snel hoe krachtig de combinatie van modellen voor kunstmatige intelligentie (AI) en vectorzoekopdrachten is om applicaties zoals aanbevelingssystemen en spambescherming aanzienlijk te verbeteren.
Toen hij zich steeds dieper bezighield met maatwerk-vectorzoeksystemen op enorme schaal, viel hem op dat er geen kant-en-klare oplossing bestond voor mensen die niet over dezelfde engineering- en data science-resources beschikten als AWS en Yahoo. Daarom richtte hij in 2019 Pinecone op, en werd de vector database geboren.
Het doel van Pinecone was om de cruciale opslag- en ophaalinfrastructuur te bieden die nodig is voor het ontwikkelen en draaien van state-of-the-art AI-applicaties. Volgens Pinecone was het oprichtingsprincipe om “de oplossing toegankelijk te maken voor engineeringteams van elke grootte en met elk niveau van AI-expertise.”
Dit resulteerde in de gebruiksvriendelijke, volledig beheerde service die Pinecone vandaag de dag is. Vier jaar later hebben we Pinecone Canopy, een framework dat Retrieval Augmented Generation (RAG) benut om ontwikkelaars in staat te stellen moeiteloos Generative AI-applicaties te bouwen.
In de rest van deze tutorial duiken we dieper in:
De Canopy-documentatie beschrijft Canopy als “een open-source Retrieval Augmented Generation (RAG)-framework en -context boven op de Pinecone vector database.”
Let op: RAG is een geavanceerd AI-framework dat in 2020 werd geïntroduceerd door Meta (destijds Facebook) AI Research. Met dynamische, domeinspecifieke data helpt RAG om de output van Large Language Models (LLM’s) te optimaliseren zonder het model te hoeven hertrainen.
Canopy neemt al het arbeidsintensieve werk rond het ontwikkelen van RAG-applicaties uit handen. Dit omvat het beheren van chatgeschiedenissen, het chunken en embedden van tekstdata, queryoptimalisatie, contextophaling (inclusief prompt engineering) en augmented generation.
Zo kunnen ontwikkelaars snel en eenvoudig experimenteren met en RAG-applicaties bouwen met Canopy. Volgens de releaseblogpost van november 2023: “Met Canopy krijg je binnen een uur een productierijpe, RAG-aangedreven applicatie up-and-running. En omdat het gebouwd en ondersteund wordt door Pinecone, krijg je dezelfde geweldige developer-ervaring en performance als onze volledig beheerde vector database.”
Voor ontwikkelaars die met RAG willen experimenteren, biedt Canopy een oplossing die:
Gebruikers kunnen tot 100k embeddings gratis opslaan met Pinecone. Dit is voldoende voor ongeveer 15 miljoen woorden of 30k pagina’s tekst. Daarnaast vermeldt de releaseblogpost: “Gratis opties voor embedding-modellen en LLM’s komen binnenkort.”
Tekstdata kan in JSONL, Parquet of platte tekst worden aangeleverd; Canopy regelt de rest. Let op: ondersteuning voor PDF wordt in de toekomst toegevoegd. Elke OpenAI LLM, waaronder GPT-4 Turbo, is compatibel met Canopy. Ondersteuning voor andere LLM’s en embedding-modellen, zoals bekende open-source modellen via Anyscale Endpoints, wordt binnenkort toegevoegd. Gebruikers die hun tekstdata in JSONL-formaat willen, kunnen deze omzetten met Pinecone’s notebook.
Productierijpe GenAI-applicaties op basis van Pinecone’s vector database kunnen snel, accuraat en betrouwbaar worden gebouwd.
De Canopy-bibliotheek kan worden gebruikt om unieke applicaties te bouwen. Gebruikers kunnen Canopy ook als webservice of applicatie draaien via een eenvoudige REST-API. Het kan bovendien aan bestaande OpenAI-applicaties worden toegevoegd door de Chat Completions API te vervangen door de server-endpoint van Canopy.
Met de Canopy CLI kun je met simpele commando’s met tekstdata communiceren. Hierdoor kunnen gebruikers RAG eenvoudig vergelijken met niet-RAG-workflows om de verrijkte resultaten interactief te evalueren voordat ze naar productie gaan.
Aan de slag gaan met Pinecone Canopy is vrij eenvoudig. Voordat je begint, moet je je aanmelden voor Standard of Enterprise. Nieuwe gebruikers krijgen $100 aan serverless credits om mee te experimenteren en het hulpmiddel te leren kennen.
Let op: als je geen creditcard wilt opgeven, kun je een gratis pod-based index maken.
Zodra je een account hebt geregistreerd, kun je aan de slag…
Installeer het Canopy-pakket met:
pip install canopy-sdkAls je dit in een virtuele omgeving wilt doen, voer dan het volgende commando uit voordat je het pakket installeert:
python3 -m venv canopy-env
source canopy-env/bin/activate
Dit maakt een virtuele omgeving aan en activeert die. Bekijk onze tutorial Virtuele omgeving in Python om meer te leren over hoe ze werken.
Vervolgens moet je je omgevingsvariabelen instellen. Hiervoor heb je een paar API-sleutels nodig.
Om je PINECONE_API_KEY te vinden, doe je simpelweg het volgende:
Andere verplichte omgevingsvariabelen zijn:
OPENAI_API_KEY → Hiermee verifieer je bij de services van OpenAI voor embedding en de chat-API. Vind hem hier. Let op: je moet mogelijk vooraf inloggen of je registreren voor OpenAI-services.INDEX_NAME → Dit is de naam van de Pinecone-index waarmee Canopy werkt – later in de tutorial meer hierover.CANOPY_CONFIG_FILE → Dit is het pad naar het configuratie-yaml-bestand dat door de Canopy-server wordt gebruikt. Als dit niet is opgegeven, wordt de standaardconfiguratie gebruikt.Zo stel je je omgevingsvariabelen in - voer het volgende commando uit vanuit je terminal:
export PINECONE_API_KEY="<PINECONE_API_KEY>"
export OPENAI_API_KEY="<OPENAI_API_KEY>"
export CANOPY_CONFIG_FILE="<CANOPY_CONFIG_FILE >"
export INDEX_NAME="<INDEX_NAME>"Als je alles tot deze stap hebt gevolgd, zou Canopy op je systeem geïnstalleerd moeten zijn.
Om zeker te zijn, voer je het volgende commando uit:
canopy Dit zou ongeveer het volgende moeten opleveren:
Canopy: Ready

Usage: canopy [OPTIONS] COMMAND [ARGS]...
# rest of the help message
Nu ben je klaar om te beginnen met je eerste Pinecone Canopy-project.
In Pinecone worden vector-embeddings opgeslagen in indexes – dit is de hoogste organisatorische eenheid voor vectordata op het platform. Ze accepteren en bewaren vectors, beantwoorden queries over de vectors die ze bevatten en voeren andere vectorbewerkingen uit op hun inhoud.
Wanneer je Canopy gebruikt, moet je een nieuwe Pinecone-index instellen die is geconfigureerd om met Canopy te werken. Dat doe je met:
canopy newVolg na het uitvoeren van dat commando de CLI-instructies.
De aangemaakte index krijgt de prefix canopy--<INDEX_NAME>.
Let op: dit proces hoef je maar één keer te doen voor elke Canopy-index die je wilt maken.
Zodra je je index hebt gemaakt, kun je data in je Canopy-index laden.
Hier zijn een paar voorbeelden van manieren om dat te doen, afhankelijk van je data:
canopy upsert /path/to/data_directory
# or
canopy upsert /path/to/data_directory/file.parquet
# or
canopy upsert /path/to/data_directory/file.jsonl
# or
canopy upsert /path/to/directory_of_txt_files/
# ...
Volgens de documentatie “ondersteunt Canopy bestanden in jsonl-, parquet- en csv-formaat. Daarnaast kun je platte-tekstbestanden in .txt-formaat laden. In dat geval wordt elk bestand als één document behandeld. De document-id is de bestandsnaam en de bron is het volledige pad van het bestand.”
Let op het gebruik van het upsert-commando. De upsert-operatie schrijft simpelweg records weg in een namespace van een index. Als een record-ID al bestaat, zal de upsert-operatie het gehele record overschrijven.
Als je updates wilt doorvoeren, gebruik dan de update-operatie om een deel van een record te wijzigen.
De Canopy-server stelt zijn functionaliteit beschikbaar via een REST-API. Concreet kun je ermee met je data converseren, documenten uploaden en relevante documenten ophalen voor een specifieke query. Elke chatapplicatie kan eenvoudig worden gekoppeld aan de /chat.completion-endpoint van de server.
Om de server te starten, voer je uit:
canopy startDit toont het standaard Uvicorn-bericht:
...

INFO:     Uvicorn running on http://0.0.0.0:8000 (Press CTRL+C to quit)
Zodra je dat bericht ziet, ben je klaar om de Canopy-server te gebruiken met elke chatapplicatie die een /chat.completion-endpoint ondersteunt.
Canopy wordt geleverd als webservice (via de Canopy Server) en als bibliotheek die kan worden gebruikt om maatwerkapplicaties te bouwen. De bibliotheek bestaat uit drie componenten, of klassen, die afzonderlijk of als geheel kunnen worden gebruikt. Elke component is verantwoordelijk voor een specifiek deel van de RAG-workflow:
Met de Knowledge Base wordt data voorbereid voor de RAG-workflow. Tekstinvoer wordt automatisch in chunks opgedeeld en omgezet in tekst-embeddings voordat deze in de Pinecone vector database wordt ge-upsert.
Het “retrieval”-gedeelte van RAG wordt afgehandeld door de Context Engine. Met behulp van de Knowledge Base lokaliseert de Context Engine de meest relevante documenten uit Pinecone en organiseert ze die in een context om te gebruiken als LLM-prompt.
De volledige RAG-workflow wordt geïmplementeerd door de Canopy Chat Engine. Hij begrijpt eerdere chatgeschiedenis, herkent meerdeelige vragen, genereert meerdere relevante queries op basis van één prompt en zet die om in embeddings. Daarna krijgt de eindgebruiker een zeer relevant antwoord, met gebruik van de context die voor de LLM is gegenereerd via de Context Engine.
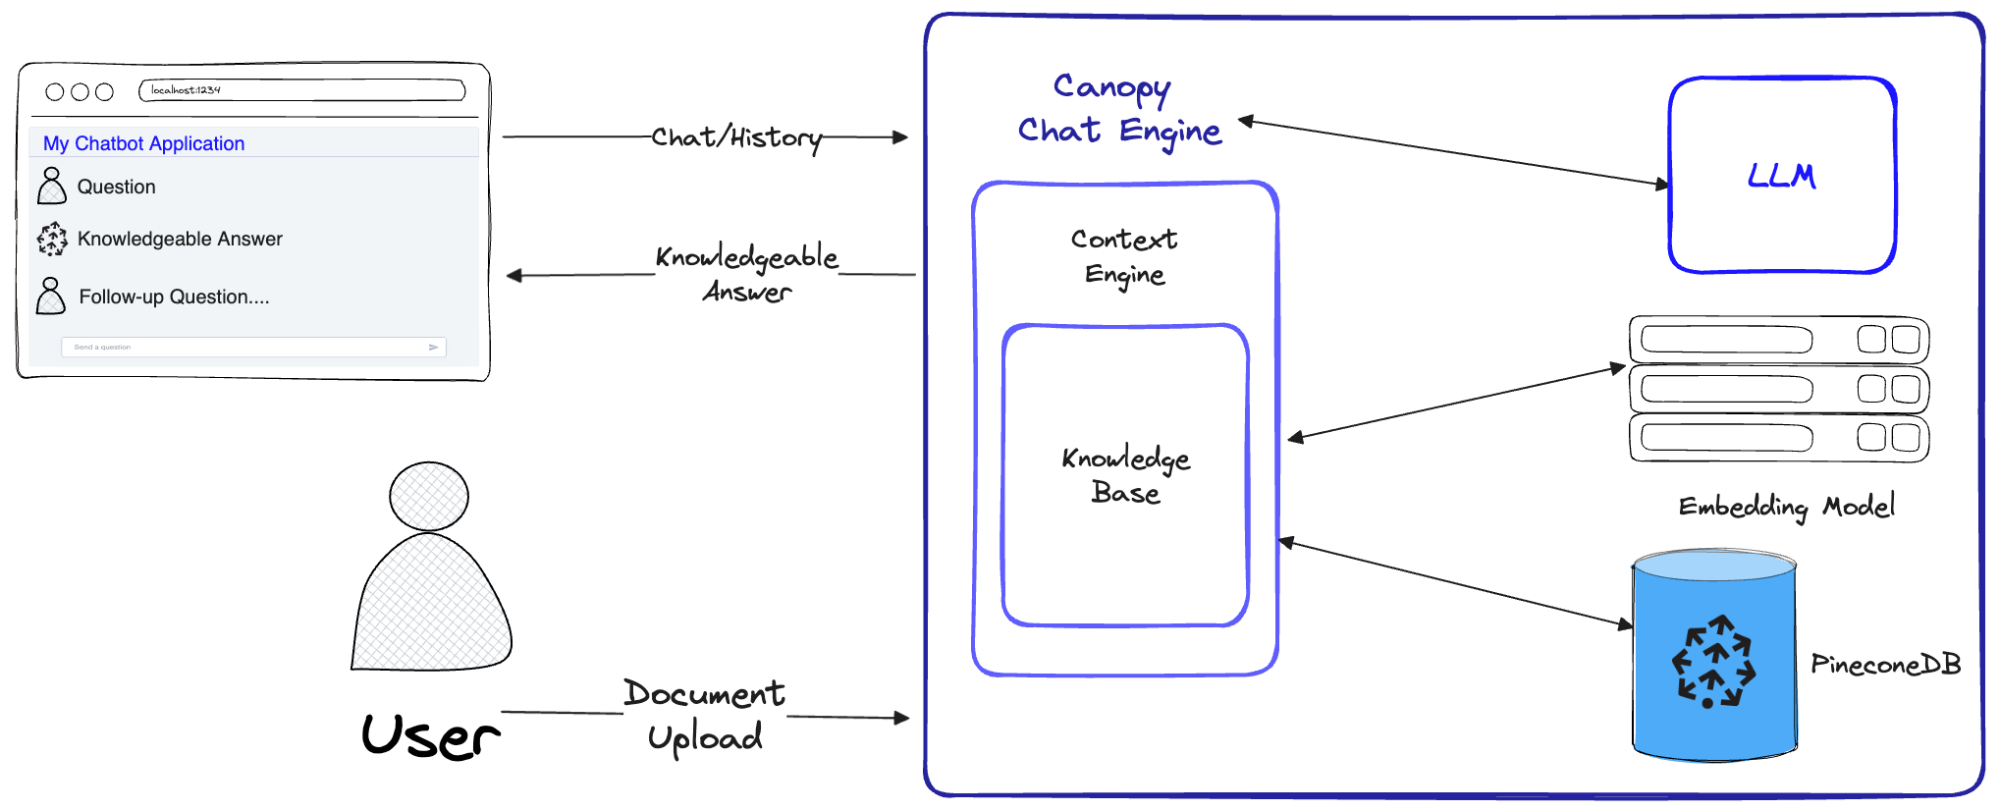
Een diagram dat laat zien hoe de Canopy Chat Engine de volledige RAG-workflow implementeert. Bron - Introducing Canopy: An easy, free, and flexible RAG framework powered by Pinecone
Gebruikers van Canopy kunnen Pinecone benutten om hun indexes verticaal of horizontaal te schalen. Verticale schaalvergroting (ook wel scaling up) maakt meer compute-resources beschikbaar, en horizontale schaalvergroting (scaling out) maakt meer machines beschikbaar om de belasting te verdelen.
Een andere geavanceerde functie is het partitioneren van records in een index in namespaces. Dit beperkt queries en andere bewerkingen tot één namespace, zodat verschillende verzoeken verschillende subsets van je index kunnen doorzoeken.
Zo kun je bijvoorbeeld een namespace definiëren voor het indexeren van nummers per genre en een andere voor het indexeren van nummers per uitgiftejaar. Hier is een uitgebreide tutorial over hoe je dat doet.
Tot slot is er batch upsert. Let op: de upsert-operatie laat gebruikers een record naar een namespace schrijven. Maar wanneer je grotere hoeveelheden data upsert, instrueert de documentatie gebruikers om “records in batches van 100 of minder te upserten over meerdere upsert-verzoeken.”
Hier is een voorbeeld:
# Source: https://docs.pinecone.io/docs/upsert-data
import random
import itertools
from pinecone import Pinecone

pc = Pinecone(api_key="YOUR_API_KEY")
index = pc.Index("pinecone-index")

def chunks(iterable, batch_size=100):
    """A helper function to break an iterable into chunks of size batch_size."""
    it = iter(iterable)
    chunk = tuple(itertools.islice(it, batch_size))
    while chunk:
        yield chunk
        chunk = tuple(itertools.islice(it, batch_size))

vector_dim = 128
vector_count = 10000

# Example generator that generates many (id, vector) pairs
example_data_generator = map(lambda i: (f'id-{i}', [random.random() for _ in range(vector_dim)]), range(vector_count))

# Upsert data with 100 vectors per upsert request
for ids_vectors_chunk in chunks(example_data_generator, batch_size=100):
index.upsert(vectors=ids_vectors_chunk) Hoewel LLM’s een geweldige uitvinding zijn, hebben ze een groot mankement: ze verzinnen dingen. RAG kan hun bruikbaarheid vergroten door feitelijke context te bieden die ze kunnen gebruiken bij het beantwoorden van vragen.
Een techniek die je kunt proberen is chunken om RAG-workflows te optimaliseren voor performance en nauwkeurigheid. Dit is een fundamenteel onderdeel bij het ontwikkelen van RAG-systemen, maar frameworks zoals Canopy abstraheren dit proces meestal weg zodat gebruikers er niet over hoeven na te denken. Toch doet chunkgrootte ertoe, en het is de moeite waard om die te overwegen om je RAG-prestaties te verbeteren – bekijk deze Pinecone-blogpost om chunkingmethoden te leren.
Canopy van Pinecone vereenvoudigt het bouwen van RAG-applicaties door al het arbeidsintensieve werk rond het ontwikkelen van RAG-applicaties op zich te nemen, zoals het beheren van chatgeschiedenis, het chunken en embedden van tekstdata, queryoptimalisatie, contextophaling (inclusief prompt engineering) en augmented generation. Dit maakt het voor iedereen die RAG wil bouwen en ermee wil experimenteren makkelijker om te beginnen.
In deze tutorial hebben we alles doorgenomen wat je moet weten om te beginnen met experimenteren en het maken van RAG-applicaties. De belofte van de ontwikkelaars van Canopy is dat je binnen een uur een productierijpe, RAG-aangedreven applicatie draaiende hebt. Probeer het zelf.
Ga verder met leren via:
Begin vandaag nog met je AI-reis!
Leerpad
Cursus
blog
Adel Nehme
15 min

