
Lernpfad
Grundlagen der KI
10 Std.
Edo Liberty war Forschungsdirektor bei AWS und Yahoo. In dieser Zeit wurde ihm schnell klar, wie mächtig die Kombination aus Modellen der Künstlichen Intelligenz (KI) und Vektorsuche ist, um Anwendungen wie Empfehlungssysteme und Spam-Filter deutlich zu verbessern.
Als er tiefer in die Arbeit mit maßgeschneiderten Vektorsuchsystemen im großen Maßstab einstieg, bemerkte er, dass es keine Lösung von der Stange für Teams gab, die nicht über die Engineering- und Data-Science-Ressourcen von AWS oder Yahoo verfügten. Also gründete er 2019 Pinecone – die Vektordatenbank war geboren.
Ziel von Pinecone war es, die zentrale Speicher- und Abrufinfrastruktur bereitzustellen, die für die Entwicklung und den Betrieb moderner KI-Anwendungen nötig ist. Laut Pinecone bestand das Gründungsprinzip darin, „die Lösung für Engineering-Teams jeder Größe und mit jedem KI-Erfahrungsstand zugänglich zu machen“.
Das Ergebnis ist der heute leicht bedienbare, vollständig verwaltete Service von Pinecone. Vier Jahre später gibt es Pinecone Canopy – ein Framework, das Retrieval Augmented Generation (RAG) nutzt, damit Entwickler mühelos Generative-AI-Anwendungen bauen können.
Im weiteren Verlauf dieses Tutorials schauen wir uns an:
Die Canopy-Dokumentation beschreibt Canopy als „ein Open-Source-Framework und Kontext für Retrieval Augmented Generation (RAG), aufgebaut auf der Pinecone-Vektordatenbank.“
Hinweis: RAG ist ein fortgeschrittenes KI-Framework, das 2020 von Meta (damals Facebook) AI Research vorgestellt wurde. Mit dynamischen, domänenspezifischen Daten hilft RAG, die Ausgabe großer Sprachmodelle (LLMs) zu optimieren, ohne das Modell neu trainieren zu müssen.
Canopy übernimmt die arbeitsintensiven Aufgaben bei der Entwicklung von RAG-Anwendungen: Verwaltung von Chatverläufen, Chunking und Embedding von Textdaten, Query-Optimierung, Kontexterstellung (inklusive Prompt-Engineering) und die erweiterte Generierung.
So können Entwickler schnell und einfach mit RAG experimentieren und Anwendungen erstellen. Laut Release-Blogpost im November 2023 gilt: „Mit Canopy kannst du in weniger als einer Stunde eine produktionsreife, RAG-gestützte Anwendung starten. Und weil es von Pinecone gebaut und unterstützt wird, profitierst du vom gleichen starken Developer-Erlebnis und der Performance unserer vollständig verwalteten Vektordatenbank.“
Für Entwickler, die mit RAG experimentieren möchten, bietet Canopy eine Lösung, die ist:
Du kannst bis zu 100.000 Embeddings kostenlos in Pinecone speichern. Das entspricht ungefähr 15 Mio. Wörtern oder 30.000 Seiten Text. Zusätzlich heißt es im Release-Blogpost: „Kostenlose Optionen für Embedding-Modelle und LLMs kommen bald.“
Textdaten können in JSONL, Parquet oder als Klartext vorliegen – Canopy übernimmt den Rest. Unterstützung für PDF wird später ergänzt. Jedes OpenAI-LLM, inklusive GPT-4 Turbo, ist mit Canopy kompatibel. Support für weitere LLMs und Embedding-Modelle, etwa bekannte Open-Source-Modelle über Anyscale Endpoints, folgt in Kürze. Wer seine Textdaten nach JSONL konvertieren möchte, kann dafür Pinecones Notebook nutzen.
Produktionsreife GenAI-Anwendungen auf Basis der Pinecone-Vektordatenbank lassen sich schnell, präzise und stabil entwickeln.
Die Canopy-Bibliothek kann für individuelle Anwendungen genutzt werden. Du kannst Canopy außerdem als Webservice oder Anwendung über eine einfache REST-API betreiben. Bestehende OpenAI-Anwendungen lassen sich anbinden, indem du die Chat Completions API durch Canopys Server-Endpoint ersetzt.
Die Canopy-CLI ermöglicht mit einfachen Befehlen die Interaktion mit Textdaten. So kannst du RAG- mit Nicht-RAG-Workflows vergleichen und die erweiterten Ergebnisse interaktiv prüfen, bevor du in Produktion gehst.
Der Einstieg in Pinecone Canopy ist recht unkompliziert. Bevor du loslegst, musst du dich für Standard oder Enterprise registrieren. Neue Nutzer erhalten 100 $ an serverlosen Credits zum Ausprobieren.
Hinweis: Wenn du keine Kreditkarte hinterlegen willst, kannst du einen kostenlosen pod-basierten Index erstellen.
Sobald dein Account steht, kann es losgehen…
Installiere das Canopy-Paket mit:
pip install canopy-sdkWenn du das in einer virtuellen Umgebung machen willst, führe vor der Installation folgende Befehle aus:
python3 -m venv canopy-env
source canopy-env/bin/activate
Damit erstellst du eine virtuelle Umgebung und aktivierst sie. Sieh dir unser Tutorial zu virtuellen Umgebungen in Python an, um mehr darüber zu erfahren.
Als Nächstes musst du deine Umgebungsvariablen setzen. Dafür brauchst du einige API-Keys.
So findest du deinen PINECONE_API_KEY:
Weitere notwendige Umgebungsvariablen sind:
OPENAI_API_KEY → Dient zur Authentifizierung bei OpenAI-Services für Embeddings und Chat-API. Du findest ihn hier. Hinweis: Eventuell musst du dich vorher bei OpenAI anmelden oder registrieren.INDEX_NAME → Der Name des Pinecone-Index, mit dem Canopy arbeitet – mehr dazu weiter unten im Tutorial.CANOPY_CONFIG_FILE → Pfad zur YAML-Konfigurationsdatei, die der Canopy-Server nutzt. Wenn nicht angegeben, wird die Standardkonfiguration verwendet.So setzt du die Umgebungsvariablen – führe im Terminal Folgendes aus:
export PINECONE_API_KEY="<PINECONE_API_KEY>"
export OPENAI_API_KEY="<OPENAI_API_KEY>"
export CANOPY_CONFIG_FILE="<CANOPY_CONFIG_FILE >"
export INDEX_NAME="<INDEX_NAME>"Wenn du allen Schritten bis hierher gefolgt bist, sollte Canopy installiert sein.
Zur Sicherheit führe folgenden Befehl aus:
canopy Die Ausgabe sollte in etwa so aussehen:
Canopy: Ready

Usage: canopy [OPTIONS] COMMAND [ARGS]...
# rest of the help message
Jetzt kannst du dein erstes Pinecone-Canopy-Projekt starten.
In Pinecone werden Vektorembeddings in Indizes gespeichert – das ist die oberste Organisationsebene für Vektordaten in der Plattform. Sie nehmen Vektoren entgegen, speichern sie, beantworten Abfragen darüber und führen weitere Vektoroperationen auf ihren Inhalten aus.
Für die Nutzung von Canopy musst du einen neuen Pinecone-Index anlegen, der für Canopy konfiguriert ist. Das machst du mit:
canopy newBefolge anschließend die Anweisungen in der CLI.
Der erstellte Index erhält das Präfix canopy--<INDEX_NAME>.
Hinweis: Diesen Prozess führst du pro Canopy-Index nur einmal durch.
Nachdem du deinen Index erstellt hast, kannst du Daten in deinen Canopy-Index laden.
Je nach Datenlage sind das beispielsweise folgende Varianten:
canopy upsert /path/to/data_directory
# oder
canopy upsert /path/to/data_directory/file.parquet
# oder
canopy upsert /path/to/data_directory/file.jsonl
# oder
canopy upsert /path/to/directory_of_txt_files/
# ...
Laut Dokumentation „unterstützt Canopy Dateien in den Formaten jsonl, parquet und csv. Zusätzlich kannst du Klartextdateien im Format .txt laden. In diesem Fall gilt jede Datei als ein einzelnes Dokument. Die Dokument-ID ist der Dateiname, als Quelle wird der vollständige Pfad der Datei verwendet.“
Achte auf den Befehl upsert. Die Operation upsert schreibt Datensätze in einen Index-Namespace. Existiert eine Datensatz-ID bereits, überschreibt upsert den gesamten Datensatz.
Wenn du nur Teile eines Datensatzes ändern möchtest, nutze die Operation update.
Der Canopy-Server stellt seine Funktionen über eine REST-API bereit. Damit kannst du mit deinen Daten chatten, Dokumente hochladen und für eine konkrete Anfrage passende Dokumente abrufen. Jede Chat-Anwendung lässt sich unkompliziert mit dem Server-Endpoint /chat.completion verbinden.
Zum Starten des Servers führe aus:
canopy startDaraufhin erscheint die übliche Uvicorn-Meldung:
...

INFO:     Uvicorn running on http://0.0.0.0:8000 (Press CTRL+C to quit)
Sobald diese Meldung erscheint, kannst du den Canopy-Server mit jeder Chat-Anwendung nutzen, die einen /chat.completion-Endpoint unterstützt.
Canopy wird als Webservice (über den Canopy-Server) und als Bibliothek ausgeliefert, mit der sich eigene Anwendungen entwickeln lassen. Die Bibliothek besteht aus drei Komponenten bzw. Klassen, die getrennt oder als Gesamtpaket genutzt werden können. Jede Komponente verantwortet einen eigenen Teil des RAG-Workflows:
Die Knowledge Base bereitet Daten für den RAG-Workflow auf. Texteingaben werden automatisch gechunkt und in Text-Embeddings umgewandelt, bevor sie in die Pinecone-Vektordatenbank upsertet werden.
Die Context Engine übernimmt den „Retrieval“-Teil von RAG. Mithilfe der Knowledge Base findet sie die relevantesten Dokumente in Pinecone und organisiert sie als Kontext für den LLM-Prompt.
Die Canopy Chat Engine setzt den gesamten RAG-Workflow um. Sie versteht vorherige Chatverläufe, erkennt mehrteilige Fragen, erzeugt aus einem Prompt mehrere relevante Anfragen und wandelt sie in Embeddings um. Am Ende erhält der Nutzende eine hochrelevante Antwort, indem der über die Context Engine erzeugte Kontext für das LLM genutzt wird.
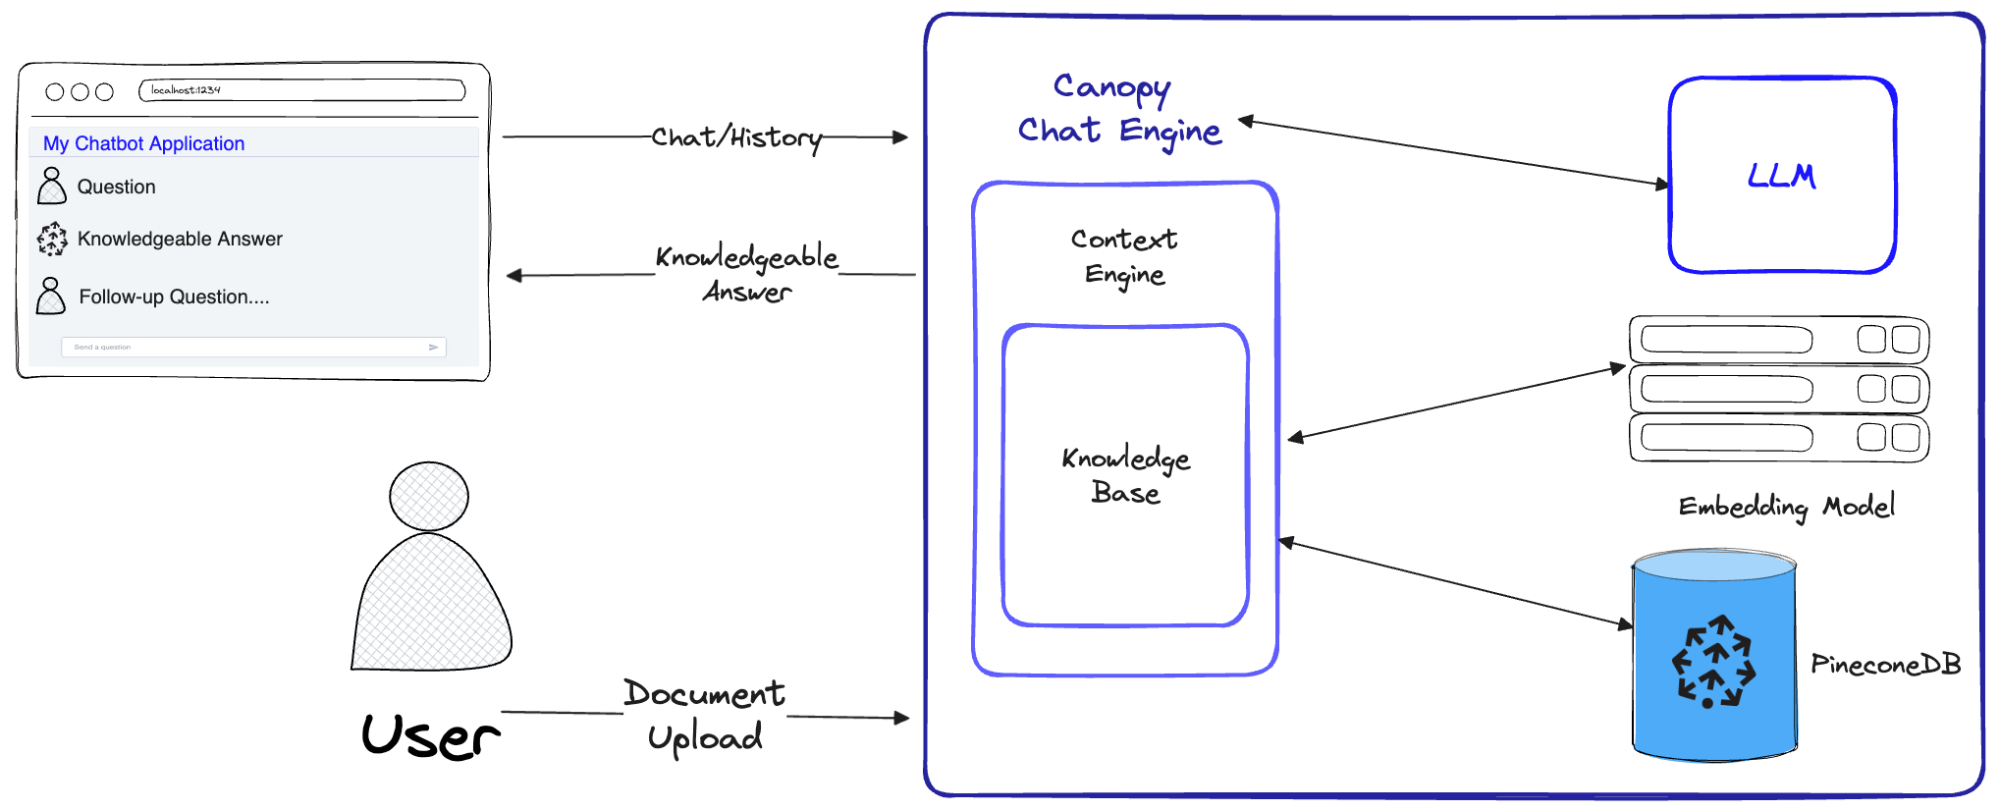
Ein Diagramm zeigt, wie die Canopy Chat Engine den gesamten RAG-Workflow umsetzt. Quelle – Introducing Canopy: An easy, free, and flexible RAG framework powered by Pinecone
Mit Canopy können Nutzer Pinecone nutzen, um ihre Indizes vertikal oder horizontal zu skalieren. Vertikales Skalieren (Scaling up) stellt mehr Rechenressourcen bereit, horizontales Skalieren (Scaling out) verteilt die Last auf zusätzliche Maschinen.
Ein weiteres Feature ist das Partitionieren von Datensätzen eines Index in Namespaces. So lassen sich Abfragen und andere Operationen auf einen Namespace begrenzen; verschiedene Requests durchsuchen damit unterschiedliche Teilmengen deines Index.
Beispielsweise könntest du einen Namespace für Songs nach Genre und einen weiteren für Songs nach Erscheinungsjahr definieren. Hier findest du ein ausführliches Tutorial dazu.
Zuletzt noch Batch-Upsert: Die Operation upsert schreibt Datensätze in einen Namespace. Wenn du große Datenmengen upserten willst, empfiehlt die Dokumentation, „Datensätze in Batches von 100 oder weniger über mehrere Upsert-Requests“ zu upserten.
Ein Beispiel:
# Quelle: https://docs.pinecone.io/docs/upsert-data
import random
import itertools
from pinecone import Pinecone

pc = Pinecone(api_key="YOUR_API_KEY")
index = pc.Index("pinecone-index")

def chunks(iterable, batch_size=100):
    """A helper function to break an iterable into chunks of size batch_size."""
    it = iter(iterable)
    chunk = tuple(itertools.islice(it, batch_size))
    while chunk:
        yield chunk
        chunk = tuple(itertools.islice(it, batch_size))

vector_dim = 128
vector_count = 10000

# Example generator that generates many (id, vector) pairs
example_data_generator = map(lambda i: (f'id-{i}', [random.random() for _ in range(vector_dim)]), range(vector_count))

# Upsert data with 100 vectors per upsert request
for ids_vectors_chunk in chunks(example_data_generator, batch_size=100):
index.upsert(vectors=ids_vectors_chunk) LLMs sind großartig, haben aber einen Haken: Sie halluzinieren. Mit RAG lässt sich ihre Nützlichkeit steigern, indem man ihnen faktenbasierten Kontext für Antworten liefert.
Eine Technik dafür ist Chunking, um RAG-Workflows in Leistung und Genauigkeit zu optimieren. Das ist ein Grundbaustein beim Entwickeln von RAG-Systemen, wird in Frameworks wie Canopy aber oft abstrahiert, sodass du dich nicht darum kümmern musst. Dennoch ist die Chunk-Größe entscheidend und sollte für bessere RAG-Ergebnisse bedacht werden – in diesem Pinecone-Blogpost findest du passende Methoden.
Canopy von Pinecone vereinfacht den Aufbau von RAG-Anwendungen, indem es die arbeitsintensiven Schritte übernimmt: Verwaltung von Chatverläufen, Chunking und Embedding von Text, Query-Optimierung, Kontexterstellung (inklusive Prompt-Engineering) und erweiterte Generierung. So fällt der Einstieg ins Bauen und Experimentieren mit RAG deutlich leichter.
In diesem Tutorial hast du alles Nötige kennengelernt, um mit RAG-Anwendungen zu experimentieren und sie zu erstellen. Das Versprechen der Canopy-Entwickler: In unter einer Stunde läuft eine produktionsreife, RAG-gestützte Anwendung. Probier es aus.
Wenn du weitermachen willst, sieh dir an:
Starte heute deine KI-Reise!
Lernpfad
Kurs