
Last chance! 50% off DataCamp Premium
Sale ends in
Edo Liberty è stato direttore della ricerca in AWS e Yahoo. In quel periodo, gli è bastato poco per rendersi conto dell’enorme potere di combinare modelli di intelligenza artificiale (AI) con la ricerca vettoriale per migliorare in modo significativo applicazioni come i sistemi di raccomandazione e i rilevatori di spam.
Approfondendo sempre più il lavoro su sistemi personalizzati di ricerca vettoriale su larga scala, ha notato che non esisteva una soluzione pronta all’uso per chi non aveva le stesse risorse di ingegneria e data science disponibili in AWS e Yahoo. Così, nel 2019, ha fondato Pinecone, e il database di vettori è nato.
Lo scopo di Pinecone era fornire l’infrastruttura critica di archiviazione e recupero necessaria per sviluppare ed eseguire applicazioni AI all’avanguardia. Secondo Pinecone, il suo principio fondante era “rendere la soluzione accessibile ai team di ingegneria di tutte le dimensioni e con qualsiasi livello di esperienza in AI”.
Il risultato è il servizio completamente gestito e facile da usare che Pinecone è oggi. Quattro anni dopo, è arrivato Pinecone Canopy, un framework che utilizza la Retrieval Augmented Generation (RAG) per permettere agli sviluppatori di creare applicazioni di Generative AI senza sforzo.
Nel resto di questo tutorial, approfondiremo:
La documentazione definisce Canopy come “un framework open-source di Retrieval Augmented Generation (RAG) e contesto costruito sopra il database di vettori Pinecone.”
Nota: RAG è un framework AI avanzato introdotto dal team Meta (all’epoca Facebook) AI Research nel 2020. Utilizzando dati dinamici e specifici del dominio, RAG aiuta a ottimizzare l’output dei Large Language Model (LLM) senza dover riaddestrare il modello.
Canopy gestisce tutte le attività più onerose coinvolte nello sviluppo di applicazioni RAG. Questo include la gestione della cronologia delle chat, il chunking e l’embedding dei dati testuali, l’ottimizzazione delle query, il recupero del contesto (inclusa la prompt engineering) e la generazione aumentata.
In questo modo, gli sviluppatori possono sperimentare e creare applicazioni RAG in modo rapido e semplice usando Canopy. Secondo il post di annuncio del novembre 2023, “Con Canopy, puoi mettere in piedi un’applicazione RAG pronta per la produzione in meno di un’ora. E poiché è costruita e supportata da Pinecone, ottieni la stessa ottima esperienza per sviluppatori e le prestazioni del nostro database di vettori completamente gestito.”
Per gli sviluppatori che desiderano sperimentare con RAG, Canopy offre una soluzione:
Gli utenti possono archiviare fino a 100mila embedding con Pinecone senza costi. Questo equivale a circa 15 milioni di parole o 30mila pagine di testo. Inoltre, il post di annuncio afferma: “Opzioni gratuite per modelli di embedding e LLM in arrivo a breve”.
I dati testuali possono essere in formato JSONL, Parquet o testo semplice, e Canopy si occuperà del resto. Il supporto per i PDF verrà aggiunto in futuro. Qualsiasi LLM di OpenAI, incluso GPT-4 Turbo, è compatibile con Canopy. Il supporto per altri LLM e modelli di embedding, come noti modelli open-source da Anyscale Endpoints, sarà aggiunto a breve. Gli utenti che desiderano avere i propri dati testuali in formato JSONL possono trasformarli utilizzando il notebook di Pinecone.
Applicazioni GenAI pronte per la produzione, supportate dal database di vettori di Pinecone, possono essere costruite in modo rapido, accurato e affidabile.
La libreria Canopy può essere utilizzata per creare applicazioni uniche. Gli utenti possono anche eseguire Canopy come servizio web o applicazione tramite una semplice API REST. Può inoltre essere aggiunta ad applicazioni OpenAI esistenti sostituendo la Chat Completions API con l’endpoint del server di Canopy.
La CLI di Canopy può interagire con i dati testuali tramite semplici comandi. Questo permette agli utenti di confrontare facilmente flussi di lavoro RAG e non RAG per valutare in modo interattivo i risultati aumentati prima del passaggio in produzione.
Iniziare con Pinecone Canopy è relativamente semplice. Prima di cominciare, devi registrarti a un piano Standard o Enterprise. I nuovi utenti ricevono 100 $ di crediti serverless per fare prove e familiarizzare con lo strumento.
Nota: se non vuoi fornire una carta di credito, puoi creare un indice basato su pod gratuito.
Una volta registrato l’account, sei pronto per iniziare…
Installa il pacchetto Canopy usando:
pip install canopy-sdkSe desideri farlo in un ambiente virtuale, esegui il seguente comando prima di installare il pacchetto:
python3 -m venv canopy-env
source canopy-env/bin/activate
Questo crea un ambiente virtuale e lo attiva. Dai un’occhiata al nostro tutorial Ambienti virtuali in Python per saperne di più su come funzionano.
Successivamente, devi configurare le tue variabili d’ambiente. Per farlo, ti serviranno alcune chiavi API.
Per trovare la tua PINECONE_API_KEY, ti basta:
Altre variabili d’ambiente obbligatorie includono:
OPENAI_API_KEY → Serve per autenticarsi ai servizi di OpenAI per l’API di embedding e chat. Trovala qui. Nota: potresti dover accedere o registrarti a OpenAI in precedenza.INDEX_NAME → È il nome dell’indice Pinecone con cui Canopy lavorerà – ne parleremo più avanti nel tutorial.CANOPY_CONFIG_FILE → È il percorso al file yaml di configurazione che sarà usato dal server Canopy. Se non fornito, verrà usata la configurazione predefinita.Ecco come impostare le variabili d’ambiente: esegui il seguente comando dal terminale:
export PINECONE_API_KEY="<PINECONE_API_KEY>"
export OPENAI_API_KEY="<OPENAI_API_KEY>"
export CANOPY_CONFIG_FILE="<CANOPY_CONFIG_FILE >"
export INDEX_NAME="<INDEX_NAME>"Se hai seguito tutto fino a questo punto, Canopy dovrebbe essere installato sul tuo sistema.
Per esserne sicuro, esegui il seguente comando:
canopy Dovrebbe stampare qualcosa del tipo:
Canopy: Ready

Usage: canopy [OPTIONS] COMMAND [ARGS]...
# rest of the help message
Ora sei pronto per iniziare il tuo primo progetto con Pinecone Canopy.
In Pinecone, gli embedding vettoriali sono archiviati in indici – la più alta unità organizzativa dei dati vettoriali sulla piattaforma. In particolare, accettano e archiviano vettori, servono query sui vettori contenuti ed eseguono altre operazioni vettoriali sui loro contenuti.
Quando usi Canopy, devi configurare un nuovo indice Pinecone predisposto per funzionare con Canopy. Puoi farlo eseguendo:
canopy newDopo aver eseguito quel comando, segui le istruzioni della CLI.
L’indice creato avrà il prefisso canopy--<INDEX_NAME>.
Nota: questo processo va fatto solo una volta per ogni indice Canopy che vuoi creare.
Una volta creato l’indice, sei pronto a caricare i dati nel tuo indice Canopy.
Ecco alcuni esempi di diversi modi per farlo, a seconda dei tuoi dati:
canopy upsert /path/to/data_directory
# or
canopy upsert /path/to/data_directory/file.parquet
# or
canopy upsert /path/to/data_directory/file.jsonl
# or
canopy upsert /path/to/directory_of_txt_files/
# ...
Secondo la documentazione, “Canopy supporta file in formato jsonl, parquet e csv. Inoltre, puoi caricare file di dati in testo semplice in formato .txt. In tal caso, ogni file sarà trattato come un singolo documento. L’id del documento sarà il nome del file e la sorgente sarà il percorso completo del file.”
Nota l’uso del comando upsert. L’operazione upsert scrive semplicemente record in uno spazio dei nomi dell’indice. Se un ID record esiste già, l’operazione upsert sovrascriverà l’intero record.
Se vuoi apportare modifiche, usa l’operazione update per modificare parte di un record.
Il server Canopy utilizza una REST API per esporre le sue funzionalità. In particolare, ti consente di conversare con i tuoi dati, caricare documenti e recuperare documenti pertinenti per una query specifica. Qualsiasi applicazione di chat può essere collegata facilmente all’endpoint /chat.completion del server.
Per avviare il server, esegui:
canopy startTi verrà mostrato il classico messaggio di Uvicorn:
...

INFO:     Uvicorn running on http://0.0.0.0:8000 (Press CTRL+C to quit)
Una volta visualizzato quel messaggio, sei pronto per iniziare a usare il server Canopy con qualsiasi applicazione di chat che supporti un endpoint /chat.completion.
Canopy viene fornito come servizio web (tramite il Canopy Server) e come libreria che può essere utilizzata per creare applicazioni personalizzate. La libreria è composta da tre componenti, o classi, che possono essere usati separatamente o come pacchetto completo. Ogni componente è responsabile di una parte distinta del flusso di lavoro RAG:
I dati vengono preparati per il flusso di lavoro RAG tramite la Knowledge Base. L’input testuale è automaticamente suddiviso in chunk e trasformato in embedding testuali prima di essere inserito (upsert) nel database di vettori Pinecone.
La parte di “retrieval” del RAG è gestita dal context engine. Utilizzando la Knowledge Base, il Context Engine individua i documenti più pertinenti da Pinecone e li organizza in un contesto da usare come prompt per l’LLM.
L’intero flusso di lavoro RAG è implementato dal Canopy Chat Engine. Comprende la cronologia delle chat, riconosce domande multi‑parte, genera più query pertinenti da un singolo prompt e le trasforma in embedding. Al termine, l’utente finale riceve una risposta altamente pertinente grazie al contesto generato per l’LLM tramite il Context Engine.
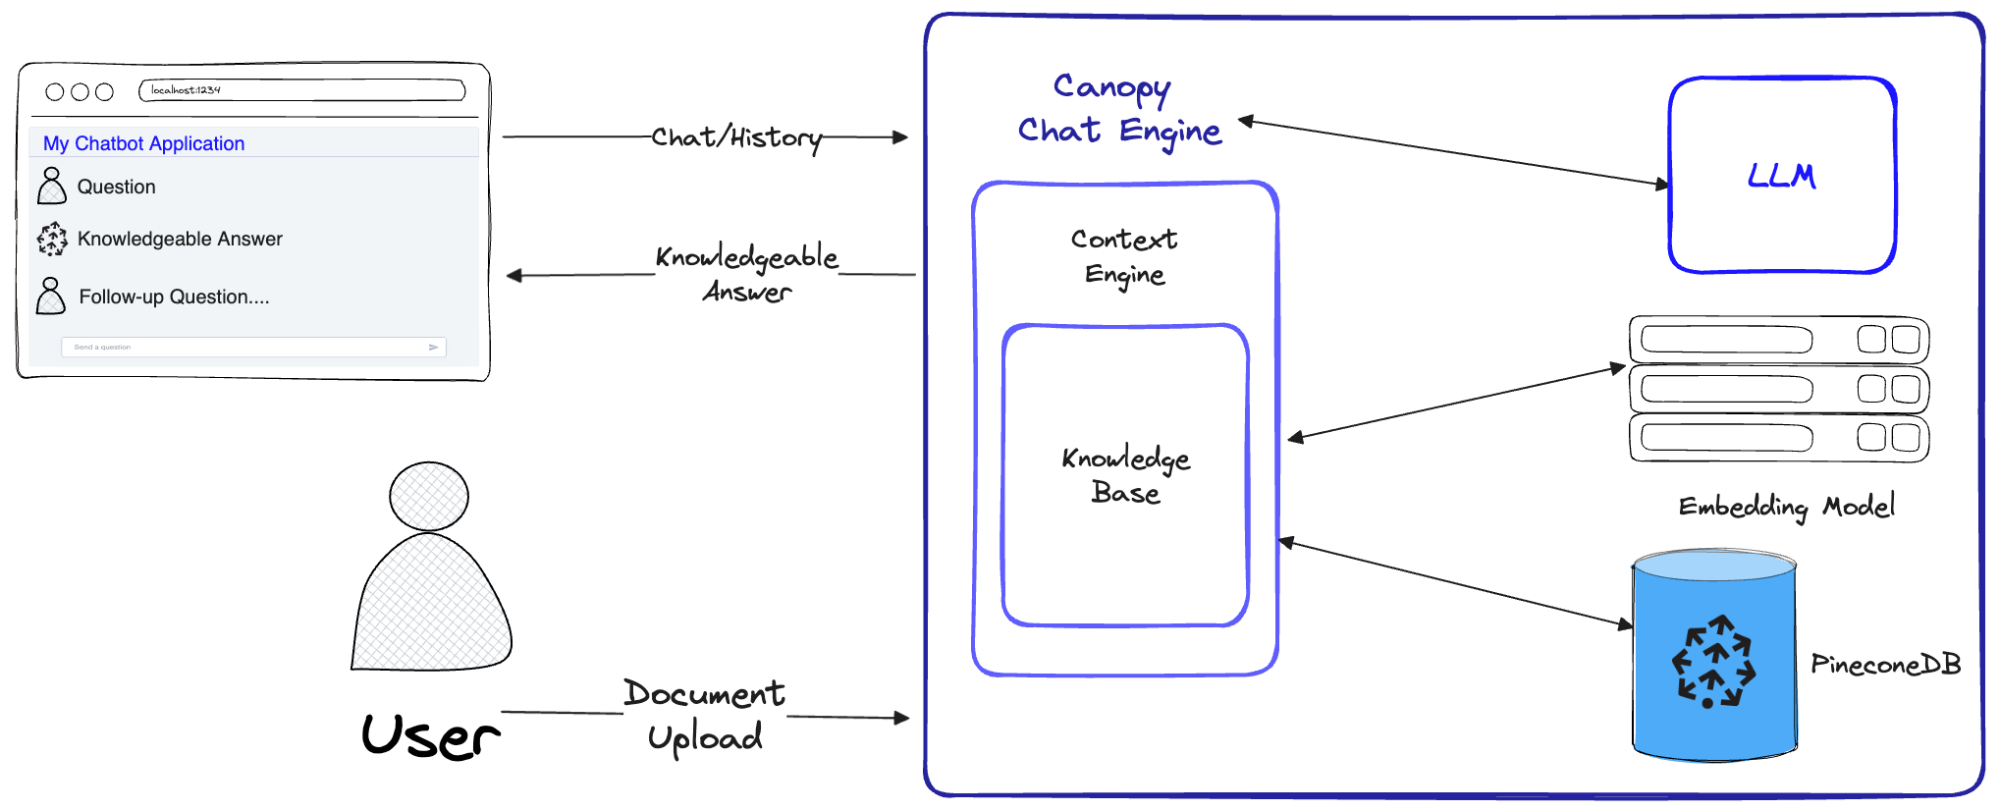
Uno schema che mostra come il Canopy Chat Engine implementa l’intero flusso di lavoro RAG. Fonte - Introducing Canopy: An easy, free, and flexible RAG framework powered by Pinecone
Gli utenti di Canopy possono sfruttare Pinecone per scalare i propri indici verticalmente o orizzontalmente. La scalabilità verticale (scaling up) mette a disposizione più risorse di calcolo, mentre la scalabilità orizzontale (scaling out) aggiunge più macchine per distribuire i carichi.
Un’altra funzionalità avanzata è la suddivisione dei record in un indice in namespace. Questo limita le query e le altre operazioni a un solo namespace, così richieste diverse possono cercare sottoinsiemi diversi del tuo indice.
Ad esempio, potresti definire un namespace per indicizzare canzoni per genere e un altro per indicizzarle per anno di pubblicazione. Ecco un tutorial approfondito su come farlo.
Ultimo ma non meno importante, c’è l’upsert in batch. Nota: l’operazione upsert consente di scrivere un record in un namespace. Tuttavia, quando esegui l’upsert di quantità maggiori di dati, la documentazione istruisce gli utenti a “inserire (upsert) i record in batch da 100 o meno su più richieste di upsert.”
Ecco un esempio:
# Source: https://docs.pinecone.io/docs/upsert-data
import random
import itertools
from pinecone import Pinecone

pc = Pinecone(api_key="YOUR_API_KEY")
index = pc.Index("pinecone-index")

def chunks(iterable, batch_size=100):
    """A helper function to break an iterable into chunks of size batch_size."""
    it = iter(iterable)
    chunk = tuple(itertools.islice(it, batch_size))
    while chunk:
        yield chunk
        chunk = tuple(itertools.islice(it, batch_size))

vector_dim = 128
vector_count = 10000

# Example generator that generates many (id, vector) pairs
example_data_generator = map(lambda i: (f'id-{i}', [random.random() for _ in range(vector_dim)]), range(vector_count))

# Upsert data with 100 vectors per upsert request
for ids_vectors_chunk in chunks(example_data_generator, batch_size=100):
index.upsert(vectors=ids_vectors_chunk) Sebbene gli LLM siano un’invenzione straordinaria, hanno un difetto importante: tendono a inventare cose. RAG può aumentarne l’utilità fornendo loro un contesto fattuale da utilizzare nel rispondere alle domande.
Una tecnica che puoi provare è il chunking per ottimizzare i flussi di lavoro RAG in termini di prestazioni e accuratezza. È una componente fondamentale nello sviluppo di sistemi RAG, ma framework come Canopy in genere astraggono questo processo così che gli utenti non debbano pensarci. Tuttavia, la dimensione dei chunk conta e dovresti tenerne conto per migliorare le prestazioni RAG – consulta questo post sul blog di Pinecone per conoscere i metodi di chunking.
Canopy di Pinecone semplifica la creazione di applicazioni RAG gestendo tutte le attività più onerose coinvolte nello sviluppo di applicazioni RAG, come la gestione della cronologia delle chat, il chunking e l’embedding dei dati testuali, l’ottimizzazione delle query, il recupero del contesto (inclusa la prompt engineering) e la generazione aumentata. Questo rende più semplice per chiunque voglia costruire e sperimentare con RAG iniziare subito.
In questo tutorial, abbiamo visto tutto ciò che ti serve per iniziare a sperimentare e creare applicazioni RAG. La promessa degli sviluppatori di Canopy è che puoi mettere in produzione un’applicazione RAG funzionante in meno di un’ora. Provala di persona.
Per continuare ad approfondire, dai un’occhiata a:
Inizia oggi il tuo percorso nell’AI!
Programma
Corso
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min




