
Last chance! 50% off DataCamp Premium
Sale ends in
Edo Liberty, AWS ve Yahoo’da eski bir araştırma direktörüdür. Bu süre zarfında, yapay zeka (AI) modellerini vektör arama ile birleştirmenin öneri sistemleri ve spam filtreleri gibi uygulamaları önemli ölçüde iyileştirmede ne kadar güçlü olduğunu kısa sürede fark etti.
Devasa ölçekte özel vektör arama sistemleri üzerine çalıştıkça, AWS ve Yahoo’daki kadar mühendislik ve veri bilimi kaynağı olmayanlar için paketlenmiş bir çözüm bulunmadığını gördü. Bunun üzerine 2019’da Pinecone’u kurdu ve vektör veritabanı doğdu.
Pinecone’un amacı, en ileri AI uygulamalarını geliştirmek ve çalıştırmak için gerekli olan kritik depolama ve getirme altyapısını sağlamaktı. Pinecone’a göre kurucu ilke, “çözümü her ölçekteki ve her seviyedeki AI uzmanlığına sahip mühendislik ekipleri için erişilebilir kılmaktı.”
Bunun sonucunda bugün Pinecone, kullanımı kolay, tamamen yönetilen bir hizmete dönüştü. Dört yıl ileri saralım: Artık geliştiricilerin üretken AI uygulamalarını zahmetsizce oluşturmasını sağlayan, Bilgi Getirmeli Üretim’i (RAG) kullanan bir çerçeve olan Pinecone Canopy var.
Bu öğreticinin geri kalanında şu konulara daha derinlemesine bakacağız:
Canopy dokümantasyonu, Canopy’yi “Pinecone vektör veritabanı üzerine kurulu, açık kaynaklı bir Bilgi Getirmeli Üretim (RAG) çerçevesi ve bağlam.” olarak tanımlar.
Not: RAG, 2020’de Meta (o zamanki adıyla Facebook) AI Research tarafından tanıtılan gelişmiş bir AI çerçevesidir. Dinamik, alana özgü veriler kullanarak modeli yeniden eğitmeye gerek kalmadan Büyük Dil Modellerinin (LLM) çıktısını optimize etmeye yardımcı olur.
Canopy, RAG uygulamaları geliştirmeyle ilgili emek yoğun işlerin tamamını üstlenir. Buna sohbet geçmişlerinin yönetimi, metin verilerinin parçalara ayrılması ve gömülmesi, sorgu optimizasyonu, bağlam getirme (istem mühendisliği dahil) ve artırılmış üretim dahildir.
Böylece geliştiriciler, Canopy ile RAG uygulamalarını hızlı ve kolay bir şekilde deneyebilir ve oluşturabilir. Kasım 2023’teki yayın blog yazısına göre, “Canopy ile üretime hazır, RAG destekli bir uygulamayı bir saatten kısa sürede çalışır hale getirebilirsiniz. Üstelik Pinecone tarafından geliştirilip desteklendiği için, tamamen yönetilen vektör veritabanımızın sunduğu aynı harika geliştirici deneyimini ve performansı elde edersiniz.”
RAG ile denemeler yapmak isteyen geliştiriciler için Canopy şu niteliklerde bir çözüm sunar:
Kullanıcılar Pinecone ile 100 bin embedding’i ücretsiz depolayabilir. Bu, yaklaşık 15 milyon kelimeye veya 30 bin sayfalık yazıya denk gelir. Ayrıca yayın blog yazısında, “Embedding modelleri ve LLM’ler için ücretsiz seçenekler yakında geliyor.” ifadesi yer alıyor.
Metin verileri JSONL, Parquet veya düz metin olarak gelebilir ve kalanını Canopy halleder. Not: PDF desteği de ileride eklenecektir. GPT-4 Turbo dahil herhangi bir OpenAI LLM’i Canopy ile uyumludur. Anyscale Endpoints gibi tanınmış açık kaynaklı modeller de dahil olmak üzere diğer LLM ve embedding modelleri için destek yakında eklenecek. Metin verilerini JSONL formatında isteyen kullanıcılar, Pinecone’un defterini kullanarak dönüştürebilir.
Pinecone’un vektör veritabanı ile desteklenen, üretime hazır GenAI uygulamaları hızlı, doğru ve güvenilir şekilde inşa edilebilir.
Canopy kütüphanesi, özgün uygulamalar oluşturmak için kullanılabilir. Kullanıcılar ayrıca Canopy’yi basit bir REST API aracılığıyla bir web hizmeti veya uygulama olarak çalıştırabilir. Mevcut OpenAI uygulamalarına da Chat Completions API’ini Canopy sunucu uç noktasıyla değiştirerek eklenebilir.
Canopy CLI, basit komutlarla metin verileriyle iletişim kurabilir. Bu, kullanıcıların RAG’i üretime geçmeden önce artırılmış sonuçları etkileşimli olarak değerlendirmek için RAG ve RAG olmayan iş akışlarını kolayca karşılaştırmasına olanak tanır.
Pinecone Canopy ile başlamak nispeten basittir. Başlamadan önce bir Standart veya Kurumsal hesap için kaydolmanız gerekir. Yeni kullanıcılara, aracı kurcalayıp alışmaları için 100$ sunucusuz kredi verilir.
Not: Kredi kartı vermek istemiyorsanız, ücretsiz pod tabanlı bir indeks oluşturabilirsiniz.
Bir hesap oluşturduktan sonra hazırsınız…
Canopy paketini şu komutla yükleyin:
pip install canopy-sdkBunu sanal bir ortamda yapmak isterseniz, paketi yüklemeden önce aşağıdaki komutu çalıştırın:
python3 -m venv canopy-env
source canopy-env/bin/activate
Bu, bir sanal ortam oluşturur ve etkinleştirir. Nasıl çalıştıkları hakkında daha fazla bilgi edinmek için Python’da Sanal Ortam öğreticimize göz atın.
Sırada ortam değişkenlerinizi ayarlamak var. Bunun için birkaç API anahtarına ihtiyacınız olacak.
PINECONE_API_KEY anahtarınızı bulmak için:
Diğer zorunlu ortam değişkenleri şunlardır:
OPENAI_API_KEY → Bu, embedding ve sohbet API’si için OpenAI hizmetlerine kimlik doğrulamada kullanılır. Buradan bulun. Not: Önceden OpenAI hizmetlerine giriş yapmanız veya kayıt olmanız gerekebilir.INDEX_NAME → Canopy’nin çalışacağı Pinecone indeksinin adıdır – bununla ilgili daha fazlası öğreticinin ilerleyen kısımlarında.CANOPY_CONFIG_FILE → Canopy sunucusu tarafından kullanılacak yapılandırma yaml dosyasının yoludur. Bu sağlanmazsa varsayılan yapılandırma kullanılır.Ortam değişkenlerinizi şu şekilde ayarlarsınız - terminalinizden aşağıdaki komutu çalıştırın:
export PINECONE_API_KEY="<PINECONE_API_KEY>"
export OPENAI_API_KEY="<OPENAI_API_KEY>"
export CANOPY_CONFIG_FILE="<CANOPY_CONFIG_FILE >"
export INDEX_NAME="<INDEX_NAME>"Buraya kadar her şeyi takip ettiyseniz, Canopy sisteminize kurulmuş olmalıdır.
Emin olmak için şu komutu çalıştırın:
canopy Şuna benzer bir çıktı görmelisiniz:
Canopy: Ready

Usage: canopy [OPTIONS] COMMAND [ARGS]...
# rest of the help message
Artık ilk Pinecone Canopy projenize başlamaya hazırsınız.
Pinecone’da vektör embedding’leri indekslerde depolanır – bu, platformdaki vektör verilerinin en üst düzey organizasyon birimidir. Özellikle indeksler vektörleri kabul eder ve depolar, içerdikleri vektörler üzerinde sorgulara hizmet verir ve içerikleri üzerinde başka vektör işlemleri gerçekleştirir.
Canopy kullanırken, Canopy ile çalışacak şekilde yapılandırılmış yeni bir Pinecone indeksi oluşturmanız gerekir. Bunu şu komutla yaparsınız:
canopy newBu komutu çalıştırdıktan sonra CLI talimatlarını izleyin.
Oluşturulan indeksin ön eki canopy--<INDEX_NAME> olacaktır.
Not: Oluşturmak istediğiniz her Canopy indeksi için bu işlemi yalnızca bir kez yapmanız yeterlidir.
İndeksinizi oluşturduktan sonra, Canopy indeksinize veri yüklemeye hazırsınız.
Verinize bağlı olarak bunu yapmanın birkaç farklı yoluna örnekler burada:
canopy upsert /path/to/data_directory
# or
canopy upsert /path/to/data_directory/file.parquet
# or
canopy upsert /path/to/data_directory/file.jsonl
# or
canopy upsert /path/to/directory_of_txt_files/
# ...
Dokümana göre, “Canopy jsonl, parquet ve csv formatlarındaki dosyaları destekler. Ek olarak, .txt formatında düz metin veri dosyaları yükleyebilirsiniz. Bu durumda, her dosya tek bir belge olarak ele alınır. Belge kimliği dosya adı, kaynak ise dosyanın tam yolu olacaktır.”
upsert komutunun kullanımına dikkat edin. upsert işlemi, bir indeks isim alanına kayıt yazmayı ifade eder. Bir kayıt kimliği zaten mevcutsa, upsert işlemi tüm kaydın üzerine yazar.
Güncelleme yapmak isterseniz, bir kaydın bir kısmını değiştirmek için update işlemini kullanın.
Canopy sunucusu işlevlerini kullanılabilir kılmak için bir REST API kullanır. Özellikle, verilerinizle sohbet etmenizi, belgeler yüklemenizi ve belirli bir sorgu için ilgili belgeleri almanızı sağlar. Herhangi bir sohbet uygulaması, sunucunun /chat.completion uç noktasına kolayca bağlanabilir.
Sunucuyu başlatmak için şunu çalıştırın:
canopy startBu size standart Uvicorn mesajını gösterecektir:
...

INFO:     Uvicorn running on http://0.0.0.0:8000 (Press CTRL+C to quit)
Bu mesajı gördüğünüzde, /chat.completion uç noktasını destekleyen herhangi bir sohbet uygulamasıyla Canopy sunucusunu kullanmaya hazırsınız demektir.
Canopy, (Canopy Sunucusu aracılığıyla) bir web hizmeti ve özel uygulamalar oluşturmak için kullanılabilecek bir kütüphane olarak paketlenmiştir. Kütüphane, ayrı ayrı veya tam bir paket olarak kullanılabilen üç bileşen ya da sınıftan oluşur. Her bileşen, RAG iş akışının farklı bir bölümünden sorumludur:
RAG iş akışı için veriler Bilgi Tabanı kullanılarak hazırlanır. Metin girişi otomatik olarak parçalara ayrılır ve metin embedding’lerine dönüştürülür; ardından Pinecone vektör veritabanına upsert edilir.
RAG’in “getirme” kısmı bağlam motoru tarafından yönetilir. Bağlam Motoru, Bilgi Tabanını kullanarak Pinecone içinden en alakalı belgeleri bulur ve bunları bir LLM isteminde kullanılmak üzere bir bağlam halinde düzenler.
Tüm RAG iş akışı Canopy Sohbet Motoru tarafından uygulanır. Önceki sohbet geçmişini anlar, çok parçalı soruları tanır, tek bir istemden birden fazla ilgili sorgu üretir ve bunları embedding’lere dönüştürür. Sonunda, Bağlam Motoru aracılığıyla LLM için üretilen bağlamı kullanarak son kullanıcıya yüksek derecede ilgili bir yanıt sunulur.
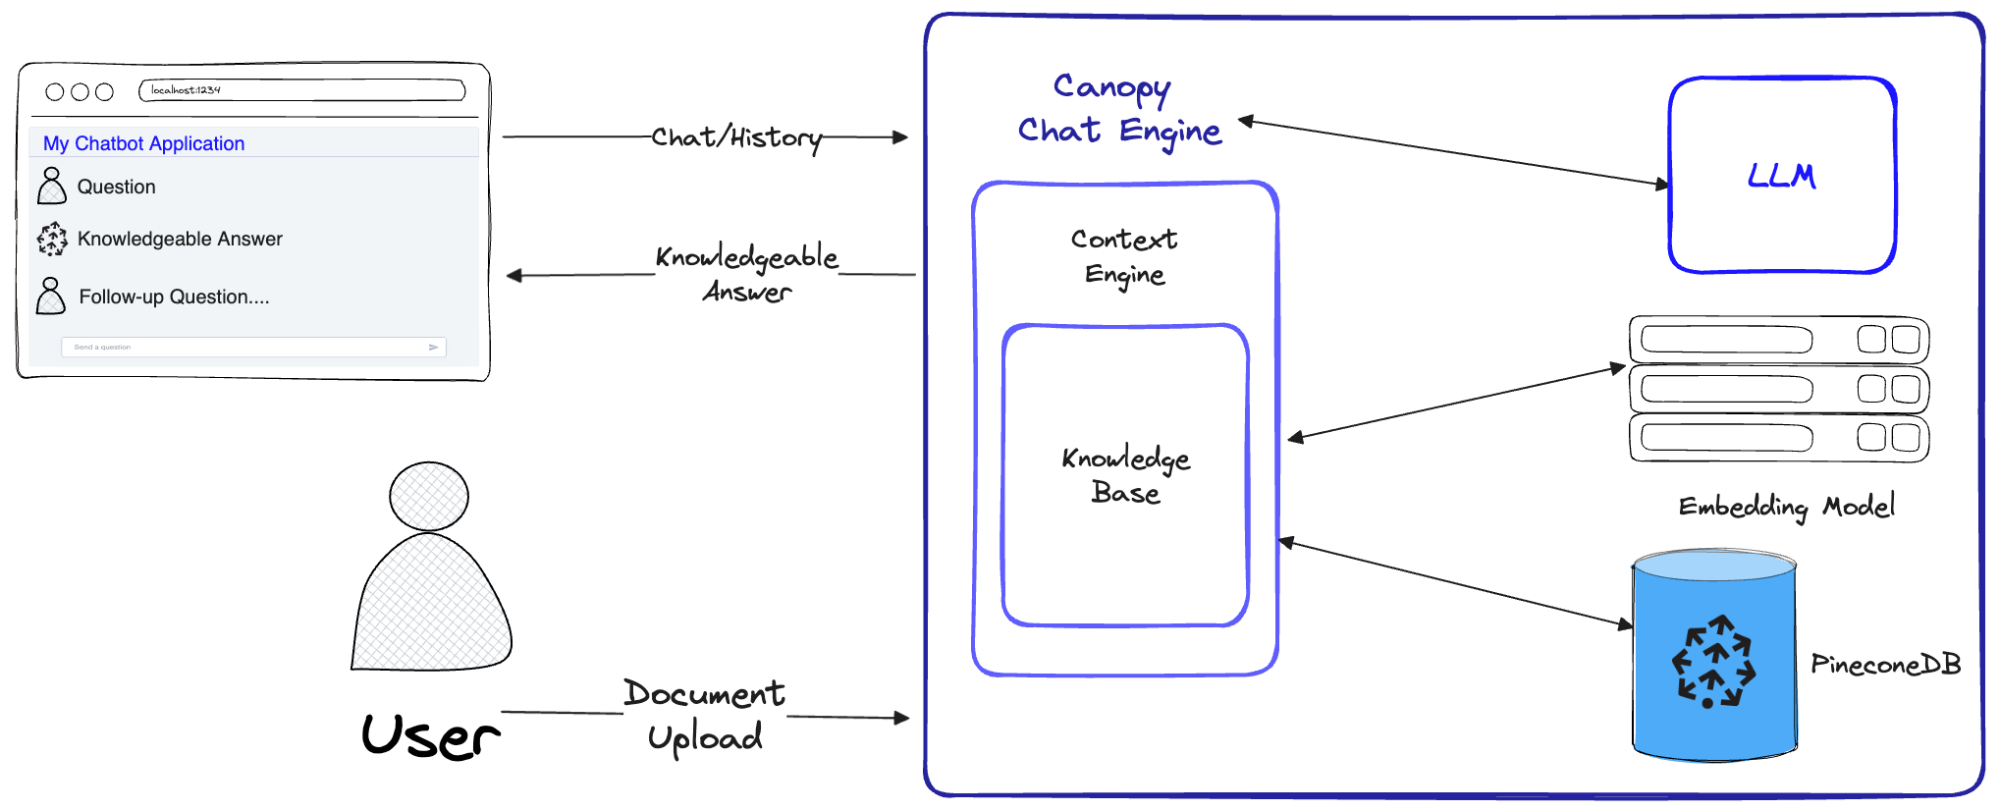
Canopy Sohbet Motoru’nun tüm RAG iş akışını nasıl uyguladığını gösteren bir diyagram. Kaynak - Introducing Canopy: An easy, free, and flexible RAG framework powered by Pinecone
Canopy kullanıcıları, indekslerini dikey veya yatay olarak ölçeklendirmek için Pinecone’dan yararlanabilir. Dikey ölçekleme (yani “scale up”), daha fazla hesaplama kaynağı sağlar; yatay ölçekleme (yani “scale out”) ise yükleri dağıtmak için kullanılabilecek daha fazla makine sağlar.
Bir diğer ileri düzey özellik, bir indeks içindeki kayıtların isim alanlarına bölümlenmesidir. Bu, sorguları ve diğer işlemleri tek bir isim alanıyla sınırlar; böylece farklı istekler indeksinizin farklı alt kümelerini arayabilir.
Örneğin, şarkıları türe göre indekslemek için bir isim alanı, çıkış yılına göre indekslemek için başka bir isim alanı tanımlamak isteyebilirsiniz. Bunu nasıl yapacağınıza dair ayrıntılı bir öğretici burada.
Son olarak, toplu upsert. Not: upsert işlemi kullanıcıların bir isim alanına kayıt yazmasına olanak tanır. Ancak daha büyük miktarda veri upsert ederken, dokümantasyon kullanıcılara “kayıtları birden fazla upsert isteği boyunca 100 veya daha azlık partiler halinde upsert edin.” talimatını verir.
İşte bir örnek:
# Source: https://docs.pinecone.io/docs/upsert-data
import random
import itertools
from pinecone import Pinecone

pc = Pinecone(api_key="YOUR_API_KEY")
index = pc.Index("pinecone-index")

def chunks(iterable, batch_size=100):
    """A helper function to break an iterable into chunks of size batch_size."""
    it = iter(iterable)
    chunk = tuple(itertools.islice(it, batch_size))
    while chunk:
        yield chunk
        chunk = tuple(itertools.islice(it, batch_size))

vector_dim = 128
vector_count = 10000

# Example generator that generates many (id, vector) pairs
example_data_generator = map(lambda i: (f'id-{i}', [random.random() for _ in range(vector_dim)]), range(vector_count))

# Upsert data with 100 vectors per upsert request
for ids_vectors_chunk in chunks(example_data_generator, batch_size=100):
index.upsert(vectors=ids_vectors_chunk) LLM’ler harika bir buluş olsalar da önemli bir kusurları var: uydurma yapabilirler. RAG, soruları yanıtlarken kullanmaları için onlara olgusal bir bağlam sağlayarak faydalarını artırmak için kullanılabilir.
Deneyebileceğiniz tekniklerden biri, performans ve doğruluk için RAG iş akışlarını optimize etmek üzere parçalara ayırmadır (chunking). Bu, RAG sistemleri geliştirmenin temel bir bileşenidir; ancak Canopy gibi çerçeveler genellikle bu süreci soyutlayarak kullanıcıların bununla uğraşmasını gerektirmez. Yine de parça boyutu önemlidir ve RAG performansınızı iyileştirmek için bunu dikkate almalısınız – yöntemleri öğrenmek için bu Pinecone blog yazısına göz atın.
Pinecone’un Canopy’si, sohbet geçmişlerini yönetme, metin verilerini parçalara ayırma ve gömme, sorgu optimizasyonu, bağlam getirme (istem mühendisliği dahil) ve artırılmış üretim gibi RAG uygulamaları geliştirmeye ilişkin emek yoğun işlerin tamamını üstlenerek RAG uygulamaları oluşturma sürecini basitleştirir. Bu da RAG inşa etmek ve denemek isteyen herkes için başlamayı kolaylaştırır.
Bu öğreticide, RAG uygulamalarında denemelere başlamak ve uygulamalar oluşturmak için bilmeniz gereken her şeyi adım adım ele aldık. Canopy geliştiricilerinin vaadi, üretime hazır RAG destekli bir uygulamayı bir saatten kısa sürede ayağa kaldırabileceğiniz yönünde. Siz de deneyin.
Öğrenmeye devam etmek için şunlara göz atın:
Yapay Zeka Yolculuğunuza Bugün Başlayın!
Program
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme




