
लर्निंग पाथ
एआई मूलभूत बातें
10 घंटा
Edo Liberty, AWS और Yahoo में पूर्व अनुसंधान निदेशक रहे हैं। इस दौरान, उन्हें जल्द ही एहसास हो गया कि कृत्रिम बुद्धिमत्ता (AI) मॉडलों को वेक्टर सर्च के साथ मिलाने से सिफारिश प्रणालियों और स्पैम डिटेक्टर जैसे अनुप्रयोगों में उल्लेखनीय सुधार किया जा सकता है।
जब उन्होंने अत्यधिक पैमाने पर कस्टम वेक्टर सर्च सिस्टम्स पर अपना काम गहराई से किया, तो उन्होंने देखा कि AWS और Yahoo जैसी इंजीनियरिंग और डेटा साइंस संसाधन जिनके पास नहीं हैं, उनके लिए कोई पैकेज्ड समाधान उपलब्ध नहीं था। इसी कारण 2019 में उन्होंने Pinecone की स्थापना की, और वेक्टर डेटाबेस अस्तित्व में आया।
Pinecone का उद्देश्य अत्याधुनिक AI अनुप्रयोगों को विकसित और चलाने के लिए आवश्यक स्टोरेज और रिट्रीवल इन्फ्रास्ट्रक्चर उपलब्ध कराना था। Pinecone के अनुसार, इसकी स्थापना का सिद्धांत था कि “समाधान को हर आकार और हर स्तर की AI विशेषज्ञता वाली इंजीनियरिंग टीमों के लिए सुलभ बनाया जाए।”
इसका नतीजा है आज का Pinecone—आसान-से-उपयोग, पूर्ण रूप से प्रबंधित सेवा। चार साल बाद, हमारे पास Pinecone Canopy है, एक फ्रेमवर्क जो Retrieval Augmented Generation (RAG) का उपयोग करके डेवलपर्स को जनरेटिव AI अनुप्रयोग सहजता से बनाने में सक्षम बनाता है।
इस ट्यूटोरियल के शेष भाग में, हम गहराई से देखेंगे:
Canopy की डॉक्यूमेंटेशन Canopy को इस प्रकार वर्णित करती है: “Pinecone वेक्टर डेटाबेस के ऊपर निर्मित एक ओपन-सोर्स Retrieval Augmented Generation (RAG) फ्रेमवर्क और संदर्भ।”
ध्यान दें, RAG एक उन्नत AI फ्रेमवर्क है जिसे 2020 में Meta (तब Facebook) AI Research ने पेश किया था। डायनेमिक, डोमेन-विशिष्ट डेटा का उपयोग करके, RAG बड़े भाषा मॉडल्स (LLMs) के आउटपुट को बिना मॉडल को पुनः प्रशिक्षित किए अनुकूलित करने में मदद करता है।
Canopy, RAG एप्लिकेशन विकसित करने में शामिल श्रम-गहन कार्यों को संभालता है। इसमें चैट हिस्ट्री प्रबंधन, टेक्स्ट डेटा का चंकिंग और एम्बेडिंग, क्वेरी अनुकूलन, संदर्भ पुनर्प्राप्ति (प्रॉम्प्ट इंजीनियरिंग सहित), और ऑगमेंटेड जेनरेशन शामिल हैं।
इस प्रकार, डेवलपर्स Canopy का उपयोग करके तेजी से और आसानी से RAG एप्लिकेशन का प्रयोग और निर्माण कर सकते हैं। नवंबर 2023 की रिलीज़ ब्लॉग पोस्ट के अनुसार, “Canopy के साथ, आप एक घंटे से भी कम समय में प्रोडक्शन-रेडी RAG-संचालित एप्लिकेशन चालू कर सकते हैं। और क्योंकि इसे Pinecone ने बनाया और सपोर्ट किया है, आपको हमारे पूर्ण रूप से प्रबंधित वेक्टर डेटाबेस वाला वही शानदार डेवलपर अनुभव और प्रदर्शन मिलता है।”
जो डेवलपर्स RAG के साथ प्रयोग करना चाहते हैं, उनके लिए Canopy एक ऐसा समाधान प्रस्तुत करता है जो है:
उपयोगकर्ता Pinecone का उपयोग करके 100k एम्बेडिंग्स तक बिना किसी शुल्क के स्टोर कर सकते हैं। यह लगभग 1.5 करोड़ शब्दों या 30 हजार पन्नों के बराबर है। इसके अलावा, रिलीज़ ब्लॉग पोस्ट में कहा गया है, “एम्बेडिंग मॉडल्स और LLMs के नि:शुल्क विकल्प जल्द ही आ रहे हैं।”
टेक्स्ट डेटा JSONL, Parquet, या सादे टेक्स्ट में आ सकता है, और बाकी काम Canopy संभाल लेगा। ध्यान दें, भविष्य में PDF के लिए भी सपोर्ट जोड़ा जाएगा। कोई भी OpenAI LLM, जिसमें GPT-4 Turbo शामिल है, Canopy के साथ संगत है। अन्य LLMs और एम्बेडिंग मॉडल्स, जैसे Anyscale Endpoints के लोकप्रिय ओपन-सोर्स मॉडल्स, का सपोर्ट भी जल्द जोड़ा जाएगा। जो उपयोगकर्ता अपना टेक्स्ट डेटा JSONL फॉर्मेट में चाहते हैं, वे Pinecone के नोटबुक का उपयोग करके इसे बदल सकते हैं।
Pinecone के वेक्टर डेटाबेस द्वारा समर्थित प्रोडक्शन-रेडी GenAI एप्लिकेशन तेज़ी से, सटीकता के साथ और भरोसेमंद तरीके से बनाए जा सकते हैं।
Canopy लाइब्रेरी का उपयोग करके आप अनूठे एप्लिकेशन बना सकते हैं। उपयोगकर्ता सरल REST API के जरिए Canopy को वेब सर्विस या एप्लिकेशन के रूप में भी चला सकते हैं। इसे मौजूदा OpenAI एप्लिकेशनों में भी जोड़ा जा सकता है, जहां Chat Completions API को Canopy के सर्वर एंडपॉइंट से बदल दें।
Canopy CLI साधारण कमांड्स के साथ टेक्स्ट डेटा से संवाद कर सकता है। यह उपयोगकर्ताओं को RAG और नॉन-RAG वर्कफ़्लोज़ की आसानी से तुलना करने में सक्षम बनाता है ताकि प्रोडक्शन में जाने से पहले इंटरेक्टिव तरीके से ऑगमेंटेड परिणामों का मूल्यांकन किया जा सके।
Pinecone Canopy के साथ शुरुआत करना अपेक्षाकृत सरल है। शुरू करने से पहले, आपको Standard या Enterprise के लिए साइन अप करना होगा। नए उपयोगकर्ताओं को टूल से परिचित होने के लिए $100 के सर्वरलेस क्रेडिट दिए जाते हैं।
ध्यान दें, यदि आप क्रेडिट कार्ड नहीं देना चाहते हैं, तो आप एक मुफ्त पॉड-आधारित इंडेक्स बना सकते हैं।
एक बार जब आप खाता पंजीकृत कर लेते हैं, तो आप शुरू करने के लिए तैयार हैं…
Canopy पैकेज इंस्टॉल करें:
pip install canopy-sdkयदि आप इसे वर्चुअल वातावरण में करना चाहते हैं, तो पैकेज इंस्टॉल करने से पहले निम्न कमांड चलाएँ:
python3 -m venv canopy-env
source canopy-env/bin/activate
यह एक वर्चुअल वातावरण बनाता है और उसे सक्रिय करता है। यह कैसे काम करते हैं, इसे समझने के लिए हमारा Virtual Environment in Python ट्यूटोरियल देखें।
अगला, आपको अपने एनवायरनमेंट वेरिएबल्स सेट करने होंगे। ऐसा करने के लिए, आपको कुछ API कुंजियों की आवश्यकता होगी।
अपना PINECONE_API_KEY खोजने के लिए, बस:
अन्य अनिवार्य एनवायरनमेंट वेरिएबल्स में शामिल हैं:
OPENAI_API_KEY → यह OpenAI की सेवाओं के लिए एम्बेडिंग और चैट API को प्रमाणित करने के लिए उपयोग होता है। इसे यहाँ पाएँ। ध्यान दें, आपको पहले OpenAI सेवाओं में लॉगिन या पंजीकरण करना पड़ सकता है।INDEX_NAME → यह उस Pinecone इंडेक्स का नाम है जिसके साथ Canopy काम करेगा—इस पर आगे ट्यूटोरियल में और जानेंगे।CANOPY_CONFIG_FILE → यह उस कॉन्फ़िगरेशन yaml फाइल का पथ है जिसका उपयोग Canopy सर्वर करेगा। यदि यह प्रदान नहीं किया गया है, तो डिफ़ॉल्ट कॉन्फ़िगरेशन का उपयोग होगा।यहाँ बताया गया है कि आप अपने एनवायरनमेंट वेरिएबल्स कैसे सेट करते हैं—अपने टर्मिनल से निम्न कमांड चलाएँ:
export PINECONE_API_KEY="<PINECONE_API_KEY>"
export OPENAI_API_KEY="<OPENAI_API_KEY>"
export CANOPY_CONFIG_FILE="<CANOPY_CONFIG_FILE >"
export INDEX_NAME="<INDEX_NAME>"यदि आपने इस चरण तक सब कुछ फॉलो किया है, तो Canopy आपके सिस्टम पर इंस्टॉल होना चाहिए।
पक्का करने के लिए, निम्न कमांड चलाएँ:
canopy इसका आउटपुट कुछ ऐसा होना चाहिए:
Canopy: Ready

Usage: canopy [OPTIONS] COMMAND [ARGS]...
# rest of the help message
अब आप अपने पहले Pinecone Canopy प्रोजेक्ट पर काम शुरू करने के लिए तैयार हैं।
Pinecone में, वेक्टर एम्बेडिंग्स इंडेक्स में स्टोर की जाती हैं—यह प्लेटफ़ॉर्म में वेक्टर डेटा की सर्वोच्च संगठनात्मक इकाई है। विशेष रूप से, ये वेक्टर स्वीकार और स्टोर करते हैं, उनमें शामिल वेक्टरों पर क्वेरी सर्व करते हैं, और उनकी सामग्रियों पर अन्य वेक्टर ऑपरेशन्स करते हैं।
Canopy का उपयोग करते समय, आपको Canopy के साथ काम करने के लिए कॉन्फ़िगर किया हुआ नया Pinecone इंडेक्स सेट करना होगा। आप यह चलाकर करते हैं:
canopy newउस कमांड को चलाने के बाद, CLI निर्देशों का पालन करें।
बनाया गया इंडेक्स canopy--<INDEX_NAME> प्रीफ़िक्स के साथ होगा।
ध्यान दें, जिस भी Canopy इंडेक्स को आप बनाना चाहते हैं, उसके लिए यह प्रक्रिया आपको केवल एक बार करनी होती है।
एक बार जब आपने अपना इंडेक्स बना लिया, तो आप अपने Canopy इंडेक्स में डेटा लोड करने के लिए तैयार हैं।
आपके डेटा के आधार पर, इसे करने के कुछ उदाहरण इस प्रकार हैं:
canopy upsert /path/to/data_directory
# or
canopy upsert /path/to/data_directory/file.parquet
# or
canopy upsert /path/to/data_directory/file.jsonl
# or
canopy upsert /path/to/directory_of_txt_files/
# ...
डॉक्यूमेंटेशन के अनुसार, “Canopy jsonl, parquet और csv फॉर्मैट में फाइलों का समर्थन करता है। इसके अतिरिक्त, आप .txt फॉर्मैट में प्लेनटेक्स्ट डेटा फाइलें भी लोड कर सकते हैं। इस स्थिति में, प्रत्येक फाइल को एक एकल दस्तावेज़ के रूप में माना जाएगा। दस्तावेज़ आईडी फाइलनेम होगा, और सोर्स फाइल का पूरा पाथ होगा।”
ध्यान दें कि यहाँ upsert कमांड का उपयोग किया गया है। upsert ऑपरेशन बस रिकॉर्ड्स को किसी इंडेक्स नेमस्पेस में लिखता है। यदि कोई रिकॉर्ड आईडी पहले से मौजूद है, तो upsert ऑपरेशन पूरे रिकॉर्ड को ओवरराइट कर देगा।
यदि आप अपडेट करना चाहते हैं, तो किसी रिकॉर्ड के हिस्से को बदलने के लिए update ऑपरेशन का उपयोग करें।
Canopy सर्वर अपनी क्षमताएँ उपलब्ध कराने के लिए REST API का उपयोग करता है। विशेष रूप से, यह आपको अपने डेटा से बातचीत करने, दस्तावेज़ अपलोड करने और किसी विशिष्ट क्वेरी के लिए प्रासंगिक दस्तावेज़ प्राप्त करने में सक्षम बनाता है। किसी भी चैट एप्लिकेशन को सर्वर के /chat.completion एंडपॉइंट के साथ आसानी से जोड़ा जा सकता है।
सर्वर लॉन्च करने के लिए चलाएँ:
canopy startयह आपको मानक Uvicorn संदेश दिखाएगा:
...

INFO:     Uvicorn running on http://0.0.0.0:8000 (Press CTRL+C to quit)
यह संदेश मिलते ही, आप किसी भी ऐसे चैट एप्लिकेशन के साथ Canopy सर्वर का उपयोग शुरू करने के लिए तैयार हैं जो /chat.completion एंडपॉइंट को सपोर्ट करता है।
Canopy वेब सर्विस (Canopy Server के माध्यम से) और एक लाइब्रेरी के रूप में पैकेज होकर आता है, जिसका उपयोग कस्टम एप्लिकेशन बनाने में किया जा सकता है। लाइब्रेरी में तीन कॉम्पोनेन्ट्स, या क्लासेस, होती हैं जिन्हें अलग-अलग या एक पूर्ण पैकेज के रूप में उपयोग किया जा सकता है। प्रत्येक कॉम्पोनेन्ट RAG वर्कफ़्लो के अलग-अलग हिस्से के लिए ज़िम्मेदार है:
RAG वर्कफ़्लो के लिए डेटा नॉलेज बेस का उपयोग करके तैयार किया जाता है। टेक्स्ट इनपुट अपने आप चंक किया जाता है और टेक्स्ट एम्बेडिंग्स में बदला जाता है, इसके बाद उन्हें Pinecone वेक्टर डेटाबेस में अपसर्ट किया जाता है।
RAG के “retrieval” हिस्से को कॉन्टेक्स्ट इंजन संभालता है। नॉलेज बेस का उपयोग करके, कॉन्टेक्स्ट इंजन Pinecone से सबसे प्रासंगिक दस्तावेज़ ढूँढता है और उन्हें LLM प्रॉम्प्ट के रूप में उपयोग के लिए एक संदर्भ में व्यवस्थित करता है।
पूरे RAG वर्कफ़्लो को Canopy चैट इंजन द्वारा लागू किया जाता है। यह पिछली चैट हिस्ट्री को समझता है, बहु-भाग वाले प्रश्नों को पहचानता है, एक ही प्रॉम्प्ट से कई प्रासंगिक क्वेरीज़ बनाता है, और उन्हें एम्बेडिंग्स में बदलता है। अंत में, कॉन्टेक्स्ट इंजन के माध्यम से LLM के लिए तैयार किए गए संदर्भ का उपयोग करके अंतिम उपयोगकर्ता को अत्यंत प्रासंगिक उत्तर प्रस्तुत किया जाता है।
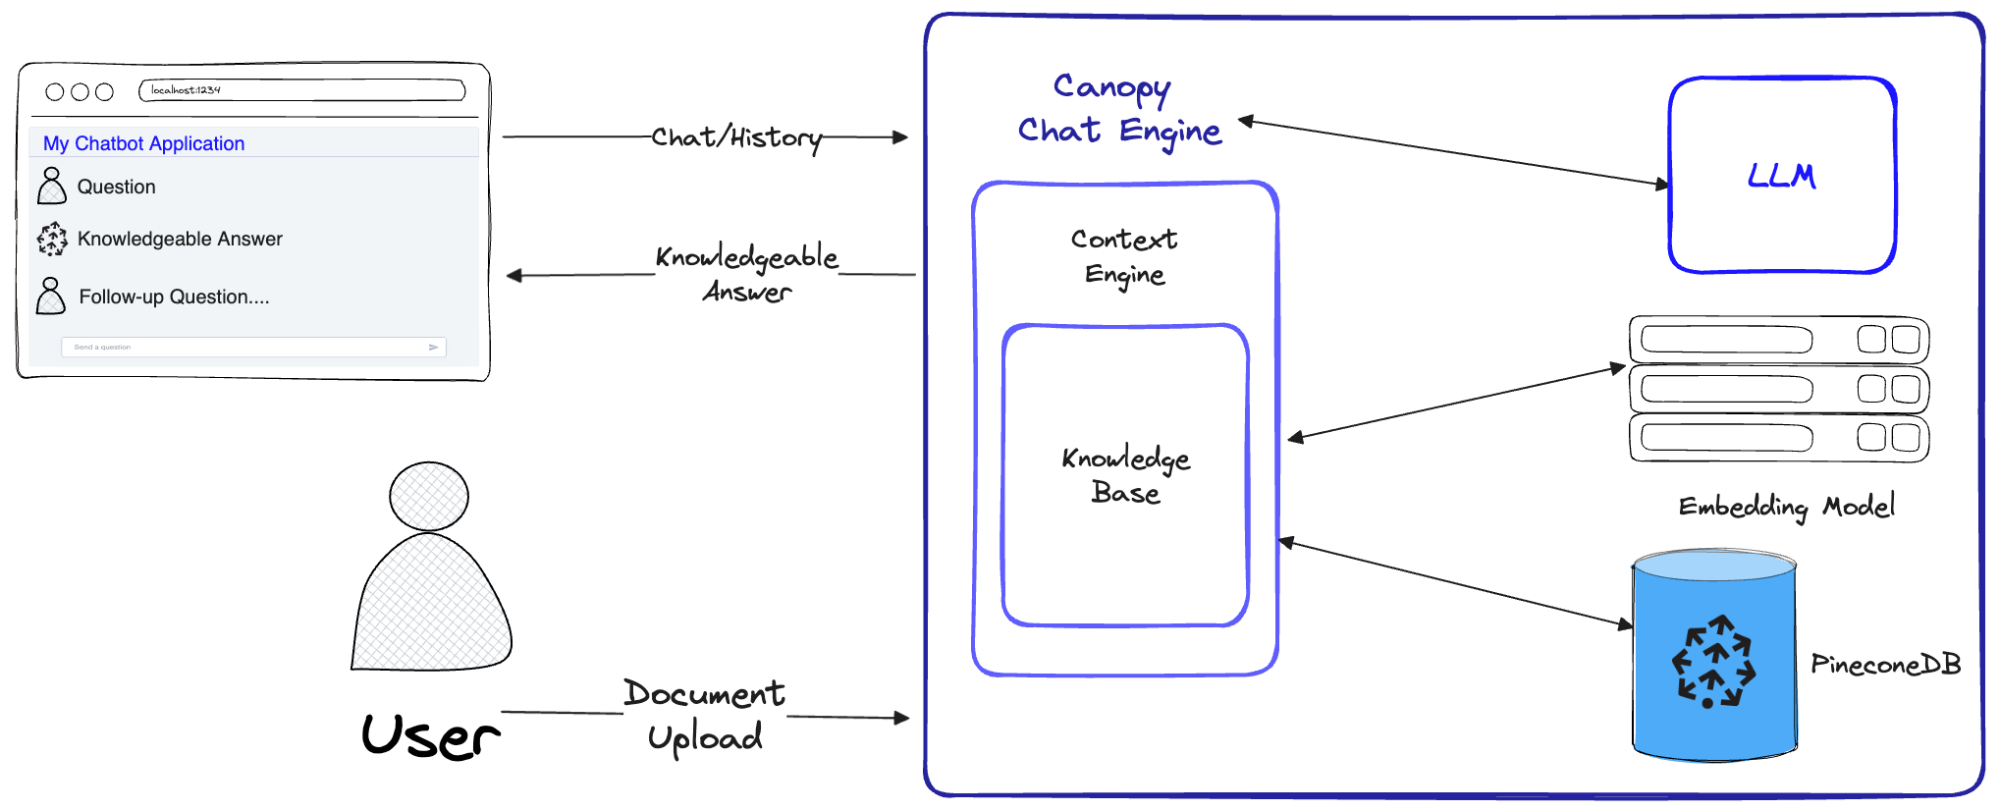
एक आरेख जो दर्शाता है कि Canopy चैट इंजन पूरे RAG वर्कफ़्लो को कैसे लागू करता है। स्रोत - Introducing Canopy: An easy, free, and flexible RAG framework powered by Pinecone
Canopy के उपयोगकर्ता अपने इंडेक्स को वर्टिकल या हॉरिजॉन्टल तरीके से स्केल करने के लिए Pinecone का लाभ उठा सकते हैं। वर्टिकल स्केलिंग (यानी स्केल अप) अधिक कम्प्यूट संसाधन उपलब्ध कराती है, और हॉरिजॉन्टल स्केलिंग (यानी स्केल आउट) अधिक मशीनें उपलब्ध कराती है जिनका उपयोग लोड वितरित करने के लिए किया जा सकता है।
एक और उन्नत सुविधा है, किसी इंडेक्स में रिकॉर्ड्स को नेमस्पेसेज़ में विभाजित करना। यह क्वेरीज़ और अन्य ऑपरेशन्स को एक नेमस्पेस तक सीमित करता है, जिससे अलग-अलग अनुरोध आपके इंडेक्स के अलग-अलग सबसेट्स में खोज कर सकते हैं।
उदाहरण के लिए, आप गीतों को शैली के अनुसार इंडेक्स करने के लिए एक नेमस्पेस और रिलीज़ वर्ष के अनुसार इंडेक्स करने के लिए दूसरा नेमस्पेस परिभाषित करना चाह सकते हैं। इसे कैसे करें इस पर एक विस्तृत ट्यूटोरियल यहाँ है।
अंत में, आपके पास बैच अपसर्ट है। ध्यान दें, upsert ऑपरेशन उपयोगकर्ताओं को किसी नेमस्पेस में रिकॉर्ड लिखने में सक्षम बनाता है। हालाँकि, जब आप बड़े पैमाने पर डेटा अपसर्ट कर रहे हों, तो डॉक्यूमेंटेशन उपयोगकर्ताओं को निर्देश देता है कि “कई upsert अनुरोधों में हर बार 100 या कम रिकॉर्ड्स के बैचों में upsert करें।”
यहाँ एक उदाहरण है:
# Source: https://docs.pinecone.io/docs/upsert-data
import random
import itertools
from pinecone import Pinecone

pc = Pinecone(api_key="YOUR_API_KEY")
index = pc.Index("pinecone-index")

def chunks(iterable, batch_size=100):
    """A helper function to break an iterable into chunks of size batch_size."""
    it = iter(iterable)
    chunk = tuple(itertools.islice(it, batch_size))
    while chunk:
        yield chunk
        chunk = tuple(itertools.islice(it, batch_size))

vector_dim = 128
vector_count = 10000

# Example generator that generates many (id, vector) pairs
example_data_generator = map(lambda i: (f'id-{i}', [random.random() for _ in range(vector_dim)]), range(vector_count))

# Upsert data with 100 vectors per upsert request
for ids_vectors_chunk in chunks(example_data_generator, batch_size=100):
index.upsert(vectors=ids_vectors_chunk) यद्यपि LLMs एक बेहतरीन आविष्कार हैं, उनमें एक बड़ी खामी है: वे बातें गढ़ते हैं। RAG का उपयोग उन्हें तथ्यात्मक संदर्भ प्रदान करके उनकी उपयोगिता बढ़ाने में किया जा सकता है ताकि वे प्रश्नों का उत्तर देते समय उसका उपयोग करें।
आप एक तकनीक आज़मा सकते हैं—प्रदर्शन और सटीकता के लिए RAG वर्कफ़्लोज़ को अनुकूलित करने हेतु चंकिंग। यह RAG सिस्टम विकसित करते समय एक मूलभूत घटक है, लेकिन Canopy जैसे फ्रेमवर्क आमतौर पर इस प्रक्रिया को एब्स्ट्रैक्ट कर देते हैं ताकि उपयोगकर्ताओं को इसके बारे में सोचना न पड़े। फिर भी, चंक आकार मायने रखता है, और आपको अपने RAG प्रदर्शन में सुधार के लिए इसे ध्यान में रखना चाहिए—चंकिंग विधियों को सीखने के लिए यह Pinecone ब्लॉग पोस्ट देखें।
Pinecone का Canopy, RAG एप्लिकेशन बनाने की प्रक्रिया को सरल बना देता है, क्योंकि यह RAG एप्लिकेशन विकसित करने में शामिल सभी श्रम-गहन कार्यों—जैसे चैट हिस्ट्री प्रबंधन, टेक्स्ट डेटा का चंकिंग और एम्बेडिंग, क्वेरी अनुकूलन, संदर्भ पुनर्प्राप्ति (प्रॉम्प्ट इंजीनियरिंग सहित), और ऑगमेंटेड जेनरेशन—को संभालता है। इससे RAG बनाने और प्रयोग करने के इच्छुक किसी भी व्यक्ति के लिए शुरुआत करना आसान हो जाता है।
इस ट्यूटोरियल में, हमने वह सब कवर किया जो आपको RAG एप्लिकेशन के साथ प्रयोग शुरू करने और उन्हें बनाने के लिए जानना चाहिए। Canopy के डेवलपर्स का वादा है कि आप एक घंटे से भी कम समय में प्रोडक्शन-रेडी RAG-संचालित एप्लिकेशन चालू कर सकते हैं। स्वयं आज़माएँ।
आगे सीखने के लिए देखें:
आज ही अपनी AI यात्रा शुरू करें!
लर्निंग पाथ
कोर्स