
Kursus
Konsep Large Language Models (LLM)
2 jam
112.1K
Tren besar dalam machine learning adalah memindahkan data ke lingkungan model untuk pelatihan. Namun bagaimana jika kita membalik proses tersebut? Karena basis data saat ini berukuran jauh lebih besar daripada model machine learning, bukankah akan jauh lebih mudah jika kita membawa model ke dataset?
Itulah ide inti di balik PostgresML — data tetap di tempatnya, Anda membawa kode ke basis data. Pendekatan machine learning dengan logika terbalik ini menghadirkan banyak manfaat nyata yang akan membuat Anda meninjau ulang konsep “basis data.”
PostgresML adalah platform machine learning komprehensif yang dibangun di atas basis data PostgreSQL yang populer. Ia memperkenalkan paradigma baru bernama machine learning “di dalam basis data”, memungkinkan Anda menjalankan banyak tugas ML dalam SQL tanpa perlu alat terpisah di setiap langkah.
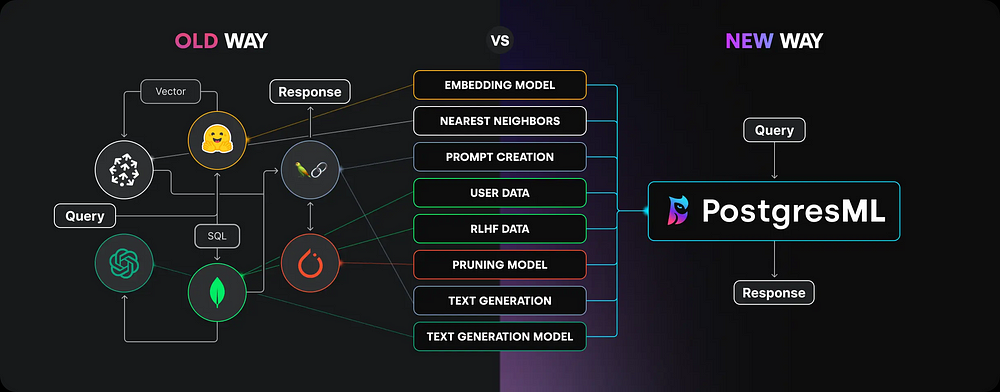
Meski relatif baru, PostgresML menjanjikan manfaat-manfaat berikut:
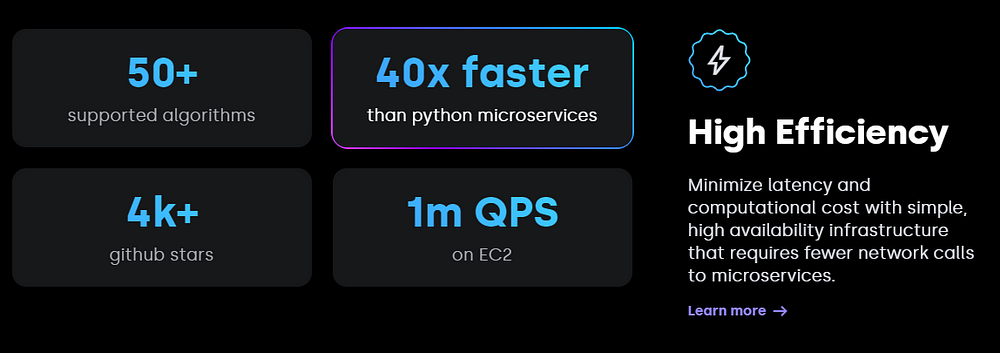
Kita akan mencoba semua fitur ini dalam tutorial dengan mengikuti alur kerja machine learning yang umum:
…semuanya di dalam basis data Postgres. Mari mulai!
Pertama, buat akun gratis di https://postgresml.org/signup:
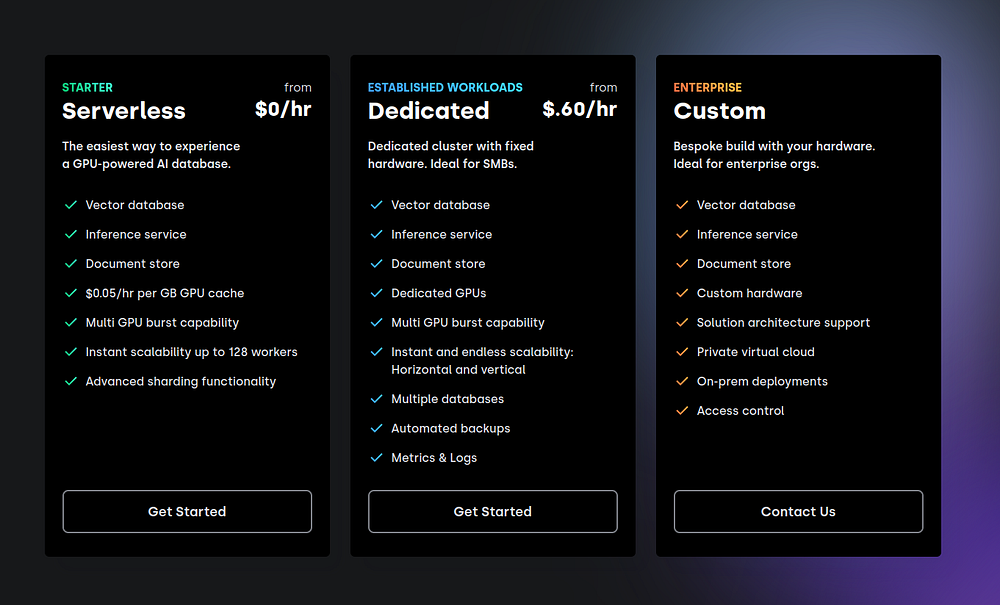
Lalu, pilih paket gratis yang memberikan sumber daya cukup besar:
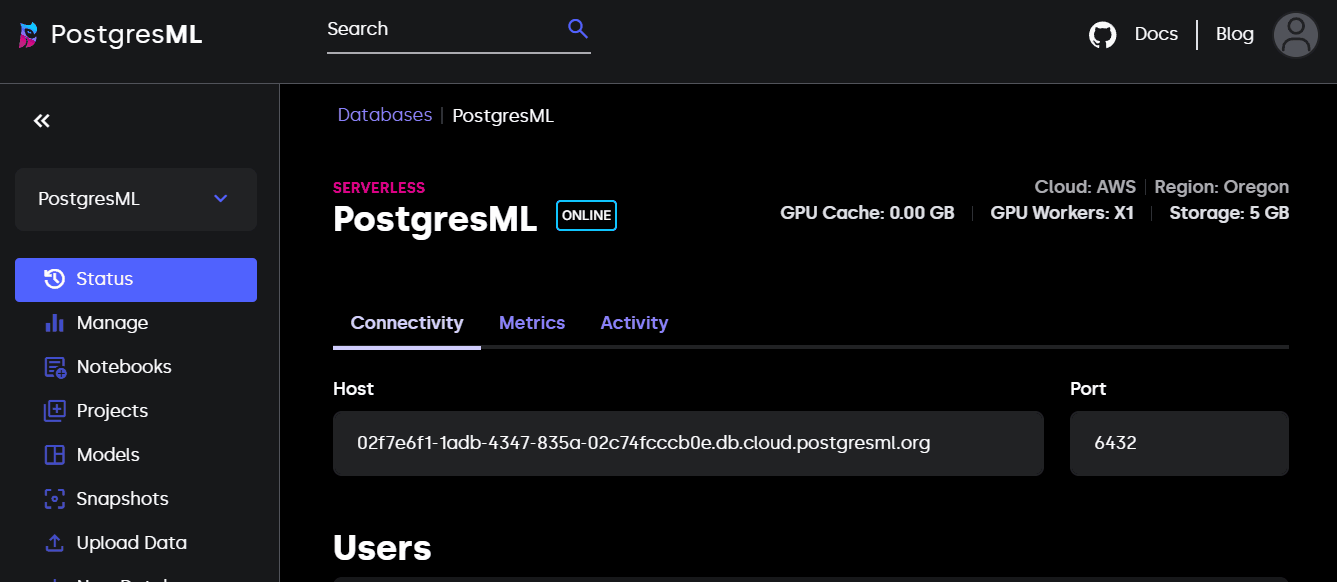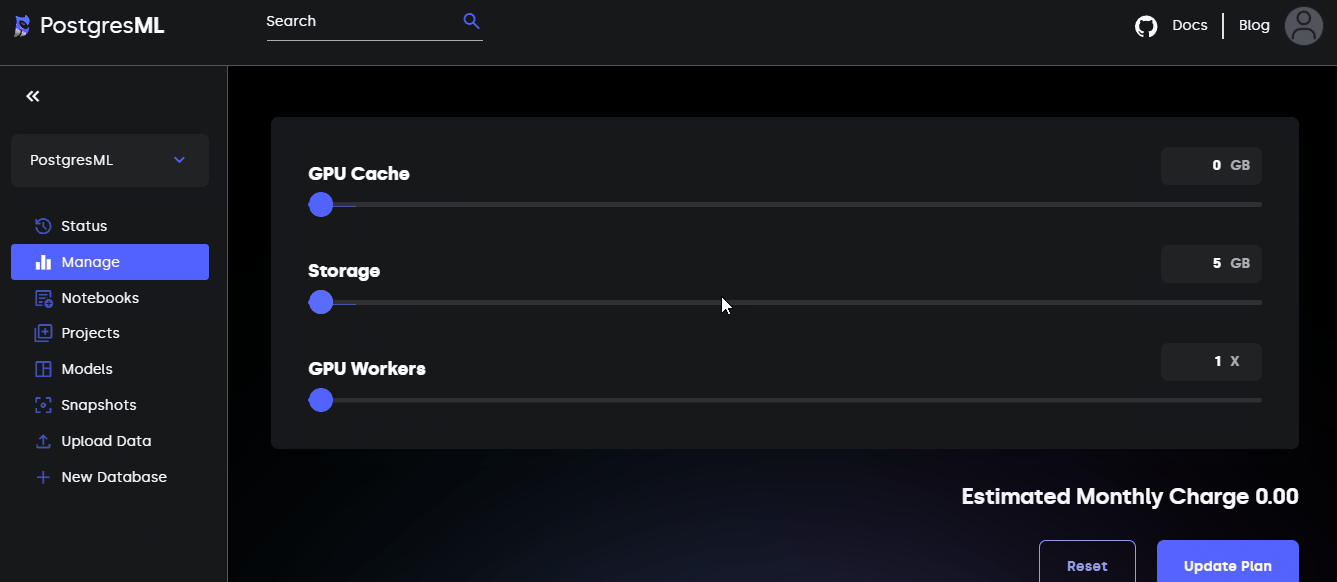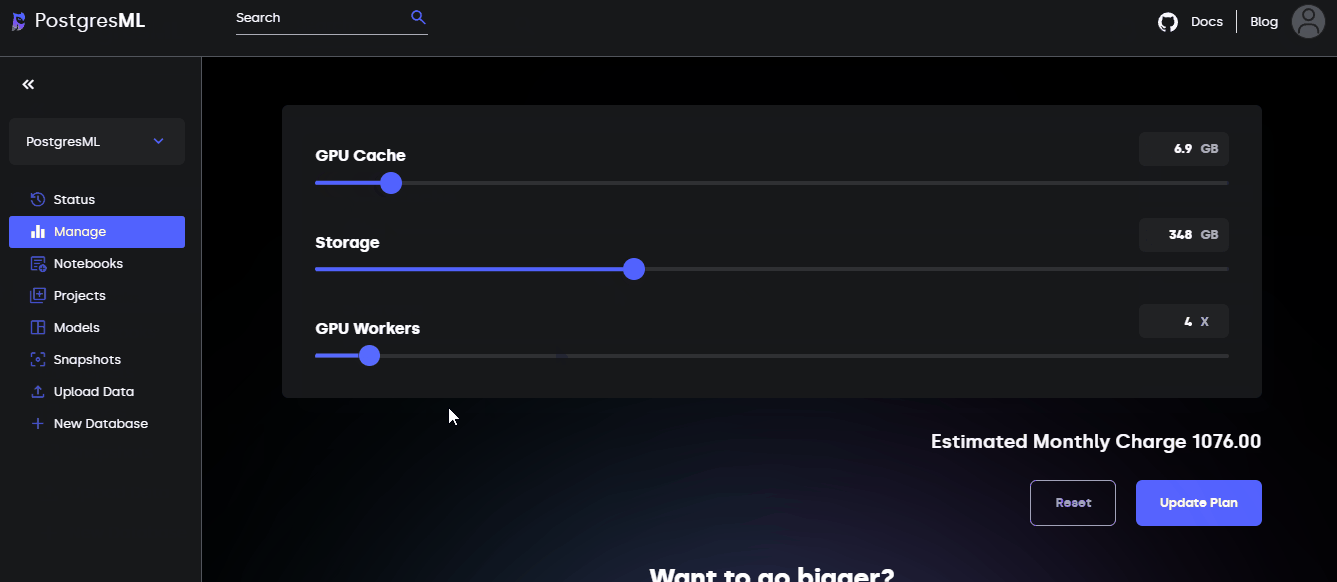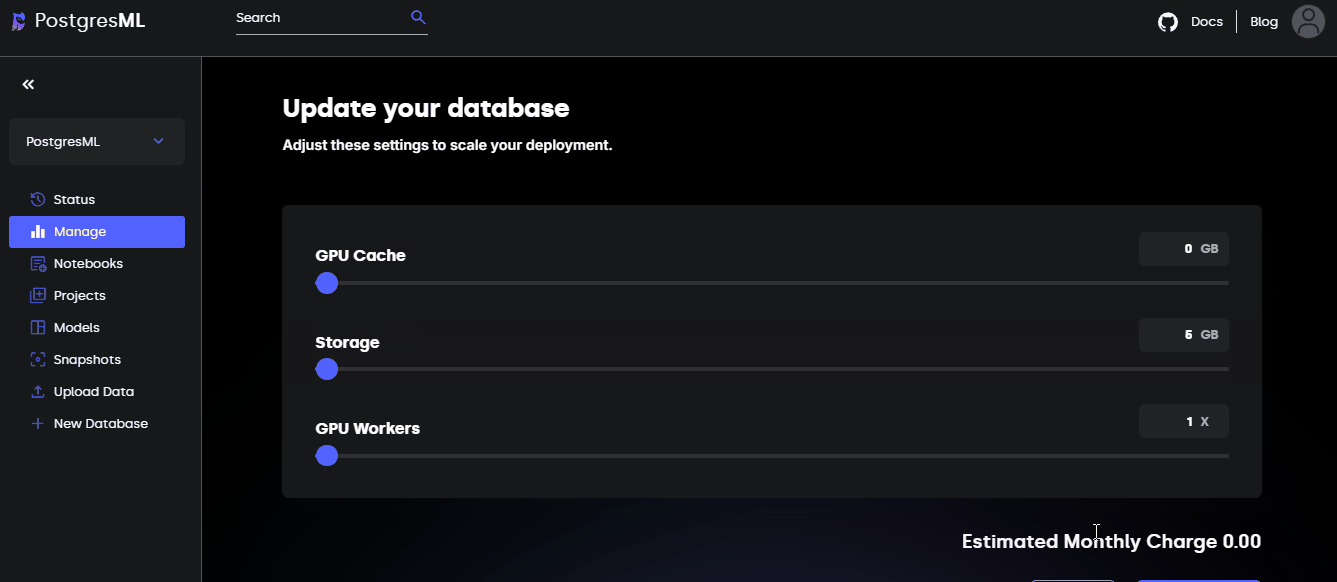
Setelah mendaftar, Anda akan tiba di konsol PostgresML. Di sinilah Anda mengelola berbagai proyek “ML di dalam basis data” dan sumber daya terkaitnya.
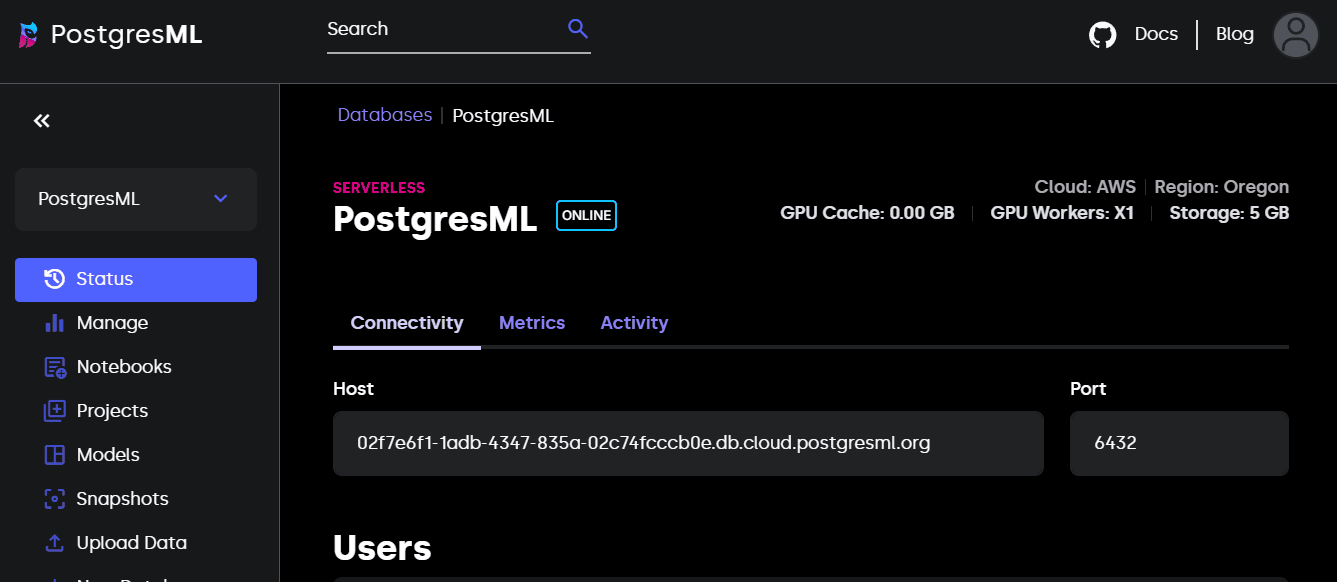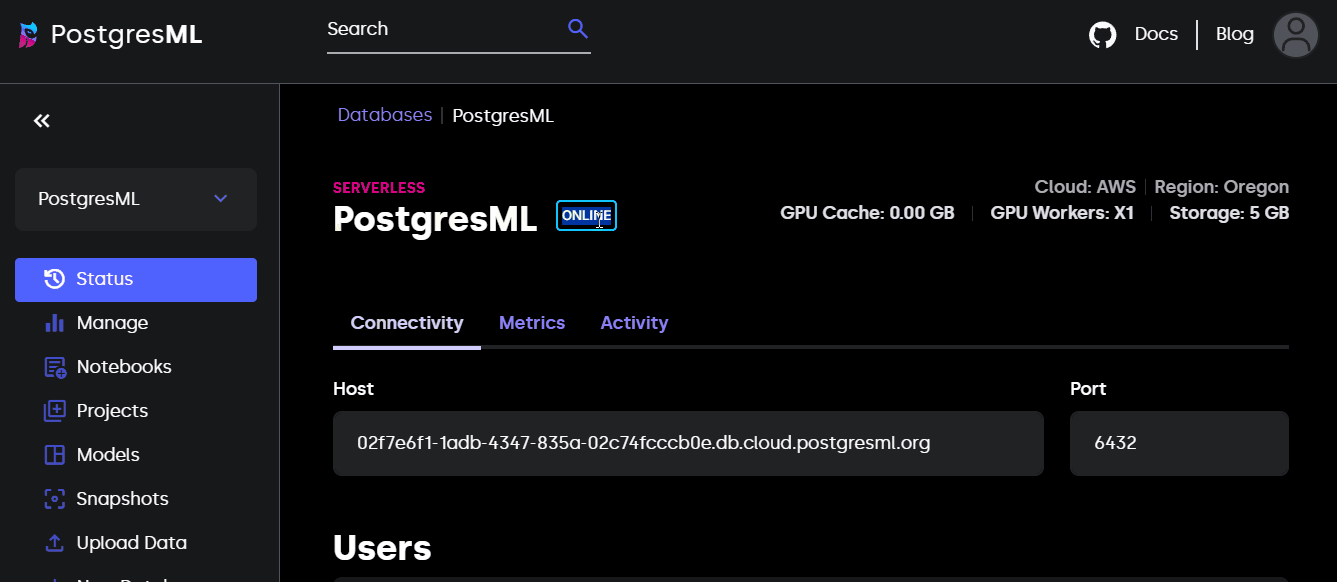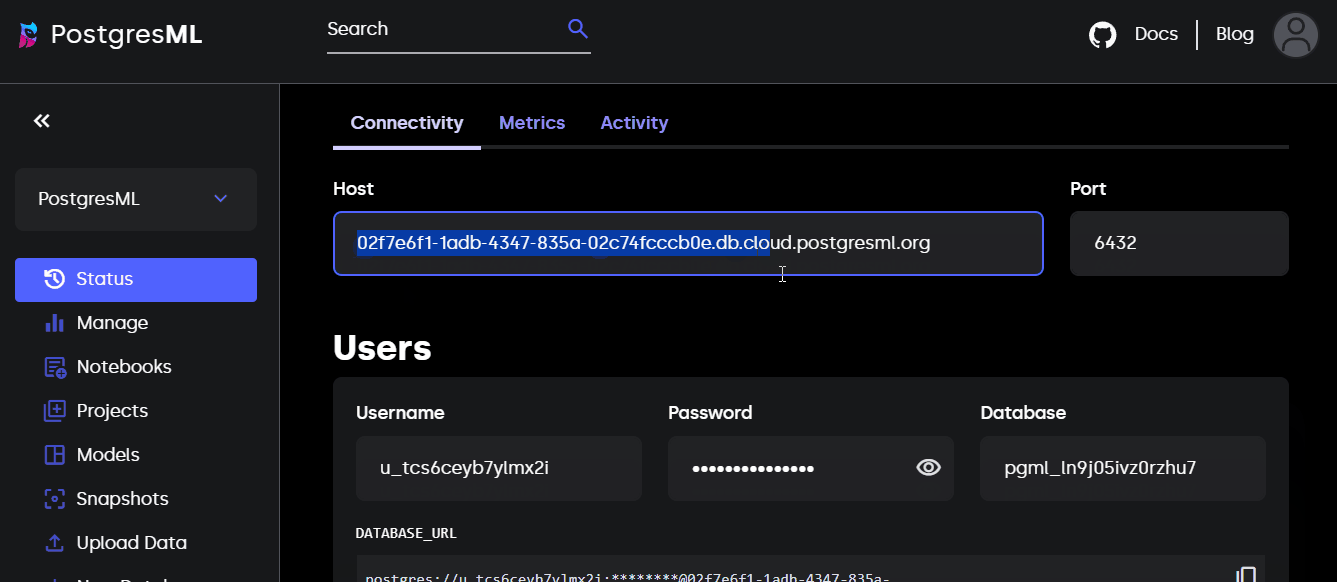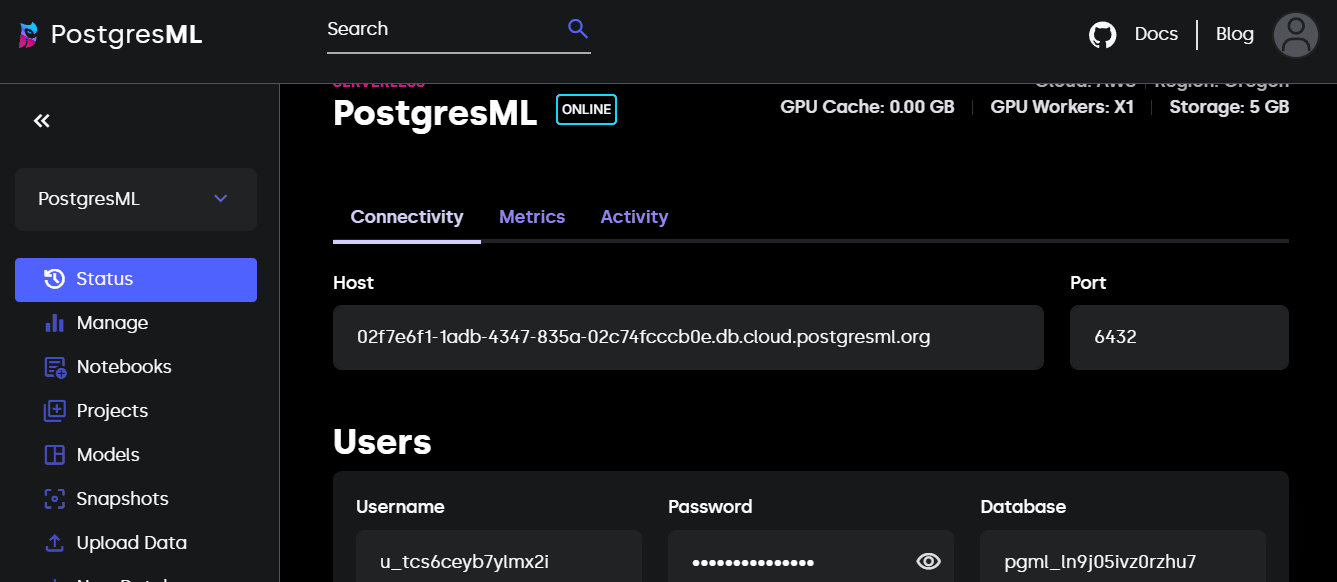
Jika Anda masuk ke bagian “Manage”, Anda dapat menskalakan lingkungan sesuai kebutuhan komputasi Anda:
Sesuai namanya, kita memerlukan PostgreSQL terpasang di sistem untuk menggunakan PostgresML. Jika Anda tidak tahu apa itu Postgres, ini adalah basis data open-source paling canggih di dunia (begitu klaim di situsnya).
Berikut tautan panduan instalasi PostgreSQL khusus platform:
Saya menggunakan WSL2, jadi saya bisa menjalankan:
$ sudo apt update
$ sudo apt install postgresql postgresql-contrib
$ sudo passwd postgres  # Set a new Postgres password
# Close and reopen your terminal and done!
Setelah itu, verifikasi instalasi dengan:
$ psql --version
psql (PostgreSQL) 12.18 (Ubuntu 12.18-0ubuntu0.20.04.1)
psql adalah klien resmi Postgres untuk terhubung dan mengelola basis data di terminal.
Saya paham bagi banyak orang tidak ideal menjalankan SQL di terminal yang kurang menarik, jadi Anda juga dapat memasang ekstensi VSCode berikut setelah memasang Postgres:
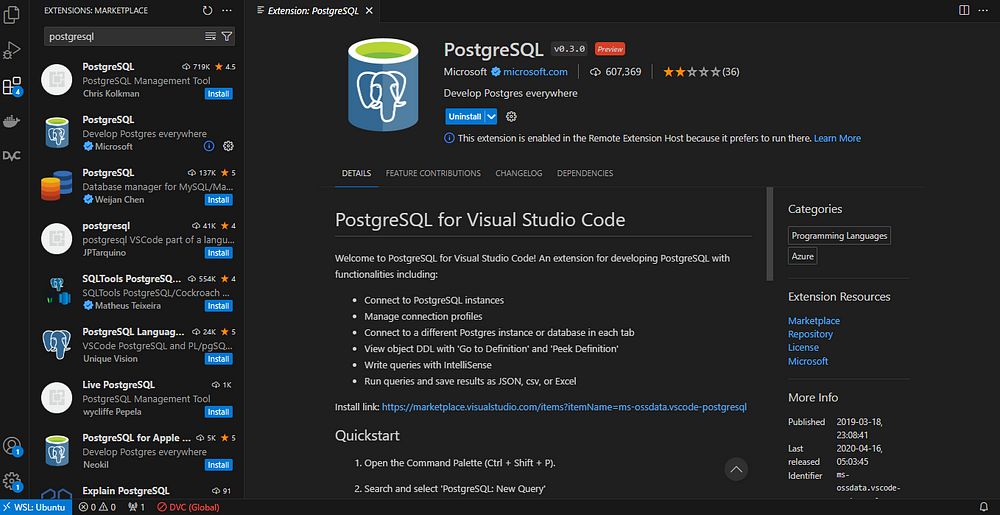
Ingat halaman awal konsol PostgresML Anda? Biarkan tetap terbuka di tab terpisah:
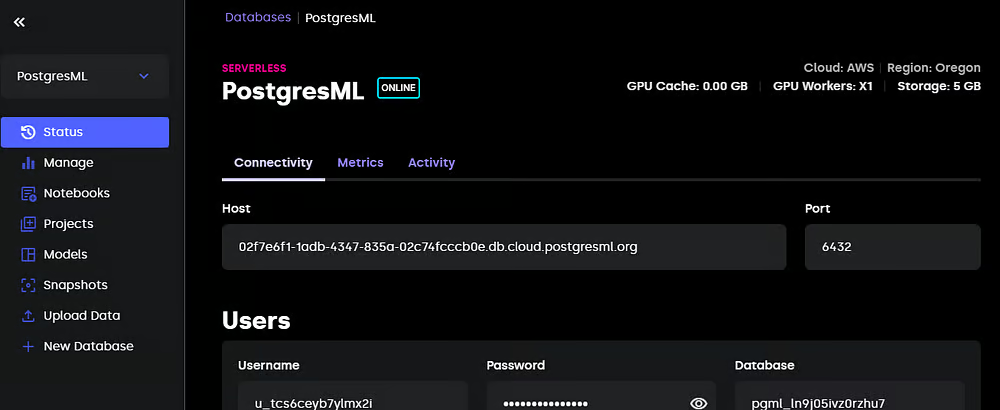
Sekarang, menggunakan psql, Anda dapat mengetik perintah berikut dengan kredensial Anda sendiri untuk menjalin koneksi dengan server PostgresML:
$ psql -h "host" \
      -U "username" \
      -p 6432 \
      -d "database_name"
Jika Anda menggunakan ekstensi VSCode, ikuti langkah-langkah berikut (diambil dari halaman instalasi ekstensi) untuk melakukan hal yang sama:
Dan Anda akan terhubung ke basis data PostgresML Anda.
Langkah berikutnya adalah membuat ekstensi pgml yang memungkinkan kita menjalankan fungsi PostgresML:
CREATE EXTENSION IF NOT EXISTS pgml;

NOTICE:  extension "pgml" already exists, skipping
CREATE EXTENSION
-- Your output may be different.
Periksa apakah semuanya berhasil dengan mencetak versi pgml:
SELECT pgml.version();

2.8.2 (98f114891db58acd472e068c44272b198274b11d)
Sekarang, mari memuat beberapa data ke dalam basis data kita. Untuk menyederhanakan, kita hanya akan membuat satu tabel menggunakan dataset Diamonds dari Kaggle. Anda dapat mengunduhnya sebagai file CSV dari situs atau menggunakan snippet Python di bawah ini:
import seaborn as sns

diamonds = sns.load_dataset("diamonds")
diamonds.to_csv("diamonds.csv", index=False)
Lalu, jalankan perintah CREATE berikut dengan skema yang benar:
CREATE TABLE IF NOT EXISTS diamonds (
   index SERIAL PRIMARY KEY,
   carat FLOAT,
   cut VARCHAR(255),
   color VARCHAR(255),
   clarity VARCHAR(255),
   depth FLOAT,
   table_ FLOAT,
   price INT,
   x FLOAT,
   y FLOAT,
   z FLOAT
)
Perintah tersebut akan membuat tabel bernama diamonds yang dapat kita isi dengan baris-baris dari file CSV:
INSERT INTO diamonds
   (carat, cut, color, clarity, depth, table_, price, x, y, z)
   FROM '~/full/path/to/diamonds.csv'
   DELIMITER ','
   CSV HEADER;
Terakhir, kita cetak bagian atas tabel sebagai konfirmasi bahwa perintah terakhir berhasil dijalankan:
SELECT * FROM diamonds
LIMIT 10;
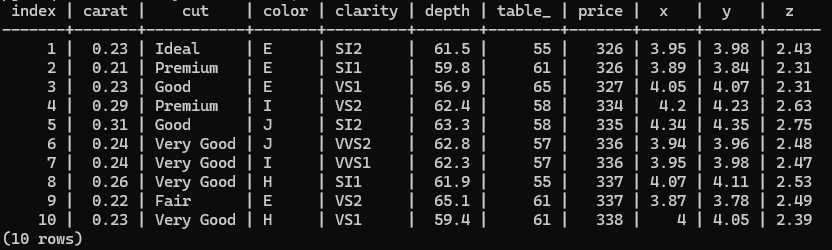
Sekarang, kita siap melatih model!
Melatih model machine learning untuk pembelajaran terawasi dilakukan menggunakan fungsi pgml.train. Berikut struktur dasarnya:
SELECT pgml.train(
 project_name => 'Diamond prices prediction',
 task => 'regression',
 relation_name => 'diamonds',
 y_column_name => 'price',
 algorithm => 'xgboost'
);
Pernyataan SQL di atas memasangkan regresor XGBoost ke tabel diamonds untuk memprediksi harga berlian. Satu hal yang akan Anda perhatikan saat menjalankan perintah ini adalah kecepatannya (hampir seketika) meski kita memiliki lebih dari 50 ribu baris.
Anda juga bisa dengan mudah mengganti tugas. Berikut cara memasangkan pengklasifikasi multi-kelas (jangan lupa ganti nama proyek):
SELECT pgml.train(
 project_name => 'Diamond cut quality prediction',
 task => 'classification',
 relation_name => 'diamonds',
 y_column_name => 'cut',
 algorithm => 'xgboost',
 test_size => 0.1
);
Perhatikan bagaimana kali ini kita menentukan argumen test_size - pembagian khusus juga didukung!
Kita juga mengubah algoritma default linear menjadi xgboost namun bisa saja menggunakan model lain dari Scikit-learn atau kerangka kerja yang didukung.
Mari coba memasangkan model random forest kali ini:
…
Tapi tunggu! Dataset diamonds memiliki fitur teks yang perlu dikodekan. Karena XGBoost secara native mengodekan kategorikal, kita tidak menerima error dari kueri sebelumnya. Hal ini mungkin tidak berlaku untuk random forest. Jadi, mari tambahkan beberapa langkah prapemrosesan ke kueri kita:
SELECT pgml.train(
   project_name => 'Diamond prices prediction',
   task => 'regression',
   relation_name => 'diamonds',
   y_column_name => 'price',
   algorithm => 'random_forest',
   preprocess => '{
       "carat": {"scale": "standard"},
       "depth": {"scale": "standard"},
       "table_": {"scale": "standard"},
       "cut": {"encode": "target", "scale": "standard"},
       "color": {"encode": "target", "scale": "standard"},
       "clarity": {"encode": "target", "scale": "standard"}
   }'::JSONB
);
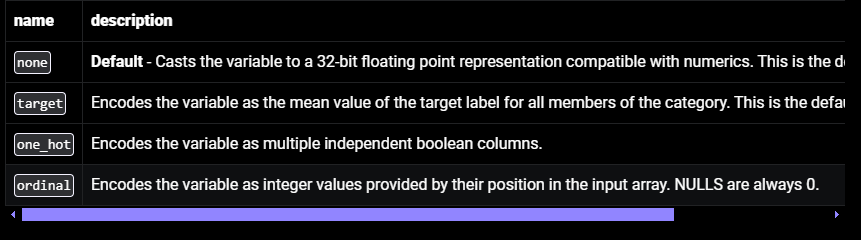
Logika prapemrosesan didefinisikan di dalam objek JSONB yang memetakan kolom ke langkah transformasi. Untuk fitur numerik, kita menggunakan standardisasi (meski standardisasi tidak wajib untuk RF). Untuk kolom kategorikal, kita menggunakan target encoding lalu standardisasi.
PostgresML juga menawarkan fungsi prapemrosesan alternatif lainnya. Berikut daftar lengkap opsi pengodean yang tersedia:
pgml juga mendukung teknik imputasi standar:
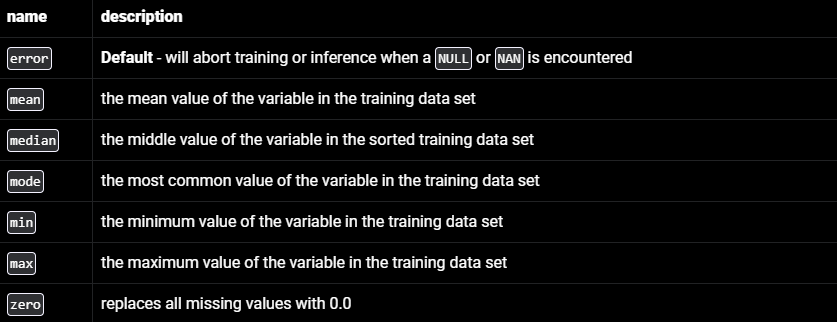
Dan berikut daftar skaler:
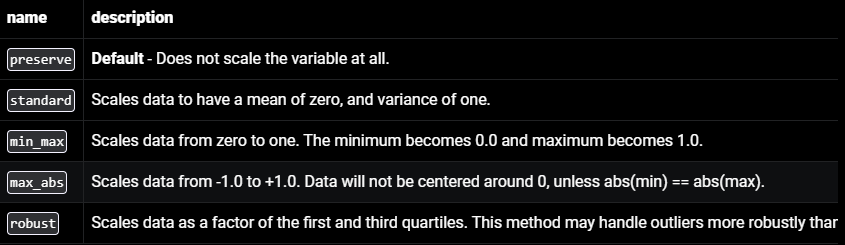
Meski Anda tidak mendapat rangkaian prapemroses selengkap di Scikit-learn, pilihan ini cukup untuk sebagian besar tugas pembelajaran terawasi.
Sejauh ini, kita menggunakan parameter default algoritma. Namun, default hampir selalu bukan pilihan ideal untuk masalah dunia nyata. Untuk menentukan nilai khusus, kita bisa menggunakan argumen hyperparams dari pgml.train:
SELECT pgml.train(
   project_name => 'Diamond prices prediction',
   task => 'regression',
   relation_name => 'diamonds',
   y_column_name => 'price',
   algorithm => 'xgboost',
   hyperparams => '{
       "n_estimators": 1000, "max_depth": 5, "eta": 0.01, "subsample": 0.7
   }'::JSONB
);
Kali ini, kita memasangkan regresor XGBoost dengan 1000 pohon, kedalaman maksimum 5, dan laju pembelajaran 0,01. Saat ini kita masih menebak, jadi hiperparameter ini mungkin tidak menghasilkan performa akurat.
Untuk memaksimalkan hasil model, kita selalu memerlukan penyetelan hiperparameter dalam tugas pembelajaran terawasi. Proses ini juga didukung di pgml di dalam fungsi train. Berikut cara melakukan grid search atas kombinasi hiperparameter kecil:
SELECT pgml.train(
   'Diamond prices prediction',
   algorithm => 'xgboost',
   search => 'grid',
   search_params => '{
       "max_depth": [5, 7],
       "n_estimators": [1000, 1500],
       "eta": [0.1, 0.01, 0.001]
   }'::JSONB
);
Pada titik ini, saya hanya ingin Anda menghargai apa yang kita lakukan. Kita menyetel hiperparameter regresor XGBoost menggunakan SQL! Saya tidak pernah menyangka akan menulis kalimat itu.
Saat tutorial ini ditulis, PostgresML belum memiliki alat evaluasi yang cukup matang. Kita hanya memiliki fungsi predict. Berikut cara menggunakannya untuk memprediksi satu sampel baru:
SELECT pgml.predict(
   project_name => 'Diamond prices prediction',
   features => ARRAY[0.7, "Ideal", "A", "IF", 67.9, 56.9, 7024, 5.85, 5.87, 3.71]
);
predict secara otomatis menggunakan model dengan performa terbaik dari eksperimen Anda. Untuk regresi, itu adalah model dengan R-squared tertinggi, sedangkan klasifikasi menggunakan model dengan F1-score tertinggi.
Untuk menggunakan model tertentu saat prediksi, Anda dapat menentukan ID-nya:
SELECT pgml.predict(
  2' -- Use model with ID of 2,
   features => ARRAY[0.7, "Ideal", "A", "IF", 67.9, 56.9, 7024, 5.85, 5.87, 3.71]
)
Tapi bagaimana cara menemukan ID model? Berikut snippet yang mencetak tabel rapi berisi informasi tersebut:
SELECT models.id, models.algorithm, models.metrics
FROM pgml.models
JOIN pgml.projects
 ON projects.id = models.project_id
WHERE projects.name = 'Diamond prices prediction';
Dari pernyataan ini, Anda dapat menemukan banyak variabel dan metrik tentang pgml seperti models.id, pgml.models, pgml.projects, dan sebagainya. Coba pernyataan `SELECT` atas objek-objek tersebut untuk memahami fungsinya.
Tidak seperti MLOps tradisional, langkah ini paling mudah di PostgresML. Ekstensi pgml secara otomatis mengekspos model dengan performa terbaik dari eksperimen Anda sebagai model default. Jadi, pernyataan SELECT pgml.predict apa pun yang dikirim pengguna ke server akan menggunakan model tersebut untuk inferensi.
Jika Anda menginginkan kontrol lebih rinci atas model yang masuk produksi, Anda dapat mengaturnya dengan fungsi pgml.deploy. Berikut strukturnya:
SELECT * FROM pgml.deploy(
   project_name TEXT,
   strategy TEXT DEFAULT 'best_score',
   algorithm TEXT DEFAULT NULL
)
Selain best_score, ada juga strategi penyebaran most_recent dan rollback:
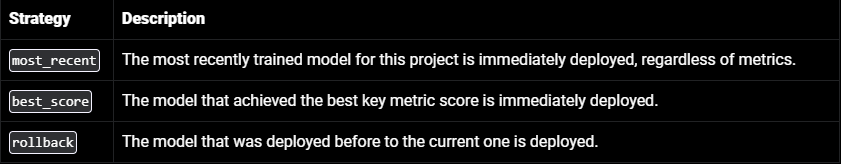
Dengan mengombinasikan parameter strategy dan algorithm, Anda bisa mempersempit penyebaran lebih lanjut. Misalnya, pernyataan di bawah ini menyebarkan model XGBoost dengan skor terbaik, bukan model dengan performa terbaik di seluruh proyek.
SELECT * FROM pgml.deploy(
   project_name => 'Diamond prices prediction',
   strategy => 'best_score',
   algorithm => 'xgboost'
)
Pembelajaran terawasi hanyalah sebagian kecil dari PostgresML. Faktanya, proposisi nilai utama PostgresML adalah “Membangun aplikasi AI di Postgres.” Untuk menunjukkannya, mereka bahkan menampilkan editor SQL kecil di beranda:
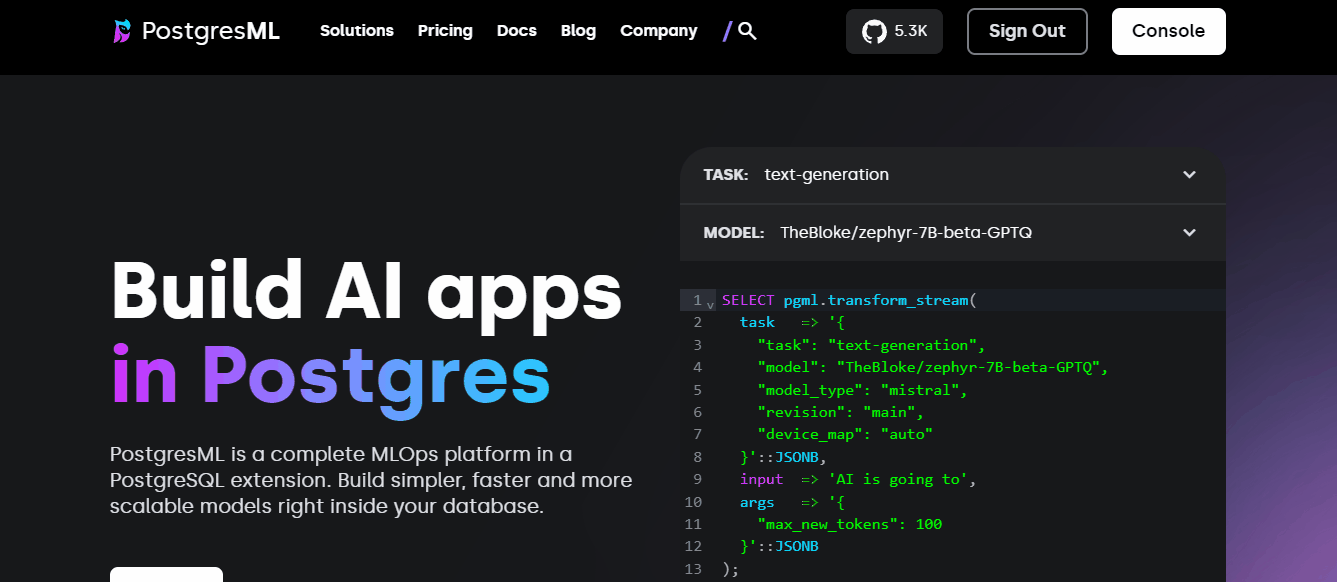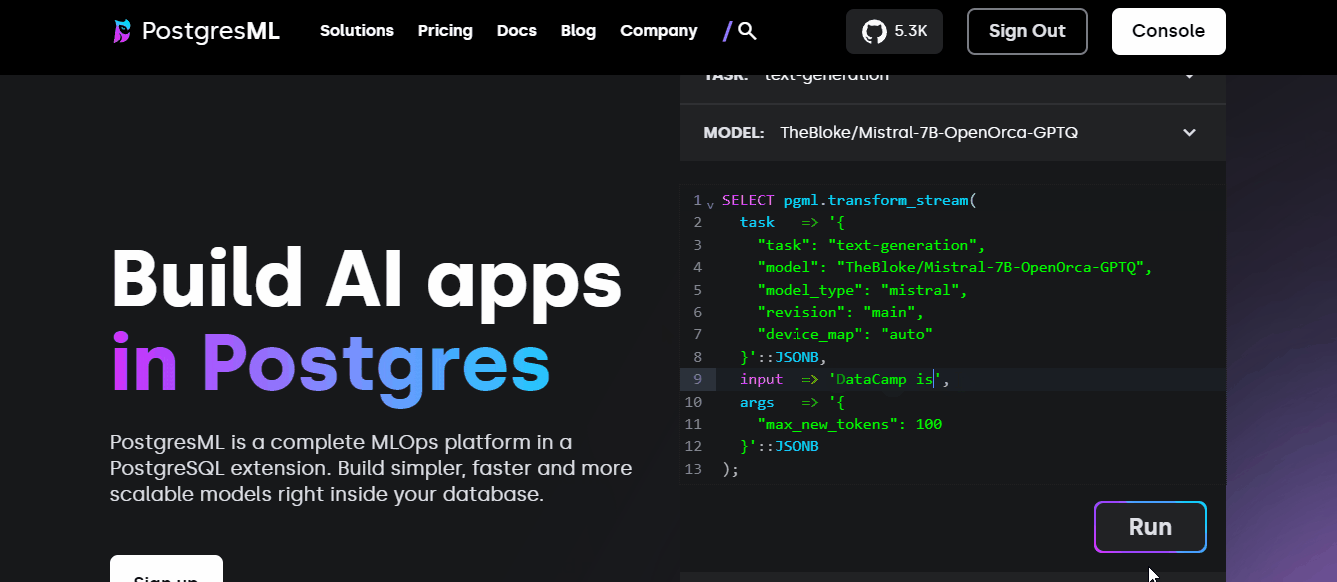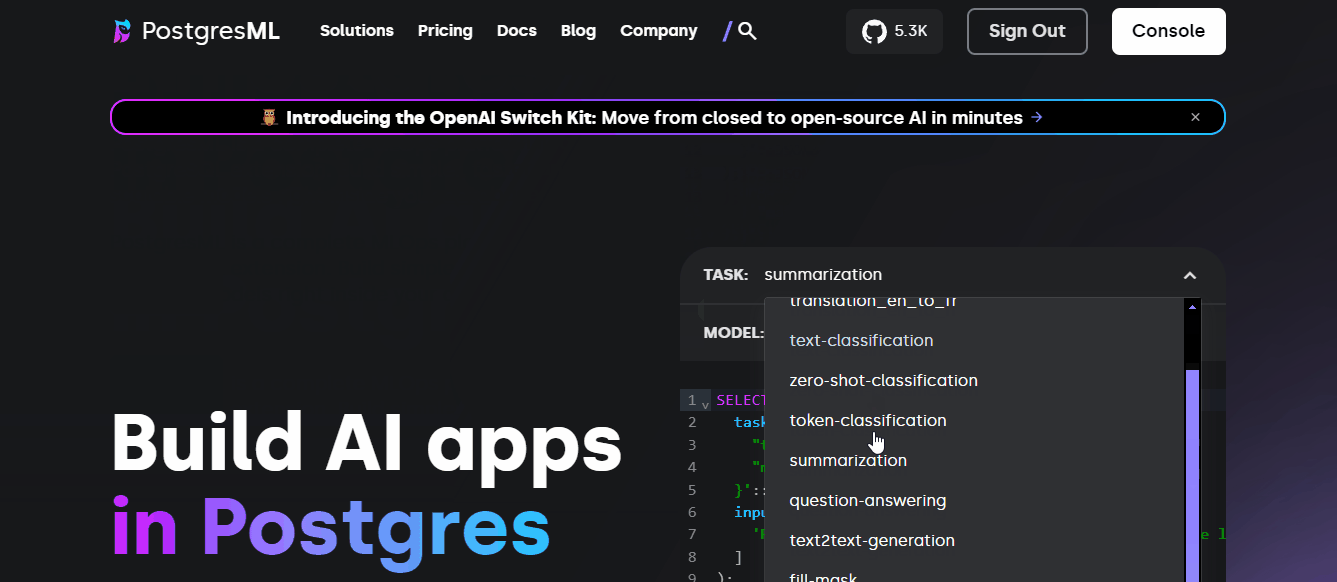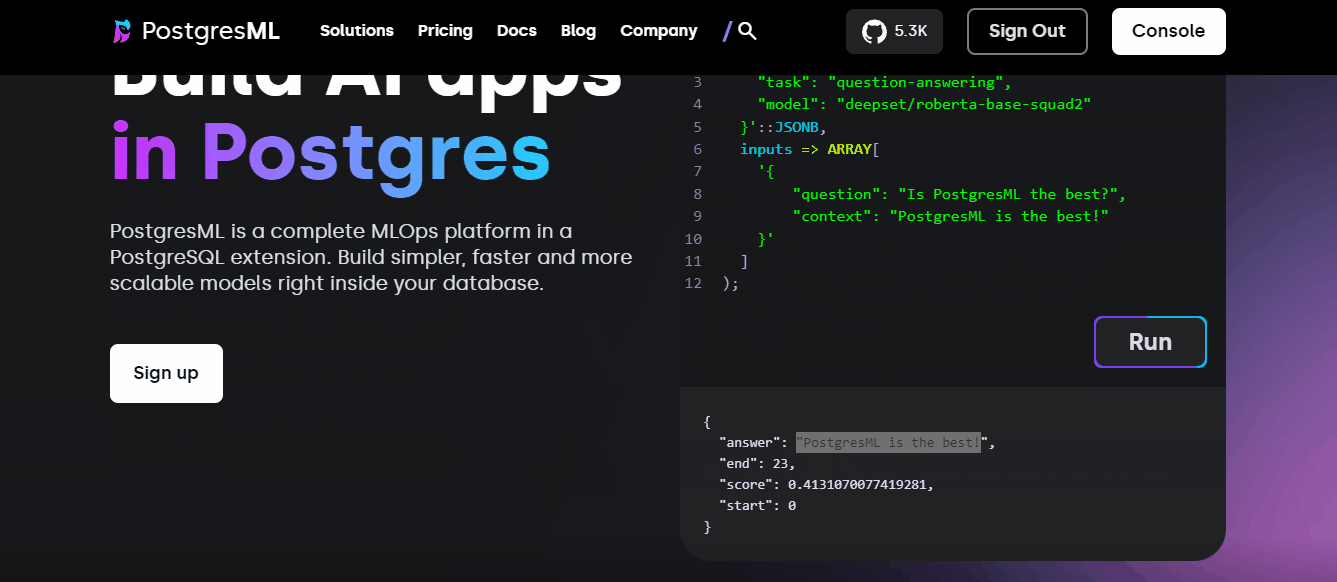
Anda dapat menjalankan contoh-contoh tersebut langsung di lingkungan yang Anda gunakan dalam tutorial ini juga!
Jadi, jika Anda ingin membangun layanan machine learning untuk konsumen dengan PostgresML, bagaimana cara melakukannya? Berikut beberapa langkah yang mungkin (setelah model siap):
psycopg2 (Python) atau pg-promise (JavaScript) untuk terhubung ke basis data PostgresML Anda.pgml.predict dipanggil.Ini adalah garis besar kasar yang dapat berubah signifikan bergantung pada use case.
PostgresML memperkenalkan paradigma yang sepenuhnya baru dalam machine learning, jadi butuh lebih dari satu tutorial untuk menguasainya. Untuk memantapkan pemahaman Anda dan menjelajahi cara lain menggunakan PostgresML, baca bagian use case di dokumentasi PostgresML.
Jika kemampuan SQL Anda agak berkarat, Anda bisa mengikuti kursus singkat DataCamp tentang membuat basis data PostgreSQL atau bahkan seluruh jalur karier Data Analyst in SQL.
Karena PostgresML sangat berfokus pada AI, Anda juga dapat mempelajari beberapa dasar-dasar AI:
Lanjutkan Perjalanan AI Anda Hari Ini!
Kursus
Program
Program
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt




