
Corso
Concetti sui Large Language Models (LLM)
2 ore
112.2K
La tendenza generale nel machine learning è spostare i dati nell'ambiente del modello per l'addestramento. Ma se facessimo il contrario? Dato che i database di oggi sono ordini di grandezza più grandi dei modelli di machine learning, non sarebbe molto più semplice portare i modelli verso i dataset?
Questa è l'idea alla base di PostgresML — i dati restano dove sono, porti il tuo codice nel database. Questo tipo di machine learning a logica inversa offre una serie di vantaggi pratici che ti faranno riconsiderare il concetto di "database".
PostgresML è una piattaforma completa di machine learning costruita sopra il popolare database PostgreSQL. Introduce un nuovo paradigma chiamato machine learning "in-database", che ti permette di svolgere molte attività di ML in SQL senza dover usare strumenti separati a ogni passaggio.
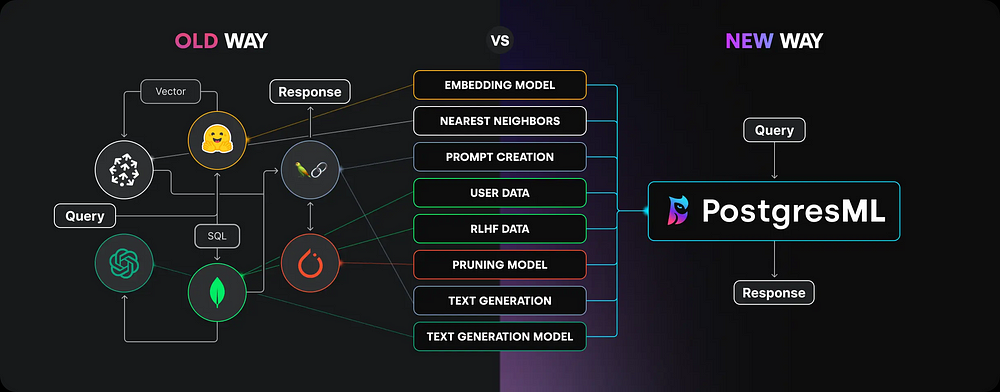
Pur essendo relativamente nuovo, PostgresML promette questi vantaggi garantiti:
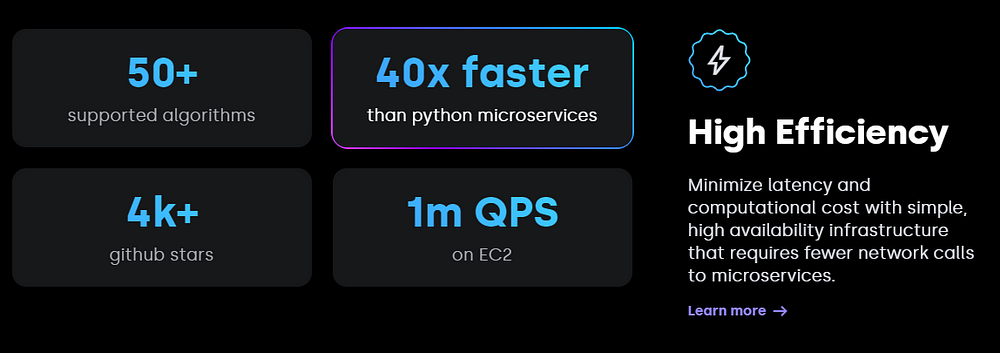
Metteremo alla prova tutte queste funzionalità in questo tutorial seguendo un tipico workflow di machine learning:
…il tutto dentro un database Postgres. Iniziamo!
Per prima cosa, creiamo un account gratuito su https://postgresml.org/signup:
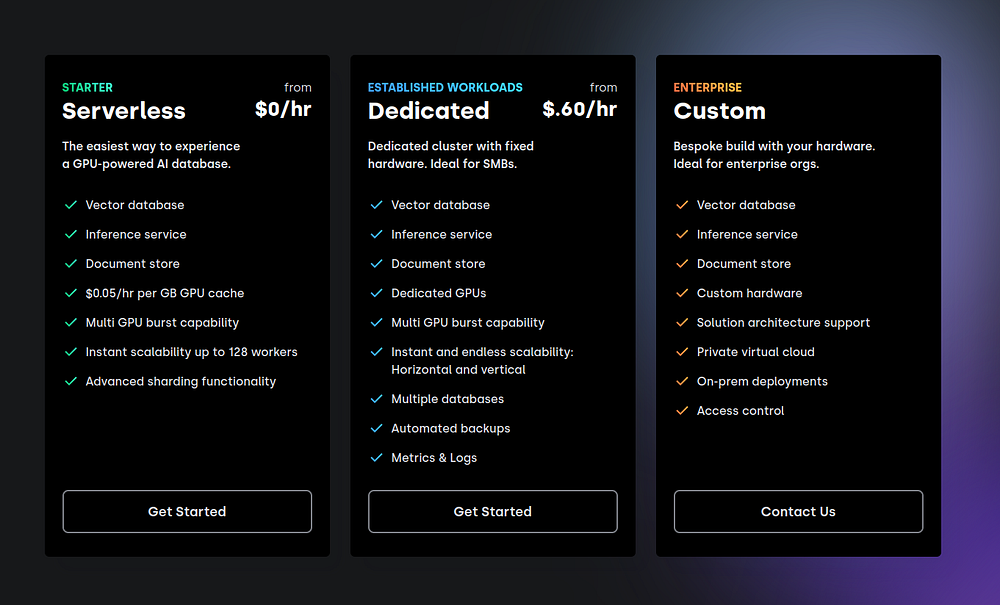
Poi, scegli il piano gratuito, che offre risorse generose:
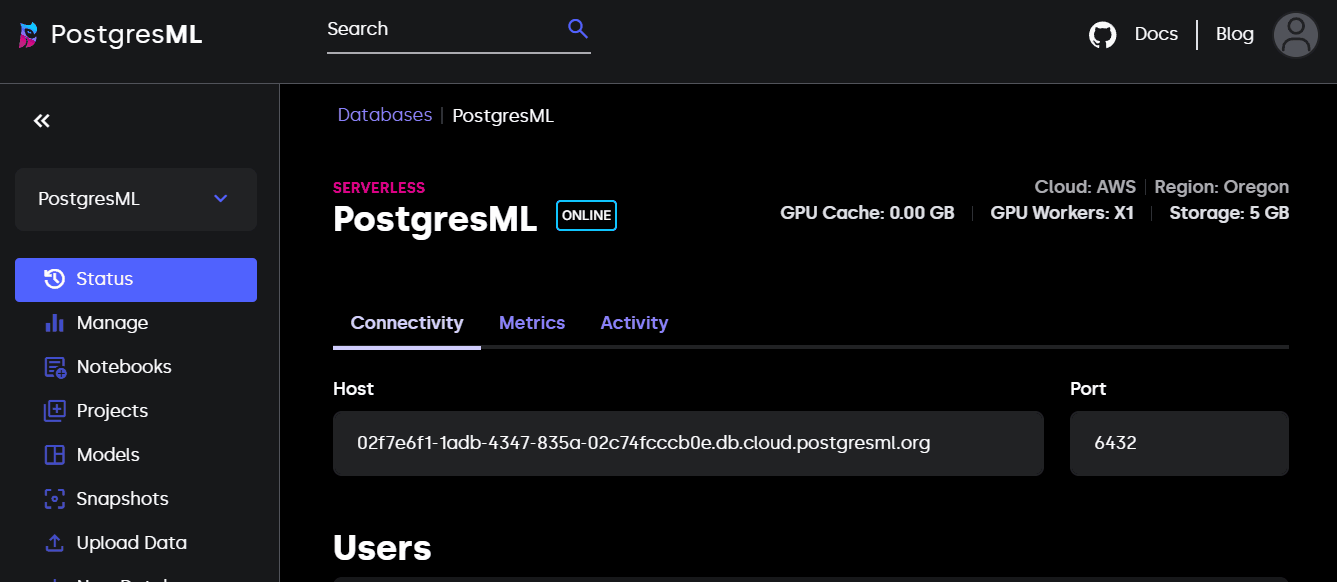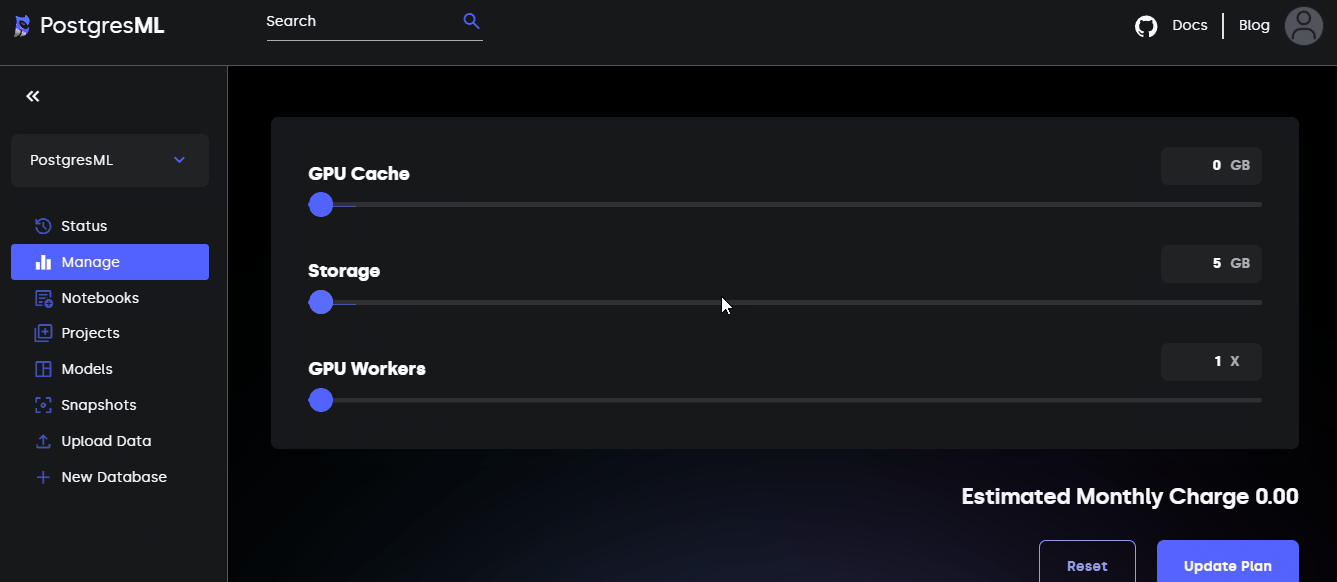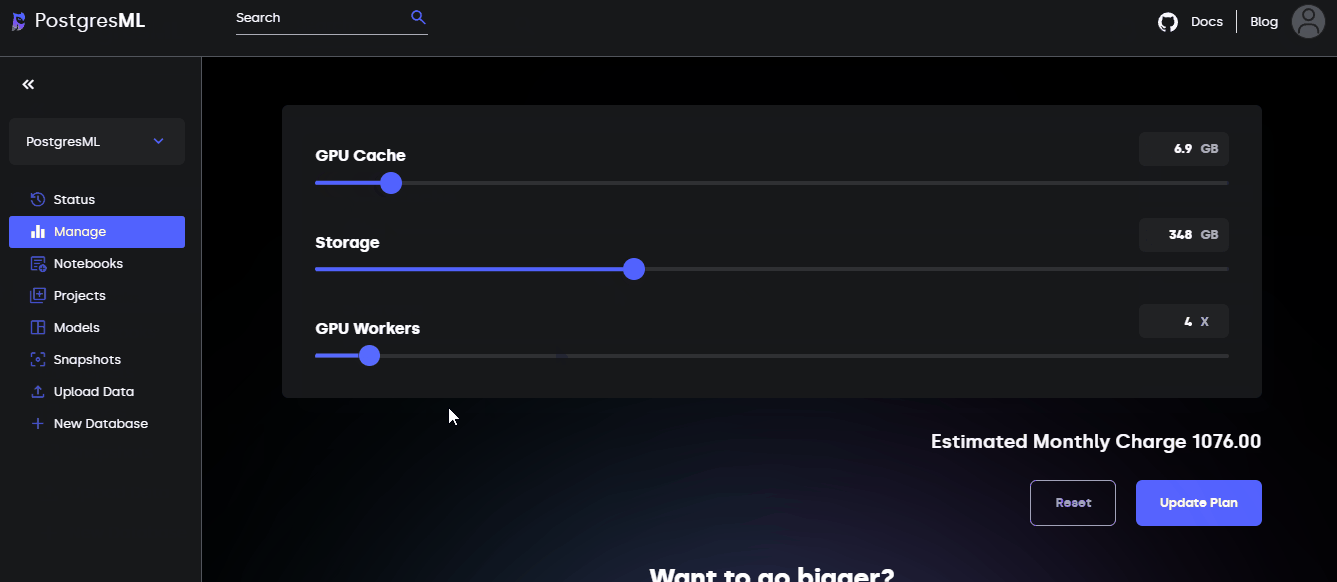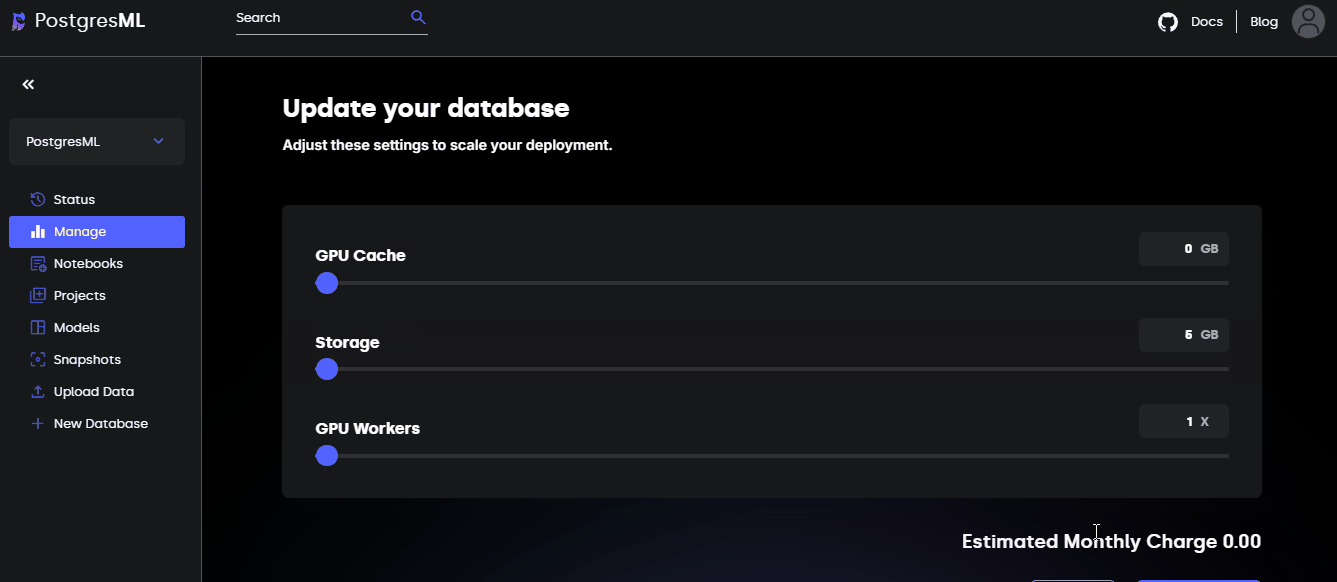
Dopo la registrazione, atterrerai sulla tua console PostgresML. Qui gestisci diversi progetti di "ML in-database" e le relative risorse.
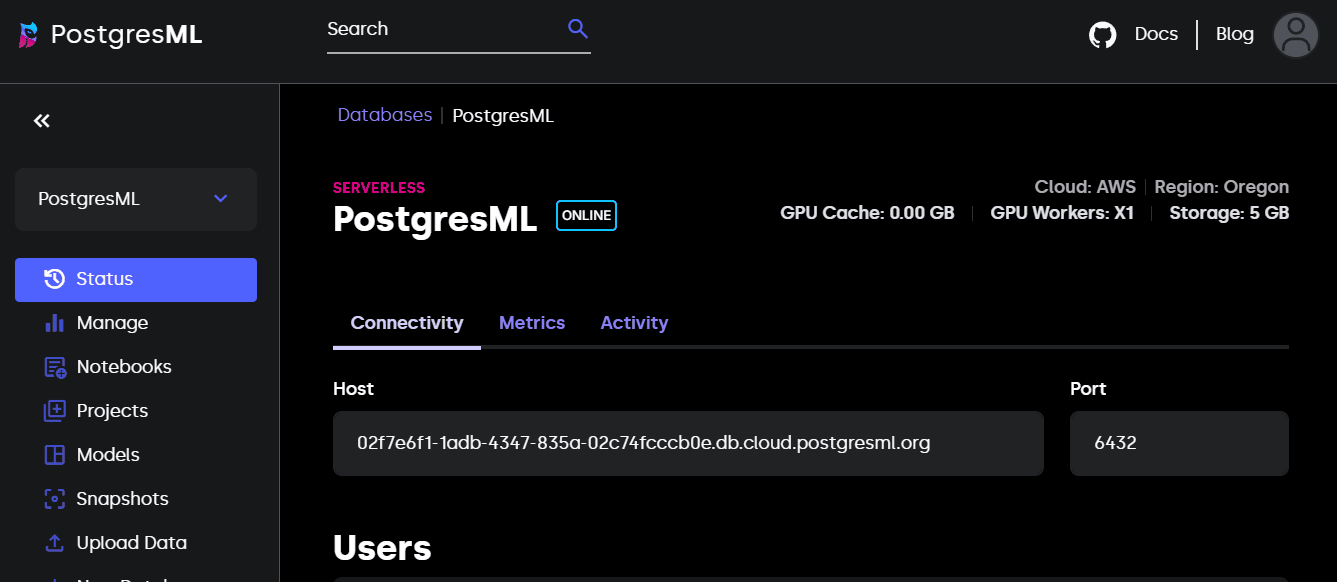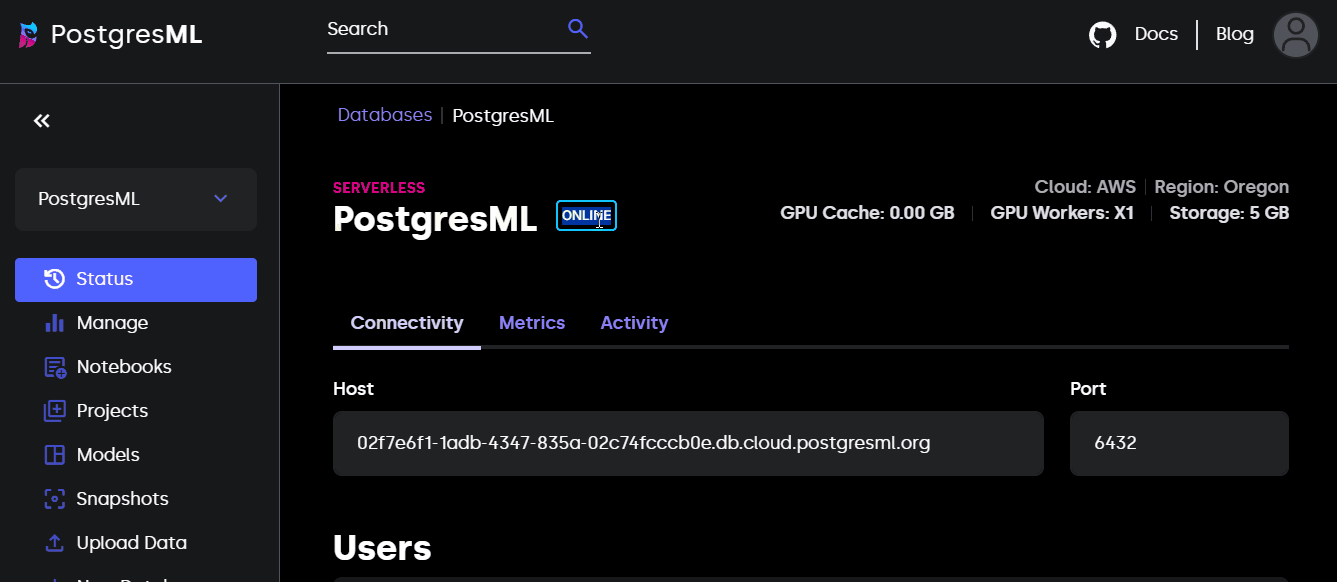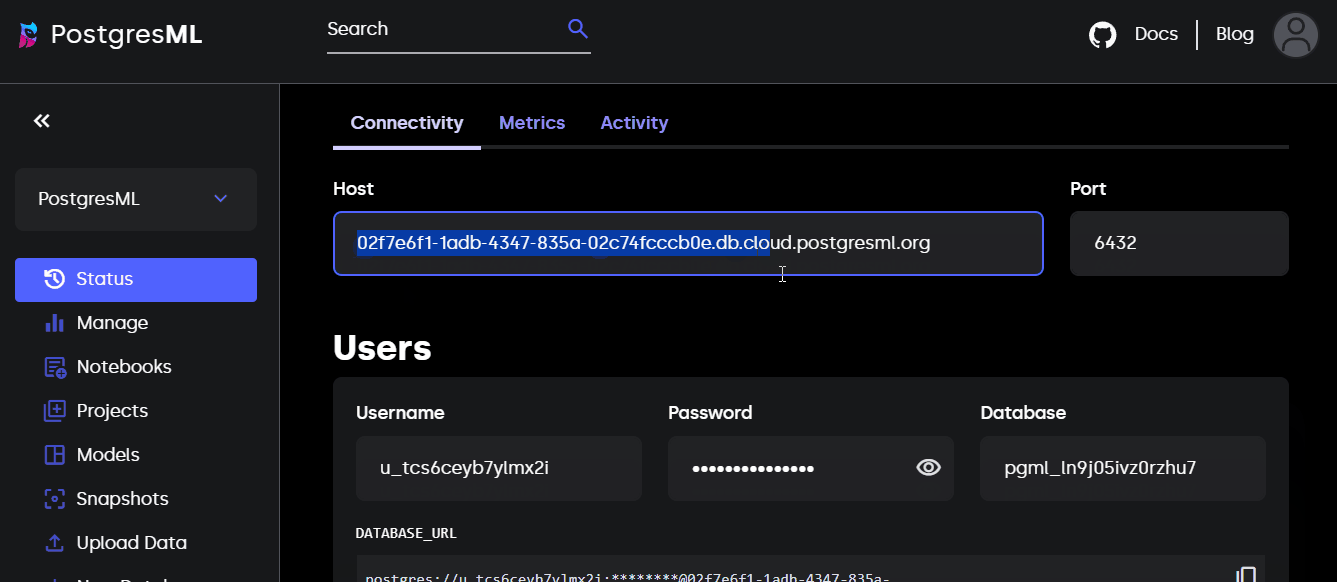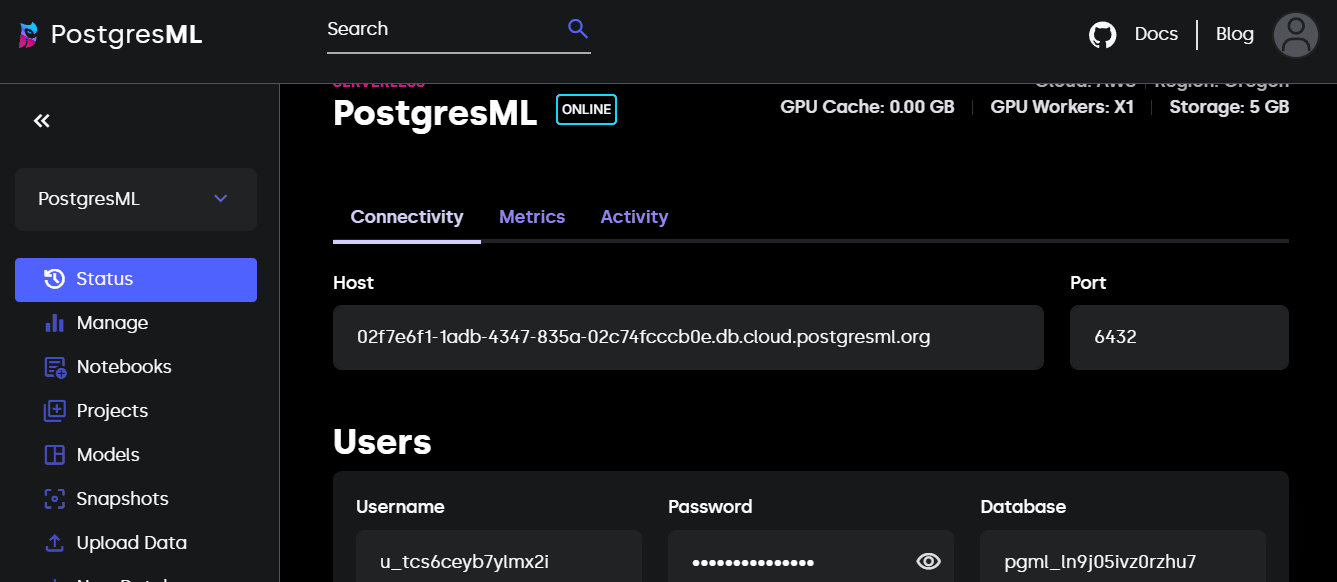
Se vai nella sezione "Manage", potrai scalare il tuo ambiente in base alle esigenze di calcolo:
Come suggerisce il nome, abbiamo bisogno di PostgreSQL installato sul sistema per usare PostgresML. Se non sai cos'è Postgres, è il database open source più avanzato al mondo (così dicono sul loro sito).
Ecco le guide specifiche per piattaforma per l'installazione di PostgreSQL:
Io sono su WSL2, quindi posso semplicemente fare:
$ sudo apt update
$ sudo apt install postgresql postgresql-contrib
$ sudo passwd postgres  # Set a new Postgres password
# Close and reopen your terminal and done!
Successivamente, verifica l'installazione con:
$ psql --version
psql (PostgreSQL) 12.18 (Ubuntu 12.18-0ubuntu0.20.04.1)
psql è il client ufficiale di Postgres per connettersi e gestire i database da terminale.
Capisco che per la maggior parte delle persone non sia l'ideale eseguire SQL in terminali spartani, quindi puoi anche installare la seguente estensione di VSCode dopo aver installato Postgres:
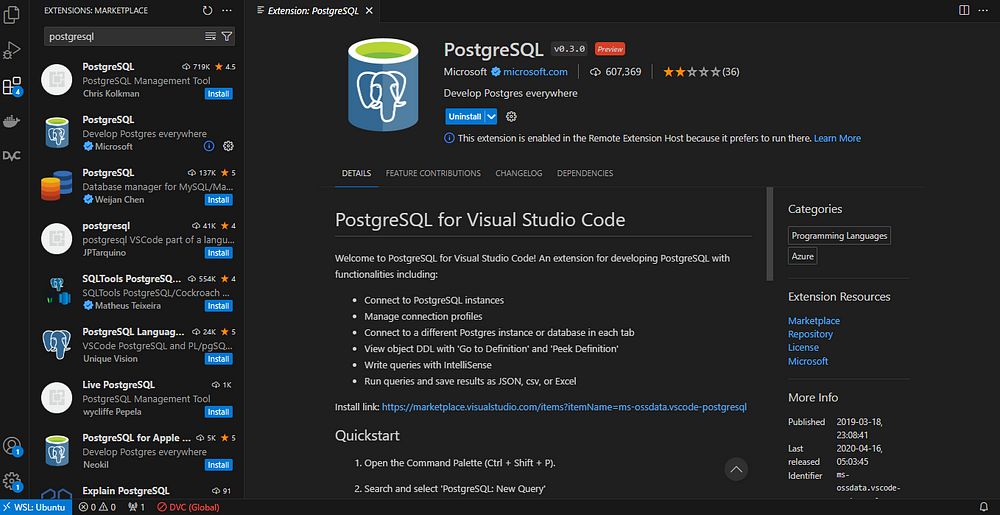
Ricordi la pagina iniziale della tua console PostgresML? Tienila aperta in una scheda separata:
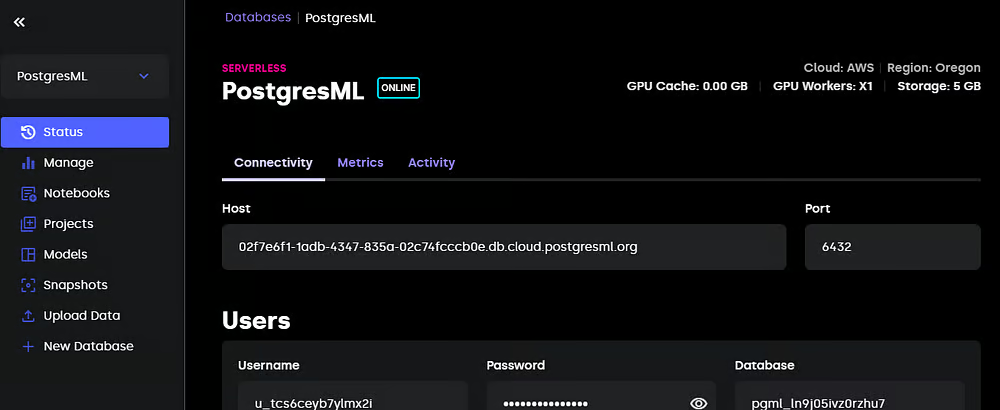
Ora, usando psql, puoi digitare il seguente comando con le tue credenziali per stabilire una connessione con il server PostgresML:
$ psql -h "host" \
      -U "username" \
      -p 6432 \
      -d "database_name"
Se usi l'estensione VSCode, segui questi passaggi (tratti dalla pagina di installazione dell'estensione) per fare lo stesso:
E sarai connesso al tuo database PostgresML.
Il prossimo passo è creare l'estensione pgml che ci permetterà di eseguire le funzioni di PostgresML:
CREATE EXTENSION IF NOT EXISTS pgml;

NOTICE:  extension "pgml" already exists, skipping
CREATE EXTENSION
-- Your output may be different.
Controlla che tutto sia andato a buon fine stampando la versione di pgml:
SELECT pgml.version();

2.8.2 (98f114891db58acd472e068c44272b198274b11d)
Ora carichiamo alcuni dati nel nostro database. Per semplicità, creeremo una sola tabella usando il dataset Diamonds da Kaggle. Puoi scaricarlo come file CSV dal sito oppure usare lo snippet Python qui sotto:
import seaborn as sns

diamonds = sns.load_dataset("diamonds")
diamonds.to_csv("diamonds.csv", index=False)
Poi esegui il seguente comando CREATE con lo schema corretto:
CREATE TABLE IF NOT EXISTS diamonds (
   index SERIAL PRIMARY KEY,
   carat FLOAT,
   cut VARCHAR(255),
   color VARCHAR(255),
   clarity VARCHAR(255),
   depth FLOAT,
   table_ FLOAT,
   price INT,
   x FLOAT,
   y FLOAT,
   z FLOAT
)
Il comando creerà una tabella chiamata diamonds che possiamo popolare con le righe del file CSV:
INSERT INTO diamonds
   (carat, cut, color, clarity, depth, table_, price, x, y, z)
   FROM '~/full/path/to/diamonds.csv'
   DELIMITER ','
   CSV HEADER;
Infine, stampiamo la testa della tabella per confermare che l'ultimo comando sia stato eseguito correttamente:
SELECT * FROM diamonds
LIMIT 10;
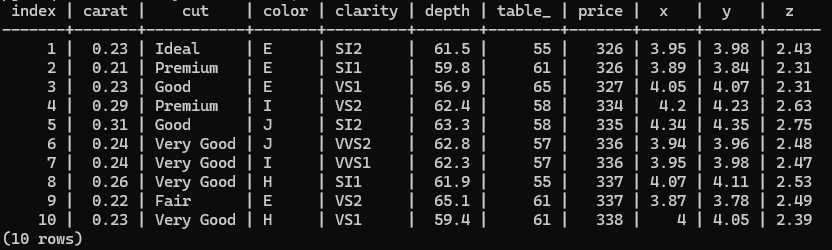
Ora siamo pronti ad addestrare un modello!
L'addestramento di un modello di machine learning per l'apprendimento supervisionato si fa con la funzione pgml.train. Ecco la sua struttura di base:
SELECT pgml.train(
 project_name => 'Diamond prices prediction',
 task => 'regression',
 relation_name => 'diamonds',
 y_column_name => 'price',
 algorithm => 'xgboost'
);
La query SQL sopra adatta un regressore XGBoost alla tabella diamonds per prevedere i prezzi dei diamanti. Una cosa che noterai eseguendo il comando è la velocità (quasi istantanea) nonostante abbiamo oltre 50k righe.
Puoi anche cambiare facilmente attività. Ecco come adattare un classificatore multiclasse (non dimenticare di cambiare il nome del progetto):
SELECT pgml.train(
 project_name => 'Diamond cut quality prediction',
 task => 'classification',
 relation_name => 'diamonds',
 y_column_name => 'cut',
 algorithm => 'xgboost',
 test_size => 0.1
);
Nota come questa volta specifichiamo l'argomento test_size - è supportato anche uno split personalizzato!
Abbiamo anche cambiato l'algoritmo predefinito linear in xgboost, ma avrebbe potuto essere qualsiasi altro modello di Scikit-learn o di un framework supportato.
Proviamo questa volta ad adattare un modello random forest:
…
Aspetta! Il dataset diamonds ha feature testuali che vanno codificate. Dato che XGBoost codifica nativamente le categoriche, non abbiamo ricevuto errori nelle query precedenti. Potrebbe non essere così con le random forest. Quindi, aggiungiamo alcune fasi di preprocessing alla query:
SELECT pgml.train(
   project_name => 'Diamond prices prediction',
   task => 'regression',
   relation_name => 'diamonds',
   y_column_name => 'price',
   algorithm => 'random_forest',
   preprocess => '{
       "carat": {"scale": "standard"},
       "depth": {"scale": "standard"},
       "table_": {"scale": "standard"},
       "cut": {"encode": "target", "scale": "standard"},
       "color": {"encode": "target", "scale": "standard"},
       "clarity": {"encode": "target", "scale": "standard"}
   }'::JSONB
);
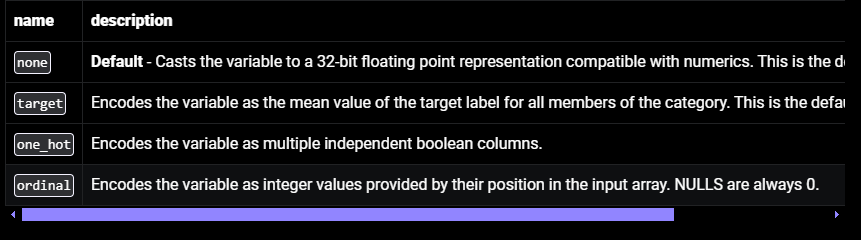
La logica di preprocessing è definita dentro un oggetto JSONB che mappa le colonne ai passaggi di trasformazione. Per le feature numeriche usiamo la standardizzazione (anche se per le RF non è necessaria). Per le colonne categoriche usiamo il target encoding e poi la standardizzazione.
PostgresML offre anche altre funzioni di preprocessing alternative. Ecco l'elenco completo delle opzioni di codifica disponibili:
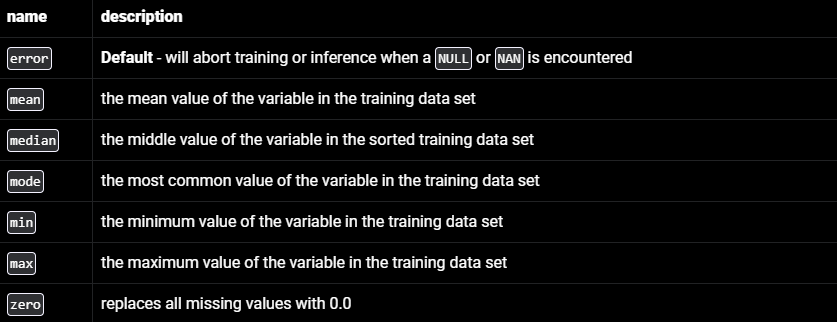
pgml supporta anche le tecniche standard di imputazione:
Ed ecco l'elenco degli scaler:
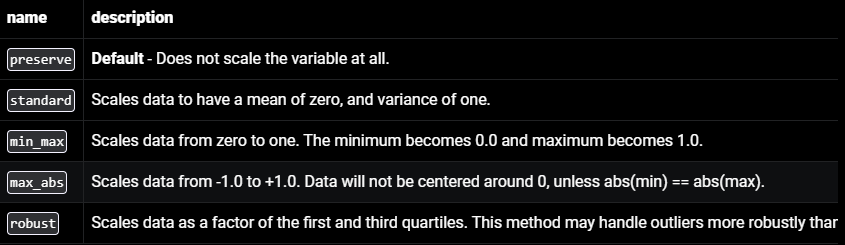
Anche se non hai una vasta suite di preprocessori come in Scikit-learn, questi saranno sufficienti per la maggior parte dei compiti di apprendimento supervisionato.
Finora abbiamo usato i parametri predefiniti degli algoritmi. Tuttavia, i default quasi mai sono la scelta ideale per problemi reali. Per specificare valori personalizzati, possiamo usare l'argomento hyperparams di pgml.train:
SELECT pgml.train(
   project_name => 'Diamond prices prediction',
   task => 'regression',
   relation_name => 'diamonds',
   y_column_name => 'price',
   algorithm => 'xgboost',
   hyperparams => '{
       "n_estimators": 1000, "max_depth": 5, "eta": 0.01, "subsample": 0.7
   }'::JSONB
);
Questa volta stiamo adattando un regressore XGBoost con 1000 alberi, profondità massima di 5 e learning rate di 0,01. Al momento stiamo tirando un po' a indovinare, quindi questi iperparametri potrebbero non produrre risultati accurati.
Per massimizzare i risultati del modello, nei compiti di apprendimento supervisionato serve sempre il tuning degli iperparametri. Questo processo è supportato in pgml all'interno della funzione train. Ecco come eseguire una grid search su una piccola selezione di combinazioni di iperparametri:
SELECT pgml.train(
   'Diamond prices prediction',
   algorithm => 'xgboost',
   search => 'grid',
   search_params => '{
       "max_depth": [5, 7],
       "n_estimators": [1000, 1500],
       "eta": [0.1, 0.01, 0.001]
   }'::JSONB
);
A questo punto, voglio solo che tu apprezzi cosa stiamo facendo qui. Stiamo sintonizzando gli iperparametri di un regressore XGBoost usando SQL! È una frase che non avrei mai pensato di scrivere.
Al momento della stesura di questo tutorial, PostgresML non ha ancora strumenti di valutazione sufficientemente maturi a disposizione. Abbiamo soltanto la funzione predict. Ecco come usarla per prevedere su un nuovo singolo campione:
SELECT pgml.predict(
   project_name => 'Diamond prices prediction',
   features => ARRAY[0.7, "Ideal", "A", "IF", 67.9, 56.9, 7024, 5.85, 5.87, 3.71]
);
predict usa automaticamente il modello con le prestazioni migliori tra i tuoi esperimenti. Per la regressione sarà il modello con l'R-quadrato più alto, mentre per la classificazione usa il modello con l'F1-score più alto.
Per usare un modello specifico per la previsione, puoi specificarne l'ID:
SELECT pgml.predict(
  2' -- Use model with ID of 2,
   features => ARRAY[0.7, "Ideal", "A", "IF", 67.9, 56.9, 7024, 5.85, 5.87, 3.71]
)
Ma come si trovano gli ID dei modelli, dirai? Ecco uno snippet che stampa una bella tabella con esattamente queste informazioni:
SELECT models.id, models.algorithm, models.metrics
FROM pgml.models
JOIN pgml.projects
 ON projects.id = models.project_id
WHERE projects.name = 'Diamond prices prediction';
Da questa query puoi scoprire molte variabili e metriche su pgml come models.id, pgml.models, pgml.projects e così via. Prova istruzioni `SELECT` su di esse per capire come funzionano.
A differenza della MLOps tradizionale, questo passaggio è il più semplice in PostgresML. L'estensione pgml espone automaticamente come predefinito il modello con le prestazioni migliori tra i tuoi esperimenti. Quindi, qualsiasi istruzione SELECT pgml.predict inviata dagli utenti al server userà quel modello per l'inferenza.
Se vuoi un controllo più fine su quale modello va in produzione, puoi gestirlo con la funzione pgml.deploy. Ecco la sua struttura:
SELECT * FROM pgml.deploy(
   project_name TEXT,
   strategy TEXT DEFAULT 'best_score',
   algorithm TEXT DEFAULT NULL
)
Oltre a best_score, ci sono anche le strategie di distribuzione most_recent e rollback:
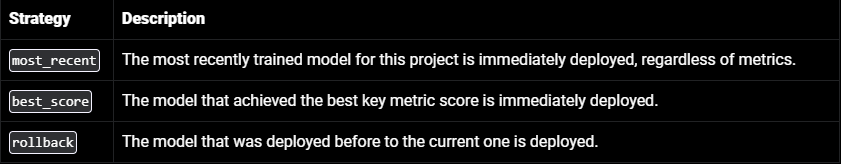
Combinando i parametri strategy e algorithm, puoi restringere ulteriormente la distribuzione. Ad esempio, la query qui sotto distribuisce il miglior modello XGBoost per punteggio, non il migliore dell'intero progetto.
SELECT * FROM pgml.deploy(
   project_name => 'Diamond prices prediction',
   strategy => 'best_score',
   algorithm => 'xgboost'
)
L'apprendimento supervisionato è solo una piccola parte di PostgresML. In effetti, la proposta di valore di PostgresML è "Costruire app di AI in Postgres". Per dimostrarlo, hanno persino inserito un piccolo editor SQL in homepage:
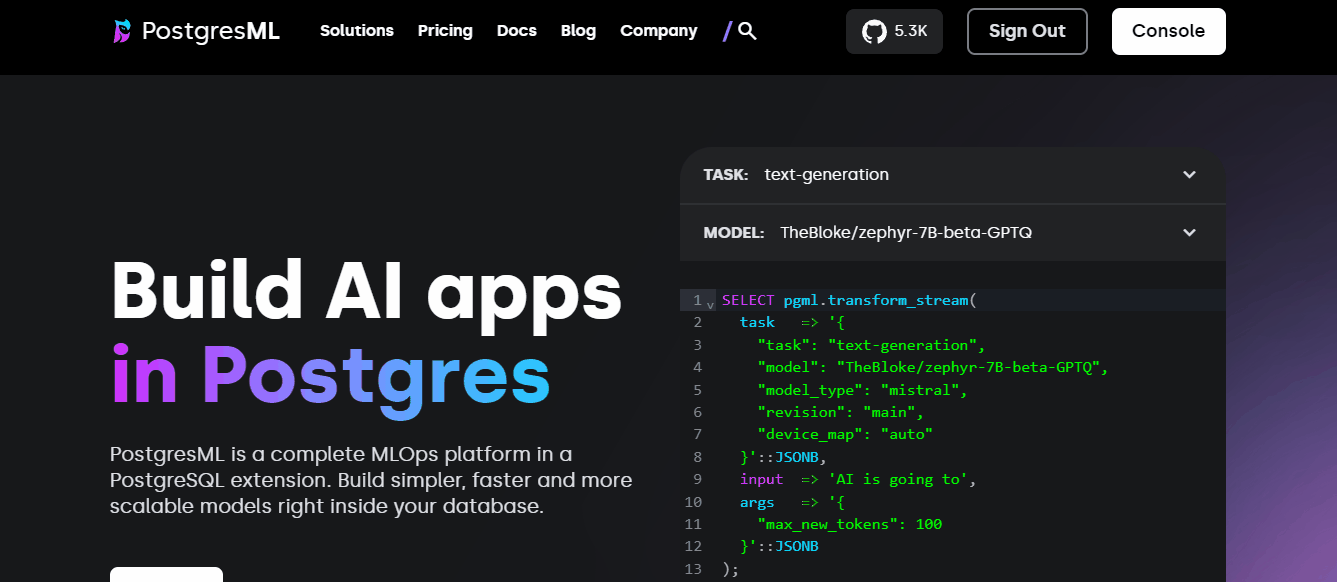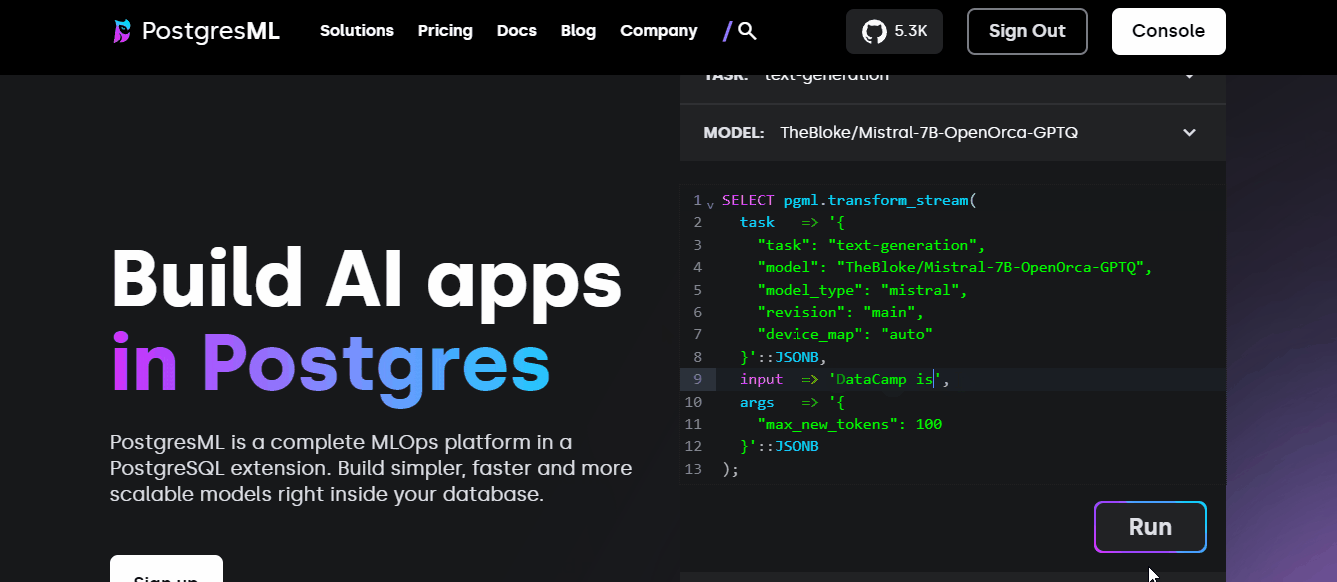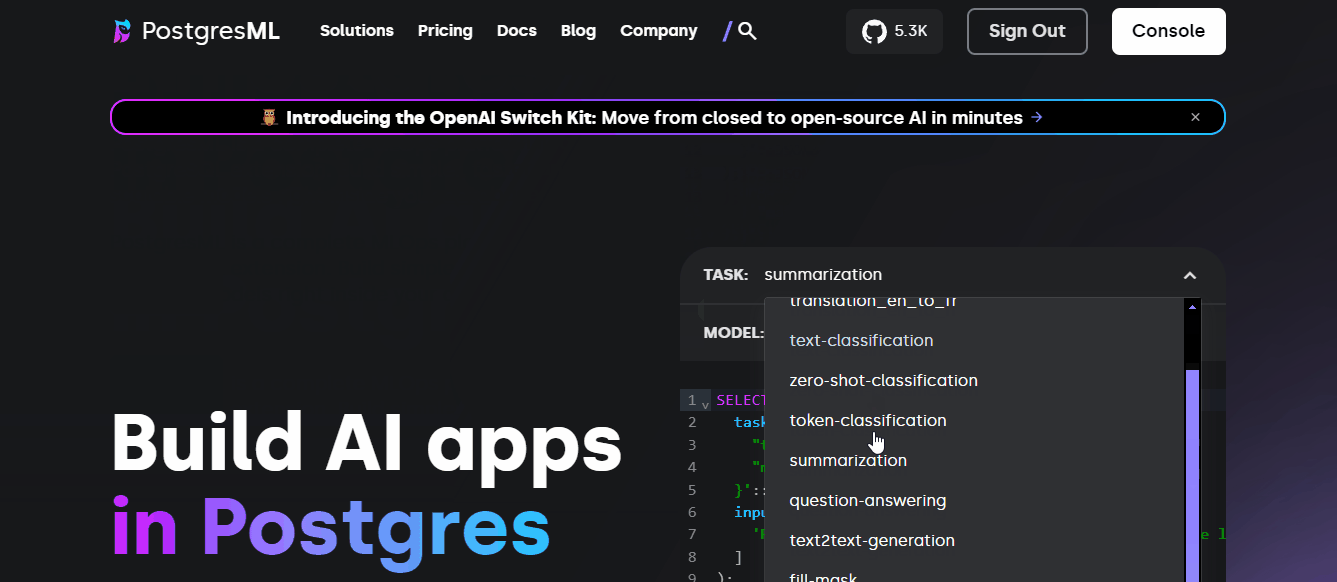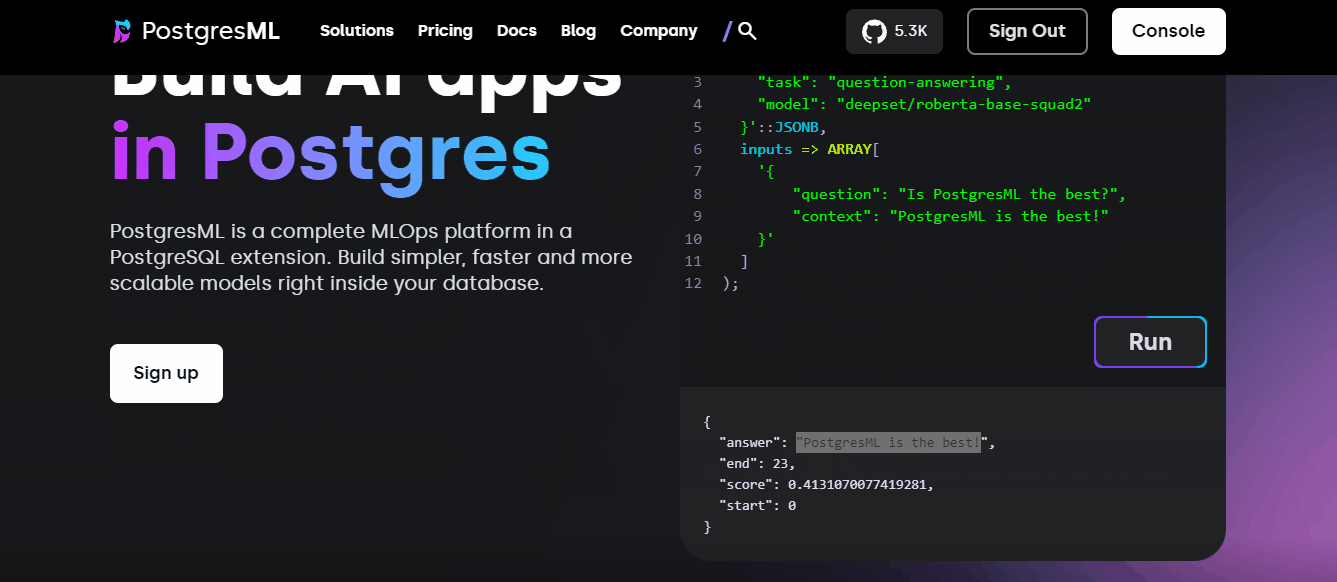
Puoi eseguire quegli esempi direttamente nell'ambiente che hai usato anche in questo tutorial!
Quindi, se volessi costruire un servizio di machine learning rivolto ai consumatori con PostgresML, come faresti? Ecco alcuni possibili passaggi (dopo aver pronto il modello):
psycopg2 (Python) o pg-promise (JavaScript) per connetterti al tuo database PostgresML.pgml.predict.Questa è una traccia di massima che può cambiare sensibilmente in base ai casi d'uso.
PostgresML introduce un paradigma completamente nuovo nel machine learning, quindi serve più di un singolo tutorial per padroneggiarlo. Per consolidare la comprensione ed esplorare altri modi d'uso di PostgresML, leggi la sezione dei casi d'uso della documentazione di PostgresML.
Se le tue competenze SQL sono un po' arrugginite, puoi seguire il corso breve di DataCamp su creazione di database PostgreSQL o anche l'intero percorso professionale Data Analyst in SQL.
Dato che PostgresML punta molto sull'AI, puoi anche approfondire alcune nozioni di base sull'AI:
Continua il tuo percorso nell'AI oggi!
Corso
Programma
Programma
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



