Curso
Conceptos de grandes modelos lingüísticos (LLM)
2 h
110.2K
La tendencia general en machine learning es mover los datos al entorno del modelo para entrenarlo. Pero ¿y si lo hacemos al revés? Dado que las bases de datos actuales son varios órdenes de magnitud más grandes que los modelos de ML, ¿no sería mucho más sencillo llevar los modelos a los conjuntos de datos?
Esa es la idea central de PostgresML: los datos se quedan donde están y tú llevas tu código a la base de datos. Este enfoque de machine learning con la lógica invertida aporta un montón de ventajas prácticas que te harán replantearte el concepto de «base de datos».
PostgresML es una plataforma integral de machine learning construida sobre la popular base de datos PostgreSQL. Introduce un nuevo paradigma llamado machine learning «en base de datos», que te permite realizar muchas tareas de ML en SQL sin necesitar herramientas separadas en cada paso.
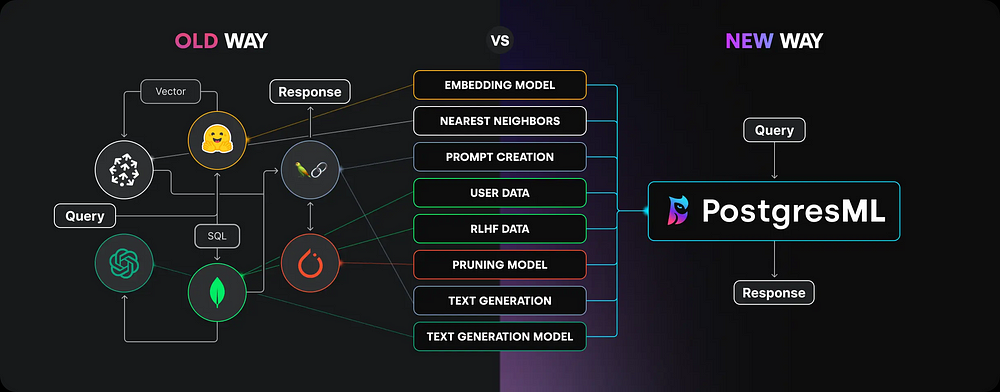
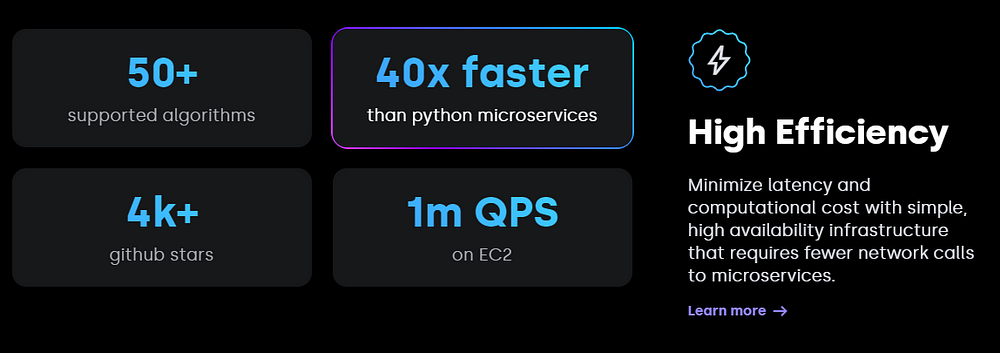
Aunque es relativamente nuevo, PostgresML promete estas ventajas claras:
Pondremos a prueba todas estas funciones en este tutorial siguiendo un flujo de trabajo típico de machine learning:
…todo dentro de una base de datos Postgres. ¡Vamos allá!
Primero, crea una cuenta gratuita en https://postgresml.org/signup:
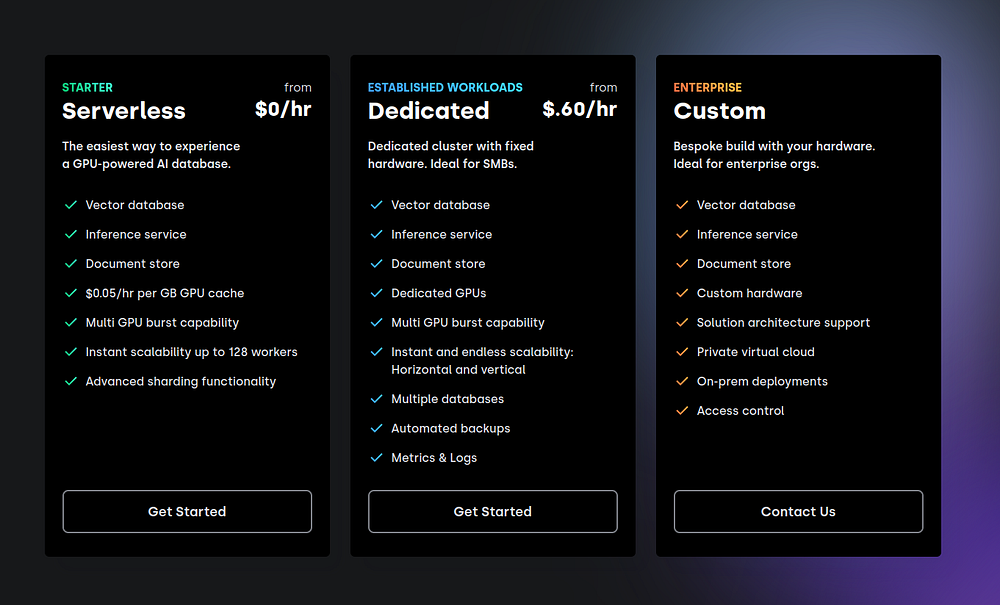
Luego, elige el plan gratuito, que ofrece recursos más que generosos:
Tras registrarte, llegarás a tu consola de PostgresML. Aquí es donde gestionas diferentes proyectos de «ML en base de datos» y sus recursos relacionados.
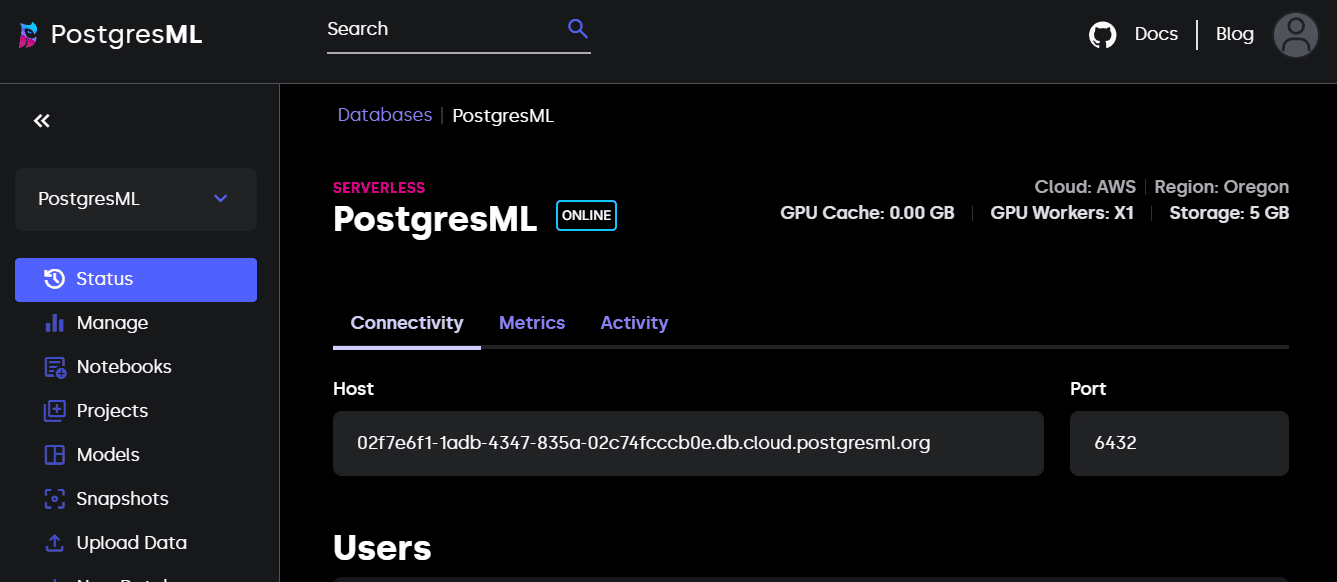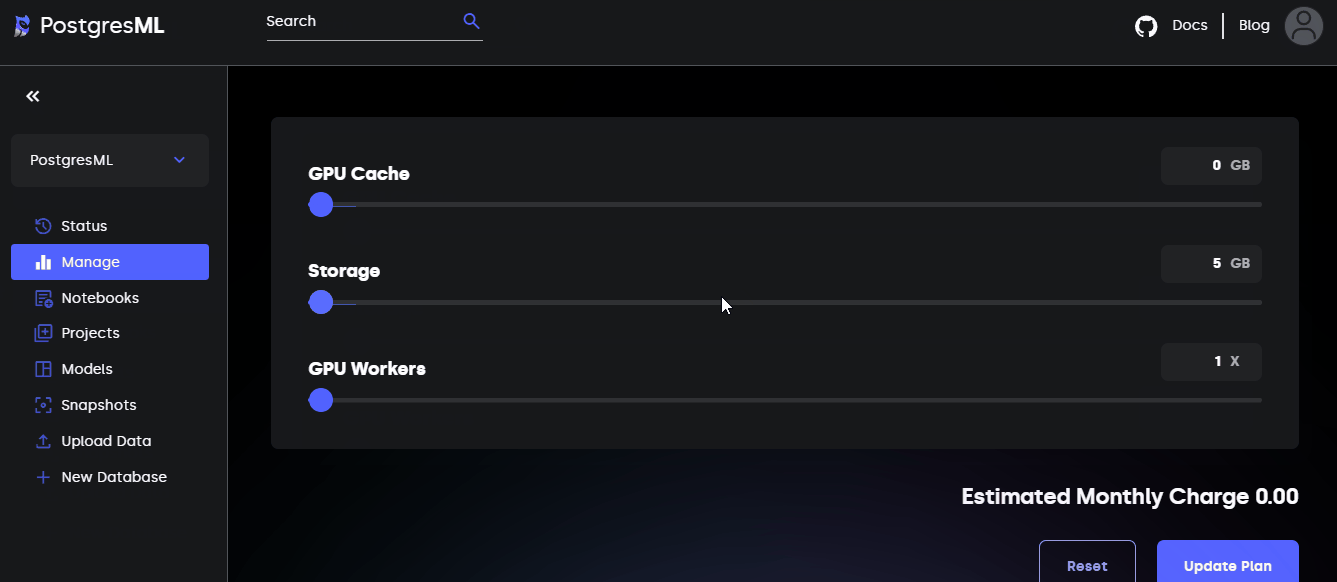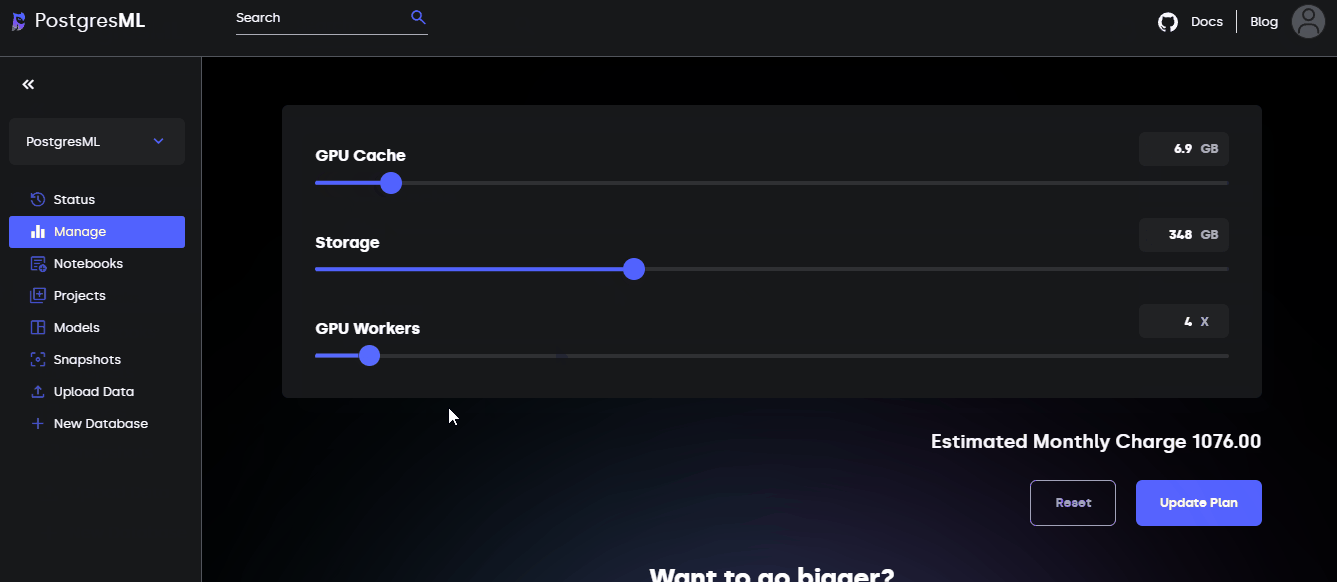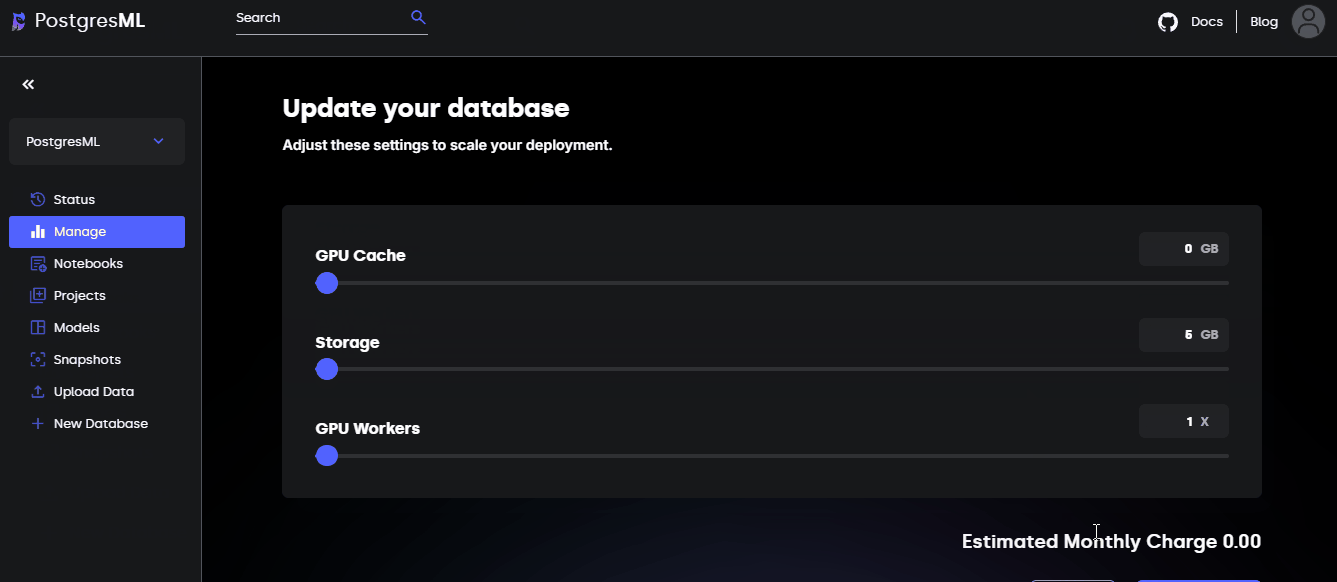
Si vas a la sección «Manage», podrás escalar tu entorno según tus necesidades de cómputo:
Como su nombre indica, necesitamos tener PostgreSQL instalado en nuestro sistema para usar PostgresML. Si no sabes qué es Postgres, es la base de datos open source más avanzada del mundo (eso dicen en su web).
Aquí tienes guías específicas por plataforma para instalar PostgreSQL:
Yo estoy en WSL2, así que puedo hacer:
$ sudo apt update
$ sudo apt install postgresql postgresql-contrib
$ sudo passwd postgres  # Set a new Postgres password
# Close and reopen your terminal and done!
Después, verifica la instalación con:
$ psql --version
psql (PostgreSQL) 12.18 (Ubuntu 12.18-0ubuntu0.20.04.1)
psql es el cliente oficial de Postgres para conectar y administrar bases de datos desde la terminal.
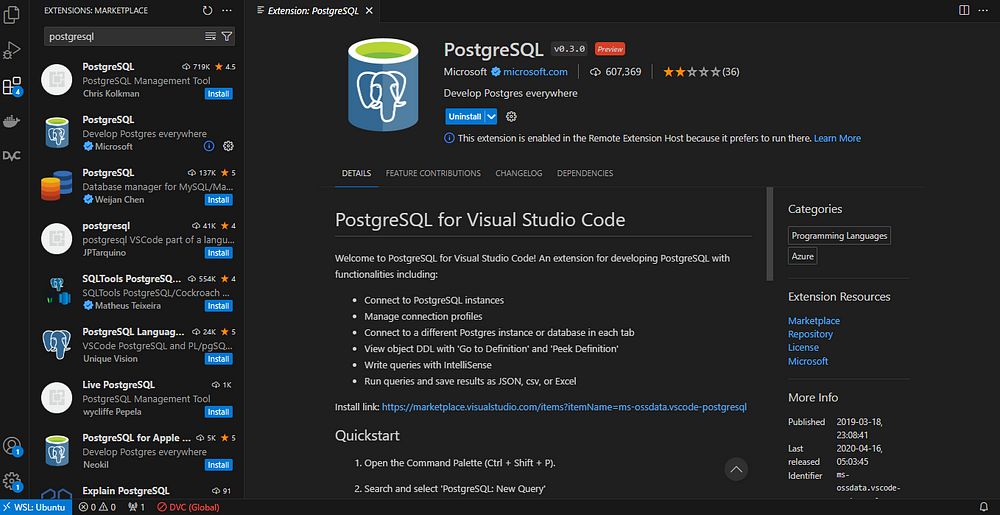
Entiendo que para mucha gente no es ideal ejecutar SQL en terminales «feas», así que también puedes instalar la siguiente extensión de VSCode después de instalar Postgres:
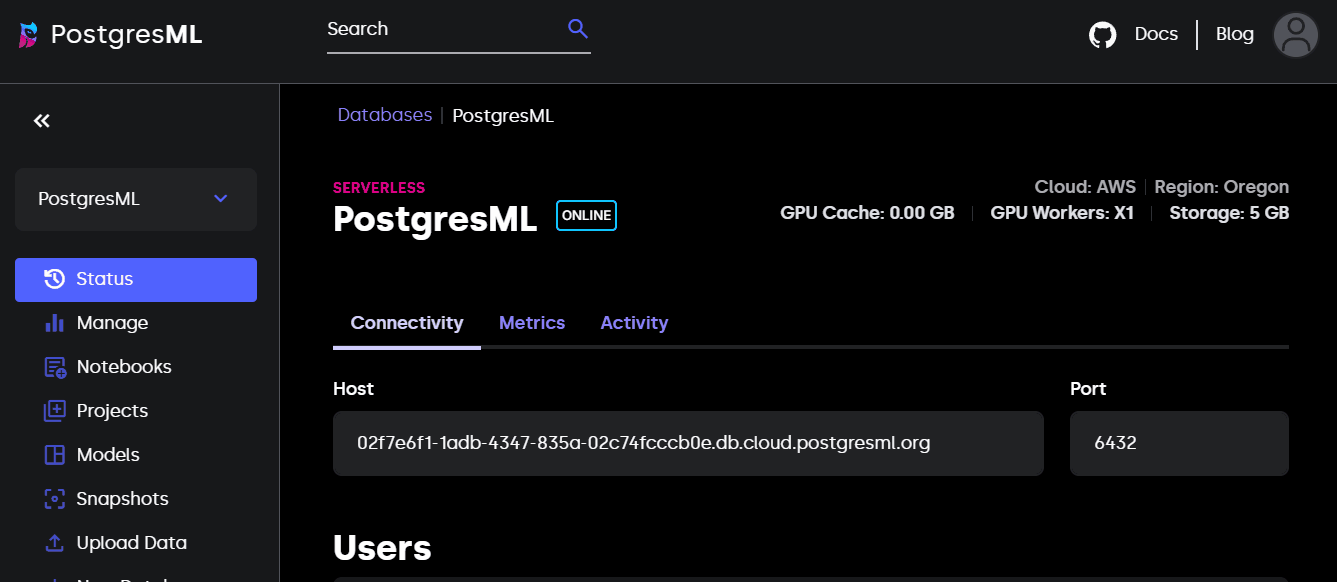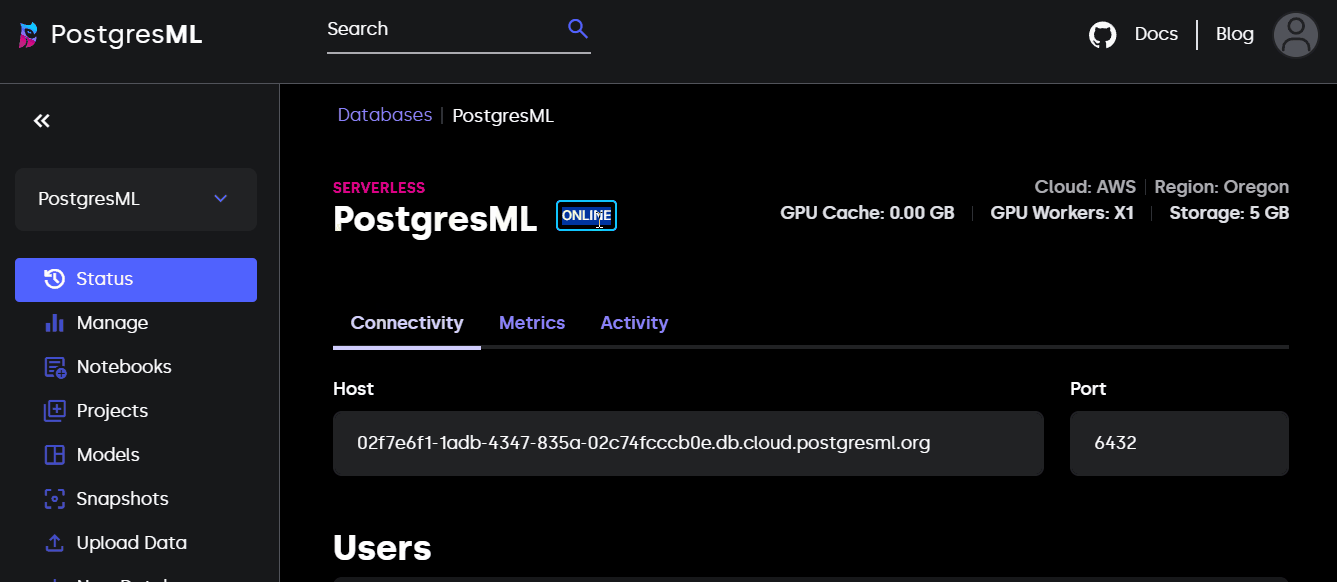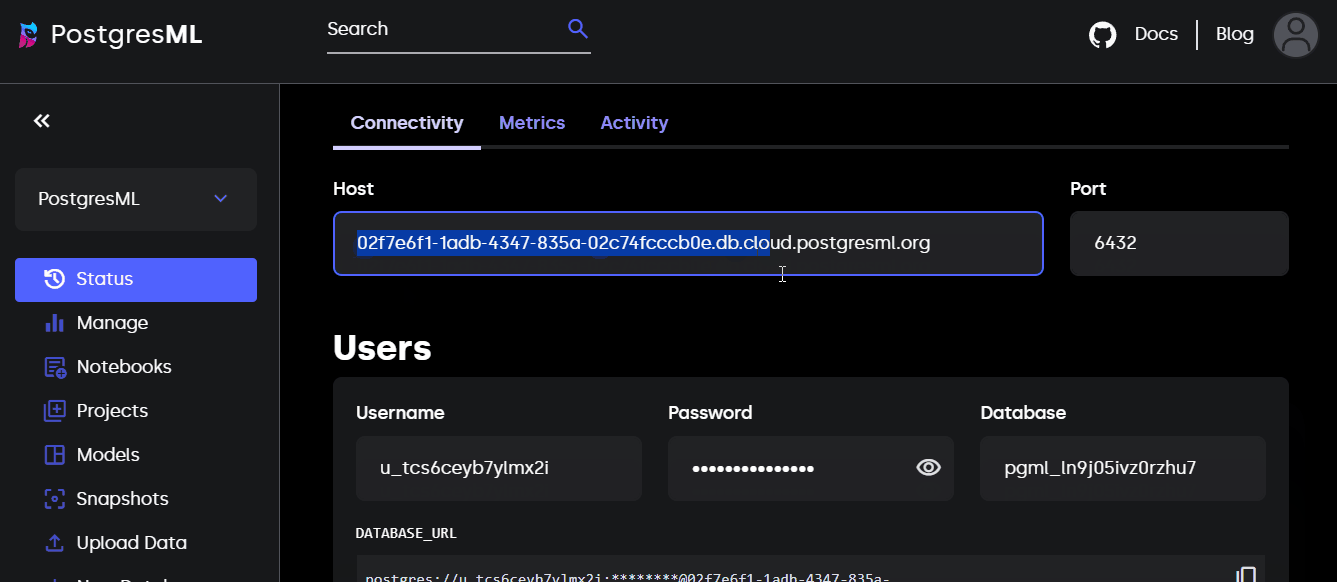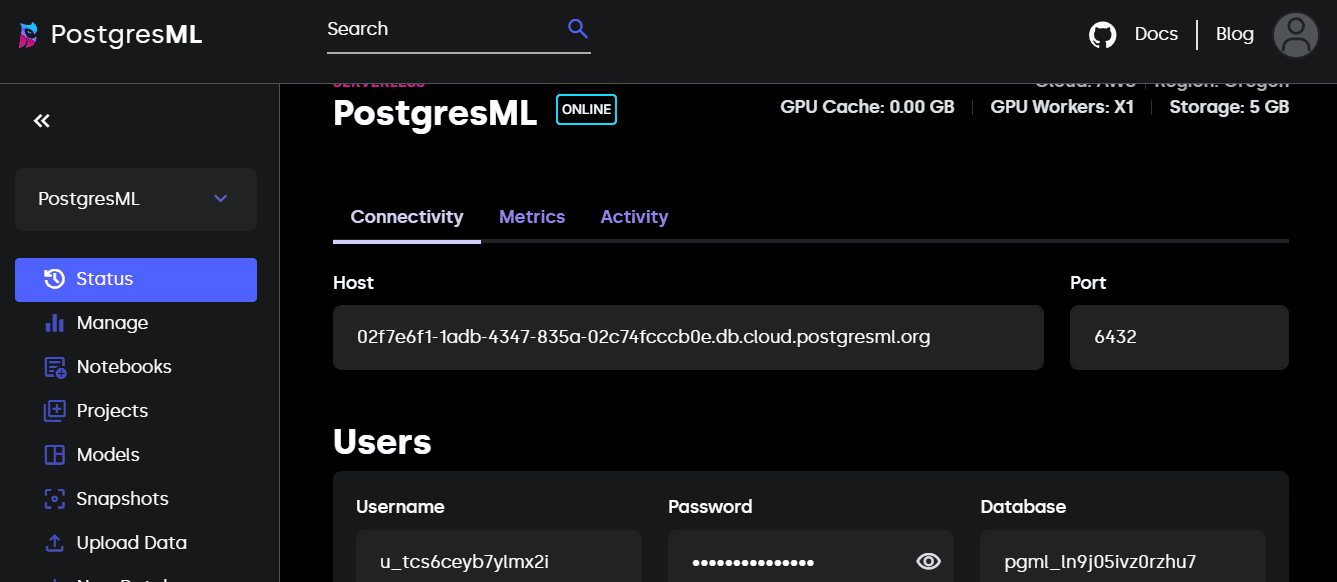
¿Recuerdas la página de inicio de tu consola de PostgresML? Déjala abierta en otra pestaña:
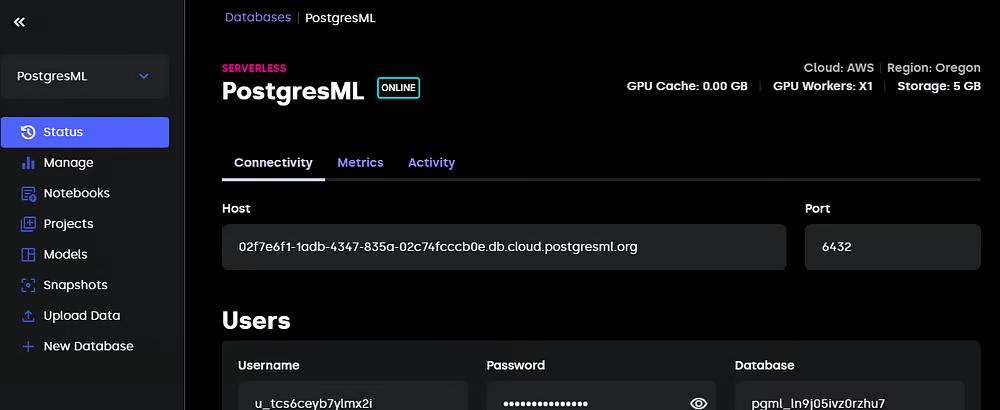
Ahora, usando psql, puedes escribir el siguiente comando con tus credenciales para establecer una conexión con el servidor de PostgresML:
$ psql -h "host" \
      -U "username" \
      -p 6432 \
      -d "database_name"
Si usas la extensión de VSCode, sigue estos pasos (tomados de la página de instalación de la extensión) para hacer lo mismo:
Y quedarás conectado a tu base de datos de PostgresML.
El siguiente paso es crear la extensión pgml que nos permitirá ejecutar funciones de PostgresML:
CREATE EXTENSION IF NOT EXISTS pgml;

NOTICE:  extension "pgml" already exists, skipping
CREATE EXTENSION
-- Your output may be different.
Comprueba que todo ha ido bien imprimiendo la versión de pgml:
SELECT pgml.version();

2.8.2 (98f114891db58acd472e068c44272b198274b11d)
Ahora, vamos a cargar algunos datos en nuestra base. Para mantenerlo simple, crearemos una única tabla usando el conjunto de datos Diamonds de Kaggle. Puedes descargarlo como CSV desde la web o con el siguiente fragmento en Python:
import seaborn as sns

diamonds = sns.load_dataset("diamonds")
diamonds.to_csv("diamonds.csv", index=False)
Luego, ejecuta el siguiente comando CREATE con el esquema correcto:
CREATE TABLE IF NOT EXISTS diamonds (
   index SERIAL PRIMARY KEY,
   carat FLOAT,
   cut VARCHAR(255),
   color VARCHAR(255),
   clarity VARCHAR(255),
   depth FLOAT,
   table_ FLOAT,
   price INT,
   x FLOAT,
   y FLOAT,
   z FLOAT
)
El comando creará una tabla llamada diamonds que podemos rellenar con las filas del archivo CSV:
INSERT INTO diamonds
   (carat, cut, color, clarity, depth, table_, price, x, y, z)
   FROM '~/full/path/to/diamonds.csv'
   DELIMITER ','
   CSV HEADER;
Por último, imprimimos la cabecera de la tabla para confirmar que el último comando se ejecutó correctamente:
SELECT * FROM diamonds
LIMIT 10;
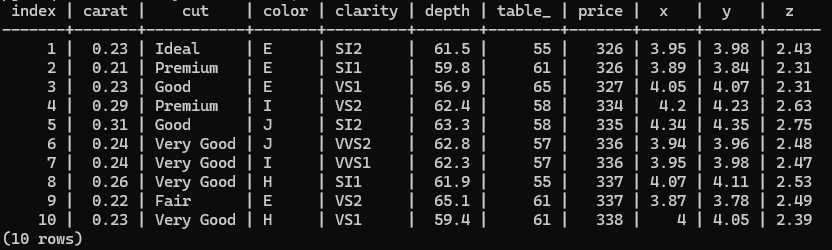
¡Listo, ya podemos entrenar un modelo!
Entrenar un modelo de machine learning para aprendizaje supervisado se hace con la función pgml.train. Esta es su estructura básica:
SELECT pgml.train(
 project_name => 'Diamond prices prediction',
 task => 'regression',
 relation_name => 'diamonds',
 y_column_name => 'price',
 algorithm => 'xgboost'
);
La sentencia anterior ajusta un regresor XGBoost a la tabla diamonds para predecir precios de diamantes. Verás que el comando es muy rápido (casi instantáneo) a pesar de tener más de 50k filas.
También puedes cambiar de tarea fácilmente. Así es como ajustas un clasificador multiclase (no olvides cambiar el nombre del proyecto):
SELECT pgml.train(
 project_name => 'Diamond cut quality prediction',
 task => 'classification',
 relation_name => 'diamonds',
 y_column_name => 'cut',
 algorithm => 'xgboost',
 test_size => 0.1
);
Fíjate en que esta vez especificamos el argumento test_size; también se admiten particiones personalizadas.
Además, hemos cambiado el algoritmo por defecto (linear) a xgboost, pero podría haber sido cualquier otro modelo de Scikit-learn u otro framework compatible.
Vamos a probar a ajustar ahora un modelo de random forest:
…
¡Un momento! El conjunto diamonds tiene variables de texto que hay que codificar. Como XGBoost codifica categóricas de forma nativa, no recibimos errores en las consultas anteriores. Puede que no sea el caso con random forests. Así que añadamos algunos pasos de preprocesado a nuestra consulta:
SELECT pgml.train(
   project_name => 'Diamond prices prediction',
   task => 'regression',
   relation_name => 'diamonds',
   y_column_name => 'price',
   algorithm => 'random_forest',
   preprocess => '{
       "carat": {"scale": "standard"},
       "depth": {"scale": "standard"},
       "table_": {"scale": "standard"},
       "cut": {"encode": "target", "scale": "standard"},
       "color": {"encode": "target", "scale": "standard"},
       "clarity": {"encode": "target", "scale": "standard"}
   }'::JSONB
);
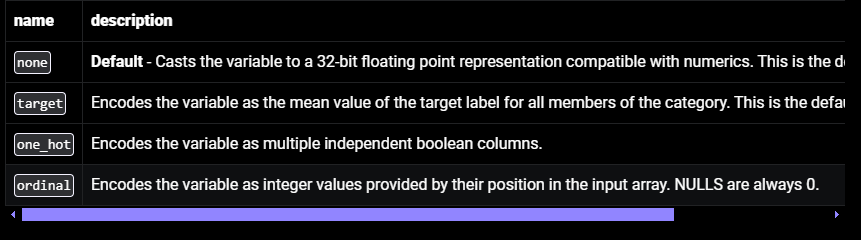
La lógica de preprocesamiento se define dentro de un objeto JSONB que mapea columnas con pasos de transformación. Para las numéricas, usamos estandarización (aunque no sea imprescindible para RF). Para las categóricas, usamos target encoding y luego estandarización.
PostgresML ofrece otras funciones de preprocesamiento alternativas. Aquí tienes la lista completa de opciones de codificación disponibles:
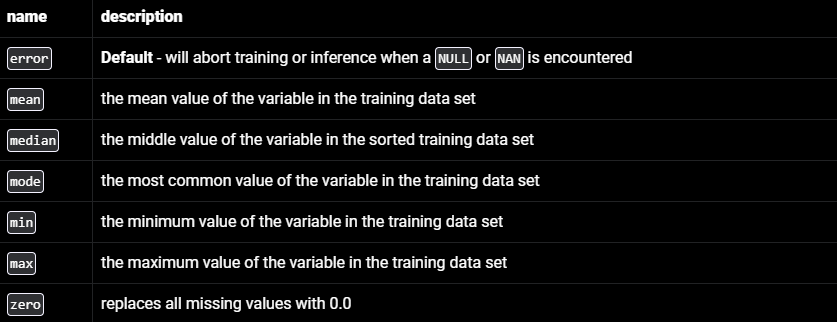
pgml también admite técnicas estándar de imputación:
Y esta es la lista de escalados disponibles:
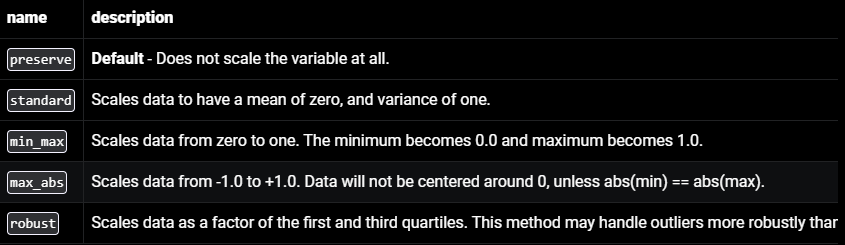
Aunque no tienes un abanico tan amplio como en Scikit-learn, esto será suficiente para la mayoría de tareas de aprendizaje supervisado.
Hasta ahora hemos usado los parámetros por defecto. Sin embargo, casi nunca son la mejor opción en problemas reales. Para definir valores personalizados, podemos usar el argumento hyperparams de pgml.train:
SELECT pgml.train(
   project_name => 'Diamond prices prediction',
   task => 'regression',
   relation_name => 'diamonds',
   y_column_name => 'price',
   algorithm => 'xgboost',
   hyperparams => '{
       "n_estimators": 1000, "max_depth": 5, "eta": 0.01, "subsample": 0.7
   }'::JSONB
);
Esta vez ajustamos un regresor XGBoost con 1000 árboles, una profundidad máxima de 5 y una tasa de aprendizaje de 0.01. Ahora mismo estamos «disparando a ciegas», así que estos hiperparámetros pueden no dar los mejores resultados.
Para exprimir el modelo al máximo, siempre necesitamos ajustar hiperparámetros en tareas supervisadas. Este proceso también está soportado en pgml dentro de la función train. Así haces una búsqueda en cuadrícula sobre una pequeña selección de combinaciones:
SELECT pgml.train(
   'Diamond prices prediction',
   algorithm => 'xgboost',
   search => 'grid',
   search_params => '{
       "max_depth": [5, 7],
       "n_estimators": [1000, 1500],
       "eta": [0.1, 0.01, 0.001]
   }'::JSONB
);
Llegados a este punto, quiero que valores lo que estamos haciendo. ¡Estamos ajustando los hiperparámetros de un regresor XGBoost usando SQL! Jamás pensé que escribiría esa frase.
En el momento de escribir este tutorial, PostgresML aún no dispone de herramientas de evaluación lo bastante maduras. Solo tenemos disponible la función predict. Así la usas para predecir sobre una muestra individual nueva:
SELECT pgml.predict(
   project_name => 'Diamond prices prediction',
   features => ARRAY[0.7, "Ideal", "A", "IF", 67.9, 56.9, 7024, 5.85, 5.87, 3.71]
);
predict utiliza automáticamente el mejor modelo de tus experimentos. En regresión, será el modelo con mayor R-cuadrado; en clasificación, el de mayor F1.
Para usar un modelo concreto en la predicción, puedes indicar su ID:
SELECT pgml.predict(
  2' -- Use model with ID of 2,
   features => ARRAY[0.7, "Ideal", "A", "IF", 67.9, 56.9, 7024, 5.85, 5.87, 3.71]
)
¿Y cómo encuentras los IDs de los modelos? Aquí tienes un snippet que imprime una tabla con exactamente esa información:
SELECT models.id, models.algorithm, models.metrics
FROM pgml.models
JOIN pgml.projects
 ON projects.id = models.project_id
WHERE projects.name = 'Diamond prices prediction';
Con esta sentencia puedes descubrir muchas variables y métricas de pgml como models.id, pgml.models, pgml.projects, etc. Prueba sentencias SELECT sobre ellas para hacerte una idea de lo que ofrecen.
A diferencia del MLOps tradicional, este paso es el más fácil en PostgresML. La extensión pgml expone automáticamente el mejor modelo de tus experimentos como predeterminado. Así, cualquier sentencia SELECT pgml.predict que los usuarios envíen al servidor usará ese modelo para inferencia.
Si quieres un control más fino sobre qué modelo pasa a producción, puedes gestionarlo con la función pgml.deploy. Esta es su estructura:
SELECT * FROM pgml.deploy(
   project_name TEXT,
   strategy TEXT DEFAULT 'best_score',
   algorithm TEXT DEFAULT NULL
)
Además de best_score, también existen las estrategias de despliegue most_recent y rollback:
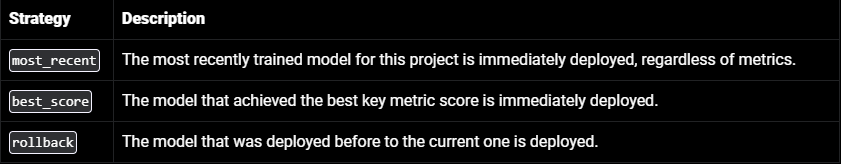
Combinando los parámetros strategy y algorithm, puedes acotar aún más el despliegue. Por ejemplo, la sentencia siguiente despliega el mejor modelo de XGBoost, no el mejor de todo el proyecto.
SELECT * FROM pgml.deploy(
   project_name => 'Diamond prices prediction',
   strategy => 'best_score',
   algorithm => 'xgboost'
)
El aprendizaje supervisado es solo una parte de PostgresML. De hecho, toda su propuesta de valor es «construir aplicaciones de IA en Postgres». Para demostrarlo, incluso han puesto un pequeño editor SQL en la página de inicio:
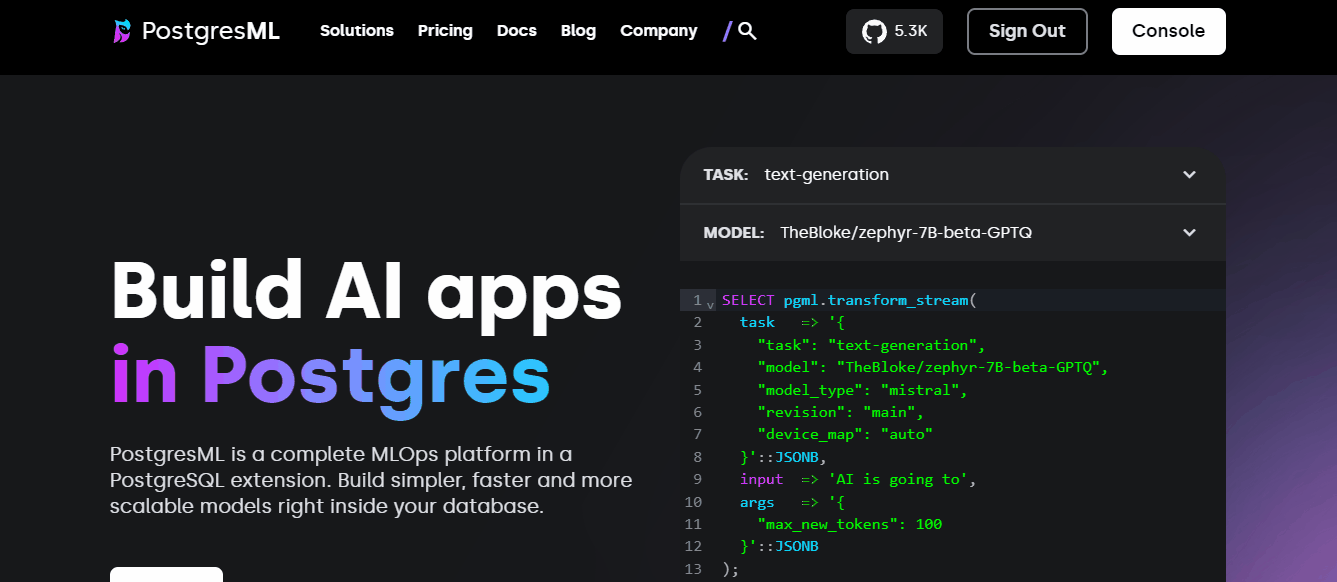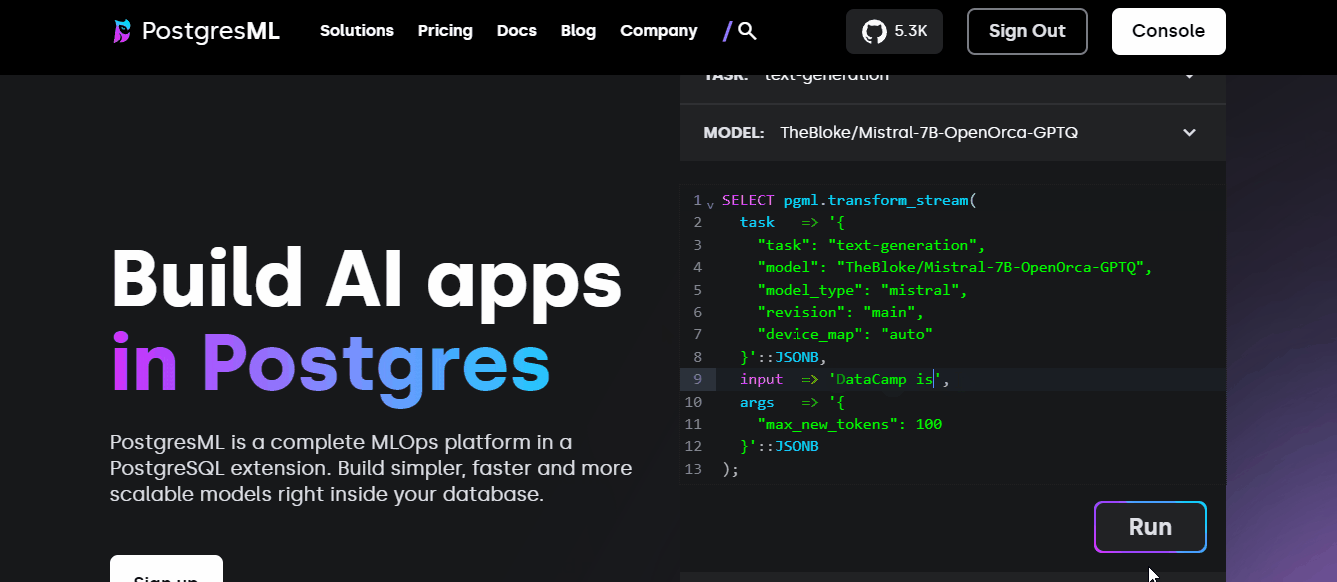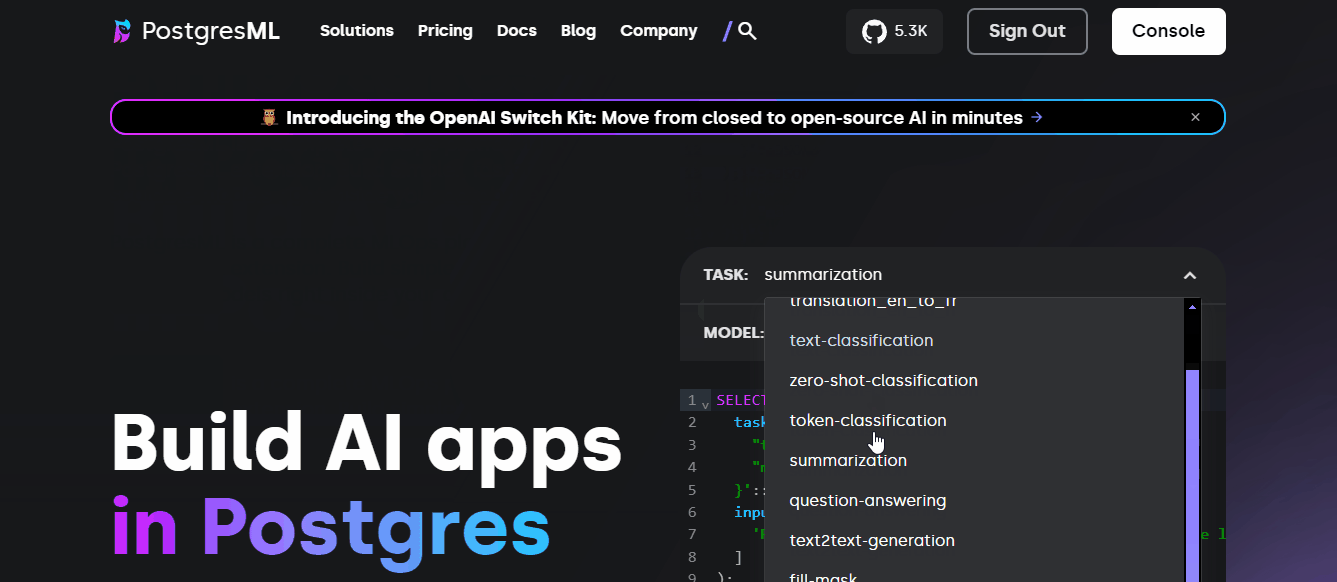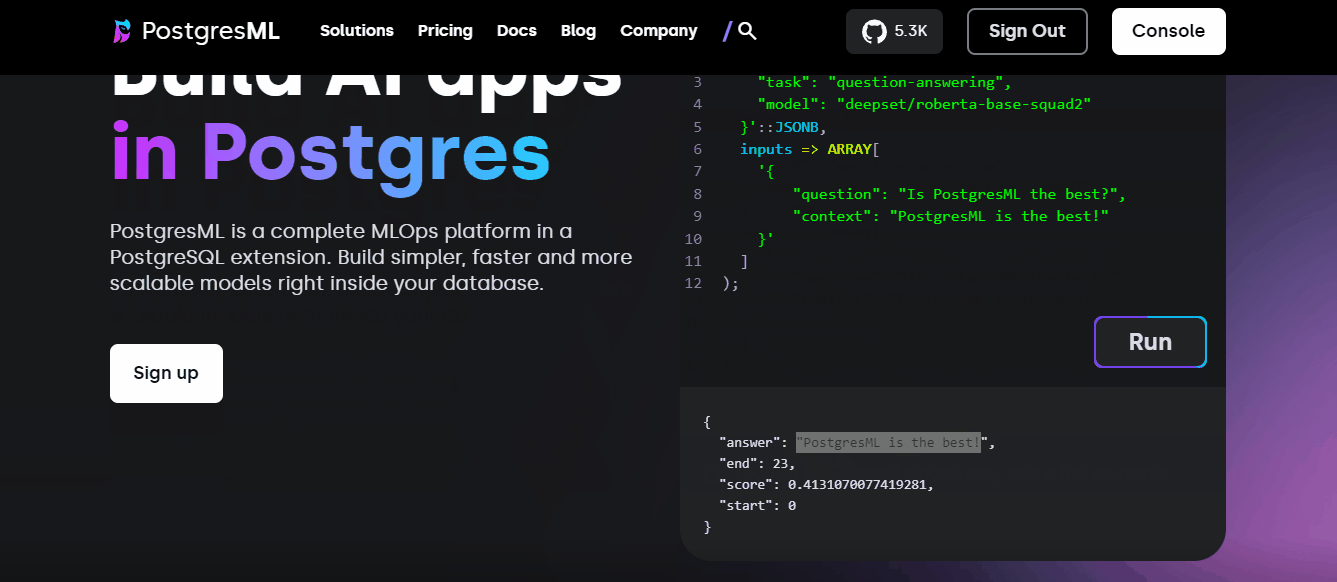
¡Puedes ejecutar esos ejemplos directamente en el entorno que has usado en este tutorial!
Entonces, si quisieras crear un servicio de machine learning para usuarios finales con PostgresML, ¿cómo lo harías? Aquí tienes algunos pasos posibles (una vez tengas el modelo listo):
psycopg2 (Python) o pg-promise (JavaScript) para conectar con tu base de datos PostgresML.pgml.predict.Es un esquema general que puede variar bastante según el caso de uso.
PostgresML introduce un paradigma completamente nuevo en machine learning, así que dominarlo requiere algo más que un solo tutorial. Para afianzar lo aprendido y explorar otros usos, lee la sección de casos de uso de la documentación de PostgresML.
Si tienes el SQL un poco oxidado, puedes hacer el curso corto de DataCamp sobre creación de bases de datos PostgreSQL o incluso todo el itinerario profesional de Data Analyst in SQL.
Como PostgresML se centra mucho en IA, también puedes aprender algunos fundamentos de IA:
¡Continúa hoy tu viaje en IA!
Curso
programa
programa
blog
Abid Ali Awan
15 min
Tutorial
Moez Ali
10 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Elena Kosourova
8 min
Tutorial
Sejal Jaiswal
15 min