
Cours
Concepts des grands modèles de langage (LLM)
2 h
109.8K
La tendance dominante en machine learning consiste à déplacer les données vers l’environnement du modèle pour l’entraînement. Et si l’on faisait l’inverse ? Puisque les bases de données actuelles sont bien plus volumineuses que les modèles de machine learning, ne serait-il pas plus simple d’amener les modèles au plus près des jeux de données ?
C’est l’idée au cœur de PostgresML — les données restent en place, vous amenez votre code dans la base. Cette approche de machine learning « inversée » offre de nombreux avantages concrets qui vous feront reconsidérer la notion même de « base de données ».
PostgresML est une plateforme de machine learning complète bâtie sur la base de données PostgreSQL. Elle introduit un nouveau paradigme, le machine learning « in-database », qui permet d’effectuer de nombreuses tâches de ML en SQL sans multiplier les outils à chaque étape.
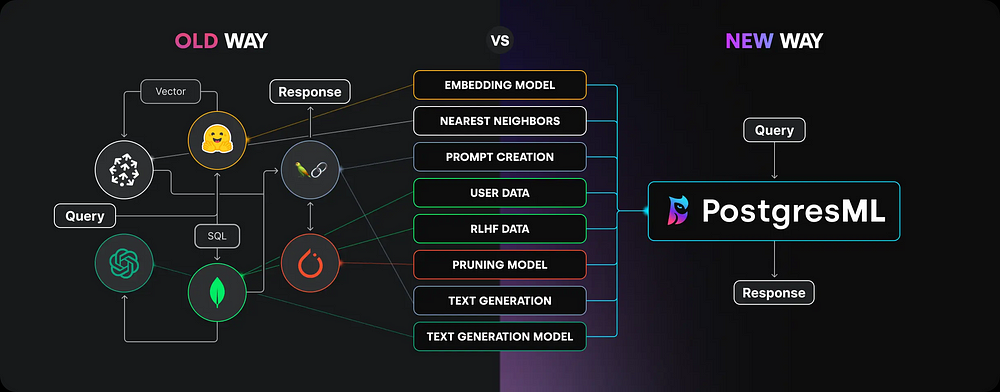
Même si le projet est relativement récent, PostgresML annonce des bénéfices clairs :
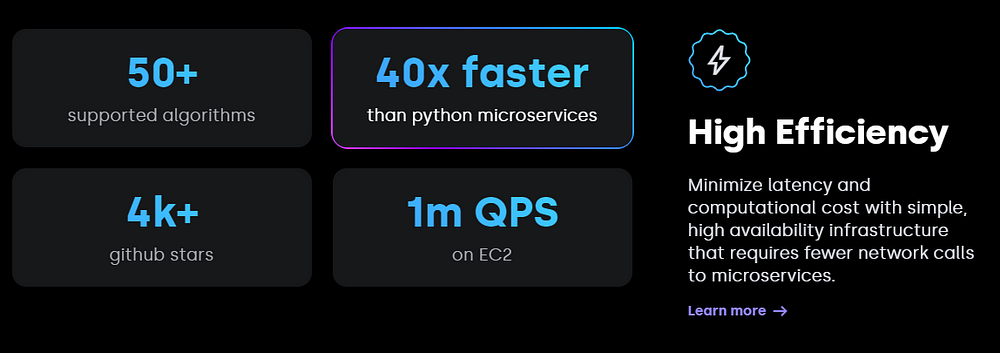
Nous allons tester toutes ces fonctionnalités dans ce tutoriel en suivant un flux de travail type en machine learning :
... le tout dans une base Postgres. C’est parti !
Commencez par créer un compte gratuit sur https://postgresml.org/signup :
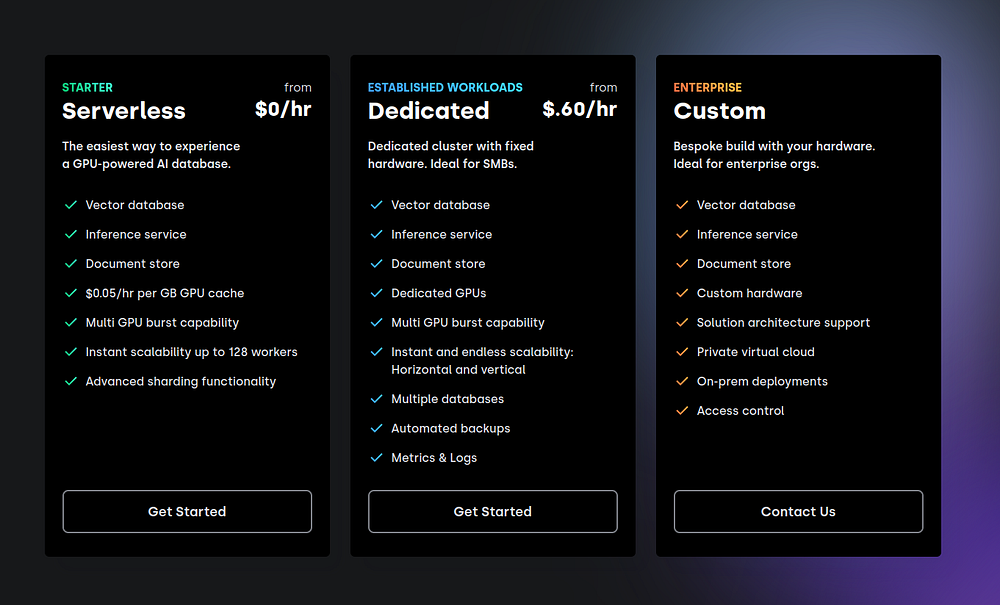
Ensuite, choisissez l’offre gratuite, qui propose des ressources généreuses :
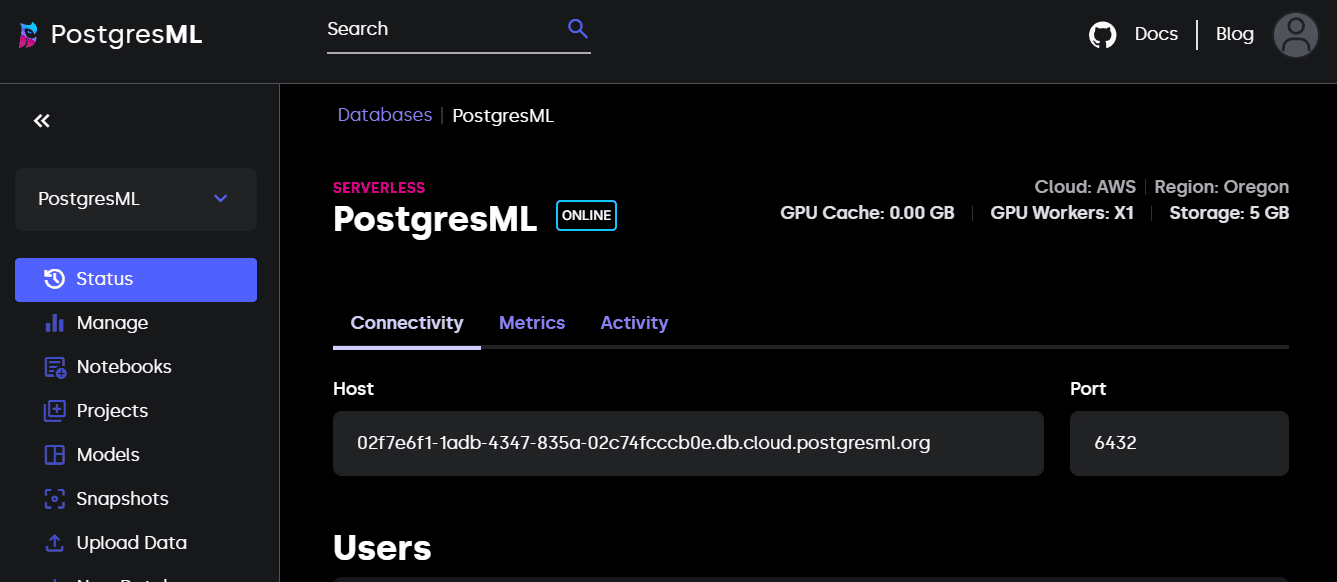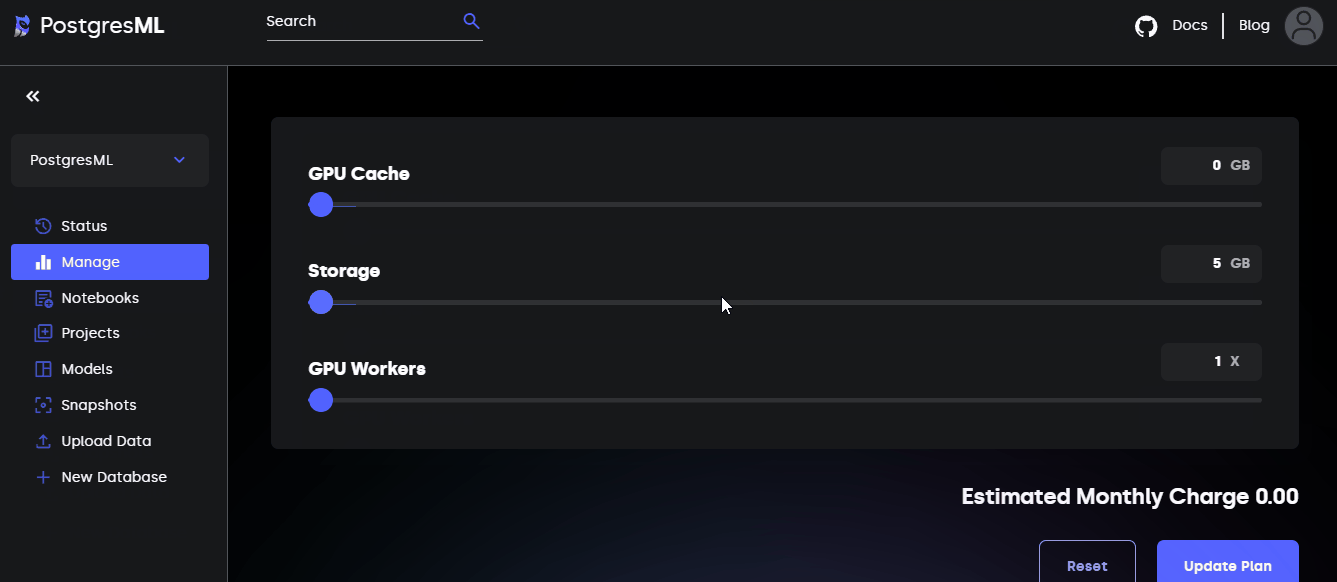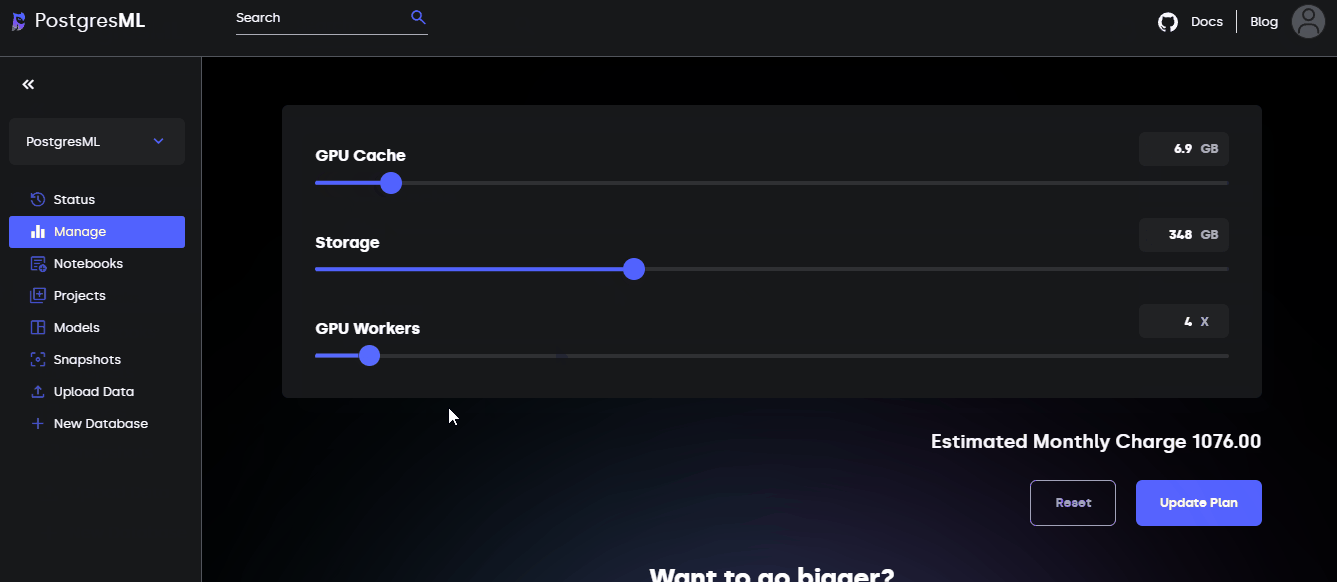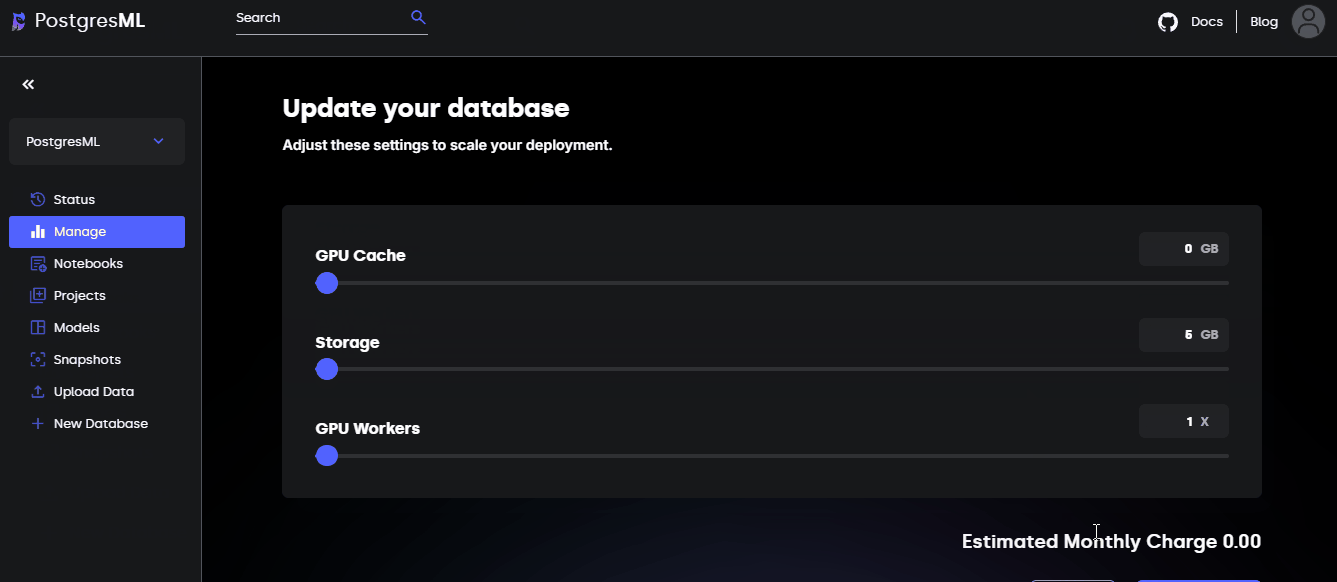
Après l’inscription, vous arriverez sur votre console PostgresML. C’est là que vous gérez vos projets de « ML in-database » et leurs ressources associées.
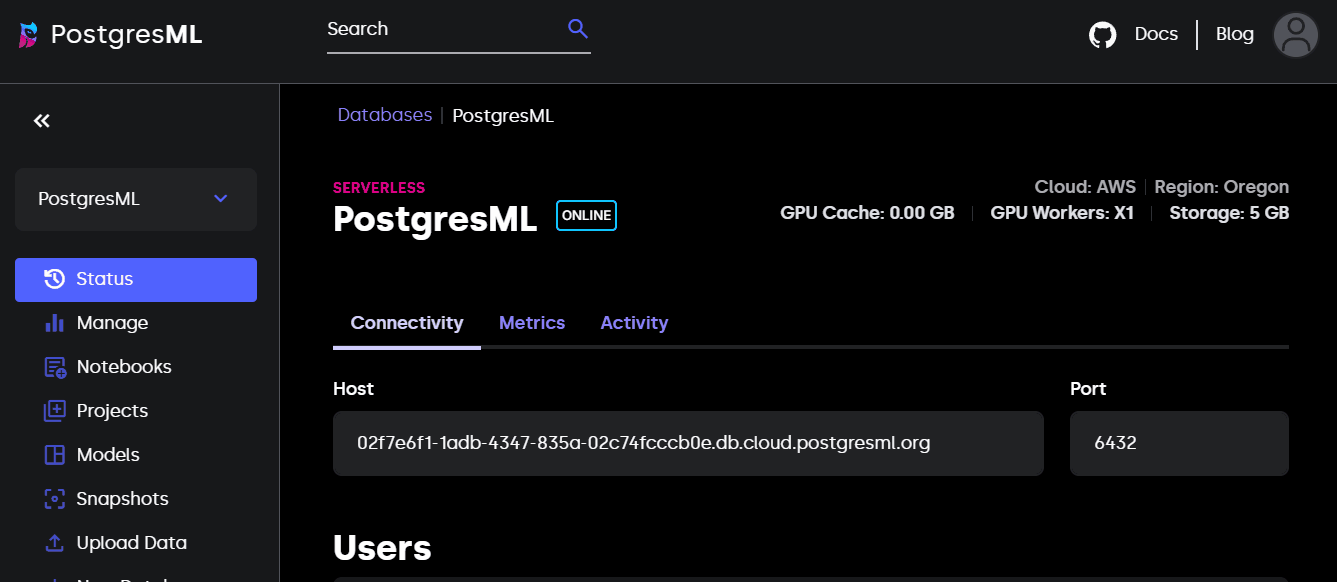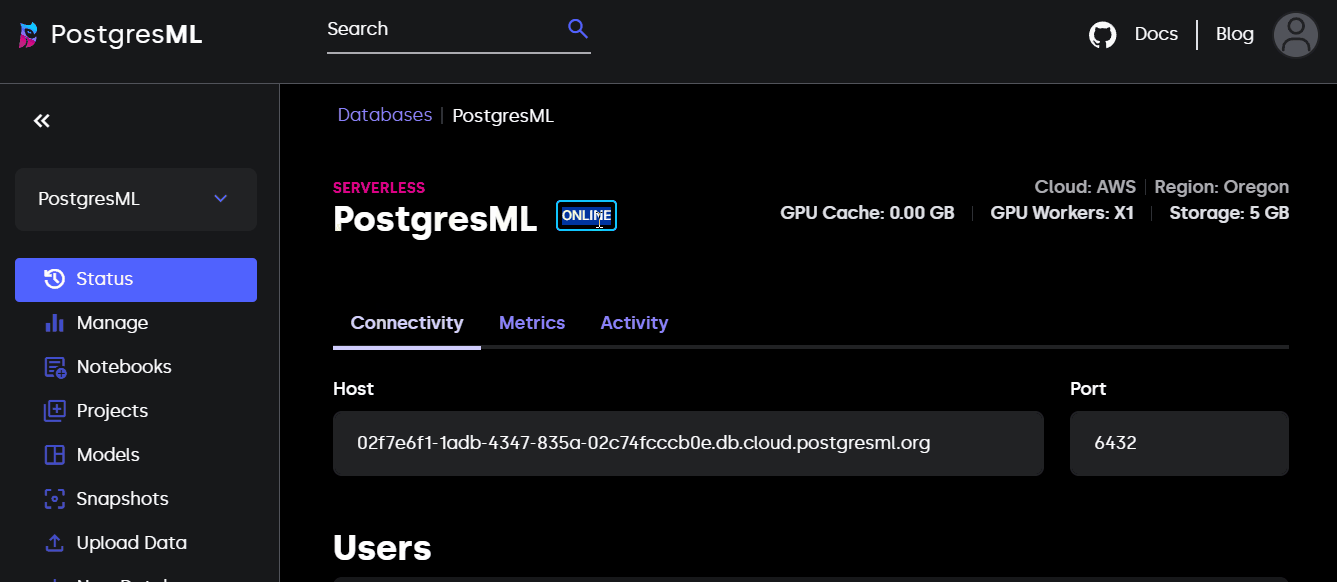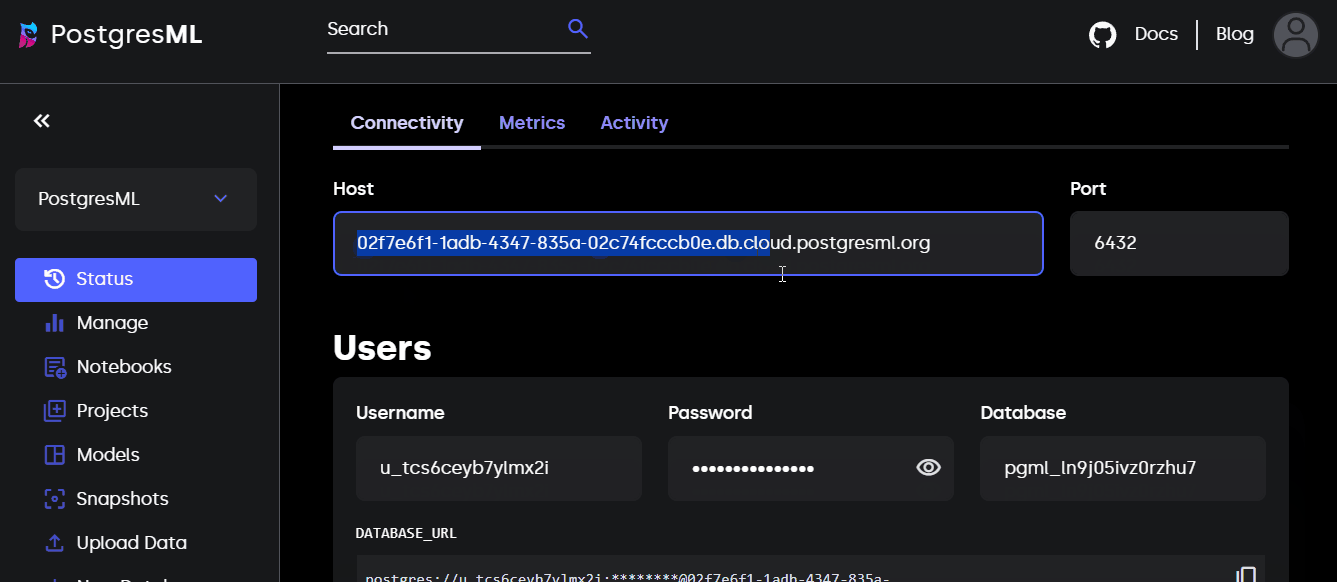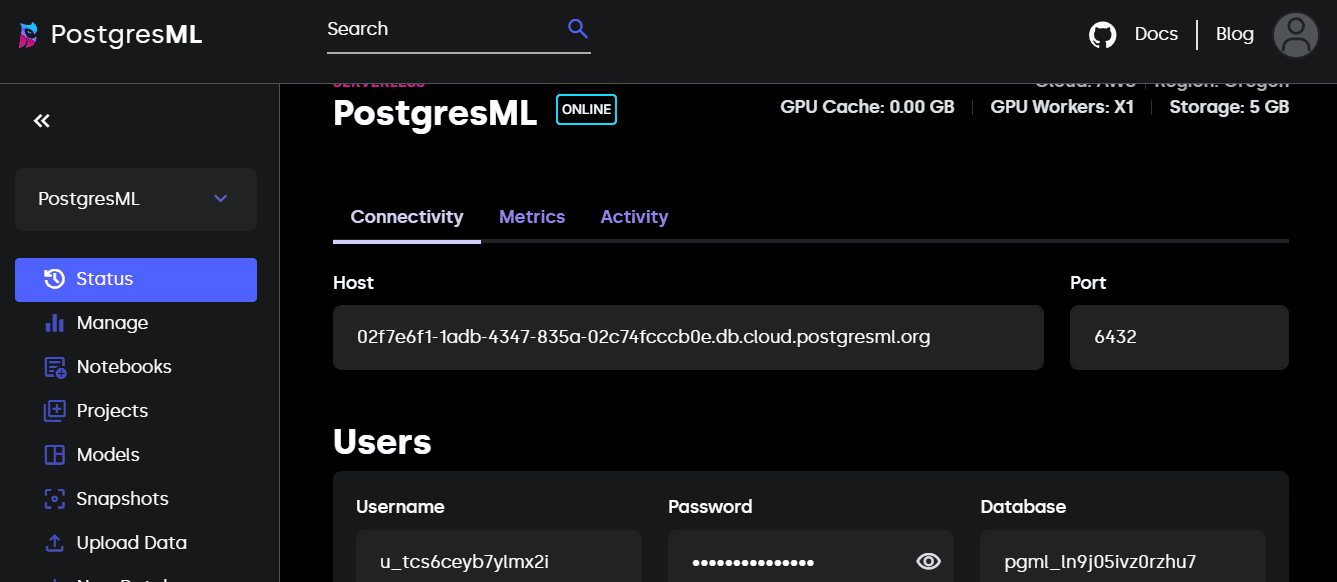
Dans la section « Manage », vous pourrez faire évoluer votre environnement selon vos besoins de calcul :
Comme son nom l’indique, nous avons besoin de PostgreSQL pour utiliser PostgresML. Si vous ne connaissez pas Postgres, c’est la base de données open-source la plus avancée (dixit leur site).
Voici des guides d’installation spécifiques à chaque plateforme :
Je suis sous WSL2, je peux donc simplement exécuter :
$ sudo apt update
$ sudo apt install postgresql postgresql-contrib
$ sudo passwd postgres  # Définir un nouveau mot de passe Postgres
# Fermez et réouvrez votre terminal, et c’est bon !
Ensuite, vérifiez l’installation avec :
$ psql --version
psql (PostgreSQL) 12.18 (Ubuntu 12.18-0ubuntu0.20.04.1)
psql est le client Postgres officiel pour se connecter et administrer les bases depuis le terminal.
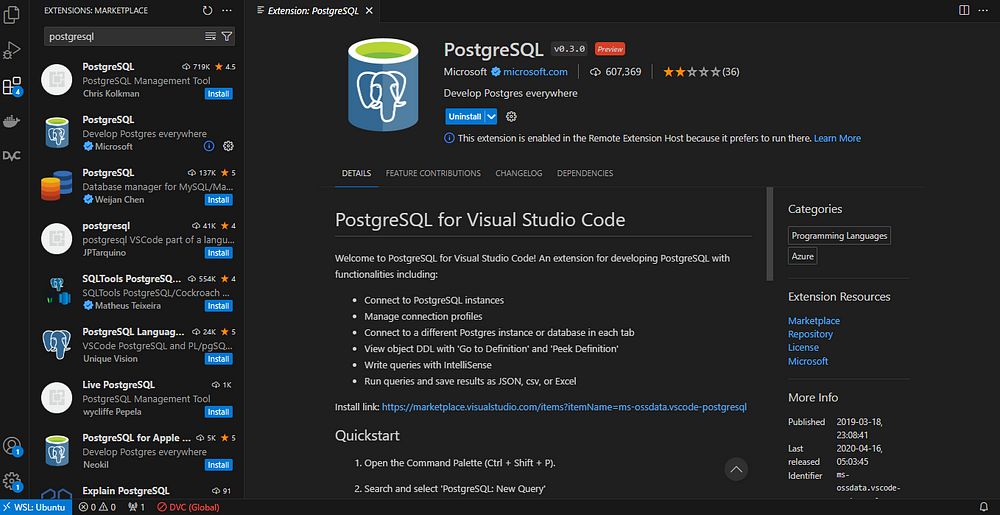
Je comprends que pour beaucoup, taper du SQL dans un terminal peu engageant n’est pas idéal : vous pouvez aussi installer cette extension VS Code après avoir installé Postgres :
Souvenez-vous de la page d’accueil de votre console PostgresML. Gardez-la ouverte dans un autre onglet :
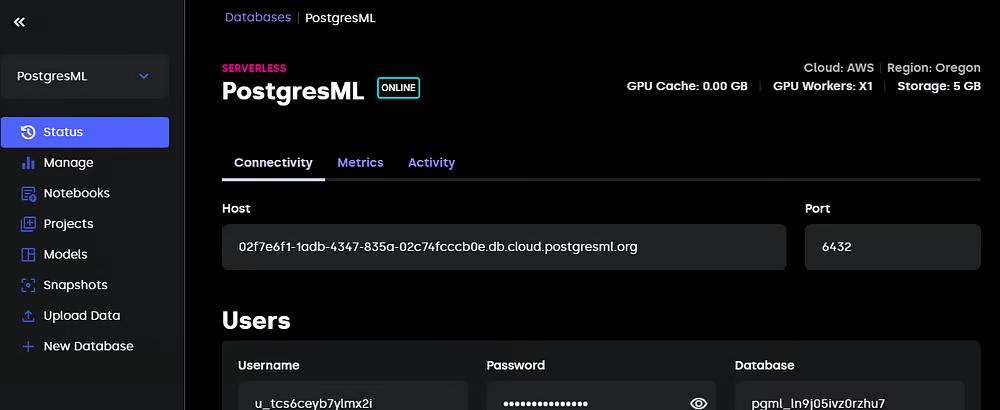
Maintenant, avec psql, vous pouvez saisir la commande suivante en remplaçant par vos identifiants pour établir la connexion au serveur PostgresML :
$ psql -h "host" \
      -U "username" \
      -p 6432 \
      -d "database_name"
Si vous utilisez l’extension VS Code, suivez ces étapes (issues de la page d’installation de l’extension) pour faire la même chose :
Vous serez alors connecté à votre base PostgresML.
La prochaine étape consiste à créer l’extension pgml qui nous permettra d’exécuter les fonctions PostgresML :
CREATE EXTENSION IF NOT EXISTS pgml;

NOTICE:  extension "pgml" already exists, skipping
CREATE EXTENSION
-- Votre sortie peut différer.
Vérifiez que tout est en place en affichant la version de pgml :
SELECT pgml.version();

2.8.2 (98f114891db58acd472e068c44272b198274b11d)
Chargeons des données dans notre base. Pour rester simple, nous allons créer une seule table à partir du jeu de données Diamonds de Kaggle. Vous pouvez le télécharger en CSV depuis le site ou via l’extrait Python ci-dessous :
import seaborn as sns

diamonds = sns.load_dataset("diamonds")
diamonds.to_csv("diamonds.csv", index=False)
Ensuite, exécutez la commande CREATE suivante avec le schéma adéquat :
CREATE TABLE IF NOT EXISTS diamonds (
   index SERIAL PRIMARY KEY,
   carat FLOAT,
   cut VARCHAR(255),
   color VARCHAR(255),
   clarity VARCHAR(255),
   depth FLOAT,
   table_ FLOAT,
   price INT,
   x FLOAT,
   y FLOAT,
   z FLOAT
)
La commande crée une table nommée diamonds que nous pouvons alimenter avec les lignes du CSV :
INSERT INTO diamonds
   (carat, cut, color, clarity, depth, table_, price, x, y, z)
   FROM '~/full/path/to/diamonds.csv'
   DELIMITER ','
   CSV HEADER;
Enfin, affichons le début de la table pour confirmer la bonne exécution de la commande précédente :
SELECT * FROM diamonds
LIMIT 10;
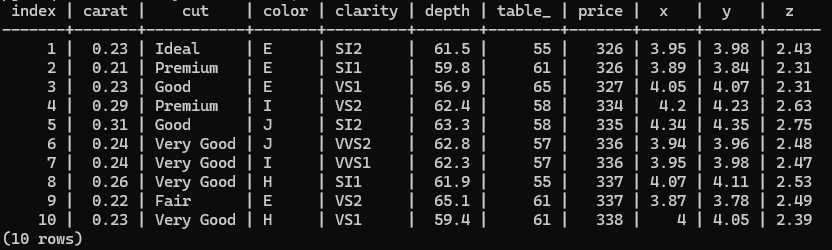
Nous sommes prêts à entraîner un modèle !
L’entraînement d’un modèle supervisé se fait via la fonction pgml.train. Voici sa structure minimale :
SELECT pgml.train(
 project_name => 'Diamond prices prediction',
 task => 'regression',
 relation_name => 'diamonds',
 y_column_name => 'price',
 algorithm => 'xgboost'
);
Cette requête ajuste un régresseur XGBoost sur la table diamonds pour prédire le prix des diamants. Vous remarquerez la rapidité d’exécution (quasi instantanée) malgré plus de 50 000 lignes.
Vous pouvez aussi changer de tâche très facilement. Voici comment ajuster un classifieur multi-classes (n’oubliez pas de modifier le nom du projet) :
SELECT pgml.train(
 project_name => 'Diamond cut quality prediction',
 task => 'classification',
 relation_name => 'diamonds',
 y_column_name => 'cut',
 algorithm => 'xgboost',
 test_size => 0.1
);
Notez que nous spécifions cette fois l’argument test_size : les découpages personnalisés sont pris en charge !
Nous avons également remplacé l’algorithme par défaut linear par xgboost, mais cela pourrait être n’importe quel autre modèle de Scikit-learn ou d’un framework supporté.
Essayons cette fois d’entraîner une forêt aléatoire :
…
Mais attendez ! Le jeu de données diamonds contient des variables textuelles à encoder. XGBoost gérant nativement les catégorielles, les requêtes précédentes n’ont pas levé d’erreur. Ce ne sera pas forcément le cas avec les forêts aléatoires. Ajoutons donc des étapes de prétraitement à notre requête :
SELECT pgml.train(
   project_name => 'Diamond prices prediction',
   task => 'regression',
   relation_name => 'diamonds',
   y_column_name => 'price',
   algorithm => 'random_forest',
   preprocess => '{
       "carat": {"scale": "standard"},
       "depth": {"scale": "standard"},
       "table_": {"scale": "standard"},
       "cut": {"encode": "target", "scale": "standard"},
       "color": {"encode": "target", "scale": "standard"},
       "clarity": {"encode": "target", "scale": "standard"}
   }'::JSONB
);
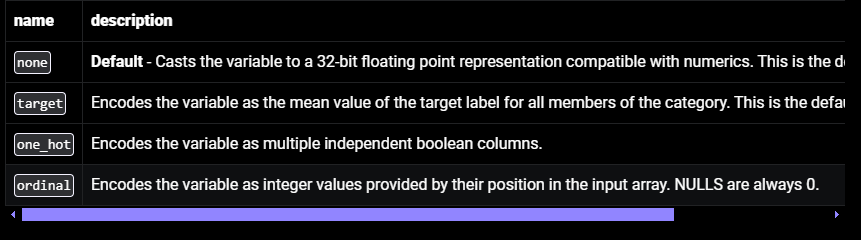
La logique de prétraitement est définie dans un objet JSONB qui associe chaque colonne à des transformations. Pour les variables numériques, nous utilisons une standardisation (même si elle n’est pas indispensable pour les forêts). Pour les catégorielles, nous appliquons un target encoding puis une standardisation.
PostgresML propose d’autres fonctions de prétraitement. Voici la liste des méthodes d’encodage disponibles :
pgml gère aussi les techniques classiques d’imputation :
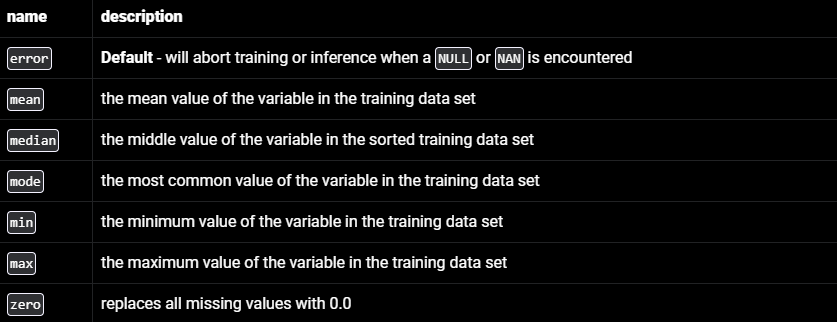
Et voici les échelles de normalisation :
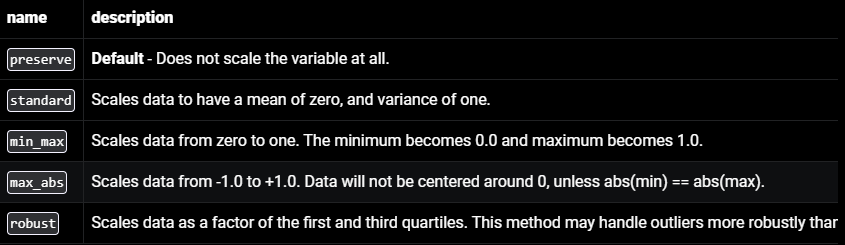
Même si l’offre est moins vaste que dans Scikit-learn, ces options couvrent la plupart des besoins en apprentissage supervisé.
Jusqu’ici, nous utilisions les paramètres par défaut des algorithmes. Or, ils sont rarement idéaux en production. Pour fixer des valeurs personnalisées, utilisez l’argument hyperparams de pgml.train :
SELECT pgml.train(
   project_name => 'Diamond prices prediction',
   task => 'regression',
   relation_name => 'diamonds',
   y_column_name => 'price',
   algorithm => 'xgboost',
   hyperparams => '{
       "n_estimators": 1000, "max_depth": 5, "eta": 0.01, "subsample": 0.7
   }'::JSONB
);
Ici, nous ajustons un régresseur XGBoost avec 1000 arbres, une profondeur maximale de 5 et un taux d’apprentissage de 0,01. Pour l’heure, c’est empirique : ces valeurs ne seront pas nécessairement optimales.
Pour tirer le meilleur d’un modèle supervisé, un tuning d’hyperparamètres s’impose. C’est aussi possible dans pgml via la fonction train. Voici comment réaliser une recherche en grille sur un petit ensemble de combinaisons :
SELECT pgml.train(
   'Diamond prices prediction',
   algorithm => 'xgboost',
   search => 'grid',
   search_params => '{
       "max_depth": [5, 7],
       "n_estimators": [1000, 1500],
       "eta": [0.1, 0.01, 0.001]
   }'::JSONB
);
Prenez un instant pour apprécier ce que nous faisons ici : nous ajustons les hyperparamètres d’un régresseur XGBoost en SQL ! Une phrase que je n’aurais jamais pensé écrire.
À la date de rédaction, PostgresML ne propose pas encore un outillage d’évaluation très poussé. Nous disposons surtout de la fonction predict. Voici comment l’utiliser pour prédire sur un échantillon unique :
SELECT pgml.predict(
   project_name => 'Diamond prices prediction',
   features => ARRAY[0.7, "Ideal", "A", "IF", 67.9, 56.9, 7024, 5.85, 5.87, 3.71]
);
predict utilise automatiquement le meilleur modèle issu de vos expériences. En régression, il s’agit de celui au meilleur R², tandis qu’en classification, c’est le meilleur F1-score.
Pour utiliser un modèle précis, vous pouvez indiquer son ID :
SELECT pgml.predict(
  2' -- Utiliser le modèle d'ID 2,
   features => ARRAY[0.7, "Ideal", "A", "IF", 67.9, 56.9, 7024, 5.85, 5.87, 3.71]
)
Comment retrouver les IDs des modèles ? Voici un extrait qui affiche un tableau récapitulatif avec ces informations :
SELECT models.id, models.algorithm, models.metrics
FROM pgml.models
JOIN pgml.projects
 ON projects.id = models.project_id
WHERE projects.name = 'Diamond prices prediction';
Avec cette requête, vous pouvez découvrir de nombreuses variables et métriques proposées par pgml comme models.id, pgml.models, pgml.projects, etc. Testez des instructions SELECT dessus pour vous familiariser.
Contrairement au MLOps traditionnel, cette étape est la plus simple avec PostgresML. L’extension pgml expose automatiquement le meilleur modèle de vos expériences comme modèle par défaut. Ainsi, toute instruction SELECT pgml.predict envoyée au serveur utilisera ce modèle pour l’inférence.
Si vous souhaitez contrôler plus finement quel modèle part en production, utilisez la fonction pgml.deploy. Voici sa structure :
SELECT * FROM pgml.deploy(
   project_name TEXT,
   strategy TEXT DEFAULT 'best_score',
   algorithm TEXT DEFAULT NULL
)
Outre best_score, il existe également les stratégies most_recent et rollback :
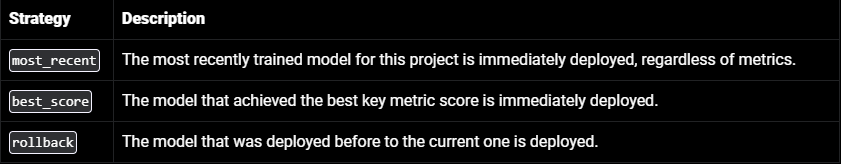
En combinant les paramètres strategy et algorithm, vous pouvez affiner encore le déploiement. Par exemple, la requête ci-dessous déploie le meilleur modèle XGBoost, et non le meilleur modèle du projet au global.
SELECT * FROM pgml.deploy(
   project_name => 'Diamond prices prediction',
   strategy => 'best_score',
   algorithm => 'xgboost'
)
L’apprentissage supervisé n’est qu’une petite partie de PostgresML. La proposition de valeur centrale est : « construire des applications d’IA dans Postgres ». Pour le démontrer, ils proposent même un petit éditeur SQL sur la page d’accueil :
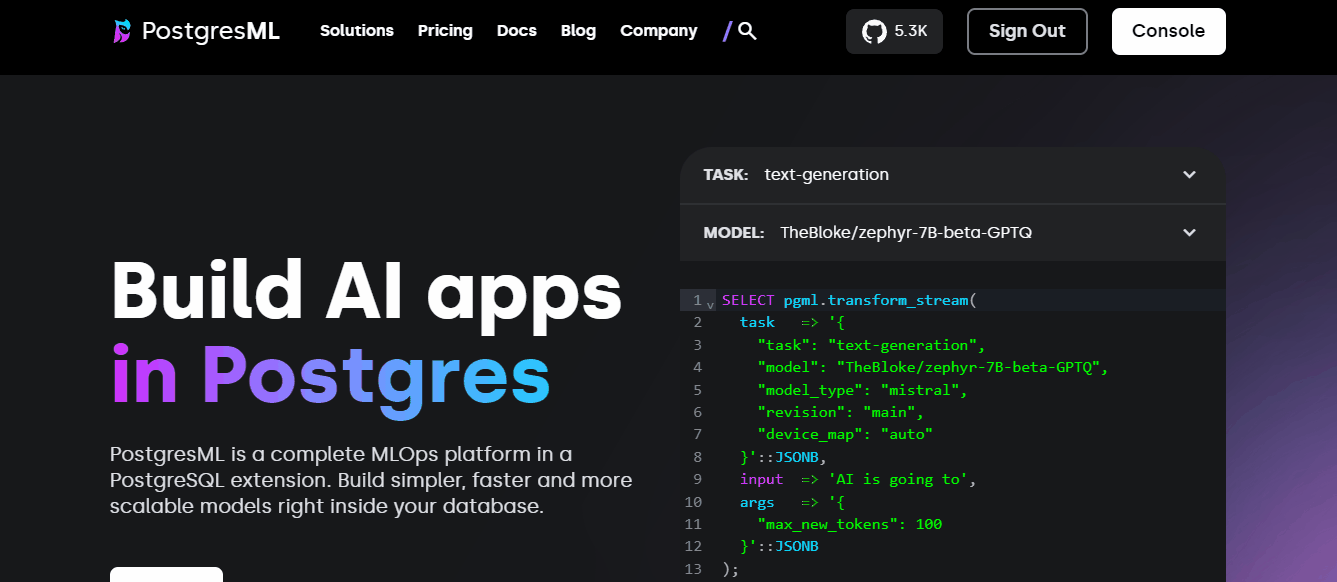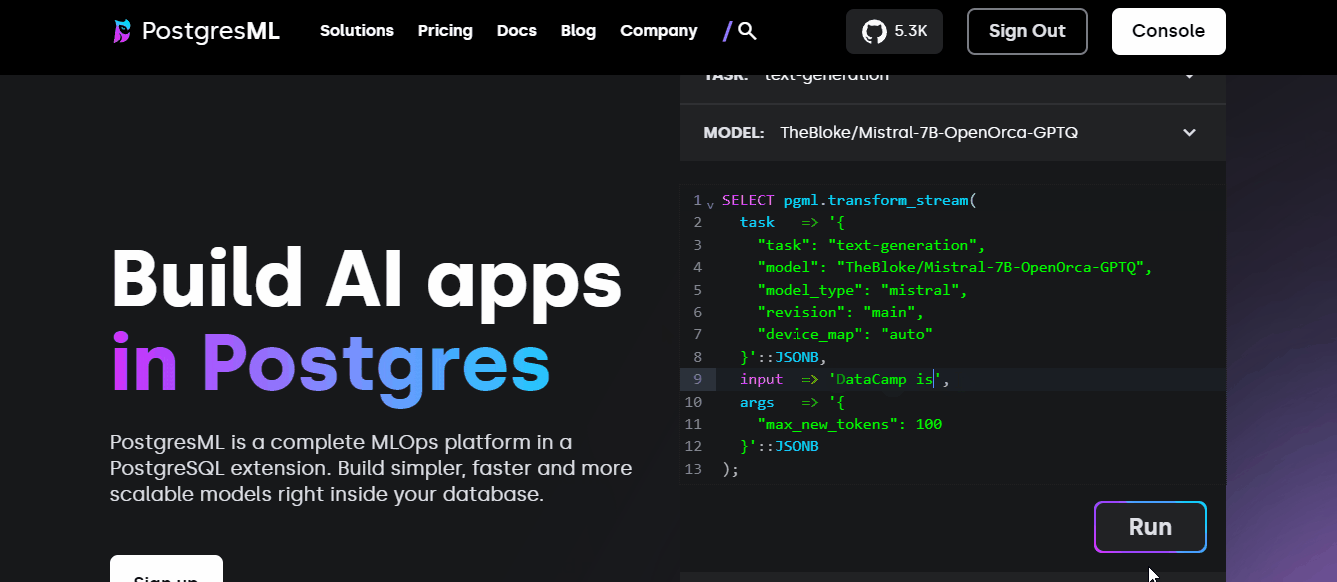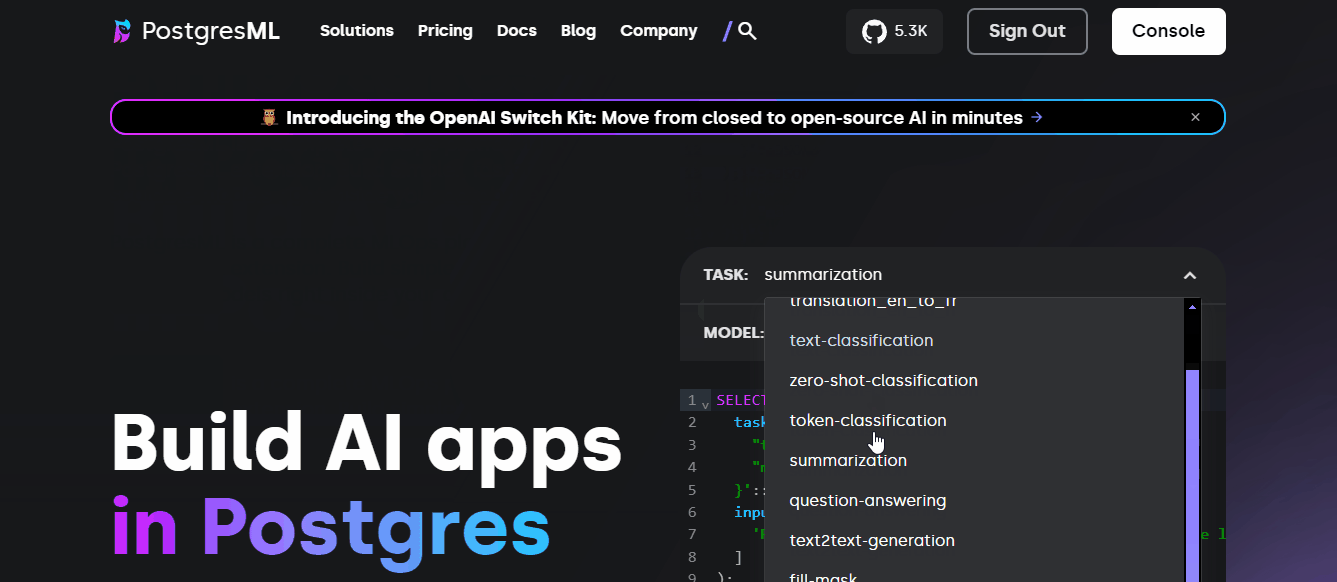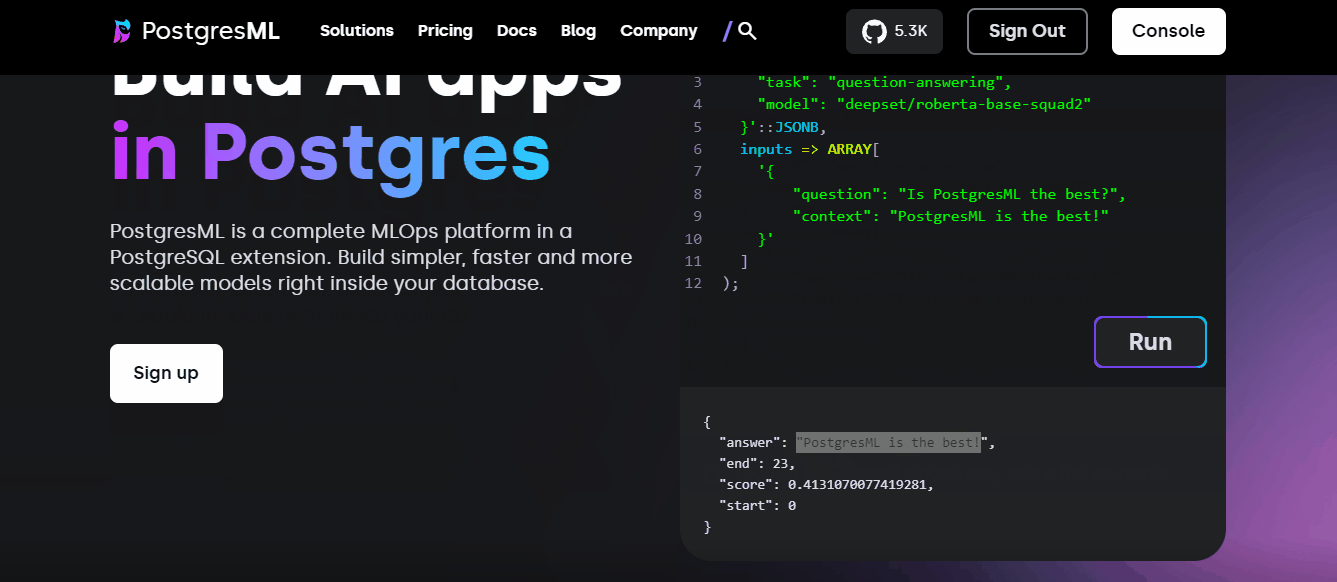
Vous pouvez exécuter ces exemples directement dans l’environnement utilisé pour ce tutoriel !
Si vous souhaitiez créer un service de machine learning à destination du grand public avec PostgresML, comment feriez-vous ? Voici quelques étapes possibles (après entraînement du modèle) :
psycopg2 (Python) ou pg-promise (JavaScript) pour vous connecter à votre base PostgresML.pgml.predict.Il s’agit d’une trame générale, à adapter selon les cas d’usage.
PostgresML introduit un nouveau paradigme en machine learning ; il faut plus qu’un simple tutoriel pour l’explorer en profondeur. Pour consolider votre compréhension et découvrir d’autres usages, consultez la section cas d’usage de la documentation PostgresML.
Si vos compétences SQL sont un peu rouillées, suivez le cours rapide de DataCamp sur la création de bases PostgreSQL ou même tout le parcours Data Analyst in SQL.
PostgresML étant très tourné vers l’IA, vous pouvez aussi renforcer vos fondamentaux en IA :
Poursuivez votre aventure IA dès aujourd’hui !
Cours
Cursus
Cursus