
Cursus
Concepten van Large Language Models (LLMs)
2 uur
111.6K
De overkoepelende trend in machine learning is dat data naar de omgeving van het model wordt verplaatst voor training. Maar wat als we dat omdraaien? Aangezien databases tegenwoordig vele ordes van grootte groter zijn dan machinelearningmodellen, zou het dan niet veel makkelijker zijn om de modellen naar de datasets te brengen?
Dat is het kernidee achter PostgresML — data blijft waar het is, jij brengt je code naar de database. Dit soort omgekeerde logica in machine learning levert tal van praktische voordelen op die je blik op wat een “database” is, zullen veranderen.
PostgresML is een volledig machinelearningplatform bovenop de populaire PostgreSQL-database. Het introduceert een nieuw paradigma, “in-database” machine learning, waarmee je veel ML-taken in SQL kunt uitvoeren zonder voor elke stap aparte tools nodig te hebben.
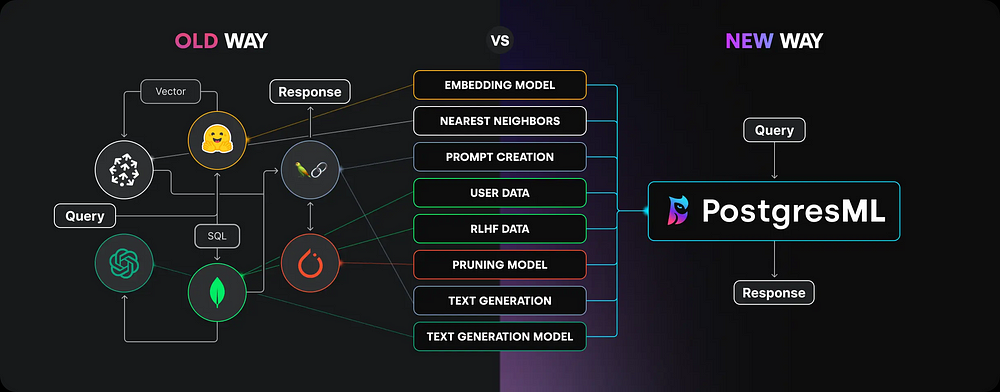
Hoewel het relatief nieuw is, belooft PostgresML deze duidelijke voordelen:
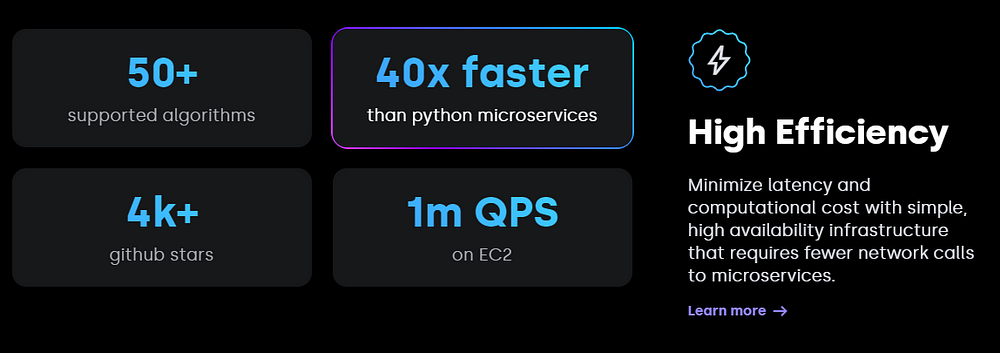
We gaan al deze features in deze tutorial uitproberen door een typische machinelearningworkflow te volgen:
…allemaal binnen een Postgres-database. Laten we beginnen!
We beginnen met het aanmaken van een gratis account op https://postgresml.org/signup:
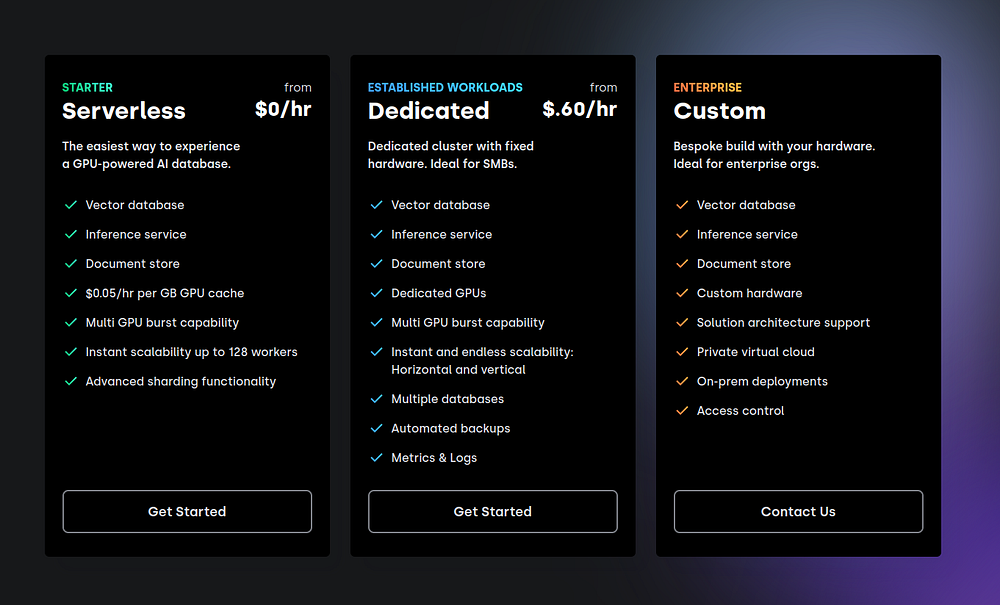
Kies vervolgens de gratis laag, die royaal wat resources biedt:
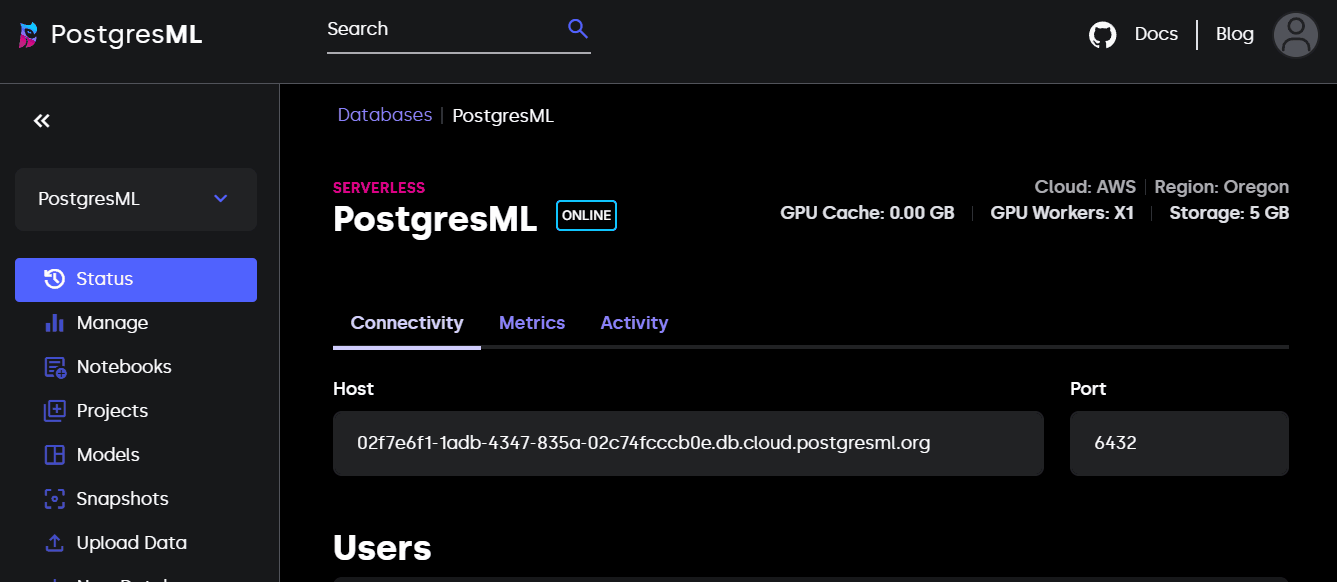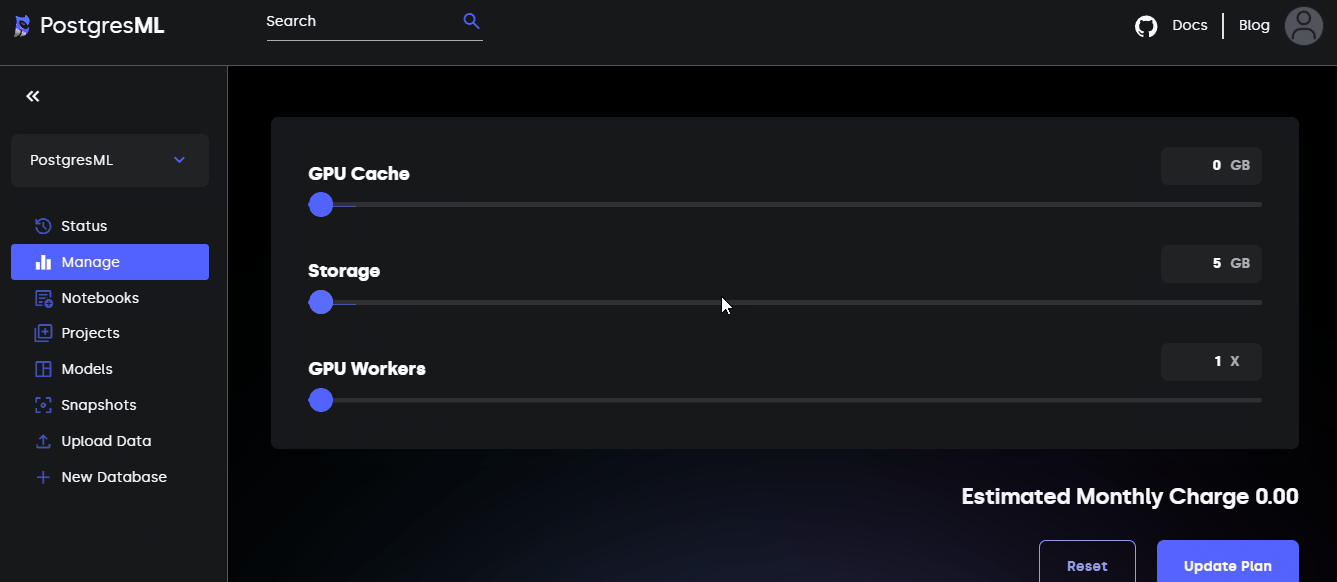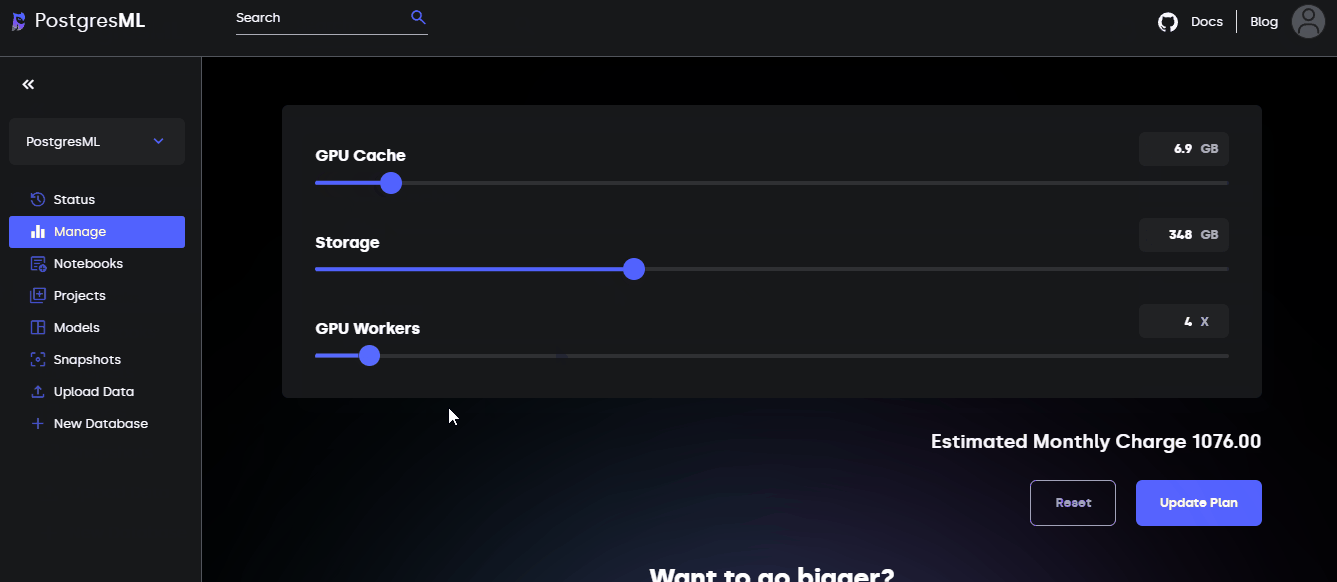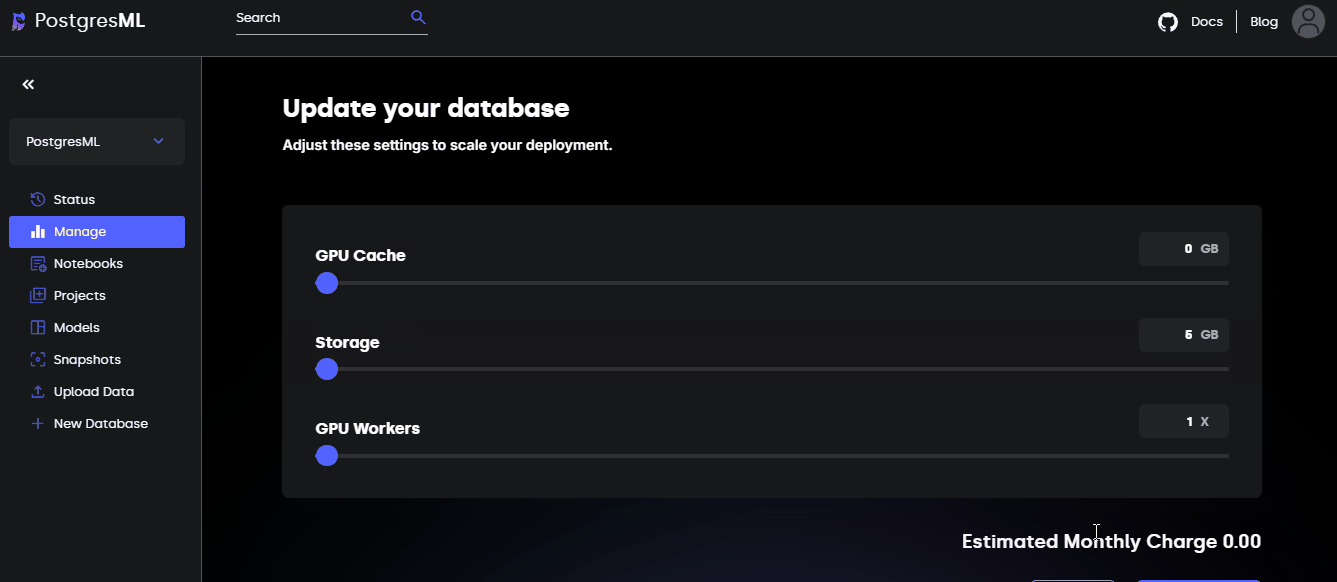
Na het aanmelden kom je in je PostgresML-console. Hier beheer je verschillende “In-database ML”-projecten en de bijbehorende resources.
Als je naar de sectie “Manage” gaat, kun je je omgeving opschalen op basis van je compute-behoeften:
Zoals de naam al aangeeft, hebben we PostgreSQL nodig op ons systeem om PostgresML te gebruiken. Als je niet weet wat Postgres is: het is ’s werelds meest geavanceerde open-sourcedatabase (volgens hun website).
Hier zijn links naar platformspecifieke handleidingen voor de installatie van PostgreSQL:
Ik gebruik WSL2, dus ik kan gewoon dit doen:
$ sudo apt update
$ sudo apt install postgresql postgresql-contrib
$ sudo passwd postgres  # Set a new Postgres password
# Close and reopen your terminal and done!
Controleer daarna de installatie met:
$ psql --version
psql (PostgreSQL) 12.18 (Ubuntu 12.18-0ubuntu0.20.04.1)
psql is de officiële Postgres-client om databases te verbinden en beheren in de terminal.
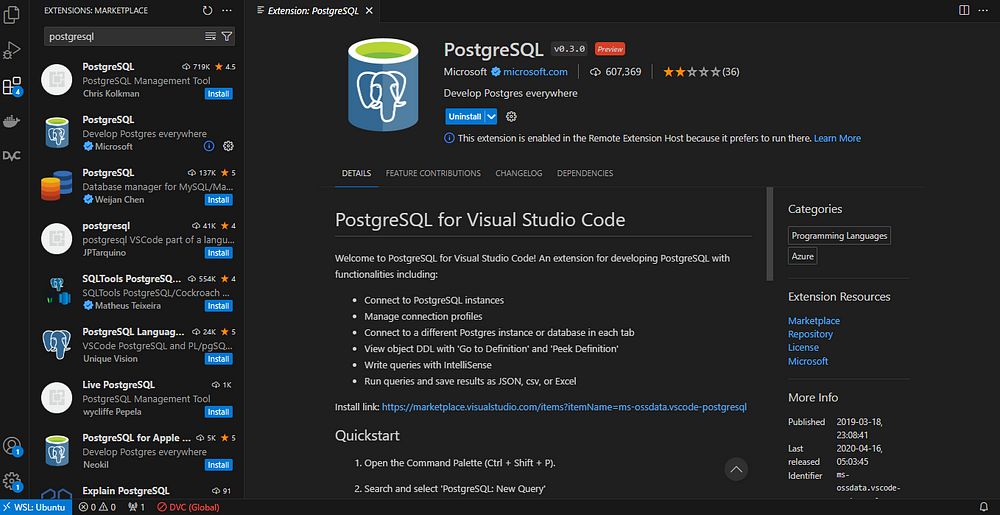
Ik snap dat het voor de meesten niet ideaal is om SQL in een lelijke terminal te draaien, dus je kunt na het installeren van Postgres ook de volgende VSCode-extensie installeren:
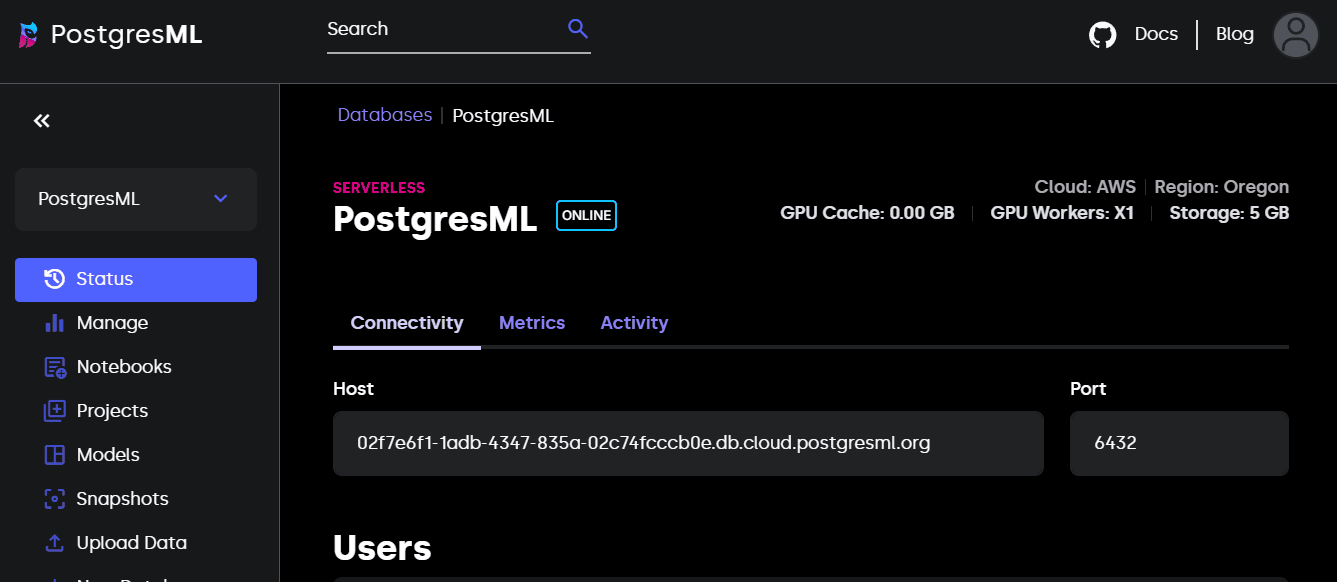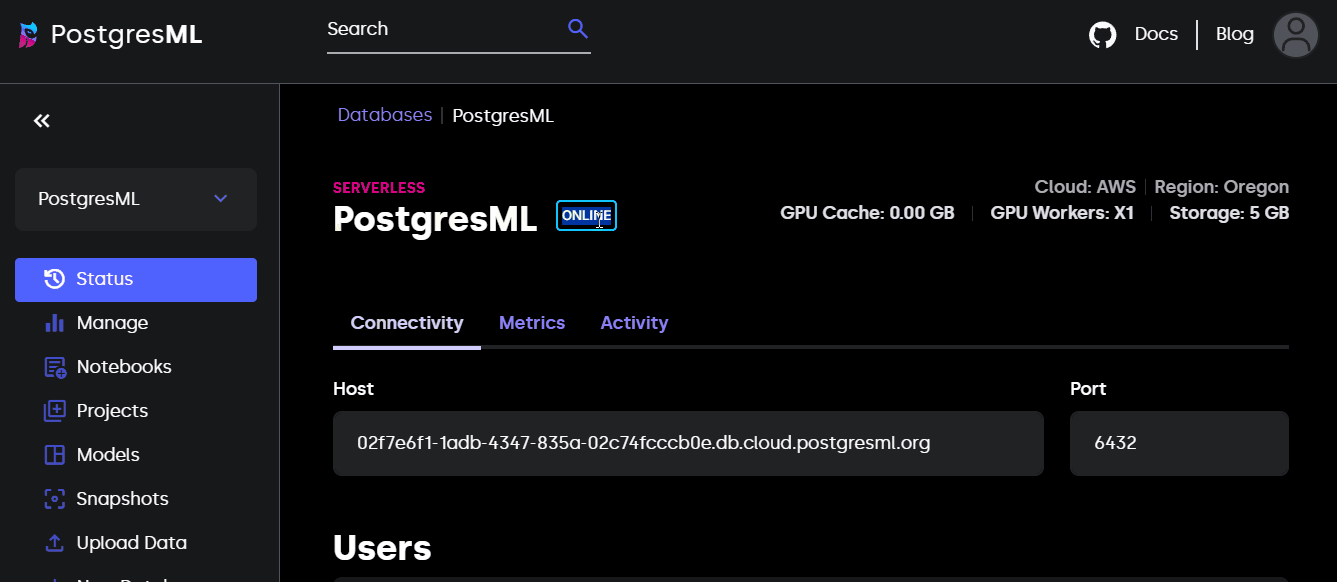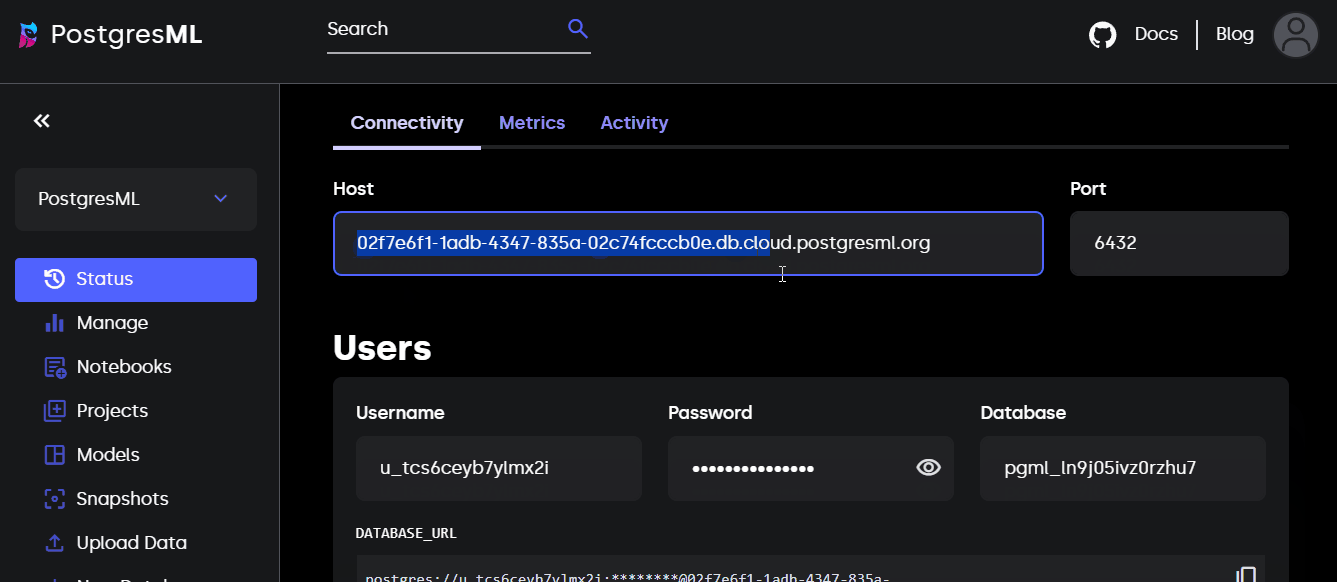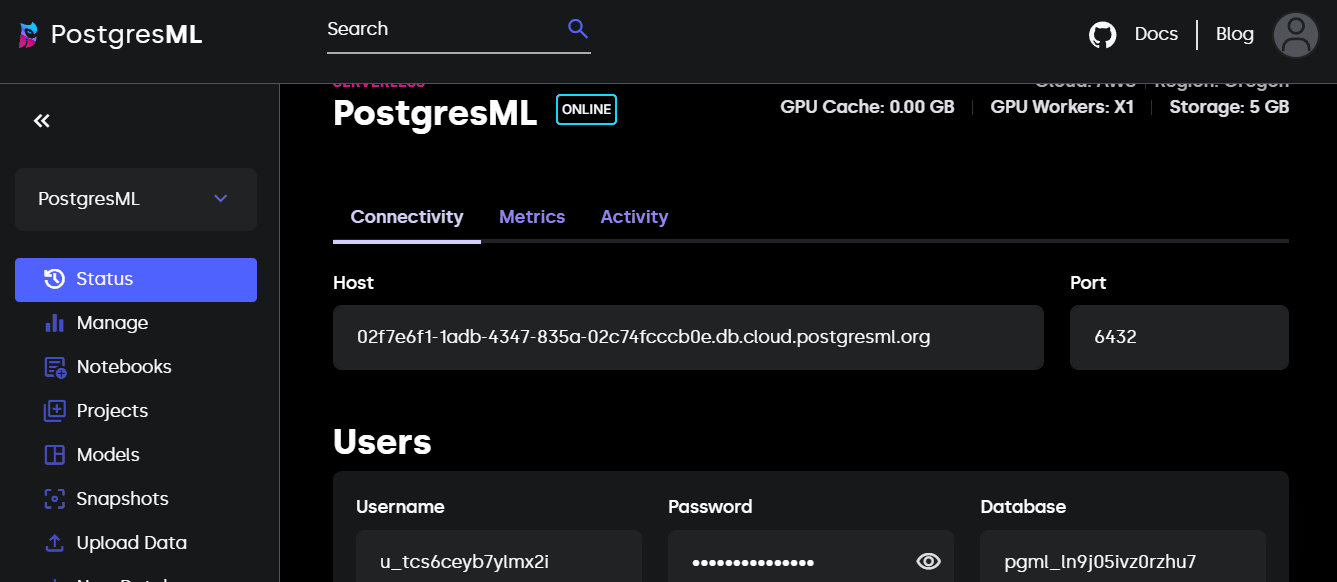
Weet je nog, de landingspagina van je PostgresML-console? Laat die in een apart tabblad openstaan:
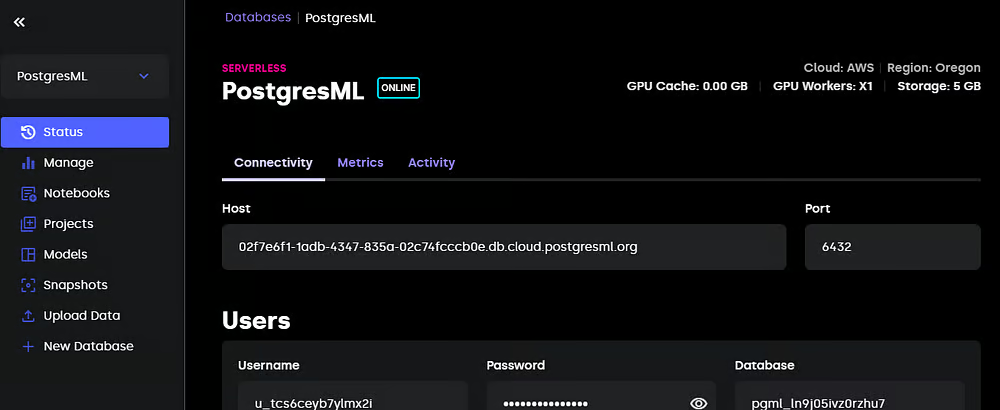
Gebruik nu psql en typ het volgende commando met je eigen gegevens om een verbinding met de PostgresML-server op te zetten:
$ psql -h "host" \
      -U "username" \
      -p 6432 \
      -d "database_name"
Als je de VSCode-extensie gebruikt, volg dan deze stappen (overgenomen van de installatiepagina van de extensie) om hetzelfde te doen:
En je bent verbonden met je PostgresML-database.
De volgende stap is het aanmaken van de pgml-extensie waarmee we PostgresML-functies kunnen draaien:
CREATE EXTENSION IF NOT EXISTS pgml;

NOTICE:  extension "pgml" already exists, skipping
CREATE EXTENSION
-- Your output may be different.
Controleer of alles gelukt is door de pgml-versie te printen:
SELECT pgml.version();

2.8.2 (98f114891db58acd472e068c44272b198274b11d)
We gaan nu wat data in onze database laden. Om het simpel te houden maken we één enkele tabel met de Diamonds-dataset van Kaggle. Je kunt die als CSV downloaden via de website of met de Python-snippet hieronder:
import seaborn as sns

diamonds = sns.load_dataset("diamonds")
diamonds.to_csv("diamonds.csv", index=False)
Voer daarna het volgende CREATE-commando uit met het juiste schema:
CREATE TABLE IF NOT EXISTS diamonds (
   index SERIAL PRIMARY KEY,
   carat FLOAT,
   cut VARCHAR(255),
   color VARCHAR(255),
   clarity VARCHAR(255),
   depth FLOAT,
   table_ FLOAT,
   price INT,
   x FLOAT,
   y FLOAT,
   z FLOAT
)
Dit commando maakt een tabel met de naam diamonds die we kunnen vullen met de rijen uit het CSV-bestand:
INSERT INTO diamonds
   (carat, cut, color, clarity, depth, table_, price, x, y, z)
   FROM '~/full/path/to/diamonds.csv'
   DELIMITER ','
   CSV HEADER;
Tot slot printen we de bovenkant van de tabel als bevestiging dat het laatste commando succesvol is uitgevoerd:
SELECT * FROM diamonds
LIMIT 10;
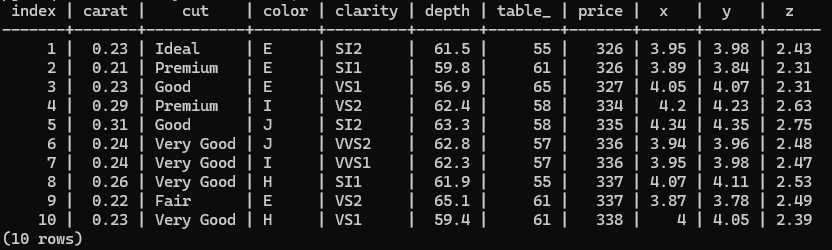
Nu zijn we klaar om een model te trainen!
Het trainen van een machinelearningmodel voor supervised learning doe je met de functie pgml.train. Dit is de basisstructuur:
SELECT pgml.train(
 project_name => 'Diamond prices prediction',
 task => 'regression',
 relation_name => 'diamonds',
 y_column_name => 'price',
 algorithm => 'xgboost'
);
Bovenstaande SQL-statement past een XGBoost-regressor op de diamonds-tabel toe om diamantprijzen te voorspellen. Wat opvalt als je het commando draait, is hoe snel het is (bijna instantaan), ook al hebben we meer dan 50k rijen.
Je kunt ook makkelijk van taak wisselen. Zo pas je een multiclass-classifier toe (vergeet niet de projectnaam te wijzigen):
SELECT pgml.train(
 project_name => 'Diamond cut quality prediction',
 task => 'classification',
 relation_name => 'diamonds',
 y_column_name => 'cut',
 algorithm => 'xgboost',
 test_size => 0.1
);
Merk op dat we dit keer het argument test_size opgeven - aangepaste splitsing wordt ook ondersteund!
We hebben het standaardalgoritme linear ook gewijzigd naar xgboost, maar dat had elk ander model uit Scikit-learn of een ander ondersteund framework kunnen zijn.
Laten we dit keer een random forest-model fitten:
…
Maar wacht! De diamonds-dataset heeft tekstfeatures die gecodeerd moeten worden. Omdat XGBoost categorische variabelen native kan encoderen, kregen we bij de vorige queries geen fouten. Dat kan bij random forests anders zijn. Laten we dus wat preprocessing-stappen aan onze query toevoegen:
SELECT pgml.train(
   project_name => 'Diamond prices prediction',
   task => 'regression',
   relation_name => 'diamonds',
   y_column_name => 'price',
   algorithm => 'random_forest',
   preprocess => '{
       "carat": {"scale": "standard"},
       "depth": {"scale": "standard"},
       "table_": {"scale": "standard"},
       "cut": {"encode": "target", "scale": "standard"},
       "color": {"encode": "target", "scale": "standard"},
       "clarity": {"encode": "target", "scale": "standard"}
   }'::JSONB
);
De preprocessing-logica staat in een JSONB-object dat kolommen aan transformaties koppelt. Voor numerieke features gebruiken we standaardisatie (ook al is dat voor RF niet per se nodig). Voor categorische kolommen gebruiken we target encoding en daarna standaardisatie.
PostgresML biedt ook andere alternatieve preprocessingfuncties. Hier is de volledige lijst met encodeeropties:
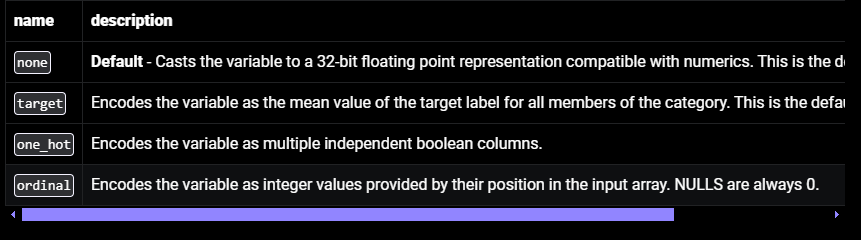
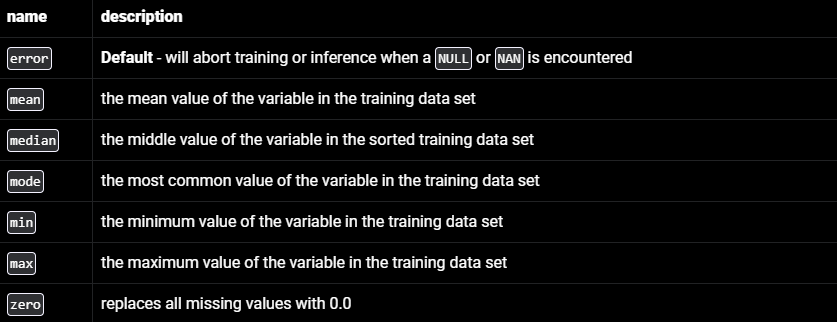
pgml ondersteunt ook gangbare imputatietechnieken:
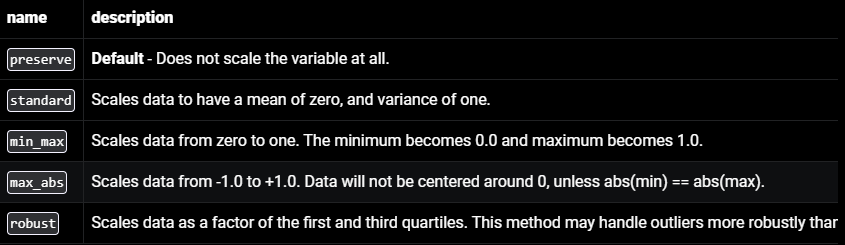
En hier is een lijst met scalers:
Hoewel je niet zo’n enorme suite aan preprocessors hebt als in Scikit-learn, is dit genoeg voor de meeste supervised learning-taken.
Tot nu toe hebben we de standaardparameters van algoritmen gebruikt. Die zijn echter bijna nooit ideaal voor echte problemen. Om aangepaste waarden op te geven, kunnen we het argument hyperparams van pgml.train gebruiken:
SELECT pgml.train(
   project_name => 'Diamond prices prediction',
   task => 'regression',
   relation_name => 'diamonds',
   y_column_name => 'price',
   algorithm => 'xgboost',
   hyperparams => '{
       "n_estimators": 1000, "max_depth": 5, "eta": 0.01, "subsample": 0.7
   }'::JSONB
);
Dit keer fitten we een XGBoost-regressor met 1000 bomen, een maximale diepte van 5 en een learning rate van 0,01. We schieten nu een beetje op goed geluk, dus deze hyperparameters leveren mogelijk niet de beste resultaten op.
Om het maximale uit het model te halen, heb je bij supervised learning-taken altijd hyperparametertuning nodig. Dit proces wordt in pgml ook ondersteund binnen de functie train. Zo voer je een grid search uit over een kleine set combinaties van hyperparameters:
SELECT pgml.train(
   'Diamond prices prediction',
   algorithm => 'xgboost',
   search => 'grid',
   search_params => '{
       "max_depth": [5, 7],
       "n_estimators": [1000, 1500],
       "eta": [0.1, 0.01, 0.001]
   }'::JSONB
);
Op dit punt wil ik vooral dat je waardeert wat we hier doen. We tunen de hyperparameters van een XGBoost-regressor met SQL! Dat is een zin waarvan ik nooit dacht dat ik ’m zou schrijven.
Op het moment van schrijven heeft PostgresML nog geen volwassen evaluatietools. We hebben alleen de functie predict tot onze beschikking. Zo gebruik je die om voor een nieuwe, enkele sample te voorspellen:
SELECT pgml.predict(
   project_name => 'Diamond prices prediction',
   features => ARRAY[0.7, "Ideal", "A", "IF", 67.9, 56.9, 7024, 5.85, 5.87, 3.71]
);
predict gebruikt automatisch het best presterende model uit je experimenten. Voor regressie is dat het model met de hoogste R-squared, en voor classificatie het model met de hoogste F1-score.
Wil je een specifiek model gebruiken voor voorspellen, dan kun je het ID opgeven:
SELECT pgml.predict(
  2' -- Use model with ID of 2,
   features => ARRAY[0.7, "Ideal", "A", "IF", 67.9, 56.9, 7024, 5.85, 5.87, 3.71]
)
Maar hoe vind je model-ID’s, vraag je? Hier is een snippet die een nette tabel met precies die info print:
SELECT models.id, models.algorithm, models.metrics
FROM pgml.models
JOIN pgml.projects
 ON projects.id = models.project_id
WHERE projects.name = 'Diamond prices prediction';
Uit deze statement kun je veel variabelen en metrics over pgml ontdekken, zoals models.id, pgml.models, pgml.projects, enzovoort. Probeer `SELECT`-statements op deze tabellen om gevoel te krijgen voor wat ze doen.
In tegenstelling tot traditionele MLOps is deze stap in PostgresML het makkelijkst. De pgml-extensie stelt automatisch het best presterende model uit je experimenten in als standaard. Dus alle SELECT pgml.predict-statements die gebruikers naar de server sturen, gebruiken dat model voor inferentie.
Wil je fijnmaziger bepalen welk model naar productie gaat, dan kun je dat regelen met de functie pgml.deploy. Dit is de structuur:
SELECT * FROM pgml.deploy(
   project_name TEXT,
   strategy TEXT DEFAULT 'best_score',
   algorithm TEXT DEFAULT NULL
)
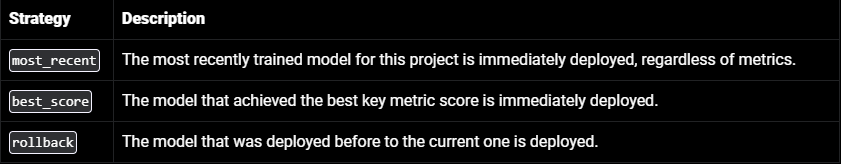
Naast best_score zijn er ook most_recent en rollback als deploymentstrategieën:
Door de parameters strategy en algorithm te combineren, kun je de deployment nog verder aanscherpen. Zo deployt onderstaand statement het best scorende XGBoost-model, niet het best presterende model van het hele project.
SELECT * FROM pgml.deploy(
   project_name => 'Diamond prices prediction',
   strategy => 'best_score',
   algorithm => 'xgboost'
)
Supervised learning is maar een klein onderdeel van PostgresML. De volledige propositie van PostgresML is zelfs: “AI-apps bouwen in Postgres.” Ter illustratie staat er op de homepage zelfs een kleine SQL-editor:
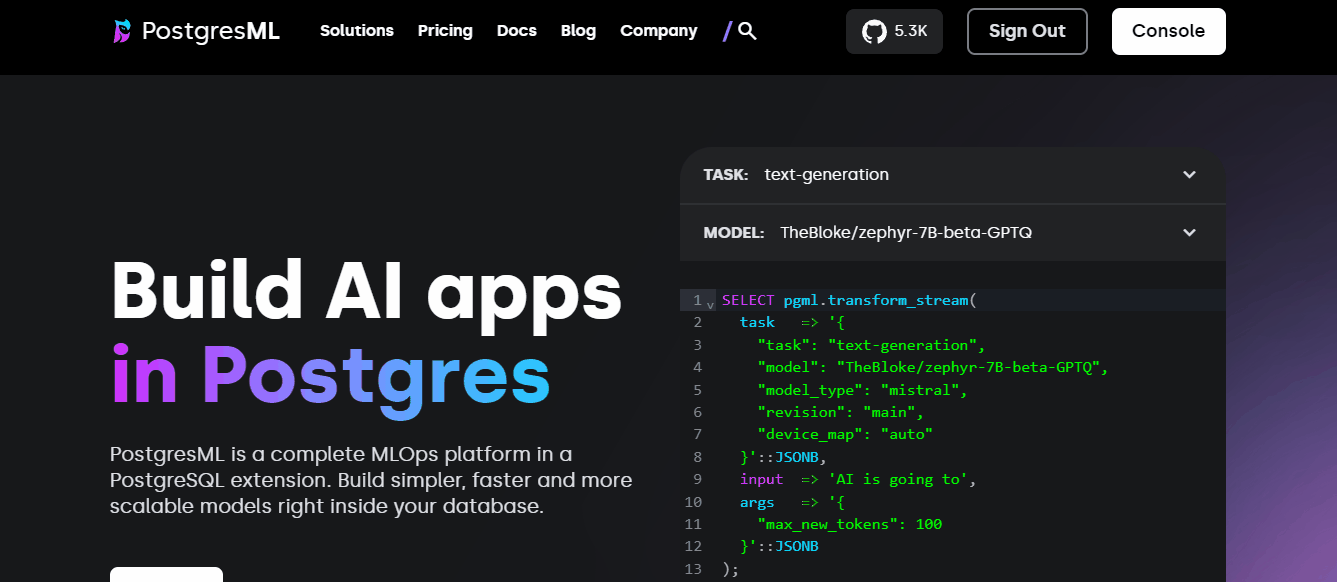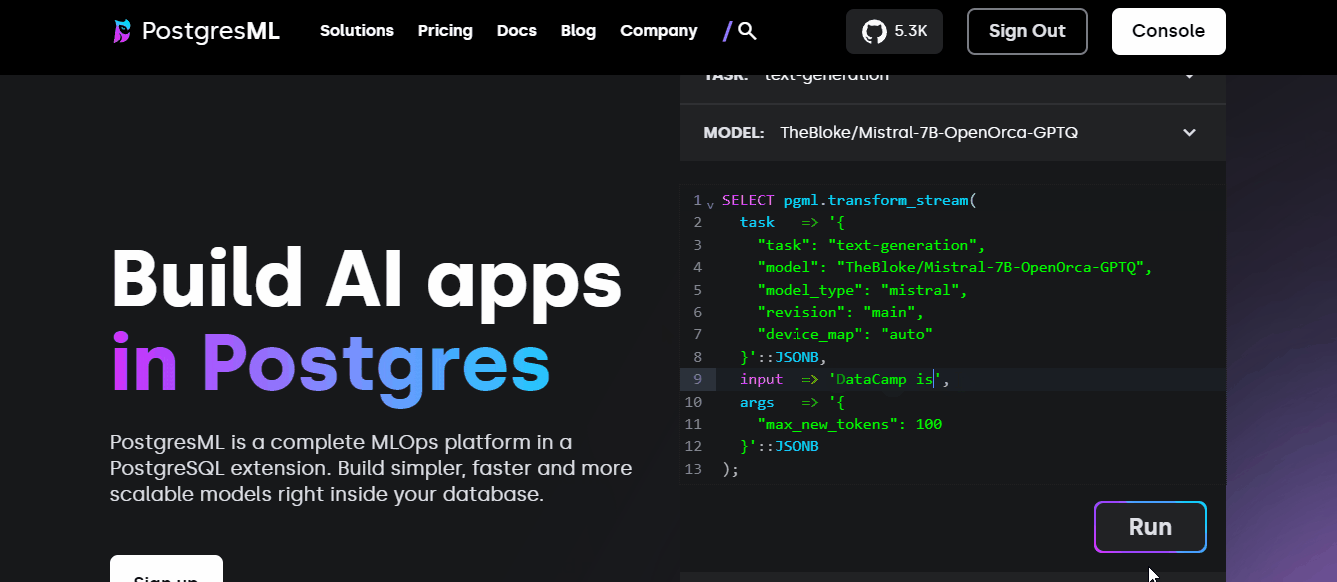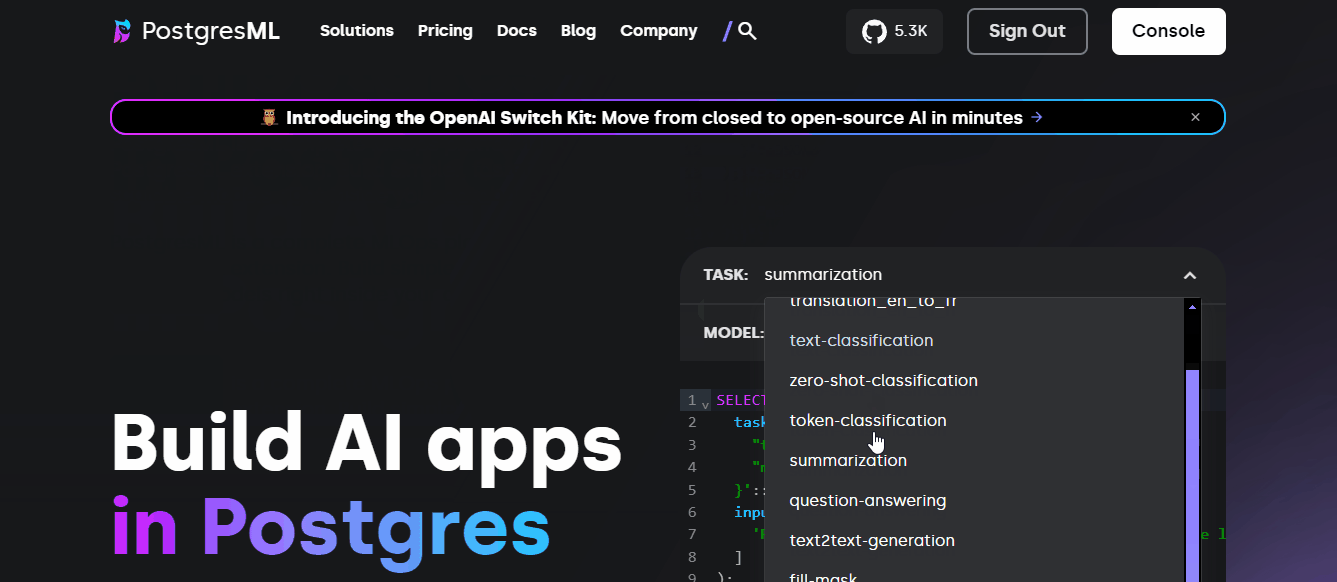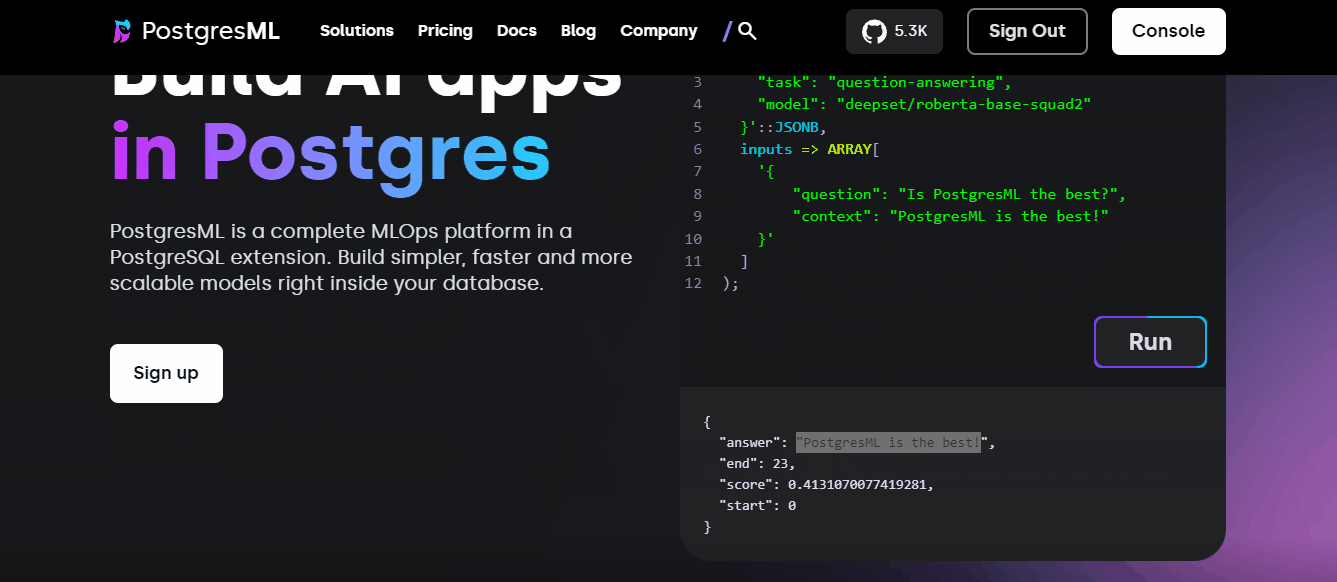
Je kunt die voorbeelden ook direct draaien in de omgeving die je in deze tutorial hebt gebruikt!
Stel, je wilt met PostgresML een consumentgerichte machinelearningservice bouwen. Hoe zou je dat aanpakken? Hier zijn mogelijke stappen (nadat je model klaar is):
psycopg2 (Python) of pg-promise (JavaScript) om verbinding te maken met je PostgresML-database.pgml.predict aangeroepen.Dit is een globale schets die afhankelijk van de usecase aanzienlijk kan veranderen.
PostgresML introduceert een compleet nieuw paradigma in machine learning, dus het kost wat meer dan één tutorial om het onder de knie te krijgen. Om je begrip te versterken en andere manieren te verkennen waarop je PostgresML kunt gebruiken, lees de use-cases-sectie van de PostgresML-docs.
Als je SQL-vaardigheden wat zijn weggezakt, kun je bij DataCamp een korte cursus volgen over het maken van PostgreSQL-databases of zelfs het hele Data Analyst in SQL-carrièrepad.
Omdat PostgresML sterk op AI focust, kun je ook wat AI-basics leren:
Zet je AI-reis vandaag voort!
Cursus
Leerpad
Leerpad
blog
Adel Nehme
15 min

