
{count, plural, one {कोर्स} other {कोर्स}}
Large Language Models (LLMs) कॉन्सेप्ट्स
{hours} घंटा
112.3K
मशीन लर्निंग में व्यापक प्रवृत्ति यह है कि प्रशिक्षण के लिए डेटा को मॉडल के वातावरण में ले जाया जाता है। लेकिन अगर हम इसे उल्टा करें तो? चूंकि आज के डेटाबेस मशीन लर्निंग मॉडलों से कई गुना बड़े हैं, तो क्या यह आसान नहीं होगा कि हम मॉडलों को ही डेटासेट्स के पास ले आएँ?
यही PostgresML का मूल विचार है — डेटा वहीं रहता है, और आप अपना कोड डेटाबेस तक लाते हैं। इस प्रकार की उलटी-तर्क वाली मशीन लर्निंग कई व्यावहारिक लाभ लाती है, जो आपको “डेटाबेस” की परिभाषा पर फिर से सोचने पर मजबूर कर देगी।
PostgresML लोकप्रिय PostgreSQL डेटाबेस पर निर्मित एक व्यापक मशीन लर्निंग प्लेटफ़ॉर्म है। यह “इन-डेटाबेस” मशीन लर्निंग नामक एक नया प्रतिमान प्रस्तुत करता है, जो आपको अलग-अलग टूल्स की आवश्यकता के बिना केवल SQL में कई ML कार्य करने देता है।
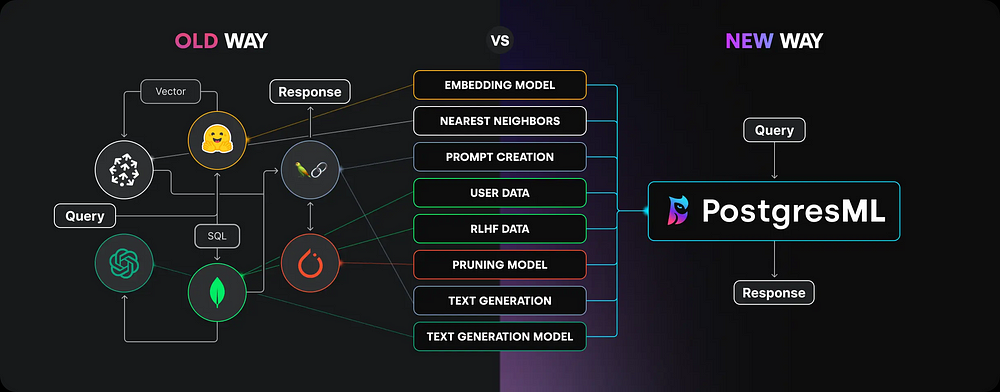
हालाँकि यह अपेक्षाकृत नया है, PostgresML निम्नलिखित ठोस लाभों का वादा करता है:
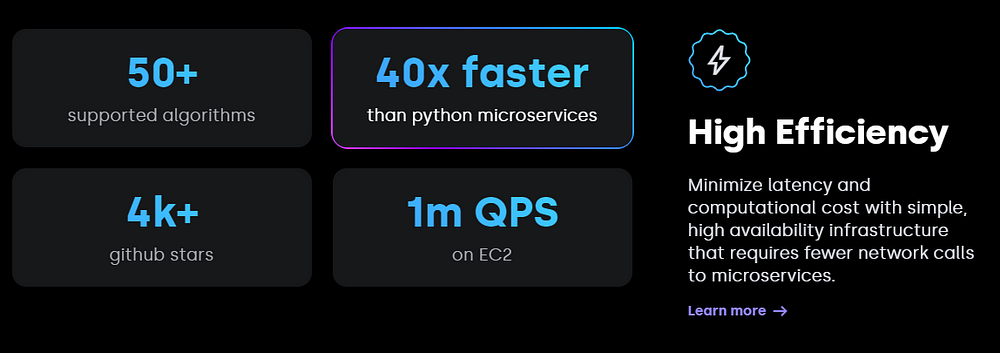
हम इस ट्यूटोरियल में एक सामान्य मशीन-लर्निंग वर्कफ़्लो के साथ इन सभी सुविधाओं को आज़माएँगे:
…और यह सब Postgres डेटाबेस के भीतर। चलिए शुरू करते हैं!
सबसे पहले, हम https://postgresml.org/signup पर एक मुफ़्त खाता बनाएँगे:
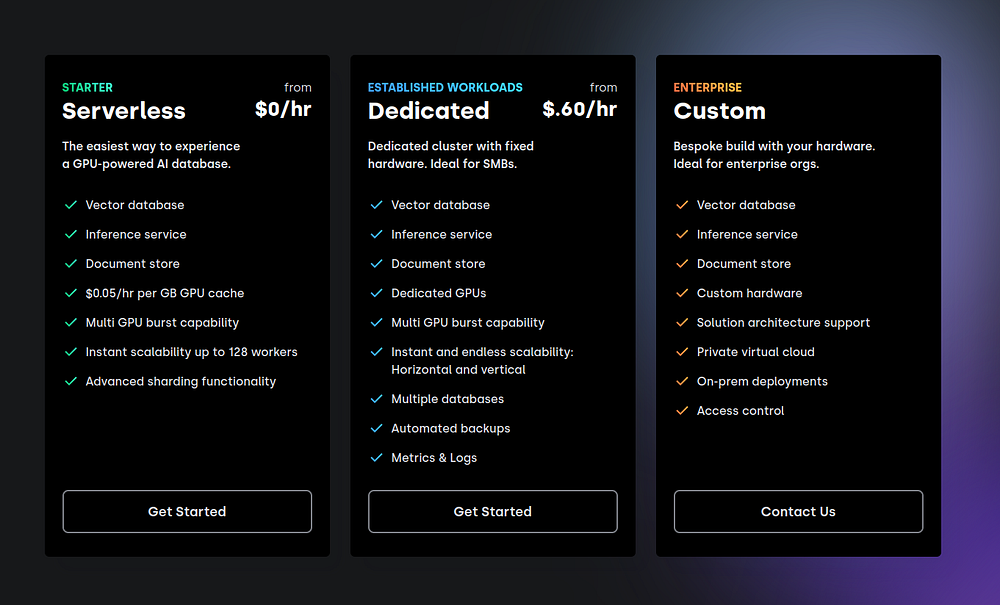
इसके बाद, फ्री टियर चुनें, जो पर्याप्त संसाधन देता है:
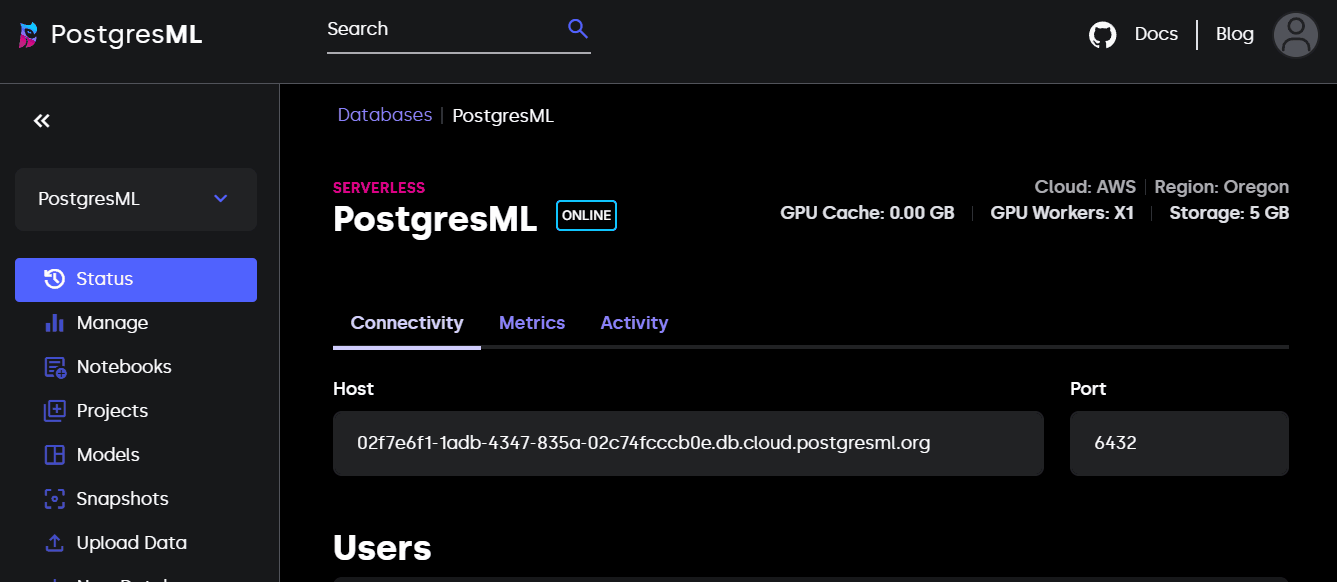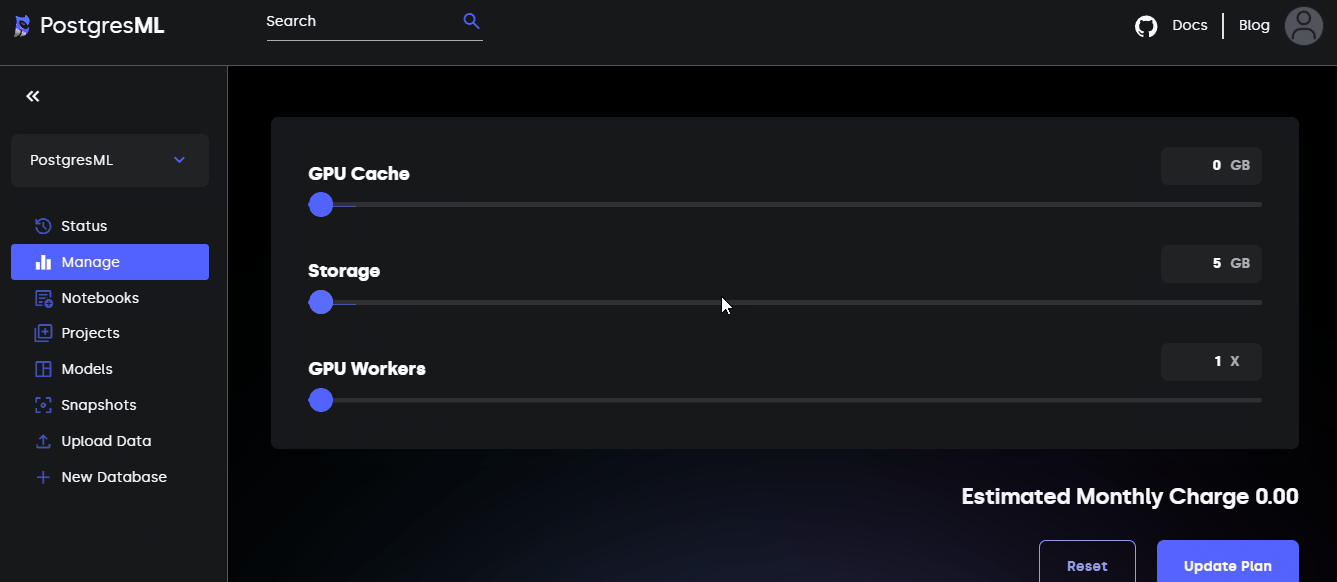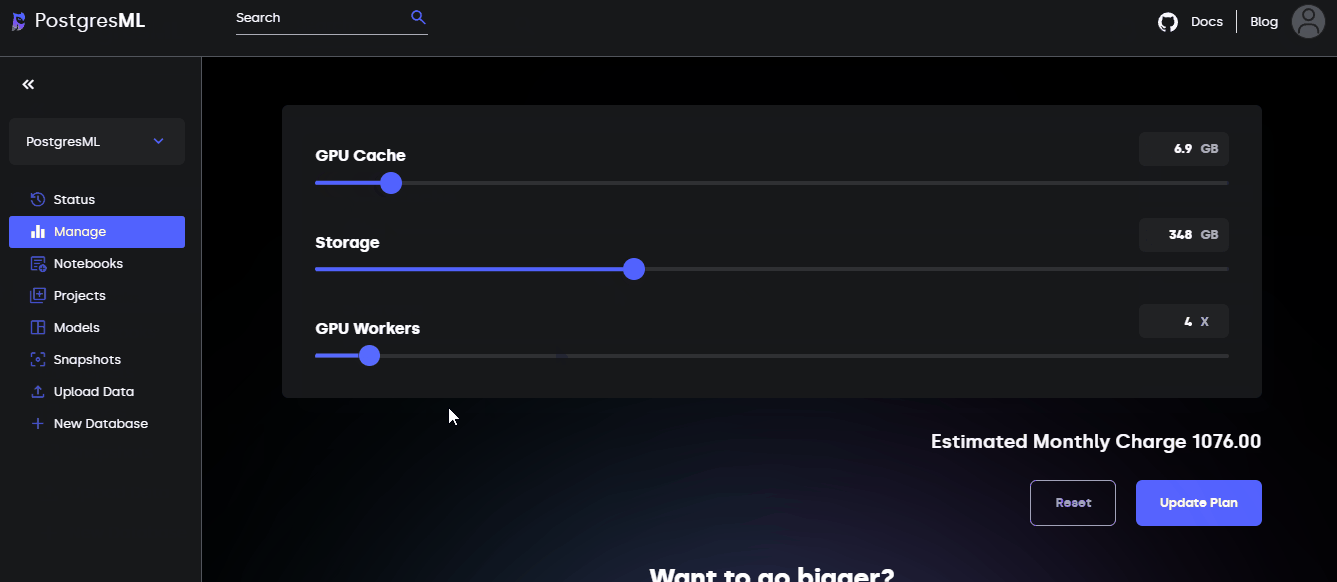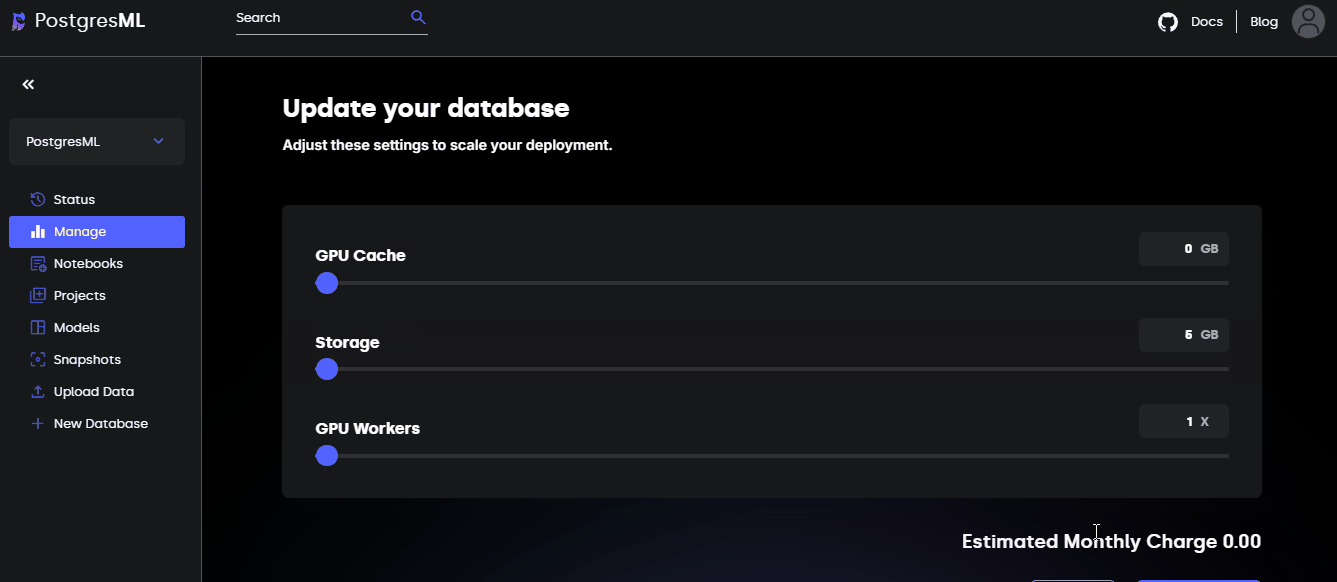
साइन-अप के बाद, आप अपने PostgresML कंसोल पर पहुँचेंगे। यही वह स्थान है जहाँ आप अलग-अलग “इन-डेटाबेस ML” प्रोजेक्ट्स और उनसे जुड़ी संसाधनों का प्रबंधन करते हैं।
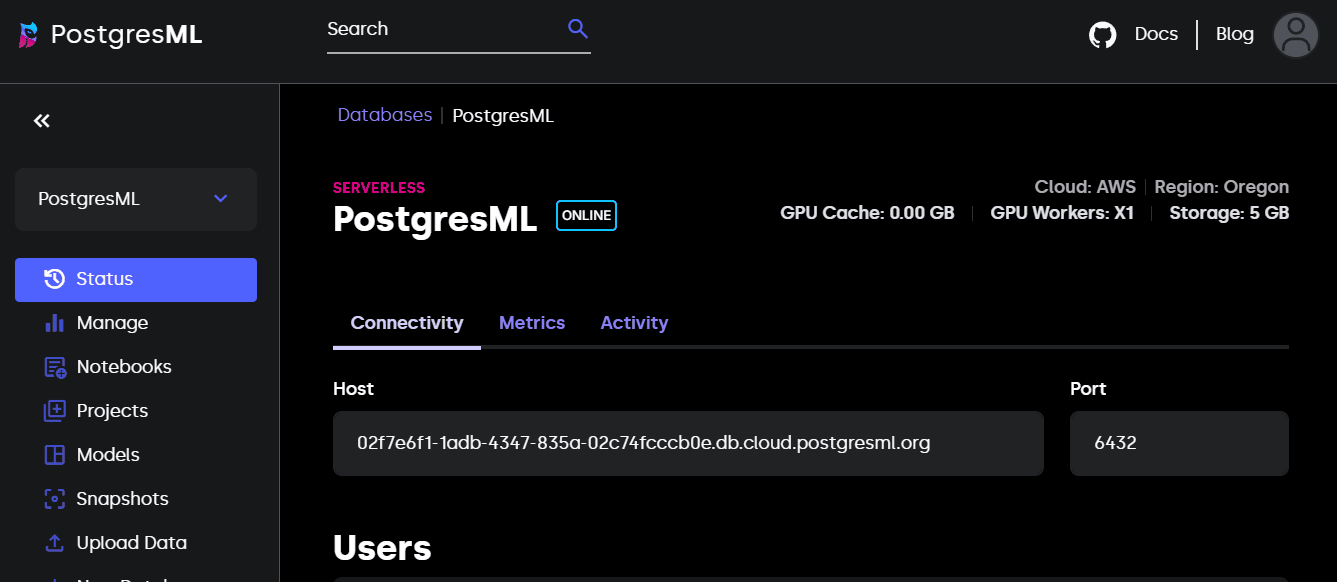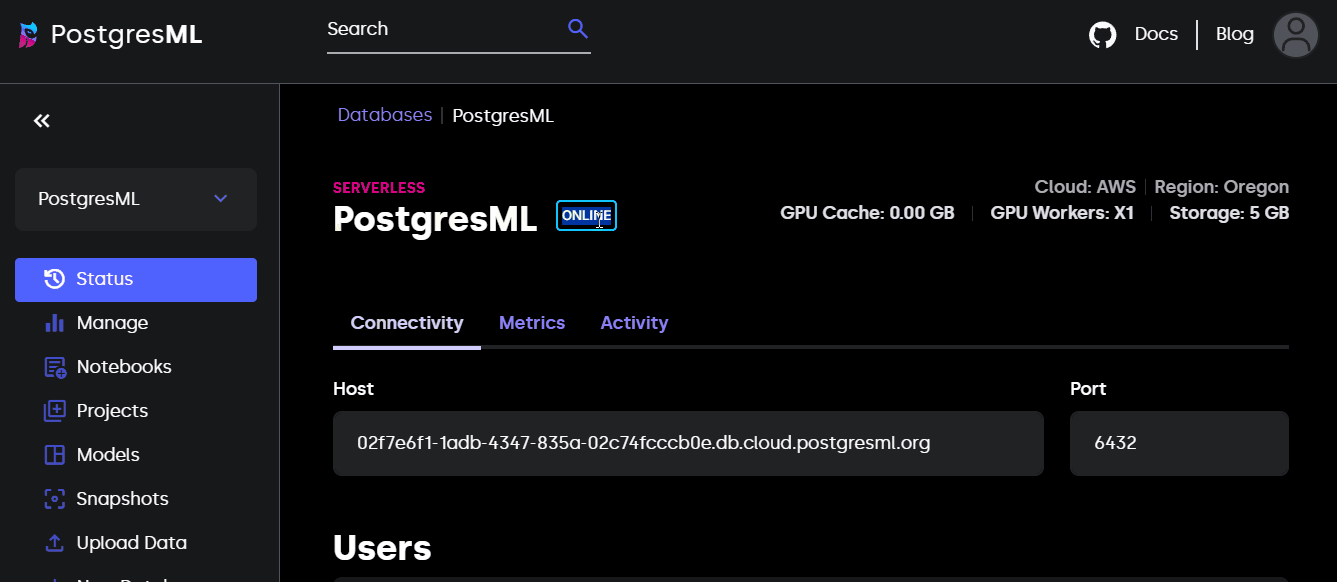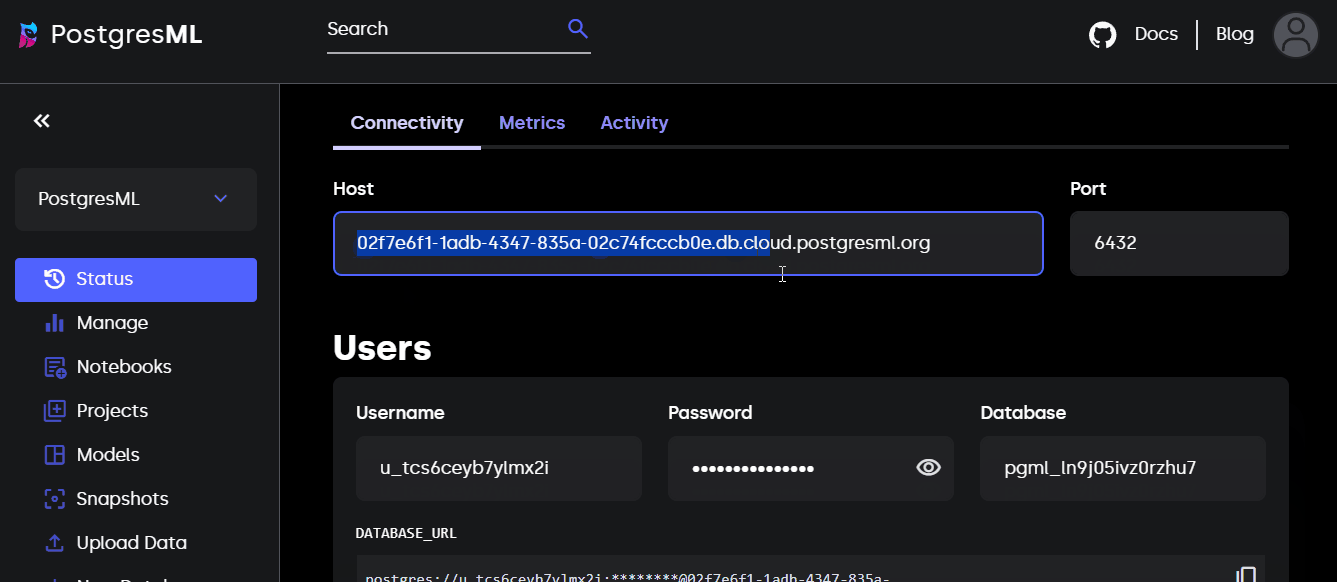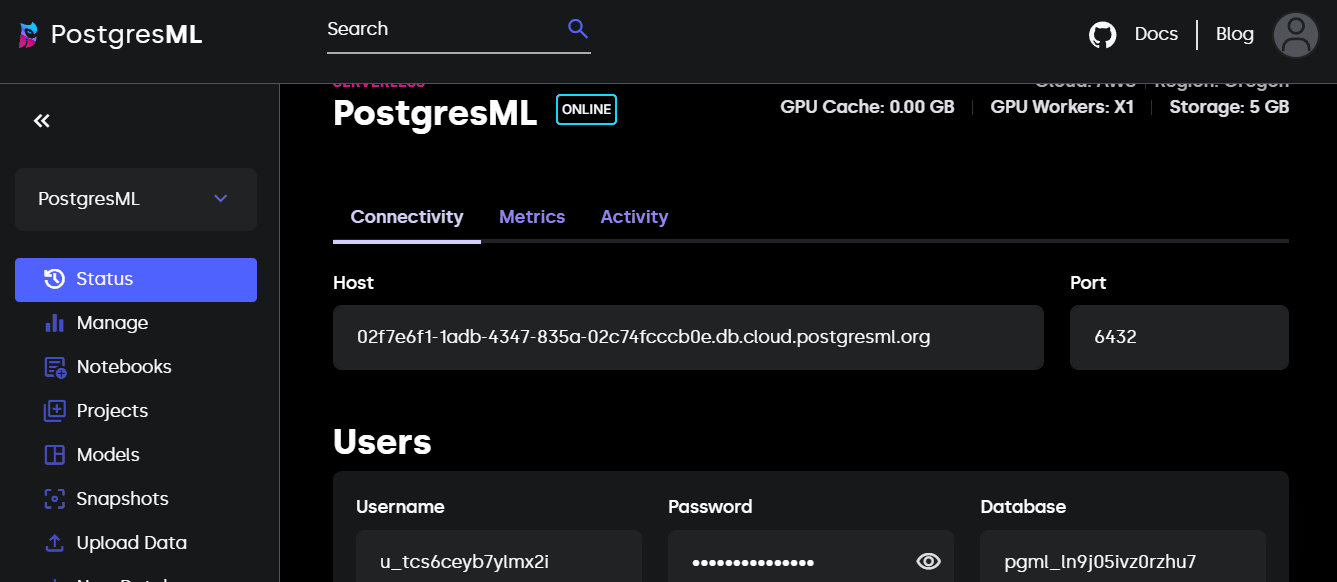
यदि आप “Manage” सेक्शन में जाएँगे, तो आप अपनी compute आवश्यकताओं के आधार पर अपना वातावरण स्केल कर पाएँगे:
नाम से स्पष्ट है कि PostgresML का उपयोग करने के लिए हमें अपने सिस्टम पर PostgreSQL इंस्टॉल होना चाहिए। यदि आप नहीं जानते कि Postgres क्या है, तो यह दुनिया का सबसे उन्नत ओपन-सोर्स डेटाबेस है (यह उनकी वेबसाइट पर लिखा है)।
PostgreSQL इंस्टॉलेशन पर प्लेटफ़ॉर्म-विशिष्ट गाइड के लिंक यहाँ हैं:
मैं WSL2 पर हूँ, इसलिए मैं बस यह कर सकता हूँ:
$ sudo apt update
$ sudo apt install postgresql postgresql-contrib
$ sudo passwd postgres  # Set a new Postgres password
# Close and reopen your terminal and done!
इसके बाद, इंस्टॉलेशन को निम्न कमांड से जाँचें:
$ psql --version
psql (PostgreSQL) 12.18 (Ubuntu 12.18-0ubuntu0.20.04.1)
psql टर्मिनल में डेटाबेस से कनेक्ट करने और उन्हें मैनेज करने के लिए आधिकारिक Postgres क्लाइंट है।
मैं समझता हूँ कि अधिकांश लोगों के लिए बेढंगे टर्मिनलों में SQL चलाना आदर्श नहीं है, इसलिए Postgres इंस्टॉल करने के बाद आप निम्न VSCode एक्सटेंशन भी इंस्टॉल कर सकते हैं:
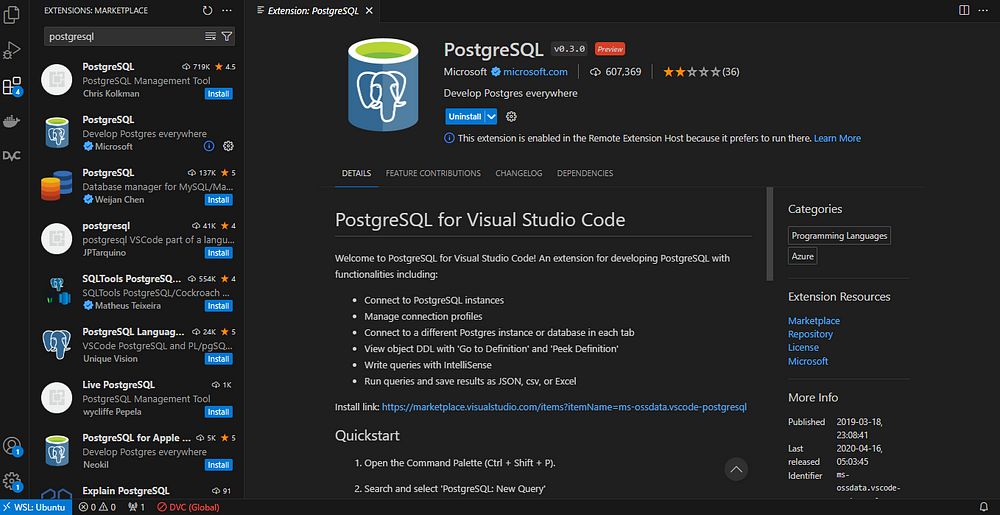
क्या आपको अपने PostgresML कंसोल का लैंडिंग पेज याद है? उसे एक अलग टैब में खुला रखें:
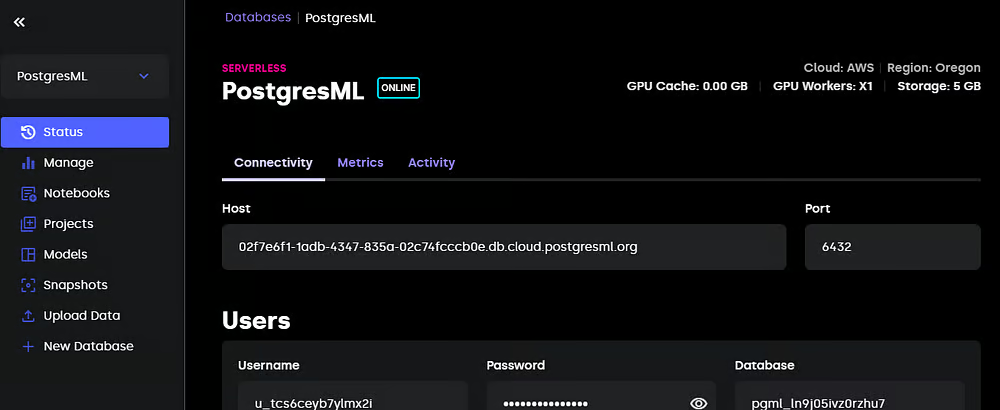
अब, psql का उपयोग करके, आप अपनी साख के साथ निम्न कमांड टाइप कर PostgresML सर्वर से कनेक्शन बना सकते हैं:
$ psql -h "host" \
      -U "username" \
      -p 6432 \
      -d "database_name"
यदि आप VSCode एक्सटेंशन का उपयोग कर रहे हैं, तो यही काम करने के लिए (एक्सटेंशन के इंस्टॉलेशन पेज से ली गई) ये स्टेप्स अपनाएँ:
और आप अपने PostgresML डेटाबेस से कनेक्ट हो जाएँगे।
अगला कदम pgml एक्सटेंशन बनाना है, जो हमें PostgresML फ़ंक्शनों को चलाने देगा:
CREATE EXTENSION IF NOT EXISTS pgml;

NOTICE:  extension "pgml" already exists, skipping
CREATE EXTENSION
-- Your output may be different.
सब कुछ सही है या नहीं, यह pgml वर्शन प्रिंट करके जाँचें:
SELECT pgml.version();

2.8.2 (98f114891db58acd472e068c44272b198274b11d)
अब, अपने डेटाबेस में कुछ डेटा लोड करते हैं। सरल रखने के लिए, हम केवल एक तालिका बनाएँगे, जिसमें Kaggle के Diamonds डेटासेट का उपयोग करेंगे। आप इसे वेबसाइट से CSV के रूप में डाउनलोड कर सकते हैं या नीचे दिए Python स्निपेट से:
import seaborn as sns

diamonds = sns.load_dataset("diamonds")
diamonds.to_csv("diamonds.csv", index=False)
इसके बाद, सही स्कीमा के साथ निम्न CREATE कमांड चलाएँ:
CREATE TABLE IF NOT EXISTS diamonds (
   index SERIAL PRIMARY KEY,
   carat FLOAT,
   cut VARCHAR(255),
   color VARCHAR(255),
   clarity VARCHAR(255),
   depth FLOAT,
   table_ FLOAT,
   price INT,
   x FLOAT,
   y FLOAT,
   z FLOAT
)
यह कमांड diamonds नाम की तालिका बनाएगा, जिसे हम CSV फ़ाइल की पंक्तियों से भर सकते हैं:
INSERT INTO diamonds
   (carat, cut, color, clarity, depth, table_, price, x, y, z)
   FROM '~/full/path/to/diamonds.csv'
   DELIMITER ','
   CSV HEADER;
अंत में, यह सुनिश्चित करने के लिए कि पिछला कमांड सफल रहा, तालिका का शीर्ष भाग प्रिंट करें:
SELECT * FROM diamonds
LIMIT 10;
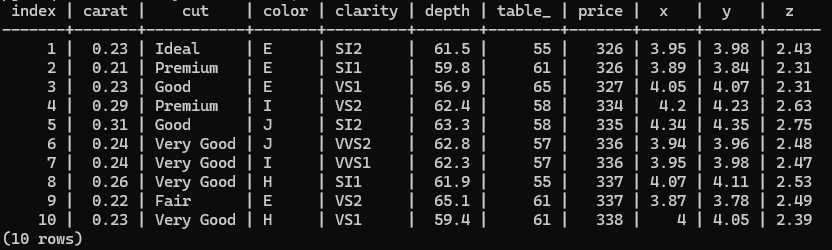
अब, हम मॉडल ट्रेन करने के लिए तैयार हैं!
सुपरवाइज़्ड लर्निंग के लिए मशीन लर्निंग मॉडल का प्रशिक्षण pgml.train फ़ंक्शन से किया जाता है। इसकी बुनियादी संरचना यह है:
SELECT pgml.train(
 project_name => 'Diamond prices prediction',
 task => 'regression',
 relation_name => 'diamonds',
 y_column_name => 'price',
 algorithm => 'xgboost'
);
उपरोक्त SQL कथन diamonds तालिका पर XGBoost रिग्रेसर फिट करता है ताकि हीरे की कीमतें भविष्यवाणी की जा सकें। इस कमांड को चलाने पर आप नोट करेंगे कि यह कितना तेज़ है (लगभग तात्कालिक), जबकि हमारे पास 50,000 से अधिक पंक्तियाँ हैं।
आप कार्यों को आसानी से बदल भी सकते हैं। यहाँ बहु-वर्ग वर्गीकरणकर्ता फिट करने का तरीका है (प्रोजेक्ट नाम बदलना न भूलें):
SELECT pgml.train(
 project_name => 'Diamond cut quality prediction',
 task => 'classification',
 relation_name => 'diamonds',
 y_column_name => 'cut',
 algorithm => 'xgboost',
 test_size => 0.1
);
ध्यान दें कि इस बार हमने test_size आर्ग्युमेंट निर्दिष्ट किया है — कस्टम स्प्लिटिंग भी समर्थित है!
हमने डिफ़ॉल्ट एल्गोरिद्म linear को xgboost में बदला है, लेकिन यह Scikit-learn या अन्य समर्थित फ्रेमवर्क के किसी भी अन्य मॉडल से बदला जा सकता था।
इस बार एक रैंडम फॉरेस्ट मॉडल फिट करने की कोशिश करते हैं:
…
लेकिन ठहरिए! डायमंड्स डेटासेट में टेक्स्ट फीचर्स हैं जिन्हें एन्कोड करने की ज़रूरत है। चूँकि XGBoost मूल रूप से कैटेगोरिकल्स को एन्कोड कर लेता है, इसलिए हमें पिछले क्वेरीज़ से कोई त्रुटि नहीं मिली। रैंडम फॉरेस्ट के साथ ऐसा नहीं हो सकता। तो चलिए अपनी क्वेरी में कुछ पूर्वप्रक्रिया स्टेप्स जोड़ते हैं:
SELECT pgml.train(
   project_name => 'Diamond prices prediction',
   task => 'regression',
   relation_name => 'diamonds',
   y_column_name => 'price',
   algorithm => 'random_forest',
   preprocess => '{
       "carat": {"scale": "standard"},
       "depth": {"scale": "standard"},
       "table_": {"scale": "standard"},
       "cut": {"encode": "target", "scale": "standard"},
       "color": {"encode": "target", "scale": "standard"},
       "clarity": {"encode": "target", "scale": "standard"}
   }'::JSONB
);
पूर्वप्रक्रिया तर्क एक JSONB ऑब्जेक्ट में परिभाषित है, जो कॉलम्स को ट्रांसफॉर्मेशन स्टेप्स से मैप करता है। संख्यात्मक फीचर्स के लिए हम स्टैंडर्डाइज़ेशन का उपयोग कर रहे हैं (हालाँकि RF के लिए स्टैंडर्डाइज़ेशन आवश्यक नहीं है)। कैटेगोरिकल कॉलम्स के लिए हम टार्गेट एन्कोडिंग और फिर स्टैंडर्डाइज़ेशन कर रहे हैं।
PostgresML अन्य वैकल्पिक पूर्वप्रक्रिया फ़ंक्शंस भी देता है। यहाँ उपलब्ध एन्कोडिंग विकल्पों की पूरी सूची है:
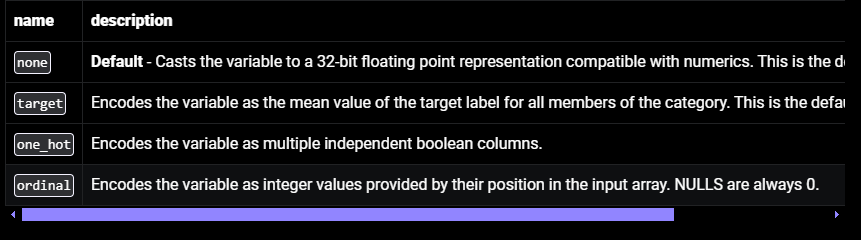
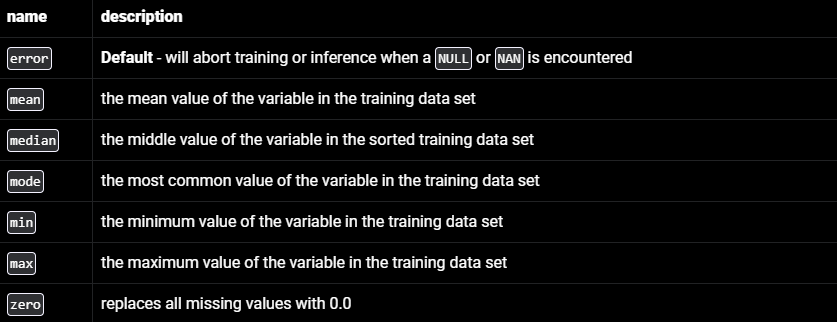
pgml मानक इम्प्यूटिंग तकनीकों का भी समर्थन करता है:
और यहाँ स्केलर्स की सूची है:
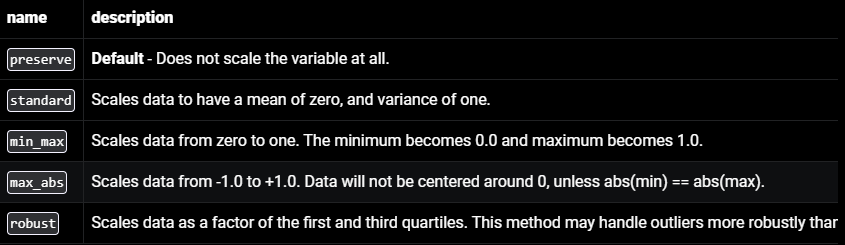
हालाँकि आपको Scikit-learn जैसी व्यापक प्रीप्रोसेसर सूट नहीं मिलता, लेकिन ये अधिकांश सुपरवाइज़्ड लर्निंग कार्यों के लिए पर्याप्त हैं।
अब तक हम एल्गोरिद्म के डिफ़ॉल्ट पैरामीटर का उपयोग कर रहे थे। हालाँकि, वास्तविक समस्याओं के लिए डिफ़ॉल्ट लगभग कभी आदर्श नहीं होते। कस्टम मान निर्दिष्ट करने के लिए, हम pgml.train के hyperparams आर्ग्युमेंट का उपयोग कर सकते हैं:
SELECT pgml.train(
   project_name => 'Diamond prices prediction',
   task => 'regression',
   relation_name => 'diamonds',
   y_column_name => 'price',
   algorithm => 'xgboost',
   hyperparams => '{
       "n_estimators": 1000, "max_depth": 5, "eta": 0.01, "subsample": 0.7
   }'::JSONB
);
इस बार, हम 1000 पेड़ों, 5 की अधिकतम गहराई और 0.01 की लर्निंग रेट के साथ XGBoost रिग्रेसर फिट कर रहे हैं। फिलहाल हम अनुमान लगा रहे हैं, इसलिए ये हाइपरपैरामीटर सटीक परिणाम न भी दें।
मॉडल के परिणामों को अधिकतम करने के लिए, सुपरवाइज़्ड-लर्निंग कार्यों में हमेशा हाइपरपैरामीटर ट्यूनिंग की आवश्यकता होती है। यह प्रक्रिया pgml में train फ़ंक्शन के भीतर समर्थित है। यहाँ थोड़े से हाइपरपैरामीटर संयोजनों पर ग्रिड सर्च करने का तरीका है:
SELECT pgml.train(
   'Diamond prices prediction',
   algorithm => 'xgboost',
   search => 'grid',
   search_params => '{
       "max_depth": [5, 7],
       "n_estimators": [1000, 1500],
       "eta": [0.1, 0.01, 0.001]
   }'::JSONB
);
इस बिंदु पर, मैं बस चाहता हूँ कि आप सराहें कि हम यहाँ क्या कर रहे हैं। हम SQL का उपयोग करके XGBoost रिग्रेसर के हाइपरपैरामीटर ट्यून कर रहे हैं! यह वाक्य मैंने कभी लिखने की नहीं सोची थी।
जब यह ट्यूटोरियल लिखा जा रहा है, PostgresML के पास पर्याप्त परिपक्व मूल्यांकन टूल्स नहीं हैं। हमारे पास केवल predict फ़ंक्शन उपलब्ध है। किसी एक नए सैंपल पर भविष्यवाणी करने के लिए इसका उपयोग इस प्रकार करें:
SELECT pgml.predict(
   project_name => 'Diamond prices prediction',
   features => ARRAY[0.7, "Ideal", "A", "IF", 67.9, 56.9, 7024, 5.85, 5.87, 3.71]
);
predict स्वतः ही आपके प्रयोगों में से सर्वश्रेष्ठ प्रदर्शन करने वाले मॉडल का उपयोग करता है। रिग्रेशन के लिए यह सबसे उच्च R-squared वाला मॉडल होगा, जबकि क्लासिफिकेशन में सबसे उच्च F1-score वाला मॉडल चुना जाता है।
किसी विशिष्ट मॉडल से प्रेडिक्शन कराने के लिए, आप उसका ID दे सकते हैं:
SELECT pgml.predict(
  2' -- Use model with ID of 2,
   features => ARRAY[0.7, "Ideal", "A", "IF", 67.9, 56.9, 7024, 5.85, 5.87, 3.71]
)
लेकिन आप पूछेंगे कि मॉडल IDs कैसे मिलें? यहाँ एक स्निपेट है जो ठीक वही जानकारी वाली एक अच्छी तालिका प्रिंट करता है:
SELECT models.id, models.algorithm, models.metrics
FROM pgml.models
JOIN pgml.projects
 ON projects.id = models.project_id
WHERE projects.name = 'Diamond prices prediction';
इस कथन से आप pgml के बारे में कई वेरिएबल्स और मेट्रिक्स जान सकते हैं, जैसे models.id, pgml.models, pgml.projects आदि। उन पर `SELECT` कथन चलाकर देखें कि वे क्या करते हैं।
पारंपरिक MLOps के विपरीत, यह चरण PostgresML में सबसे आसान है। pgml एक्सटेंशन स्वतः ही आपके प्रयोगों में से सर्वश्रेष्ठ प्रदर्शन करने वाले मॉडल को डिफ़ॉल्ट के रूप में एक्सपोज़ करता है। अतः उपयोगकर्ता द्वारा सर्वर को भेजे गए किसी भी SELECT pgml.predict कथन में वही मॉडल इन्फ़रेंस के लिए उपयोग होगा।
यदि आप यह नियंत्रित करना चाहते हैं कि कौन सा मॉडल प्रोडक्शन में जाए, तो आप pgml.deploy फ़ंक्शन से इसे नियंत्रित कर सकते हैं। इसकी संरचना यह है:
SELECT * FROM pgml.deploy(
   project_name TEXT,
   strategy TEXT DEFAULT 'best_score',
   algorithm TEXT DEFAULT NULL
)
best_score के अलावा, most_recent और rollback डिप्लॉयमेंट रणनीतियाँ भी उपलब्ध हैं:
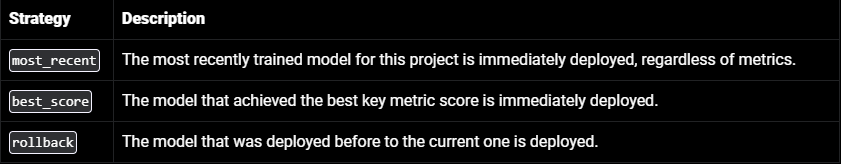
आप strategy और algorithm पैरामीटर को मिलाकर डिप्लॉयमेंट को और संकीर्ण कर सकते हैं। उदाहरण के लिए, नीचे दिया कथन पूरे प्रोजेक्ट के सर्वश्रेष्ठ मॉडल के बजाय सर्वश्रेष्ठ स्कोर वाले XGBoost मॉडल को डिप्लॉय करता है।
SELECT * FROM pgml.deploy(
   project_name => 'Diamond prices prediction',
   strategy => 'best_score',
   algorithm => 'xgboost'
)
सुपरवाइज़्ड लर्निंग PostgresML का केवल एक छोटा हिस्सा है। दरअसल, PostgresML का पूरा वैल्यू प्रपोज़िशन है “Postgres में AI ऐप्स बनाना।” इसे दिखाने के लिए उन्होंने होमपेज पर एक छोटा सा SQL एडिटर भी रखा है:
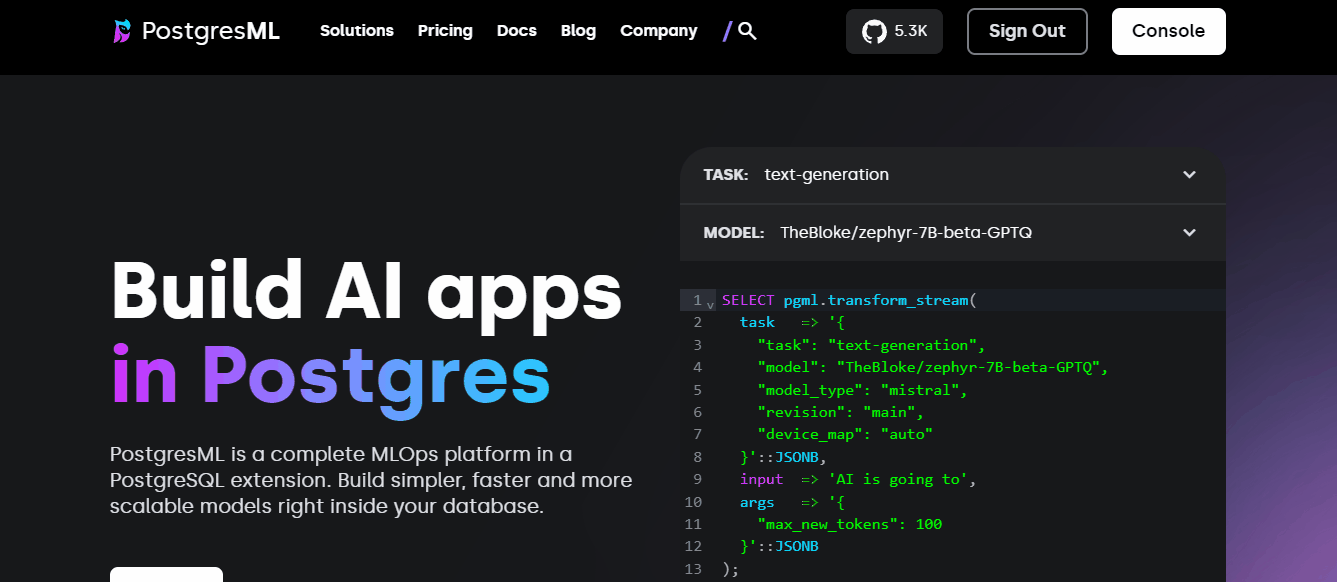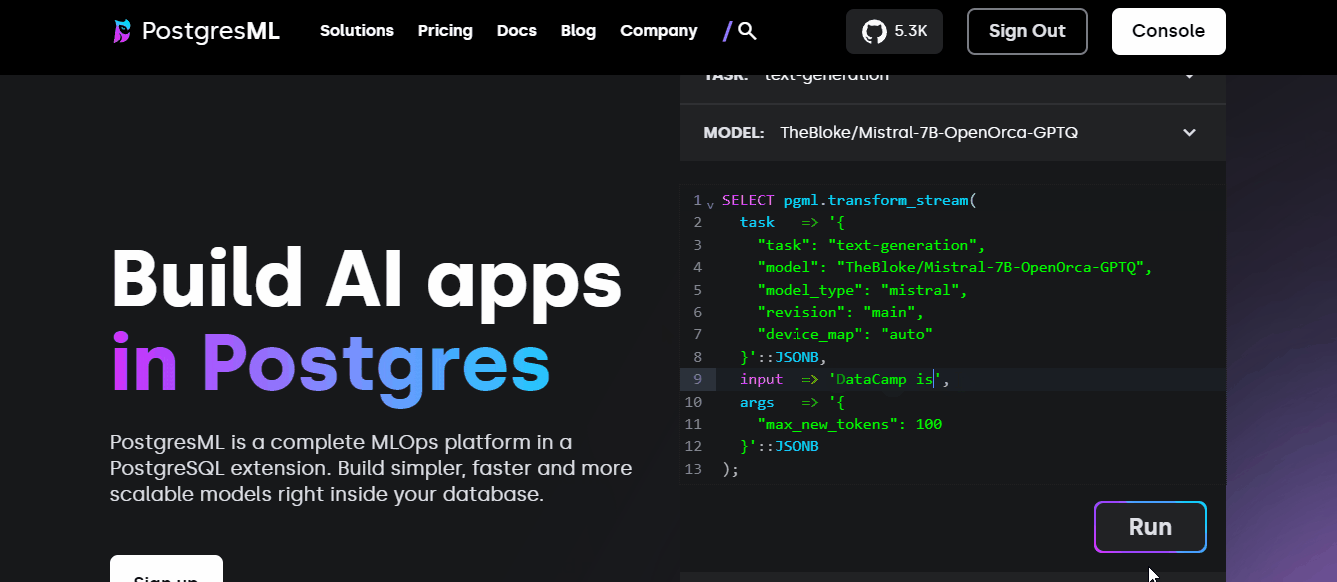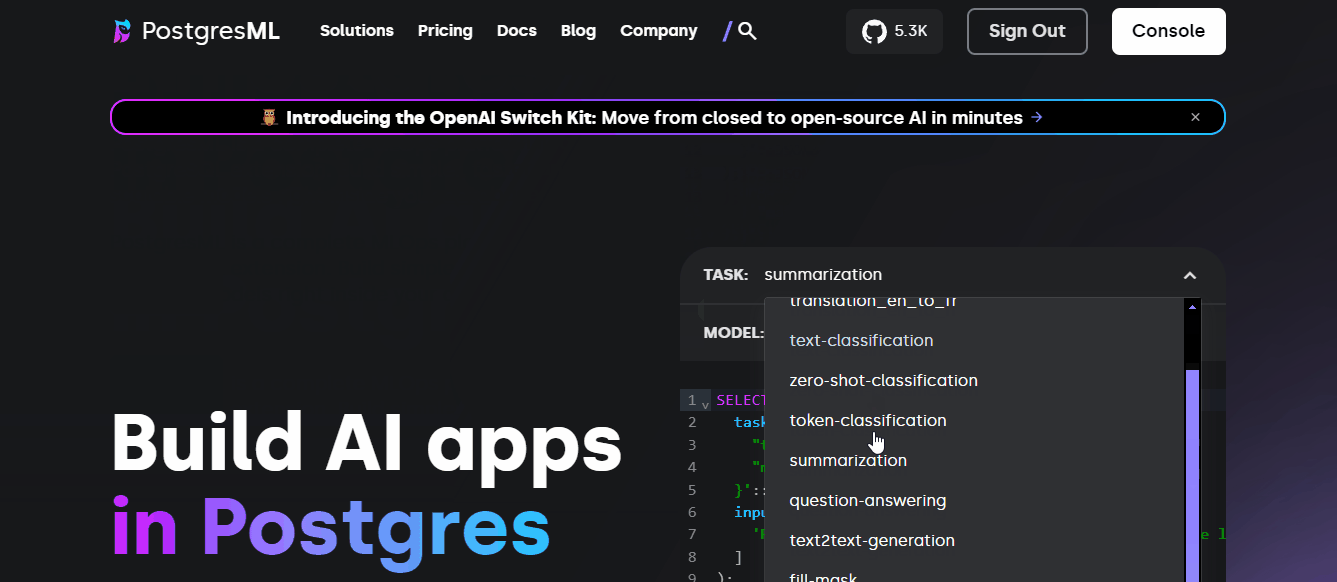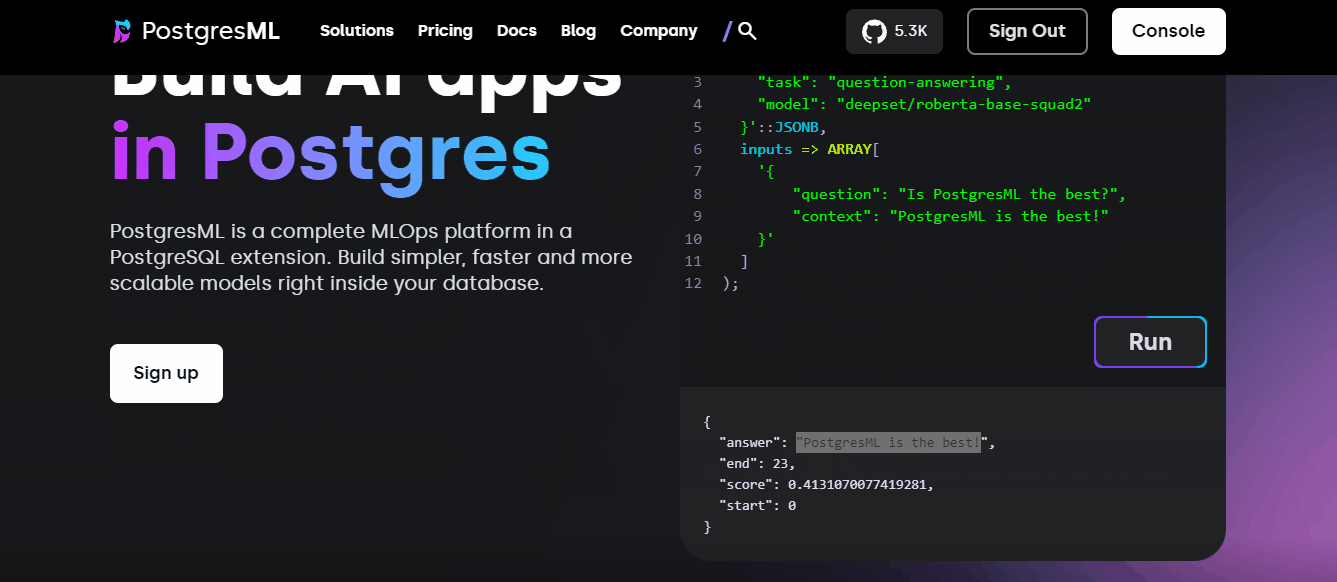
आप इस ट्यूटोरियल में जिस वातावरण का उपयोग कर रहे हैं, उसी में वे उदाहरण सीधे चला सकते हैं!
तो, यदि आप PostgresML के साथ एक उपभोक्ता-उन्मुख मशीन लर्निंग सेवा बनाना चाहें, तो आप कैसे करेंगे? यहाँ कुछ संभावित चरण हैं (मॉडल तैयार होने के बाद):
psycopg2 (Python) या pg-promise (JavaScript) जैसी लाइब्रेरियों से अपने PostgresML डेटाबेस से कनेक्ट करें।pgml.predict कॉल किया जाता है।यह एक मोटा-सा खाका है, जो उपयोग-केस के अनुसार काफी बदल सकता है।
PostgresML मशीन लर्निंग में एक बिल्कुल नया प्रतिमान पेश करता है, इसलिए इसे अच्छी तरह सीखने में एक ट्यूटोरियल से अधिक समय लगेगा। अपनी समझ को पुख्ता करने और PostgresML के अन्य उपयोग तरीकों का पता लगाने के लिए, PostgresML डॉक्यूमेंटेशन के यूज़-केस सेक्शन को पढ़ें।
यदि आपकी SQL स्किल्स थोड़ी जंग खा गई हैं, तो आप DataCamp का छोटा कोर्स creating PostgreSQL databases या पूरा Data Analyst in SQL करियर ट्रैक कर सकते हैं।
चूँकि PostgresML का फोकस AI पर काफ़ी है, आप कुछ AI मूलभूत बातें भी सीख सकते हैं:
आज ही अपनी AI यात्रा आगे बढ़ाएँ!
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}