
Kurs
Konzepte großer Sprachmodelle (LLMs)
2 Std.
109.8K
Der gängige Ansatz im Machine Learning ist, die Daten in die Umgebung des Modells zu verschieben, um dort zu trainieren. Aber was wäre, wenn wir das umdrehen? Da heutige Datenbanken um Größenordnungen größer sind als ML-Modelle, wäre es nicht viel einfacher, die Modelle zu den Datensätzen zu bringen?
Genau darauf setzt PostgresML — die Daten bleiben, wo sie sind, und du bringst deinen Code in die Datenbank. Dieses umgekehrte Denkmuster im Machine Learning bringt eine Reihe handfester Vorteile mit sich, die deine Vorstellung davon, was eine „Datenbank“ ist, grundlegend verändern.
PostgresML ist eine umfassende Machine-Learning-Plattform auf Basis der beliebten PostgreSQL-Datenbank. Sie führt ein neues Paradigma ein: „In-Database“-Machine Learning. Damit kannst du viele ML-Aufgaben direkt mit SQL erledigen, ohne für jeden Schritt separate Tools zu brauchen.
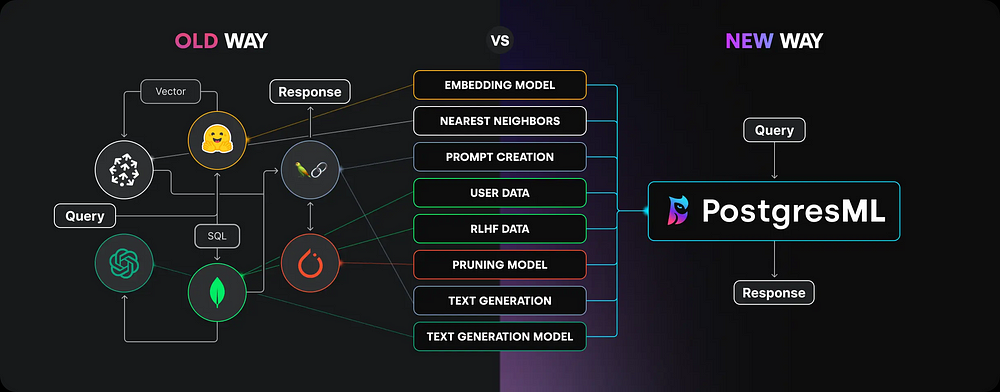
Auch wenn PostgresML noch relativ neu ist, verspricht es klare Vorteile:
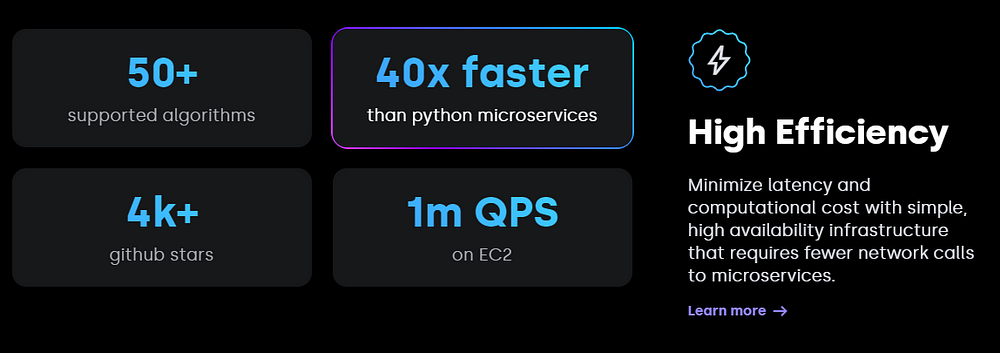
All das probieren wir in diesem Tutorial aus – entlang eines typischen Machine-Learning-Workflows:
…und zwar alles innerhalb einer Postgres-Datenbank. Legen wir los!
Erstelle zuerst ein kostenloses Konto unter https://postgresml.org/signup:
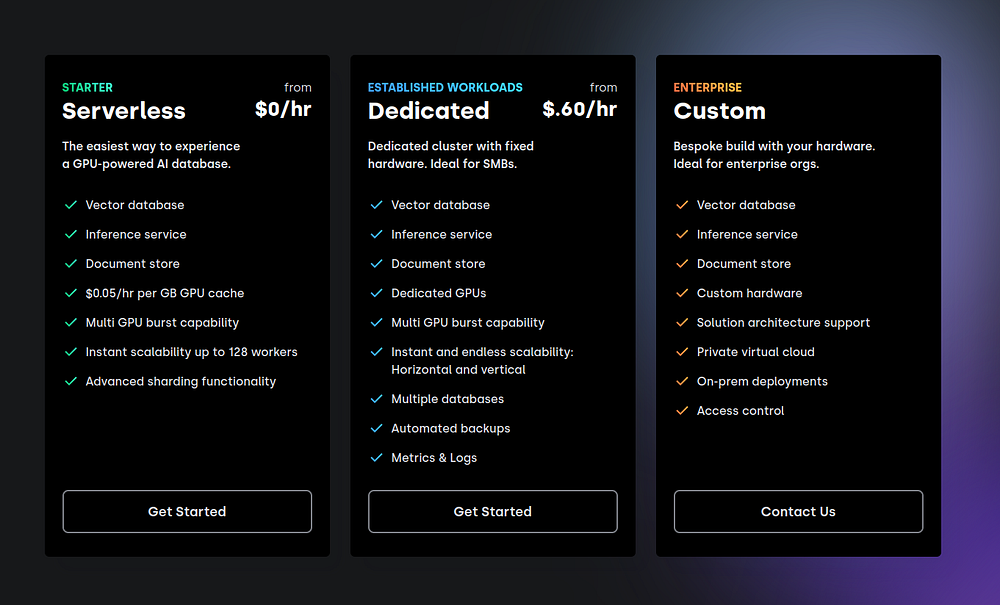
Wähle dann die kostenlose Stufe – die ist überraschend großzügig ausgestattet:
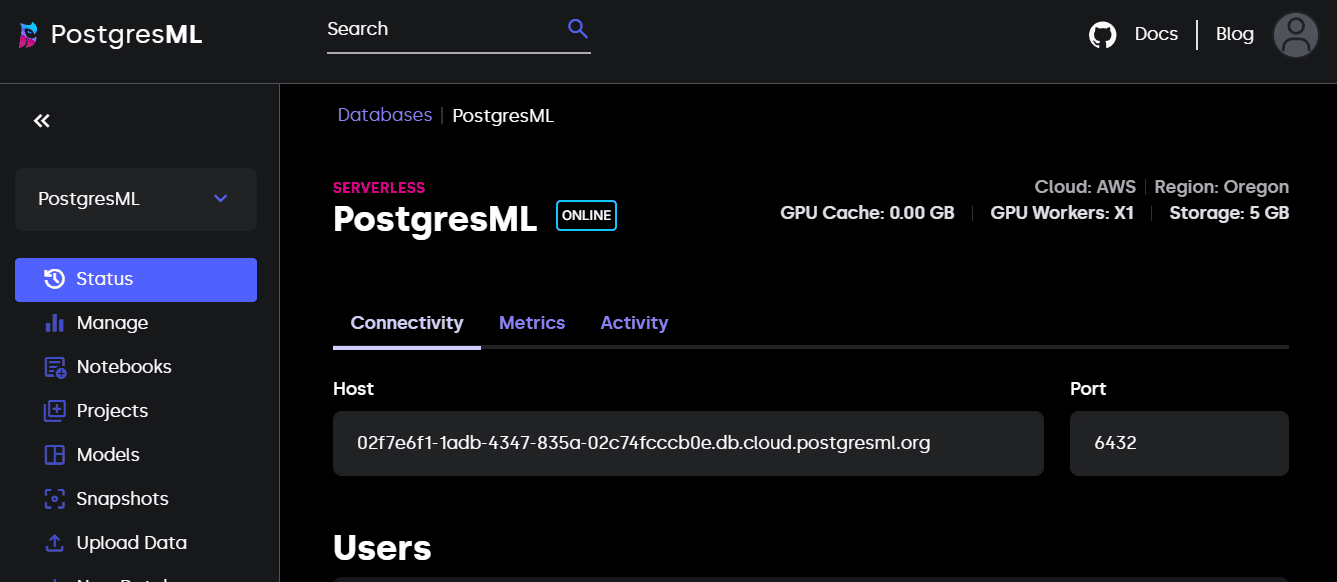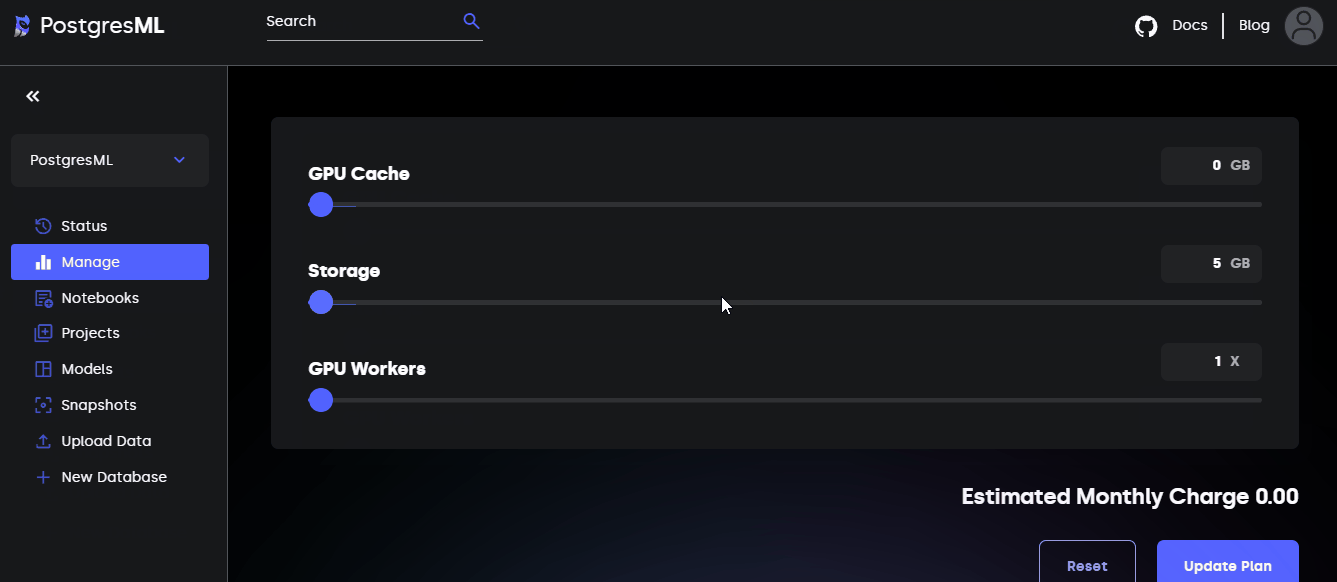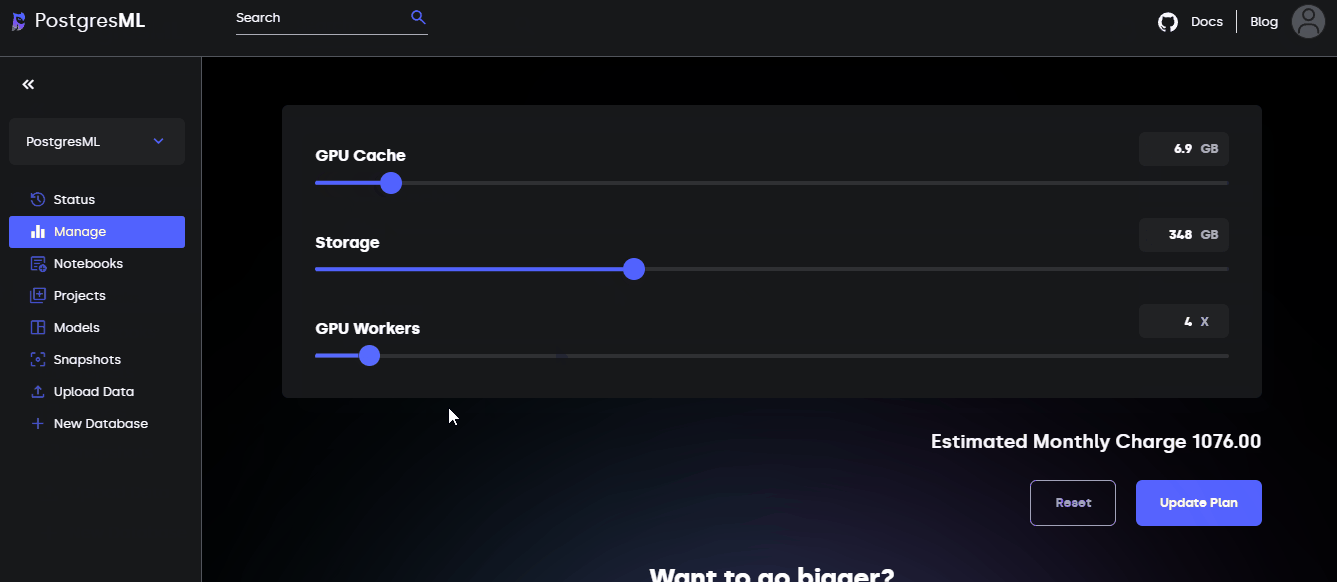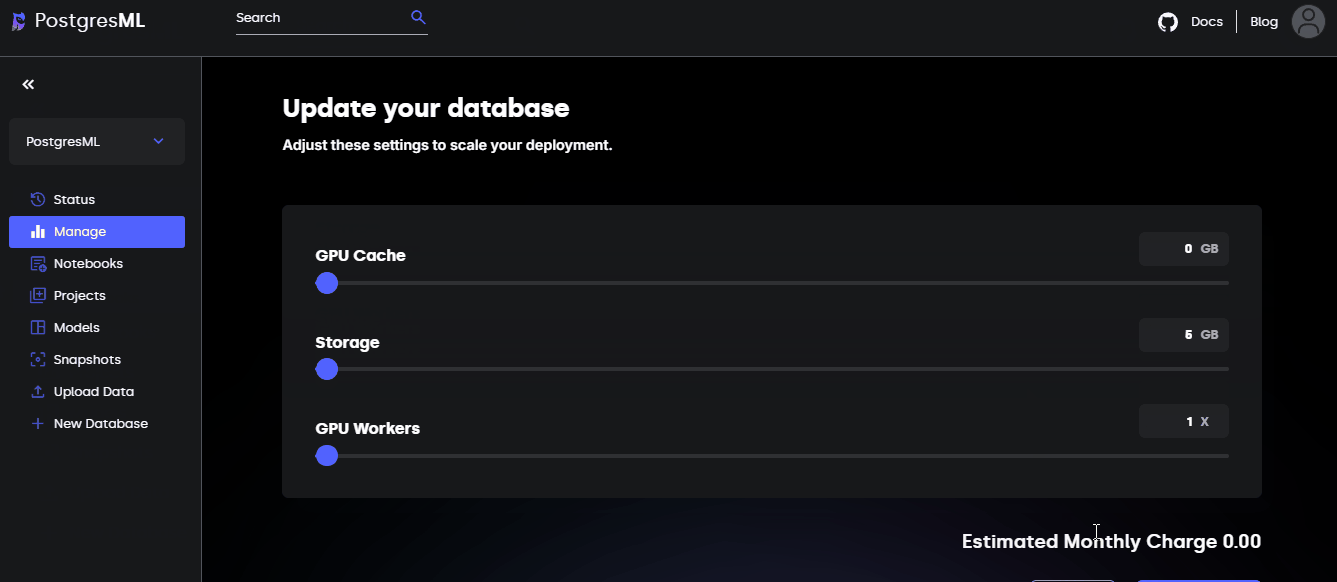
Nach der Anmeldung landest du in deiner PostgresML-Konsole. Hier verwaltest du deine „In-Database-ML“-Projekte und die zugehörigen Ressourcen.
Im Bereich „Manage“ kannst du deine Umgebung an deine Compute-Anforderungen anpassen und skalieren:
Wie der Name schon sagt, brauchen wir PostgreSQL auf unserem System, um PostgresML zu verwenden. Falls du Postgres noch nicht kennst: Das ist laut eigener Aussage die weltweit fortschrittlichste Open-Source-Datenbank.
Hier sind plattformspezifische Installationsanleitungen für PostgreSQL:
Ich nutze WSL2, daher reicht Folgendes:
$ sudo apt update
$ sudo apt install postgresql postgresql-contrib
$ sudo passwd postgres  # Set a new Postgres password
# Close and reopen your terminal and done!
Danach prüfst du die Installation mit:
$ psql --version
psql (PostgreSQL) 12.18 (Ubuntu 12.18-0ubuntu0.20.04.1)
psql ist der offizielle Postgres-Client, um Datenbanken im Terminal zu verbinden und zu verwalten.
Für viele ist es nicht ideal, SQL in einem tristen Terminal zu tippen. Du kannst daher nach der Postgres-Installation auch diese VSCode-Erweiterung installieren:
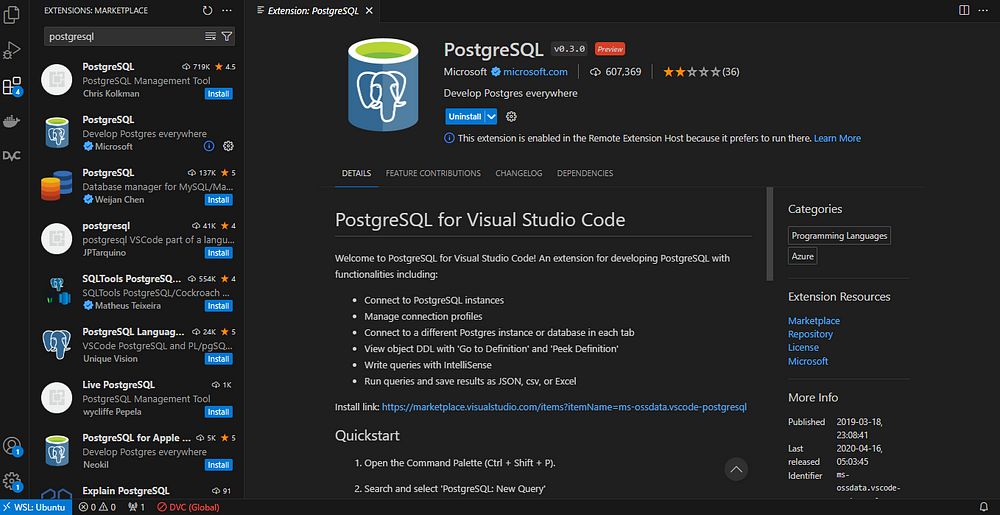
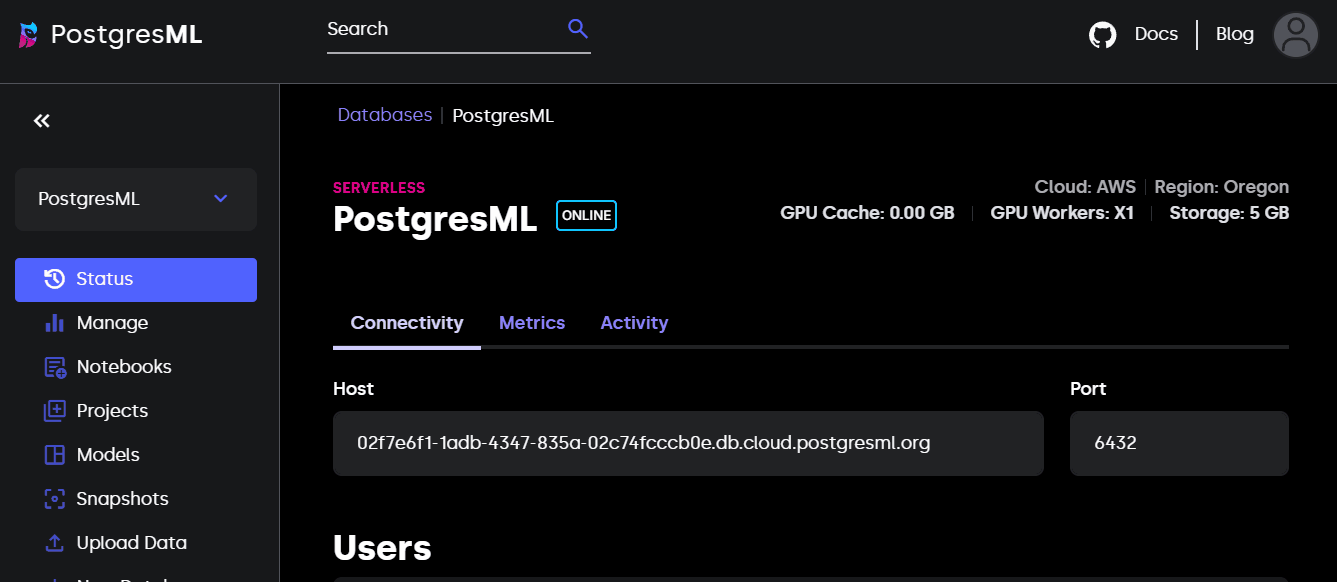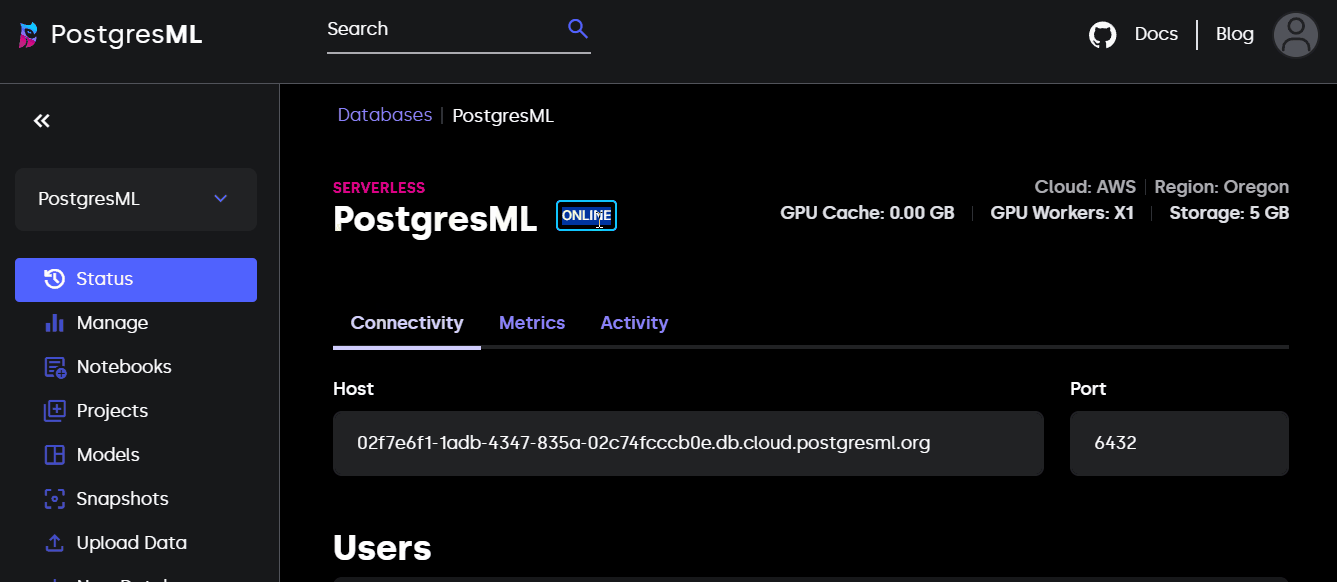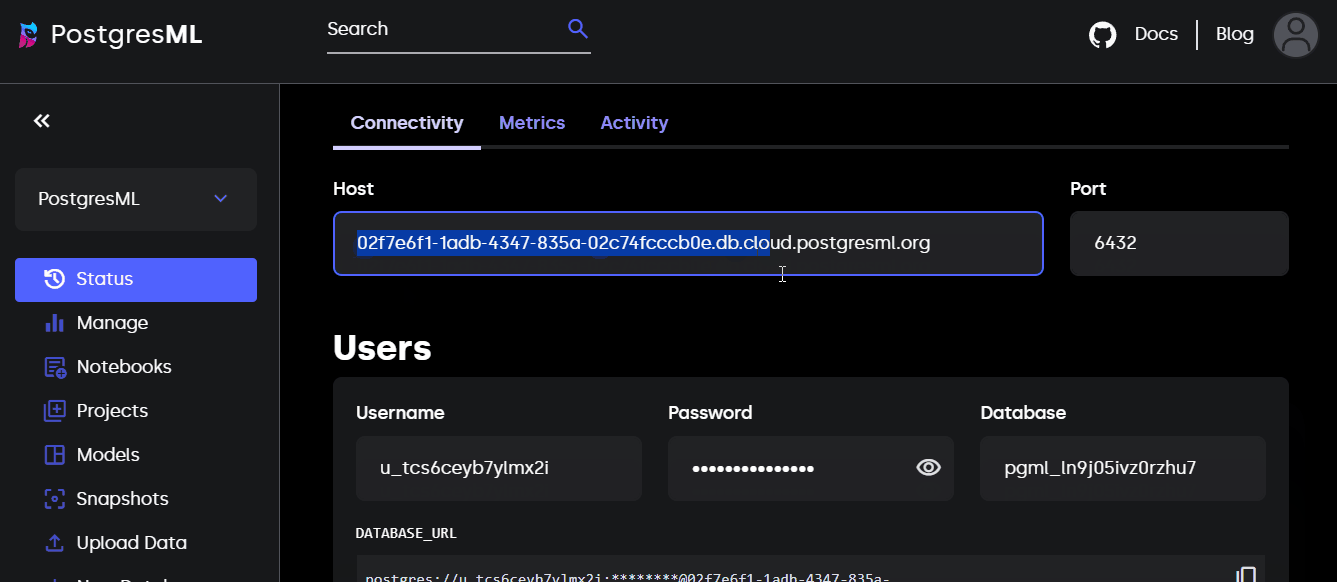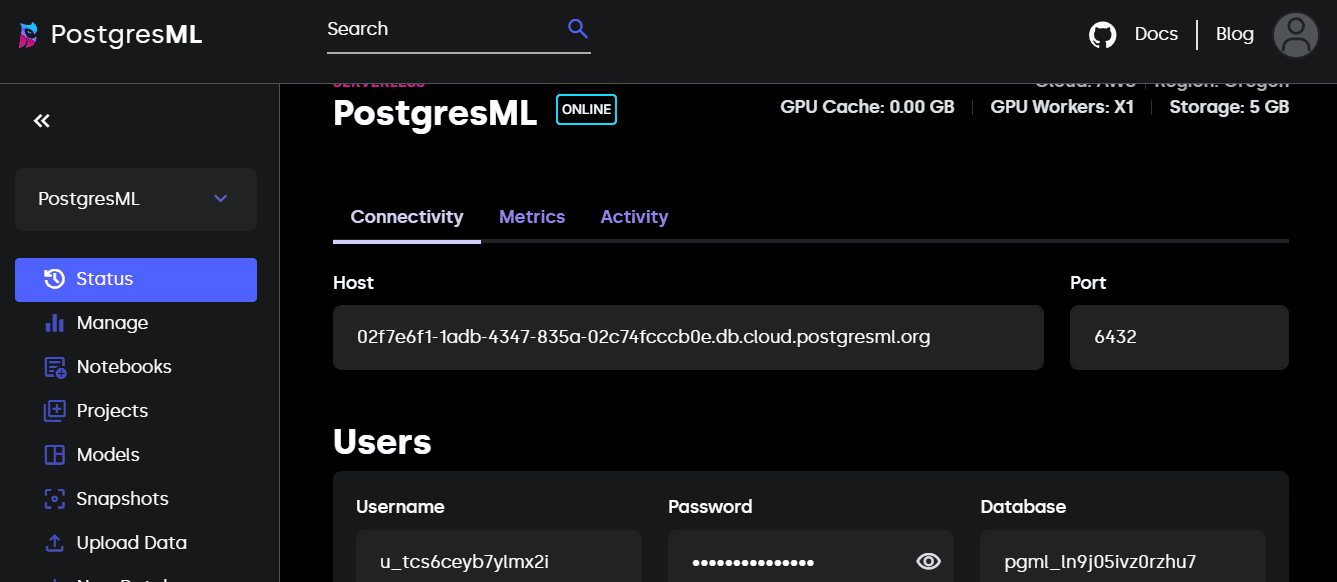
Erinnerst du dich an die Startseite deiner PostgresML-Konsole? Lass sie in einem separaten Tab geöffnet:
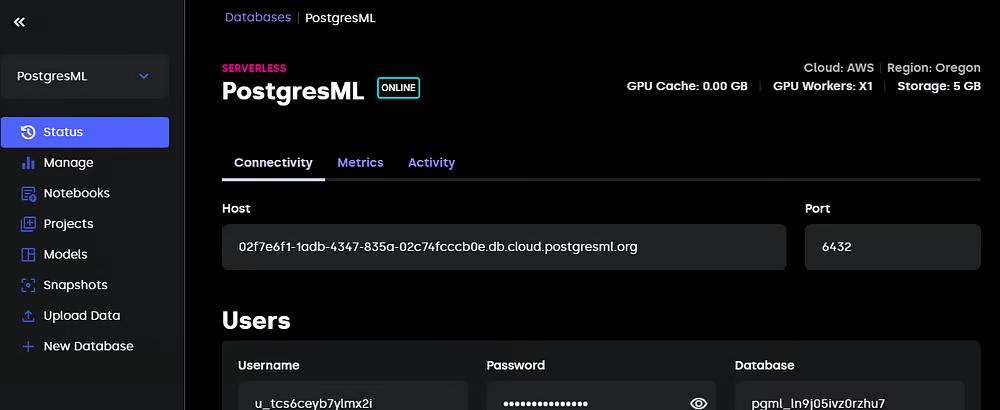
Jetzt kannst du mit psql und deinen Zugangsdaten die Verbindung zum PostgresML-Server herstellen:
$ psql -h "host" \
      -U "username" \
      -p 6432 \
      -d "database_name"
Wenn du die VSCode-Erweiterung nutzt, folge diesen Schritten (aus der Installationsseite übernommen):
Und schon bist du mit deiner PostgresML-Datenbank verbunden.
Als Nächstes erstellen wir die pgml-Erweiterung, mit der wir PostgresML-Funktionen ausführen können:
CREATE EXTENSION IF NOT EXISTS pgml;

NOTICE:  extension "pgml" already exists, skipping
CREATE EXTENSION
-- Your output may be different.
Prüfe den Erfolg, indem du die pgml-Version ausgibst:
SELECT pgml.version();

2.8.2 (98f114891db58acd472e068c44272b198274b11d)
Jetzt laden wir Daten in die Datenbank. Zur Vereinfachung erstellen wir nur eine Tabelle mit dem Diamonds-Datensatz von Kaggle. Du kannst ihn als CSV von der Website laden oder mit dem folgenden Python-Snippet:
import seaborn as sns

diamonds = sns.load_dataset("diamonds")
diamonds.to_csv("diamonds.csv", index=False)
Erstelle dann die Tabelle mit dem passenden Schema per CREATE:
CREATE TABLE IF NOT EXISTS diamonds (
   index SERIAL PRIMARY KEY,
   carat FLOAT,
   cut VARCHAR(255),
   color VARCHAR(255),
   clarity VARCHAR(255),
   depth FLOAT,
   table_ FLOAT,
   price INT,
   x FLOAT,
   y FLOAT,
   z FLOAT
)
Dieser Befehl legt eine Tabelle diamonds an, die wir mit den Zeilen aus der CSV befüllen können:
INSERT INTO diamonds
   (carat, cut, color, clarity, depth, table_, price, x, y, z)
   FROM '~/full/path/to/diamonds.csv'
   DELIMITER ','
   CSV HEADER;
Zum Schluss geben wir zur Kontrolle den Tabellenkopf aus, um zu sehen, ob der letzte Befehl erfolgreich war:
SELECT * FROM diamonds
LIMIT 10;
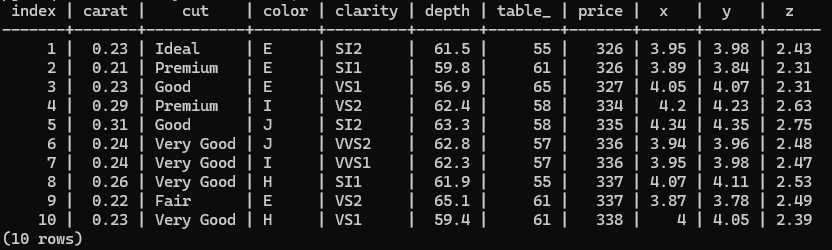
Jetzt sind wir bereit zum Trainieren!
Das Training eines Modells für Supervised Learning erfolgt mit der Funktion pgml.train. So sieht die Grundstruktur aus:
SELECT pgml.train(
 project_name => 'Diamond prices prediction',
 task => 'regression',
 relation_name => 'diamonds',
 y_column_name => 'price',
 algorithm => 'xgboost'
);
Die obige SQL-Anweisung trainiert einen XGBoost-Regressor auf der Tabelle diamonds, um Diamantpreise vorherzusagen. Auffällig ist, wie schnell das geht (nahezu sofort) – trotz mehr als 50.000 Zeilen.
Du kannst die Aufgabe auch leicht wechseln. So trainierst du einen Multiclass-Classifier (denk an einen neuen Projektnamen):
SELECT pgml.train(
 project_name => 'Diamond cut quality prediction',
 task => 'classification',
 relation_name => 'diamonds',
 y_column_name => 'cut',
 algorithm => 'xgboost',
 test_size => 0.1
);
Beachte, dass wir diesmal das Argument test_size setzen – individuelles Splitting ist ebenfalls möglich!
Außerdem haben wir den Standardalgorithmus linear auf xgboost geändert. Du könntest aber auch jedes andere Modell aus Scikit-learn oder einem unterstützten Framework wählen.
Probieren wir diesmal einen Random-Forest aus:
…
Moment! Der Diamonds-Datensatz enthält Textmerkmale, die encodiert werden müssen. XGBoost encodiert Kategorien nativ, daher gab es zuvor keine Fehler. Beim Random Forest ist das nicht selbstverständlich. Also fügen wir Vorverarbeitungsschritte in der Query hinzu:
SELECT pgml.train(
   project_name => 'Diamond prices prediction',
   task => 'regression',
   relation_name => 'diamonds',
   y_column_name => 'price',
   algorithm => 'random_forest',
   preprocess => '{
       "carat": {"scale": "standard"},
       "depth": {"scale": "standard"},
       "table_": {"scale": "standard"},
       "cut": {"encode": "target", "scale": "standard"},
       "color": {"encode": "target", "scale": "standard"},
       "clarity": {"encode": "target", "scale": "standard"}
   }'::JSONB
);
Die Vorverarbeitung legst du in einem JSONB-Objekt fest, das Spalten auf Transformationsschritte abbildet. Für numerische Features nutzen wir Standardisierung (auch wenn RF sie nicht zwingend braucht). Kategorische Spalten encodieren wir per Target Encoding und standardisieren anschließend.
PostgresML bietet zudem weitere Vorverarbeitungsfunktionen. Hier sind die verfügbaren Encoding-Optionen:
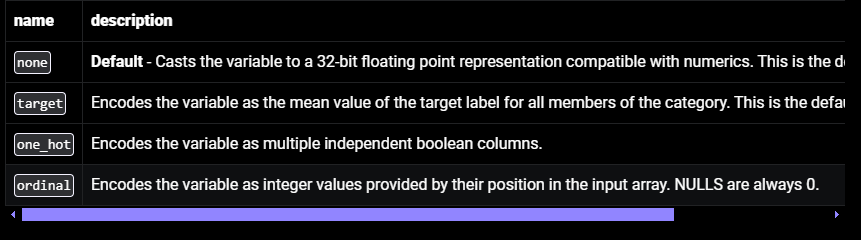
pgml unterstützt auch gängige Imputing-Methoden:
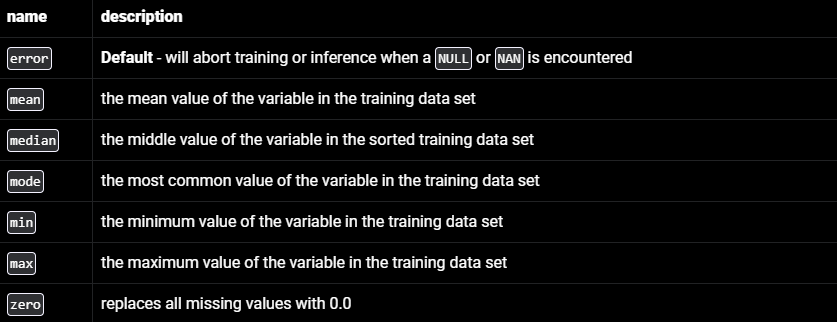
Und hier eine Übersicht der Skalierer:
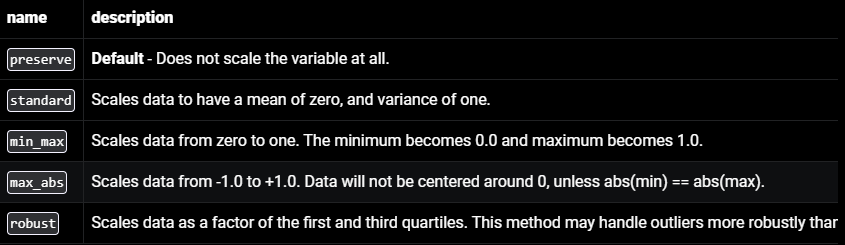
Auch wenn der Umfang nicht an Scikit-learn heranreicht, reicht das für die meisten Supervised-Learning-Aufgaben völlig aus.
Bis jetzt haben wir die Standardparameter der Algorithmen genutzt. In realen Projekten sind Defaults jedoch selten optimal. Eigene Werte definierst du mit dem Argument hyperparams in pgml.train:
SELECT pgml.train(
   project_name => 'Diamond prices prediction',
   task => 'regression',
   relation_name => 'diamonds',
   y_column_name => 'price',
   algorithm => 'xgboost',
   hyperparams => '{
       "n_estimators": 1000, "max_depth": 5, "eta": 0.01, "subsample": 0.7
   }'::JSONB
);
Hier trainieren wir einen XGBoost-Regressor mit 1000 Bäumen, einer maximalen Tiefe von 5 und einer Lernrate von 0,01. Aktuell schießen wir noch ins Blaue – diese Hyperparameter müssen nicht zwingend gute Ergebnisse liefern.
Um das Maximum aus dem Modell zu holen, brauchen wir Hyperparameter-Tuning. Auch das unterstützt pgml innerhalb der train-Funktion. So führst du eine Grid Search über eine kleine Kombinationsmenge aus:
SELECT pgml.train(
   'Diamond prices prediction',
   algorithm => 'xgboost',
   search => 'grid',
   search_params => '{
       "max_depth": [5, 7],
       "n_estimators": [1000, 1500],
       "eta": [0.1, 0.01, 0.001]
   }'::JSONB
);
An dieser Stelle darfst du kurz wertschätzen, was hier passiert. Wir stimmen die Hyperparameter eines XGBoost-Regressors mit SQL ab! Das hätte ich selbst nicht erwartet.
Zum Zeitpunkt dieses Tutorials sind die Evaluationswerkzeuge von PostgresML noch überschaubar. Aktuell steht uns vor allem die Funktion predict zur Verfügung. So sagst du für eine neue, einzelne Stichprobe etwas voraus:
SELECT pgml.predict(
   project_name => 'Diamond prices prediction',
   features => ARRAY[0.7, "Ideal", "A", "IF", 67.9, 56.9, 7024, 5.85, 5.87, 3.71]
);
predict nutzt automatisch das bestabschneidende Modell aus deinen Experimenten. Bei Regression ist das Modell mit dem höchsten R², bei Klassifikation das mit dem höchsten F1-Score.
Wenn du ein bestimmtes Modell für die Vorhersage verwenden willst, kannst du dessen ID angeben:
SELECT pgml.predict(
  2' -- Use model with ID of 2,
   features => ARRAY[0.7, "Ideal", "A", "IF", 67.9, 56.9, 7024, 5.85, 5.87, 3.71]
)
Und wie findest du die Modell-IDs? Diese Abfrage gibt dir eine übersichtliche Tabelle mit genau den Informationen:
SELECT models.id, models.algorithm, models.metrics
FROM pgml.models
JOIN pgml.projects
 ON projects.id = models.project_id
WHERE projects.name = 'Diamond prices prediction';
Über solche Statements lernst du viele Variablen und Metriken in pgml kennen, etwa models.id, pgml.models, pgml.projects und mehr. Probiere SELECT-Abfragen darauf aus, um ein Gefühl dafür zu bekommen.
Anders als im klassischen MLOps ist dieser Schritt in PostgresML am einfachsten. Die Erweiterung pgml stellt das bestabschneidende Modell aus deinen Experimenten automatisch als Standard bereit. Alle SELECT pgml.predict-Anfragen nutzen dieses Modell für Inferenz.
Wenn du präziser steuern willst, welches Modell live geht, nutzt du pgml.deploy. So ist die Funktion aufgebaut:
SELECT * FROM pgml.deploy(
   project_name TEXT,
   strategy TEXT DEFAULT 'best_score',
   algorithm TEXT DEFAULT NULL
)
Neben best_score gibt es auch die Strategien most_recent und rollback:
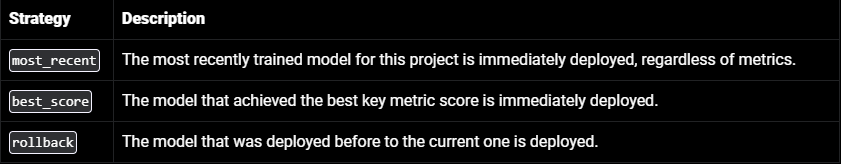
Durch die Kombination von strategy und algorithm kannst du das Deployment weiter eingrenzen. Zum Beispiel deployt das folgende Statement das bestbewertete XGBoost-Modell – nicht zwingend das insgesamt beste im Projekt.
SELECT * FROM pgml.deploy(
   project_name => 'Diamond prices prediction',
   strategy => 'best_score',
   algorithm => 'xgboost'
)
Supervised Learning ist nur ein kleiner Teil von PostgresML. Der eigentliche Wertversprechen lautet: „KI-Apps in Postgres bauen.“ Zur Veranschaulichung gibt es auf der Startseite sogar einen kleinen SQL-Editor:
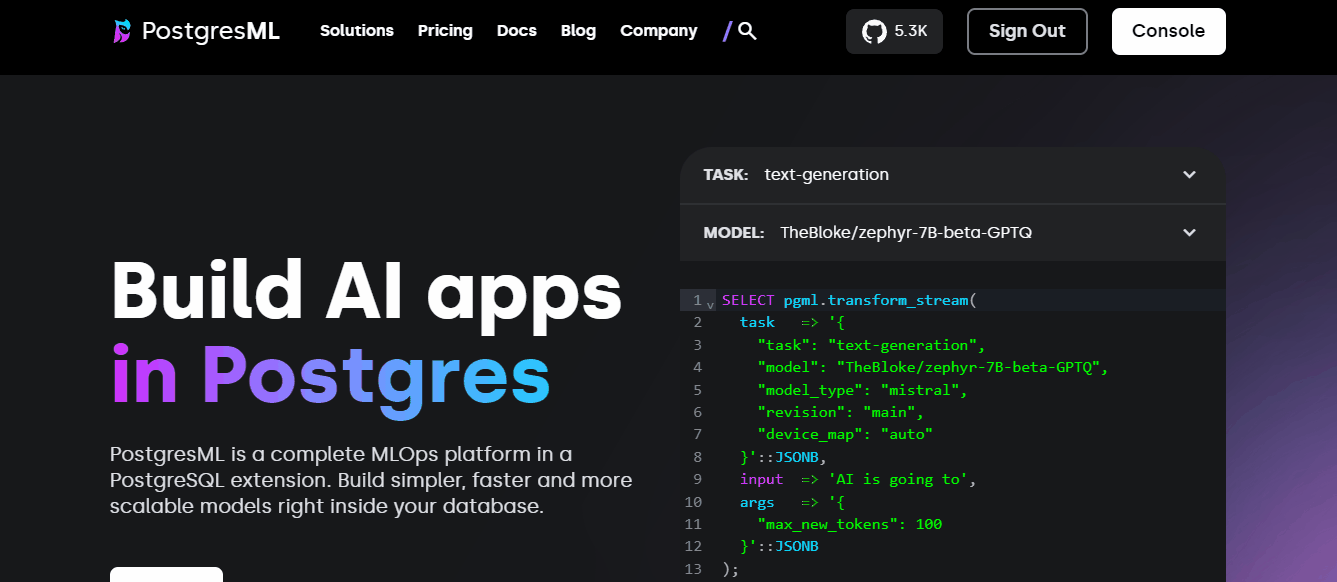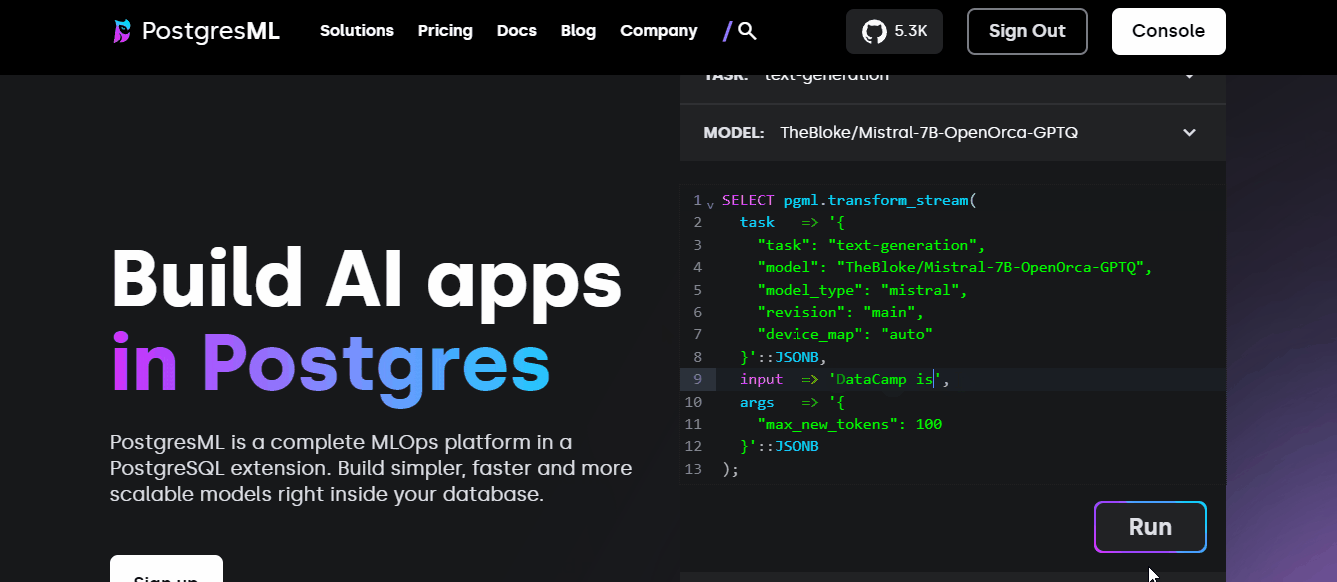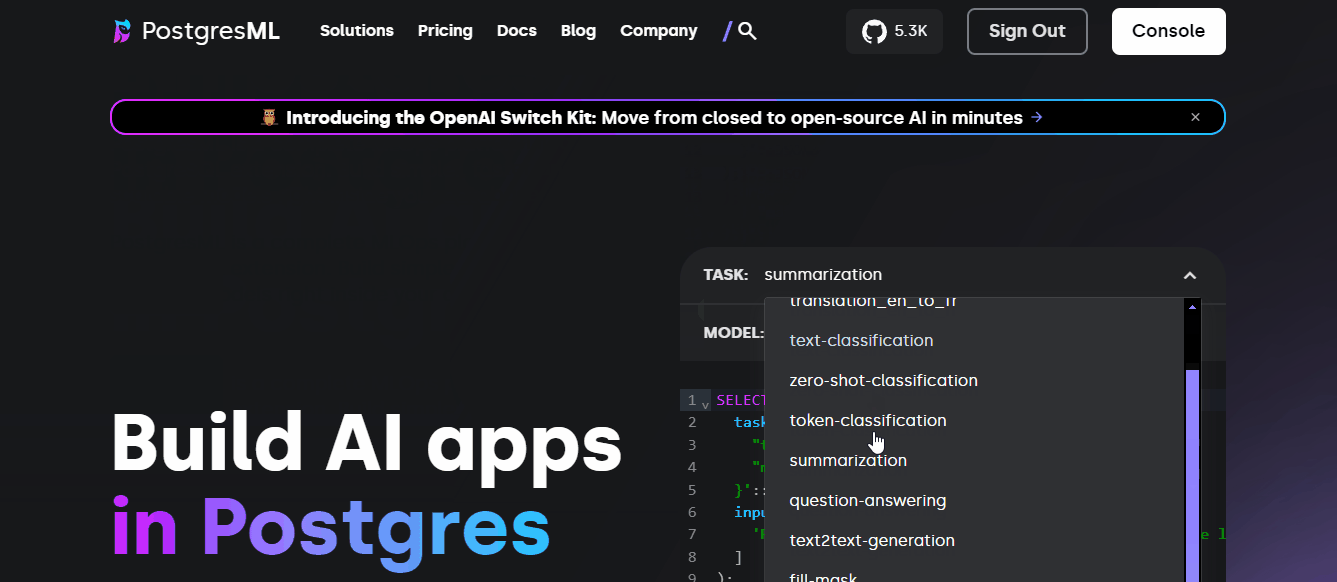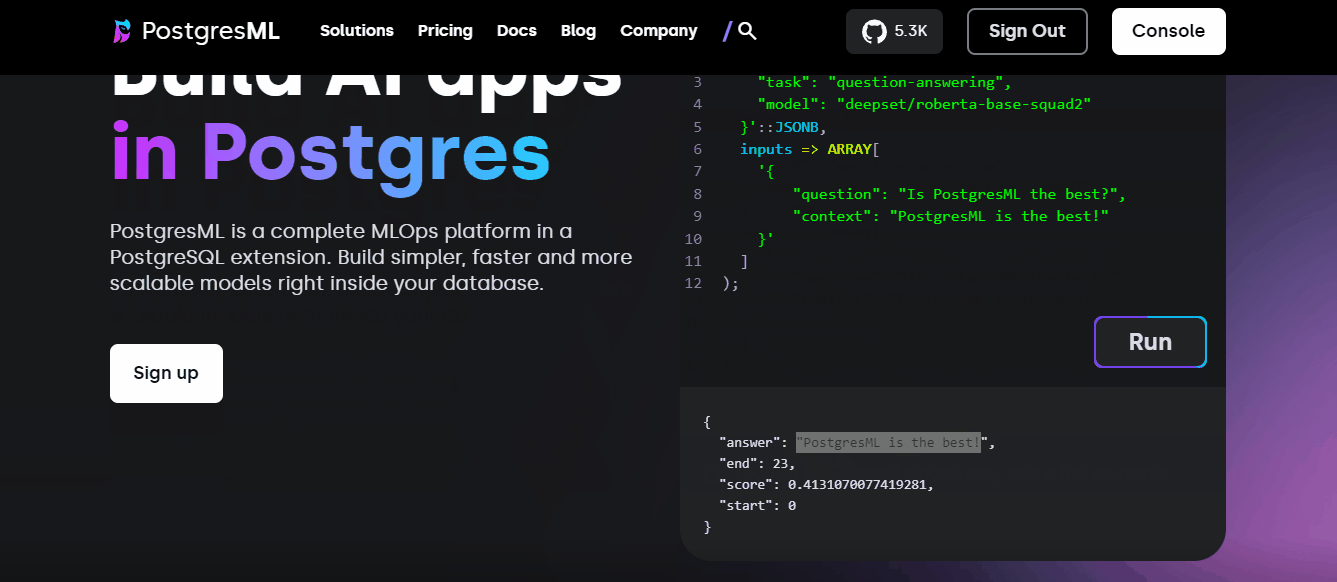
Diese Beispiele kannst du direkt in der Umgebung ausführen, die du in diesem Tutorial verwendet hast!
Wie würdest du nun einen Consumer-Service auf Basis von PostgresML aufbauen? Mögliche Schritte (nachdem das Modell steht):
psycopg2 (Python) oder pg-promise (JavaScript).pgml.predict auf.Das ist eine grobe Skizze, die je nach Use Case stark variieren kann.
PostgresML führt ein völlig neues Paradigma im Machine Learning ein. Um es zu meistern, braucht es mehr als ein einziges Tutorial. Vertiefe dein Verständnis und entdecke weitere Einsatzmöglichkeiten im Use-Case-Bereich der PostgresML-Dokumentation.
Wenn deine SQL-Kenntnisse etwas eingerostet sind, empfehlen wir den kurzen DataCamp-Kurs zu PostgreSQL-Datenbanken erstellen oder sogar den gesamten Data Analyst in SQL-Lernpfad.
Weil PostgresML stark auf KI fokussiert ist, lohnt sich auch ein Blick in die KI-Grundlagen:
Starte noch heute deine KI-Reise!
Kurs
Lernpfad
Lernpfad