Curso
Conceitos de Grandes Modelos de Linguagem (LLMs)
2 h
110K
A tendência dominante em machine learning é levar os dados para o ambiente do modelo para treinar. Mas e se fizéssemos o contrário? Como os bancos de dados de hoje são ordens de grandeza maiores que os modelos de machine learning, não seria muito mais simples trazer os modelos até os datasets?
Essa é a ideia central do PostgresML — os dados ficam onde estão, e você leva seu código para o banco. Esse tipo de ML de lógica invertida traz uma série de benefícios práticos que fazem você repensar o conceito de “banco de dados”.
O PostgresML é uma plataforma completa de machine learning construída sobre o popular banco de dados PostgreSQL. Ele apresenta um novo paradigma chamado machine learning “in-database”, que permite executar muitas tarefas de ML em SQL sem precisar de ferramentas separadas a cada etapa.
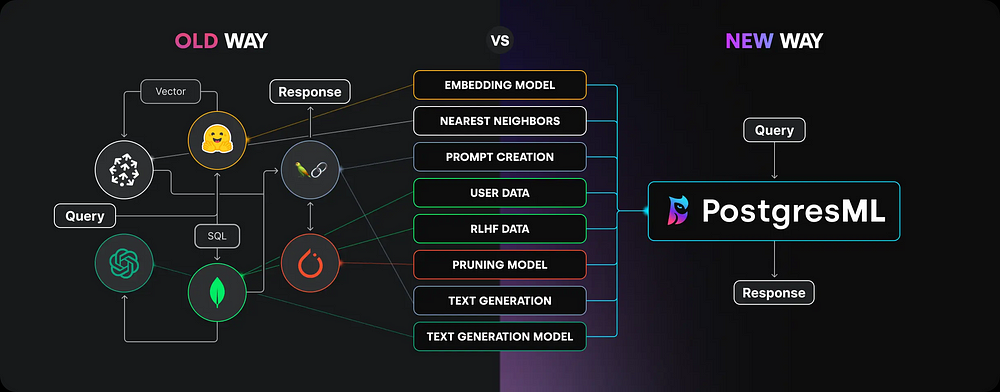
Apesar de relativamente novo, o PostgresML promete estes benefícios:
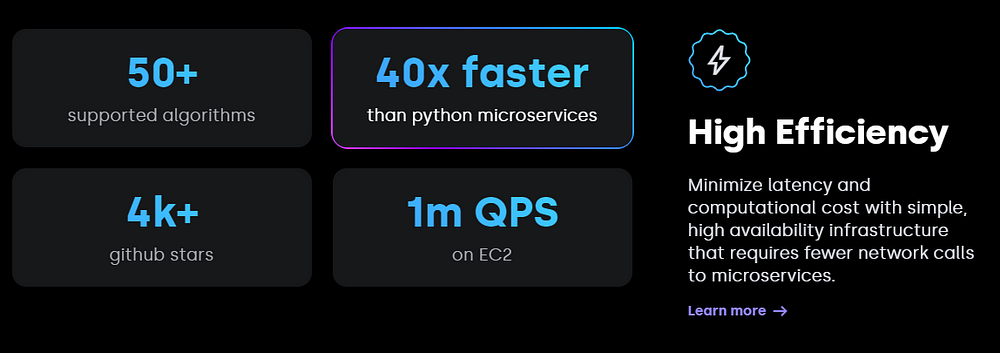
Vamos explorar todos esses recursos neste tutorial seguindo um fluxo típico de machine learning:
…tudo dentro de um banco Postgres. Vamos lá!
Primeiro, crie uma conta gratuita em https://postgresml.org/signup:
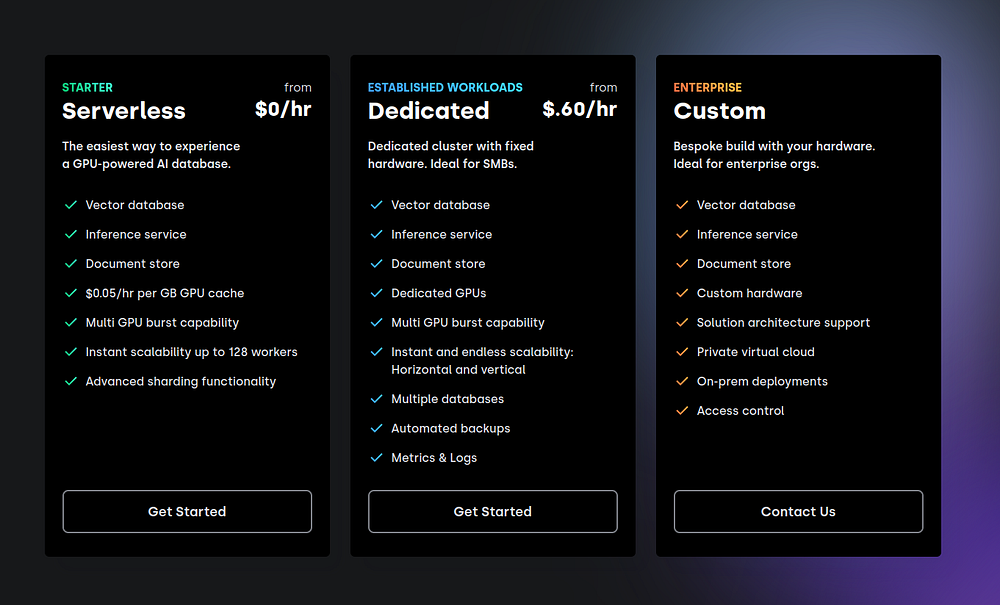
Depois, escolha o plano gratuito, que oferece recursos bem generosos:
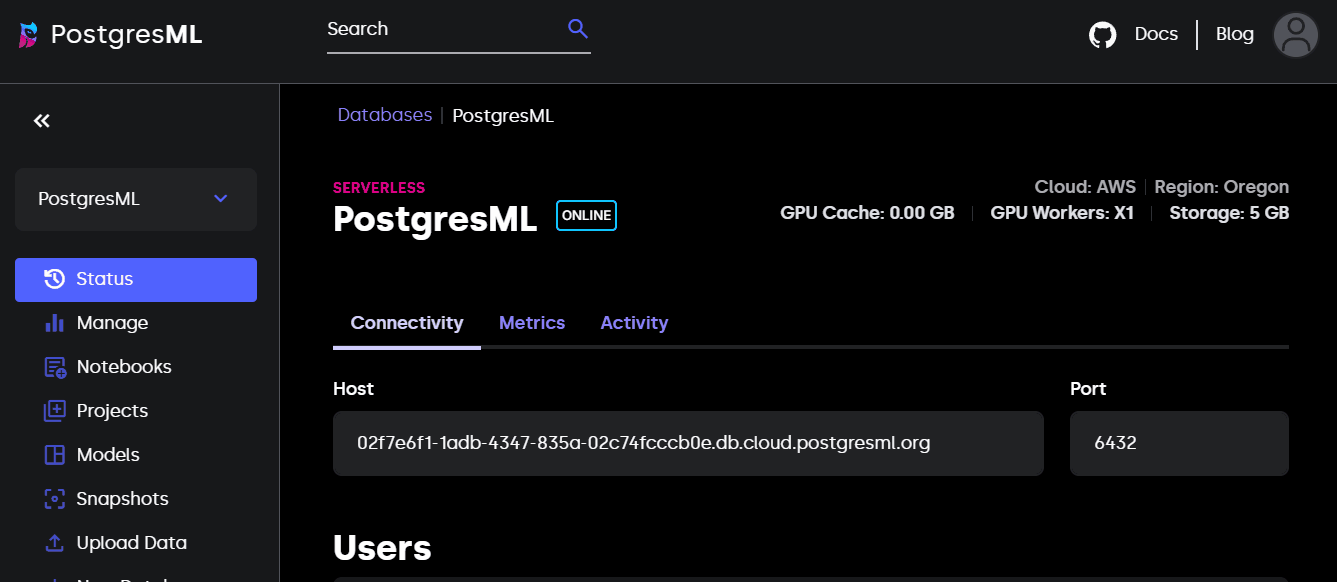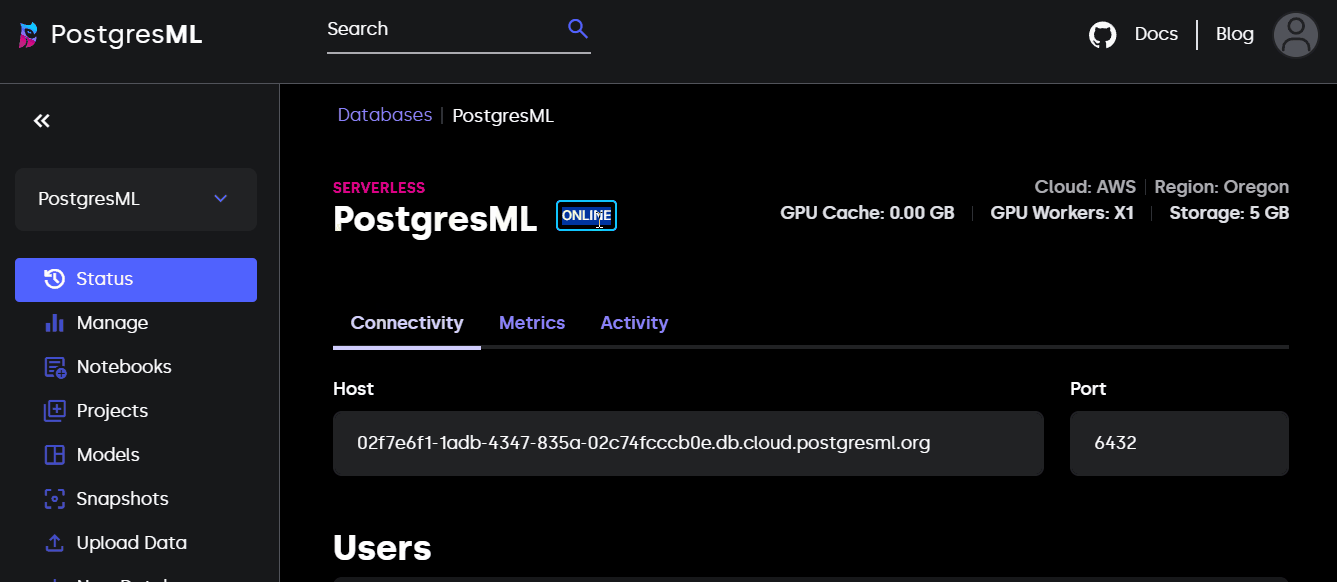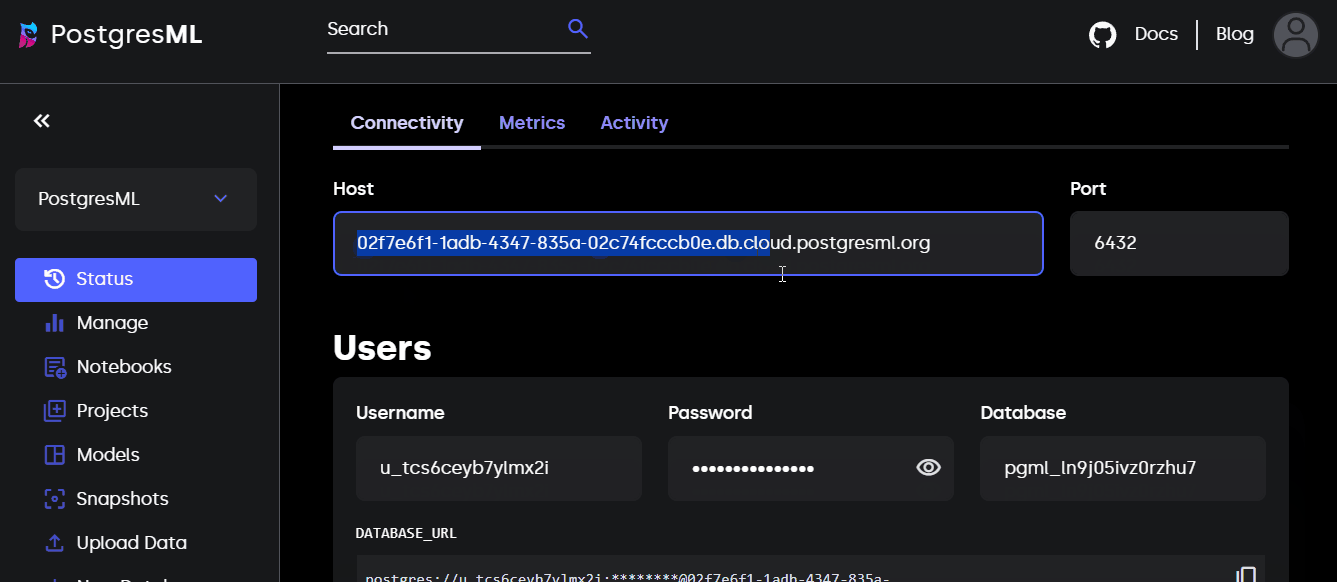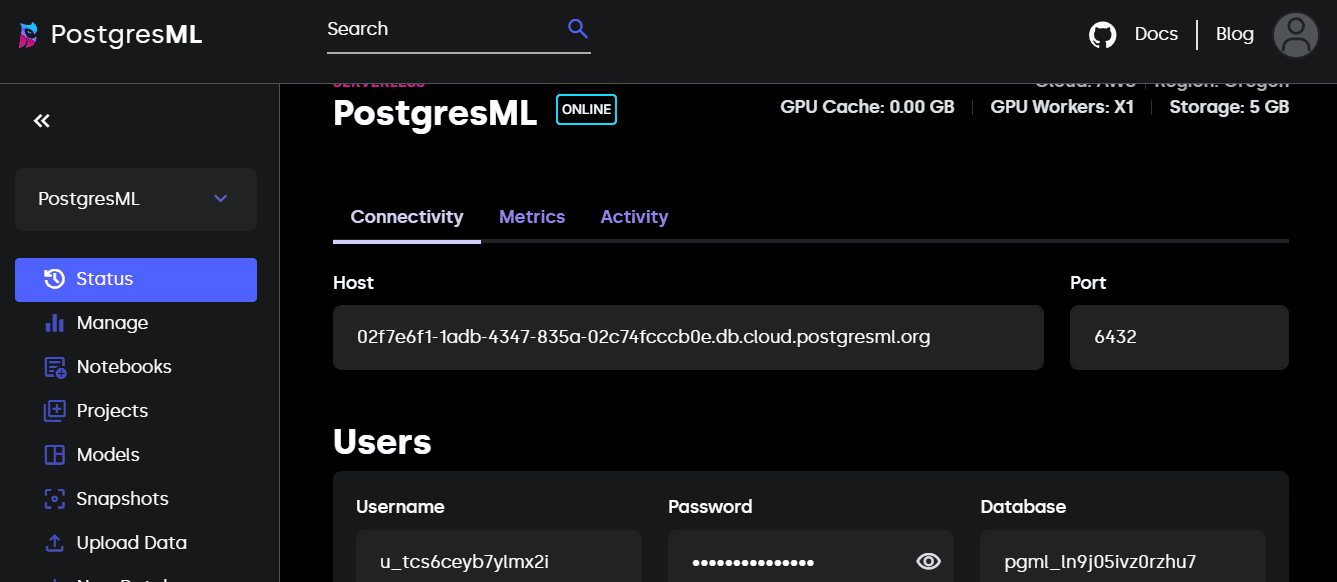
Após o cadastro, você vai para o seu console do PostgresML. É lá que você gerencia diferentes projetos de “ML in-database” e seus respectivos recursos.
Na seção “Manage”, você consegue escalar seu ambiente conforme suas necessidades de computação:
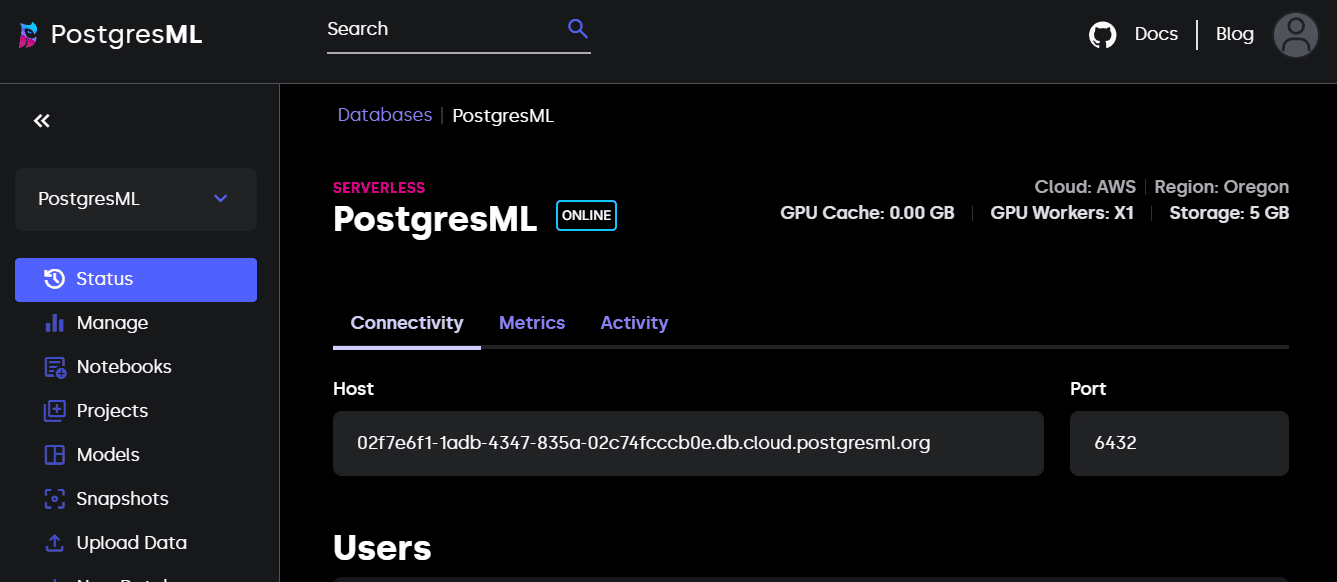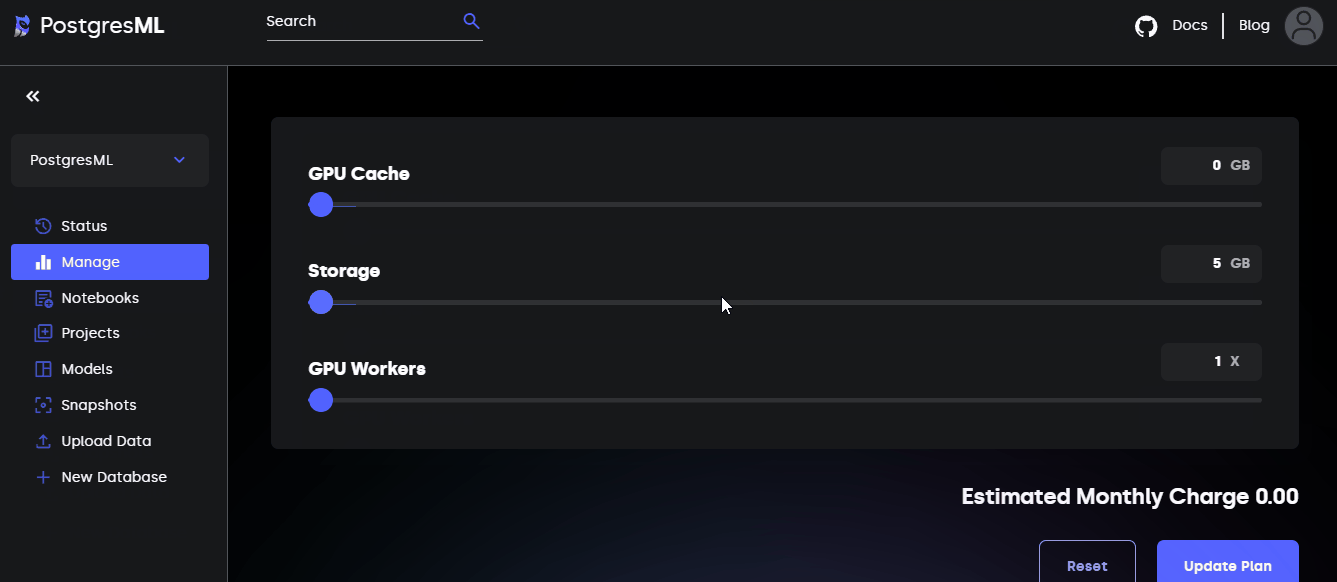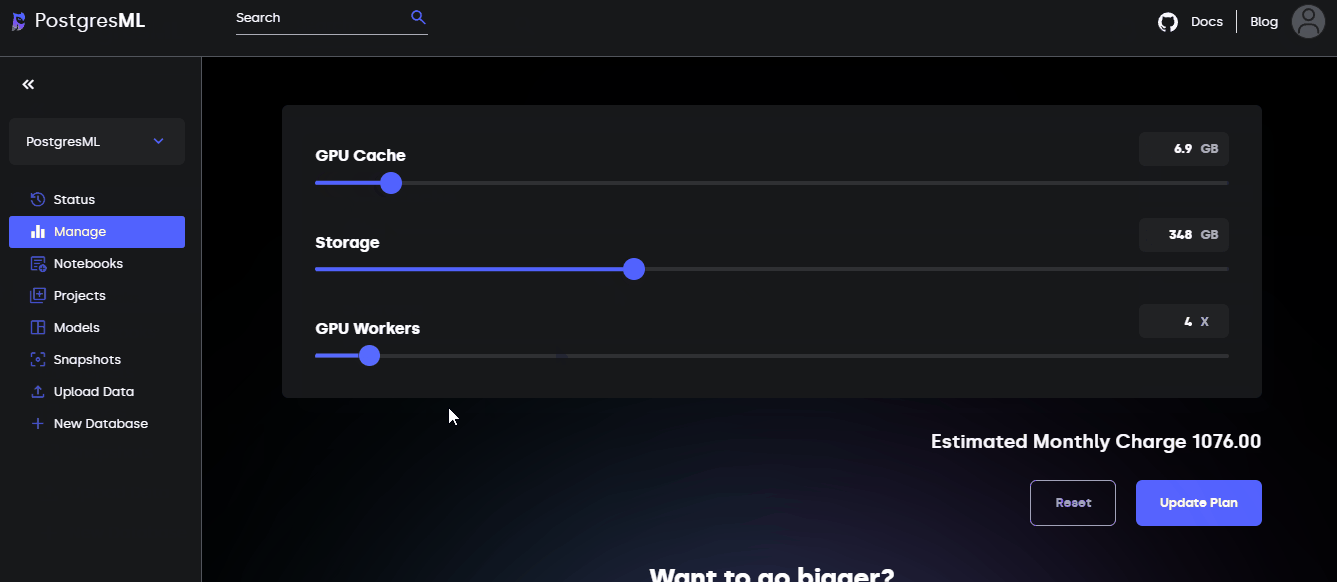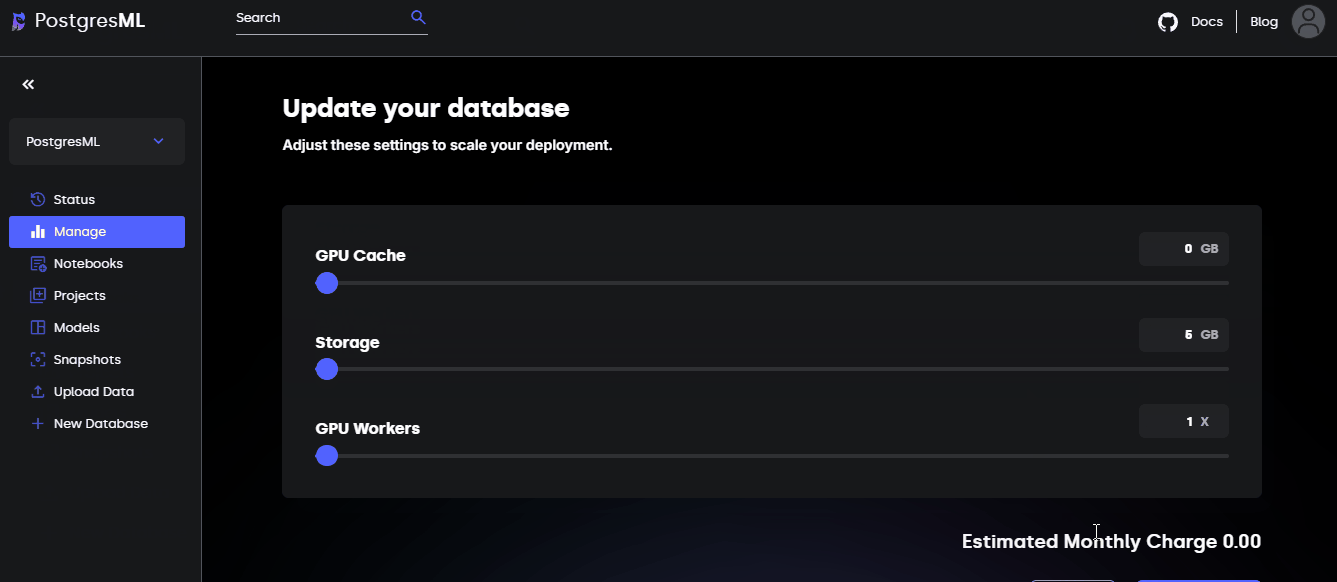
Como o nome sugere, precisamos do PostgreSQL instalado no sistema para usar o PostgresML. Se você não conhece o Postgres, ele é o banco de dados open source mais avançado do mundo (palavras do próprio site).
Aqui estão os guias de instalação do PostgreSQL por plataforma:
Estou no WSL2, então posso simplesmente fazer:
$ sudo apt update
$ sudo apt install postgresql postgresql-contrib
$ sudo passwd postgres  # Defina uma nova senha para o Postgres
# Feche e reabra o terminal e pronto!
Depois, verifique a instalação com:
$ psql --version
psql (PostgreSQL) 12.18 (Ubuntu 12.18-0ubuntu0.20.04.1)
psql é o cliente oficial do Postgres para conectar e gerenciar bancos no terminal.
Entendo que, para a maioria das pessoas, não é o ideal rodar SQL em um terminal “feioso”, então você também pode instalar a extensão abaixo no VSCode depois de instalar o Postgres:
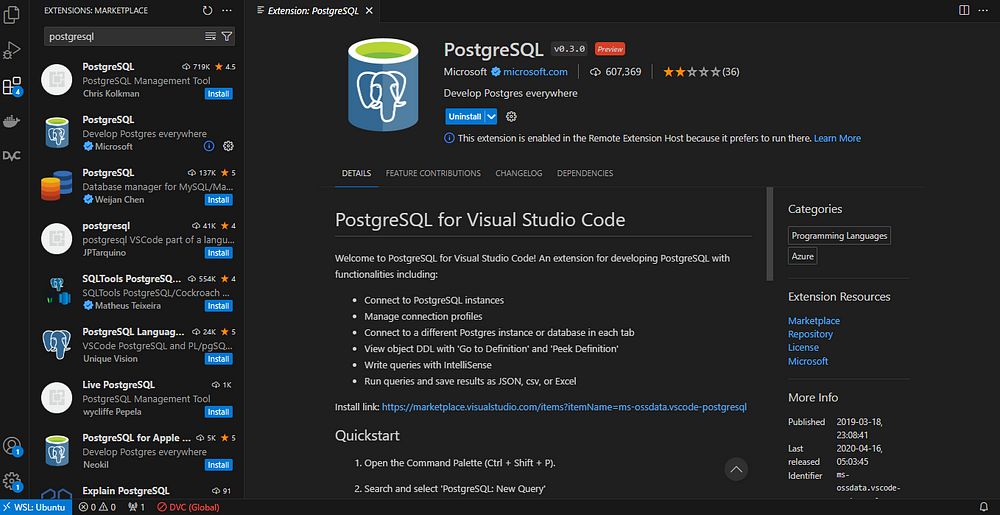
Lembra da página inicial do seu console do PostgresML? Deixe-a aberta em uma aba separada:
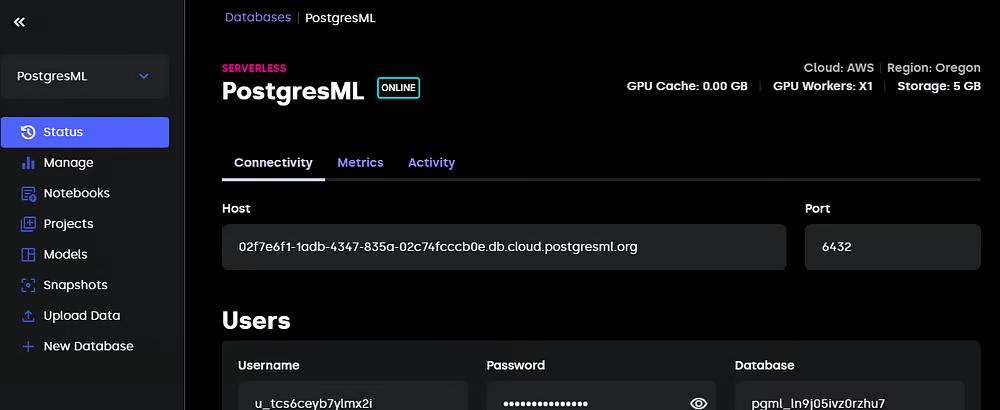
Agora, usando o psql, você pode digitar o comando abaixo com suas credenciais para se conectar ao servidor do PostgresML:
$ psql -h "host" \
      -U "username" \
      -p 6432 \
      -d "database_name"
Se estiver usando a extensão do VSCode, siga estes passos (retirados da página da extensão) para fazer o mesmo:
Pronto, você estará conectado ao seu banco do PostgresML.
O próximo passo é criar a extensão pgml, que permite executar funções do PostgresML:
CREATE EXTENSION IF NOT EXISTS pgml;

NOTICE:  extension "pgml" already exists, skipping
CREATE EXTENSION
-- Sua saída pode ser diferente.
Verifique se deu tudo certo imprimindo a versão do pgml:
SELECT pgml.version();

2.8.2 (98f114891db58acd472e068c44272b198274b11d)
Agora, vamos carregar alguns dados no banco. Para simplificar, vamos criar apenas uma tabela usando o dataset Diamonds do Kaggle. Você pode baixá-lo como CSV no site ou usando o snippet em Python abaixo:
import seaborn as sns

diamonds = sns.load_dataset("diamonds")
diamonds.to_csv("diamonds.csv", index=False)
Em seguida, rode o comando CREATE com o schema correto:
CREATE TABLE IF NOT EXISTS diamonds (
   index SERIAL PRIMARY KEY,
   carat FLOAT,
   cut VARCHAR(255),
   color VARCHAR(255),
   clarity VARCHAR(255),
   depth FLOAT,
   table_ FLOAT,
   price INT,
   x FLOAT,
   y FLOAT,
   z FLOAT
)
O comando cria uma tabela chamada diamonds, que podemos popular com as linhas do arquivo CSV:
INSERT INTO diamonds
   (carat, cut, color, clarity, depth, table_, price, x, y, z)
   FROM '~/full/path/to/diamonds.csv'
   DELIMITER ','
   CSV HEADER;
Por fim, imprimimos o topo da tabela para confirmar que o último comando foi executado com sucesso:
SELECT * FROM diamonds
LIMIT 10;
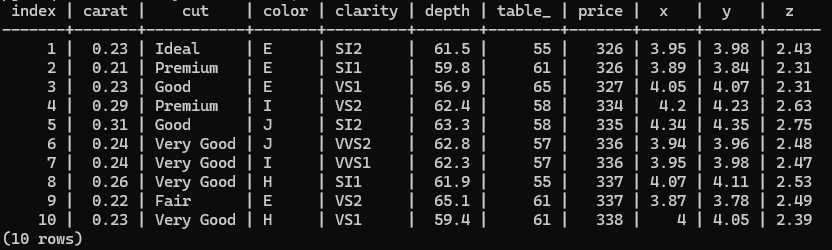
Agora estamos prontos para treinar um modelo!
Treinar um modelo de machine learning para aprendizado supervisionado é feito com a função pgml.train. Veja a estrutura básica:
SELECT pgml.train(
 project_name => 'Diamond prices prediction',
 task => 'regression',
 relation_name => 'diamonds',
 y_column_name => 'price',
 algorithm => 'xgboost'
);
O SQL acima ajusta um regressor XGBoost à tabela diamonds para prever preços de diamantes. Uma coisa que você vai notar ao executar o comando é a velocidade (quase instantânea), mesmo com mais de 50 mil linhas.
Você também pode alternar de tarefa facilmente. Veja como ajustar um classificador multiclasse (não esqueça de mudar o nome do projeto):
SELECT pgml.train(
 project_name => 'Diamond cut quality prediction',
 task => 'classification',
 relation_name => 'diamonds',
 y_column_name => 'cut',
 algorithm => 'xgboost',
 test_size => 0.1
);
Repare que agora estamos especificando o argumento test_size — divisão customizada também é suportada!
Também trocamos o algoritmo padrão linear por xgboost, mas poderia ser qualquer outro modelo do Scikit-learn ou de outro framework suportado.
Vamos tentar ajustar um modelo de random forest desta vez:
…
Mas espere! O dataset de diamantes tem variáveis de texto que precisam ser codificadas. Como o XGBoost codifica categóricas nativamente, não recebemos erros nas consultas anteriores. Isso pode não acontecer com random forests. Então, vamos incluir algumas etapas de pré-processamento na query:
SELECT pgml.train(
   project_name => 'Diamond prices prediction',
   task => 'regression',
   relation_name => 'diamonds',
   y_column_name => 'price',
   algorithm => 'random_forest',
   preprocess => '{
       "carat": {"scale": "standard"},
       "depth": {"scale": "standard"},
       "table_": {"scale":"standard"},
       "cut": {"encode": "target", "scale": "standard"},
       "color": {"encode": "target", "scale": "standard"},
       "clarity": {"encode": "target", "scale": "standard"}
   }'::JSONB
);
A lógica de pré-processamento é definida em um objeto JSONB que mapeia colunas para transformações. Para variáveis numéricas, estamos usando padronização (mesmo não sendo necessária para RF). Já para as categóricas, usamos target encoding e depois padronização.
O PostgresML também oferece outras opções de pré-processamento. Aqui vai a lista completa de métodos de codificação disponíveis:
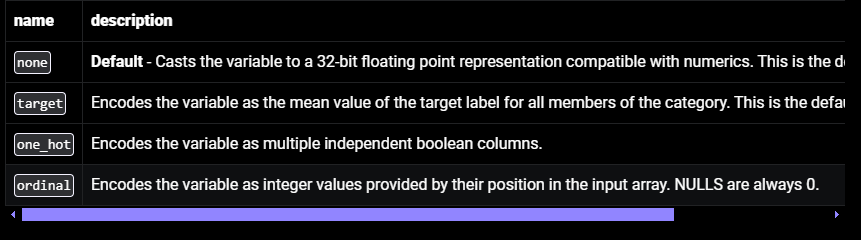
pgml também suporta técnicas padrão de imputação:
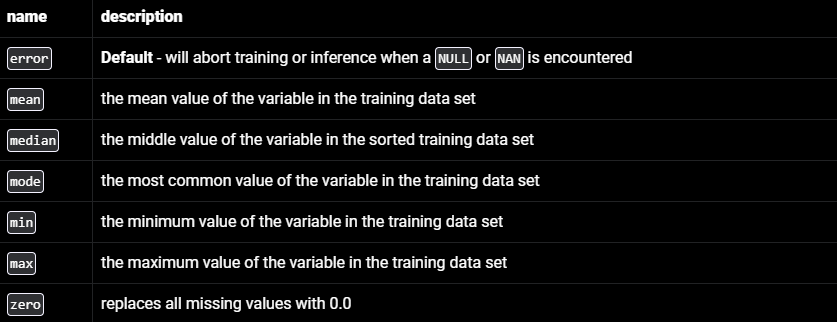
E aqui está a lista de scalers:
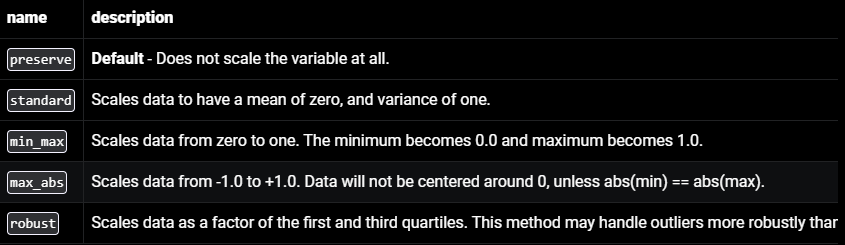
Embora você não tenha um conjunto tão vasto quanto no Scikit-learn, isso já cobre a maioria das tarefas de aprendizado supervisionado.
Até agora, usamos os parâmetros padrão dos algoritmos. Porém, os defaults quase nunca são a melhor escolha para problemas reais. Para definir valores customizados, usamos o argumento hyperparams do pgml.train:
SELECT pgml.train(
   project_name => 'Diamond prices prediction',
   task => 'regression',
   relation_name => 'diamonds',
   y_column_name => 'price',
   algorithm => 'xgboost',
   hyperparams => '{
       "n_estimators": 1000, "max_depth": 5, "eta": 0.01, "subsample": 0.7
   }'::JSONB
);
Desta vez, ajustamos um XGBoost com 1000 árvores, profundidade máxima 5 e taxa de aprendizado 0,01. Por enquanto, estamos “no chute”, então esses hiperparâmetros podem não gerar os melhores resultados.
Para extrair o máximo do modelo, quase sempre precisamos ajustar hiperparâmetros em tarefas supervisionadas. Esse processo também é suportado no pgml dentro da função train. Veja como fazer uma busca em grade (grid search) em um pequeno conjunto de combinações:
SELECT pgml.train(
   'Diamond prices prediction',
   algorithm => 'xgboost',
   search => 'grid',
   search_params => '{
       "max_depth": [5, 7],
       "n_estimators": [1000, 1500],
       "eta": [0.1, 0.01, 0.001]
   }'::JSONB
);
Neste ponto, vale apreciar o que estamos fazendo: ajustando hiperparâmetros de um XGBoost usando SQL! Eu nunca achei que escreveria essa frase.
No momento em que escrevemos este tutorial, o PostgresML ainda não tem ferramentas de avaliação muito maduras. Temos apenas a função predict disponível. Veja como usá-la para prever um novo exemplo individual:
SELECT pgml.predict(
   project_name => 'Diamond prices prediction',
   features => ARRAY[0.7, "Ideal", "A", "IF", 67.9, 56.9, 7024, 5.85, 5.87, 3.71]
);
predict usa automaticamente o melhor modelo dos seus experimentos. Para regressão, é o modelo com maior R-quadrado; já em classificação, o de maior F1-score.
Para usar um modelo específico na predição, você pode informar o ID dele:
SELECT pgml.predict(
  2' -- Use o modelo com ID 2,
   features => ARRAY[0.7, "Ideal", "A", "IF", 67.9, 56.9, 7024, 5.85, 5.87, 3.71]
)
Mas como descobrir os IDs dos modelos? Aqui vai um snippet que imprime uma tabela com exatamente essa informação:
SELECT models.id, models.algorithm, models.metrics
FROM pgml.models
JOIN pgml.projects
 ON projects.id = models.project_id
WHERE projects.name = 'Diamond prices prediction';
A partir dessa instrução, você pode descobrir várias variáveis e métricas do pgml, como models.id, pgml.models, pgml.projects e por aí vai. Faça consultas SELECT nelas para se familiarizar.
Diferente do MLOps tradicional, esta etapa é a mais simples no PostgresML. A extensão pgml expõe automaticamente o melhor modelo dos seus experimentos como padrão. Assim, qualquer instrução SELECT pgml.predict enviada ao servidor usará esse modelo para inferência.
Se quiser ter controle mais fino sobre qual modelo vai para produção, você pode usar a função pgml.deploy. Eis a estrutura:
SELECT * FROM pgml.deploy(
   project_name TEXT,
   strategy TEXT DEFAULT 'best_score',
   algorithm TEXT DEFAULT NULL
)
Além de best_score, também existem as estratégias de deployment most_recent e rollback:
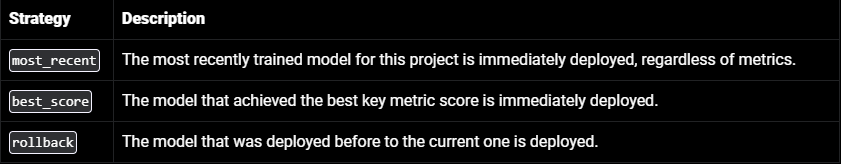
Combinando os parâmetros strategy e algorithm, você refina ainda mais a publicação. Por exemplo, a instrução abaixo publica o melhor modelo XGBoost, e não o melhor modelo geral do projeto.
SELECT * FROM pgml.deploy(
   project_name => 'Diamond prices prediction',
   strategy => 'best_score',
   algorithm => 'xgboost'
)
Aprendizado supervisionado é só uma parte do PostgresML. Na verdade, a proposta de valor é “construir apps de IA no Postgres”. Para mostrar isso, eles até colocaram um pequeno editor de SQL na home:
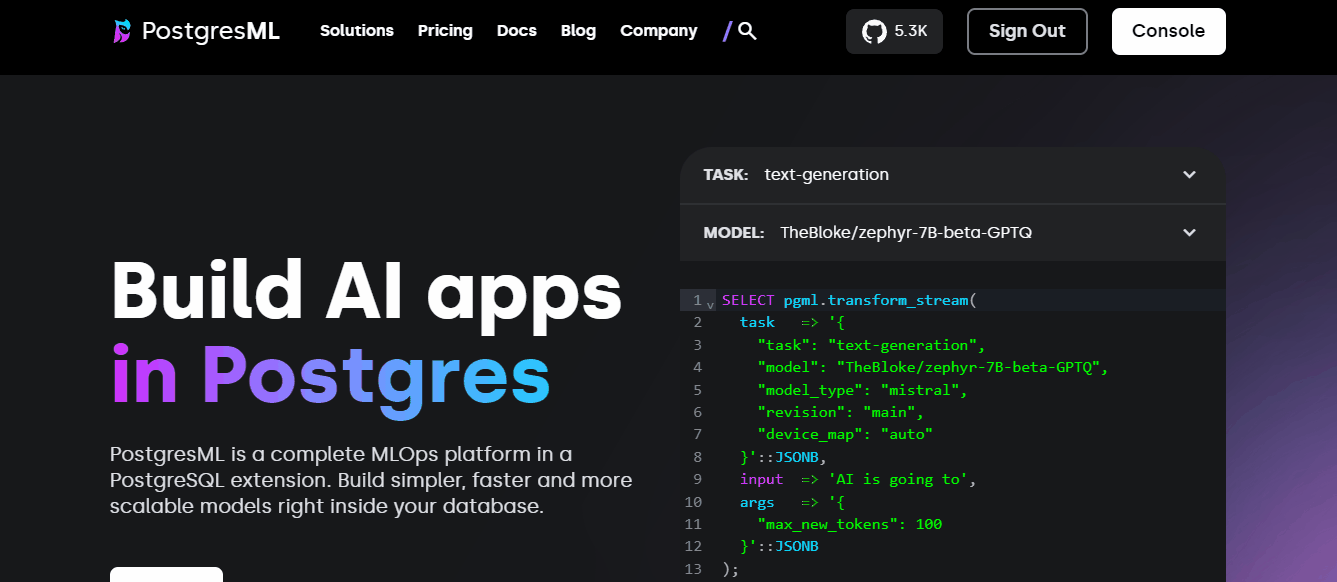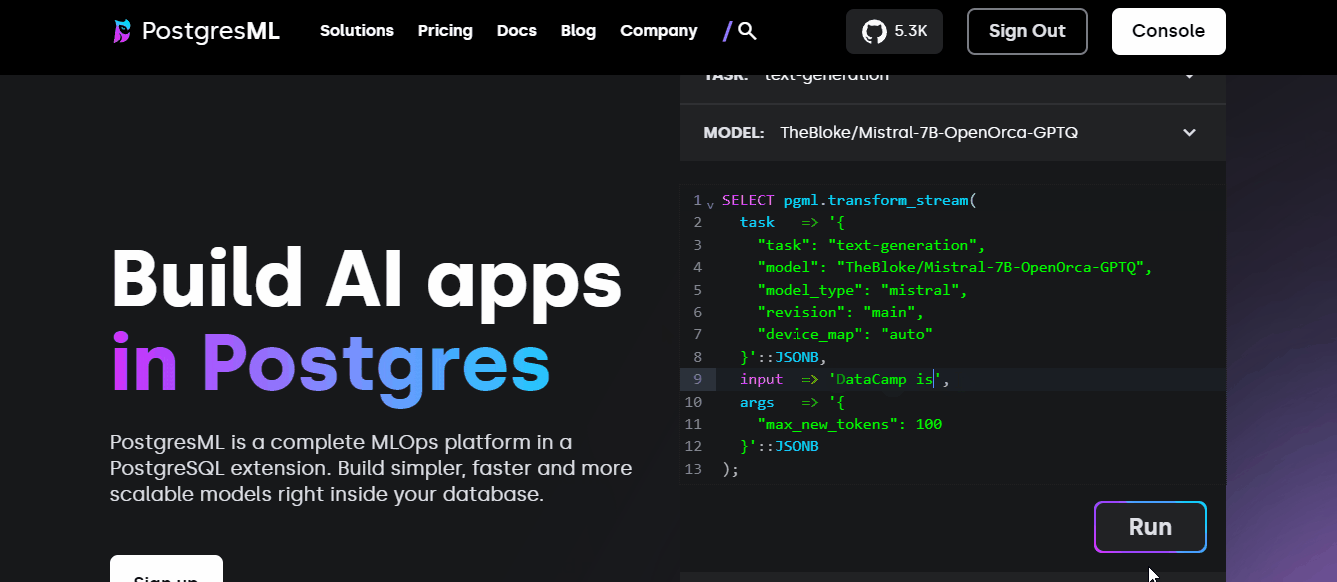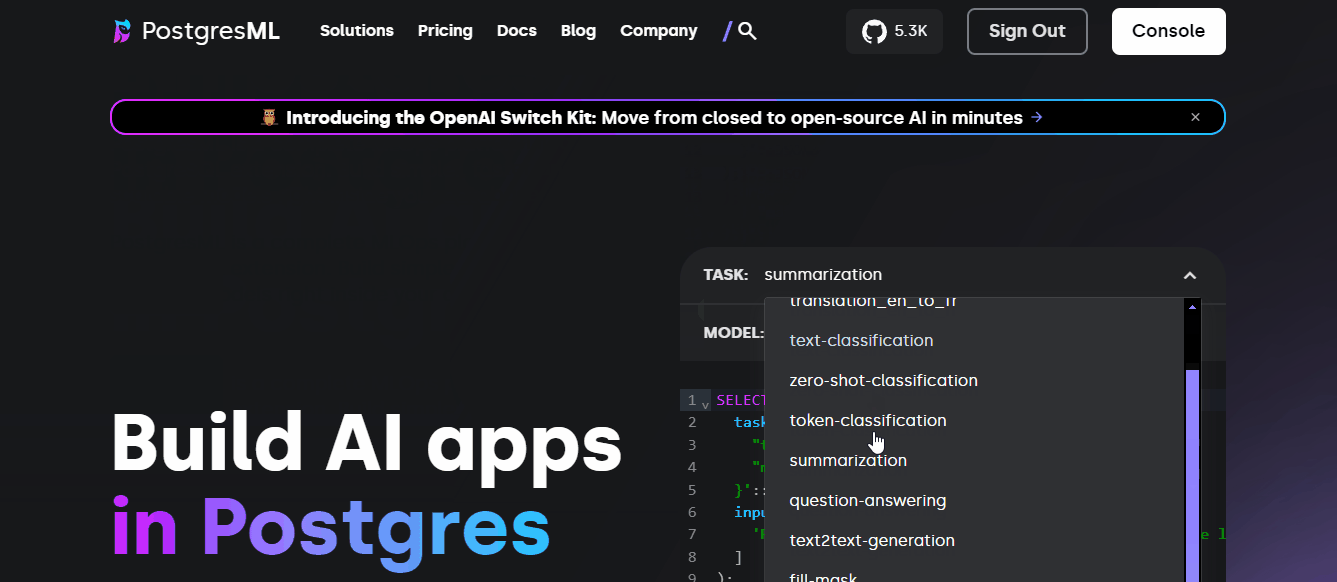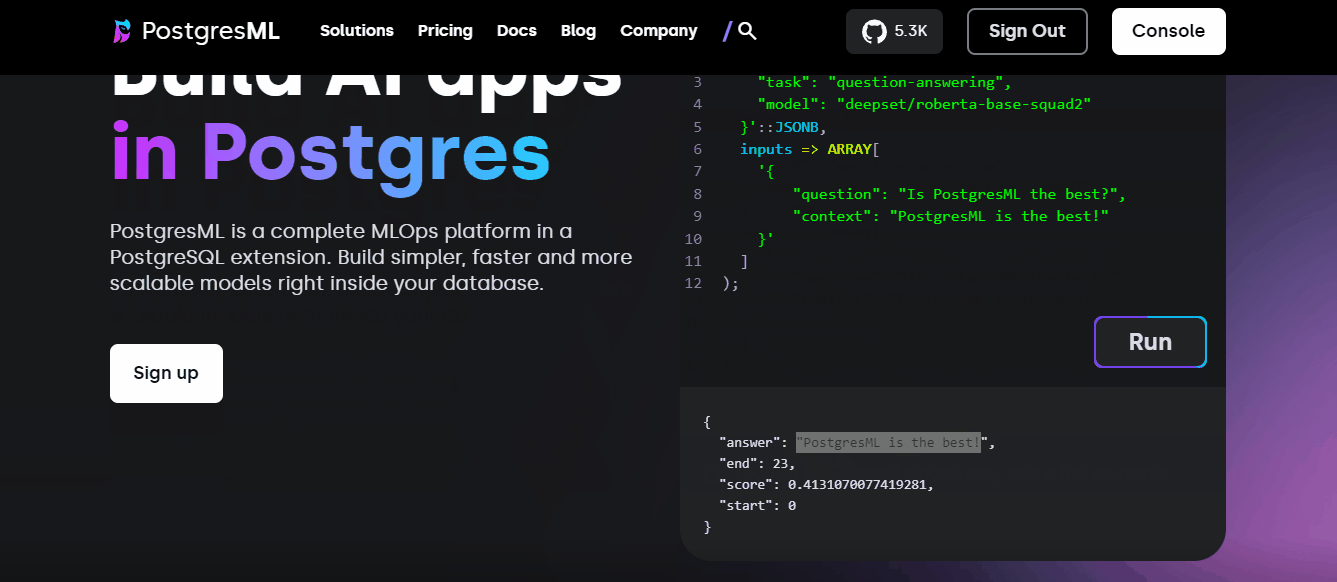
Você pode rodar esses exemplos direto no ambiente que usou neste tutorial também!
Então, se você quisesse construir um serviço de machine learning para o usuário final com PostgresML, como faria? Aqui estão alguns passos possíveis (depois que o modelo estiver pronto):
psycopg2 (Python) ou pg-promise (JavaScript) para conectar ao seu banco PostgresML.pgml.predict.Esse é um esboço geral que pode mudar bastante conforme o caso de uso.
O PostgresML apresenta um paradigma totalmente novo em machine learning, então leva mais do que um único tutorial para dominá-lo. Para consolidar seu entendimento e explorar outras formas de uso, leia a seção de casos de uso na documentação do PostgresML.
Se seu SQL estiver um pouco enferrujado, você pode fazer o curso curto da DataCamp sobre criação de bancos PostgreSQL ou até a trilha de carreira Data Analyst in SQL.
Como o PostgresML é muito focado em IA, você também pode aprender alguns fundamentos de IA:
Continue sua jornada em IA hoje mesmo!
Curso
Programa
Programa
Tutorial
Moez Ali
10 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Elena Kosourova
8 min
Tutorial
Javier Canales Luna
15 min
Tutorial
DataCamp Team
3 min