
Khóa học
Các khái niệm về Large Language Models (LLMs)
2 giờ
113.3K
Xu hướng bao quát trong machine learning là di chuyển dữ liệu đến môi trường của mô hình để huấn luyện. Nhưng nếu làm ngược lại thì sao? Vì cơ sở dữ liệu ngày nay lớn hơn mô hình machine learning hàng bậc độ lớn, chẳng phải sẽ dễ hơn nhiều nếu chúng ta mang mô hình đến với các tập dữ liệu?
Đó là ý tưởng cốt lõi đằng sau PostgresML — dữ liệu giữ nguyên tại chỗ, bạn mang mã của mình vào cơ sở dữ liệu. Kiểu machine learning “đảo ngược logic” này mang lại hàng loạt lợi ích thực tế, khiến bạn phải nghĩ lại về khái niệm “cơ sở dữ liệu.”
PostgresML là một nền tảng machine learning toàn diện được xây dựng trên cơ sở dữ liệu PostgreSQL phổ biến. Nó giới thiệu một mô hình mới gọi là machine learning “trong cơ sở dữ liệu”, cho phép bạn thực hiện nhiều tác vụ ML bằng SQL mà không cần công cụ riêng ở mỗi bước.
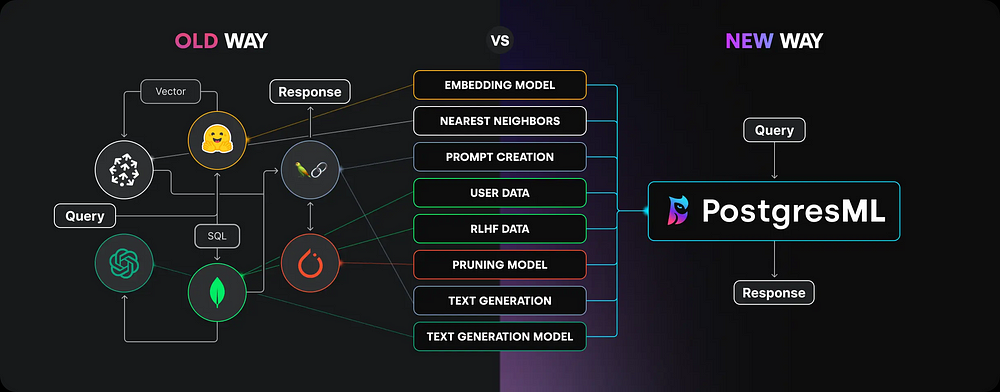
Dù còn khá mới, PostgresML hứa hẹn những lợi ích rõ ràng sau:
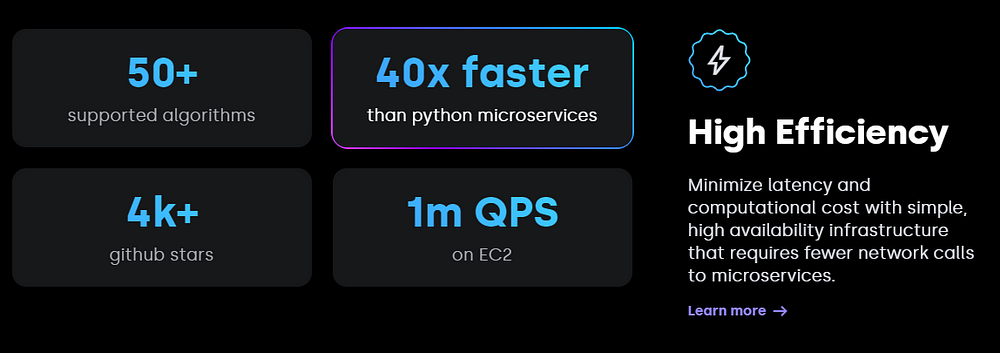
Chúng ta sẽ lái thử tất cả các tính năng này trong hướng dẫn bằng cách theo một quy trình machine learning điển hình:
…tất cả đều bên trong cơ sở dữ liệu Postgres. Bắt đầu thôi!
Trước hết, hãy tạo tài khoản miễn phí tại https://postgresml.org/signup:
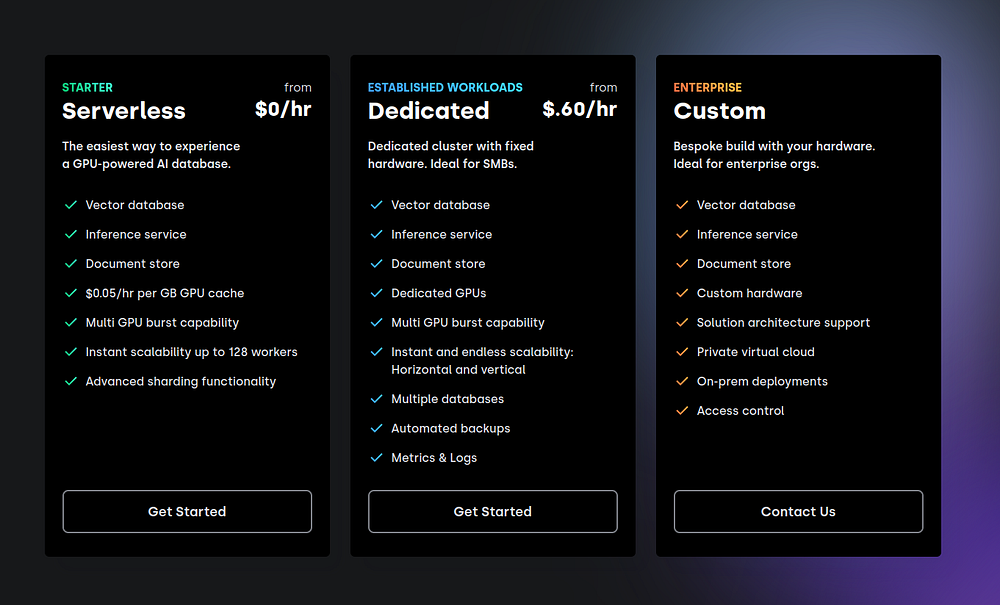
Sau đó, chọn gói miễn phí với tài nguyên khá hào phóng:
Sau khi đăng ký, bạn sẽ vào bảng điều khiển PostgresML. Đây là nơi bạn quản lý các dự án “ML trong cơ sở dữ liệu” và tài nguyên liên quan.
Nếu vào mục “Manage”, bạn có thể mở rộng môi trường theo nhu cầu tính toán của mình:
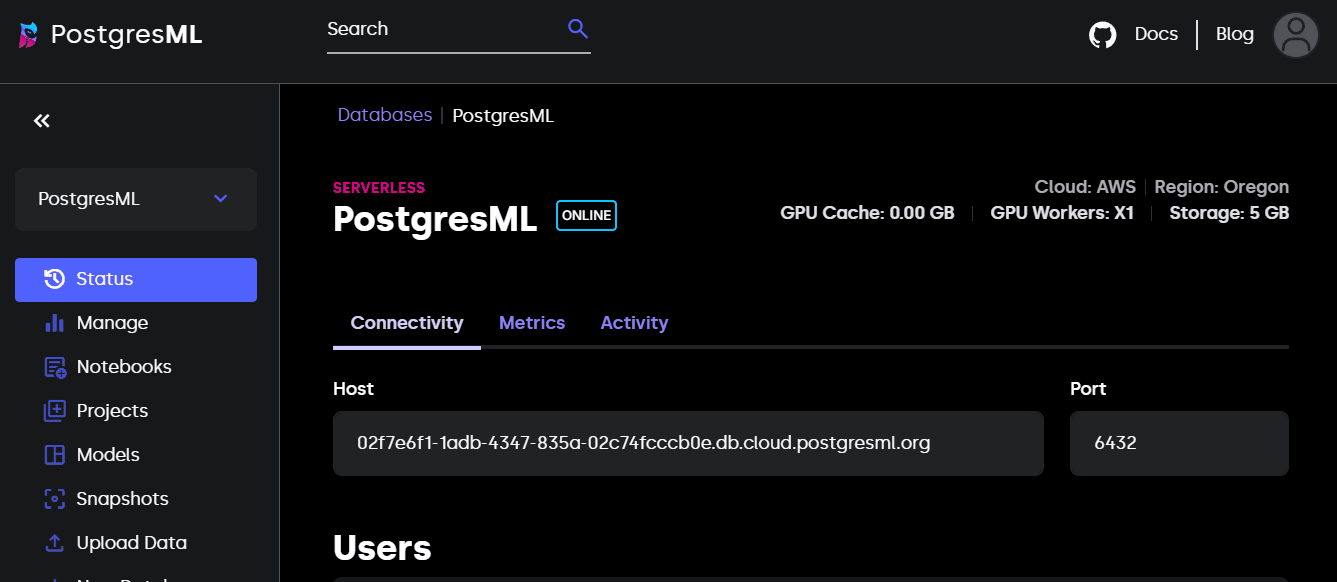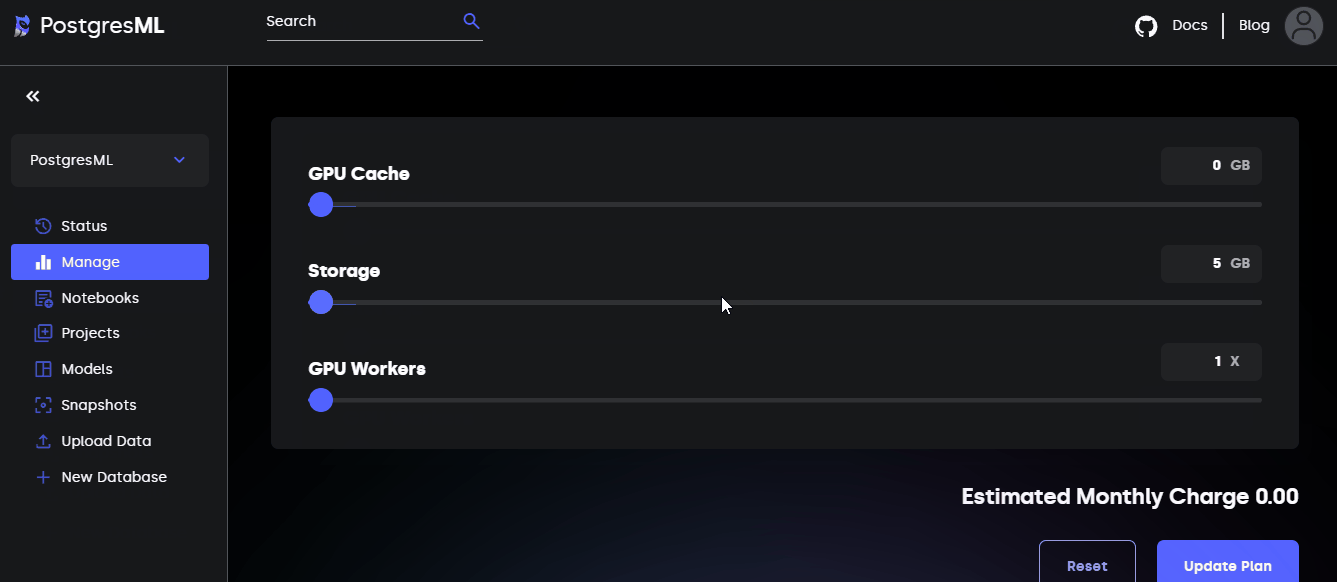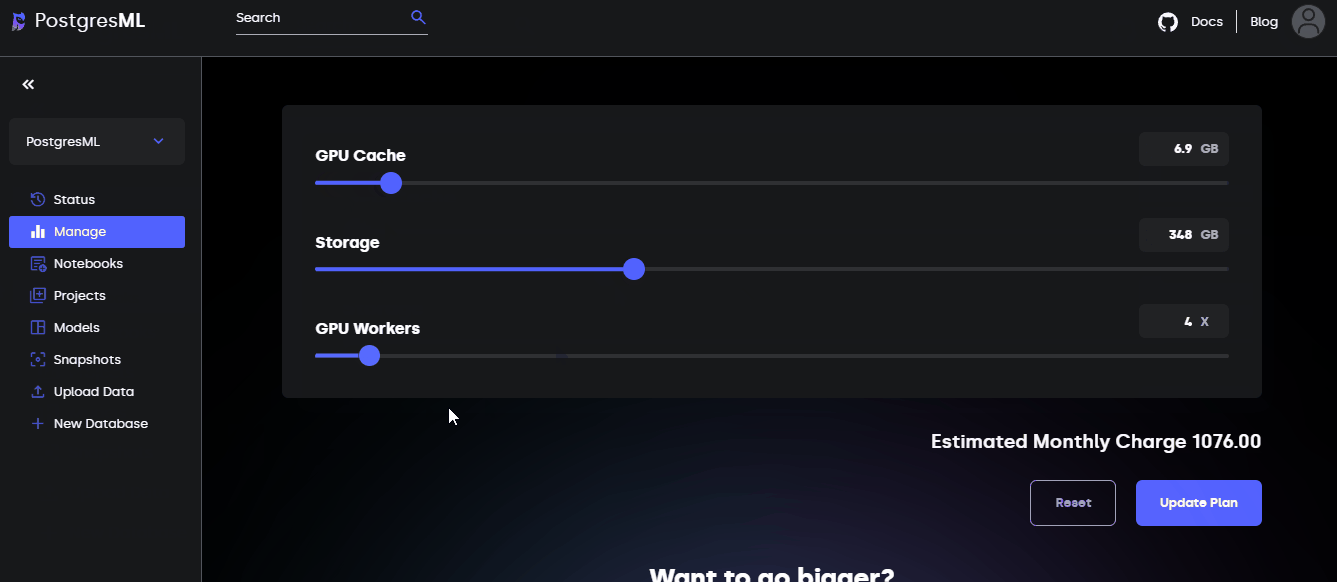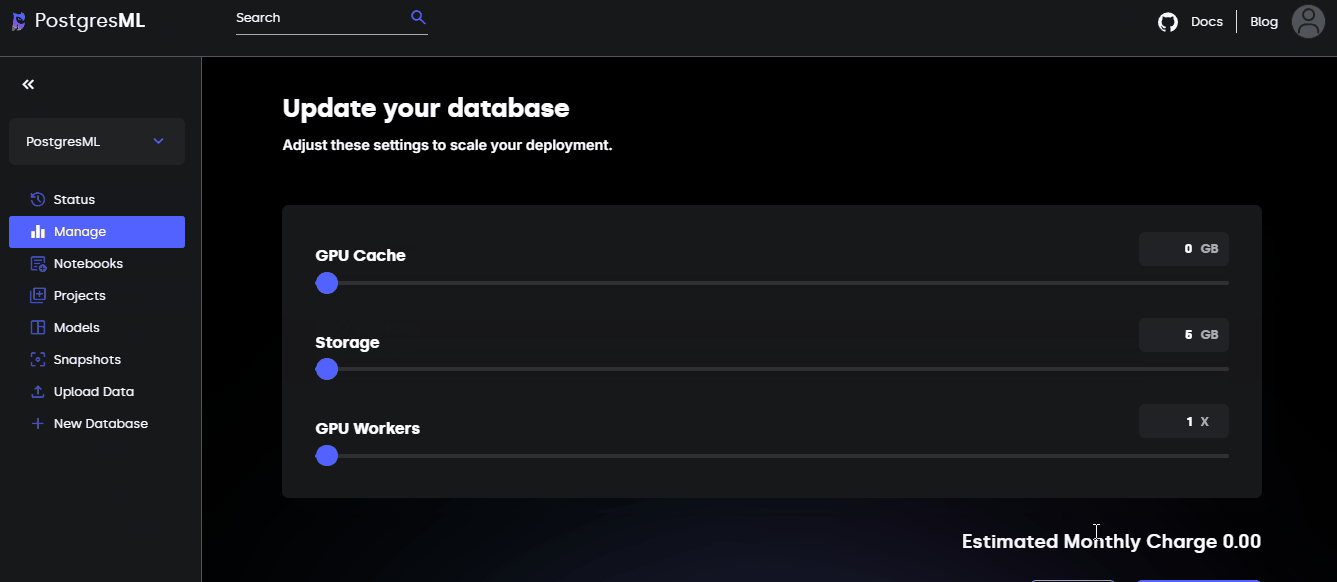
Đúng như tên gọi, chúng ta cần cài PostgreSQL trên hệ thống để dùng PostgresML. Nếu bạn chưa biết Postgres là gì, đó là cơ sở dữ liệu mã nguồn mở tiên tiến nhất thế giới (theo lời giới thiệu trên website của họ).
Dưới đây là các hướng dẫn cài đặt PostgreSQL theo nền tảng:
Tôi dùng WSL2 nên chỉ cần làm như sau:
$ sudo apt update
$ sudo apt install postgresql postgresql-contrib
$ sudo passwd postgres  # Set a new Postgres password
# Close and reopen your terminal and done!
Sau đó, xác minh việc cài đặt bằng:
$ psql --version
psql (PostgreSQL) 12.18 (Ubuntu 12.18-0ubuntu0.20.04.1)
psql là client chính thức của Postgres để kết nối và quản trị cơ sở dữ liệu trong terminal.
Tôi hiểu rằng với đa số, việc chạy SQL trong terminal “xấu xí” không lý tưởng, nên bạn cũng có thể cài tiện ích mở rộng VSCode sau khi cài Postgres:
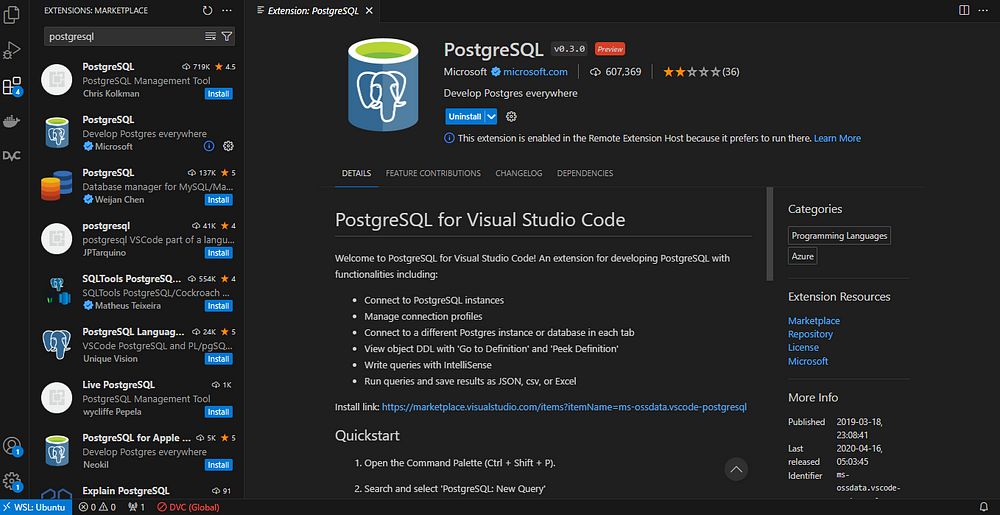
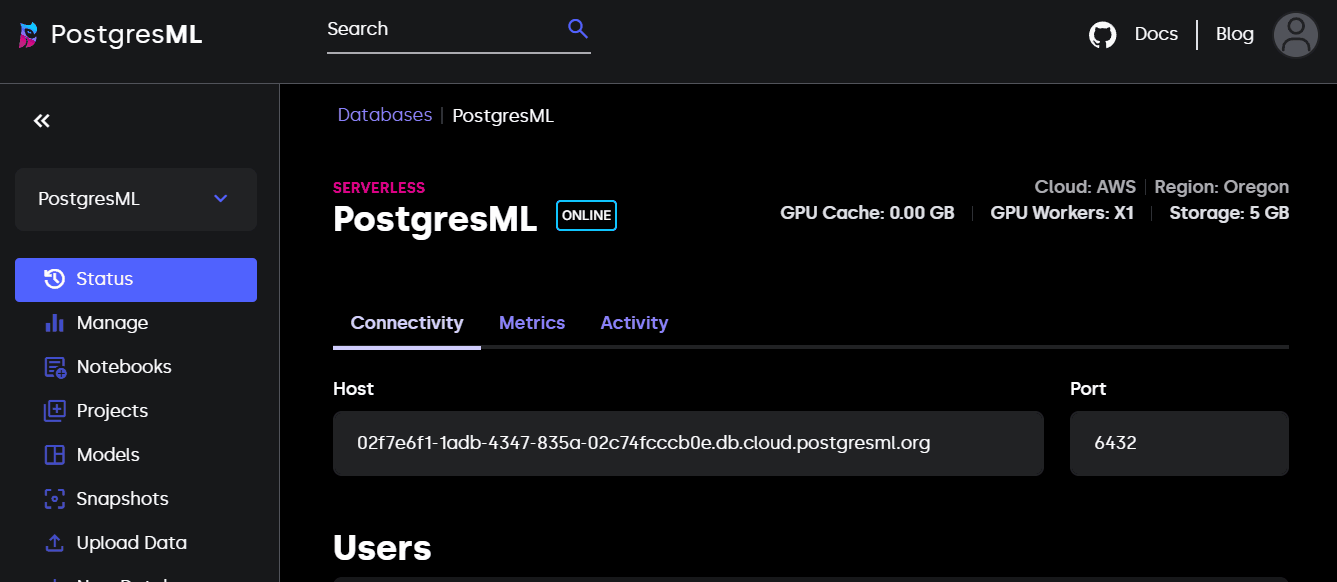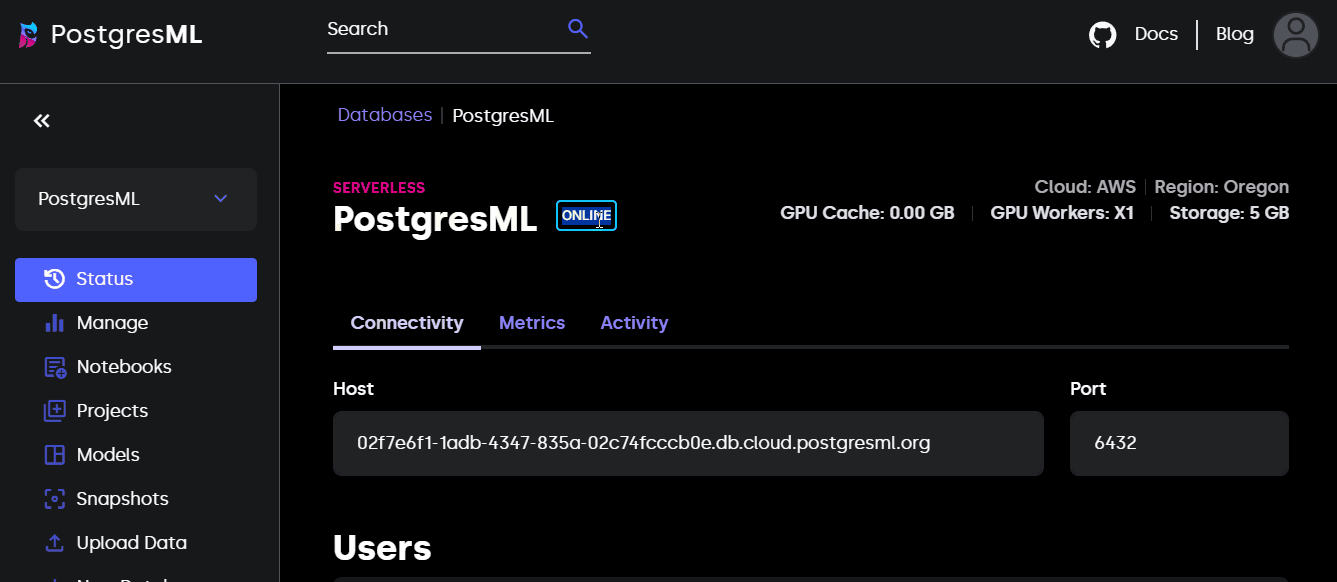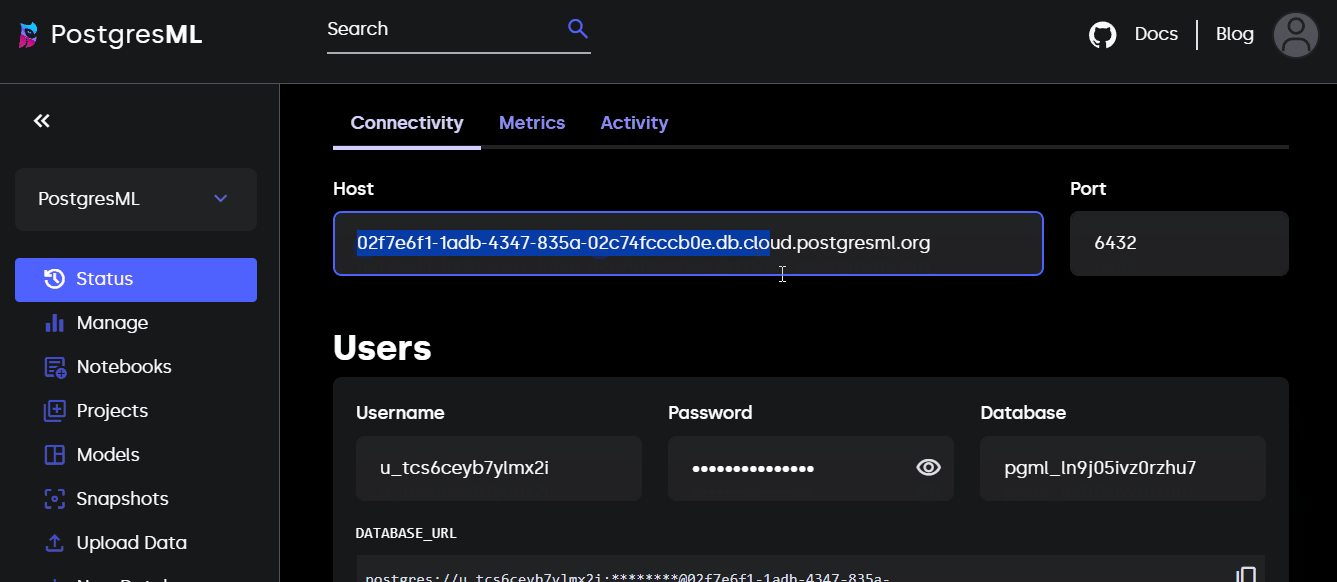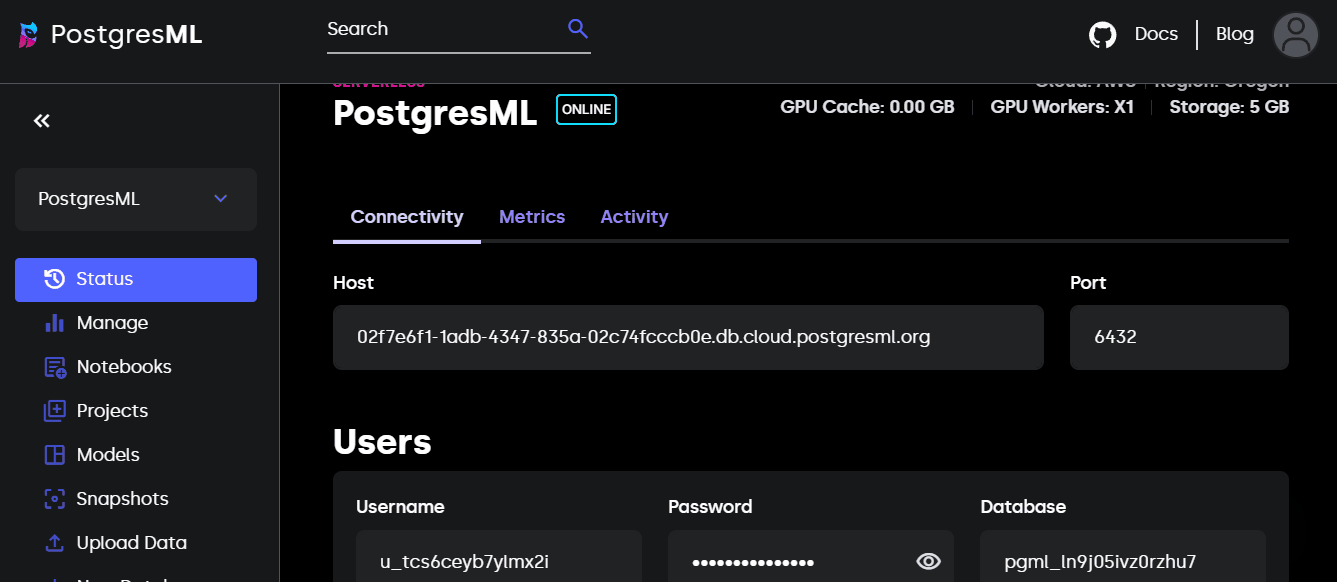
Nhớ trang đích của bảng điều khiển PostgresML chứ? Hãy mở nó ở một thẻ riêng:
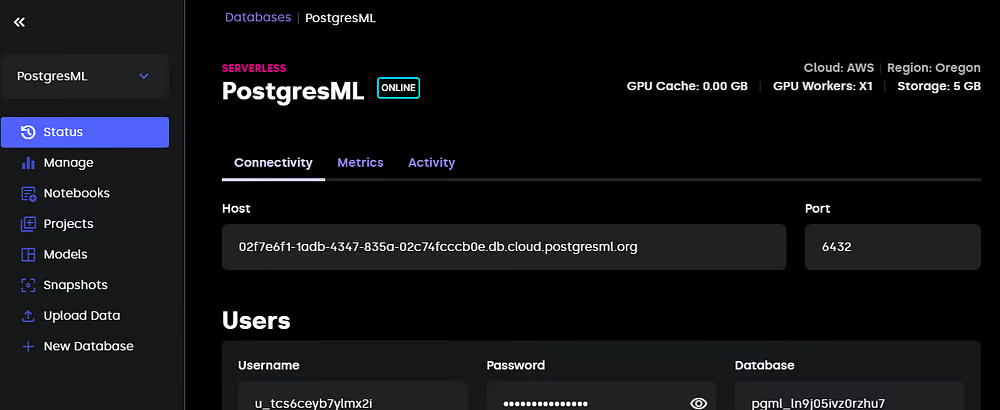
Bây giờ, dùng psql, bạn có thể gõ lệnh dưới đây với thông tin xác thực của mình để kết nối tới máy chủ PostgresML:
$ psql -h "host" \
      -U "username" \
      -p 6432 \
      -d "database_name"
Nếu dùng tiện ích VSCode, hãy làm theo các bước sau (trích từ trang cài tiện ích) để làm điều tương tự:
Và bạn sẽ được kết nối tới cơ sở dữ liệu PostgresML của mình.
Bước tiếp theo là tạo tiện ích mở rộng pgml để chạy các hàm PostgresML:
CREATE EXTENSION IF NOT EXISTS pgml;

NOTICE:  extension "pgml" already exists, skipping
CREATE EXTENSION
-- Your output may be different.
Kiểm tra mọi thứ đã thành công bằng cách in phiên bản pgml:
SELECT pgml.version();

2.8.2 (98f114891db58acd472e068c44272b198274b11d)
Bây giờ, hãy nạp một ít dữ liệu vào cơ sở dữ liệu. Để đơn giản, chúng ta sẽ chỉ tạo một bảng duy nhất dùng bộ dữ liệu Diamonds từ Kaggle. Bạn có thể tải CSV từ website hoặc dùng đoạn Python dưới đây:
import seaborn as sns

diamonds = sns.load_dataset("diamonds")
diamonds.to_csv("diamonds.csv", index=False)
Sau đó, chạy lệnh CREATE sau với schema đúng:
CREATE TABLE IF NOT EXISTS diamonds (
   index SERIAL PRIMARY KEY,
   carat FLOAT,
   cut VARCHAR(255),
   color VARCHAR(255),
   clarity VARCHAR(255),
   depth FLOAT,
   table_ FLOAT,
   price INT,
   x FLOAT,
   y FLOAT,
   z FLOAT
)
Lệnh trên sẽ tạo bảng tên diamonds để chúng ta có thể nạp các dòng từ file CSV:
INSERT INTO diamonds
   (carat, cut, color, clarity, depth, table_, price, x, y, z)
   FROM '~/full/path/to/diamonds.csv'
   DELIMITER ','
   CSV HEADER;
Cuối cùng, in phần đầu bảng để xác nhận lệnh vừa chạy đã thành công:
SELECT * FROM diamonds
LIMIT 10;
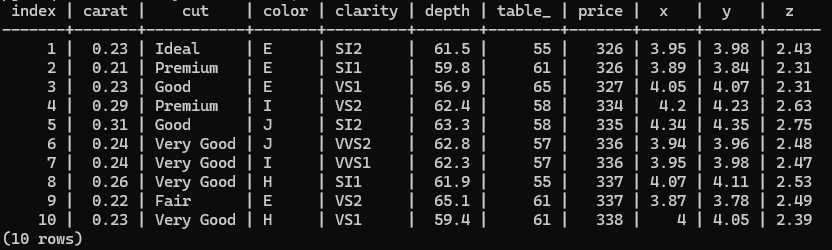
Giờ thì chúng ta sẵn sàng huấn luyện mô hình!
Huấn luyện mô hình machine learning cho bài toán giám sát được thực hiện bằng hàm pgml.train. Cấu trúc cơ bản như sau:
SELECT pgml.train(
 project_name => 'Diamond prices prediction',
 task => 'regression',
 relation_name => 'diamonds',
 y_column_name => 'price',
 algorithm => 'xgboost'
);
Câu lệnh SQL trên khớp một bộ hồi quy XGBoost với bảng diamonds để dự đoán giá kim cương. Bạn sẽ thấy lệnh chạy rất nhanh (gần như tức thời) dù có hơn 50 nghìn dòng.
Bạn cũng có thể dễ dàng chuyển đổi tác vụ. Đây là cách khớp một bộ phân loại đa lớp (đừng quên đổi tên dự án):
SELECT pgml.train(
 project_name => 'Diamond cut quality prediction',
 task => 'classification',
 relation_name => 'diamonds',
 y_column_name => 'cut',
 algorithm => 'xgboost',
 test_size => 0.1
);
Lưu ý lần này chúng ta chỉ định tham số test_size - cũng hỗ trợ tách tập tùy chỉnh!
Chúng ta cũng đã đổi thuật toán mặc định linear sang xgboost, nhưng có thể là bất kỳ mô hình nào khác từ Scikit-learn hoặc framework được hỗ trợ.
Hãy thử khớp một mô hình random forest lần này:
…
Nhưng khoan! Bộ dữ liệu diamonds có các đặc trưng dạng văn bản cần được mã hóa. Vì XGBoost hỗ trợ mã hóa biến loại bản địa, chúng ta không gặp lỗi ở các truy vấn trước. Điều này có thể không đúng với random forest. Vậy nên, hãy thêm một số bước tiền xử lý vào truy vấn:
SELECT pgml.train(
   project_name => 'Diamond prices prediction',
   task => 'regression',
   relation_name => 'diamonds',
   y_column_name => 'price',
   algorithm => 'random_forest',
   preprocess => '{
       "carat": {"scale": "standard"},
       "depth": {"scale": "standard"},
       "table_": {"scale": "standard"},
       "cut": {"encode": "target", "scale": "standard"},
       "color": {"encode": "target", "scale": "standard"},
       "clarity": {"encode": "target", "scale": "standard"}
   }'::JSONB
);
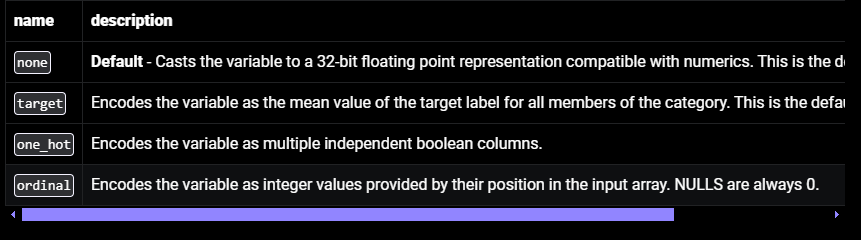
Logic tiền xử lý được định nghĩa trong một đối tượng JSONB ánh xạ các cột với bước biến đổi. Với đặc trưng số, chúng ta dùng chuẩn hóa (dù với RF thì không nhất thiết). Với cột phân loại, chúng ta dùng target encoding rồi chuẩn hóa.
PostgresML cũng cung cấp các hàm tiền xử lý thay thế khác. Đây là danh sách đầy đủ các tùy chọn mã hóa có sẵn:
pgml cũng hỗ trợ các kỹ thuật điền khuyết giá trị tiêu chuẩn:
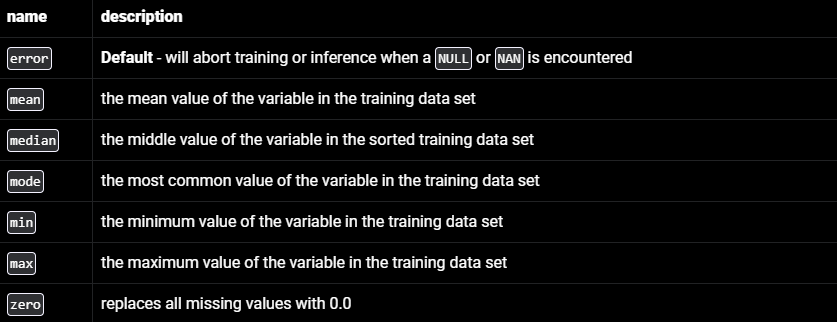
Và đây là danh sách các bộ biến đổi tỷ lệ:
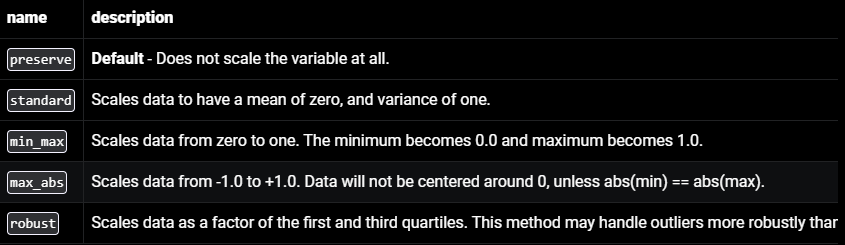
Dù không có bộ tiền xử lý đồ sộ như Scikit-learn, chừng đó là đủ cho hầu hết bài toán học có giám sát.
Đến giờ, chúng ta dùng tham số mặc định của thuật toán. Tuy nhiên, mặc định gần như không phải lựa chọn tối ưu cho bài toán thực tế. Để chỉ định giá trị tùy chỉnh, ta dùng tham số hyperparams của pgml.train:
SELECT pgml.train(
   project_name => 'Diamond prices prediction',
   task => 'regression',
   relation_name => 'diamonds',
   y_column_name => 'price',
   algorithm => 'xgboost',
   hyperparams => '{
       "n_estimators": 1000, "max_depth": 5, "eta": 0.01, "subsample": 0.7
   }'::JSONB
);
Lần này, chúng ta khớp bộ hồi quy XGBoost với 1000 cây, độ sâu tối đa 5 và tốc độ học 0,01. Hiện tại, ta chỉ “bắn thử trong bóng tối”, nên các siêu tham số này có thể không cho kết quả chính xác.
Để tối đa hóa kết quả, ta luôn cần tinh chỉnh siêu tham số trong các bài toán có giám sát. Quy trình này cũng được hỗ trợ trong pgml ngay trong hàm train. Đây là cách thực hiện grid search trên một tập nhỏ tổ hợp siêu tham số:
SELECT pgml.train(
   'Diamond prices prediction',
   algorithm => 'xgboost',
   search => 'grid',
   search_params => '{
       "max_depth": [5, 7],
       "n_estimators": [1000, 1500],
       "eta": [0.1, 0.01, 0.001]
   }'::JSONB
);
Đến đây, tôi chỉ muốn bạn “thưởng thức” điều chúng ta đang làm. Chúng ta đang tinh chỉnh siêu tham số của một bộ hồi quy XGBoost bằng SQL! Câu này tôi chưa từng nghĩ sẽ viết ra.
Tại thời điểm viết hướng dẫn này, PostgresML chưa có bộ công cụ đánh giá đủ trưởng thành. Chúng ta chỉ có hàm predict. Đây là cách dùng nó để dự đoán trên một mẫu mới, đơn lẻ:
SELECT pgml.predict(
   project_name => 'Diamond prices prediction',
   features => ARRAY[0.7, "Ideal", "A", "IF", 67.9, 56.9, 7024, 5.85, 5.87, 3.71]
);
predict sẽ tự động dùng mô hình có hiệu năng tốt nhất từ các thí nghiệm của bạn. Với hồi quy, đó là mô hình có R-squared cao nhất, còn phân loại thì dùng mô hình có F1-score cao nhất.
Để dùng một mô hình cụ thể cho suy luận, bạn có thể chỉ định ID của nó:
SELECT pgml.predict(
  2' -- Use model with ID of 2,
   features => ARRAY[0.7, "Ideal", "A", "IF", 67.9, 56.9, 7024, 5.85, 5.87, 3.71]
)
Nhưng làm sao tìm được ID mô hình? Đây là đoạn truy vấn in ra một bảng gọn gàng với đúng thông tin đó:
SELECT models.id, models.algorithm, models.metrics
FROM pgml.models
JOIN pgml.projects
 ON projects.id = models.project_id
WHERE projects.name = 'Diamond prices prediction';
Từ câu lệnh này, bạn có thể khám phá nhiều biến và chỉ số về pgml như models.id, pgml.models, pgml.projects, v.v. Hãy thử các câu `SELECT` trên chúng để làm quen.
Không giống MLOps truyền thống, bước này là dễ nhất trong PostgresML. Tiện ích mở rộng pgml tự động “lộ diện” mô hình có hiệu năng tốt nhất từ các thí nghiệm làm mô hình mặc định. Vì vậy, mọi câu lệnh SELECT pgml.predict người dùng gửi đến máy chủ sẽ dùng mô hình đó để suy luận.
Nếu bạn muốn kiểm soát chi tiết hơn mô hình nào được đưa vào sản xuất, bạn có thể điều khiển bằng hàm pgml.deploy. Cấu trúc như sau:
SELECT * FROM pgml.deploy(
   project_name TEXT,
   strategy TEXT DEFAULT 'best_score',
   algorithm TEXT DEFAULT NULL
)
Ngoài best_score, còn có các chiến lược triển khai most_recent và rollback:
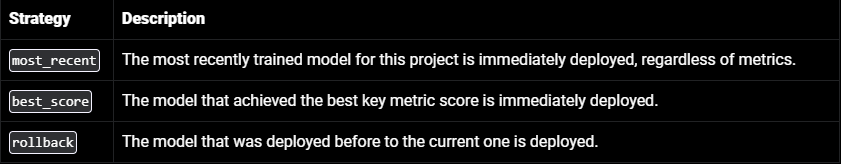
Bằng cách kết hợp tham số strategy và algorithm, bạn có thể thu hẹp việc triển khai hơn nữa. Ví dụ, câu lệnh dưới đây triển khai mô hình XGBoost có điểm số tốt nhất, không phải mô hình tốt nhất của toàn bộ dự án.
SELECT * FROM pgml.deploy(
   project_name => 'Diamond prices prediction',
   strategy => 'best_score',
   algorithm => 'xgboost'
)
Học có giám sát chỉ là một phần nhỏ của PostgresML. Thực tế, đề xuất giá trị cốt lõi của PostgresML là “Xây dựng ứng dụng AI trong Postgres.” Để minh họa, họ thậm chí đặt một trình soạn thảo SQL nhỏ ngay trên trang chủ:
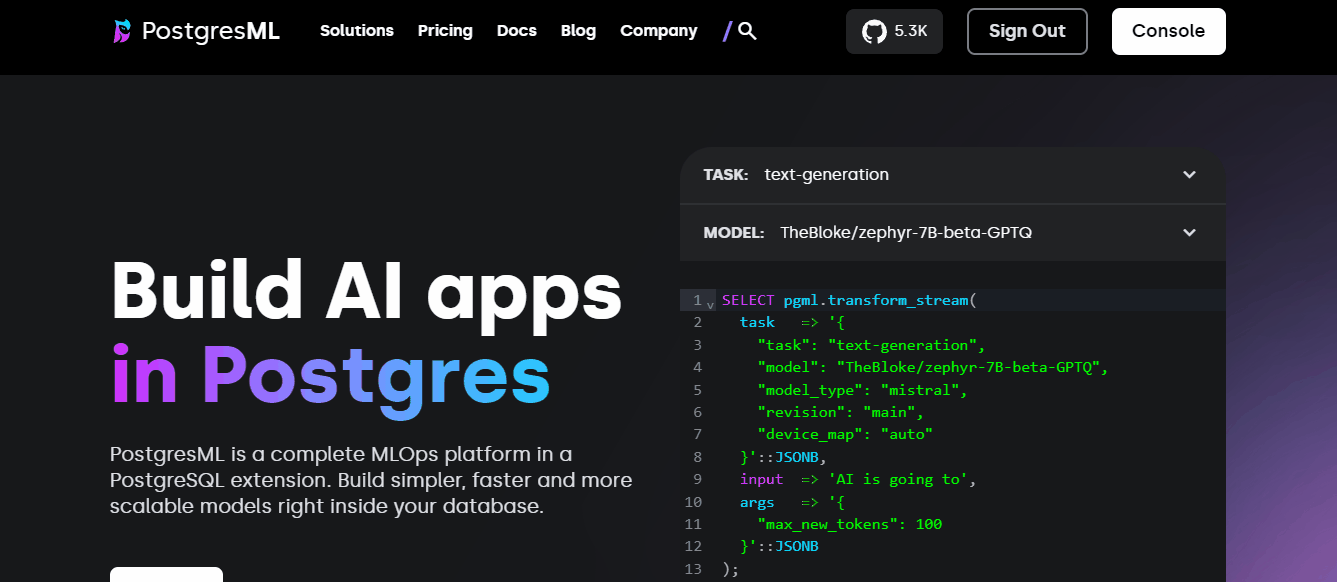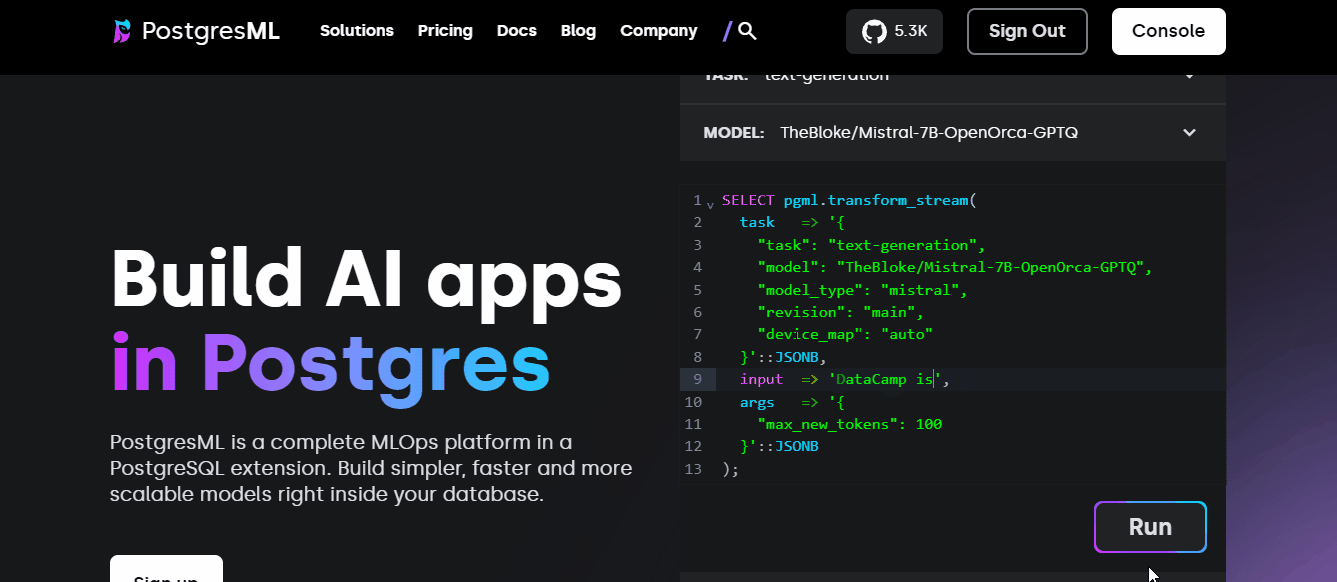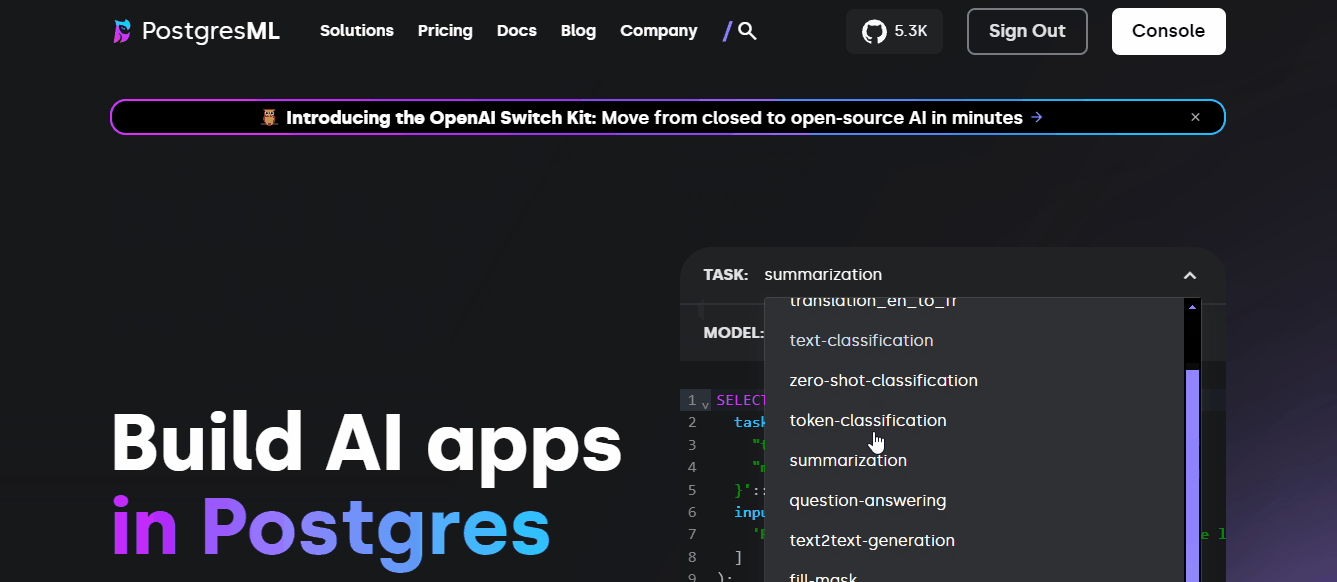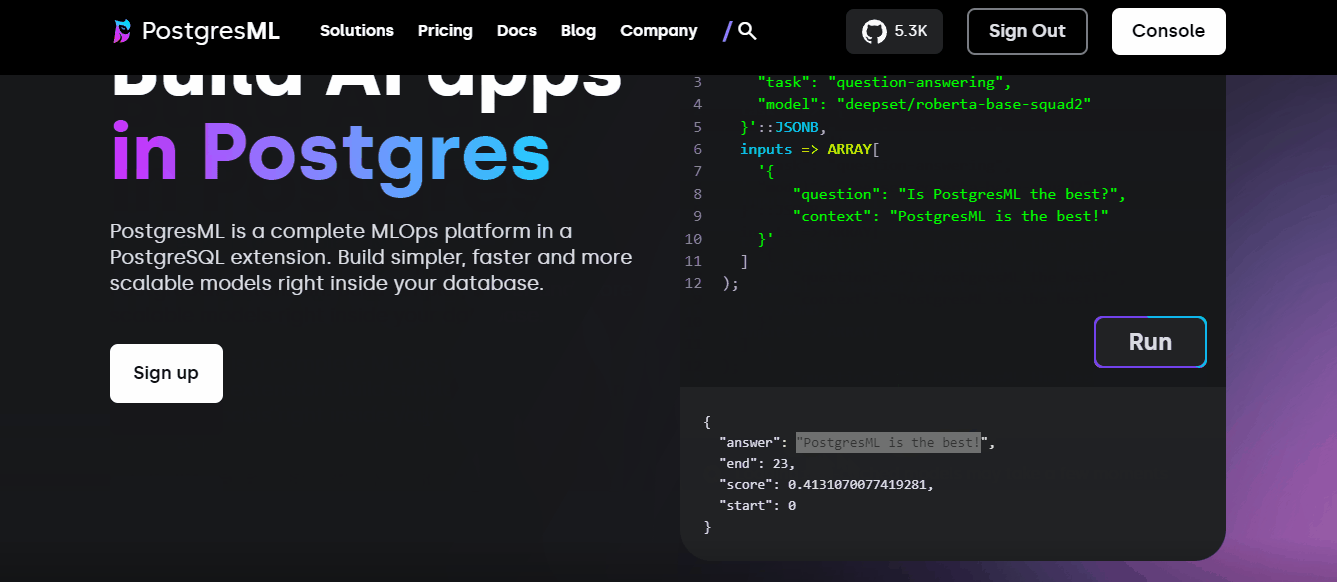
Bạn có thể chạy các ví dụ đó trực tiếp trong môi trường bạn đã dùng trong hướng dẫn này!
Vậy, nếu muốn xây dựng một dịch vụ machine learning hướng người dùng bằng PostgresML, bạn sẽ làm thế nào? Dưới đây là một số bước có thể có (sau khi bạn đã có mô hình sẵn sàng):
psycopg2 (Python) hoặc pg-promise (JavaScript) để kết nối tới cơ sở dữ liệu PostgresML.pgml.predict.Đây là phác thảo tổng quan có thể thay đổi đáng kể tùy trường hợp sử dụng.
PostgresML giới thiệu một mô hình hoàn toàn mới trong machine learning, nên cần nhiều hơn một hướng dẫn để làm chủ. Để củng cố hiểu biết và khám phá các cách dùng khác của PostgresML, hãy đọc phần use-cases trong tài liệu PostgresML.
Nếu kỹ năng SQL của bạn hơi “rỉ sét”, bạn có thể học khóa ngắn của DataCamp về tạo cơ sở dữ liệu PostgreSQL hoặc cả lộ trình Data Analyst in SQL.
Vì PostgresML tập trung mạnh vào AI, bạn cũng có thể học một số nền tảng AI:
Tiếp tục hành trình AI của bạn ngay hôm nay!
Khóa học
Lộ trình
Lộ trình
blog
Matt Crabtree
10 phút
