
Kurs
Large Language Models (LLMs) Kavramları
2 sa
112K
Makine öğrenimindeki baskın eğilim, verilerin eğitim için modelin ortamına taşınmasıdır. Peki bunu tersine çevirsek ne olur? Günümüz veritabanları, makine öğrenimi modellerinden katbekat büyük olduğuna göre, modelleri veri kümelerine getirmek çok daha kolay olmaz mı?
PostgresML'in temel fikri tam da bu — veri yerinde kalır, siz kodunuzu veritabanına getirirsiniz. Bu tür ters mantıklı makine öğrenimi yaklaşımı, “veritabanı” kavramını yeniden düşünmenize neden olacak bir dizi gerçek dünya faydası sunar.
PostgresML, popüler PostgreSQL veritabanı üzerine inşa edilmiş kapsamlı bir makine öğrenimi platformudur. “Veritabanı içi” makine öğrenimi olarak adlandırılan yeni bir paradigma sunar ve birçok ML görevini her adımda ayrı araçlara ihtiyaç duymadan SQL içinde gerçekleştirmenize olanak tanır.
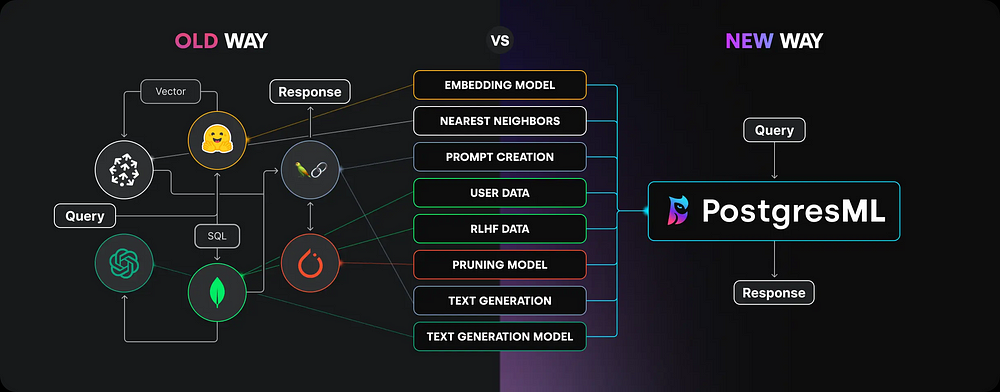
Görece yeni olmasına rağmen, PostgresML şu garantili avantajları vaat eder:
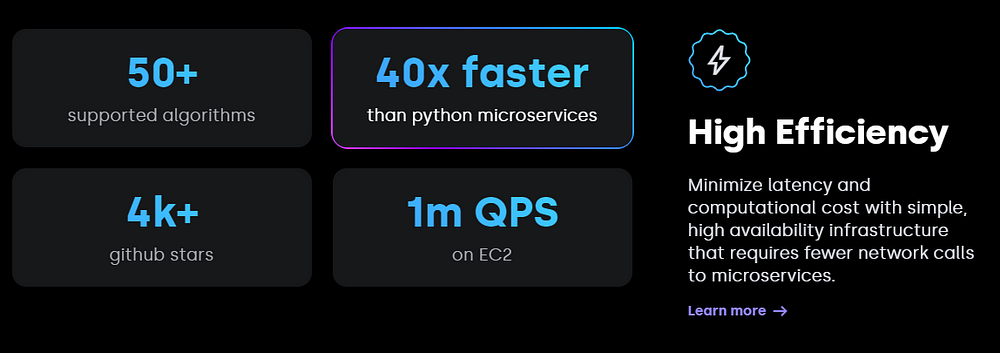
Bu eğitimde tipik bir makine öğrenimi iş akışını izleyerek tüm bu özellikleri test edeceğiz:
…bunların hepsi bir Postgres veritabanının içinde. Hadi başlayalım!
Öncelikle, https://postgresml.org/signup adresinden ücretsiz bir hesap oluşturarak başlayacağız:
Ardından, cömert kaynaklar sunan ücretsiz katmanı seçin:
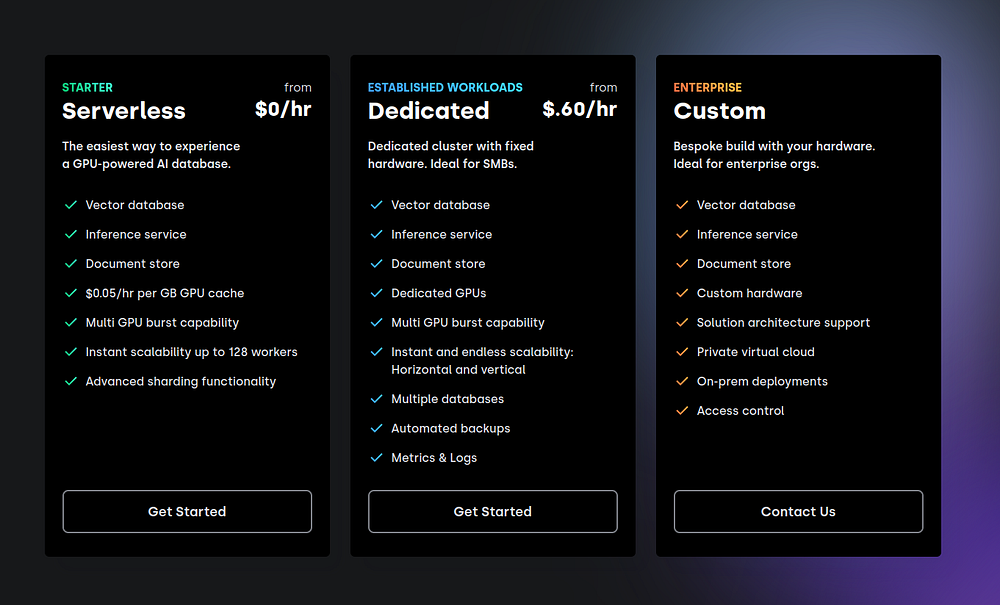
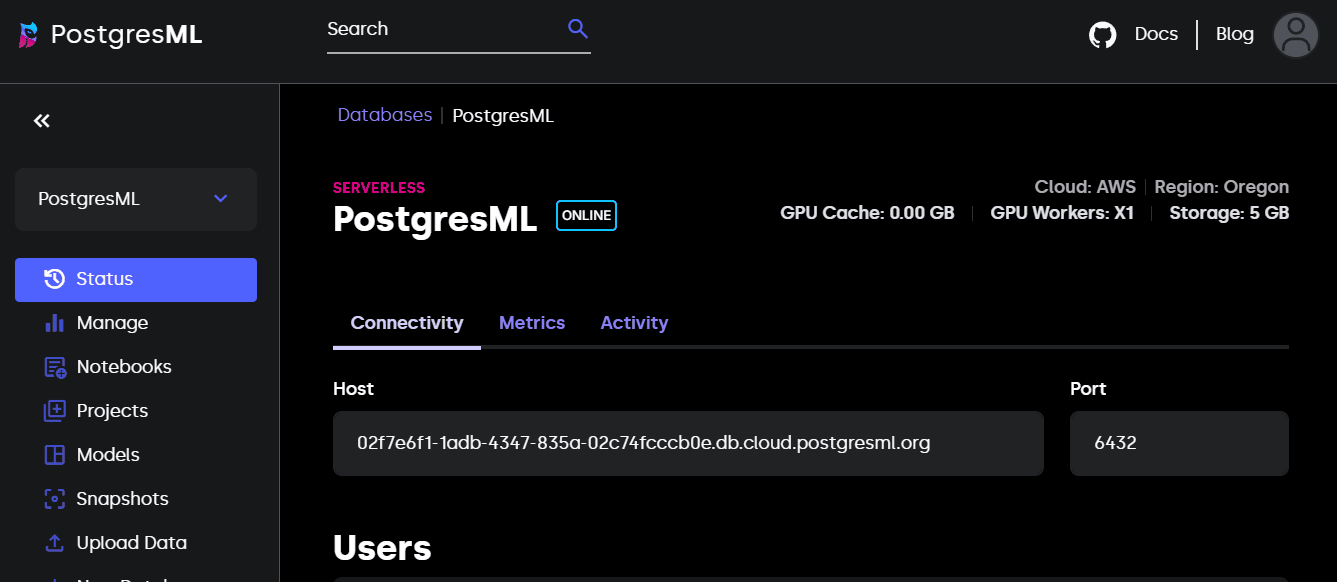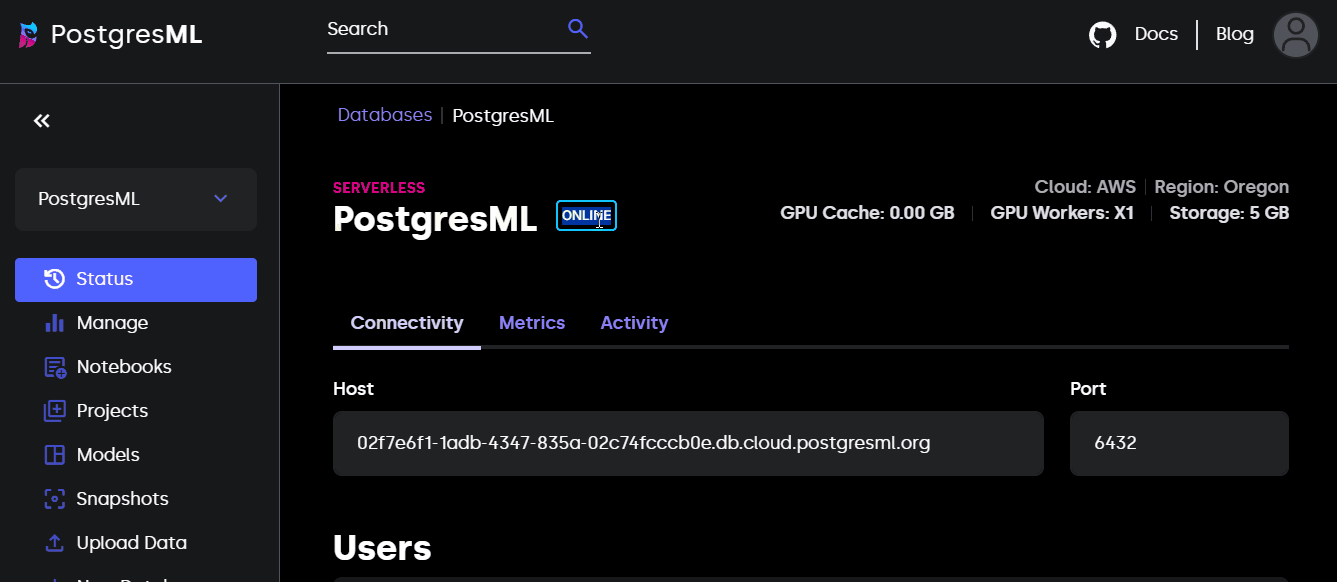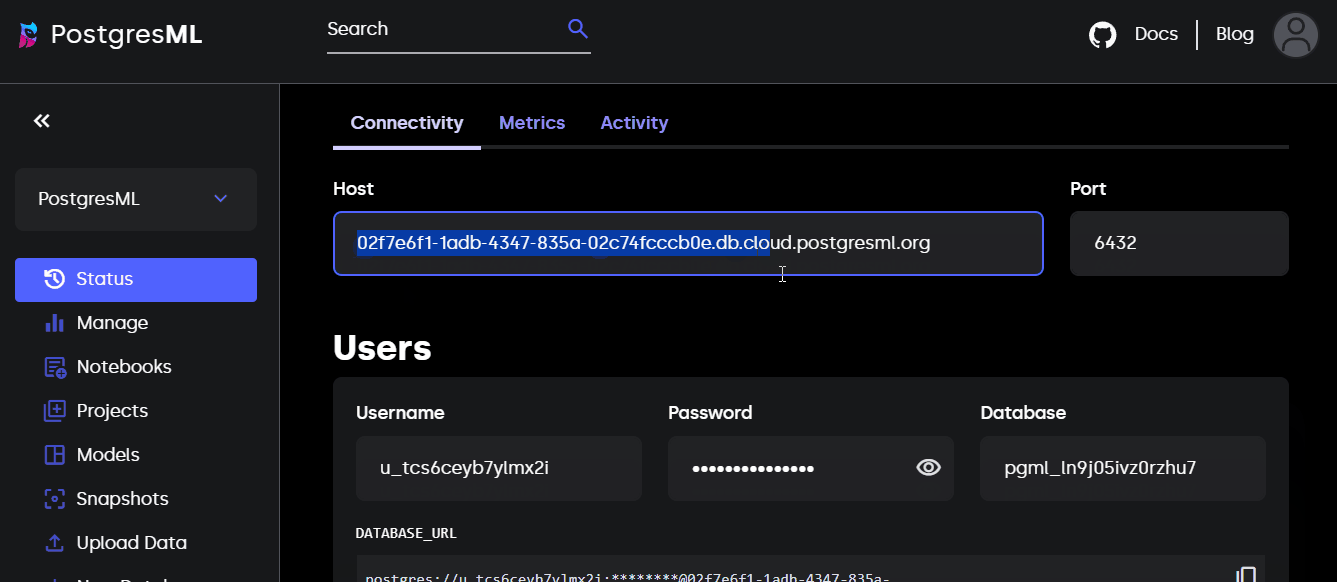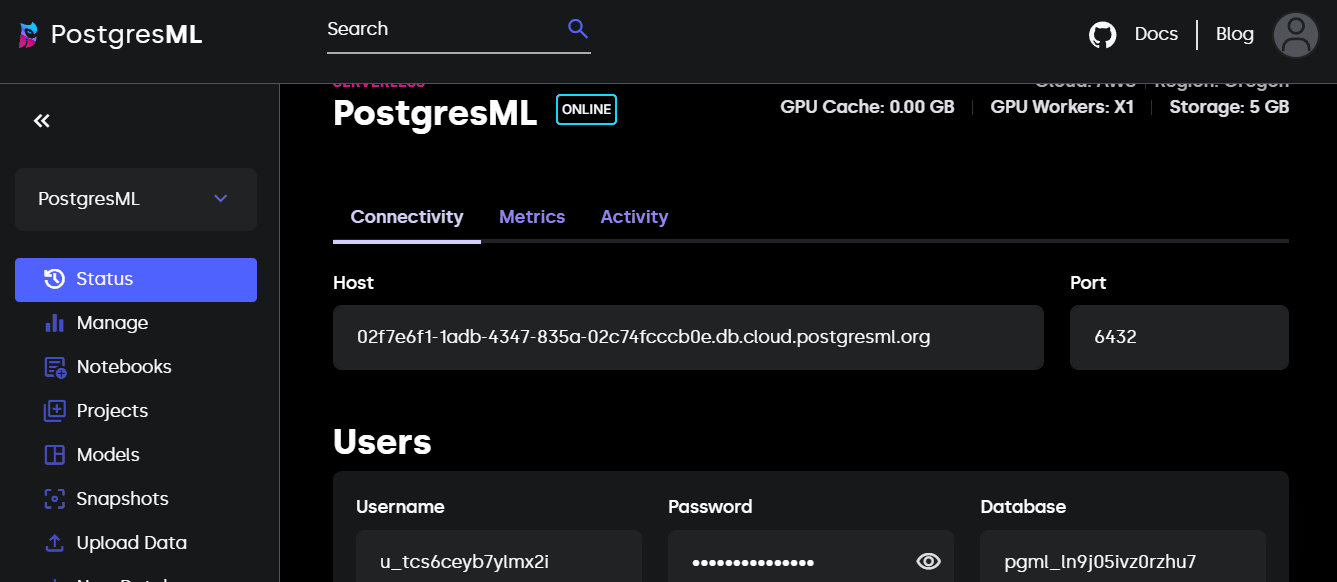
Kayıttan sonra PostgresML konsolunuza yönlendirileceksiniz. Burada farklı “Veritabanı içi ML” projelerini ve ilgili kaynaklarını yönetirsiniz.
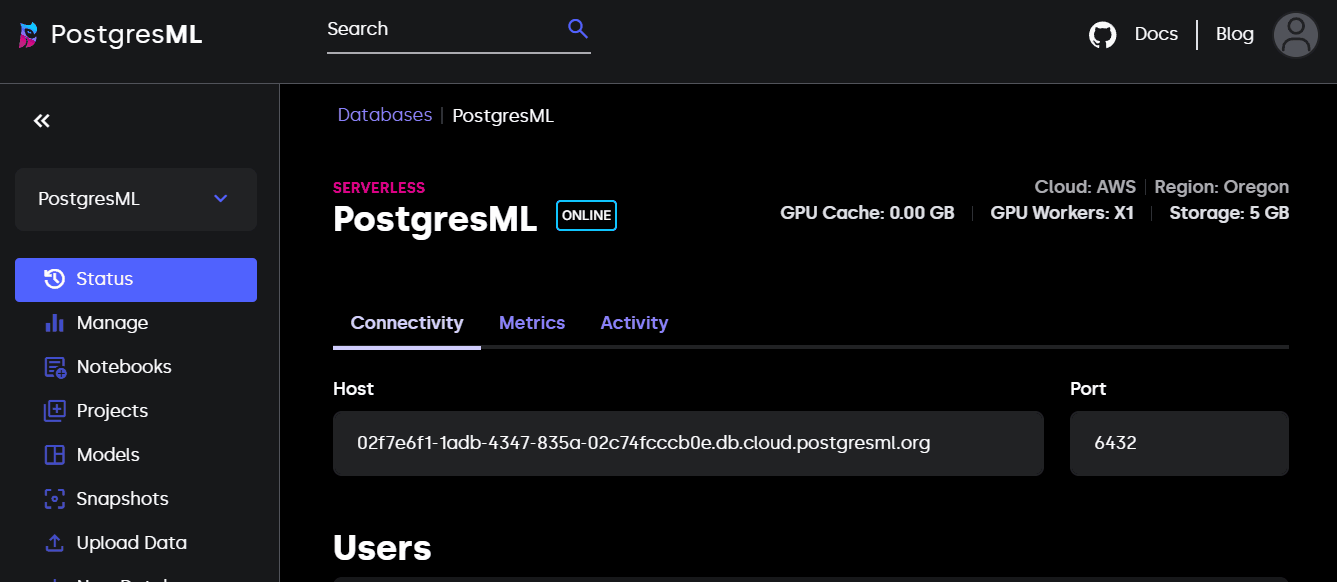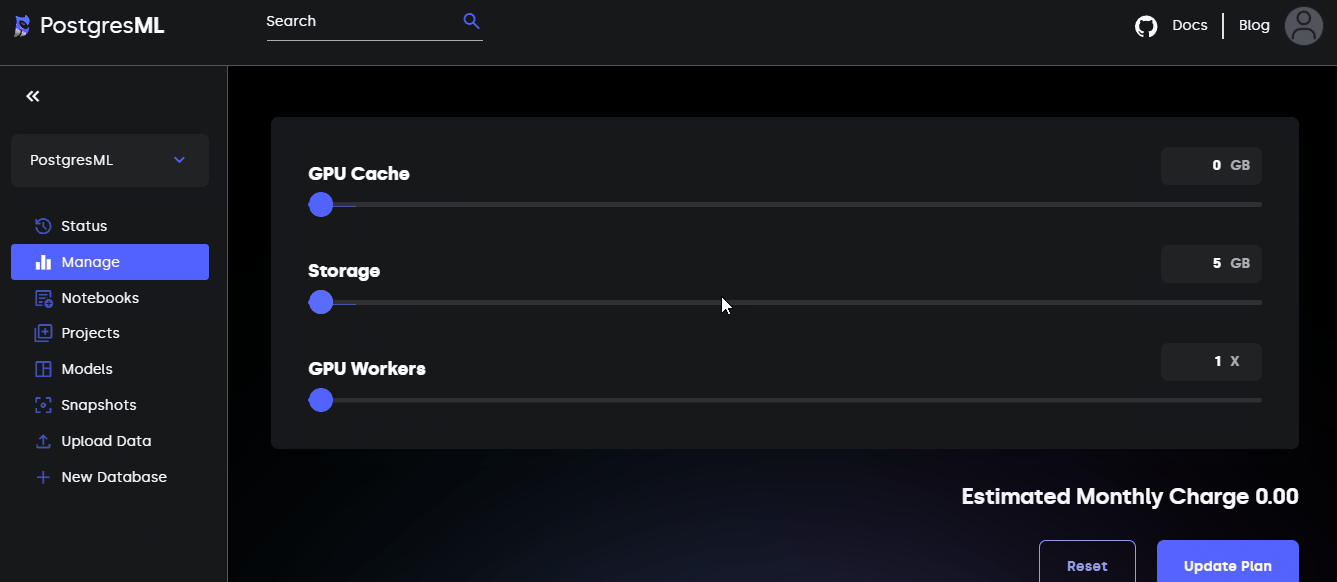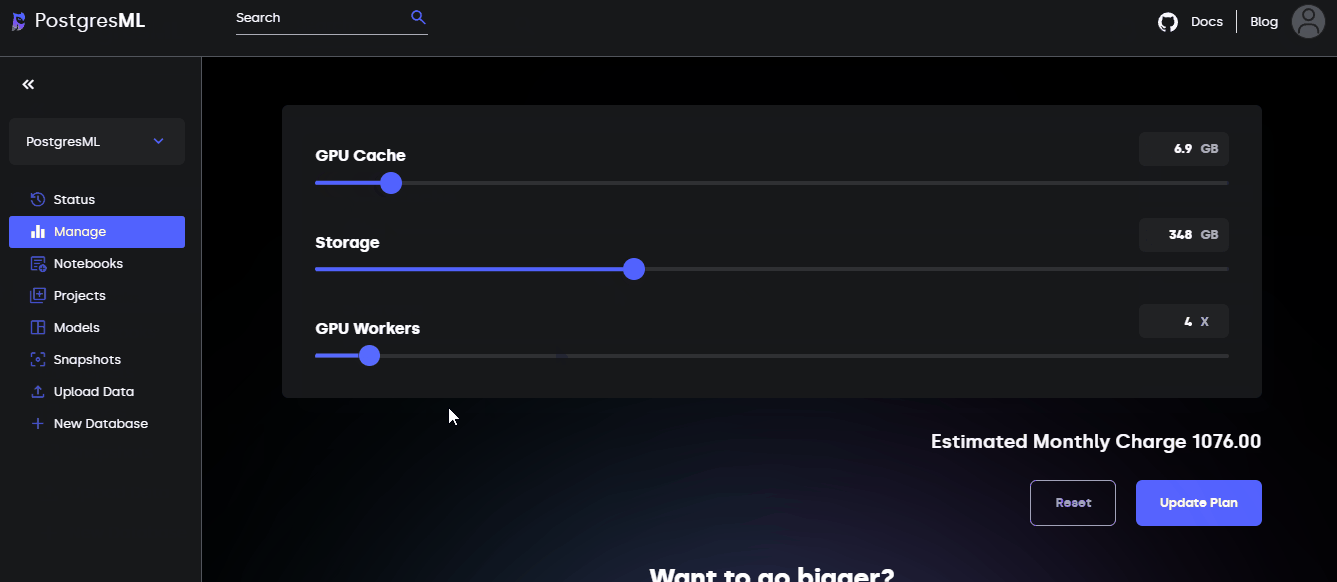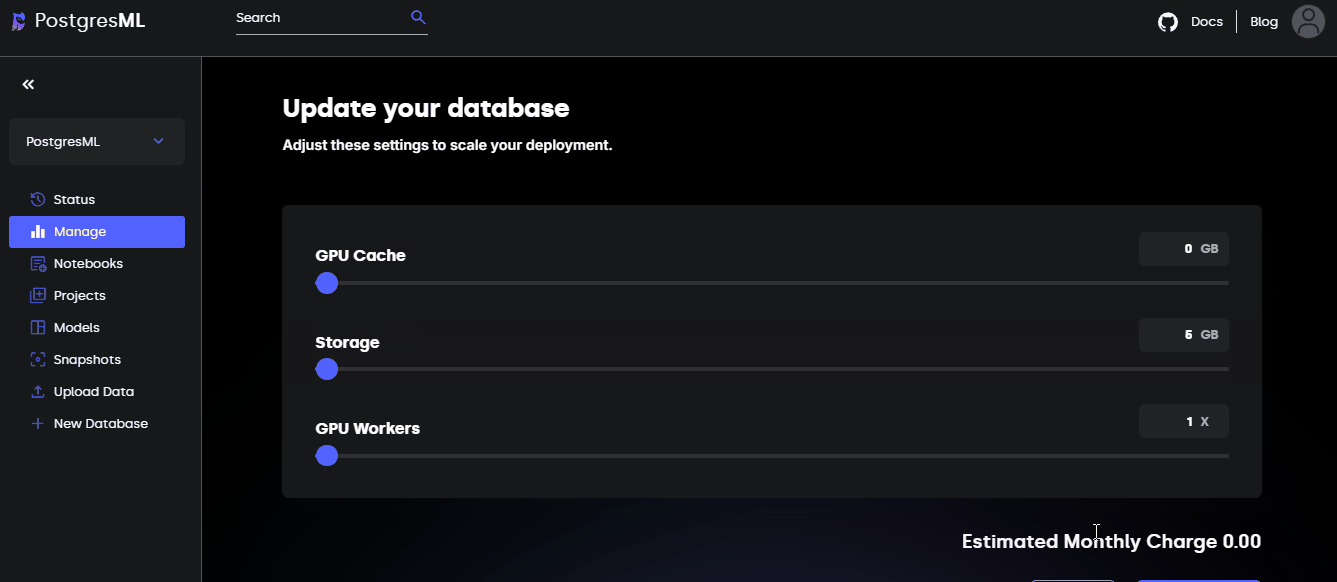
“Manage” bölümüne giderseniz, hesaplama gereksinimlerinize göre ortamınızı ölçekleyebilirsiniz:
İsminden de anlaşılacağı üzere, PostgresML'i kullanmak için sistemimizde PostgreSQL kurulu olmalıdır. Postgres’in ne olduğunu bilmiyorsanız, kendilerini “dünyanın en gelişmiş açık kaynak veritabanı” olarak tanımlıyorlar (web sitelerinde böyle yazıyor).
İşte platforma özel PostgreSQL kurulum rehberlerinin bağlantıları:
Ben WSL2 kullanıyorum, dolayısıyla şunu çalıştırabilirim:
$ sudo apt update
$ sudo apt install postgresql postgresql-contrib
$ sudo passwd postgres  # Set a new Postgres password
# Close and reopen your terminal and done!
Ardından kurulumu şu komutla doğrulayın:
$ psql --version
psql (PostgreSQL) 12.18 (Ubuntu 12.18-0ubuntu0.20.04.1)
psql, terminalde veritabanlarına bağlanmak ve yönetmek için resmi Postgres istemcisidir.
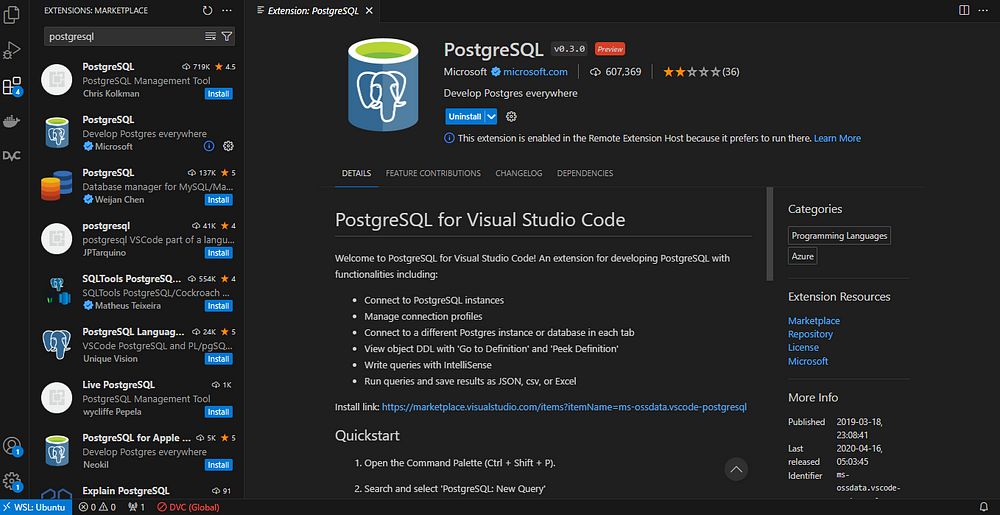
Çoğu kişi için SQL’i sade bir terminalde çalıştırmak ideal olmayabilir; bu nedenle Postgres’i kurduktan sonra aşağıdaki VSCode uzantısını da yükleyebilirsiniz:
PostgresML konsolunuzun açılış sayfasını hatırlıyor musunuz? Ayrı bir sekmede açık tutun:
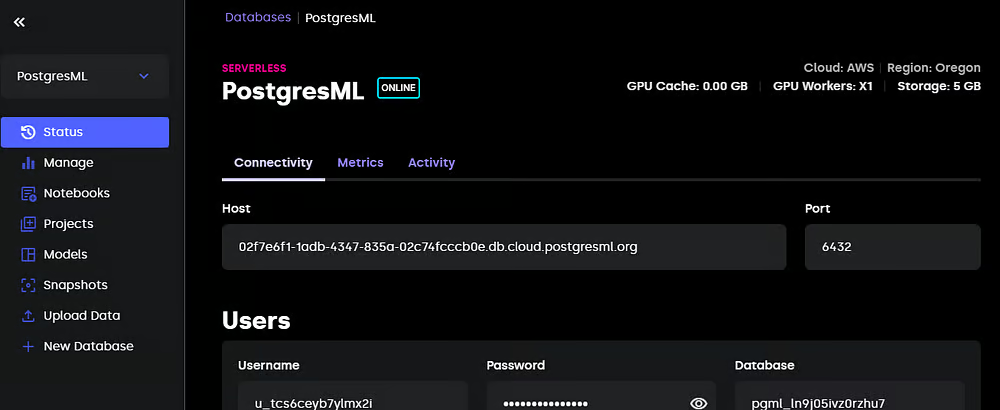
Şimdi psql kullanarak, kendi kimlik bilgilerinizle aşağıdaki komutu yazıp PostgresML sunucusuna bağlanabilirsiniz:
$ psql -h "host" \
      -U "username" \
      -p 6432 \
      -d "database_name"
VSCode uzantısını kullanıyorsanız, aynı işlemi yapmak için (uzantının kurulum sayfasından alınan) şu adımları izleyin:
Ve böylece PostgresML veritabanınıza bağlanmış olacaksınız.
Bir sonraki adım, PostgresML işlevlerini çalıştırmamıza olanak tanıyacak pgml uzantısını oluşturmaktır:
CREATE EXTENSION IF NOT EXISTS pgml;

NOTICE:  extension "pgml" already exists, skipping
CREATE EXTENSION
-- Your output may be different.
Her şeyin başarılı olup olmadığını pgml sürümünü yazdırarak kontrol edin:
SELECT pgml.version();

2.8.2 (98f114891db58acd472e068c44272b198274b11d)
Şimdi veritabanımıza biraz veri yükleyelim. Basit tutmak için Kaggle’daki Diamonds veri setini kullanarak tek bir tablo oluşturacağız. Bunu web sitesinden CSV olarak indirebilir veya aşağıdaki Python parçacığını kullanabilirsiniz:
import seaborn as sns

diamonds = sns.load_dataset("diamonds")
diamonds.to_csv("diamonds.csv", index=False)
Ardından, doğru şemayla aşağıdaki CREATE komutunu çalıştırın:
CREATE TABLE IF NOT EXISTS diamonds (
   index SERIAL PRIMARY KEY,
   carat FLOAT,
   cut VARCHAR(255),
   color VARCHAR(255),
   clarity VARCHAR(255),
   depth FLOAT,
   table_ FLOAT,
   price INT,
   x FLOAT,
   y FLOAT,
   z FLOAT
)
Bu komut, CSV dosyasındaki satırlarla doldurabileceğimiz diamonds adlı bir tablo oluşturacaktır:
INSERT INTO diamonds
   (carat, cut, color, clarity, depth, table_, price, x, y, z)
   FROM '~/full/path/to/diamonds.csv'
   DELIMITER ','
   CSV HEADER;
Son olarak, son komutun başarıyla çalıştığını doğrulamak için tablonun üst kısmını yazdıralım:
SELECT * FROM diamonds
LIMIT 10;
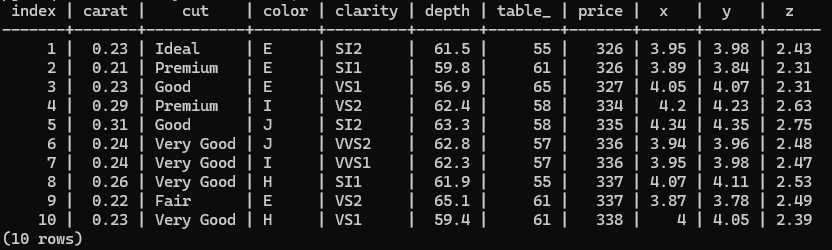
Artık bir model eğitmeye hazırız!
Denetimli öğrenim için bir makine öğrenimi modelini eğitmek, pgml.train işleviyle yapılır. Temel yapısı şöyledir:
SELECT pgml.train(
 project_name => 'Diamond prices prediction',
 task => 'regression',
 relation_name => 'diamonds',
 y_column_name => 'price',
 algorithm => 'xgboost'
);
Yukarıdaki SQL deyimi, elmas fiyatlarını tahmin etmek için diamonds tablosuna bir XGBoost regresörü uydurur. Komutu çalıştırdığınızda fark edeceğiniz şeylerden biri, 50 binden fazla satır olmasına rağmen ne kadar hızlı olduğudur (neredeyse anında).
Görevleri de kolayca değiştirebilirsiniz. Çok sınıflı bir sınıflandırıcıyı böyle uydurursunuz (proje adını değiştirmeyi unutmayın):
SELECT pgml.train(
 project_name => 'Diamond cut quality prediction',
 task => 'classification',
 relation_name => 'diamonds',
 y_column_name => 'cut',
 algorithm => 'xgboost',
 test_size => 0.1
);
Bu kez test_size argümanını belirttiğimize dikkat edin – özel bölme de destekleniyor!
Ayrıca varsayılan linear algoritmasını xgboost ile değiştirdik ancak Scikit-learn’den ya da desteklenen başka bir çerçeveden herhangi bir model de olabilirdi.
Bu kez bir rasgele orman modeli uydurmayı deneyelim:
…
Ama durun! Diamonds veri setinde kodlanması gereken metin özellikleri var. XGBoost kategorikleri yerel olarak kodladığı için önceki sorgularda hata almadık. Bu, rasgele ormanlar için geçerli olmayabilir. O hâlde sorgumuza bazı ön işleme adımları ekleyelim:
SELECT pgml.train(
   project_name => 'Diamond prices prediction',
   task => 'regression',
   relation_name => 'diamonds',
   y_column_name => 'price',
   algorithm => 'random_forest',
   preprocess => '{
       "carat": {"scale": "standard"},
       "depth": {"scale": "standard"},
       "table_": {"scale": "standard"},
       "cut": {"encode": "target", "scale": "standard"},
       "color": {"encode": "target", "scale": "standard"},
       "clarity": {"encode": "target", "scale": "standard"}
   }'::JSONB
);
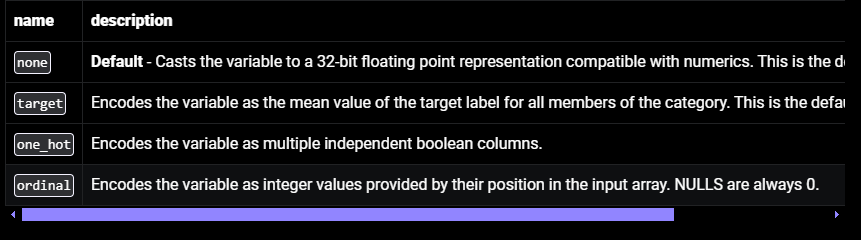
Ön işleme mantığı, sütunları dönüşüm adımlarına eşleyen bir JSONB nesnesi içinde tanımlanır. Sayısal özellikler için standardizasyon kullanıyoruz (RF için şart olmasa da). Kategorik sütunlarda ise hedef kodlama ardından standardizasyon uyguluyoruz.
PostgresML alternatif ön işleme işlevleri de sunar. Mevcut kodlama seçeneklerinin tam listesi şöyledir:
pgml standart değer atama (imputing) tekniklerini de destekler:
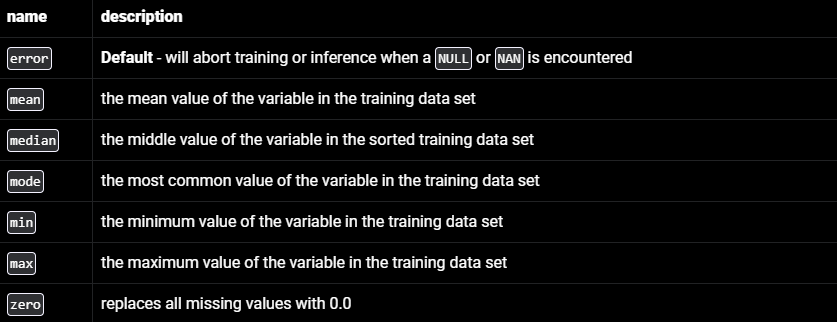
Ve işte ölçekleyicilerin listesi:
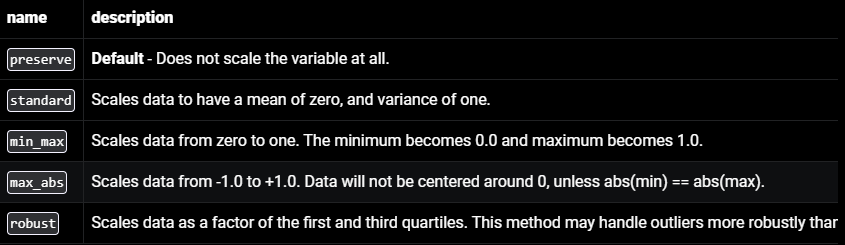
Scikit-learn’deki kadar geniş bir ön işleyici setiniz olmasa da, bunlar denetimli öğrenimdeki çoğu görev için yeterlidir.
Şimdiye kadar algoritmaların varsayılan parametrelerini kullandık. Ancak gerçek dünya problemlerinde varsayılanlar neredeyse hiç ideal değildir. Özel değerleri belirtmek için pgml.train işlevinin hyperparams argümanını kullanabiliriz:
SELECT pgml.train(
   project_name => 'Diamond prices prediction',
   task => 'regression',
   relation_name => 'diamonds',
   y_column_name => 'price',
   algorithm => 'xgboost',
   hyperparams => '{
       "n_estimators": 1000, "max_depth": 5, "eta": 0.01, "subsample": 0.7
   }'::JSONB
);
Bu kez, 1000 ağaçlı, maksimum derinliği 5 olan ve öğrenme oranı 0,01 olan bir XGBoost regresörü uyduruyoruz. Şimdilik biraz deneme-yanılmayla hareket ediyoruz, dolayısıyla bu hiperparametreler isabetli sonuçlar vermeyebilir.
Model sonuçlarını en üst düzeye çıkarmak için denetimli öğrenim görevlerinde her zaman hiperparametre ayarına ihtiyaç duyarız. Bu süreç, train işlevi içinde pgml tarafından da desteklenir. İşte küçük bir hiperparametre kombinasyonu kümesi üzerinde ızgara araması (grid search) yapma örneği:
SELECT pgml.train(
   'Diamond prices prediction',
   algorithm => 'xgboost',
   search => 'grid',
   search_params => '{
       "max_depth": [5, 7],
       "n_estimators": [1000, 1500],
       "eta": [0.1, 0.01, 0.001]
   }'::JSONB
);
Bu noktada ne yaptığımızı takdir etmenizi istiyorum. Bir XGBoost regresörünün hiperparametrelerini SQL kullanarak ayarlıyoruz! Böyle bir cümle yazacağımı hiç düşünmemiştim.
Bu eğitimin yazıldığı sırada, PostgresML’in elinde yeterince olgun değerlendirme araçları yok. Yalnızca predict işlevi mevcut. Yeni, tek bir örnek üzerinde tahmin yapmak için şöyle kullanılır:
SELECT pgml.predict(
   project_name => 'Diamond prices prediction',
   features => ARRAY[0.7, "Ideal", "A", "IF", 67.9, 56.9, 7024, 5.85, 5.87, 3.71]
);
predict, deneylerinizdeki en iyi performanslı modeli otomatik olarak kullanır. Regresyonda bu, en yüksek R-kare değerine sahip modeldir; sınıflandırmada ise en yüksek F1 skorlu model kullanılır.
Belirli bir modeli tahmin için kullanmak isterseniz, kimliğini belirtebilirsiniz:
SELECT pgml.predict(
  2' -- Use model with ID of 2,
   features => ARRAY[0.7, "Ideal", "A", "IF", 67.9, 56.9, 7024, 5.85, 5.87, 3.71]
)
Peki model kimliklerini nasıl bulacaksınız? İşte tam da bu bilgiyi içeren güzel bir tabloyu yazdıran küçük bir parça:
SELECT models.id, models.algorithm, models.metrics
FROM pgml.models
JOIN pgml.projects
 ON projects.id = models.project_id
WHERE projects.name = 'Diamond prices prediction';
Bu deyimden, models.id, pgml.models, pgml.projects vb. gibi pgml ile ilgili birçok değişken ve ölçümü keşfedebilirsiniz. Ne yaptıklarını görmek için üzerlerinde `SELECT` deyimleri deneyin.
Geleneksel MLOps’un aksine, bu adım PostgresML’de en kolay olanıdır. pgml uzantısı, deneylerinizdeki en iyi performanslı modeli varsayılan olarak otomatik şekilde kullanıma açar. Böylece sunucuya gönderilen tüm SELECT pgml.predict deyimleri çıkarım için o modeli kullanır.
Daha ince ayarlı bir kontrolle hangi modelin üretime alınacağını belirlemek isterseniz, bunu pgml.deploy işleviyle yönetebilirsiniz. Yapısı şöyledir:
SELECT * FROM pgml.deploy(
   project_name TEXT,
   strategy TEXT DEFAULT 'best_score',
   algorithm TEXT DEFAULT NULL
)
best_score’ın yanı sıra most_recent ve rollback dağıtım stratejileri de mevcuttur:
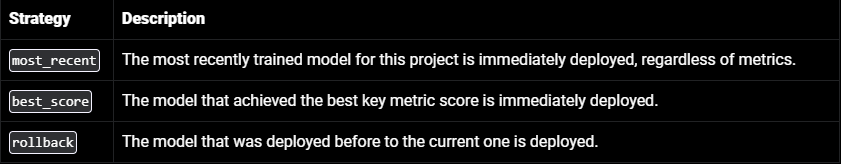
strategy ve algorithm parametrelerini birleştirerek dağıtımı daha da daraltabilirsiniz. Örneğin, aşağıdaki deyim, tüm projenin en iyi performanslı modelini değil, en yüksek skorlu XGBoost modelini dağıtır.
SELECT * FROM pgml.deploy(
   project_name => 'Diamond prices prediction',
   strategy => 'best_score',
   algorithm => 'xgboost'
)
Denetimli öğrenim, PostgresML’in yalnızca küçük bir parçasıdır. Aslında PostgresML’in tüm değer önerisi “Postgres içinde yapay zekâ uygulamaları geliştirmek”tir. Bunu sergilemek için ana sayfaya küçük bir SQL düzenleyici bile koymuşlar:
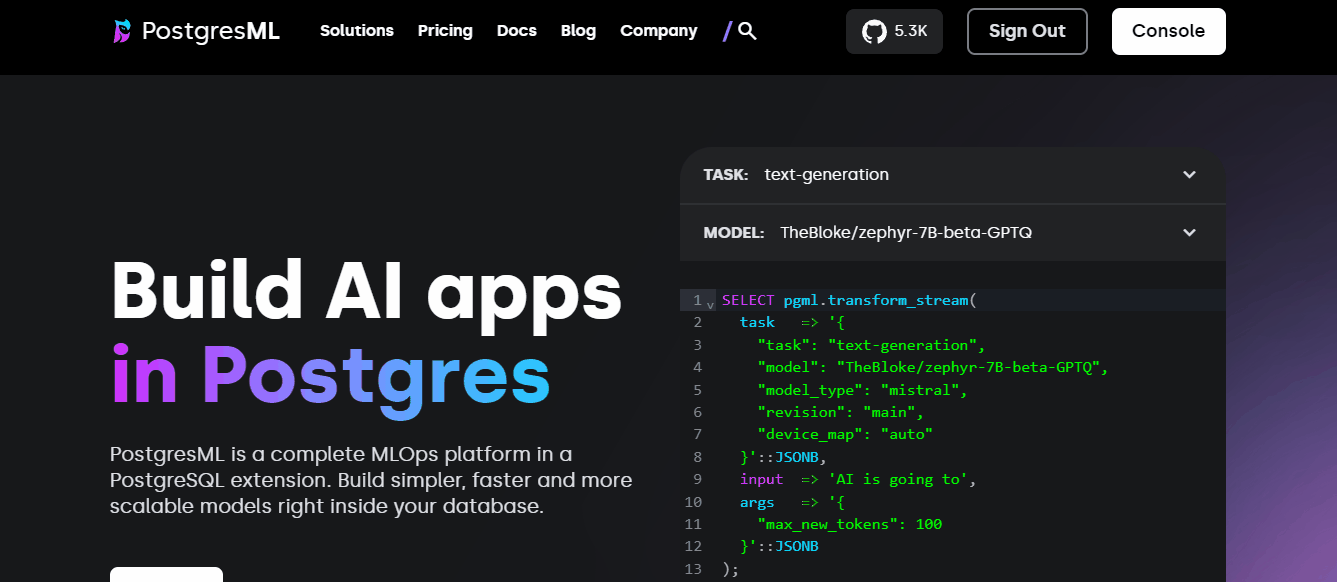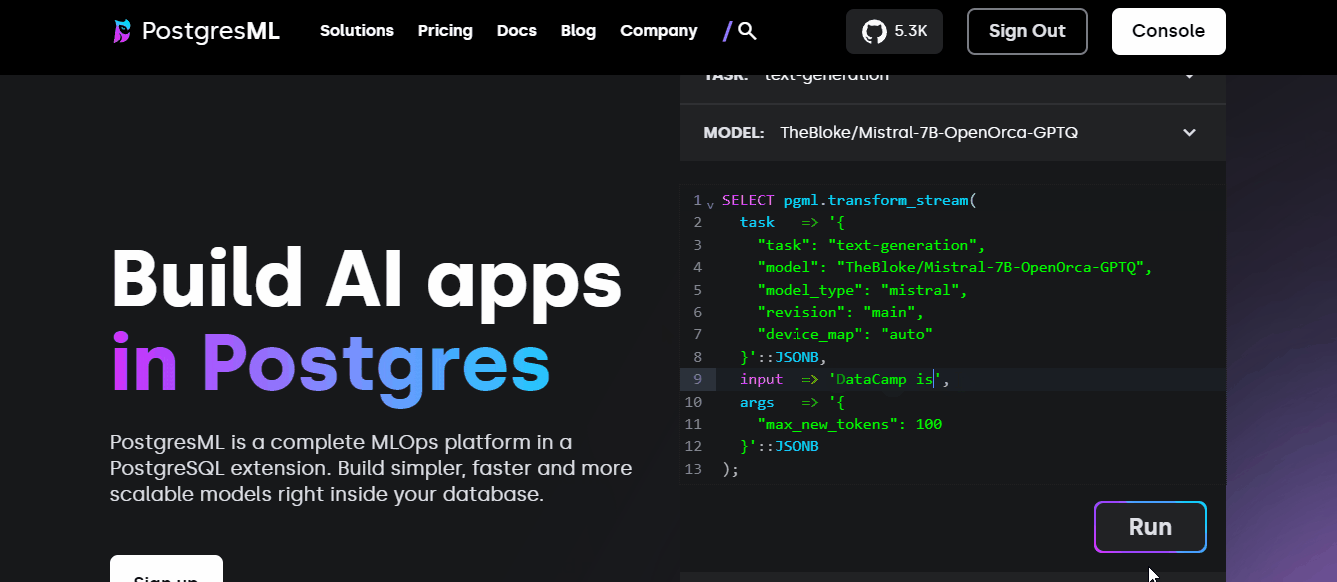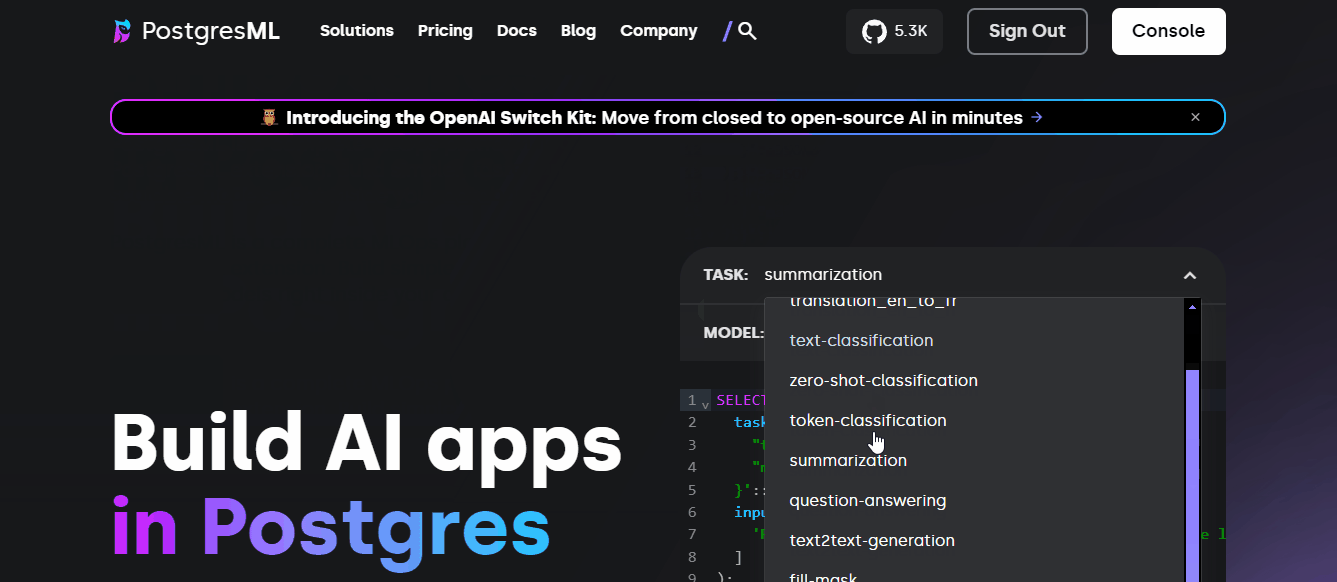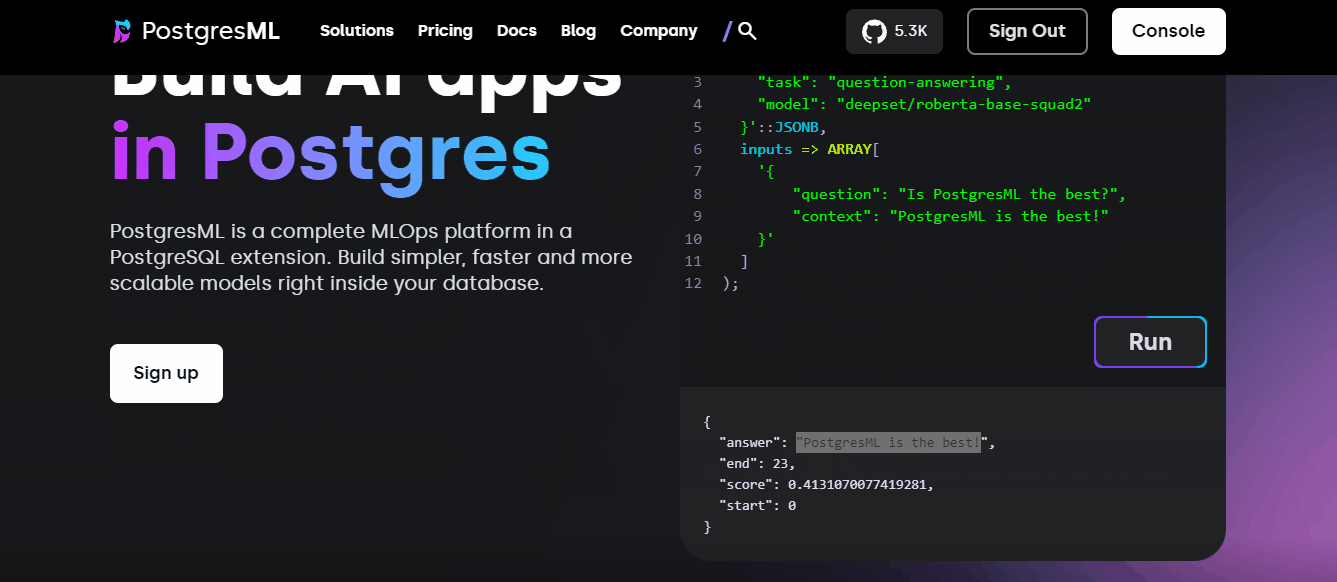
Bu eğitimde kullandığınız ortamda da bu örnekleri doğrudan çalıştırabilirsiniz!
Peki PostgresML ile son kullanıcıya yönelik bir makine öğrenimi hizmeti geliştirmek isteseydiniz, nasıl yapardınız? İşte bazı olası adımlar (model hazır olduktan sonra):
psycopg2 (Python) veya pg-promise (JavaScript) gibi kitaplıkları kullanın.pgml.predict çağrılır.Bu, kullanım senaryolarına göre önemli ölçüde değişebilecek kabaca bir taslaktır.
PostgresML, makine öğreniminde tamamen yeni bir paradigma sunar; bu nedenle onu ustalıkla kullanmak tek bir eğitimden daha fazlasını gerektirir. Anlayışınızı pekiştirmek ve PostgresML’in başka nasıl kullanılabileceğini keşfetmek için PostgresML dokümanlarının kullanım örnekleri bölümünü okuyun.
SQL becerileriniz biraz paslandıysa DataCamp’in PostgreSQL veritabanları oluşturma üzerine kısa kursunu ya da hatta tüm SQL ile Veri Analisti kariyer yolunu alabilirsiniz.
PostgresML yapay zekâya yoğunlaştığından, bazı temel AI konularını da öğrenebilirsiniz:
Yapay Zekâ Yolculuğunuza Bugün Devam Edin!
Kurs
Program
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




