
Program
Pengembangan Aplikasi Kecerdasan Buatan
21 jam
Seri Qwen2.5-Coder (sebelumnya dikenal sebagai CodeQwen1.5), yang dikembangkan oleh tim riset Qwen Alibaba, didedikasikan untuk memajukan Open CodeLLMs. Seri ini mencakup model seperti Qwen 2.5-32B-Instruct, yang telah menjadi model kode open-source mutakhir, menandingi kemampuan pengkodean raksasa proprietary seperti GPT-4o dan Gemini.
Model-model ini diposisikan sebagai:
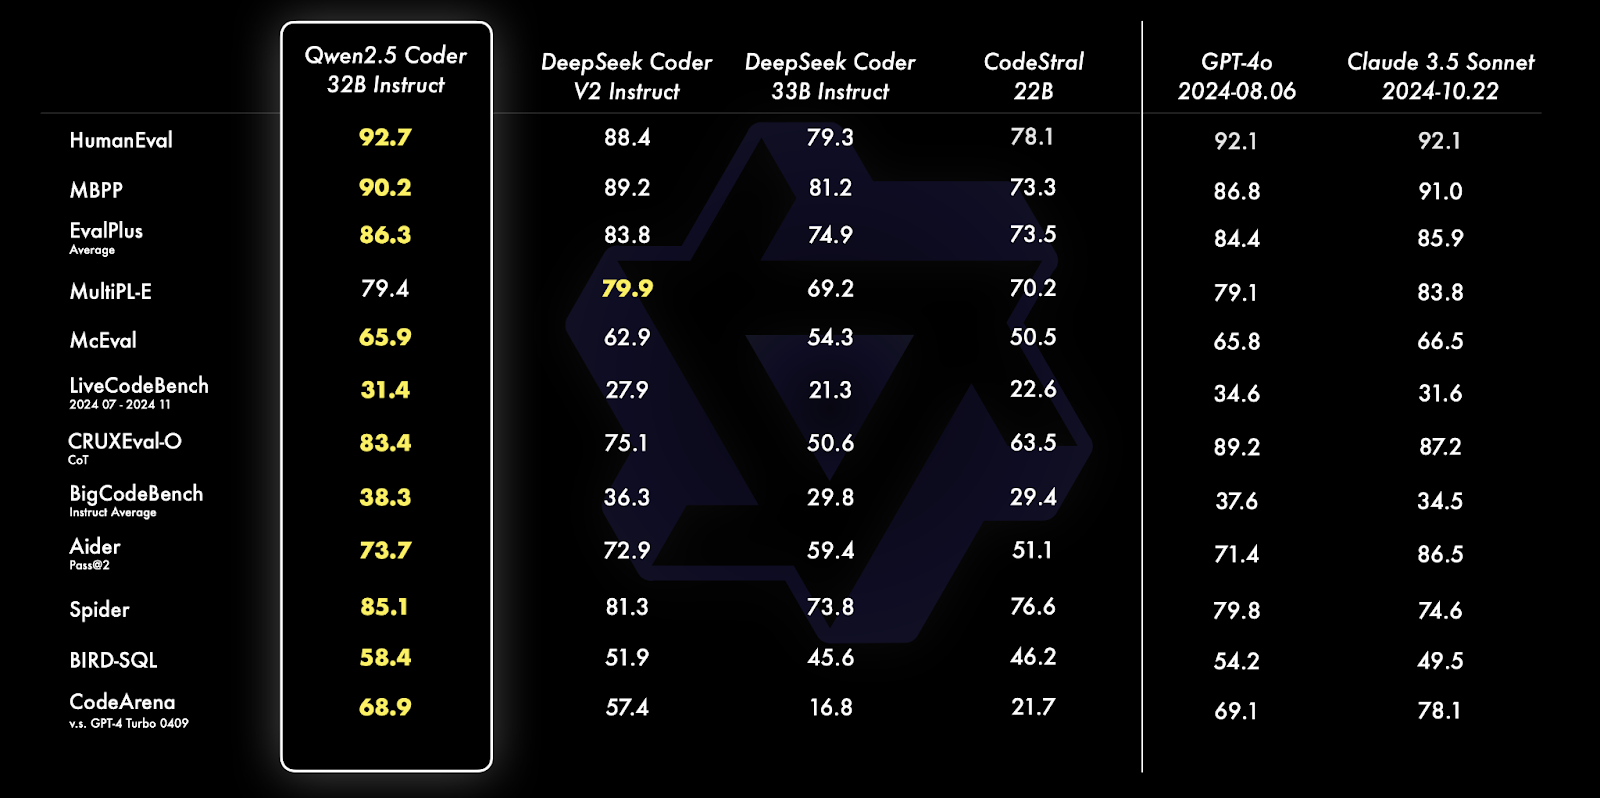
Sumber: Blog resmi Qwen
Qwen 2.5 Coder 32B Instruct mengungguli para pesaingnya di berbagai tolok ukur, termasuk HumanEval, MBPP, dan Spider, menunjukkan kemampuan pengkodean dan pemecahan masalah yang luar biasa. Model ini unggul dalam beragam tugas seperti pembuatan kueri SQL, evaluasi kode, dan tantangan pemrograman dunia nyata, melampaui model seperti GPT-4o dan Claude 3.5 Sonnet.
Untuk mempelajari lebih lanjut tentang kemampuan dan perbandingan model-model ini, baca artikel pengumuman Seri Qwen2.5-Coder.
Pada bagian ini, kita akan menyelami implementasi kode untuk asisten peninjau kode menggunakan Gradio.
Kita akan mulai dengan menyiapkan prasyarat yang diperlukan, kemudian menginisialisasi model dengan konfigurasi yang dioptimalkan.
Selanjutnya, kita akan mendefinisikan fungsionalitas inti, memanfaatkan kemampuan instruksi model dan pada akhirnya mengintegrasikan komponen-komponen ini ke antarmuka Gradio yang ramah pengguna, sehingga memudahkan interaksi dengan asisten.
Sebelum masuk ke implementasi, pastikan kita telah memasang alat dan pustaka berikut:
Jalankan perintah berikut untuk memasang dependensi yang diperlukan:
!pip install torch transformers gradio bitsandbytes -qSetelah dependensi di atas terpasang, jalankan perintah impor berikut:
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
import torch
Import gradio as gr
Catatan: Menjalankan model Qwen2.5-Coder-32B-Instruct di Google Colab memerlukan GPU A100 dengan RAM tinggi. Jika sumber daya terbatas, pertimbangkan untuk menggunakan model berparameter lebih rendah seperti 0.5B, 3B, 7B, atau 14B.
Pustaka Hugging Face Transformers memudahkan pemuatan model besar. Kita mulai dengan menginisialisasi model Qwen2.5-Coder-32B-Instruct dari HuggingFace dengan kuantisasi untuk kinerja yang lebih baik:
# Define quantization configuration for optimized performance
bnb_config = BitsAndBytesConfig(load_in_8bit=True)
# Load the model and tokenizer
model_name = "Qwen/Qwen2.5-Coder-32B-Instruct"
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.float16,
    device_map="auto",
    quantization_config=bnb_config
)
tokenizer = AutoTokenizer.from_pretrained(model_name)
if tokenizer.pad_token_id is None:
    tokenizer.pad_token_id = tokenizer.eos_token_id
Cuplikan kode di atas memungkinkan kita memuat model Qwen2.5-Coder-32B-Instruct dengan kuantisasi 8-bit, mengurangi penggunaan memori untuk eksekusi yang efisien pada perangkat dengan sumber daya terbatas.
Kode tersebut menggunakan BitsAndBytesConfig untuk mengaktifkan kuantisasi, torch.float16 untuk komputasi yang dioptimalkan pada GPU yang didukung, dan device_map="auto" untuk alokasi perangkat keras otomatis. Tokenizer dari pustaka transformers milik HuggingFace memastikan pemrosesan teks yang mudah, menetapkan pad_token_id jika belum disetel. Konfigurasi ini memudahkan menjalankan model besar secara efisien pada perangkat kelas konsumen.
Setelah kita memuat model beserta tokenizer, kita menyiapkan fungsi untuk menghasilkan respons dari model menggunakan metode apply_chat_template.
def generate_response(messages):
    text = tokenizer.apply_chat_template(
        messages,
        tokenize=False,
        add_generation_prompt=True
    )
    model_inputs = tokenizer([text], return_tensors="pt").to(model.device)
    generated_ids = model.generate(
        **model_inputs,
        max_new_tokens=200,
        temperature=0.7,
        repetition_penalty=1.2
    )
    generated_ids = [
        output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
    ]
    response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
    return response
Fungsi di atas berfungsi sebagai utilitas untuk berinteraksi dengan model Qwen2.5-Coder-32B-Instruct dalam menghasilkan respons yang kontekstual. Fungsi ini menerima daftar pesan bergaya chat (dengan peran seperti “system” dan “user”) sebagai masukan dan melakukan langkah-langkah berikut:
apply_chat_template, menyiapkannya untuk pemahaman berbasis chat oleh model.max_new_tokens=200; Parameter ini membatasi panjang respons hingga 200 token.temperature=0.7; Membantu mengontrol keacakan respons, sehingga menyeimbangkan kreativitas dan konsistensi.repetition_penalty=1.2; Parameter ini mengurangi frasa berulang pada keluaran.4. Pascapemrosesan: Langkah ini menghapus prompt masukan dari keluaran yang dihasilkan dengan melakukan slicing dan mendekode respons menjadi string yang dapat dibaca manusia menggunakan fungsi batch_decode. Fungsi ini mengabstraksi kompleksitas penyiapan, pembuatan, dan pengodean respons, sehingga dapat digunakan kembali untuk berbagai tugas seperti debugging, analisis kode, dan menghasilkan umpan balik yang dapat ditindaklanjuti.
Selanjutnya, kita menyiapkan kode untuk fitur inti aplikasi kita, yaitu penganalisis kode, peningkat kode, dan pemeriksa standar pengkodean. Karena kita menggunakan model instruksi, kita dapat menggunakan peran seperti “system” dan “user” dan menyertakannya ke dalam prompt untuk menghasilkan respons dari model.
Berikut tiga fitur inti aplikasi kita: pendeteksi isu, pakar kualitas kode, dan pakar standar pengkodean.
Asisten ini mengidentifikasi kesalahan sintaks, bug logis, dan potensi kerentanan dalam kode yang diberikan. Instruksi khusus untuk model adalah:
def analyze_code_issues(code):
    messages = [
        {"role": "system", "content": "You are Qwen, a helpful coding assistant. Your job is to analyze and debug code."},
        {"role": "user", "content": f"""Review this code:
    {code}
    List all syntax errors, logical bugs, and potential runtime issues. Format as:
    - Error/Bug: [description]
    - Impact: [potential consequences]
    - Fix: [suggested solution]"""}
        ]
    return generate_response(messages)
Kode di atas terdiri dari pesan yang berisi peran dan konten beserta prompt awal agar model bertindak seperti asisten pengodean yang membantu. Pesan ini kemudian diteruskan ke fungsi generate_response untuk mengembalikan respons yang sesuai.
Asisten ini membantu meningkatkan keterbacaan, efisiensi, dan kemudahan pemeliharaan kode dengan menghasilkan saran terkait optimasi dan kualitas kode.
def suggest_code_improvements(code):
    messages = [
        {"role": "system", "content": "You are Qwen, an expert in code optimization. Help improve code quality."},
        {"role": "user", "content": f"""Review this code:
    {code}
    Provide specific optimization suggestions:
    1. Performance improvements
    2. Better variable names
    3. Simpler logic
    4. Memory efficiency
    Include code examples where relevant."""}
    ]
return generate_response(messages)Asisten ini memeriksa apakah kode yang diberikan mengikuti standar pengkodean yang ideal dan memberikan saran sesuai temuan.
messages = [
        {"role": "system", "content": "You are Qwen, a coding standards expert. Your task is to evaluate code adherence to best practices."},
        {"role": "user", "content": f"""Evaluate this code:
    {code}
    Check against these standards:
    1. PEP 8 compliance
    2. Function/variable naming
    3. Documentation completeness
    4. Error handling
    5. Code organization
    List violations with specific examples and corrections."""}
        ]
    return generate_response(messages)
Fungsi di atas memungkinkan model bertindak sebagai pakar standar pengkodean, mengevaluasi kode yang diberikan untuk kepatuhan terhadap pedoman seperti kepatuhan PEP 8, penamaan fungsi yang tepat, penanganan kesalahan yang tangguh, dan lainnya.
Gradio menyederhanakan penerapan asisten, memungkinkan pengguna memasukkan kode dan melihat hasilnya secara interaktif. Respons model dari bagian sebelumnya diintegrasikan mulus ke dalam antarmuka Gradio.
def review_code(code):
    issues = analyze_code_issues(code)
    improvements = suggest_code_improvements(code)
    standards = check_coding_standards(code)
    return issues, improvements, standards
interface = gr.Interface(
    fn=review_code,
    inputs="textbox",
    outputs=["text", "text", "text"],
    title="AI Code Review Assistant",
    description="Analyze code for issues, suggest improvements, and check adherence to coding standards."
)
interface.launch(debug=True)
Fungsi review_code mengintegrasikan tiga komponen: analyze_code_issues, suggest_code_improvements, dan check_coding_standards. Fungsi-fungsi ini mengidentifikasi kesalahan sintaks, bug, optimasi, serta kepatuhan terhadap standar pengkodean. Antarmuka Gradio menerima masukan pengguna melalui kotak teks dan mengeluarkan hasil sebagai tiga bidang teks. Ini menyediakan antarmuka web yang mudah digunakan bagi pengembang untuk menganalisis dan meningkatkan kode mereka. Setelah kita menjalankan sel terakhir ini, kita akan mendapatkan antarmuka aplikasi Gradio yang berjalan seperti yang ditunjukkan di bawah.
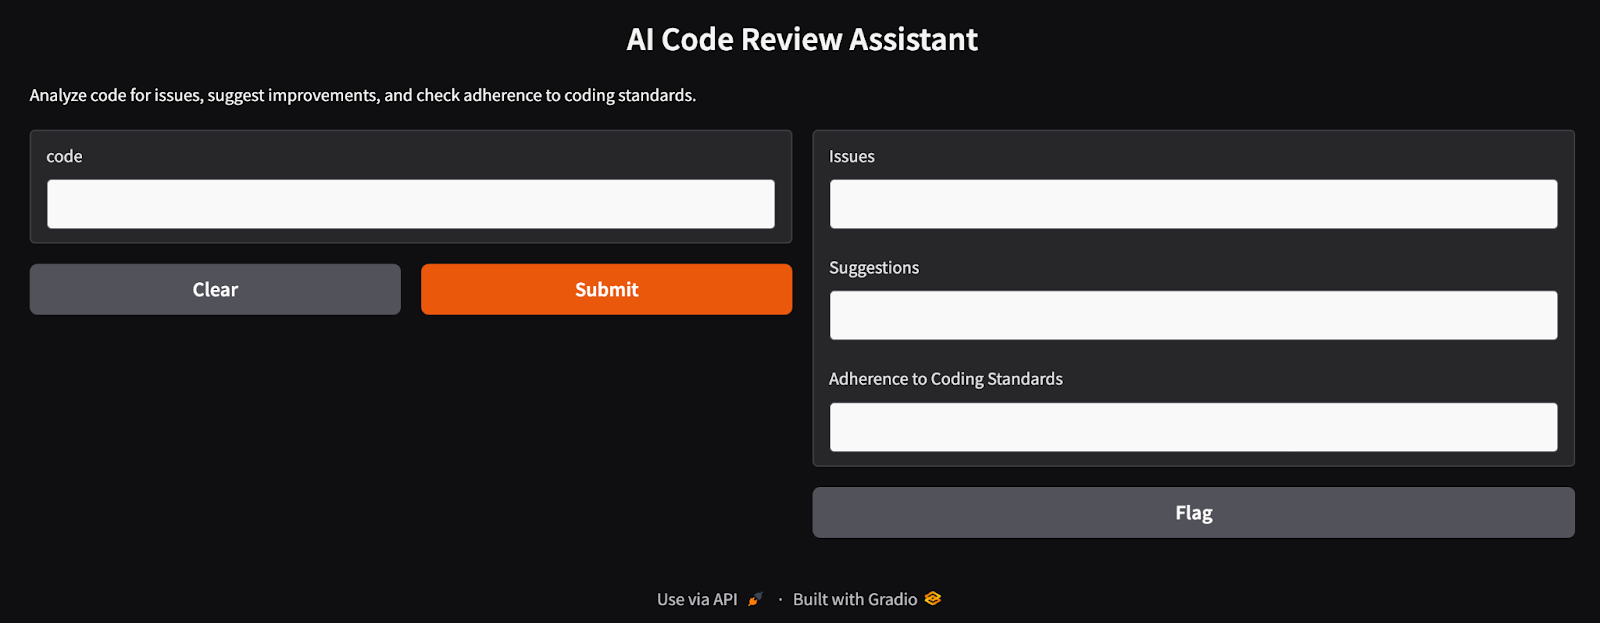
Antarmuka asisten peninjau kode AI yang dibangun menggunakan Gradio
Jika pengguna tidak ingin menjalankan aplikasi Gradio, mereka dapat menguji asisten dengan menjalankan kode berikut. Berikut contoh bagaimana asisten menganalisis fungsi Python yang bermasalah:
code = """
def add_numbers(a, b):
return a + b
"""
issues, suggestions, standards = review_code(code)
print("Issues:", issues)
print("Suggestions:", suggestions)
print("Adherence to coding standards:", standards)
Issues:
Here's the review of your provided Python code:
```python
.
.
- **Fix:** Implement input validation or use exception handling to manage unexpected data types gracefully.
Suggestions:
Certainly! Let's review the provided function and suggest optimizations based on your criteria:
1. **Proper Indentation**
.
.
2. **Better Variable Names**
In this simple case, `a` and `b` could be considered generic enough as they represent arbitrary operands. However, more descriptive names can help when functions become complex.
Adherence to coding standards:
Certainly! Let's go through the provided Python function `add_numbers` according to the specified standards.
.
.
2. **Function/Variable Naming**
- The names `add_numbers`, `a`, and `b` follow good conventions for simplicity and clarity in their context (function name clearly indicates addition; variable names indicate they're operands). However, if you want more descriptive variable names (especially useful in larger functions), consider using something like `operand_one` or `num1`.
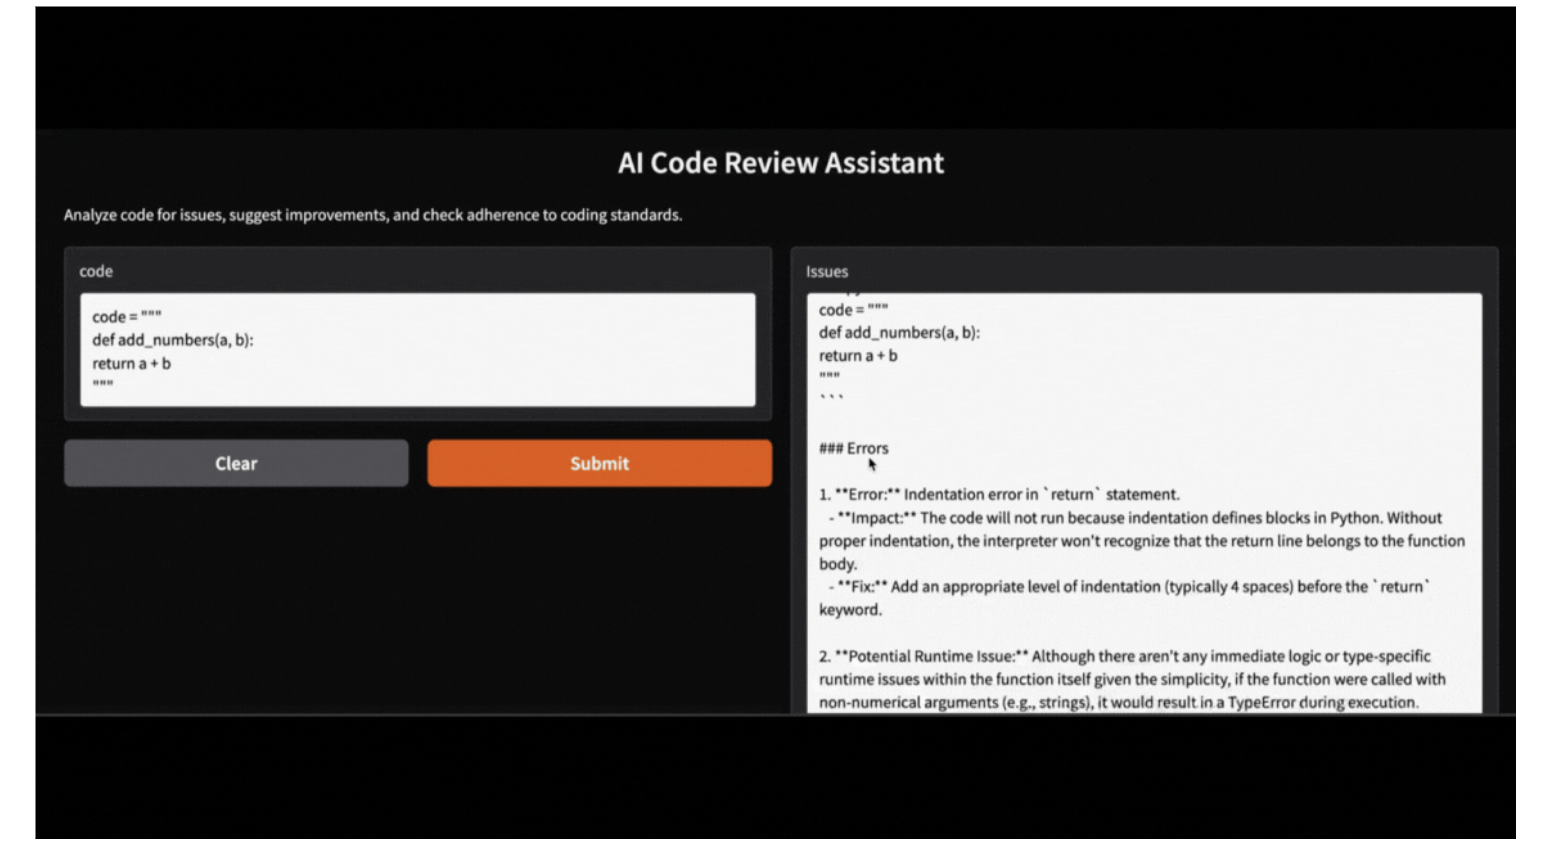
Aplikasi Gradio ini juga dapat dijalankan secara lokal dengan kode yang disediakan, memanfaatkan model Qwen-2.5 yang dapat diakses melalui Ollama. Cukup ganti model pustaka HF dengan model pustaka Ollama lokal, dan aplikasi Anda akan berjalan mulus.
Dalam artikel ini, kita mempelajari cara menggunakan Qwen 2.5-Coder-32B-Instruct bersama Gradio untuk membangun asisten peninjau kode AI. Alat ini menganalisis kode untuk kesalahan sintaks, menyarankan optimasi, dan menegakkan standar pengkodean, sehingga merampingkan proses pengembangan perangkat lunak.
Sekarang setelah Anda tahu cara menyiapkan Qwen 2.5, saya mendorong Anda untuk membangun proyek Anda sendiri!
Pelajari AI dengan kursus-kursus ini!
Program
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt




