
Lộ trình
Phát triển các ứng dụng trí tuệ nhân tạo
21 giờ
Dòng Qwen2.5-Coder (trước đây là CodeQwen1.5), do nhóm nghiên cứu Qwen của Alibaba phát triển, tập trung vào việc nâng tầm các Open CodeLLM. Dòng này bao gồm các mô hình như Qwen 2.5-32B-Instruct, đã trở thành mô hình mã nguồn mở hàng đầu cho lập trình, sánh ngang năng lực mã hóa với các mô hình độc quyền như GPT-4o và Gemini.
Những mô hình này được giới thiệu là:
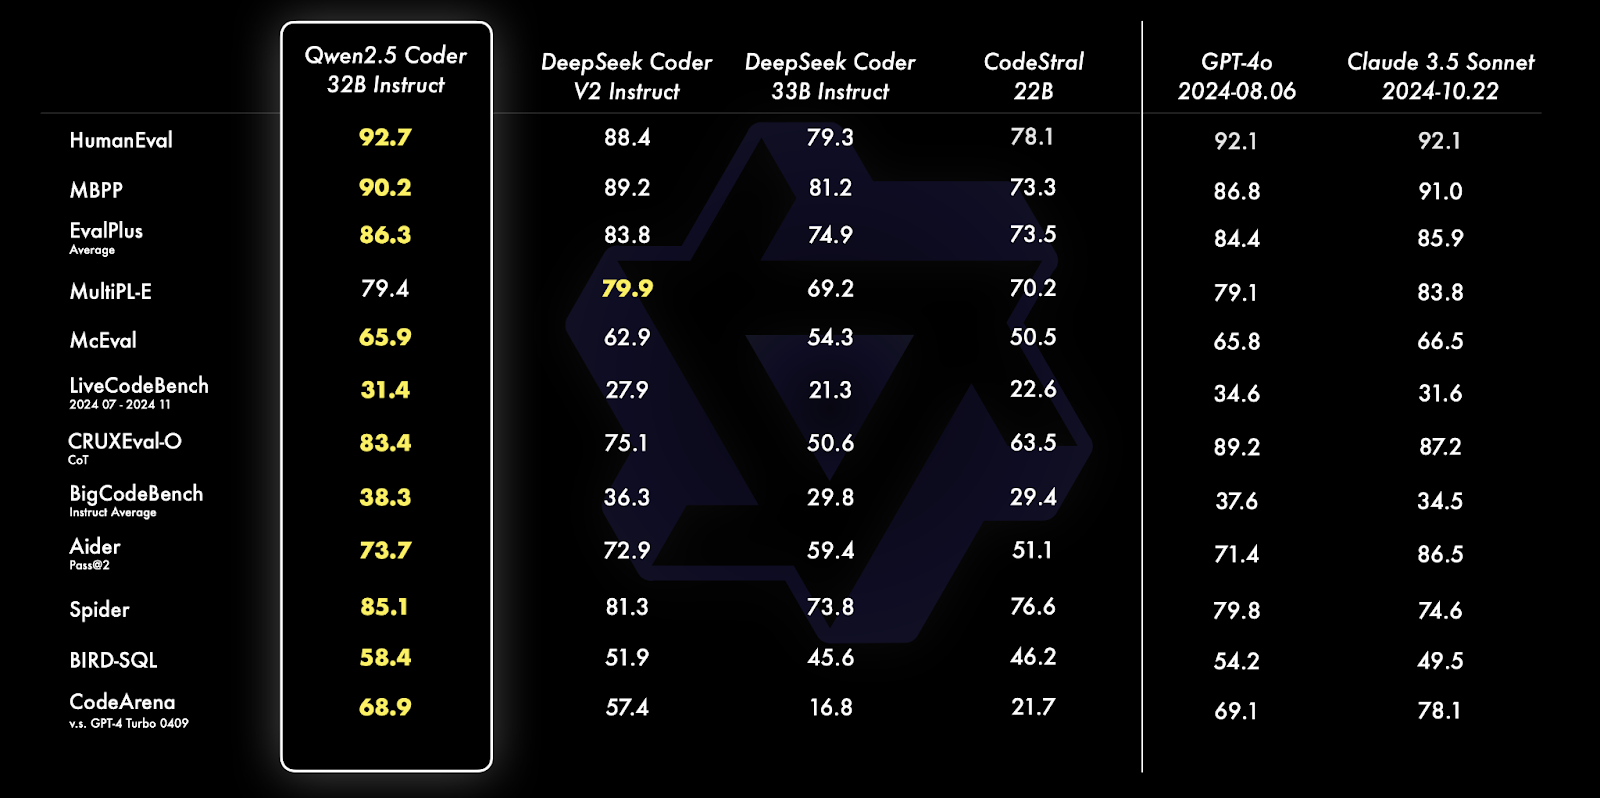
Nguồn: blog chính thức của Qwen
Qwen 2.5 Coder 32B Instruct vượt trội so với các đối thủ trên nhiều thước đo như HumanEval, MBPP và Spider, thể hiện năng lực lập trình và giải quyết vấn đề xuất sắc. Mô hình nổi bật ở các tác vụ đa dạng như sinh truy vấn SQL, đánh giá mã và thách thức lập trình thực tế, vượt qua các mô hình như GPT-4o và Claude 3.5 Sonnet.
Để tìm hiểu thêm về năng lực và so sánh các mô hình này, hãy đọc bài viết công bố về dòng Qwen2.5-Coder.
Trong phần này, chúng ta sẽ đi vào triển khai mã cho trợ lý rà soát mã bằng Gradio.
Chúng ta bắt đầu bằng cách thiết lập các điều kiện tiên quyết, sau đó khởi tạo mô hình với cấu hình tối ưu.
Tiếp theo, chúng ta định nghĩa các chức năng cốt lõi, tận dụng khả năng instruct của mô hình và cuối cùng tích hợp các thành phần này vào giao diện Gradio thân thiện, giúp tương tác với trợ lý dễ dàng.
Trước khi bắt đầu triển khai, hãy bảo đảm bạn đã cài đặt các công cụ và thư viện sau:
Chạy các lệnh sau để cài đặt phụ thuộc cần thiết:
!pip install torch transformers gradio bitsandbytes -qSau khi cài đặt xong, chạy các lệnh import sau:
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
import torch
Import gradio as gr
Lưu ý: Chạy mô hình Qwen2.5-Coder-32B-Instruct trên Google Colab cần GPU A100 với RAM cao. Nếu tài nguyên hạn chế, hãy cân nhắc dùng các mô hình nhỏ hơn như 0.5B, 3B, 7B hoặc 14B.
Thư viện Hugging Face Transformers giúp việc tải các mô hình lớn trở nên đơn giản. Ta bắt đầu bằng cách khởi tạo mô hình Qwen2.5-Coder-32B-Instruct từ HuggingFace kèm lượng tử hóa để cải thiện hiệu năng:
# Define quantization configuration for optimized performance
bnb_config = BitsAndBytesConfig(load_in_8bit=True)
# Load the model and tokenizer
model_name = "Qwen/Qwen2.5-Coder-32B-Instruct"
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.float16,
    device_map="auto",
    quantization_config=bnb_config
)
tokenizer = AutoTokenizer.from_pretrained(model_name)
if tokenizer.pad_token_id is None:
    tokenizer.pad_token_id = tokenizer.eos_token_id
Đoạn mã trên cho phép tải mô hình Qwen2.5-Coder-32B-Instruct với lượng tử hóa 8-bit, giảm sử dụng bộ nhớ để chạy hiệu quả trên thiết bị tài nguyên hạn chế.
Sử dụng BitsAndBytesConfig để bật lượng tử hóa, torch.float16 để tối ưu tính toán trên GPU hỗ trợ, và device_map="auto" để tự động phân bổ phần cứng. Tokenizer từ thư viện transformers của HuggingFace đảm bảo xử lý văn bản thuận tiện, gán pad_token_id nếu chưa có. Cấu hình này giúp chạy các mô hình lớn hiệu quả trên phần cứng phổ thông.
Sau khi tải mô hình và tokenizer, ta thiết lập hàm để sinh phản hồi từ mô hình bằng phương thức apply_chat_template.
def generate_response(messages):
    text = tokenizer.apply_chat_template(
        messages,
        tokenize=False,
        add_generation_prompt=True
    )
    model_inputs = tokenizer([text], return_tensors="pt").to(model.device)
    generated_ids = model.generate(
        **model_inputs,
        max_new_tokens=200,
        temperature=0.7,
        repetition_penalty=1.2
    )
    generated_ids = [
        output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
    ]
    response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
    return response
Hàm trên là tiện ích để tương tác với Qwen2.5-Coder-32B-Instruct nhằm sinh phản hồi theo ngữ cảnh. Hàm nhận danh sách thông điệp dạng trò chuyện (với vai trò như “system” và “user”) và thực hiện các bước sau:
apply_chat_template để chuẩn bị cho cách hiểu dựa trên hội thoại của mô hình.max_new_tokens=200; Tham số này giới hạn độ dài phản hồi ở mức 200 token.temperature=0.7; Giúp kiểm soát tính ngẫu nhiên của phản hồi, cân bằng giữa sáng tạo và nhất quán.repetition_penalty=1.2; Tham số này giảm thiểu lặp lại trong đầu ra.4. Hậu xử lý: Loại bỏ phần nhắc đầu vào khỏi đầu ra bằng thao tác cắt và giải mã về chuỗi dễ đọc với batch_decode. Hàm này trừu tượng hóa toàn bộ việc chuẩn bị, sinh và giải mã phản hồi, giúp tái sử dụng cho nhiều tác vụ như gỡ lỗi, phân tích mã và tạo phản hồi mang tính hành động.
Tiếp theo, ta thiết lập mã cho các tính năng cốt lõi của ứng dụng: bộ phân tích mã, bộ cải thiện mã và bộ kiểm tra tiêu chuẩn mã hóa. Vì dùng mô hình instruct, ta có thể sử dụng các vai trò như “system” và “user” và truyền vào mô hình trong prompt để sinh phản hồi.
Ba tính năng cốt lõi của ứng dụng: trình phát hiện vấn đề, chuyên gia chất lượng mã và chuyên gia tiêu chuẩn mã hóa.
Trợ lý này xác định lỗi cú pháp, lỗi logic và lỗ hổng tiềm ẩn trong mã được cung cấp. Hướng dẫn cụ thể cho mô hình như sau:
def analyze_code_issues(code):
    messages = [
        {"role": "system", "content": "You are Qwen, a helpful coding assistant. Your job is to analyze and debug code."},
        {"role": "user", "content": f"""Review this code:
    {code}
    List all syntax errors, logical bugs, and potential runtime issues. Format as:
    - Error/Bug: [description]
    - Impact: [potential consequences]
    - Fix: [suggested solution]"""}
        ]
    return generate_response(messages)
Đoạn mã trên gồm các thông điệp chứa vai trò và nội dung cùng một lời nhắc ban đầu để mô hình đóng vai trò trợ lý lập trình hữu ích. Thông điệp sau đó được truyền vào hàm generate_response để trả về phản hồi phù hợp.
Trợ lý này giúp cải thiện khả năng đọc, hiệu suất và khả năng bảo trì của mã bằng cách đưa ra đề xuất tối ưu hóa và nâng cao chất lượng mã.
def suggest_code_improvements(code):
    messages = [
        {"role": "system", "content": "You are Qwen, an expert in code optimization. Help improve code quality."},
        {"role": "user", "content": f"""Review this code:
    {code}
    Provide specific optimization suggestions:
    1. Performance improvements
    2. Better variable names
    3. Simpler logic
    4. Memory efficiency
    Include code examples where relevant."""}
    ]
return generate_response(messages)Trợ lý này kiểm tra xem mã cung cấp có tuân theo các tiêu chuẩn mã hóa lý tưởng không và đưa ra đề xuất tương ứng.
messages = [
        {"role": "system", "content": "You are Qwen, a coding standards expert. Your task is to evaluate code adherence to best practices."},
        {"role": "user", "content": f"""Evaluate this code:
    {code}
    Check against these standards:
    1. PEP 8 compliance
    2. Function/variable naming
    3. Documentation completeness
    4. Error handling
    5. Code organization
    List violations with specific examples and corrections."""}
        ]
    return generate_response(messages)
Hàm trên cho phép mô hình đóng vai trò chuyên gia tiêu chuẩn mã hóa, đánh giá mã được cung cấp theo các hướng dẫn như tuân thủ PEP 8, đặt tên hàm/biến phù hợp, xử lý lỗi vững chắc, v.v.
Gradio đơn giản hóa việc triển khai trợ lý, cho phép người dùng nhập mã và xem kết quả tương tác. Phản hồi của mô hình từ các phần trước được tích hợp mượt mà vào giao diện Gradio.
def review_code(code):
    issues = analyze_code_issues(code)
    improvements = suggest_code_improvements(code)
    standards = check_coding_standards(code)
    return issues, improvements, standards
interface = gr.Interface(
    fn=review_code,
    inputs="textbox",
    outputs=["text", "text", "text"],
    title="AI Code Review Assistant",
    description="Analyze code for issues, suggest improvements, and check adherence to coding standards."
)
interface.launch(debug=True)
Hàm review_code tích hợp ba thành phần: analyze_code_issues, suggest_code_improvements và check_coding_standards. Các hàm này nhận diện lỗi cú pháp, bug, tối ưu hóa và mức độ tuân thủ tiêu chuẩn mã hóa. Giao diện Gradio nhận đầu vào qua một ô textbox và xuất ra ba trường văn bản. Đây là giao diện web dễ dùng cho nhà phát triển để phân tích và cải thiện mã. Khi chạy ô lệnh cuối cùng này, bạn sẽ được một ứng dụng Gradio đang hoạt động như hình minh họa bên dưới.
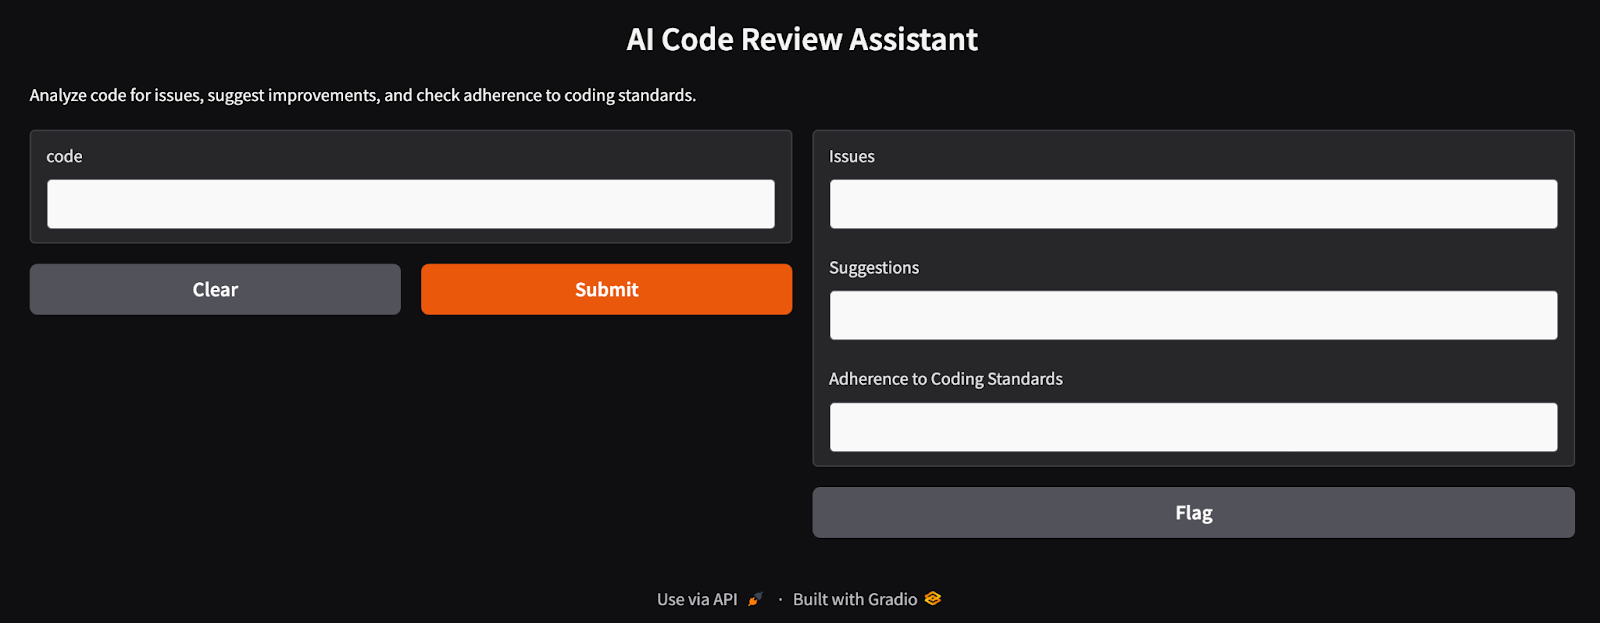
Giao diện trợ lý rà soát mã AI xây dựng bằng Gradio
Nếu người dùng không muốn chạy ứng dụng Gradio, họ có thể kiểm thử trợ lý bằng cách chạy đoạn mã sau. Đây là ví dụ trợ lý phân tích một hàm Python có lỗi:
code = """
def add_numbers(a, b):
return a + b
"""
issues, suggestions, standards = review_code(code)
print("Issues:", issues)
print("Suggestions:", suggestions)
print("Adherence to coding standards:", standards)
Issues:
Here's the review of your provided Python code:
```python
.
.
- **Fix:** Implement input validation or use exception handling to manage unexpected data types gracefully.
Suggestions:
Certainly! Let's review the provided function and suggest optimizations based on your criteria:
1. **Proper Indentation**
.
.
2. **Better Variable Names**
In this simple case, `a` and `b` could be considered generic enough as they represent arbitrary operands. However, more descriptive names can help when functions become complex.
Adherence to coding standards:
Certainly! Let's go through the provided Python function `add_numbers` according to the specified standards.
.
.
2. **Function/Variable Naming**
- The names `add_numbers`, `a`, and `b` follow good conventions for simplicity and clarity in their context (function name clearly indicates addition; variable names indicate they're operands). However, if you want more descriptive variable names (especially useful in larger functions), consider using something like `operand_one` or `num1`.
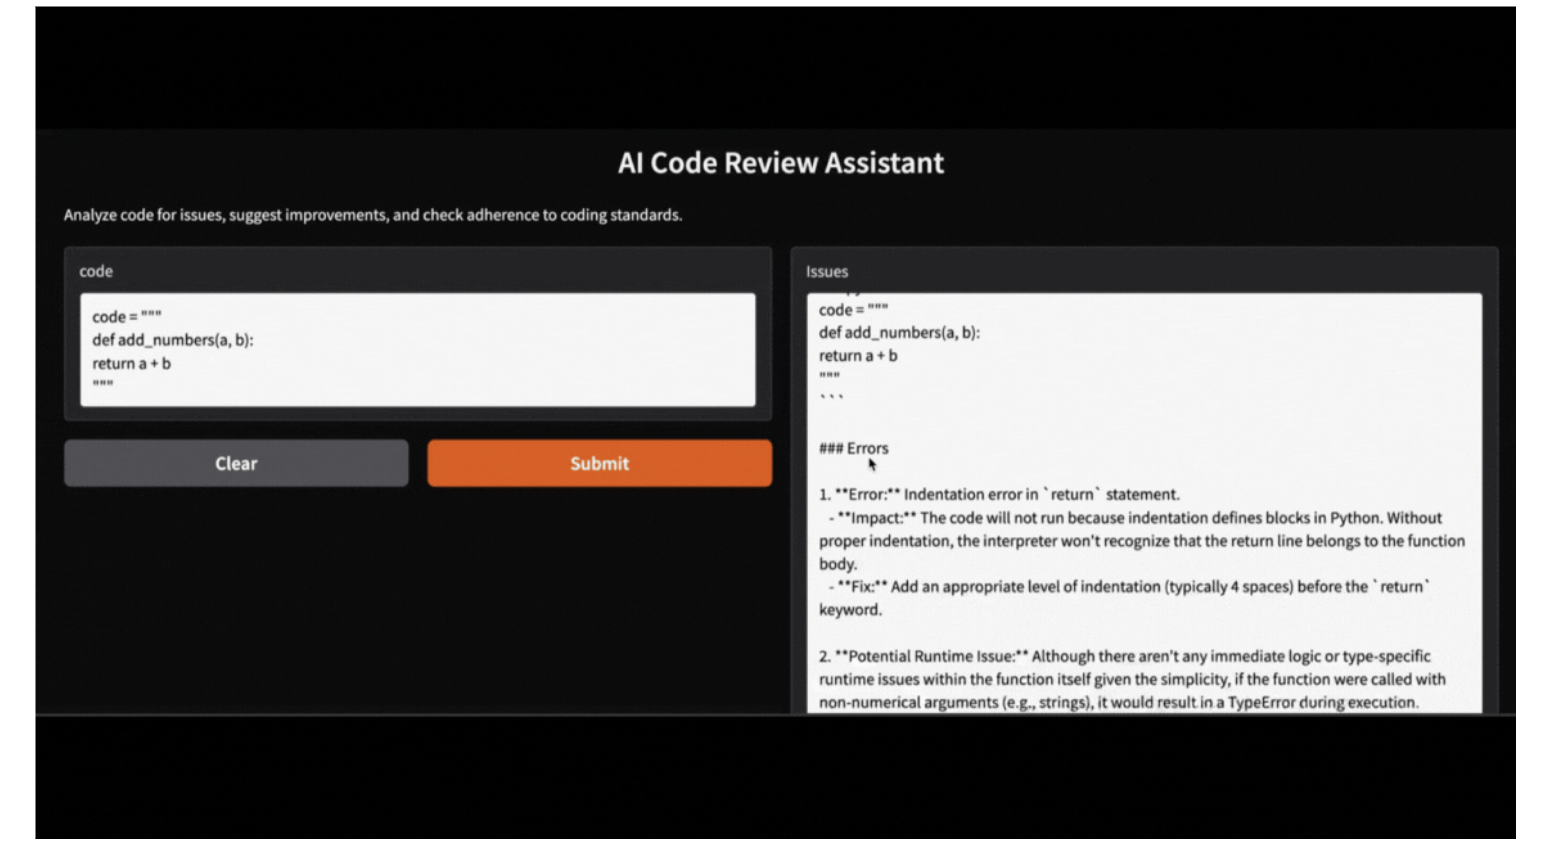
Ứng dụng Gradio này cũng có thể chạy cục bộ với mã cung cấp, sử dụng mô hình Qwen-2.5 truy cập qua Ollama. Chỉ cần thay mô hình thư viện HF bằng mô hình thư viện Ollama cục bộ là ứng dụng sẽ chạy trơn tru.
Trong bài viết này, chúng ta đã học cách dùng Qwen 2.5-Coder-32B-Instruct kết hợp với Gradio để xây dựng trợ lý rà soát mã AI. Công cụ này phân tích lỗi cú pháp, đề xuất tối ưu và đảm bảo tiêu chuẩn mã hóa, giúp tinh gọn quy trình phát triển phần mềm.
Giờ bạn đã biết cách thiết lập Qwen 2.5, hãy thử xây dựng dự án của riêng mình!
Học AI với các khóa học này!
Lộ trình
Khóa học
Khóa học