
Last chance! 50% off DataCamp Premium
Sale ends in
Alibaba की Qwen शोध टीम द्वारा विकसित Qwen2.5-Coder श्रृंखला (पहले CodeQwen1.5 के नाम से जानी जाती थी) Open CodeLLMs को आगे बढ़ाने के लिए समर्पित है। इस श्रृंखला में Qwen 2.5-32B-Instruct जैसे मॉडल शामिल हैं, जो अत्याधुनिक ओपन-सोर्स कोड मॉडल बन चुका है और GPT-4o और Gemini जैसे प्रॉपर्टियट दिग्गजों की कोडिंग क्षमताओं की टक्कर देता है।
इन मॉडलों को इस प्रकार प्रस्तुत किया गया है:
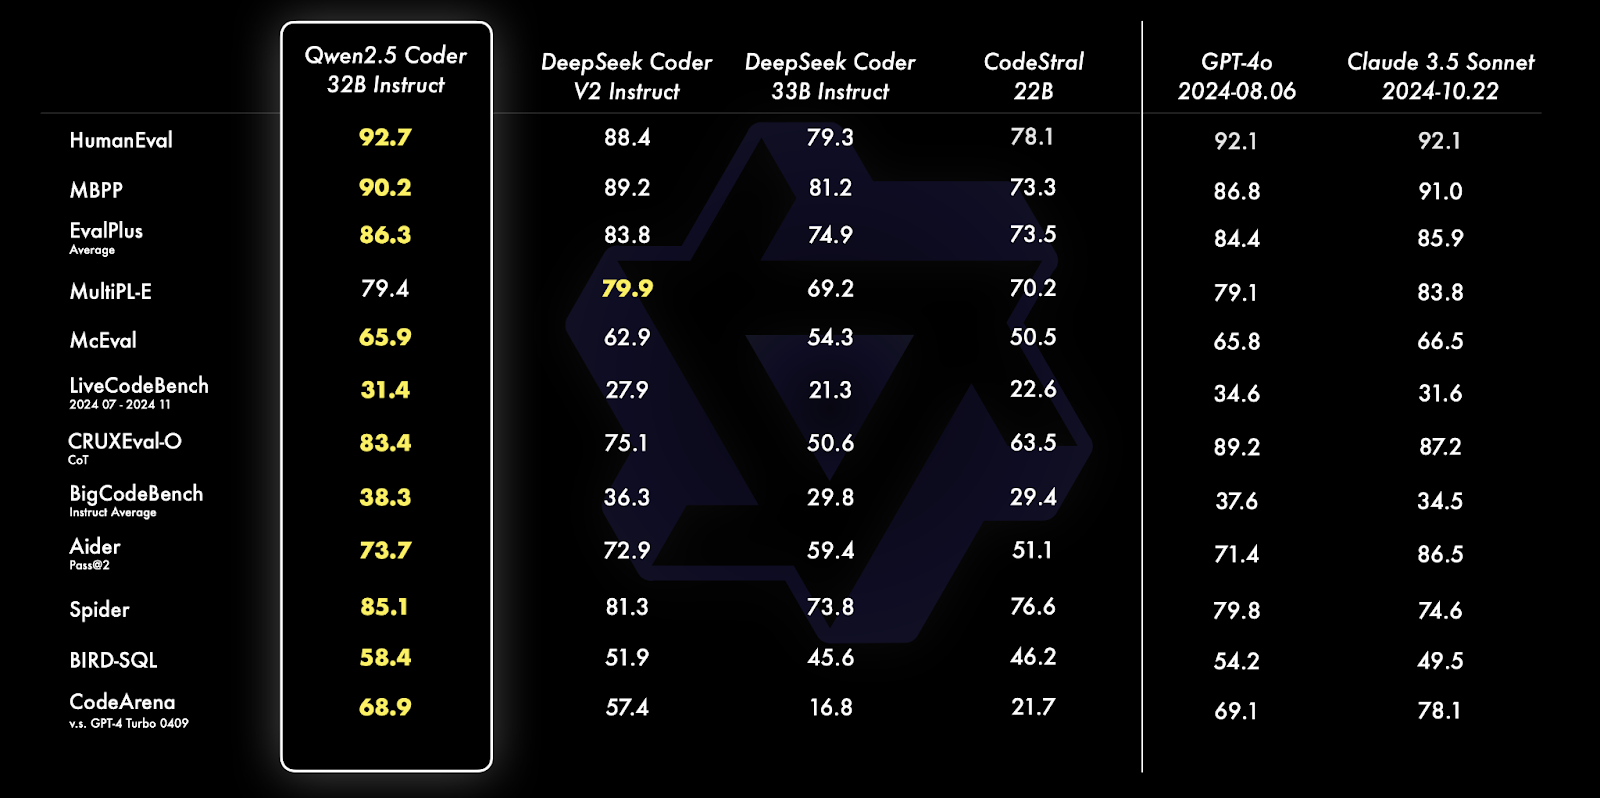
स्रोत: Qwen का आधिकारिक ब्लॉग
Qwen 2.5 Coder 32B Instruct ने HumanEval, MBPP, और Spider सहित कई बेंचमार्क पर अपने समकक्षों से बेहतर प्रदर्शन किया है, और असाधारण कोडिंग व समस्या-समाधान क्षमताएँ दिखाईं हैं। यह SQL क्वेरी जनरेशन, कोड मूल्यांकन, और वास्तविक दुनिया की प्रोग्रामिंग चुनौतियों जैसे विविध कार्यों में उत्कृष्ट है, और GPT-4o और Claude 3.5 Sonnet जैसे मॉडलों को पीछे छोड़ देता है।
इन मॉडलों की क्षमताओं और तुलनाओं के बारे में अधिक जानने के लिए Qwen2.5-Coder श्रृंखला का घोषणा लेख पढ़ें।
इस खंड में, हम Gradio का उपयोग करके अपने कोड रिव्यू सहायक के कोड इम्प्लीमेंटेशन में उतरेंगे।
हम आवश्यक पूर्वापेक्षाएँ सेटअप करने से शुरू करेंगे, और फिर ऑप्टिमाइज़्ड कॉन्फ़िगरेशन के साथ मॉडल को इनिशियलाइज़ करेंगे।
इसके बाद, हम मॉडल की इंस्ट्रक्ट क्षमताओं का उपयोग करके मुख्य फ़ंक्शनलिटी परिभाषित करेंगे और अंत में इन घटकों को एक उपयोगकर्ता-अनुकूल Gradio इंटरफ़ेस में इंटीग्रेट करेंगे, जिससे सहायक के साथ आसानी से संवाद हो सके।
इम्प्लीमेंटेशन में उतरने से पहले, सुनिश्चित करें कि निम्नलिखित टूल और लाइब्रेरी इंस्टॉल हैं:
आवश्यक डिपेंडेंसी इंस्टॉल करने के लिए निम्न कमांड चलाएँ:
!pip install torch transformers gradio bitsandbytes -qऊपर दी गई डिपेंडेंसी इंस्टॉल होने के बाद, निम्न इम्पोर्ट कमांड चलाएँ:
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
import torch
Import gradio as gr
नोट: Google Colab पर Qwen2.5-Coder-32B-Instruct मॉडल चलाने के लिए उच्च RAM वाला A100 GPU आवश्यक है। यदि संसाधन सीमित हों, तो 0.5B, 3B, 7B, या 14B जैसे कम पैरामीटर वाले मॉडल का उपयोग करने पर विचार करें।
Hugging Face Transformers लाइब्रेरी बड़े मॉडलों को लोड करना सरल बनाती है। हम Qwen2.5-Coder-32B-Instruct मॉडल को HuggingFace से क्वांटाइज़ेशन के साथ इनिशियलाइज़ करके शुरू करेंगे, ताकि परफॉर्मेंस बेहतर हो:
# Define quantization configuration for optimized performance
bnb_config = BitsAndBytesConfig(load_in_8bit=True)
# Load the model and tokenizer
model_name = "Qwen/Qwen2.5-Coder-32B-Instruct"
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.float16,
    device_map="auto",
    quantization_config=bnb_config
)
tokenizer = AutoTokenizer.from_pretrained(model_name)
if tokenizer.pad_token_id is None:
    tokenizer.pad_token_id = tokenizer.eos_token_id
उपरोक्त कोड स्निपेट हमें Qwen2.5-Coder-32B-Instruct मॉडल को 8-बिट क्वांटाइज़ेशन के साथ लोड करने देता है, जिससे सीमित संसाधनों वाले डिवाइस पर मेमोरी उपयोग कम होता है और निष्पादन कुशल बनता है।
यह BitsAndBytesConfig का उपयोग क्वांटाइज़ेशन सक्षम करने के लिए करता है, समर्थित GPU पर ऑप्टिमाइज़्ड कम्प्यूटेशन के लिए torch.float16 अपनाता है, और स्वतः हार्डवेयर आवंटन हेतु device_map="auto" का उपयोग करता है। HuggingFace की transformers लाइब्रेरी का टोकनाइज़र आसान टेक्स्ट प्रोसेसिंग सुनिश्चित करता है और आवश्यकता होने पर pad_token_id असाइन करता है। यह कॉन्फ़िगरेशन बड़े मॉडलों को कंज़्यूमर-ग्रेड हार्डवेयर पर भी कुशलता से चलाना सरल बनाता है।
एक बार जब हम मॉडल और टोकनाइज़र लोड कर लेते हैं, तो हम apply_chat_template मेथड का उपयोग करके मॉडल से प्रतिक्रिया जनरेट करने के लिए एक फ़ंक्शन सेटअप करते हैं।
def generate_response(messages):
    text = tokenizer.apply_chat_template(
        messages,
        tokenize=False,
        add_generation_prompt=True
    )
    model_inputs = tokenizer([text], return_tensors="pt").to(model.device)
    generated_ids = model.generate(
        **model_inputs,
        max_new_tokens=200,
        temperature=0.7,
        repetition_penalty=1.2
    )
    generated_ids = [
        output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
    ]
    response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
    return response
ऊपर दिया गया फ़ंक्शन Qwen2.5-Coder-32B-Instruct मॉडल के साथ इंटरैक्ट करने के लिए एक यूटिलिटी के रूप में काम करता है, ताकि संदर्भ-संवेदी प्रतिक्रियाएँ जनरेट की जा सकें। यह इनपुट के रूप में चैट-जैसे संदेशों (जैसे “system” और “user” रोल) की सूची लेता है और निम्न चरण पूरे करता है:
apply_chat_template फ़ंक्शन का उपयोग करके संदेशों को फॉर्मैट करता है, ताकि मॉडल उन्हें चैट-आधारित तरीके से समझ सके।max_new_tokens=200; यह पैरामीटर प्रतिक्रिया की लंबाई 200 टोकन तक सीमित करता है।temperature=0.7; यह प्रतिक्रिया में रैंडमनेस को नियंत्रित करने में मदद करता है, जिससे रचनात्मकता और स्थिरता के बीच संतुलन बनता है।repetition_penalty=1.2; यह पैरामीटर आउटपुट में दोहरावदार वाक्यांशों को हतोत्साहित करता है।4. पोस्ट-प्रोसेसिंग: यह चरण जनरेट किए आउटपुट से इनपुट प्रॉम्प्ट को स्लाइसिंग द्वारा हटाता है और batch_decode फ़ंक्शन का उपयोग करके मानव-पठनीय स्ट्रिंग में डिकोड करता है। यह फ़ंक्शन तैयारी, जनरेशन और डिकोडिंग की जटिलताओं को एब्स्ट्रैक्ट कर देता है, जिससे इसे डिबगिंग, कोड विश्लेषण और क्रियाशील फीडबैक जनरेट करने जैसे विभिन्न कार्यों में पुन: उपयोग किया जा सकता है।
अब हम अपने एप्लिकेशन की मुख्य विशेषताओं—कोड एनालाइज़र, कोड इम्प्रूवर, और कोडिंग स्टैंडर्ड्स चेकर—के लिए कोड सेटअप करेंगे। चूंकि हम एक इंस्ट्रक्ट मॉडल का उपयोग कर रहे हैं, हम “system” और “user” जैसे रोल का उपयोग कर सकते हैं और उन्हें प्रॉम्प्ट के भीतर मॉडल को पास कर प्रतिक्रिया जनरेट करा सकते हैं।
हमारे ऐप की तीन कोर विशेषताएँ इस प्रकार हैं: इश्यू डिटेक्टर, कोड क्वालिटी एक्सपर्ट, और कोडिंग स्टैंडर्ड्स एक्सपर्ट।
यह सहायक दिए गए कोड में सिंटैक्स एरर, लॉजिकल बग, और संभावित कमजोरियाँ पहचानता है। मॉडल के लिए विशिष्ट निर्देश इस प्रकार हैं:
def analyze_code_issues(code):
    messages = [
        {"role": "system", "content": "You are Qwen, a helpful coding assistant. Your job is to analyze and debug code."},
        {"role": "user", "content": f"""Review this code:
    {code}
    List all syntax errors, logical bugs, and potential runtime issues. Format as:
    - Error/Bug: [description]
    - Impact: [potential consequences]
    - Fix: [suggested solution]"""}
        ]
    return generate_response(messages)
ऊपर दिए गए कोड में रोल और कंटेंट वाले संदेश शामिल हैं, साथ ही मॉडल को एक सहायक कोडिंग असिस्टेंट की तरह कार्य करने के लिए एक प्रारंभिक प्रॉम्प्ट भी है। यह संदेश generate_response फ़ंक्शन में पास किया जाता है, जो उपयुक्त प्रतिक्रिया लौटाता है।
यह सहायक पठनीयता, दक्षता और मेंटेनबिलिटी को बेहतर बनाने में मदद करता है, और ऑप्टिमाइज़ेशन व कोड गुणवत्ता पर सुझाव जनरेट करता है।
def suggest_code_improvements(code):
    messages = [
        {"role": "system", "content": "You are Qwen, an expert in code optimization. Help improve code quality."},
        {"role": "user", "content": f"""Review this code:
    {code}
    Provide specific optimization suggestions:
    1. Performance improvements
    2. Better variable names
    3. Simpler logic
    4. Memory efficiency
    Include code examples where relevant."""}
    ]
return generate_response(messages)यह सहायक जाँचता है कि दिया गया कोड आदर्श कोडिंग मानकों का पालन करता है या नहीं, और तदनुसार सुझाव देता है।
messages = [
        {"role": "system", "content": "You are Qwen, a coding standards expert. Your task is to evaluate code adherence to best practices."},
        {"role": "user", "content": f"""Evaluate this code:
    {code}
    Check against these standards:
    1. PEP 8 compliance
    2. Function/variable naming
    3. Documentation completeness
    4. Error handling
    5. Code organization
    List violations with specific examples and corrections."""}
        ]
    return generate_response(messages)
ऊपर दिया गया फ़ंक्शन मॉडल को कोडिंग स्टैंडर्ड्स के विशेषज्ञ की तरह काम करने में सक्षम बनाता है, और दिए गए कोड का PEP 8 अनुपालन, उचित फ़ंक्शन नामकरण, मज़बूत एरर हैंडलिंग आदि दिशानिर्देशों के अनुरूप मूल्यांकन करता है।
Gradio सहायक की डिप्लॉयमेंट को सरल बनाता है, जिससे उपयोगकर्ता इंटरैक्टिव तरीके से कोड इनपुट कर परिणाम देख सकते हैं। पिछले सेक्शन से मॉडल की प्रतिक्रियाएँ निर्बाध रूप से Gradio इंटरफ़ेस में इंटीग्रेट की जाती हैं।
def review_code(code):
    issues = analyze_code_issues(code)
    improvements = suggest_code_improvements(code)
    standards = check_coding_standards(code)
    return issues, improvements, standards
interface = gr.Interface(
    fn=review_code,
    inputs="textbox",
    outputs=["text", "text", "text"],
    title="AI Code Review Assistant",
    description="Analyze code for issues, suggest improvements, and check adherence to coding standards."
)
interface.launch(debug=True)
review_code फ़ंक्शन तीन घटकों—analyze_code_issues, suggest_code_improvements, और check_coding_standards—को एकीकृत करता है। ये फ़ंक्शन सिंटैक्स एरर, बग, ऑप्टिमाइज़ेशन और कोडिंग मानकों के पालन की पहचान करते हैं। Gradio इंटरफ़ेस टेक्स्टबॉक्स के माध्यम से उपयोगकर्ता इनपुट लेता है और परिणाम तीन टेक्स्ट फ़ील्ड के रूप में आउटपुट करता है। यह डेवलपर्स के लिए अपने कोड का विश्लेषण और सुधार करने हेतु एक आसान वेब इंटरफ़ेस प्रदान करता है। जब हम यह अंतिम सेल चलाते हैं, तो हमें नीचे दिखाए गए जैसा एक चल रहा Gradio ऐप इंटरफ़ेस मिलता है।
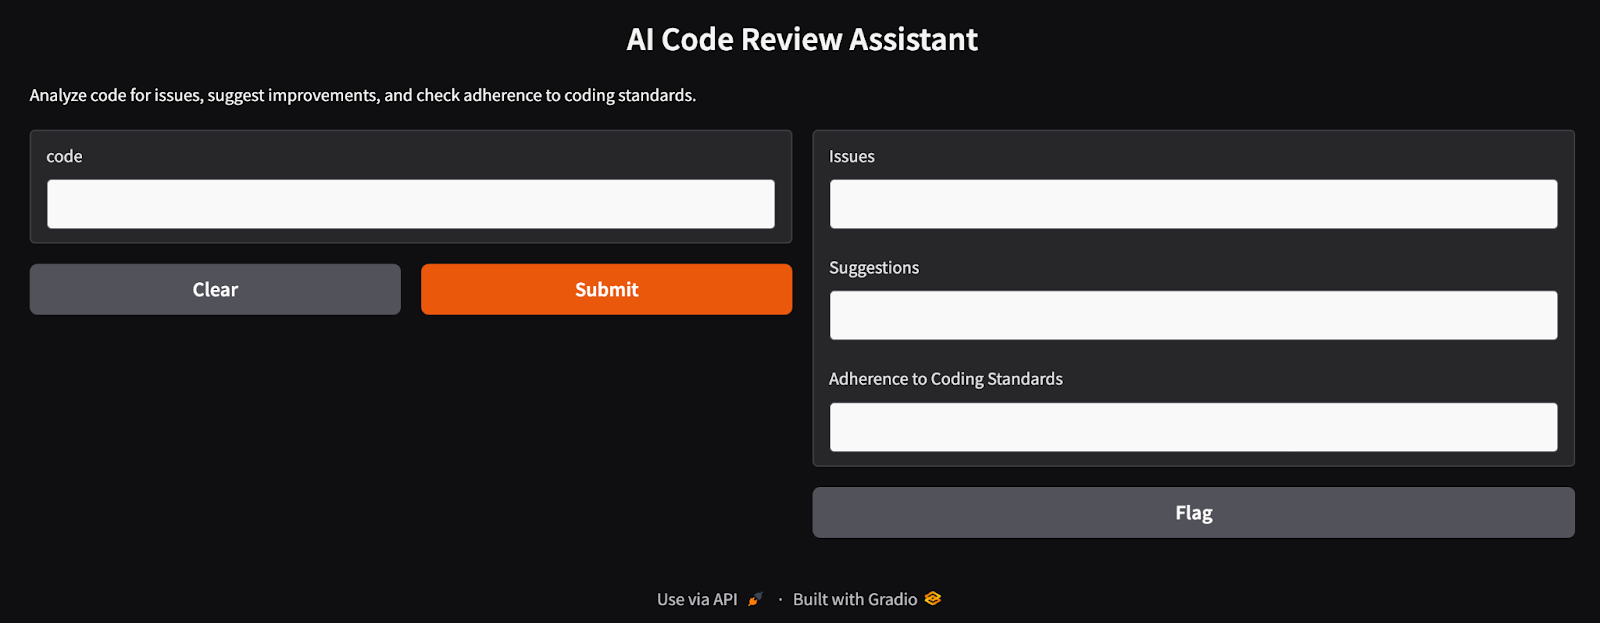
Gradio की मदद से बनाया गया AI कोड रिव्यू असिस्टेंट इंटरफ़ेस
अगर कोई उपयोगकर्ता Gradio ऐप नहीं चलाना चाहता, तो वह निम्न कोड चलाकर सहायक का परीक्षण कर सकता है। यहाँ एक उदाहरण है कि सहायक बगयुक्त Python फ़ंक्शन का विश्लेषण कैसे करता है:
code = """
def add_numbers(a, b):
return a + b
"""
issues, suggestions, standards = review_code(code)
print("Issues:", issues)
print("Suggestions:", suggestions)
print("Adherence to coding standards:", standards)
Issues:
Here's the review of your provided Python code:
```python
.
.
- **Fix:** Implement input validation or use exception handling to manage unexpected data types gracefully.
Suggestions:
Certainly! Let's review the provided function and suggest optimizations based on your criteria:
1. **Proper Indentation**
.
.
2. **Better Variable Names**
In this simple case, `a` and `b` could be considered generic enough as they represent arbitrary operands. However, more descriptive names can help when functions become complex.
Adherence to coding standards:
Certainly! Let's go through the provided Python function `add_numbers` according to the specified standards.
.
.
2. **Function/Variable Naming**
- The names `add_numbers`, `a`, and `b` follow good conventions for simplicity and clarity in their context (function name clearly indicates addition; variable names indicate they're operands). However, if you want more descriptive variable names (especially useful in larger functions), consider using something like `operand_one` or `num1`.
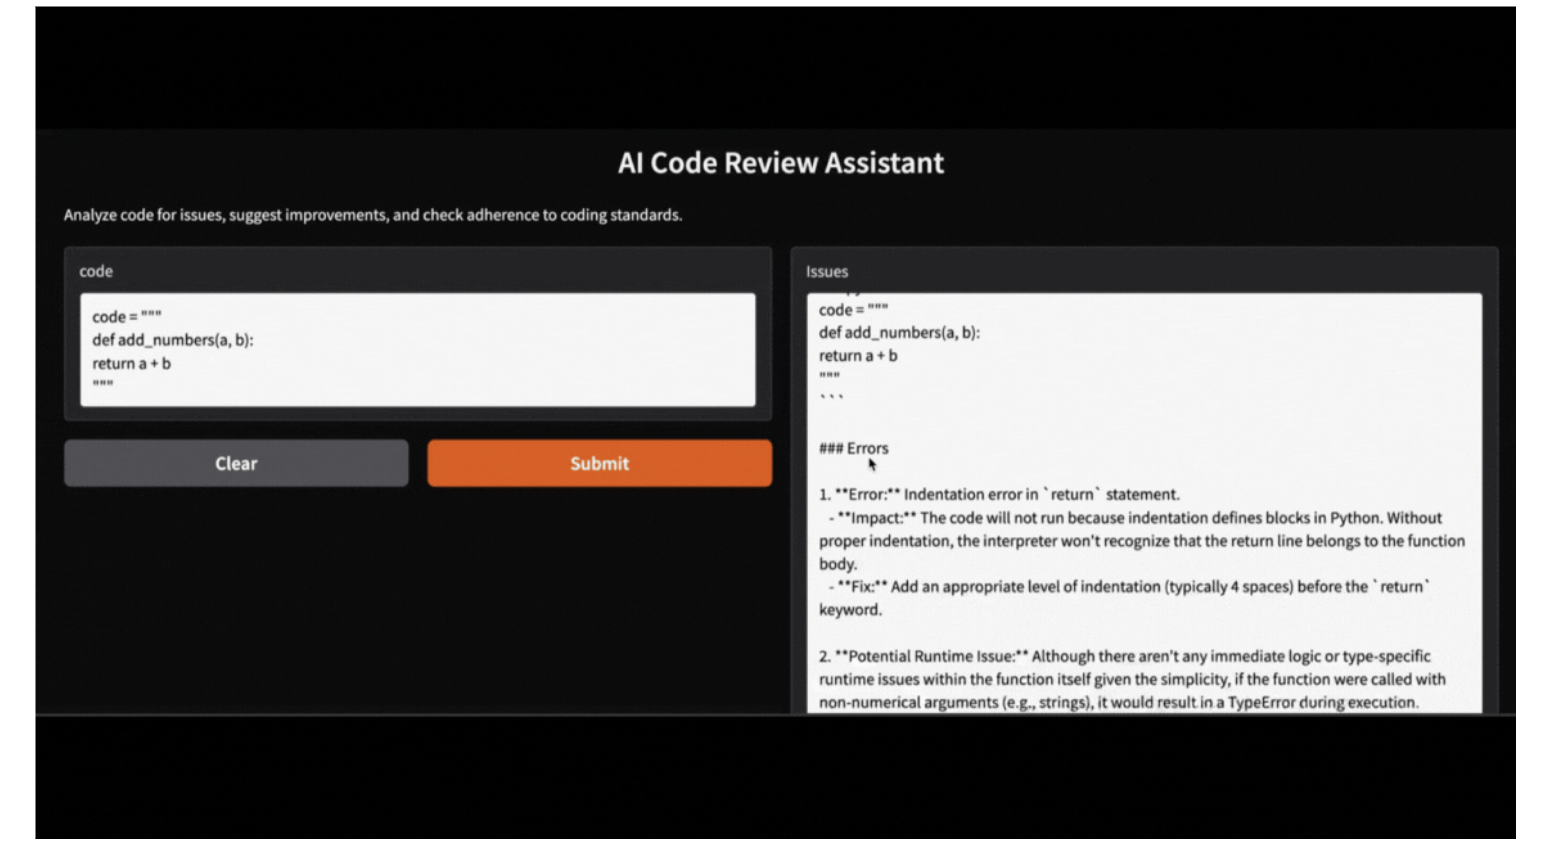
यह Gradio ऐप दिए गए कोड के साथ स्थानीय रूप से भी चलाया जा सकता है, Ollama के माध्यम से सुलभ Qwen-2.5 मॉडल का उपयोग करते हुए। बस HF लाइब्रेरी मॉडल को स्थानीय Ollama लाइब्रेरी मॉडल से बदलें, और आपका ऐप बिना किसी रुकावट के चल पड़ेगा।
इस लेख में, हमने Qwen 2.5-Coder-32B-Instruct को Gradio के साथ मिलाकर एक AI कोड रिव्यू सहायक बनाना सीखा। यह टूल सिंटैक्स एरर का विश्लेषण करता है, ऑप्टिमाइज़ेशन सुझाता है, और कोडिंग मानकों को लागू करता है, जिससे सॉफ्टवेयर डेवलपमेंट प्रक्रिया सुगम होती है।
अब जब आप Qwen 2.5 सेटअप करना जानते हैं, तो मैं आपको अपना प्रोजेक्ट बनाने के लिए प्रोत्साहित करता/करती हूँ!
इन कोर्सेज़ के साथ AI सीखें!
लर्निंग पाथ
कोर्स
कोर्स
